در این مجموعه

LLM & SLM

راهنمای انتخاب مدل زبانی بزرگ و کوچک

مدل زبانی مناسب ترجمه، دستیار اسناد و Agent را بر اساس زبان، حافظه، سخت‌افزار و هزینه انتخاب کنید؛ مقایسه مدل‌ها و راهنمای اجرای سازمانی.

امروزه بسیاری از افراد و سازمان‌ها تمایل دارند برای کاربردهای مختلف،(LLM یا SLM) یک مدل زبانی محلی در اختیار داشته باشند؛ مدلی که روی رایانه یا سرور خودشان اجرا شود و برای گفت‌وگو، برنامه‌نویسی، ترجمه یا پاسخ‌گویی بر اساس اسناد از آن استفاده کنند. حفظ محرمانگی اطلاعات، استقلال از سرویس‌های خارجی و کنترل هزینه‌ها از انگیزه‌های این انتخاب است. اما تنوع مدل‌ها و روش‌های اجرای آن‌ها، تصمیم‌گیری را دشوار می‌کند: چه مدلی برای کار ما کافی است، روی سخت‌افزار موجود چه چیزی می‌توان اجرا کرد و چه زمانی ارتقای زیرساخت ضرورت دارد؟

این مجموعه برای پاسخ به همین پرسش‌ها تهیه شده است. در جدول‌های تعاملی می‌توانید مدل‌های زبانی کوچک و بزرگ، مدل‌های تخصصی مرتبط، نیازهای سخت‌افزاری و نرم‌افزارهای اجرای آن‌ها را مقایسه کنید و به منابع و لینک‌های کاربردی دسترسی داشته باشید. مقاله‌های همراه نیز توضیح می‌دهند هر انتخاب چه مزایا و محدودیت‌هایی دارد؛ تا بتوانید متناسب با کاربرد، کیفیت موردانتظار و بودجه خود تصمیم بگیرید و برای قابلیتی که به آن نیاز ندارید، هزینه نکنید.

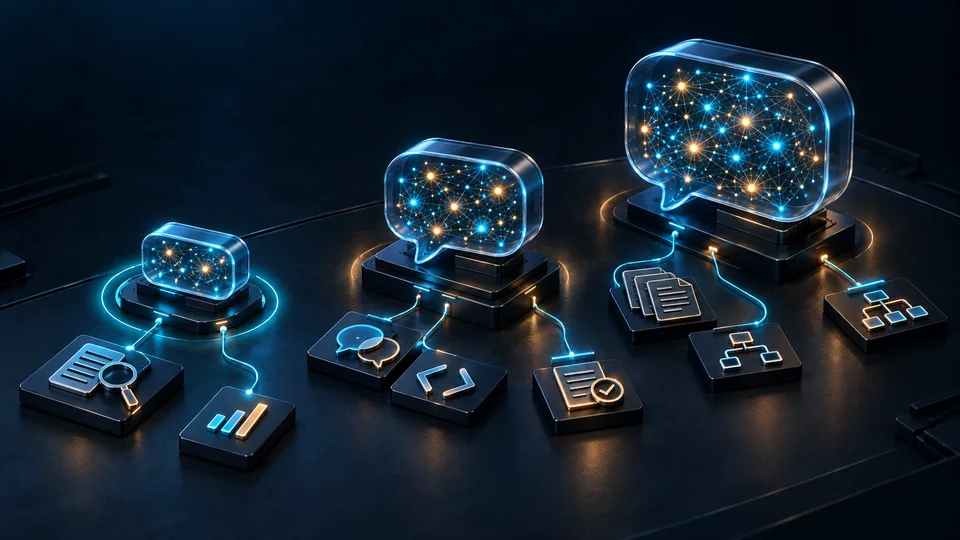
مدل‌های زبانی در اندازه‌های مختلف، متصل به کاربردهای گفت‌وگو، کدنویسی و کار با اسناد
راهنمای استفاده از مجموعه

از کجا شروع کنیم؟

برای مقایسه، جدول را باز کنید؛ برای شناخت مفاهیم و دلیل انتخاب، یادداشت‌های هر مسیر را بخوانید.

راهنمای تعامل

با چند پرسش اصلی شروع کنید؛ برای نتیجهٔ دقیق‌تر، مشخصات اجرا را بعداً اضافه کنید.

می‌خواهید کدام کار بهتر انجام شود؟

اول بگویید قرار است چه کاری را به مدل بسپارید؛ مدلی که برای ترجمه خوب است، لزوماً برای کدنویسی هم انتخاب خوبی نیست.

مقاله مرتبط ↗
راهنمای انتخاب مدل سازمانی

اول یک کار مشخص را برای آزمایش انتخاب کنید

خلاصه‌کردن نامه، استخراج مبلغ فاکتور یا یافتن بند آیین‌نامه را انتخاب کنید. خروجی درست را با کسی مشخص کنید که همان کار را انجام می‌دهد؛ سپس به پرسش اول برگردید.

اطلاعاتی که وارد کرده‌اید

برای تصمیم بعدی، این‌ها را بخوانید

برای تیم فنی

برای مقایسهٔ مدل‌های بالا، نسخهٔ فایل‌ها و تنظیمات هر اجرا را ثبت کنید.

تمام پاسخ‌ها و مبنای آن‌ها

2026-09-20.2 · 2026-09-20 — Qwen3.6 / Qwen3.7

برای پیمانکار

از پیمانکار بخواهید هزینهٔ آزمایش مدل‌های بالا را با همین بودجه و انتظار شما پیشنهاد بدهد. هزینهٔ راه‌اندازی و پشتیبانی ماهانه، مسئول نگهداری و نتیجهٔ آزمون با تعداد درخواست موردنظر، جدا مشخص شوند.

۱۴۱ مدل ۱۷ نرم‌افزار ۷ جدول تعاملی ۱۵ مقالهٔ راهنما آخرین به‌روزرسانی داده‌ها:

پس از مشخص‌شدن مدل و حافظهٔ لازم، کارت گرافیک و سرور مناسب را مقایسه کنید.

دربارهٔ اطلاعات این راهنما

برای تهیهٔ این جدول‌ها، مشخصات مدل‌ها و مستندات نرم‌افزارها را بررسی کرده‌ایم. اعداد کیفیت و سرعت از آزمون‌های منتشرشده نقل شده‌اند و حاصل آزمایش ما نیستند. منبع و شرایط هر آزمون هم کنار نتیجه آمده است.

در این مجموعه، مدل‌هایی برای نوشتن متن، برنامه‌نویسی، خواندن تصویر و سند، جست‌وجوی معنایی و مرتب‌کردن نتایج جست‌وجو آورده‌ایم. مدل بزرگ‌تر یا مدلی که چندزبانه معرفی شده، لزوماً برای کار شما یا متن فارسی بهتر نیست؛ باید دید در همان کاربرد و زبان چه نتیجه‌ای داشته است.

اطلاعات سخت‌افزاری و نتایج سرعت این راهنما بیشتر به کارت‌های NVIDIA مربوط است. اجرای مدل روی CPU، مک‌های مجهز به Apple Silicon یا کارت‌های AMD به پشتیبانی نرم‌افزار بستگی دارد. برای مقایسهٔ سرعت این گزینه‌ها، هنوز آزمون‌های کافی با شرایط یکسان در اختیار نداریم. کدام نرم‌افزار روی سخت‌افزار شما اجرا می‌شود؟

برای برآورد حافظهٔ لازم، حجم فایل وزن‌های مدل، حافظهٔ موقت مدل (KV cache) و فضای اضافهٔ موردنیاز برای اجرا روی هر دستگاه را در نظر گرفته‌ایم. فرمول معمول KV را برای مدل‌های با معماری ترکیبی، MLA یا معماری نامشخص به کار نبرده‌ایم. جزئیات محاسبه در بخش حافظه آمده است.

آخرین بررسی داده‌ها: · اگر اشتباهی دیدید، به من خبر بدهید

نمای داده‌ای

شناسنامهٔ مدل‌ها

مدل‌های با وزن قابل دریافت: اندازه، معماری، طول متن و مجوز؛ سرویس‌های API در این فهرست نیستند.

آزمونِ ستون نتیجه: MIRACL · nDCG@10 · fa

این انتخاب برای ستون نتیجهٔ همهٔ جدول‌هاست. شرایط اجرا در جزئیات هر مدل آمده است.

دیدن نتایج به تفکیک آزمون ←
۱۴۱ نتیجه از ۱۴۱ ردیف
نسخهٔ قابل دریافت
مسیر راه‌اندازی مستند
خانواده
نوع مدل
مرحلهٔ مدل
اندازهٔ اعلامی مدل(میلیارد)
فیلترهای تخصصی ۱۷ کنترل
ناشر فایل
پارامتر فعال(میلیارد)
ساختار پارامترها
ورودی
خروجی
کاربرد
حداکثر طول متن(token)
وضعیت انتشار
تاریخ انتشار
تاریخ بازبینی
همهٔ ردیف‌ها
مقایسهٔ ردیف‌ها و شرایط آن

قاعدهٔ مقایسه: مشاهدهٔ کنارهم همیشه مجاز است؛ محاسبه فقط برای فیلدهای هم‌واحد و انتساب نسخه‌مند معتبر است.

با × کنار عنوان، ستون را پنهان کنید؛ برای دیدن منابع و شرایط، جزئیات ردیف را باز کنید.

ستون‌های پنهان:
مدل‌های عرضه‌شده از طریق API · ۵

این خدمت‌ها برای استفاده از API فهرست شده‌اند و وارد تخمین حافظه یا پیشنهاد اجرای محلی نمی‌شوند.

GPT-6.1 Sol · gpt-6.1-sol

OpenAI · API · ۱٬۰۵۰٬۰۰۰ توکن زمینه · حداکثر خروجی ۱۲۸٬۰۰۰ · 2026-10-03

ورودی: متن و تصویر ← خروجی: متن · وزن قابل دریافت ندارد · فاین‌تیون پشتیبانی نمی‌شود.

ابزارهای Responses API: MCP · computer use · code interpreter · file search · web search

تعرفهٔ استاندارد هر یک میلیون توکن؛ ورودی / ورودی کش‌شده / نوشتن کش / خروجی: $2 / $0.1 / $2.5 / $10

اگر ورودی درخواست از ۲۷۲٬۰۰۰ توکن بیشتر شود، نرخ کل همان درخواست به‌ترتیب $4 / $0.2 / $5 / $15. هزینهٔ ابزارها جداست؛ کیفیت فارسی و ادعاهای عملکرد نیازمند آزمون مستقل‌اند.

منبع رسمی و وضعیت عرضه ↗
جدول شناسنامهٔ مدل‌های زبانی
مقایسهجزئیات
ورودی ← خروجی
کاربردهای شاخص
مجوز
دریافت و اجرای مدل
صفحهٔ رسمی ↗
BGE · BAAI حدود ۰٫۵۶۹ میلیارد · متراکم متن ← بردار ۸٬۱۹۲ توکن بازیابی ترکیبی سند در RAG MIT ↗
PYTORCH · رسمی ↗GGUF · ثالث ↗ONNX · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
BGE · BAAI حدود ۰٫۵۶۸ میلیارد · متراکم متن ← دادهٔ ساختاریافته ۸٬۱۹۲ توکن مرتب‌کردن دوبارهٔ اسناد بازیابی‌شده Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Aya / Cohere · Cohere Labs حدود ۳۲ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن نگارش و گفت‌وگوی چندزبانه با اسناد بلند CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Aya / Cohere · Cohere Labs حدود ۸ میلیارد · متراکم متن ← متن ۸٬۱۹۲ توکن دستیار نوشتن و بازنویسی چندزبانه CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Aya / Cohere · Cohere Labs حدود ۳٫۳۵ میلیارد · متراکم متن ← متن ۸٬۱۹۲ توکن گفت‌وگوی محلی در زبان‌های گوناگون CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
SmolLM · Hugging Face حدود ۱٫۷ میلیارد · متراکم متن ← متن ۸٬۱۹۲ توکن نمونه‌سازی دستیار کوچک با فراخوانی تابع Apache-2.0 ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
SmolLM · Hugging Face حدود ۰٫۱۳۵ میلیارد · متراکم متن ← متن ۸٬۱۹۲ توکن آزمایش پیروی از دستور با مدل بسیار کوچک Apache-2.0 ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
SmolLM · Hugging Face حدود ۰٫۳۶ میلیارد · متراکم متن ← متن ۸٬۱۹۲ توکن بازنویسی و خلاصه‌سازی متن کوتاه Apache-2.0 ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
SmolLM · Hugging Face حدود ۳ میلیارد · متراکم متن ← متن ۶۵٬۵۳۶ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN و افزایش max_position_embeddings دستیار کوچک با انتخاب حالت فکرکردن Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۰٫۶ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن نمونه‌سازی گفت‌وگو با کوچک‌ترین Qwen3 Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۱٫۷ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن دستیار متنی کوچک با کنترل استدلال Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗SAFETENSORS · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۱۴٫۸ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN تولید و تحلیل متن با Qwen3 متراکم Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۳۰٫۵ میلیارد · ۳٫۳ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN دستیار ابزارمحور با معماری MoE Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۳۲٫۸ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN تحلیل چندمرحله‌ای با نسخهٔ متراکم بزرگ Qwen3 Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۴ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN دستیار عمومی در اندازهٔ چهار میلیارد Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۸٫۲ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN گفت‌وگو و کار با متن با کنترل فکرکردن Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۳۰٫۵ میلیارد · ۳٫۳ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۲۶۲٬۱۴۴ توکن تا ۱٬۰۴۸٬۵۷۶ توکن با تنظیم YaRN اصلاح مخزن کد با دستیار ابزارمحور Apache-2.0 ↗
SAFETENSORS · رسمی ↗SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۰٫۶ میلیارد · متراکم متن ← بردار ۳۲٬۷۶۸ توکن بازیابی برداری با کوچک‌ترین Qwen3 Embedding Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۴ میلیارد · متراکم متن ← بردار ۳۲٬۷۶۸ توکن نمایه‌سازی چندزبانه با بردار قابل تنظیم Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۸ میلیارد · متراکم متن ← بردار ۳۲٬۷۶۸ توکن بازیابی سند با بزرگ‌ترین Qwen3 Embedding فهرست Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۰٫۶ میلیارد · متراکم متن ← دادهٔ ساختاریافته ۳۲٬۷۶۸ توکن بازرتبه‌بندی سبک‌تر در خانوادهٔ Qwen3 Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۴ میلیارد · متراکم متن ← دادهٔ ساختاریافته ۳۲٬۷۶۸ توکن بازرتبه‌بندی دستورپذیر اسناد نامزد Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۸ میلیارد · متراکم متن ← دادهٔ ساختاریافته ۳۲٬۷۶۸ توکن بازرتبه‌بندی با نسخهٔ هشت‌میلیاردی Qwen3 Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۸ میلیارد اسمی · متراکم شمار کل تأیید نشده متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن خواندن تصویر و سند با Qwen3-VL Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۲ میلیارد · حدود ۲ میلیارد جزء زبانی · متراکم · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن نمونه‌سازی چندوجهی با Qwen3.5 کوچک Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۳۵ میلیارد · ۳ میلیارد فعال · حدود ۳۵ میلیارد جزء زبانی · ترکیب متخصصان (MoE) · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با افزایش زمینه با YaRN عامل چندوجهی با Qwen3.5 از نوع MoE Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۴ میلیارد · حدود ۴ میلیارد جزء زبانی · متراکم · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با افزایش زمینه با YaRN پردازش متن و تصویر در اندازهٔ چهار میلیارد Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۹ میلیارد · حدود ۹ میلیارد جزء زبانی · متراکم · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با افزایش زمینه با YaRN دستیار اسناد و تصویر با Qwen3.5 متراکم Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۲۷ میلیارد · حدود ۲۷ میلیارد جزء زبانی · ترکیبی · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن تا ۱٬۰۰۰٬۰۰۰ توکن با افزایش زمینه با YaRN گردش‌کار طولانی با عامل متن–تصویر Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
OLMo · Allen Institute for AI حدود ۷ میلیارد · متراکم متن ← متن ۶۵٬۵۳۶ توکن پژوهش دستورپذیری با مسیر آموزش قابل بررسی Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
DeepSeek · DeepSeek حدود ۸ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن آزمایش استدلال تقطیرشده از R1-0528 MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
DeepSeek · DeepSeek حدود ۷۰ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن استدلال تقطیرشده روی پایهٔ Llama 70B MIT + underlying Llama 3.3 terms ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
DeepSeek · DeepSeek حدود ۱٫۵ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن آزمایش مرز استدلال در مدل تقطیری بسیار کوچک MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
DeepSeek · DeepSeek حدود ۱۴ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن حل مسئله با تقطیر R1 در اندازهٔ میانی MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
DeepSeek · DeepSeek حدود ۳۲ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن تحلیل و کدنویسی با تقطیر متراکم ۳۲میلیاردی MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
DeepSeek · DeepSeek حدود ۷ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن حل مسئله با نسخهٔ هفت‌میلیاردی تقطیر R1 MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
DeepSeek · DeepSeek ۶۸۵٫۳۹۷ میلیارد عنصر در فایل وزن · ترکیب متخصصان (MoE) شمار ذخیره‌شده در checkpoint؛ شامل مؤلفه‌های اضافی، نه شمار فعال در تولید هر توکن. متن ← متن ۱۶۳٬۸۴۰ توکن پیوند استدلال و ابزار در گردش‌کار عامل MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
DeepSeek · DeepSeek ۸ میلیارد فعال هنگام prefill · ۱۶ میلیارد فعال هنگام decode · حدود ۵۵۲ میلیارد بدنهٔ اصلی · حدود ۱۹۶ میلیارد حافظهٔ شرطی Engram · ترکیب متخصصان (MoE) · توجه ترکیبی شمار کل تأیید نشده متن، تصویر ← متن ۱٬۰۰۰٬۰۰۰ توکن عامل چندوجهی برای ورودی‌های بسیار بلند MIT ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Gemma · Google DeepMind حدود ۱۲ میلیارد · متراکم متن، تصویر ← متن ۱۳۱٬۰۷۲ توکن پرسش از تصویر و متن با Gemma 3 میانی gemma ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Gemma · Google DeepMind حدود ۱ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن دستیار متنی کوچک از خانوادهٔ Gemma 3 gemma ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Gemma · Google DeepMind حدود ۲۷ میلیارد · متراکم متن، تصویر ← متن ۱۳۱٬۰۷۲ توکن درک متن و تصویر با بزرگ‌ترین Gemma 3 فهرست gemma ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Gemma · Google DeepMind حدود ۴ میلیارد · متراکم متن، تصویر ← متن ۱۳۱٬۰۷۲ توکن ورود به پردازش تصویر در خانوادهٔ Gemma 3 gemma ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Gemma · Google DeepMind حدود ۲۶ میلیارد اسمی · حدود ۲۵٫۲ میلیارد جزء زبانیِ جدول ناشر · ترکیب متخصصان (MoE) شمار کل تأیید نشده متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن استدلال چندوجهی با Gemma 4 از نوع MoE Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Gemma · Google DeepMind حدود ۲٫۳ میلیارد مؤثر بدون جدول embedding · حدود ۵٫۱ میلیارد جزء زبانی با embedding · حدود ۰٫۳ میلیارد رمزگذار صوت · متراکم شمار کل تأیید نشده متن، تصویر، صوت، ویدیو ← متن ۱۳۱٬۰۷۲ توکن پردازش محلی متن، تصویر و صوت با Gemma 4 کوچک Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Granite · IBM حدود ۲ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن تولید پاسخ از اسناد بازیابی‌شده Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
E5 · intfloat / multilingual E5 authors ۰٫۱۱۸ میلیارد · متراکم متن ← بردار ۵۱۲ توکن بازیابی چندزبانه با بردار کم‌بُعد MIT ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Llama · Meta حدود ۷۰ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن دستیار عمومی با Llama 3.1 بزرگ llama3.1 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Llama · Meta حدود ۸ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن گفت‌وگو و کار با متن با Llama 3.1 هشت‌میلیاردی llama3.1 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Llama · Meta حدود ۱ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن بازنویسی و خلاصه‌سازی محلی با Llama کوچک llama3.2 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Llama · Meta حدود ۳ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن دستیار متنی روی دستگاه با Llama سه‌میلیاردی llama3.2 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Phi · Microsoft حدود ۳٫۸ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن تحلیل و منطق در محیط محدودتر MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Mistral · Mistral AI حدود ۲۴ میلیارد · متراکم متن، تصویر ← متن ۲۶۲٬۱۴۴ توکن عامل ویرایش چندفایلی و جست‌وجوی مخزن Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Mistral · Mistral AI حدود ۳٫۴ میلیارد جزء زبانی · متراکم شمار کل تأیید نشده متن، تصویر ← متن ۲۶۲٬۱۴۴ توکن وزن منتشرشده FP8؛ ظرفیت اجرا به precision و حافظهٔ زمینه وابسته است. دستیار چندوجهی برای استقرار لبه Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Mistral · Mistral AI حدود ۷ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن دستیار متنی با قالب فراخوانی تابع Mistral Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Mistral · Mistral AI حدود ۲۴ میلیارد · متراکم متن، تصویر ← متن ۱۳۱٬۰۷۲ توکن دستیار چندزبانهٔ متن و تصویر Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Nemotron · NVIDIA حدود ۹ میلیارد · ترکیبی · توجه ترکیبی متن ← متن ۱۳۱٬۰۷۲ توکن پاسخ از سند با کنترل بودجهٔ استدلال nvidia-open-model-license ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
gpt-oss · OpenAI حدود ۱۱۷ میلیارد · ۵٫۱ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۱۳۱٬۰۷۲ توکن با تنظیمات YaRN همراه مدل منتشرشده عامل با استدلال قابل تنظیم در نسخهٔ بزرگ gpt-oss Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
gpt-oss · OpenAI حدود ۲۱ میلیارد · ۳٫۶ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۱۳۱٬۰۷۲ توکن با تنظیمات YaRN همراه مدل منتشرشده استدلال محلی با نسخهٔ کوچک‌تر gpt-oss Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
GLM · Z.ai حدود ۳۰ میلیارد · ۳ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۲۰۲٬۷۵۲ توکن عامل برنامه‌نویسی با استدلال حفظ‌شونده MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Kimi · Moonshot AI حدود ۱٬۰۰۰ میلیارد اسمی · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده متن ← متن ۱۳۱٬۰۷۲ توکن عامل متنی برای برنامه‌نویسی و گردش‌کارهای ابزارمحور Modified MIT ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Kimi · Moonshot AI حدود ۱٬۰۰۰ میلیارد اسمی · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده متن ← متن ۲۶۲٬۱۴۴ توکن عامل استدلالی برای زنجیره‌های طولانی ابزار و تحلیل Modified MIT ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Kimi · Moonshot AI حدود ۱٬۰۰۰ میلیارد اسمی · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن عامل چندوجهی برای کدنویسی از طرح تصویری و تحلیل سند Modified MIT ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
MiniMax · MiniMax حدود ۲۳۰ میلیارد اسمی · ۱۰ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده متن ← متن ۱۹۶٬۶۰۸ توکن دستیار توسعه نرم‌افزار و گردش‌کارهای ابزارمحور Modified MIT ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
MiniMax · MiniMax حدود ۲۳۰ میلیارد اسمی · ۱۰ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده متن ← متن ۱۹۶٬۶۰۸ توکن مدل ابزارمحور برای کدنویسی و برنامه‌ریزی چندمرحله‌ای Modified MIT ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۲۳۵ میلیارد · ۲۲ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۲۶۲٬۱۴۴ توکن دستیار بزرگ با پاسخ مستقیم و زمینهٔ بلند Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۴۸۰ میلیارد · ۳۵ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۲۶۲٬۱۴۴ توکن عامل کدنویسی برای مخزنهای بزرگ و چندفایلی Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۲۷ میلیارد · متراکم · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن دستیار چندوجهی برای تحلیل، کد و سند Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۰٫۸ میلیارد · متراکم · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن مدل کوچک برای نمونه‌سازی و تخصصی‌سازی وظیفه Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۱۲۲ میلیارد · ۱۰ میلیارد فعال · ترکیب متخصصان (MoE) متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن مدل چندوجهی MoE برای تحلیل و کار با ابزار Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۳۹۷ میلیارد · ۱۷ میلیارد فعال · ترکیب متخصصان (MoE) متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن دستیار چندوجهی بزرگ برای مسائل پیچیده Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Llama · Meta حدود ۷۰ میلیارد اسمی · متراکم شمار کل تأیید نشده متن ← متن ۱۳۱٬۰۷۲ توکن دستیار متنی چندزبانه برای پاسخ‌گویی و کار سازمانی llama3.3 ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Phi · Microsoft حدود ۱۴ میلیارد اسمی · متراکم شمار کل تأیید نشده متن ← متن ۱۶٬۳۸۴ توکن مدل انگلیسی برای ریاضی، منطق و تولید متن MIT ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
SmolVLM · Hugging Face حدود ۲٫۲ میلیارد اسمی · متراکم شمار کل تأیید نشده متن، تصویر، ویدیو ← متن ۸٬۱۹۲ توکن مدل کوچک برای پرسش از تصویر و ویدئو Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
MiniLM · Sentence Transformers ۰٫۰۲۳ میلیارد · متراکم متن ← بردار ۲۵۶ توکن بردارساز سبک انگلیسی برای جست‌وجو و خوشه‌بندی Apache-2.0 ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
E5 · intfloat / multilingual E5 authors ۰٫۲۷۸ میلیارد · متراکم متن ← بردار ۵۱۲ توکن بردارساز چندزبانه با پیشوند مجزای پرسش و سند MIT ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
E5 · intfloat / multilingual E5 authors ۰٫۵۶ میلیارد · متراکم متن ← بردار ۵۱۲ توکن بردارساز چندزبانه برای جست‌وجوی معنایی MIT ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
BGE · BAAI ۰٫۰۳۳ میلیارد · متراکم متن ← بردار ۵۱۲ توکن بردارساز کوچک انگلیسی برای بازیابی اسناد MIT ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
BGE · BAAI ۰٫۲۷۸ میلیارد · متراکم متن ← دادهٔ ساختاریافته ۵۱۲ توکن بازرتبه‌بند انگلیسی و چینی برای نتایج جست‌وجو MIT ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۷٫۶۱ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن دستیار کدنویسی کوچک برای توضیح و اصلاح کد Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۱۴٫۷ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن دستیار کدنویسی برای تولید، توضیح و رفع خطا Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud حدود ۳۲٫۵ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن دستیار کدنویسی با ظرفیت بیشتر برای مسائل دشوار Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
EmbeddingGemma · Google DeepMind حدود ۰٫۳ میلیارد اسمی · متراکم شمار کل تأیید نشده متن ← بردار ۲٬۰۴۸ توکن بردارساز چندزبانه کوچک برای اجرا روی دستگاه gemma ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Jina · Jina AI حدود ۰٫۵۷ میلیارد اسمی · متراکم شمار کل تأیید نشده متن ← بردار ۸٬۱۹۲ توکن بردارساز چندزبانه با آداپترهای وابسته به وظیفه CC-BY-NC-4.0 ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Jina · Jina AI ۰٫۲۷۸ میلیارد · متراکم متن ← دادهٔ ساختاریافته ۱٬۰۲۴ توکن بازرتبه‌بند چندزبانه برای اسناد بلندتر CC-BY-NC-4.0 ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
Mixedbread · Mixedbread ۰٫۳۳۵ میلیارد · متراکم متن ← بردار ۵۱۲ توکن بردارساز انگلیسی برای بازیابی با دستور پرسش Apache-2.0 ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
Nomic · Nomic AI ۰٫۱۳۷ میلیارد · متراکم متن ← بردار ۸٬۱۹۲ توکن بردارساز انگلیسی با زمینهٔ بلند و ابعاد قابل کاهش Apache-2.0 ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
ModernBERT · Answer.AI / LightOn ۰٫۱۵ میلیارد · متراکم متن ← دادهٔ ساختاریافته ۸٬۱۹۲ توکن رمزگذار پایه برای آموزش دسته‌بندی و استخراج موجودیت Apache-2.0 ↗
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen ۱٫۵۴ میلیارد · متراکم متن ← متن ۳۲٬۷۶۸ توکن تکمیل کد و پرکردن جای خالی apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
StarCoder2 · bigcode ۳ میلیارد · متراکم متن ← متن ۱۶٬۳۸۴ توکن توجه محلی با پنجرهٔ ۴٬۰۹۶ توکنی. تکمیل کد با پنجرهٔ لغزان bigcode-openrail-m ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen ۸۰ میلیارد · ۳ میلیارد فعال · ترکیب متخصصان (MoE) · توجه ترکیبی متن ← متن ۲۶۲٬۱۴۴ توکن عامل برنامه‌نویسی apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
E5 · intfloat ۰٫۵۶ میلیارد · متراکم متن ← بردار ۵۱۲ توکن بازیابی چندزبانه با دستور وظیفه mit ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen ۴ میلیارد · متراکم متن ← متن ۲۶۲٬۱۴۴ توکن دستیار کوچک با پاسخ مستقیم apache-2.0 ↗
SAFETENSORS · رسمی ↗SAFETENSORS · ثالث ↗
صفحهٔ رسمی ↗
Tooka · PartAI ۰٫۱۲۳ میلیارد · متراکم متن ← بردار ۵۱۲ توکن بردارسازی متن فارسی —
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Tooka · PartAI ۰٫۳۵۳ میلیارد · متراکم متن ← بردار ۵۱۲ توکن بردارسازی متن فارسی —
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
ParsBERT · HooshvareLab متراکم شمار پارامتر ثبت نشده متن ← دادهٔ ساختاریافته ۵۱۲ توکن پایهٔ آموزش وظایف فارسی —
PYTORCH · رسمی ↗
صفحهٔ رسمی ↗
Salamandra · BSC-LT ۲٫۲۵۳ میلیارد · متراکم متن ← متن ۸٬۱۹۲ توکن تولید متن به زبان‌های ایبری Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Salamandra · BSC-LT ۷٫۷۶۸ میلیارد · متراکم متن ← متن ۸٬۱۹۲ توکن تولید متن به زبان‌های ایبری Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
MiniCPM · openbmb ۲٫۵۱۷ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن استدلال با مدل کوچک Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
LFM · LiquidAI ۱٫۱۷ میلیارد · ترکیبی متن ← متن ۳۲٬۷۶۸ توکن استخراج اطلاعات روی دستگاه LFM Open License 1.0 ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Granite · ibm-granite ۳٫۶۶ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن استدلال با مدل کوچک Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
GLM · Z.ai ۷۴۴ میلیارد · ۴۰ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۲۰۲٬۷۵۲ توکن کدنویسی و استفاده از ابزار MIT ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
GLM · Z.ai ۷۵۳٫۸۶۴ میلیارد عنصر در فایل وزن · ترکیب متخصصان (MoE) شمار ذخیره‌شده در checkpoint؛ شامل مؤلفه‌های اضافی، نه شمار فعال در تولید هر توکن. متن ← متن ۲۰۲٬۷۵۲ توکن کدنویسی و استفاده از ابزار MIT ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
GLM · Z.ai ۷۵۳٫۳۳ میلیارد عنصر در فایل وزن · ترکیب متخصصان (MoE) شمار ذخیره‌شده در checkpoint؛ شامل مؤلفه‌های اضافی، نه شمار فعال در تولید هر توکن. متن ← متن ۱٬۰۴۸٬۵۷۶ توکن کدنویسی و استفاده از ابزار MIT ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
GLM · Z.ai ترکیب متخصصان (MoE) شمار پارامتر ثبت نشده متن ← متن ۱٬۰۴۸٬۵۷۶ توکن کدنویسی و استفاده از ابزار GLM-5.3 License ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Kimi · Moonshot AI ۱٬۰۰۰ میلیارد · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن کدنویسی و استفاده از ابزار Modified MIT ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Kimi · Moonshot AI ۱٬۰۰۰ میلیارد · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن کدنویسی و استفاده از ابزار Modified MIT ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Kimi · Moonshot AI ۲٬۸۰۰ میلیارد · ۱۰۴ میلیارد فعال · ترکیب متخصصان (MoE) متن، تصویر، ویدیو ← متن ۱٬۰۴۸٬۵۷۶ توکن کدنویسی و استفاده از ابزار Kimi K3 License ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen ۲ میلیارد · متراکم متن، تصویر، ویدیو ← بردار ۳۲٬۷۶۸ توکن بازیابی چندوجهی Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen ۸ میلیارد · متراکم متن، تصویر، ویدیو ← بردار ۳۲٬۷۶۸ توکن بازیابی چندوجهی Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen ۲ میلیارد · متراکم متن، تصویر، ویدیو ← دادهٔ ساختاریافته ۳۲٬۷۶۸ توکن بازرتبه‌بندی چندوجهی Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen ۸ میلیارد · متراکم متن، تصویر، ویدیو ← دادهٔ ساختاریافته ۳۲٬۷۶۸ توکن بازرتبه‌بندی چندوجهی Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud ۲۷٫۷۸۱ میلیارد · حدود ۲۷ میلیارد جزء زبانی؛ شمار گرد‌شدهٔ ناشر · متراکم · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با نیازمند تنظیم YaRN؛ سقف بومی ۲۶۲٬۱۴۴ توکن است. مدل متن و تصویر با توجه ترکیبی Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Qwen · Qwen / Alibaba Cloud ۳۵٫۹۵۲ میلیارد · ۳ میلیارد فعال · حدود ۳۵ میلیارد جزء زبانی؛ شمار گرد‌شدهٔ ناشر · ترکیب متخصصان (MoE) · توجه ترکیبی متن، تصویر، ویدیو ← متن ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با نیازمند تنظیم YaRN؛ سقف بومی ۲۶۲٬۱۴۴ توکن است. مدل متن و تصویر با توجه ترکیبی Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
HY-MT · Tencent ۱٫۸ میلیارد · متراکم متن ← متن — ترجمهٔ تخصصی متن Tencent HY Community License ↗ استفادهٔ تجاری مشروط به مجوز
صفحهٔ رسمی ↗
HY-MT · Tencent ۷ میلیارد · متراکم متن ← متن — ترجمهٔ تخصصی متن Tencent HY Community License ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · رسمی ↗SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
HY-MT · Tencent ۱٫۸ میلیارد · متراکم متن ← متن — ترجمهٔ تخصصی Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
HY-MT · Tencent ۷ میلیارد · متراکم متن ← متن — ترجمهٔ تخصصی Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
HY-MT · Tencent ۳۰ میلیارد · ۳ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن — ترجمهٔ تخصصی Apache-2.0 ↗
SAFETENSORS · رسمی ↗SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Gemma · Google ۴ میلیارد · متراکم متن، تصویر ← متن — ترجمهٔ تخصصی Gemma terms ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Gemma · Google ۱۲ میلیارد · متراکم متن، تصویر ← متن — ترجمهٔ تخصصی Gemma terms ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Gemma · Google ۲۷ میلیارد · متراکم متن، تصویر ← متن — ترجمهٔ تخصصی Gemma terms ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
MADLAD · Google ۳ میلیارد · متراکم متن ← متن — ترجمهٔ تخصصی Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
NLLB · Meta ۰٫۶ میلیارد · متراکم متن ← متن — ترجمهٔ تخصصی CC-BY-NC-4.0 ↗ استفادهٔ تجاری مشروط به مجوز
PYTORCH · رسمی ↗
صفحهٔ رسمی ↗
Qwen-Image · Qwen / Alibaba حدود ۷ میلیارد مولد تصویر DiT · حدود ۸ میلیارد رمزگذار Qwen3-VL · سایر شمار کل تأیید نشده متن، تصویر ← تصویر — ساخت و ویرایش تصویر Qwen Research License — غیرتجاری ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
MiMo · Xiaomi MiMo ۱٬۰۲۰ میلیارد · ۴۲ میلیارد فعال · ترکیب متخصصان (MoE) · توجه ترکیبی متن، تصویر، ویدیو، صوت ← متن ۱٬۰۴۸٬۵۷۶ توکن کدنویسی، عامل‌های نرم‌افزاری و تحلیل متن و تصویر MIT ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
LFM · LiquidAI ۳٫۱۲۳ میلیارد · ترکیبی متن، تصویر ← متن ۳۲٬۷۶۸ توکن مدل هدف برای پاسخ به ورودی تصویر و متن LFM Open License 1.0 ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
LFM · LiquidAI ۰٫۲۷۹ میلیارد · متراکم — — وابسته به LFM2.5-VL-3B؛ تولید پیش‌نویس توکن LFM Open License 1.0 ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
Cohere Embed · Cohere سایر شمار پارامتر ثبت نشده متن، تصویر ← بردار ۱۲۸٬۰۰۰ توکن 128K اعلامی ناشر؛ کیفیت بلندمتن اندازه‌گیری نشده است. فضای برداری مشترک Pro/Fast؛ نمایه‌سازی آفلاین با Pro و query برخط با Fast، با ابعاد و قالب خروجی یکسان. این سازگاری به معنای سازگاری index نسخهٔ Embed 4 نیست. —
صفحهٔ رسمی ↗
Clef · Cloudflare ۲۷ میلیارد · متراکم متن، تصویر ← دادهٔ ساختاریافته — دسته‌بندی، مسیریابی، امتیازدهی و کنترل تصمیم Agent Apache-2.0 ↗
صفحهٔ رسمی ↗
Clef · Cloudflare ۹ میلیارد · متراکم متن، تصویر ← دادهٔ ساختاریافته — دسته‌بندی، مسیریابی، امتیازدهی و کنترل تصمیم Agent Apache-2.0 ↗
صفحهٔ رسمی ↗
North Small Translate · Cohere Labs ۲۱۸ میلیارد · ۲۵ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۳۲٬۷۶۸ توکن حداکثر ۱۶K توکن ورودی و ۱۶K خروجی؛ عدد ۳۲K فقط مجموع دو سقف است و تمام آن ورودی نیست. ترجمهٔ متن؛ وزن‌ها پس از پذیرش شرایط دسترسی قابل دریافت‌اند. CC BY-NC 4.0 ↗ استفادهٔ تجاری مشروط به مجوز
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Bespoke Nimble · Bespoke Labs ۹ میلیارد · متراکم متن ← دادهٔ ساختاریافته ۸٬۱۹۲ توکن به وزن کامل Qwen3.5-9B نیاز دارد؛ فایل ۱۶۵MiB فقط آداپتر است. Apache-2.0 ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
GLM · Z.ai ۳۲۰ میلیارد · ۱۸ میلیارد فعال · ترکیب متخصصان (MoE) · توجه ترکیبی متن، تصویر، ویدیو ← متن — متن و تصویر برای کدنویسی و کارهای عامل‌محور؛ کیفیت فارسی آزموده نشده است. MIT ↗
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
Beam · Reflection ۵۰۱ میلیارد · ۲۳ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن — برنامه‌نویسی، استدلال و Agent؛ کاربردهای اعلام سازنده —
صفحهٔ رسمی ↗
K2 Horizon · IFM ۰٫۹ میلیارد · متراکم متن ← متن ۱۳۱٬۰۷۲ توکن گفت‌وگو، استدلال، کدنویسی و فراخوانی ابزار Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
K2 Horizon · IFM ۳٫۷ میلیارد · متراکم متن ← متن ۵۲۴٬۲۸۸ توکن گفت‌وگو، استدلال، کدنویسی و فراخوانی ابزار Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
K2 Horizon · IFM ۷ میلیارد · متراکم متن ← متن ۵۲۴٬۲۸۸ توکن گفت‌وگو، استدلال، کدنویسی و فراخوانی ابزار Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
K2 Horizon · IFM ۳۲ میلیارد · متراکم متن ← متن ۵۲۴٬۲۸۸ توکن گفت‌وگو، استدلال، کدنویسی و فراخوانی ابزار Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
K2 Horizon · IFM ۳۶ میلیارد · ۴ میلیارد فعال · ترکیب متخصصان (MoE) متن ← متن ۵۲۴٬۲۸۸ توکن گفت‌وگو، استدلال، کدنویسی و فراخوانی ابزار Apache-2.0 ↗
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
EmbeddingGemma · Google DeepMind ۰٫۷۴ میلیارد · حدود ۰٫۲۷ میلیارد بخش متنی؛ قابل بارگذاری مستقل · متراکم · توجه ترکیبی متن، تصویر، ویدیو، صوت ← بردار ۸٬۱۹۲ توکن بازیابی چندوجهی و محلی برای RAG؛ مولد پاسخ نیست Apache-2.0 ↗
SAFETENSORS · رسمی ↗

«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.

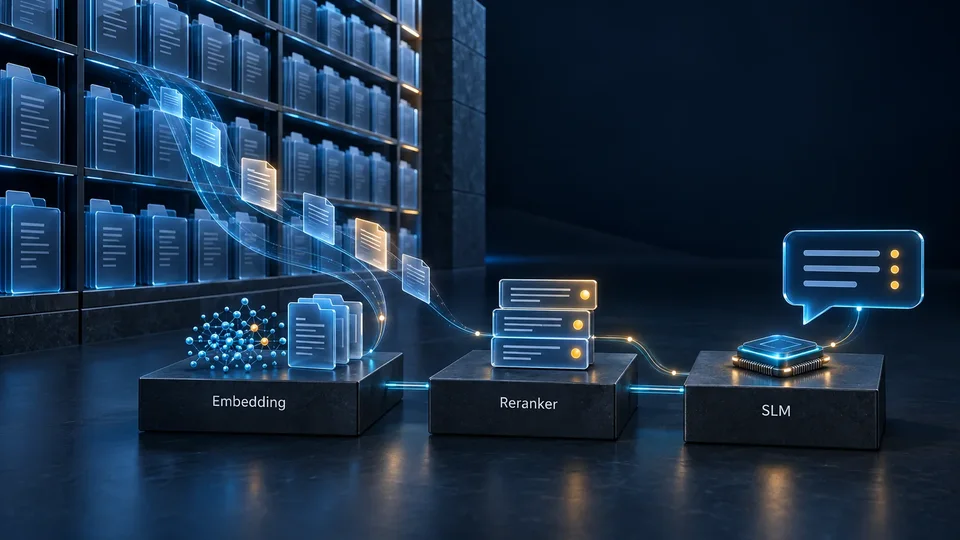
برای RAG، نقش بازیابی، بازرتبه‌بندی و تولید پاسخ را جدا بررسی کنید.
نمای داده‌ای

تناسب مدل با کاربرد

مدل مناسب برای گفت‌وگو، برنامه‌نویسی، جست‌وجو و کار با اسناد.

آزمونِ ستون نتیجه: MIRACL · nDCG@10 · fa

این انتخاب برای ستون نتیجهٔ همهٔ جدول‌هاست. شرایط اجرا در جزئیات هر مدل آمده است.

دیدن نتایج به تفکیک آزمون ←
کدام مدل برای کار من مناسب است؟

نقطهٔ شروع بر پایهٔ مستندات؛ رتبه‌بندی کیفیت نیست.

شروع انتخاب برای بازیابی فارسی

E5 در MIRACL فارسی و Tooka/Jina در PTEB ارزیابی شده‌اند. MIRACL کیفیت بازیابی سند را می‌سنجد؛ PTEB چند وظیفه را پوشش می‌دهد و امتیاز کل آن با نتیجهٔ بازیابی یکسان نیست.

برای جست‌وجوی متن فارسی، با ثبت طول قطعه و پیشوند صحیح هر مدل؛ برای Tooka پرسش با «سوال: » و سند با «متن: » طبق کارت ناشر.

میانگین بالاتر Tooka-Large به معنی بازیابی بهتر از Small نیست.

بازیابی برای اسپانیایی

E5-Small خط پایهٔ کم‌حجم‌تری است؛ Large-Instruct در همین گزارش MIRACL اسپانیایی امتیاز بالاتری دارد. شواهد Qwen در این مقایسه تجمیعی و چندزبانه‌اند، نه مختص اسپانیایی.

پرسش و سند هر دو اسپانیایی باشند؛ بازیابی میان‌زبانی را جداگانه مشخص کنید.

اختلاف 51.2 تا 53.7 شواهدی برای کیفیت پاسخ نهایی چت یا پوشش تمام گونه‌های اسپانیایی نیست.

بازیابی برای انگلیسی

Large و Large-Instruct را گونه‌های مجزا بگیرید: در MIRACL انگلیسی امتیاز Large بالاتر است. برای افزودن reranker، مقایسهٔ Qwen با نامزدهای یکسان قابل استفاده است.

وقتی شواهد تک‌زبانه مهم‌تر از میانگین چندزبانه است.

واژهٔ Instruct تضمین برتری در همهٔ وظایف نیست.

افزودن مرحلهٔ بازچینی

از 0.6B به‌عنوان گزینهٔ کوچک‌تر مقایسه شروع کنید. اگر افزایش کیفیتِ همان وظیفه ارزش هزینهٔ مرحلهٔ دوم را داشت، 4B و 8B را بررسی کنید؛ در همهٔ معیارها 8B جلوتر نیست.

وقتی سند مرتبط در نامزدهای مرحلهٔ اول هست ولی رتبهٔ خوبی ندارد؛ تعداد نامزدها بخشی از تصمیم است.

بازچینی سندی را که بازیاب وارد مجموعه نکرده بازیابی نمی‌کند.

حل مسئله یا ویرایش کد؟

برای دستیار دستورپذیر، معیارهای ویرایش مخزن و حل مسئله را جدا مقایسه کنید. StarCoder2-3B برای تکمیل کد/FIM است؛ HumanEval کیفیت گفت‌وگو یا عامل ویرایشگر را نمی‌سنجد.

وقتی رابط و وظیفه مشخص است: تکمیل داخل ادیتور، اصلاح چند فایل یا حل یک مسئله.

پارامتر فعال MoE مبنای حافظهٔ وزن‌های مقیم نیست.

مدل کوچک برای کار محدود

LFM گزینه‌ای کوچک برای استخراج و گردش‌کار محدود است؛ MiniCPM و Granite برای بررسی استدلال و ابزار نیز شواهد دارند. حجم واقعی وزن‌ها ممکن است با عدد گرد‌شدهٔ نام مدل متفاوت باشد.

وقتی دامنهٔ وظیفه، قالب خروجی و محدودیت حافظه روشن است.

امتیاز بالای یک مدل کوچک، تأخیر کمتر یا توان اجرای زمینهٔ حداکثری روی لپ‌تاپ را ثابت نمی‌کند.

تشخیص نیت و دسته‌بندی

برای دسته‌بندی نیت، شواهد MassiveIntent و MTOP را انتخاب کنید. embedding بخشی از سامانهٔ دسته‌بندی است؛ امتیاز به روش طبقه‌بندی و دادهٔ آموزش آن هم وابسته است.

برای برچسب‌های محدود و مشخص؛ این داده انتخاب نقطهٔ شروع را پشتیبانی می‌کند.

مدل embedding یا ParsBERT بدون سرِ وظیفه، چت‌بات آماده نیست.

aya-expanse-8b

پوشش اعلامی ۲۳ زبان، از جمله فارسی و اسپانیایی؛ زمینهٔ ۸٬۱۹۲ توکن و مجوز عمومی غیرتجاری.

fa: اعلام ناشر
aya-expanse-8b — model card · گزارش ناشر https://huggingface.co/CohereLabs/aya-expanse-8b ↗
ناشر / نویسنده
Cohere Labs
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
README.md: model description / architecture / intended use; matching lines 14, 27, 116, 124, 143
  • اعداد پارامتر معرفی مدل، گرد‌شده‌اند؛ safetensors.total شمار عناصر ذخیره‌شده است و الزاماً پارامتر یکتا نیست.
  • کارت عمومی در تاریخ دسترسی خوانده شده؛ متن کارت به commit وزن‌ها پین نشده است.
aya-expanse-8b — Hub metadata · گزارش ناشر https://huggingface.co/api/models/CohereLabs/aya-expanse-8b?blobs=true ↗
ناشر / نویسنده
Cohere Labs
تاریخ دسترسی
2026-09-15
نسخه / commit
5062468bf9bc0c6035fd64e06274333ec127d980
بخش مرتبط در منبع
$.sha; $.id; $.pipeline_tag; $.cardData; $.safetensors; $.siblings
  • فهرست فایل و شمار tensorها معادل حافظهٔ اجرا یا شمار پارامتر یکتا نیست.
aya-expanse-8b — parameter specification · گزارش ناشر https://huggingface.co/CohereLabs/aya-expanse-8b ↗
ناشر / نویسنده
Cohere Labs
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
README.md: parameter count / named model variant; matching lines 27, 65
  • اعداد پارامتر معرفی مدل، گرد‌شده‌اند؛ safetensors.total شمار عناصر ذخیره‌شده است و الزاماً پارامتر یکتا نیست.
  • کارت عمومی در تاریخ دسترسی خوانده شده؛ متن کارت به commit وزن‌ها پین نشده است.
aya-expanse-8b — license declaration · گزارش ناشر https://huggingface.co/CohereLabs/aya-expanse-8b ↗
ناشر / نویسنده
Cohere Labs
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
README.md: license / underlying-model terms; Hub $.cardData.license; matching lines 1, 23, 167
aya-expanse-8b — context declaration · گزارش ناشر https://huggingface.co/CohereLabs/aya-expanse-8b ↗
ناشر / نویسنده
Cohere Labs
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
README.md: context length / model specification / usage limits; matching lines 128
  • CohereLabs/aya-expanse-8b؛ طول زمینهٔ اعلام‌شده، جدا از مقدار پیکربندی و طول آزموده‌شده.
  • KV cache، توکن تصویر و خروجی تولیدی نیز باید در سناریوی واقعی حساب شوند.
Aya Expanse release · گزارش ناشر https://cohere.com/blog/aya-expanse-connecting-our-world ↗
ناشر / نویسنده
Cohere
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
October 24 2024; 8B and 32B downloadable models
  • تاریخ انتشار گونه‌های نام‌برده؛ تاریخ ساخت مخزن یا برداشت داده نیست.
CohereLabs/aya-expanse-8b — model card · گزارش ناشر https://huggingface.co/CohereLabs/aya-expanse-8b ↗
ناشر / نویسنده
Cohere Labs
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
Description; model details; usage
CohereLabs/aya-expanse-8b — repository metadata · گزارش ناشر https://huggingface.co/api/models/CohereLabs/aya-expanse-8b?blobs=true ↗
ناشر / نویسنده
Cohere Labs
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
cardData; sha; safetensors; siblings
۱۲۳ نتیجه از ۱۲۳ ردیف
کاربرد
اندازهٔ اعلامی مدل(میلیارد)
مبنای پیشنهاد
نقش در سامانه
فیلترهای تخصصی ۳ کنترل
نوع مدل
همهٔ ردیف‌ها
مقایسهٔ ردیف‌ها و شرایط آن

قاعدهٔ مقایسه: محور مدل می‌تواند متفاوت باشد؛ کاربرد، زبان، داده، نسخهٔ آزمون، معیار و واحد باید کنترل یا افشا شوند.

با × کنار عنوان، ستون را پنهان کنید؛ برای دیدن منابع و شرایط، جزئیات ردیف را باز کنید.

ستون‌های پنهان:
جدول راهنمای کاربرد مدل‌ها
مقایسهجزئیات
نقش در سامانه
کاربرد اصلی
ویژگی و دلیل بررسی
شرط مهم استفاده
مبنای پیشنهاد
شروع کار
صفحهٔ رسمی ↗
بازیابی سند بازیابی ترکیبی سند در RAG سه خروجی متراکم، تنک و چندبرداری در یک مدل؛ بیش از ۱۰۰ زبان، ورودی ۸٬۱۹۲ توکن و بردار متراکم ۱٬۰۲۴بُعدی. برای استفادهٔ هم‌زمان از هر سه خروجی، مسیر FlagEmbedding را انتخاب کنید؛ خروجی بستهٔ GGUF یا Ollama به backend بستگی دارد. پیشنهاد تحلیلی راهنما
PYTORCH · رسمی ↗GGUF · ثالث ↗ONNX · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی سند مرتب‌کردن دوبارهٔ اسناد بازیابی‌شده پرسش و سند را با هم می‌خواند و امتیاز ارتباط می‌دهد؛ مکمل مرحلهٔ بازیابی BGE-M3 است. ابتدا تعداد محدودی سند بازیابی کنید؛ امتیاز sigmoid احتمال درستی پاسخ نیست و خروجی مدل، embedding نیست. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته نگارش و گفت‌وگوی چندزبانه با اسناد بلند نسخهٔ ۳۲میلیاردی Aya Expanse با زمینهٔ ۱۳۱٬۰۷۲ توکن؛ فارسی در فهرست ۲۳ زبان ناشر آمده است. دقت پاسخ در ورودی بلند را با پرسش‌هایی از ابتدا، میانه و انتهای سند بسنجید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته دستیار نوشتن و بازنویسی چندزبانه نسخهٔ ۸میلیاردی Aya Expanse، با زمینهٔ ۸٬۱۹۲ توکن و آموزش ترجیحات چندزبانه، برای آزمایش نگارش فارسی نیز قابل بررسی است. نتایج نسخهٔ ۸ میلیاردی را جدا از نسخهٔ ۳۲ میلیاردی مقایسه کنید؛ سقف ورودی این دو یکسان نیست. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی گفت‌وگوی محلی در زبان‌های گوناگون شاخهٔ Global از Tiny Aya برای پوشش عمومی زبان‌ها عرضه شده؛ با نسخه‌های منطقه‌ای Earth،Fire و Water یکی نیست. برای کاربرد فارسی نمونه‌های خود را ارزیابی کنید؛ نسخهٔ منطقه‌ای یا مدل پایه را جایگزین بی‌بررسی این checkpoint نکنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی نمونه‌سازی دستیار کوچک با فراخوانی تابع بزرگ‌ترین نسخهٔ SmolLM2 در این فهرست، علاوه بر پیروی از دستور، قالب فراخوانی تابع دارد؛ این ویژگی به دو نسخهٔ کوچک‌تر تعمیم ندارد. مدل عمدتاً انگلیسی است؛ اجرای تابع را برنامهٔ میزبان انجام می‌دهد و باید آرگومان‌ها را اعتبارسنجی کند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته آزمایش پیروی از دستور با مدل بسیار کوچک نسخهٔ ۱۳۵میلیون‌پارامتری SmolLM2 برای نمونه‌سازی سادهٔ تولید متن و بررسی محدودیت مدل‌های کم‌حجم مناسب است. دامنهٔ کار را به متن کوتاه و وظیفهٔ محدود ببندید؛ از آن انتظار دانش گسترده یا ابزارخوانی نسخهٔ ۱٫۷میلیاردی نداشته باشید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته بازنویسی و خلاصه‌سازی متن کوتاه نسخهٔ ۳۶۰میلیون‌پارامتری SmolLM2 با SFT و DPO برای دستورپذیری تنظیم شده و نمونهٔ اجرای CPU در کارت مدل دارد. تمرکز زبانی انگلیسی است؛ سرعت یا کیفیت فارسی از کوچک‌بودن مدل نتیجه نمی‌شود. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار دستیار کوچک با انتخاب حالت فکرکردن SmolLM3 سه‌میلیاردی دو حالت پاسخ مستقیم و استدلال دارد؛ زمینهٔ آموزش ۶۵٬۵۳۶ توکن است و جزئیات آموزش منتشر شده‌اند. برای زمینهٔ بلندتر تنظیم YaRN لازم است. متن کارت شش زبان بومی از جمله آلمانی را نام می‌برد، اما برچسب‌های مخزن هشت زبان متفاوت دارند؛ فارسی در هیچ‌یک نیست. Transformers نسخهٔ ۴٫۵۳ یا بالاتر لازم است.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار نمونه‌سازی گفت‌وگو با کوچک‌ترین Qwen3 نسخهٔ متراکم ۰٫۶میلیاردی Qwen3 هر دو حالت thinking و non-thinking را دارد؛ فایل رسمی Q8_0 نیز موجود است. بودجهٔ خروجی را محدود کنید؛ توانایی حل مسئلهٔ نسخه‌های بزرگ‌تر از نام مشترک خانواده استنتاج نمی‌شود.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار دستیار متنی کوچک با کنترل استدلال Qwen3-1.7B میان گزینه‌های زیر دو میلیارد پارامتر این فهرست قرار می‌گیرد؛ حالت پاسخ مستقیم را می‌توان از قالب پیام انتخاب کرد. در حالت thinking، توکن‌های استدلال نیز جزو هزینه و طول خروجی‌اند؛ GGUF رسمی این رکورد Q8_0 است.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗SAFETENSORS · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار تولید و تحلیل متن با Qwen3 متراکم Qwen3-14B یک مدل متراکم با دو حالت پاسخ است؛ نسخه‌های رسمی GGUF برای انتخاب دقت وزن در دسترس‌اند. بسته‌های Q4_K_M و Q8_0 در دسترس‌اند؛ سرعت و کیفیت آن‌ها در این راهنما آزموده نشده است.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی دستیار ابزارمحور با معماری MoE Qwen3-30B-A3B از خبرگان انتخابی استفاده می‌کند و از الگوی Qwen-Agent برای اتصال ابزارها بهره می‌برد. شمار پارامتر فعال، جای حجم کل وزن را در برآورد حافظه نمی‌گیرد؛ مدل باید با قالب پیام و parser سازگار اجرا شود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، برنامه‌نویسی، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، فراخوانی ابزار تحلیل چندمرحله‌ای با نسخهٔ متراکم بزرگ Qwen3 Qwen3-32B برخلاف نسخهٔ 30B-A3B معماری متراکم دارد؛ حالت استدلال را می‌توان متناسب با پیچیدگی پرسش تنظیم کرد. برای مقایسهٔ پاسخ مستقیم و thinking، طول خروجی و شرایط یکسان نگه داشته شود؛ این معرفی رتبهٔ کیفیت نیست.، این مدل عمومی است؛ مدل اختصاصی Coder قالب ابزار و آموزش متفاوت دارد.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار دستیار عمومی در اندازهٔ چهار میلیارد Qwen3-4B امکان تغییر حالت thinking را در یک checkpoint ارائه می‌کند؛ GGUF رسمی با چند روش کوانت دارد. زمینهٔ بومی ۳۲٬۷۶۸ توکن است؛ افزایش آن به تنظیمات توسعهٔ زمینه وابسته است.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار گفت‌وگو و کار با متن با کنترل فکرکردن Qwen3-8B مدل عمومی متراکم با ۸٫۲میلیارد پارامتر اعلام‌شده است؛ پاسخ مستقیم و reasoning را در قالب پیام انتخاب می‌کنید. برای شروع محلی، فایل‌های رسمی Q4_K_M و Q8_0 موجودند؛ کیفیت یا حافظهٔ اجرای آن‌ها در این راهنما اندازه‌گیری نشده است.، بازیابی، درج سند و بررسی استنادها بر عهدهٔ سامانه است؛ این رابطه بنچمارک RAG یا فارسی نیست.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
برنامه‌نویسی، فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال اصلاح مخزن کد با دستیار ابزارمحور Qwen3-Coder-30B-A3B-Instruct برای تولید کد، ویرایش مخزن و گردش‌کار عامل برنامه‌نویسی تنظیم شده؛ زمینهٔ بومی ۲۶۲٬۱۴۴ توکن دارد. این نسخه non-thinking است؛ قالب فراخوانی ابزار مخصوص Coder را رعایت کنید و آن را با Qwen3-30B-A3B عمومی یکی نگیرید.، ابزارهای فایل، آزمون و اجرا در برنامهٔ میزبان فراهم می‌شوند.، این checkpoint فقط پاسخ مستقیم تولید می‌کند؛ حالت thinking جداگانه ندارد. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بازیابی برداری با کوچک‌ترین Qwen3 Embedding نسخهٔ ۰٫۶میلیاردی، embedding دستورپذیر با حداکثر ۱٬۰۲۴ بُعد و ورودی ۳۲٬۷۶۸ توکن تولید می‌کند. دستور وظیفه را به query اضافه کنید؛ سندها باید با همان مدل و تنظیم ابعاد نمایه‌سازی شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند نمایه‌سازی چندزبانه با بردار قابل تنظیم Qwen3-Embedding-4B خروجی تا ۲٬۵۶۰ بُعد دارد و برای تطبیق بردار با وظیفه از دستور query استفاده می‌کند. کاهش بُعد نیازمند آزمون کیفیت بازیابی روی مجموعهٔ واقعی شماست؛ عدد MTEB جانشین این آزمون نیست. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بازیابی سند با بزرگ‌ترین Qwen3 Embedding فهرست Qwen3-Embedding-8B تا ۴٬۰۹۶ بُعد و زمینهٔ ۳۲٬۷۶۸ توکن دارد؛ ورودی آن متن و خروجی آن بردار است. هزینهٔ نمایه‌سازی و ذخیرهٔ بردار را جدا از هزینهٔ پاسخ مدل مولد حساب کنید؛ این مدل پاسخ نهایی نمی‌نویسد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی سند بازرتبه‌بندی سبک‌تر در خانوادهٔ Qwen3 نسخهٔ ۰٫۶میلیاردی Qwen3-Reranker برای امتیازدادن به ارتباط query و document با دستور وظیفه تنظیم شده است. قالب مخصوص reranker و امتیاز yes/no لازم است؛ از مسیر chat یا تولید embedding استفاده نکنید.، سازگاری نسخه‌مند llama.cpp: ورودی RANK بزرگ‌تر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیش‌انتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمی‌کند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی سند بازرتبه‌بندی دستورپذیر اسناد نامزد Qwen3-Reranker-4B گزینهٔ میانی این خانواده است؛ پرسش، دستور بازیابی و متن سند در محاسبهٔ ارتباط شرکت دارند. فقط اسناد نامزد را به این مرحله بدهید؛ افزایش تعداد جفت‌های پرسش–سند هزینهٔ مرحلهٔ دوم را بالا می‌برد.، سازگاری نسخه‌مند llama.cpp: ورودی RANK بزرگ‌تر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیش‌انتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمی‌کند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی سند بازرتبه‌بندی با نسخهٔ هشت‌میلیاردی Qwen3 Qwen3-Reranker-8B بزرگ‌ترین بازرتبه‌بند این مجموعه است؛ به جفت پرسش و سند امتیاز ارتباط می‌دهد. برای انتخاب در برابر نسخهٔ ۴میلیاردی، کیفیت جست‌وجو و زمان روی اسناد خودتان را بسنجید؛ از اندازه رتبه نسازید.، سازگاری نسخه‌مند llama.cpp: ورودی RANK بزرگ‌تر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیش‌انتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمی‌کند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی خواندن تصویر و سند با Qwen3-VL نسخهٔ Instruct هشت‌میلیاردی Qwen3-VL ورودی متن، تصویر و ویدئو را برای درک بصری و کار با سند ترکیب می‌کند. از processor و قالب پیام چندوجهی استفاده کنید؛ checkpointهای Thinking و Instruct رفتار یکسان ندارند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار نمونه‌سازی چندوجهی با Qwen3.5 کوچک Qwen3.5-2B کوچک برای نمونه‌سازی و تنظیم دقیق وظیفه‌محور معرفی شده؛ ورودی بصری را همراه متن می‌پذیرد. کیفیت نسخه‌های بزرگ‌تر خانواده به این مدل دوملیاردی تعمیم داده نمی‌شود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی عامل چندوجهی با Qwen3.5 از نوع MoE نسخهٔ 35B-A3B از پایهٔ یکپارچهٔ متن و تصویر و معماری ترکیبی بهره می‌برد و برای گردش‌کار چندمرحله‌ای قابل بررسی است. سرویس میزبانی‌شدهٔ Qwen3.5-Flash با ابزارها و زمینهٔ پیش‌فرض متفاوت عرضه می‌شود؛ مشخصات API را به وزن محلی تعمیم ندهید.، تنظیمات چندوجهی و محدودیت تصویر را از راهنمای همین وزن بخوانید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار پردازش متن و تصویر در اندازهٔ چهار میلیارد Qwen3.5-4B از نسل متن–تصویر یکپارچه است؛ برای آزمودن استخراج اطلاعات از سند در اندازه‌ای کوچک‌تر از 9B قابل بررسی است. برای سند اسکن‌شده به مسیر چندوجهی نیاز دارید؛ سقف زمینهٔ متنی، تعداد تصاویر قابل پردازش را تعیین نمی‌کند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار دستیار اسناد و تصویر با Qwen3.5 متراکم نسخهٔ 9B از Qwen3.5 ترکیب متن و تصویر را در معماری متراکم این خانواده عرضه می‌کند. مقایسه با 4B باید بر دادهٔ سند یکسان و تنظیم تصویر یکسان باشد؛ شمار پارامترهای بخش زبان و بینایی را جدا بخوانید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی گردش‌کار طولانی با عامل متن–تصویر Qwen3.8-27B مدل متراکم متن–تصویر با کنترل thinking است؛ تمرکز معرفی آن بر کدنویسی، پژوهش و کارهای چندمرحله‌ای است. قابلیت‌های وعده‌داده‌شدهٔ سرویس ابری، مانند ابزارهای داخلی و زمینهٔ پیش‌فرض، جزء تضمین وزن محلی نیستند.، اندازهٔ تصویر و شیوهٔ نمونه‌برداری فریم‌ها بخشی از شرایط استفاده‌اند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار پژوهش دستورپذیری با مسیر آموزش قابل بررسی Olmo 3 7B Instruct با داده‌های Dolma 3 و Dolci عرضه شده و انتشار جزئیات آموزش، آن را برای پژوهش بازتولیدپذیر متمایز می‌کند. این checkpoint از نوع Instruct است؛ نتایج Olmo Think را به آن نسبت ندهید. Transformers نسخهٔ ۴٫۵۷ یا بالاتر لازم است. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار آزمایش استدلال تقطیرشده از R1-0528 این مدل از پس‌آموزش Qwen3-8B-Base با زنجیره‌های استدلال DeepSeek-R1-0528 به دست آمده؛ با Qwen3-8B معمولی متفاوت است. بنچمارک‌های مدل کامل R1-0528 متعلق به این نسخهٔ هشت‌میلیاردی نیستند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی استدلال تقطیرشده روی پایهٔ Llama 70B این checkpoint مسیر تقطیر R1 را روی پایهٔ Llama اجرا می‌کند و بزرگ‌ترین نسخهٔ تقطیری این فهرست است. حجم وزن و طول زنجیرهٔ فکر را جداگانه برآورد کنید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی آزمایش مرز استدلال در مدل تقطیری بسیار کوچک نسخهٔ ۱٫۵میلیاردی از تقطیر R1 روی Qwen2.5-Math ساخته شده و برای بررسی انتقال رفتار استدلال به مدل کوچک جالب است. پاسخ‌های طولانی ممکن است وارد تکرار شوند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی حل مسئله با تقطیر R1 در اندازهٔ میانی DeepSeek-R1-Distill-Qwen-14B از Qwen2.5-14B و دادهٔ تولیدی R1 استفاده می‌کند؛ وزن آن متعلق به مدل کامل R1 نیست. اعداد گزارش‌شده فقط برای همین نسخه و تنظیمات آزمون معتبرند؛ از مقایسهٔ نامتجانس با پاسخ مستقیم پرهیز کنید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی تحلیل و کدنویسی با تقطیر متراکم ۳۲میلیاردی نسخهٔ Qwen-32B مسیر تقطیر R1 را روی پایهٔ Qwen2.5 دنبال می‌کند. توان استدلال اعلام‌شده، ابزارخوانی یا اجرای کد خودکار نیست؛ ابزار و اعتبارسنجی جواب باید در برنامه فراهم شود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی حل مسئله با نسخهٔ هفت‌میلیاردی تقطیر R1 این مدل از Qwen2.5-Math-7B به‌عنوان پایه استفاده می‌کند؛ با تقطیر جدیدتر R1-0528 روی Qwen3 یکی نیست. قالب و tokenizer همین مخزن را نگه دارید؛ مقایسه با نسخهٔ هشت‌میلیاردی نیازمند آزمون مشترک است.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی پیوند استدلال و ابزار در گردش‌کار عامل DeepSeek-V3.2 توجه تنک DSA و پس‌آموزش عامل‌محور را ترکیب می‌کند؛ قالب چت آن نسبت به نسخه‌های پیشین تغییر کرده است. از قالب و مسیر اجرای مخصوص V3.2 استفاده کنید؛ نتایج نسخهٔ Speciale در پروندهٔ این مدل قابل انتقال نیستند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی عامل چندوجهی برای ورودی‌های بسیار بلند DeepSeek-V4.1-Flash متن و تصویر را در معماری CED پردازش می‌کند؛ شمار پارامتر فعال در prefill و decode متفاوت است. پارامتر فعال را یک عدد ثابت فرض نکنید؛ فشرده‌سازی KV و مسیر اجرای ویژه، بخشی از معماری این نسخه‌اند.، مسیر اجرای ویژهٔ CED را رعایت کنید؛ این رابطه، نتیجهٔ ارزیابی OCR نیست.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی پرسش از تصویر و متن با Gemma 3 میانی Gemma 3 12B IT نسخهٔ دستورپذیر چندوجهی با زمینهٔ ۱۳۱٬۰۷۲ توکن است؛ ورودی تصویر را به پاسخ متنی پیوند می‌دهد. Processor بینایی و قالب Gemma 3 لازم است؛ حداکثر زمینه به معنی کیفیت ثابت فهم سند بلند نیست. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی دستیار متنی کوچک از خانوادهٔ Gemma 3 Gemma 3 1B IT برخلاف نسخه‌های بزرگ‌تر این نسل فقط متن می‌گیرد و زمینهٔ ۳۲٬۷۶۸ توکن دارد. برای تصویر اسکن‌شده ابتدا OCR بیرونی لازم است؛ ویژگی چندوجهی 4B و بالاتر را به این نسخه تعمیم ندهید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی درک متن و تصویر با بزرگ‌ترین Gemma 3 فهرست Gemma 3 27B IT نسخهٔ متراکم بزرگ این نسل با ورودی بصری و پوشش چندزبانه است. برای ورودی تصویری، قالب پیام و پردازشگر Gemma 3 لازم است. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی ورود به پردازش تصویر در خانوادهٔ Gemma 3 Gemma 3 4B IT کوچک‌ترین مدل چندوجهی این نسل در فهرست است؛ برخلاف 1B می‌تواند تصویر را همراه متن بخواند. وزن و processor نسخهٔ 4B را با هم دریافت کنید؛ متن خروجی را برای استخراج دقیق اعداد سند اعتبارسنجی کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار استدلال چندوجهی با Gemma 4 از نوع MoE Gemma 4 26B-A4B مدل خبرگانی با کنترل thinking و زمینهٔ ۲۶۲٬۱۴۴ توکن است؛ با نسخهٔ کوچک E2B معماری یکسانی ندارد. این نسخه ورودی صوت ندارد؛ شمار پارامتر فعال با کل وزن‌های مدل متفاوت است.، مسیر processor تصویر لازم است؛ قابلیت صوت E2B به این مدل تعمیم داده نشده است.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار پردازش محلی متن، تصویر و صوت با Gemma 4 کوچک Gemma 4 E2B برای اجرای روی دستگاه معرفی شده و ورودی صوت را نیز پشتیبانی می‌کند؛ E2B شمار مؤثر است، نه کل وزن‌ها. در محاسبهٔ حافظه از شمار کل و فایل واقعی استفاده کنید؛ مسیر صوت و تصویر به processor متناظر نیاز دارد.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید پاسخ از سند، استخراج ساخت‌یافته، تولید متن، برنامه‌نویسی، فراخوانی ابزار تولید پاسخ از اسناد بازیابی‌شده Granite 3.3 2B Instruct مدل کوچک کسب‌وکارمحور با RAG، خلاصه‌سازی، استخراج متن و حالت تفکر است. سند باید توسط سامانه بازیابی و در پیام درج شود؛ خود مدل جای موتور جست‌وجو نیست و فارسی جزو ۱۲ زبان اعلام‌شده نیست.، خروجی را با schema برنامه اعتبارسنجی کنید؛ قالب دلخواه به‌تنهایی تضمین JSON معتبر نیست. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بازیابی چندزبانه با بردار کم‌بُعد Multilingual E5 Small متن را به بردار ۳۸۴بُعدی تبدیل می‌کند و سقف ورودی آن ۵۱۲ توکن است؛ برای تکه‌های کوتاه سند قابل بررسی است. پیشوندهای query: و passage: حتی برای زبان‌های غیرانگلیسی لازم‌اند؛ متن بلند را پیش از نمایه‌سازی قطعه‌بندی کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار دستیار عمومی با Llama 3.1 بزرگ Llama 3.1 70B Instruct برای گفت‌وگوی چندزبانه و کار با متن با زمینهٔ ۱۳۱٬۰۷۲ توکن عرضه شده است. ورودی این نسخه متن است. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار گفت‌وگو و کار با متن با Llama 3.1 هشت‌میلیاردی نسخهٔ 8B از Llama 3.1 برای دستیار عمومی و پیروی از دستور تنظیم شده و با مدل پایهٔ همان اندازه فرق دارد. قالب پیام و tokenizer نسخهٔ Instruct را حفظ کنید؛ زمینهٔ بلند، کیفیت جواب از سند را تضمین نمی‌کند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار بازنویسی و خلاصه‌سازی محلی با Llama کوچک Llama 3.2 1B Instruct مدل متنی کوچک این نسل است؛ برای کارهای محدود روی متن در دستگاه‌های محلی معرفی شده است. تصویر را مستقیماً نمی‌گیرد؛ مدل‌های Vision خانوادهٔ Llama 3.2 محصول جداگانه‌اند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار دستیار متنی روی دستگاه با Llama سه‌میلیاردی Llama 3.2 3B Instruct برای گفت‌وگو، بازنویسی و خلاصه‌سازی تنظیم شده و از نسخهٔ 1B ظرفیت پارامتری بیشتری دارد. تفاوت کیفیت و زمان را روی کار خود بسنجید؛ هیچ‌یک از دو مدل متنی 1B و 3B ورودی تصویر ندارند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار تحلیل و منطق در محیط محدودتر Phi-4-mini-instruct با تمرکز بر داده‌های استدلالی و پیروی از دستور ساخته شده و زمینهٔ ۱۳۱٬۰۷۲ توکن دارد. این نسخه با mini-reasoning و multimodal-instruct متفاوت است؛ نمونه‌های ریاضی یا منطق را با نام دقیق همین نسخه مقایسه کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
برنامه‌نویسی، فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، درک تصویر عامل ویرایش چندفایلی و جست‌وجوی مخزن Devstral Small 2 برای مهندسی نرم‌افزار و استفاده از ابزار برای بررسی و اصلاح کد ساخته شده؛ این نسل ورودی تصویر نیز دارد. وزن Instruct این مخزن FP8 است؛ قالب Mistral و وابستگی‌های اجرای همین نسخه را رعایت کنید، نه تنظیمات عمومی یک مدل چت.، ابزارهای عامل و قالب Mistral باید با نسخهٔ مدل سازگار باشند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازم‌اند؛ تعداد تصویر، وضوح و فریم‌ها مصرف حافظه را تغییر می‌دهد. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار دستیار چندوجهی برای استقرار لبه Ministral 3 3B Instruct مدل کوچک متن–تصویر این خانواده است؛ بخش زبان ۳٫۴ و رمزگذار تصویر ۰٫۴میلیارد پارامتر دارند. وزن رسمی FP8 است؛ عدد 3B در نام مدل، همهٔ پارامترهای بخش زبان و بینایی را نمی‌شمارد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته دستیار متنی با قالب فراخوانی تابع Mistral Mistral 7B Instruct v0.3 tokenizer نسخهٔ سوم و قابلیت فراخوانی تابع را به این مدل متنی اضافه کرده است. قالب ابزار و tokenizer v3 باید همراه checkpoint باشند؛ ورودی تصویر در این نسخه وجود ندارد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
درک تصویر، استخراج ساخت‌یافته، تولید متن، تولید پاسخ از سند، برنامه‌نویسی، فراخوانی ابزار دستیار چندزبانهٔ متن و تصویر Mistral Small 3.1 24B Instruct پردازش تصویر و زمینهٔ بلند را به نسل Small افزوده؛ فارسی در فهرست زبان‌های ناشر آمده است. برای ابزار و خروجی JSON، قالب و parser متناظر لازم است؛ اعداد مدل Base را با Instruct ترکیب نکنید.، parser و اعتبارسنجی schema را در لایهٔ برنامه تنظیم کنید. پیشنهاد تحلیلی راهنما، کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید پاسخ از سند، تولید متن، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار پاسخ از سند با کنترل بودجهٔ استدلال Nemotron Nano 9B v2 ترکیبی از Mamba-2 و attention است؛ حالت reasoning و بودجهٔ فکرکردن را می‌توان کنترل کرد. سندهای بازیابی‌شده باید از بیرون وارد شوند؛ شش زبان اعلام‌شده شامل فارسی نیستند و backend باید معماری ترکیبی را پشتیبانی کند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال عامل با استدلال قابل تنظیم در نسخهٔ بزرگ gpt-oss gpt-oss-120b مدل MoE با ۱۱۷میلیارد پارامتر کل و ۵٫۱میلیارد فعال است؛ وزن‌های خبرگان با MXFP4 عرضه شده‌اند. قالب harmony برای اجرای درست لازم است؛ ابزار مرورگر یا Python را برنامهٔ میزبان فراهم می‌کند و حافظهٔ ادعایی ناشر آزمون این سایت نیست.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، فراخوانی ابزار استدلال محلی با نسخهٔ کوچک‌تر gpt-oss gpt-oss-20b با ۲۱میلیارد پارامتر کل و ۳٫۶میلیارد فعال برای کاربرد محلی یا تخصصی معرفی شده؛ سه سطح reasoning دارد. قالب harmony و backend سازگار با MXFP4 لازم‌اند؛ نام 20B را جای شمار واقعی وزن‌ها در محاسبات نگذارید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی عامل برنامه‌نویسی با استدلال حفظ‌شونده GLM-4.7-Flash مدل MoE از ردهٔ 30B-A3B است؛ کارت مدل برای کارهای عامل چندمرحله‌ای به حفظ thinking بین نوبت‌ها اشاره می‌کند. مسیرهای vLLM و SGLang به نسخه‌های توسعه‌ای مشخص وابسته‌اند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار عامل متنی برای برنامه‌نویسی و گردش‌کارهای ابزارمحور — — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار عامل استدلالی برای زنجیره‌های طولانی ابزار و تحلیل — برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار، درک تصویر عامل چندوجهی برای کدنویسی از طرح تصویری و تحلیل سند — برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازم‌اند؛ تعداد تصویر، وضوح و فریم‌ها مصرف حافظه را تغییر می‌دهد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار دستیار توسعه نرم‌افزار و گردش‌کارهای ابزارمحور — برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار مدل ابزارمحور برای کدنویسی و برنامه‌ریزی چندمرحله‌ای — برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار دستیار بزرگ با پاسخ مستقیم و زمینهٔ بلند — این checkpoint فقط پاسخ مستقیم تولید می‌کند؛ حالت thinking جداگانه ندارد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار عامل کدنویسی برای مخزنهای بزرگ و چندفایلی — این checkpoint فقط پاسخ مستقیم تولید می‌کند؛ حالت thinking جداگانه ندارد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار، درک تصویر دستیار چندوجهی برای تحلیل، کد و سند — برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازم‌اند؛ تعداد تصویر، وضوح و فریم‌ها مصرف حافظه را تغییر می‌دهد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار، درک تصویر مدل کوچک برای نمونه‌سازی و تخصصی‌سازی وظیفه — برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازم‌اند؛ تعداد تصویر، وضوح و فریم‌ها مصرف حافظه را تغییر می‌دهد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار، درک تصویر مدل چندوجهی MoE برای تحلیل و کار با ابزار — برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازم‌اند؛ تعداد تصویر، وضوح و فریم‌ها مصرف حافظه را تغییر می‌دهد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار، درک تصویر دستیار چندوجهی بزرگ برای مسائل پیچیده — برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکن‌های تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازم‌اند؛ تعداد تصویر، وضوح و فریم‌ها مصرف حافظه را تغییر می‌دهد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی، فراخوانی ابزار دستیار متنی چندزبانه برای پاسخ‌گویی و کار سازمانی — — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی مدل انگلیسی برای ریاضی، منطق و تولید متن — — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، درک تصویر مدل کوچک برای پرسش از تصویر و ویدئو — پردازشگر تصویر و اجزای بینایی همین نسخه لازم‌اند؛ تعداد تصویر، وضوح و فریم‌ها مصرف حافظه را تغییر می‌دهد. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارساز سبک انگلیسی برای جست‌وجو و خوشه‌بندی — میانگین توکن‌ها با attention mask و نرمال‌سازی L2 کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارساز چندزبانه با پیشوند مجزای پرسش و سند — میانگین با mask و L2؛ query: برای پرسش و passage: برای سند کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارساز چندزبانه برای جست‌وجوی معنایی — میانگین با mask و L2؛ query: برای پرسش و passage: برای سند کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارساز کوچک انگلیسی برای بازیابی اسناد — CLS و نرمال‌سازی؛ دستور retrieval فقط روی پرسش کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی سند بازرتبه‌بند انگلیسی و چینی برای نتایج جست‌وجو — Cross-encoder روی زوج پرسش و سند؛ امتیاز ارتباط کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی دستیار کدنویسی کوچک برای توضیح و اصلاح کد — — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی دستیار کدنویسی برای تولید، توضیح و رفع خطا — — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تولید متن، تولید پاسخ از سند، استخراج ساخت‌یافته، برنامه‌نویسی دستیار کدنویسی با ظرفیت بیشتر برای مسائل دشوار — — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارساز چندزبانه کوچک برای اجرا روی دستگاه — بیش از ۱۰۰ زبان؛ کاهش بعد با Matryoshka تا ۱۲۸ بعد کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارساز چندزبانه با آداپترهای وابسته به وظیفه — آداپتر retrieval.query / retrieval.passage؛ میانگین توکن‌ها و L2 کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی سند بازرتبه‌بند چندزبانه برای اسناد بلندتر — بازرتبه‌بندی چندزبانه با ورودی تا ۱۰۲۴ توکن کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارساز انگلیسی برای بازیابی با دستور پرسش — دستور Represent this sentence for searching relevant passages: روی پرسش کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارساز انگلیسی با زمینهٔ بلند و ابعاد قابل کاهش — پیشوند search_query: برای پرسش و search_document: برای سند؛ نرمال‌سازی و کاهش بُعد کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
استخراج ساخت‌یافته رمزگذار پایه برای آموزش دسته‌بندی و استخراج موجودیت — برای اجرای llama.cpp از b11532+ استفاده شود؛ نسخه‌های قدیمی hidden_activation=gelu را با تقریب tanh اجرا می‌کردند. GGUF موجود نیاز به تبدیل دوباره ندارد؛ خروجی buildهای قدیمی باید بازآزمایی شود.، رمزگذار دوسویه؛ خروجی توکن یا هد آموزش‌دیدهٔ وظیفه کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗
صفحهٔ رسمی ↗
تکمیل کد / FIM تکمیل کد و پرکردن جای خالی مدل پایهٔ کدنویسی با حدود ۱٫۵۴ میلیارد پارامتر؛ برای FIM و ادامهٔ کد، نه گفت‌وگوی دستورپذیر. از قالب تکمیل کد / FIM همین مدل استفاده کنید؛ chat template مدل دستورپذیر را جایگزین نکنید. کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تکمیل کد / FIM تکمیل کد با پنجرهٔ لغزان مدل پایهٔ کدنویسی؛ ورودی ۱۶٬۳۸۴ توکنی با پنجرهٔ توجه ۴٬۰۹۶ توکنی. برای تکمیل کد، نه دستیار گفت‌وگو. از قالب تکمیل کد / FIM همین مدل استفاده کنید؛ chat template مدل دستورپذیر را جایگزین نکنید. کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
برنامه‌نویسی عامل برنامه‌نویسی مدل MoE با ۸۰ میلیارد پارامتر و ۳ میلیارد پارامتر فعال، توجه ترکیبی و پاسخ مستقیم؛ حافظهٔ وزن از کل مدل می‌آید. — کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازیابی سند بازیابی چندزبانه با دستور وظیفه بردارساز ۱۰۲۴بعدی؛ دستور یک‌جمله‌ای به پرسش اضافه می‌شود و سند بدون دستور وارد می‌شود. قالب پرسش Instruct: … Query: …؛ سند بدون دستور. masked mean pooling و نرمال‌سازی L2؛ حداکثر ۵۱۲ توکن. کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن دستیار کوچک با پاسخ مستقیم نسخهٔ دستورپذیر چهارمیلیاردی با سقف متن ۲۶۲٬۱۴۴ توکن؛ این checkpoint حالت thinking ندارد. — کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗SAFETENSORS · ثالث ↗
صفحهٔ رسمی ↗
بازیابی سند بردارسازی متن فارسی نسخهٔ کوچک Tooka-SBERT-V2 با بردار ۷۶۸بعدی؛ نامزد بومی برای بازیابی و شباهت متن فارسی. برای Tooka، پرسش با «سوال: » و سند با «متن: » به مدل داده می‌شود. کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازیابی سند بردارسازی متن فارسی نسخهٔ بزرگ Tooka-SBERT-V2 با بردار ۱۰۲۴بعدی؛ نتیجهٔ PTEB با آزمون‌های دیگر قابل رتبه‌بندی مستقیم نیست. برای Tooka، پرسش با «سوال: » و سند با «متن: » به مدل داده می‌شود. کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
استخراج ساخت‌یافته پایهٔ آموزش وظایف فارسی ParsBERT پایه برای درک متن فارسی؛ دسته‌بندی و تشخیص موجودیت به سر وظیفه و آموزش نیاز دارند. بردارساز آمادهٔ بازیابی نیست. وزن پایه به‌تنهایی دسته‌بند یا NER آماده نیست.، برای برچسب‌گذاری، سر طبقه‌بندیِ آموزش‌دیده روی encoder لازم است. کاربرد معرفی‌شده توسط سازنده
PYTORCH · رسمی ↗
صفحهٔ رسمی ↗
تولید متن تولید متن به زبان‌های ایبری گزینهٔ تخصصی‌تر برای زبان اسپانیایی و زبان‌های ایبری؛ گونهٔ 2B دستورپذیر با نتایج منتشرشدهٔ اسپانیایی. نقطهٔ مرجع زبانی است، نه برندهٔ عمومی یا گزینهٔ اثبات‌شده برای فارسی. — کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن تولید متن به زبان‌های ایبری گزینهٔ تخصصی‌تر برای زبان اسپانیایی و زبان‌های ایبری؛ گونهٔ 7B دستورپذیر با نتایج منتشرشدهٔ اسپانیایی. نقطهٔ مرجع زبانی است، نه برندهٔ عمومی یا گزینهٔ اثبات‌شده برای فارسی. — کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
استدلال استدلال با مدل کوچک مدل کوچکِ دستورپذیر برای بررسی در کارهای استدلال و ابزار؛ اندازهٔ واقعی ثبت‌شده حدود ۲٫۵۲ میلیارد پارامتر است. امتیازهای ناشر را از امتیازهای نقل‌شده از Artificial Analysis جدا کنید؛ شاهد فارسی یا اسپانیایی در این بسته ندارد. — کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
استخراج ساخت‌یافته استخراج اطلاعات روی دستگاه گزینهٔ کوچک برای استخراج اطلاعات و کارهای محدود روی دستگاه؛ ناشر آن را برای برنامه‌نویسی و کارهای دانش‌محور توصیه نمی‌کند. اسپانیایی در زبان‌های اعلام‌شده هست؛ نتیجهٔ اختصاصی فارسی ثبت نشده است. — کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
استدلال استدلال با مدل کوچک گونهٔ استدلالی Granite با حالت‌های thinking و non-thinking؛ برچسب 3B نام اندازه است و شمار ثبت‌شدهٔ پارامترها حدود ۳٫۶۶ میلیارد است. حد بومی ۱۲۸K را از ادعای گسترش تا ۵۱۲K جدا نگه دارید. — کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازیابی سند بازیابی چندوجهی بازیابی متن، تصویر و ویدئو با بردارهایی در ابعاد ۶۴ تا 2048؛ ورودی وظیفه تا ۳۲ هزار توکن. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازیابی سند بازیابی چندوجهی بازیابی متن، تصویر و ویدئو با بردارهایی در ابعاد ۶۴ تا 4096؛ ورودی وظیفه تا ۳۲ هزار توکن. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی سند بازرتبه‌بندی چندوجهی امتیازدهی به ارتباط پرسش با متن، تصویر یا ویدئو؛ بازرتبه‌بندی نتایج بازیابی با ورودی تا ۳۲ هزار توکن. سازگاری نسخه‌مند llama.cpp: ورودی RANK بزرگ‌تر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیش‌انتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمی‌کند. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن، درک تصویر، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار مدل متن و تصویر با توجه ترکیبی Qwen3.6-27B متن، تصویر و ویدئو را می‌خواند. وزن رسمی BF16 ثبت شده؛ حافظهٔ اجرای توجه ترکیبی باید با موتور واقعی سنجیده شود. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن، درک تصویر، تولید پاسخ از سند، استخراج ساخت‌یافته، استدلال، برنامه‌نویسی، فراخوانی ابزار مدل متن و تصویر با توجه ترکیبی Qwen3.6-35B-A3B متن، تصویر و ویدئو را می‌خواند. وزن رسمی BF16 ثبت شده؛ حافظهٔ اجرای توجه ترکیبی باید با موتور واقعی سنجیده شود. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی متن مدل تخصصی ترجمه با امکان تعیین معادل اصطلاحات و دادن متن زمینه؛ برای گفت‌وگوی عمومی یا پاسخ‌گویی از اسناد انتخاب نشده است. — پیشنهاد تحلیلی راهنما
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی متن مدل تخصصی ترجمه با امکان تعیین معادل اصطلاحات و دادن متن زمینه؛ برای گفت‌وگوی عمومی یا پاسخ‌گویی از اسناد انتخاب نشده است. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی نسل دوم مترجم Hy-MT با دستورهای ترجمه و حفظ اصطلاحات. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی نسل دوم مترجم Hy-MT با دستورهای ترجمه و حفظ اصطلاحات. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی نسل دوم مترجم Hy-MT با دستورهای ترجمه و حفظ اصطلاحات. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی مترجم متن و نوشته‌های تصویر با ورودی حداکثر ۲هزار توکن؛ قالب ویژهٔ ترجمه دارد. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی مترجم متن و نوشته‌های تصویر با ورودی حداکثر ۲هزار توکن؛ قالب ویژهٔ ترجمه دارد. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی مترجم متن و نوشته‌های تصویر با ورودی حداکثر ۲هزار توکن؛ قالب ویژهٔ ترجمه دارد. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی مترجم مبتنی بر T5 با دامنهٔ زبانی گسترده؛ پیشوند زبان مقصد بخشی از ورودی است. — پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
تولید متن ترجمهٔ تخصصی مدل مرجع پژوهشی ترجمه؛ مجوز غیرتجاری و ورودی آموزشی تا ۵۱۲ توکن دارد. — پیشنهاد تحلیلی راهنما
PYTORCH · رسمی ↗
صفحهٔ رسمی ↗
برنامه‌نویسی کدنویسی، عامل‌های نرم‌افزاری و تحلیل متن و تصویر مدل چندوجهی شیائومی برای کدنویسی، کار با ابزارها و بررسی ورودی‌های طولانی؛ وزن‌های نسخهٔ RL با مجوز MIT منتشر شده‌اند. حدود ۱٫۰۲ تریلیون پارامتر کل و ۴۲ میلیارد فعال؛ فایل‌های وزن ۵۳۴٫۱ GiB هستند. این نسخه برای یک کارت ۲۴ یا ۴۸ گیگابایتی جا نمی‌شود.، امتیاز ۴۶ در شاخص هوش Artificial Analysis نسخهٔ ۴٫۳٫۲ برای سرویس MiMo-V2.6-Pro؛ این نتیجه آزمون فارسی یا آزمون اجرای محلی نسخهٔ RL نیست. پیشنهاد تحلیلی راهنما
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
تولید متن، برنامه‌نویسی، استدلال، فراخوانی ابزار گفت‌وگو، استدلال، کدنویسی و فراخوانی ابزار مدل متنی K2 Horizon با وزن رسمی Safetensors و GGUF؛ اجرای llama.cpp از پیش‌انتشار b11454 ممکن شده است. شاهد ارزیابی فارسی ثبت نشده؛ سرعت و حافظهٔ واقعی این مسیر آزمون نشده‌اند. کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗GGUF · رسمی ↗
صفحهٔ رسمی ↗
بازیابی سند بازیابی چندوجهی و محلی برای RAG؛ مولد پاسخ نیست بردارساز چندوجهی محلی با وزن رسمی Apache-2.0؛ نسل قبلی EmbeddingGemma جدا در جدول می‌ماند. پیش از انتخاب برای RAG متنی فارسی، بازیابی روی پیکرهٔ فارسی را با پرسش‌ها و اسناد یکسان در ۷۶۸ و ۲۵۶ بعد مقایسه کنید؛ کیفیت فارسی و حافظهٔ واقعی نامعلوم‌اند. کاربرد معرفی‌شده توسط سازنده
SAFETENSORS · رسمی ↗

«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.

نمای داده‌ای

امکان اجرا روی سخت‌افزار

حافظهٔ لازم برای وزن‌ها، KV و اجرای مدل با تنظیمات انتخاب‌شده.

محاسبه از مشخصات · زمینه شامل تاریخچه، ورودی و خروجی است. درخواست فعال با تعداد کاربران روزانه تفاوت دارد.

کارت‌های جدول · ۳ آرایش انتخاب شده
مشخصات کارت‌ها در راهنمای GPU ←
روش محاسبه و محدودیت سناریو

حجم واقعی فایل وزن + حافظهٔ KV + ذخیرهٔ اجرایی. برای GGUF، مقدار KV با دقت FP16 محاسبه می‌شود. ذخیرهٔ پیش‌فرض GPU دو GiB برای هر کارت و ذخیرهٔ CPU چهار GiB است؛ این ذخیره فرض برنامه‌ریزی است.

مدل‌های MoE با تمام وزن‌ها محاسبه می‌شوند. ظرفیت اسمی کارت به‌عنوان بودجهٔ GiB استفاده شده؛ برای استقرار دقیق، حافظهٔ آزاد گزارش‌شدهٔ دستگاه ملاک است. مجموع حافظهٔ چند کارت، حافظهٔ یکپارچه نیست.

در مسیر FP32 مدل‌های SmolLM2، وزن و KV هر دو FP32 هستند. سناریوهای بزرگ‌تر از زمینهٔ فایل منتخب نمایش داده نمی‌شوند؛ از جمله Aya Expanse 32B با فایل GGUF منتخب و زمینهٔ حداکثر ۸٬۱۹۲ توکن.

۶۱ نتیجه از ۶۱ ردیف
فیلترهای تخصصی ۱ کنترل
حافظهٔ مورد نیاز(GiB)
همهٔ ردیف‌ها
مقایسهٔ ردیف‌ها و شرایط آن

قاعدهٔ مقایسه: ماتریس سخت‌افزار را داخل یک ردیف هم‌شرط نشان می‌دهد؛ مقایسهٔ ردیف‌ها فقط با کنترل همهٔ شرایط غیرسخت‌افزاری معتبر است.

با × کنار عنوان، ستون را پنهان کنید؛ برای دیدن منابع و شرایط، جزئیات ردیف را باز کنید.

ماتریس امکان اجرای artifact روی پیکربندی سخت‌افزار
مقایسهجزئیات
مدل
نسخهٔ وزن
RTX 4090 24GB
RTX 5090 32GB
RTX 6000 Ada 48GB
صفحهٔ رسمی ↗
Q8_0 ۳٫۴۷ GiB ۰٫۶ GiB ۰٫۸۸ GiB
صفحهٔ رسمی ↗
Q8_0 ۴٫۵۸ GiB ۱٫۷۱ GiB ۰٫۸۸ GiB
صفحهٔ رسمی ↗
Q4_K_M ۵٫۴۵ GiB ۲٫۳۳ GiB ۱٫۱۳ GiB
صفحهٔ رسمی ↗
Q8_0 ۷٫۱۱ GiB ۳٫۹۹ GiB ۱٫۱۳ GiB
صفحهٔ رسمی ↗
Q4_K_M ۷٫۸۱ GiB ۴٫۶۸ GiB ۱٫۱۳ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۱٫۲۴ GiB ۸٫۱۱ GiB ۱٫۱۳ GiB
صفحهٔ رسمی ↗
Q4_K_M ۱۱٫۶۳ GiB ۸٫۳۸ GiB ۱٫۲۵ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۷٫۸۷ GiB ۱۴٫۶۲ GiB ۱٫۲۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۰٫۰۳ GiB ۱۷٫۲۸ GiB ۰٫۷۵ GiB
صفحهٔ رسمی ↗
Q8_0 ۳۳ GiB ۳۰٫۲۵ GiB ۰٫۷۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۲٫۴ GiB ۱۸٫۴ GiB ۲ GiB
صفحهٔ رسمی ↗
Q8_0 ۳۶٫۴۳ GiB ۳۲٫۴۳ GiB ۲ GiB
صفحهٔ رسمی ↗
Q4_K_M ۴۴٫۱ GiB ۳۹٫۶ GiB ۲٫۵ GiB
صفحهٔ رسمی ↗
Q8_0 ۷۴٫۳۳ GiB ۶۹٫۸۳ GiB ۲٫۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۱۱٫۸۷ GiB ۸٫۳۷ GiB ۱٫۵ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۸٫۱۲ GiB ۱۴٫۶۲ GiB ۱٫۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۲٫۴۹ GiB ۱۸٫۴۹ GiB ۲ GiB
صفحهٔ رسمی ↗
Q8_0 ۳۶٫۴۳ GiB ۳۲٫۴۳ GiB ۲ GiB
صفحهٔ رسمی ↗
Q4_K_M ۶٫۸ GiB ۴٫۳۶ GiB ۰٫۴۴ GiB
صفحهٔ رسمی ↗
Q8_0 ۹٫۹۸ GiB ۷٫۵۴ GiB ۰٫۴۴ GiB
صفحهٔ رسمی ↗
Q4_K_M ۴۴٫۱ GiB ۳۹٫۶ GiB ۲٫۵ GiB
صفحهٔ رسمی ↗
Q8_0 ۷۴٫۳۳ GiB ۶۹٫۸۳ GiB ۲٫۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۷٫۵۸ GiB ۴٫۵۸ GiB ۱ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۰٫۹۵ GiB ۷٫۹۵ GiB ۱ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۱٫۶۹ GiB ۱۸٫۴۴ GiB ۱٫۲۵ GiB
صفحهٔ رسمی ↗
Q8_0 ۳۵٫۲۲ GiB ۳۱٫۹۷ GiB ۱٫۲۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۷٫۷۱ GiB ۴٫۷۱ GiB ۱ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۰٫۹۵ GiB ۷٫۹۵ GiB ۱ GiB
صفحهٔ رسمی ↗
Q4_K_M ۴٫۴۸ GiB ۰٫۹۸ GiB ۱٫۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲٫۲۷ GiB ۰٫۱ GiB ۰٫۱۸ GiB
صفحهٔ رسمی ↗
Q8_0 ۲٫۳۱ GiB ۰٫۱۳ GiB ۰٫۱۸ GiB
صفحهٔ رسمی ↗
Q8_0 ۲٫۶۷ GiB ۰٫۳۶ GiB ۰٫۳۱ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۰٫۰۳ GiB ۱۷٫۲۸ GiB ۰٫۷۵ GiB
صفحهٔ رسمی ↗
Q8_0 ۳۳ GiB ۳۰٫۲۵ GiB ۰٫۷۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۷٫۸۱ GiB ۴٫۶۸ GiB ۱٫۱۳ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۱٫۲۴ GiB ۸٫۱۱ GiB ۱٫۱۳ GiB
صفحهٔ رسمی ↗
Q4_K_M ۳٫۲۶ GiB ۱٫۰۴ GiB ۰٫۲۲ GiB
صفحهٔ رسمی ↗
Q8_0 ۳٫۹۸ GiB ۱٫۷۶ GiB ۰٫۲۲ GiB
صفحهٔ رسمی ↗
Q4_K_M ۴٫۰۶ GiB ۱٫۴۴ GiB ۰٫۶۳ GiB
صفحهٔ رسمی ↗
Q8_0 ۵٫۱۳ GiB ۲٫۵۱ GiB ۰٫۶۳ GiB
صفحهٔ رسمی ↗
Q4_K_M ۵٫۳۲ GiB ۲٫۳۲ GiB ۱ GiB
صفحهٔ رسمی ↗
Q8_0 ۶٫۸ GiB ۳٫۸ GiB ۱ GiB
صفحهٔ رسمی ↗
Q4_K_M ۷٫۰۷ GiB ۴٫۰۷ GiB ۱ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۰٫۱۷ GiB ۷٫۱۷ GiB ۱ GiB
صفحهٔ رسمی ↗
Q4_K_M ۱۳۶٫۳۲ GiB ۱۳۲٫۸۵ GiB ۱٫۴۷ GiB
صفحهٔ رسمی ↗
Q8_0 ۲۳۶٫۲۴ GiB ۲۳۲٫۷۷ GiB ۱٫۴۷ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۷۴٫۸ GiB ۲۷۰٫۸۶ GiB ۱٫۹۴ GiB
صفحهٔ رسمی ↗
Q8_0 ۴۷۹٫۲۴ GiB ۴۷۵٫۳ GiB ۱٫۹۴ GiB
صفحهٔ رسمی ↗
Q4_K_M ۱۱٫۹۹ GiB ۸٫۴۳ GiB ۱٫۵۶ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۸٫۰۷ GiB ۱۴٫۵۱ GiB ۱٫۵۶ GiB
صفحهٔ رسمی ↗
Q4_K_M ۶٫۸ GiB ۴٫۳۶ GiB ۰٫۴۴ GiB
صفحهٔ رسمی ↗
Q8_0 ۹٫۹۸ GiB ۷٫۵۴ GiB ۰٫۴۴ GiB
صفحهٔ رسمی ↗
Q4_K_M ۱۱٫۸۷ GiB ۸٫۳۷ GiB ۱٫۵ GiB
صفحهٔ رسمی ↗
Q8_0 ۱۸٫۱۲ GiB ۱۴٫۶۲ GiB ۱٫۵ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۲٫۴۹ GiB ۱۸٫۴۹ GiB ۲ GiB
صفحهٔ رسمی ↗
Q8_0 ۳۶٫۴۳ GiB ۳۲٫۴۳ GiB ۲ GiB
صفحهٔ رسمی ↗
Q4_K_M ۳٫۰۶ GiB ۰٫۶۲ GiB ۰٫۴۴ GiB
صفحهٔ رسمی ↗
Q4_K_M ۶٫۰۶ GiB ۲٫۹۴ GiB ۱٫۱۳ GiB
صفحهٔ رسمی ↗
Q4_K_M ۸٫۳۳ GiB ۵٫۲۱ GiB ۱٫۱۳ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۳٫۶۳ GiB ۱۹٫۶۳ GiB ۲ GiB
صفحهٔ رسمی ↗
Q4_K_M ۲۴٫۳۳ GiB ۲۰٫۸۳ GiB ۱٫۵ GiB

«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.

برای سنجش هم‌زمانی و طول زمینه، مدل و تعداد GPU را در ابزار زیر کنار هم بگذارید. منطق محاسبه و طراحی آزمون خدمت در یادداشت همراه آمده است. ۱۰۰ کاربر هم‌زمان در یک دستیار هوشمند یعنی چه؟

از تعداد کاربر تا بودجهٔ حافظه

این بار روی کدام GPU جا می‌گیرد؟

مدل و بار را انتخاب کنید. اگر GPU مشخص نکرده‌اید، چند نامزد برای آزمون پیشنهاد می‌شود. «جا دارد» در این ابزار، نتیجهٔ برآورد حافظه است؛ تعهد سرعت و کیفیت خدمت به آزمون نیاز دارد.

فرض‌های حافظه و فضای آزاد واقعی

مدل آموزشی: ۸ میلیارد پارامتر، وزن خام BF16، ۳۲ لایه، ۸ سر KV و اندازهٔ سر ۱۲۸. هندسهٔ فعلی: ۳۲ لایه، ۸ سر KV، اندازهٔ سر ۱۲۸.

ذخیرهٔ پیش‌فرض ۲ GiB، فرض برنامه‌ریزی جدول است؛ مقدار اندازه‌گیری‌شده یا سقف سربار نیست. کوانتیده‌بودن وزن به معنی KV کم‌دقت نیست؛ پشتیبانی موتور و اثر دقت کش را جدا بررسی کنید. این تخمین برای توجه کامل است و صرفه‌جویی Prefix Cache، توجه پنجره‌ای، MLA یا معماری هیبریدی را فرض نمی‌کند.

اولین نامزد برای مقایسه: ۱ × GeForce RTX 5090

در برآورد حافظه جا دارد

بودجهٔ پُربارترین GPU۲۴٫۹ GiB
کلاس حافظهٔ هر GPU۳۲ GiB
حاشیهٔ حافظهٔ هر GPU۷٫۱ GiB
سقف نظری درخواست فعال از نظر حافظه۱۵
  • وزن ۱۴٫۹ GiB
  • KV ۸ GiB
  • ذخیره و اجزای دیگر ۲ GiB

برای توزیع متوازن، بیشترین سهم هر GPU برابر ۸ درخواست فرض شده است. وزن مدل در هر GPU دوباره بارگذاری می‌شود؛ صف و توزیع نامتوازن می‌توانند این برآورد را تغییر دهند.

کلاس اسمی حافظهٔ جدول برای غربال اولیه، به‌صورت بودجهٔ GiB استفاده شده است؛ برای استقرار، عدد واقعی حافظهٔ آزاد دستگاه را وارد کنید. سقف نظری بالا، ظرفیت پاسخ‌گویی با تأخیر قابل قبول نیست.

PCIe، وابسته به سازنده · اکتیو · PCIe 5.0

مشخصات سازنده ↗
پیشنهاد GPU برای آزمون

نامزدها از فهرست فعلی GPU سایت می‌آیند و با کمترین تعداد دستگاه و سپس ظرفیت حافظه مرتب شده‌اند. قیمت، سرعت و سازگاری این بسته با هر موتور هنوز باید بررسی شود. اگر افزایش تعداد لازم باشد، همان تعداد پیشنهادی کنار نام کارت آمده است.

  • ۱ × GeForce RTX 5090۳۲ GB در هر GPU · حاشیهٔ برآوردی ۷٫۱ GiB
  • ۱ × RTX 6000 Ada۴۸ GB در هر GPU · حاشیهٔ برآوردی ۲۳٫۱ GiB
  • ۲ × GeForce RTX 4090 D۲۴ GB در هر GPU · حاشیهٔ برآوردی ۳٫۱ GiB

نسخه‌های اعلام‌شده، بردهای غیررسمی، حافظهٔ یکپارچهٔ سامانه‌ها و ظرفیت تجمیعی چند تراشه در پیشنهادها نیستند. برای AMD و Intel، پشتیبانی بسته، کرنل و موتور اجرا را روی همان مدل و سیستم‌عامل بررسی کنید.

بار کاربران و تقاضای توکن را هم ببینید
درخواست کاربر در ثانیه
۰٫۸۳۳
فراخوانی مدل در ثانیه
۰٫۸۳۳
تقاضای ورودی، توکن/ثانیه
۳٬۵۸۳٫۳۳
تقاضای خروجی، توکن/ثانیه
۲۷۵
درخواست کاربر در جریان؛ قانون لیتل
۶٫۶۷

قانون لیتل، در وضعیت پایدار، صف و همهٔ مراحل گردش‌کار را هم می‌شمارد؛ این عدد خودکار به اسلایدر درخواست‌های در حال استنتاج منتقل نمی‌شود. ورودی و خروجی را جدا سنجیده‌ایم و زمان پاسخ فرض‌شده، پیش‌بینی ابزار نیست.

نسبت تقاضا به ظرفیت اندازه‌گیری‌شده: Prefill نیازمند آزمون; Decode نیازمند آزمون.

این دو نسبت فقط غربال اولیه‌اند؛ تداخل مراحل، P95، جهش بار و Goodput باید زیر بار ترکیبی آزموده شوند. ظرفیت اندازه‌گیری‌شدهٔ کل همین چیدمان را وارد کنید؛ ابزار سرعت را با تعداد GPU ضرب نمی‌کند. پس از تغییر مدل، چیدمان یا طول درخواست، عددهای آزمون پاک می‌شوند تا نتیجهٔ همان حالت را وارد کنید.

بخش چهارم · دو نمای مستقل

نرم‌افزارهای اجرا و سرویس‌دهی

نمای داده‌ای

مقایسهٔ نرم‌افزارها

نرم‌افزارهای اجرای محلی و سرویس‌دهی مدل‌ها را مقایسه کنید.

۳۹ نتیجه از ۳۹ ردیف
نوع نیاز
محیط اجرا
نقش نرم‌افزار
فیلترهای تخصصی ۳۶ کنترل
محصول
محلی / ابری
وظیفه‌ها و چندوجهی
صف درخواست
هم‌زمانی
Batching
پذیرش بار
بارگذاری / خروج مدل
چندمدلی
Cold start
Prefix caching
Speculative decoding
CPU/GPU و KV offload
تقسیم مدل روی چند GPU
نسخه‌های مستقل
Streaming
خروجی ساختاریافته
Tool calling
کنترل reasoning
قالب پیام / مدل
Parser
پایش
Metrics
Health check
احراز هویت
محدودیت نرخ
شیوهٔ تأمین قابلیت
وضعیت نگه‌داری
تاریخ انتشار
تاریخ بازبینی
همهٔ ردیف‌ها
مقایسهٔ ردیف‌ها و شرایط آن

قاعدهٔ مقایسه: نسخه‌ها آزادانه کنار هم دیده می‌شوند؛ محور رابط backend را ثابت نگه می‌دارد و محور کل ترکیب اجازهٔ تفاوت backend می‌دهد.

با × کنار عنوان، ستون را پنهان کنید؛ برای دیدن منابع و شرایط، جزئیات ردیف را باز کنید.

ستون‌های پنهان:
جدول مقایسهٔ محصول و نسخهٔ نرم‌افزارهای اجرا و سرویس‌دهی
مقایسهجزئیات
برای چه کاری؟
مزیت کاربردی
شرط انتخاب
شروع کار
Ollama · v0.40.2 · پایدار / Latest
موتور / کتابخانهٔ استنتاج، سرور API، مدیر مدل شروع محلی، توسعه و سرویس کوچک دریافت و مدیریت مدل و راه‌اندازی API در یک ابزار اجرای محلی و ابری جدا هستند؛ OLLAMA_NO_CLOUD=1 مسیرهای ابری را غیرفعال می‌کند. Ollama v0.40.2 پایدار / Latest: روی Apple Silicon فقط معماری‌های تأییدشده به‌طور پیش‌فرض با MLX اجرا می‌شوند: Qwen3.8، Qwen3.6، Qwen3.5، Gemma 4، Nimble، Tev1، Clef، Clef Flash و EmbeddingGemma 2. این رفتار به همهٔ مدل‌ها، اندازه‌ها، کوانتیزه‌ها، ورودی‌ها یا سیستم‌عامل‌ها تعمیم داده نشود؛ تگ و فایل سازگار هر مسیر جداگانه بررسی شود. مدل‌های تصمیم فقط خروجی نوع‌دار دارند و برای chat، tools یا thinking نیستند. کیفیت فارسی، سرعت و حافظهٔ واقعی این مسیر آزمون نشده‌اند. در نخستین اجرای هر مدل قدیمی، مهاجرت در پس‌زمینه انجام می‌شود و نسخهٔ اصلی موقتاً روی دیسک می‌ماند. پیش از ارتقا فضای آزاد دیسک را بررسی کنید؛ حذف خودکار پشتیبان‌ها برای انتشار بعدی وعده داده شده است. شرط Windows/Clef Flash یعنی v0.40.1+ حفظ می‌شود. راهنمای شروع ↗
Ollama · v0.40.0
موتور / کتابخانهٔ استنتاج، سرور API، مدیر مدل دریافت، مدیریت و اجرای محلی مدل‌ها با API تولید متن، ساخت embedding، خروجی جریانی، خروجی ساختاریافته Ollama v0.40.0 پایدار؛ نسخهٔ تاریخی: روی Apple Silicon فقط معماری‌های تأییدشده به‌طور پیش‌فرض با MLX اجرا می‌شوند: Qwen3.8، Qwen3.6، Qwen3.5، Gemma 4، Nimble، Tev1، Clef، Clef Flash و EmbeddingGemma 2. این رفتار به همهٔ مدل‌ها، اندازه‌ها، کوانتیزه‌ها، ورودی‌ها یا سیستم‌عامل‌ها تعمیم داده نشود؛ تگ و فایل سازگار هر مسیر جداگانه بررسی شود. مدل‌های تصمیم فقط خروجی نوع‌دار دارند و برای chat، tools یا thinking نیستند. کیفیت فارسی، سرعت و حافظهٔ واقعی این مسیر آزمون نشده‌اند. Ollama v0.40.0 پایدار؛ نسخهٔ تاریخی: روی Apple Silicon فقط معماری‌های تأییدشده به‌طور پیش‌فرض با MLX اجرا می‌شوند: Qwen3.8، Qwen3.6، Qwen3.5، Gemma 4، Nimble، Tev1، Clef، Clef Flash و EmbeddingGemma 2. این رفتار به همهٔ مدل‌ها، اندازه‌ها، کوانتیزه‌ها، ورودی‌ها یا سیستم‌عامل‌ها تعمیم داده نشود؛ تگ و فایل سازگار هر مسیر جداگانه بررسی شود. مدل‌های تصمیم فقط خروجی نوع‌دار دارند و برای chat، tools یا thinking نیستند. کیفیت فارسی، سرعت و حافظهٔ واقعی این مسیر آزمون نشده‌اند. راهنمای شروع ↗
vLLM · v0.29.0
موتور / کتابخانهٔ استنتاج، سرور API API مدل زبانی با درخواست‌های هم‌زمان continuous batching و مدیریت KV cache؛ API سازگار با OpenAI نسخهٔ تاریخی؛ برای GGUF، افزونهٔ vllm-gguf-plugin جدا نصب می‌شود؛ پشتیبانی این قالب آزمایشی است. GHSA-x6mc-67gf-chw4: آسیب‌پذیری مشروط در 0.24.0 تا پیش از 0.30.0؛ frontend پایتون با sampler ویدئویی Qwen2-VL/Qwen3-VL و ورودی media_io_kwargs.video.max_frames و fps می‌تواند دچار DoS حافظه شود؛ انتخاب sampler از درخواست نیز ممکن است. --limit-mm-per-prompt تعداد اقلام را محدود می‌کند، نه فریم‌ها؛ در نسخه‌های متأثر --api-key به‌تنهایی /tokenize و /invocations را محافظت نمی‌کند. Rust frontend این ورودی را رد می‌کند و فقط از همین مورد متأثر نیست. ارتقا به 0.30.0 رفع اعلام‌شده است؛ احراز هویت در gateway و محدودیت منابع کنترل تکمیلی‌اند. GHSA-85xf-c7hm-whqw: خروجی ساختاریافتهٔ معیوب ممکن است EngineCore مشترک را متوقف کند؛ دامنهٔ اعلام‌شده <0.30.0 است، اما گزارش آزمایش را روی 0.25.1 تأیید می‌کند و حد پایین را مشخص نکرده است. GHSA-5fj9-pfhr-6j48: فقط Rust frontend فعال، پیش از 0.30.0؛ methodهای دلخواه HTTP در برچسب‌های Prometheus رشد حافظه می‌سازند، حتی پاسخ 405 روی /tokenize. GHSA-58v5-2m8f-94pr: از 0.23.0rc2 تا پیش از 0.30.0؛ مدل ویدئوپذیر با media_io_kwargs و انتخاب GLMGA می‌تواند پیش از decode مصرف CPU/حافظه را بالا ببرد؛ با API key فعال به کلید معتبر نیاز دارد. هر سه مورد آخر نیز طبق هشدار در 0.30.0 رفع شده‌اند. راهنمای شروع ↗
SGLang · v0.5.20
موتور / کتابخانهٔ استنتاج، سرور API سرویس‌دهی مدل زبانی و چندرسانه‌ای روی یک GPU یا خوشه تولید متن، بسته‌بندی پیوستهٔ درخواست‌ها، کش پیشوند، خروجی ساختاریافته انتخاب parser ابزار و کرنل کوانت به معماری مدل وابسته است. از 0.5.20 بسته و ایمیج CUDA 12 منتشر نمی‌شود؛ 0.5.19 آخرین نسخهٔ این مسیر است و ایمیج‌های قبلی باقی‌اند. ذخیرهٔ Responses پیش‌فرض غیرفعال است؛ بازیابی پاسخ، previous_response_id و درخواست پس‌زمینه به --enable-response-store نیاز دارند. در استقرار با جداسازی پردازش ورودی و تولید خروجی (PD)، این گزینه قابل فعال‌سازی نیست. انتخاب parser ابزار و کرنل کوانت به معماری مدل وابسته است. از 0.5.20 بسته و ایمیج CUDA 12 منتشر نمی‌شود؛ 0.5.19 آخرین نسخهٔ این مسیر است و ایمیج‌های قبلی باقی‌اند. ذخیرهٔ Responses پیش‌فرض غیرفعال است؛ بازیابی پاسخ، previous_response_id و درخواست پس‌زمینه به --enable-response-store نیاز دارند. در استقرار با جداسازی پردازش ورودی و تولید خروجی (PD)، این گزینه قابل فعال‌سازی نیست. راهنمای شروع ↗
SGLang · v0.5.19
موتور / کتابخانهٔ استنتاج، سرور API سرویس چندکاربره و بار دارای پیشوند مشترک batching و prefix caching؛ تنظیم برای نوع بار پشتیبانی parser ابزار و کرنل کوانت به معماری مدل وابسته است؛ نسخه و تنظیمات هر ردیف بنچمارک را کنار نتیجه ببینید. راهنمای شروع ↗
llama.cpp / llama-server · v0.4.1
موتور / کتابخانهٔ استنتاج، سرور API GGUF روی CPU، GPU و ترکیب RAM/VRAM کنترل کوانتیزاسیون، تقسیم لایه‌ها و اجرای CPU نسخهٔ تاریخی v0.4.1؛ برای RPC، major 6 آن را با major 7 در v0.5.0 مخلوط نکنید. اجرای جزئی روی CPU با بارگذاری لایه‌ای AirLLM یک روش واحد نیست. راهنمای شروع ↗
TensorRT-LLM · v1.2.1
موتور / کتابخانهٔ استنتاج، سرور API استقرار تخصصی روی GPUهای NVIDIA بهینه‌سازی مدل، کرنل و اجرای سرویس مسیر پشتیبانی و تنظیمات برای هر نسخه و معماری متفاوت است. راهنمای شروع ↗
Triton Inference Server · v2.73.0
سرور API، مدیر استقرار میزبانی چند مدل و چند framework از طریق سرویس مشترک TensorRT / PyTorch / ONNX / OpenVINO / Python و backendهای دیگر انتشار 26.09 پشتیبانی اولیهٔ Rubin دارد؛ کانتینر اختصاصی TensorRT-LLM backend همراه آن نیست. backend و تصویر مناسب را جدا انتخاب کنید. راهنمای شروع ↗
Triton Inference Server · v2.72.0
سرور API، مدیر استقرار مدیریت سرویس مدل‌ها و pipelineهای inference مدیریت مدل، زمان‌بندی و اتصال backendهای تخصصی انتشار ۲٫۷۲٫۰ کانتینر backendِ TensorRT-LLM را همراه ندارد. راهنمای شروع ↗
Text Embeddings Inference (TEI) · v1.9.4
موتور / کتابخانهٔ استنتاج، سرور API سرویس embedding، reranking و دسته‌بندی متن Candle / cuBLASLt / ONNX؛ Metal برای Mac طبق مدل پشتیبانی ARM64 و SM121 برای GB10 و مسیر اولیهٔ AMD/ROCm اضافه شده است؛ این اعلام به معنی تأیید همهٔ GPUهای AMD نیست. نوع وظیفه و pooling به مدل بستگی دارد. راهنمای شروع ↗
Text Embeddings Inference (TEI) · v1.9.3
موتور / کتابخانهٔ استنتاج، سرور API سرویس بردارسازی اسناد و پرسش‌ها batching و API برای embedding؛ imageهای CPU و GPU پشتیبانی reranking برای همهٔ معماری‌ها از پشتیبانی embedding نتیجه نمی‌شود. راهنمای شروع ↗
AirLLM · v4.0.0
موتور / کتابخانهٔ استنتاج امکان اجرای مدل بزرگ با VRAM کم بارگذاری و تخلیهٔ لایه‌ها با تکیه بر میزبان و دیسک هدف اصلی کاهش حافظهٔ GPU است؛ برای چت هم‌زمان از بنچمارک همان بار استفاده کنید. راهنمای شروع ↗
Transformers · v5.18.0
موتور / کتابخانهٔ استنتاج، سرور API بارگذاری مدل و ساخت گردش‌کار استنتاج در Python PyTorch و کلاس‌های مدل Transformers؛ serve طبق نسخه مدل‌های تازه و اصلاحات GGUF در ۵٫۱۸ ثبت شده‌اند؛ سازگاری GPT-OSS/ROCm و قابلیت سرویس را با نسخهٔ backend و مدل دقیق بررسی کنید. راهنمای شروع ↗
Transformers · v5.17.0
موتور / کتابخانهٔ استنتاج، سرور API پژوهش، کنترل مستقیم مدل و مسیرهای سفارشی دسترسی مستقیم به مدل و منطق پردازش سرعت یک مسیر سادهٔ Transformers نمایندهٔ همهٔ موتورهای همان مدل نیست. راهنمای شروع ↗
LiteLLM · v1.103.1
درگاه مدل‌ها، سرور API درگاه مشترک برای چند ارائه‌دهنده و سرویس مدل اتصال به API ارائه‌دهندگان و سرورهای مدل نسخهٔ پایدار تازهٔ دروازهٔ API؛ تولید متن در سرویس متصل انجام می‌شود. قابلیت‌ها و مجوز Enterprise را به هستهٔ متن‌باز تعمیم ندهید. راهنمای شروع ↗
LiteLLM · v1.101.0
درگاه مدل‌ها، سرور API مدیریت چند ارائه‌دهنده و backend API مشترک، مسیریابی و مدیریت مصرف توان اجرای وزن مدل از backend می‌آید. راهنمای شروع ↗
Open WebUI · v0.11.4
رابط گفتگو رابط گفتگو برای Ollama و APIهای سازگار Ollama یا سرویس سازگار با OpenAI API تصویر slim مدل‌های محلی و بسیاری از بسته‌ها را حذف کرده است؛ برای نصب آفلاین، embedding، اسناد و گفتار وابستگی‌های خارجی را دوباره بررسی کنید. راهنمای شروع ↗
Open WebUI · v0.11.3
رابط گفتگو پنل گفت‌وگو و کار با backendهای مدل رابط چت برای کاربران و اتصال به موتور اجرا حافظه و سرعت مدل را باید به backend متصل نسبت داد. راهنمای شروع ↗
Text Generation Inference (TGI) · v3.3.7
موتور / کتابخانهٔ استنتاج، سرور API نگه‌داری سرویس تولید متن برای مدل‌های پشتیبانی‌شده تولید متن، تقسیم مدل میان GPUها (مشروط)، خروجی جریانی، بسته‌بندی پیوستهٔ درخواست‌ها مخزن از ۲۱ مارس ۲۰۲۶ آرشیو و فقط‌خواندنی است. مخزن از ۲۱ مارس ۲۰۲۶ آرشیو و فقط‌خواندنی است. راهنمای شروع ↗
LM Studio · 0.4.24 Build 1
رابط گفتگو، مدیر مدل، سرور API دریافت مدل، گفتگو و راه‌اندازی API محلی بارگذاری و تخلیهٔ مدل، خروجی جریانی، خروجی ساختاریافته، درخواست‌های هم‌زمان قابلیت و قالب مدل به runtime انتخاب‌شده وابسته است. قابلیت و قالب مدل به runtime انتخاب‌شده وابسته است. راهنمای شروع ↗
KTransformers · v0.7.1
موتور / کتابخانهٔ استنتاج وقتی ترکیب حافظهٔ میزبان و GPU و پشتیبانی همان مدل، بخشی از طراحی اجراست. اجرای ناهمگون مدل روی CPU و GPU، از جمله مسیرهای بهینه‌شده برای مدل‌های MoE پشتیبانی‌شده. نتیجه به پیکربندی، حافظه و قابلیت پردازنده وابسته است؛ از یک بنچمارک، سرعت عمومی نتیجه نمی‌شود. راهنمای شروع ↗
Sentence Transformers · v6.1.0
موتور / کتابخانهٔ استنتاج وقتی به پیاده‌سازی یا تنظیم بخش بازیابی و ارزیابی مدل‌های تخصصی نیاز دارید. تولید embedding برای جست‌وجوی معنایی و استفاده از CrossEncoder برای امتیازدهی و بازرتبه‌بندی. ورودی چندوجهی و مستندات بهبود یافته‌اند؛ image/audio/video وابستگی اختیاری دارند و ترتیب کلیدهای ورودی می‌تواند embedding یا امتیاز را تغییر دهد. راهنمای شروع ↗
Sentence Transformers · v6.0.1
موتور / کتابخانهٔ استنتاج وقتی به پیاده‌سازی یا تنظیم بخش بازیابی و ارزیابی مدل‌های تخصصی نیاز دارید. تولید embedding برای جست‌وجوی معنایی و استفاده از CrossEncoder برای امتیازدهی و بازرتبه‌بندی. انتخاب کتابخانه، کیفیت مدل در زبان و دادهٔ شما یا وجود یک سرویس آمادهٔ چت را تضمین نمی‌کند. راهنمای شروع ↗
FlagEmbedding · v1.4.2
موتور / کتابخانهٔ استنتاج اجرای خانوادهٔ BGE و بازرتبه‌بندها خروجی‌های dense، sparse و چندبرداری BGE-M3 سه خروجی BGE-M3 مصرف و ساخت نمایهٔ متفاوت دارند؛ فقط dense را نمی‌توان جای هر سه خروجی استفاده کرد. راهنمای شروع ↗
MLX LM · v0.31.3
موتور / کتابخانهٔ استنتاج اجرای محلی و کم‌دقت‌سازی مدل‌های سازگار روی Apple silicon تولید متن (مشروط)، خروجی جریانی (مشروط)، کش پیشوند (مشروط)، تقسیم مدل میان GPUها (مشروط) مسیر مستقیم برای اجرای محلی و کم‌دقت‌سازی مدل‌های سازگار روی Apple silicon. حافظهٔ مشترک را دوباره به‌صورت RAM+VRAM جمع نزنید. شرط macOS 15 در README مربوط به memory wiring مدل‌های بزرگ است، نه حداقل قطعی همهٔ کاربردهای MLX LM. مسیر مستقیم برای اجرای محلی و کم‌دقت‌سازی مدل‌های سازگار روی Apple silicon. حافظهٔ مشترک را دوباره به‌صورت RAM+VRAM جمع نزنید. شرط macOS 15 در README مربوط به memory wiring مدل‌های بزرگ است، نه حداقل قطعی همهٔ کاربردهای MLX LM. راهنمای شروع ↗
vLLM · v0.30.0
موتور / کتابخانهٔ استنتاج، سرور API سرویس‌دهی مدل با vLLM؛ نسخهٔ پایدار 0.30.0 رفع چهار هشدار امنیتی؛ شرایط ارتقا را بخوانید پایدار؛ رفع GHSA-x6mc-67gf-chw4، GHSA-85xf-c7hm-whqw، GHSA-5fj9-pfhr-6j48 و GHSA-58v5-2m8f-94pr طبق هشدارهای رسمی. هنگام ارتقا از 0.29: GPTQ activation ordering مبتنی بر g_idx حذف شده و g_idx نادیده گرفته می‌شود؛ checkpoint وابسته به آن نیاز به بازبینی دارد. در vllm serve معمولی، scale-out با --enable-scale-out فعال می‌شود و VLLM_ENABLE_SCALE_OUT_ENDPOINTS حذف شده؛ launch render و --tokens-only استثنا هستند. بستهٔ پیش‌فرض CUDA 13.0 و بسته/ایمیج جداگانهٔ CUDA 12.9 عرضه شده‌اند؛ سازگاری GPU و درایور با بستهٔ انتخابی بررسی شود. نتایج نسخه‌های قبلی به این نسخه منتقل نشده‌اند. راهنمای شروع ↗
llama.cpp / llama-server · v0.5.0
موتور / کتابخانهٔ استنتاج، سرور API اجرای مدل و llama-server؛ نسخهٔ پایدار 0.5.0 RPC major 7؛ هماهنگی کلاینت و سرورها یادداشت مستقل پیش‌انتشار b11223: chunked prefill برای RANK در بازرتبه‌بندهای علّی Qwen3 و Qwen3-VL، با ورودی بلندتر از physical batch. یادداشت مستقل b11224 (آزمایشی): اصلاح stride و محدودهٔ دسترسی Vulkan برای صحت محاسبه روی viewهای strided؛ بدون ادعای افزایش سرعت. b11240+ · /v1/embeddings · ورودی چندوجهی OpenAI-style · پیش‌انتشار یادداشت مستقل b11279: پشتیبانی اولیه و آزمایشی GLM-5.3-Flash؛ نیازمند اصلاح بعدی #29745 و بازآزمایی. یادداشت مستقل آزمایشی، ۳۰ سپتامبر ۲۰۲۶: b11279 پشتیبانی اولیهٔ GLM-5.3-Flash را اضافه کرد (#27773). پس از ادغام، data race در آزمون CPU/ThreadSanitizer گزارش و اصلاح #29745 جداگانه ادغام شد؛ b11279 شامل این اصلاح بعدی نیست. برای آزمایش، وجود اصلاح را بررسی و صحت خروجی را بازآزمایی کنید. این خبر تأیید پشتیبانی GLM-5.3-BF16، قابلیت نسخهٔ پایدار v0.5.0 یا پیشنهاد پیش‌فرض ویزارد نیست؛ آزمون محلی انجام نشده است. پیش‌انتشار b11262؛ اصلاح صحت محاسبه در CPU. در مسیر AVX512-FP16، انباشت FP16 در dot productهای F16 ممکن بود overflow کند و logits متفاوتی بدهد؛ b11262 انباشت را به FP32 منتقل می‌کند. برای این مسیر، خروجی buildهای قدیمی‌تر را پیش از اتکا روی b11262+ حاوی اصلاح #29545 بازآزمایی کنید. این اصلاح شاهد افزایش سرعت نیست و پیش‌انتشار، انتخاب پیش‌فرض تولیدی نمی‌شود. هشدار صحت محاسبه؛ یادداشت مستقل b11224 — پیش‌انتشار/آزمایشی، ۲۸ سپتامبر ۲۰۲۶: در buildهای قدیمی فاقد اصلاح #28956، برخی مسیرهای Vulkan در mul_mat و mul_mat_id روی viewهای strided از cache یا expertها ممکن است دادهٔ اشتباه بخوانند. نویسندهٔ PR حلقهٔ بی‌پایان decoder در SheetSage2 و خطا در مسیر Qwen3 AR با --no-fa را گزارش کرده است؛ این نتیجه به همهٔ مدل‌ها یا GPUها تعمیم ندارد. برای این workloadها، پیش از اتکا به خروجی، روی b11224+ حاوی اصلاح بازآزمایی و با CPU/CUDA تحت تنظیمات یکسان و رواداری عددی مشخص مقایسه کنید. این اصلاح صحت محاسبه است، نه شاهد افزایش سرعت؛ قابلیت پایدار v0.5.0 یا تأیید آمادگی تولیدی نیز نیست. پیش‌انتشار انتخاب پیش‌فرض تولیدی نمی‌شود. پایدار؛ RPC major از ۶ در v0.4.1 به ۷ رسیده است. major کلاینت و همهٔ سرورها باید برابر باشد و minor سرور از کلاینت بالاتر نباشد؛ هماهنگ‌کردن build دو سمت توصیه می‌شود. v0.4.1 و v0.5.0 را در یک اتصال RPC مخلوط نکنید. قابلیت‌های nightly به این نسخه نسبت داده نشده‌اند. یادداشت جداگانهٔ build آزمایشی b11160، منتشرشده در ۲۴ سپتامبر ۲۰۲۶: Vulkan INT8 coopmat1 برای RDNA3 (از جمله آزمون ناشر روی RDNA3.5) و RDNA4؛ نیازمند build دارای cooperative matrix و پشتیبانی INT8 در درایور/دستگاه، با GGML_VK_DISABLE_COOPMAT غیرفعال‌نشده. قالب‌ها: q4_0، q4_1، q5_0، q5_1، q8_0، q3_k، q4_k، q5_k، q6_k، mxfp4، nvfp4 و iq4_nl. روی RDNA4 مسیر MUL_MAT برای q4_1، q5_1، q4_k، q5_k و nvfp4 فعال نیست؛ nvfp4 در MUL_MAT_ID نیز غیرفعال است. این قابلیت v0.5.0 یا افزایش سرعت همگانی AMD نیست. بازبینی یادداشت Vulkan/INT8 در b11160: آزمون صحت و سپس عملکرد را روی b11224+ حاوی #28956 تکرار کنید؛ نتیجهٔ build قدیمی شاهد قابل‌انتقال به build جدید نیست. یادداشت مستقل پیش‌انتشار b11182، منتشرشده در 2026-09-25، commit e9f824d8c0f011662a742c9d15d4aa18a41e32c0: دقت فعال‌سازی از فرادادهٔ مدل/تنسور پیروی می‌کند. در CUDA روی Blackwell، لایه‌های NVFP4/MXFP4 با سیاست W4A16 می‌توانند W4A8 را به‌جای W4A4 اجرا کنند. GGML_CUDA_MMQ_PREC=auto سیاست فراداده را دنبال می‌کند؛ q4 و q8 override هستند. q4 ممکن است پردازش prompt را سریع‌تر و دقت را کمتر کند و توصیهٔ پیش‌فرض نیست. وزن FP4 به‌معنای فعال‌سازی چهاربیتی نیست. این یادداشت قابلیت پایدار 0.5.0 یا تضمین سرعت و حافظهٔ کارت‌های دیگر نیست. یادداشت نسخه‌مند b11223 — پیش‌انتشار/آزمایشی، منتشرشده در ۲۷ سپتامبر ۲۰۲۶ ساعت ۲۲:۰۳ UTC (۲۸ سپتامبر تهران): llama-server با RANK و attention علّیِ فعال در زمان اجرا می‌تواند ورودی را بین چند physical batch تقسیم کند. قبلاً ورودی بزرگ‌تر از n_ubatch (پیش‌فرض ۵۱۲ توکن) رد می‌شد. cross-encoderهای دوطرفه همچنان باید در یک physical batch جا شوند. این تغییر به‌معنی تکمیل عمومی پشتیبانی چندوجهی /rerank و /embedding نیست. برای این مسیر به b11223+ حاوی اصلاح #28876 نیاز است؛ قابلیت به نسخهٔ پایدار v0.5.0 نسبت داده نمی‌شود و پیش‌انتشار انتخاب پیش‌فرض تولیدی نیست. آمادگی تولیدی و اثر عملکردی به آزمون هم‌شرایط نیاز دارند. یادداشت مستقل b11240، پیش‌انتشار ۲۸ سپتامبر ۲۰۲۶ ساعت ۲۲:۲۶ UTC: API ورودی تایپ‌شدهٔ متن، تصویر، صدا و ویدئو را می‌پذیرد؛ پشتیبانی هر نوع ورودی به مدل وابسته است. هر شیء {"content": [...]} یک embedding می‌سازد؛ bare content array پشتیبانی نمی‌شود و legacy API حفظ شده است. KV prefix reuse برای embedding/rerank غیرفعال است؛ ظرفیت و سرعت باید دوباره سنجیده شود. مسیر Qwen3-VL-Embedding-2B/8B آزمایشی است؛ این یادداشت پشتیبانی چندوجهی Qwen3-VL-Reranker یا کیفیت فارسی را تأیید نمی‌کند و قابلیت نسخهٔ پایدار v0.5.0 نیست. راهنمای شروع ↗
llama.cpp / llama-server · b11262 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ اصلاح صحت محاسبه در CPU با AVX512-FP16 انباشت FP32 در dot productهای F16؛ اصلاح overflow پیش‌انتشار b11262؛ اصلاح صحت محاسبه در CPU. در مسیر AVX512-FP16، انباشت FP16 در dot productهای F16 ممکن بود overflow کند و logits متفاوتی بدهد؛ b11262 انباشت را به FP32 منتقل می‌کند. برای این مسیر، خروجی buildهای قدیمی‌تر را پیش از اتکا روی b11262+ حاوی اصلاح #29545 بازآزمایی کنید. این اصلاح شاهد افزایش سرعت نیست و پیش‌انتشار، انتخاب پیش‌فرض تولیدی نمی‌شود. راهنمای شروع ↗
Ollama · v0.35.1
موتور / کتابخانهٔ استنتاج، سرور API نسخهٔ پایدار؛ تصمیم‌گیری نوع‌دار با /v1/systemone برای Nimble، Tev1، Clef و Clef Flash ورودی متن و تصویر Clef/Clef Flash؛ choice، noul و score؛ قابلیت decision نسخهٔ پایدار v0.35.1: /v1/systemone برای مدل تصمیم سازگار، پرسش‌های choice، noul و score را می‌پذیرد؛ Clef و Clef Flash متن و تصویر را با هم می‌سنجند. CAPABILITY decision باید برای مدل سازگار اعلام شود؛ کلاینت نباید آن را برای chat، tools یا thinking پیشنهاد کند. این API تولید متن آزاد ندارد. یادداشت انتشار فقط به به‌روزرسانی llama.cpp و MLX اشاره می‌کند و سازگاری تفکیکی backendها را تأیید نمی‌کند. برای Nimble و Tev1 نیز فایل Safetensors به‌تنهایی دلیل اجرای همان فایل با SystemOne نیست؛ artifact سازگار را جداگانه بررسی کنید. آزمون محلی و ارزیابی کیفیت فارسی انجام نشده است. راهنمای شروع ↗
llama.cpp / llama-server · b11310 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ اصلاح ایمنی حافظه و صحت اجرای IQ4_NL CUDA/HIP/MUSA؛ ردیف IQ4_NL با طول نامضرب QK_K پیش‌انتشار؛ اصلاح ایمنی حافظهٔ IQ4_NL در CUDA/HIP/MUSA. برای این مسیر حداقل b11310+ حاوی #29683 لازم است. اگر تعداد عناصر مضرب QK4_NL ولی نه QK_K باشد، آخرین بلوک می‌توانست از انتهای ورودی بخواند و بیرون بافر خروجی بنویسد؛ مضرب‌های QK_K از این خطا متأثر نیستند. در آزمون اشکال‌زدایی نویسنده با ۱۹۲ عنصر، نوشتن خارج‌ازمحدوده از ۱۲۸ به صفر بایت رسید (CUDA H20-3e و MUSA S5000)؛ HIP از کد مشترک استفاده می‌کند، نه اینکه آزمون مستقلی گزارش شده باشد. تا بازبینی ۱ اکتبر ۲۰۲۶، منابع بررسی‌شده CVE یا امکان بهره‌برداری اعلام نکرده‌اند. این اصلاح شاهد افزایش سرعت یا تغییر نیاز حافظه نیست. راهنمای شروع ↗
llama.cpp / llama-server · b11307 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ DFlash/DFlash2 در اجرای هم‌زمان ترتیب layer input؛ KV streamهای جدا و tensor split پیش‌انتشار؛ اصلاح ترتیب layer input برای DFlash/DFlash2 و چند sequence. برای concurrency بیش از یک، به‌ویژه با KV streamهای جدا، از b11307+ حاوی #29019 استفاده کنید؛ اصلاح با tensor split نیز سازگار است. شکستن batch می‌توانست hidden state توکن دیگری را به drafter بدهد؛ اصلاح ترتیب اصلی را بازمی‌گرداند. در SPEED-Bench نویسنده با Qwen3.8-27B و DFlash2، هر دو Q4_K_M و concurrency=16، میانگین طول پذیرش از 3.3531 به 3.9211 رسید (+16.94%). این نتیجه سرعت نهایی، کیفیت فارسی یا عملکرد مدل‌ها و سخت‌افزارهای دیگر را ثابت نمی‌کند. گزارش #27117 زمینهٔ افت پذیرش است؛ رفع همهٔ موارد آن تأیید نشده است. آزمون محلی انجام نشده و پیش‌انتشار انتخاب پیش‌فرض تولیدی نیست. راهنمای شروع ↗
llama.cpp / llama-server · b11371 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ پشتیبانی اولیهٔ Clef در /v1/systemone این ساخت Clef را فقط با متن پشتیبانی می‌کند؛ تصویر در v0.6.0 اضافه شده است b11371 پشتیبانی اولیهٔ Clef را فقط برای متن اضافه کرده است. پشتیبانی تصویری در v0.6.0 پایدار با GGUF و projector سازگار اضافه شد؛ محدودیت این ساخت به نسخه‌های جدید یا Ollama v0.35.1 تعمیم ندارد. b11371 پیش‌انتشار است؛ آزمون محلی، کارایی و کیفیت فارسی تأیید نشده‌اند. راهنمای شروع ↗
llama.cpp / llama-server · v0.6.0
موتور / کتابخانهٔ استنتاج، سرور API پایدار؛ llama.cpp / llama-server با تصمیم‌گیری متنی و تصویری Clef دسته‌بندی (مشروط) v0.6.0 پایدار پشتیبانی تصویری Clef را با /v1/systemone اضافه می‌کند. به GGUF با قالب جدید و projector سازگار (--mmproj) نیاز است؛ فایل‌های قدیمی ممکن است به تبدیل مجدد نیاز داشته باشند. کل prompt باید در --ubatch-size جا شود؛ تصویر با data URL فرستاده می‌شود. پاسخ‌ها choice، noul یا score هستند و سرور Clef تولید متن آزاد ندارد. اصلاح Vulkan FlashAttention #29988 نیز در این نسخه وجود دارد. کیفیت فارسی، سرعت و مصرف کامل حافظه آزموده نشده‌اند. v0.6.0 پایدار پشتیبانی تصویری Clef را با /v1/systemone اضافه می‌کند. به GGUF با قالب جدید و projector سازگار (--mmproj) نیاز است؛ فایل‌های قدیمی ممکن است به تبدیل مجدد نیاز داشته باشند. کل prompt باید در --ubatch-size جا شود؛ تصویر با data URL فرستاده می‌شود. پاسخ‌ها choice، noul یا score هستند و سرور Clef تولید متن آزاد ندارد. اصلاح Vulkan FlashAttention #29988 نیز در این نسخه وجود دارد. کیفیت فارسی، سرعت و مصرف کامل حافظه آزموده نشده‌اند. راهنمای شروع ↗
llama.cpp / llama-server · b11424 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ اصلاح دسترسی خارج از محدوده در Vulkan FlashAttention Vulkan + FlashAttention؛ اصلاح نوشتن در حافظهٔ اشتراکی b11424 اصلاح #29988 را برای نوشتن خارج از محدودهٔ حافظهٔ اشتراکی در Vulkan FlashAttention دارد؛ گزارش رسمی به crash نوع DeviceLost روی NVIDIA اشاره می‌کند. برای مسیر متأثر از b11424+ حاوی این اصلاح یا نسخهٔ پایدار v0.6.0 استفاده و workload را بازآزمایی کنید. این اصلاح شاهد افزایش سرعت، CVE یا بهره‌برداری اثبات‌شده نیست؛ تخمین VRAM تغییر نمی‌کند. راهنمای شروع ↗
llama.cpp / llama-server · b11454 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ حداقل مسیر llama.cpp برای پنج مدل K2 Horizon با GGUF رسمی تولید متن (مشروط)، فراخوانی ابزار (مشروط) مدل‌ها در ۳ سپتامبر عرضه شدند؛ b11454 رخداد اجرای تازه در ۶ اکتبر است و پیش‌انتشار باقی می‌ماند. فقط پنج مدل مجموعهٔ GGUF رسمی در دامنه‌اند؛ 375B-A23B به این مسیر نسبت داده نمی‌شود. -sm tensor غیرفعال است. اصلاح ZWNJ/ZWJ و Windows شاهد کیفیت فارسی نیست؛ سرعت و حافظهٔ واقعی آزمون نشده‌اند. مدل‌ها در ۳ سپتامبر عرضه شدند؛ b11454 رخداد اجرای تازه در ۶ اکتبر است و پیش‌انتشار باقی می‌ماند. فقط پنج مدل مجموعهٔ GGUF رسمی در دامنه‌اند؛ 375B-A23B به این مسیر نسبت داده نمی‌شود. -sm tensor غیرفعال است. اصلاح ZWNJ/ZWJ و Windows شاهد کیفیت فارسی نیست؛ سرعت و حافظهٔ واقعی آزمون نشده‌اند. راهنمای شروع ↗
llama.cpp / llama-server · b11532 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ حداقل نسخهٔ شامل هر دو اصلاح ایمنی حافظه و GELU در ModernBERT b11529+ کنترل offset در ggml_acc_impl پیش از تبدیل به int32_t را اضافه می‌کند تا نوشتن خارج از محدوده ناشی از سرریز رخ ندهد. گزارش PR امکان ورود offset منفی از RPC GRAPH_COMPUTE را نیز ذکر می‌کند؛ اصلاح نهایی اعتبارسنجی مستقیم پارامترهای RPC نیست. b11532+ برای ModernBERT با hidden_activation=gelu از GELU دقیق مطابق Transformers استفاده می‌کند. در منابع بررسی‌شده CVE یا بهره‌برداری عملی اعلام نشده است؛ این اصلاح شاهد افزایش سرعت نیست. GGUF موجود ModernBERT نیاز به تبدیل دوباره ندارد و خروجی buildهای قدیمی باید بازآزمایی شود. آزمون ناشر فقط CPU/F32 روی gte-reranker-modernbert-base است: بیشینهٔ خطای فعال‌سازی از 5.8e-2 به 7.4e-6 رسید؛ GPU آزمایش نشده و تغییر سرعت CPU در محدودهٔ نوسان اجرا بود. این اعداد ارزیابی مستقیم ModernBERT-base نیستند. راهنمای شروع ↗
llama.cpp / llama-server · b11537 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ حداقل نسخهٔ شامل اصلاح ترتیب گراف embedding پس از رگرسیون mixed-batch اصلاح #30160 عملگرهای GET_ROWS را پیش از دیگر عملیات ورودی می‌چیند تا تقسیم‌های اضافی گراف و انتقال ناخواسته به CPU کاهش یابد. برای mixed-batch/embedding و بازآزمایی مسیرهای MTP و چند GPU از b11537 یا جدیدتر شروع کنید؛ پشتیبانی هر مدل جدا بررسی شود. گزارش یک کاربر روی Linux، SYCL و دو Arc Pro B70 با Qwen3.8-Flash-Next / UD-IQ3_XXS: حدود 365 pp و 24 tg به 582.23 pp و 32.75 tg رسید. اعداد پس از اصلاح متعلق به شاخهٔ PR هستند، نه آزمون مستقل باینری b11537. ورودی، شمار تکرار و آزمون مستقل MTP کامل گزارش نشده‌اند؛ نتیجه به همهٔ GPUها تعمیم داده نشود. راهنمای شروع ↗
llama.cpp / llama-server · b11540 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ شتاب decode مدل‌های MoE با MXFP4 در backend SYCL SYCL MXFP4 MoE optimized decode؛ اصلاح #29809 از decode حسابی و بازچینی وزن‌ها استفاده می‌کند. گزارش نویسنده: gpt-oss-20b روی یک B70 از 55.84 به 106.64 tok/s و gpt-oss-120b روی دو B70 از 33.27 به 67.14 tok/s رسید. آزمون اصلی نویسندهٔ PR روی Windows 11، oneAPI 2026.0، CPU مدل EPYC 7402P و Flash Attention روشن است؛ ۲۰B با پنج و ۱۲۰B با دو تکرار. اعداد برای decode هستند؛ به prefill، Linux یا GPUهای دیگر تعمیم داده نشوند. build شامل اصلاح b11540 است، اما این اعداد مستقیماً از شاخهٔ PR گزارش شده‌اند و آزمون مستقلی روی سایت انجام نشده است. راهنمای شروع ↗
llama.cpp / llama-server · b11552 · پیش‌انتشار
موتور / کتابخانهٔ استنتاج، سرور API پیش‌انتشار؛ اصلاح جداسازی context در llama-server هنگام استفاده از id_slot ثابت و RAM prompt cache درخواست دارای id_slot ثابت دیگر cache را روی slot مشغول بارگذاری نمی‌کند و تا آزادشدن آن منتظر می‌ماند. شرط این پیکربندی: pinned id_slot + RAM prompt cache → b11552+. تا ارتقا و قبولی آزمون canary، این ترکیب در سرویس چندکاربره استفاده نشود. خطای جداسازی context تأیید شده است؛ در release و PR، CVE یا رخداد واقعی افشای اطلاعات گزارش نشده. آزمون محدود upstream: M2 Ultra/Metal، Qwen3.8-27B-UD-Q4_K_M همراه mmproj، --parallel 10، --kv-unified، --no-cache-idle-slots، --cache-ram 8192 و id_slot=7. در b11146، از ۳۰ جفت هم‌زمان ۱ عبور محتوای درخواست دیگر و ۹ پاسخ خراب گزارش شد؛ در شاخهٔ PR (build 11550)، از ۶۰ جفت هر دو عدد صفر بود. یک نوبت timeout سمت کاربر پس از ۶۰ ثانیه داشت. b11552 شامل اصلاح است؛ این اعداد آزمون مستقیم فایل انتشار یا تضمین همهٔ پیکربندی‌ها نیستند. میزان اثر بدون slot pinning نامعلوم است. راهنمای شروع ↗

«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.

نتایج آزمون‌ها

مقایسهٔ مدل‌ها در آزمون‌های مشترک

دربارهٔ این مقایسه‌ها

در MIRACL فارسی، nDCG@10 از 53.3 برای Small به 59.4 برای Large-Instruct می‌رسد. در اسپانیایی 51.2 و 53.7 است؛ در انگلیسی Large با 52.9 بالاتر از Large-Instruct با 51.5 گزارش شده است. میانگین چندزبانه جای زبانِ کاربرد را نمی‌گیرد.

اختلاف امتیاز را فقط برای مدل‌هایی محاسبه می‌کنیم که در یک آزمون و با شرایط یکسان بررسی شده‌اند.

MIRACL · nDCG@10· فارسی

مدلامتیازاختلاف با ردیف نخستجزئیات آزمون
۵۳٫۳ امتیاز از ۱۰۰—
جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدل

Appendix / detailed MIRACL results / language=fa / column=1

بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
۵۷٫۴ امتیاز از ۱۰۰۴٫۱
جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدل

Appendix / detailed MIRACL results / language=fa / column=2

بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
۵۹ امتیاز از ۱۰۰۵٫۷
جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدل

Appendix / detailed MIRACL results / language=fa / column=3

بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
۵۹٫۴ امتیاز از ۱۰۰۶٫۱
جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدل

Appendix / detailed MIRACL results / language=fa / column=4

بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed

MIRACL · Recall@100· فارسی

مدلامتیازاختلاف با ردیف نخستجزئیات آزمون
۹۰٫۴ امتیاز از ۱۰۰—
جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدل

Appendix / detailed MIRACL results / language=fa / column=5

بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
۹۱٫۲ امتیاز از ۱۰۰۰٫۸
جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدل

Appendix / detailed MIRACL results / language=fa / column=6

بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
۹۲٫۹ امتیاز از ۱۰۰۲٫۵
جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدل

Appendix / detailed MIRACL results / language=fa / column=7

بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
۹۲٫۹ امتیاز از ۱۰۰۲٫۵
جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدل

Appendix / detailed MIRACL results / language=fa / column=8

بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed

نتایج کیفیت مدل‌ها

MIRACL · nDCG@10 · فارسی · امتیاز

انتخاب برای مقایسهمدلامتیازحالت آزمونگزارش‌دهندهمنبع
۵۷٫۷ امتیاز0..100 as printed—dev · faBAAIگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۵۷٫۷گزارش ناشر · BAAI· فارسی· بردار متراکم
مدل نام‌گذاری‌شده در گزارش
bge-m3
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · امتیاز
زبان
فارسی
روش بازنمایی
Dense
بخش داده‌ها
dev
مقیاس امتیاز
0..100 as printed
دامنهٔ نتیجه
retrieval component only
زیرمجموعهٔ داده
fa
تاریخ دسترسی
۲۰۲۶/۰۹/۱۵ میلادی
bge-m3 — published evaluation · گزارش ناشر https://arxiv.org/html/2402.03216v1 ↗
ناشر / نویسنده
BAAI
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
S3.T2; M3-Embedding Our Work; Dense; fa
۴۵٫۲ امتیاز0..100 as printed—dev · faBAAIگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۴۵٫۲گزارش ناشر · BAAI· فارسی· بازنمایی تنک
مدل نام‌گذاری‌شده در گزارش
bge-m3
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · امتیاز
زبان
فارسی
روش بازنمایی
Sparse
بخش داده‌ها
dev
مقیاس امتیاز
0..100 as printed
دامنهٔ نتیجه
retrieval component only
زیرمجموعهٔ داده
fa
تاریخ دسترسی
۲۰۲۶/۰۹/۱۵ میلادی
bge-m3 — published evaluation · گزارش ناشر https://arxiv.org/html/2402.03216v1 ↗
ناشر / نویسنده
BAAI
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
S3.T2; M3-Embedding Our Work; Sparse; fa
۵۸٫۸ امتیاز0..100 as printed—dev · faBAAIگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۵۸٫۸گزارش ناشر · BAAI· فارسی· چندبرداری
مدل نام‌گذاری‌شده در گزارش
bge-m3
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · امتیاز
زبان
فارسی
روش بازنمایی
Multi-vec
بخش داده‌ها
dev
مقیاس امتیاز
0..100 as printed
دامنهٔ نتیجه
retrieval component only
زیرمجموعهٔ داده
fa
تاریخ دسترسی
۲۰۲۶/۰۹/۱۵ میلادی
bge-m3 — published evaluation · گزارش ناشر https://arxiv.org/html/2402.03216v1 ↗
ناشر / نویسنده
BAAI
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
S3.T2; M3-Embedding Our Work; Multi-vec; fa
۵۹٫۲ امتیاز0..100 as printed—dev · faBAAIگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۵۹٫۲گزارش ناشر · BAAI· فارسی· ترکیب متراکم و تنک
مدل نام‌گذاری‌شده در گزارش
bge-m3
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · امتیاز
زبان
فارسی
روش بازنمایی
Dense+Sparse
بخش داده‌ها
dev
مقیاس امتیاز
0..100 as printed
دامنهٔ نتیجه
retrieval component only
زیرمجموعهٔ داده
fa
تاریخ دسترسی
۲۰۲۶/۰۹/۱۵ میلادی
bge-m3 — published evaluation · گزارش ناشر https://arxiv.org/html/2402.03216v1 ↗
ناشر / نویسنده
BAAI
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
S3.T2; M3-Embedding Our Work; Dense+Sparse; fa
۶۰٫۳ امتیاز0..100 as printed—dev · faBAAIگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۶۰٫۳گزارش ناشر · BAAI· فارسی· ترکیب سه روش
مدل نام‌گذاری‌شده در گزارش
bge-m3
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · امتیاز
زبان
فارسی
روش بازنمایی
All
بخش داده‌ها
dev
مقیاس امتیاز
0..100 as printed
دامنهٔ نتیجه
retrieval component only
زیرمجموعهٔ داده
fa
تاریخ دسترسی
۲۰۲۶/۰۹/۱۵ میلادی
bge-m3 — published evaluation · گزارش ناشر https://arxiv.org/html/2402.03216v1 ↗
ناشر / نویسنده
BAAI
تاریخ دسترسی
2026-09-15
بخش مرتبط در منبع
S3.T2; M3-Embedding Our Work; All; fa

MIRACL · nDCG@10 · فارسی · از ۱۰۰

انتخاب برای مقایسهمدلامتیازحالت آزمونگزارش‌دهندهمنبع
۵۳٫۳ از ۱۰۰—developmentMicrosoft E5 authorsگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۵۳٫۳گزارش ناشر · Microsoft E5 authors· فارسی
مدل نام‌گذاری‌شده در گزارش
multilingual-e5-small
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · score-points-0-100
زبان
فارسی
بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
تاریخ دسترسی
۲۰۲۶/۰۹/۱۶ میلادی
Multilingual E5 technical report, arXiv:2402.05672v1 · گزارش ناشر https://arxiv.org/html/2402.05672v1 ↗
تاریخ دسترسی
2026-09-16
بخش مرتبط در منبع
Appendix / detailed MIRACL results / language=fa / column=1
SHA-256
6e288db32f6399019e4d6b5f47105954e046c1a959ab5038f700911f2833e269
زمان ثبت سند
2026-09-16T21:06:05.393094+00:00
۵۷٫۴ از ۱۰۰—developmentMicrosoft E5 authorsگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۵۷٫۴گزارش ناشر · Microsoft E5 authors· فارسی
مدل نام‌گذاری‌شده در گزارش
multilingual-e5-base
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · score-points-0-100
زبان
فارسی
بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
تاریخ دسترسی
۲۰۲۶/۰۹/۱۶ میلادی
Multilingual E5 technical report, arXiv:2402.05672v1 · گزارش ناشر https://arxiv.org/html/2402.05672v1 ↗
تاریخ دسترسی
2026-09-16
بخش مرتبط در منبع
Appendix / detailed MIRACL results / language=fa / column=2
SHA-256
6e288db32f6399019e4d6b5f47105954e046c1a959ab5038f700911f2833e269
زمان ثبت سند
2026-09-16T21:06:05.393094+00:00
۵۹ از ۱۰۰—developmentMicrosoft E5 authorsگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۵۹گزارش ناشر · Microsoft E5 authors· فارسی
مدل نام‌گذاری‌شده در گزارش
multilingual-e5-large
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · score-points-0-100
زبان
فارسی
بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
تاریخ دسترسی
۲۰۲۶/۰۹/۱۶ میلادی
Multilingual E5 technical report, arXiv:2402.05672v1 · گزارش ناشر https://arxiv.org/html/2402.05672v1 ↗
تاریخ دسترسی
2026-09-16
بخش مرتبط در منبع
Appendix / detailed MIRACL results / language=fa / column=3
SHA-256
6e288db32f6399019e4d6b5f47105954e046c1a959ab5038f700911f2833e269
زمان ثبت سند
2026-09-16T21:06:05.393094+00:00
۵۹٫۴ از ۱۰۰—developmentMicrosoft E5 authorsگزارش ناشر
جزئیات آزمون
MIRACL · nDCG@10: ۵۹٫۴گزارش ناشر · Microsoft E5 authors· فارسی
مدل نام‌گذاری‌شده در گزارش
multilingual-e5-large-instruct
Benchmark / نسخه
MIRACL
سنجه و واحد
nDCG@10 · score-points-0-100
زبان
فارسی
بخش داده‌ها
development
مقیاس امتیاز
0–100 as printed
تاریخ دسترسی
۲۰۲۶/۰۹/۱۶ میلادی
Multilingual E5 technical report, arXiv:2402.05672v1 · گزارش ناشر https://arxiv.org/html/2402.05672v1 ↗
تاریخ دسترسی
2026-09-16
بخش مرتبط در منبع
Appendix / detailed MIRACL results / language=fa / column=4
SHA-256
6e288db32f6399019e4d6b5f47105954e046c1a959ab5038f700911f2833e269
زمان ثبت سند
2026-09-16T21:06:05.393094+00:00
نمای داده‌ای

مدل‌های کوچک و تخصصی مکمل

نقش مدل تخصصی، طول ورودی، ابعاد بردار و نتایج مرتبط با زبان انتخابی را مقایسه کنید.

آزمونِ ستون نتیجه: MIRACL · nDCG@10 · fa

این انتخاب برای ستون نتیجهٔ همهٔ جدول‌هاست. شرایط اجرا در جزئیات هر مدل آمده است.

دیدن نتایج به تفکیک آزمون ←
۳۱ نتیجه از ۳۱ ردیف
نوع مدل
کاربرد
اندازهٔ اعلامی مدل(میلیارد)
فیلترهای تخصصی ۶ کنترل
نوع شاهد
همهٔ ردیف‌ها
مقایسهٔ ردیف‌ها و شرایط آن

قاعدهٔ مقایسه: معیار و واحد باید متناسب با یک وظیفه باشند؛ document/s هیچ‌گاه ضمنی به token/s تبدیل نمی‌شود.

با × کنار عنوان، ستون را پنهان کنید؛ برای دیدن منابع و شرایط، جزئیات ردیف را باز کنید.

ستون‌های پنهان:
جدول مدل‌های کوچک و تخصصی مکمل
مقایسهجزئیات
وظیفهٔ دقیق
نوع / ابعاد خروجی
زبان‌ها و شاهد زبان انتخابی
مجوز
نتیجهٔ مرتبط با زبان انتخابی
دریافت و راه‌اندازی
صفحهٔ رسمی ↗
بازیابی متراکم، تنک و چندبرداری حدود ۰٫۵۶۹ میلیارد ۸٬۱۹۲ توکن بردار متراکم ۱۰۲۴بُعدی + وزن توکن + چندبرداری multilingual fa: نتیجهٔ منتشرشده MIT ↗ ۳٫۸۱ GiB / یک میلیون بردار
PYTORCH · رسمی ↗GGUF · ثالث ↗ONNX · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی زوج پرسش و سند حدود ۰٫۵۶۸ میلیارد ۸٬۱۹۲ توکن امتیاز ارتباط؛ sigmoid اختیاری در بازهٔ ۰ تا ۱ multilingual fa: نتیجهٔ منتشرشده Apache-2.0 ↗ — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی معنایی و ساخت بردار متن حدود ۰٫۶ میلیارد ۳۲٬۷۶۸ توکن بردار متراکم؛ ۱۰۲۴ بُعد پیش‌فرض / حداکثر multilingual fa: شاهد ثبت نشده Apache-2.0 ↗ — ۳٫۸۱ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی معنایی و ساخت بردار متن حدود ۴ میلیارد ۳۲٬۷۶۸ توکن بردار متراکم؛ ۲۵۶۰ بُعد پیش‌فرض / حداکثر multilingual fa: شاهد ثبت نشده Apache-2.0 ↗ — ۹٫۵۴ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی معنایی و ساخت بردار متن حدود ۸ میلیارد ۳۲٬۷۶۸ توکن بردار متراکم؛ ۴۰۹۶ بُعد پیش‌فرض / حداکثر multilingual fa: شاهد ثبت نشده Apache-2.0 ↗ — ۱۵٫۲۶ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی زوج پرسش و سند حدود ۰٫۶ میلیارد ۳۲٬۷۶۸ توکن امتیاز ارتباط زوج متن؛ بدون embedding multilingual fa: شاهد ثبت نشده Apache-2.0 ↗ — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی زوج پرسش و سند حدود ۴ میلیارد ۳۲٬۷۶۸ توکن امتیاز ارتباط زوج متن؛ بدون embedding multilingual fa: شاهد ثبت نشده Apache-2.0 ↗ — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی زوج پرسش و سند حدود ۸ میلیارد ۳۲٬۷۶۸ توکن امتیاز ارتباط زوج متن؛ بدون embedding multilingual fa: شاهد ثبت نشده Apache-2.0 ↗ — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن ۰٫۱۱۸ میلیارد ۵۱۲ توکن بردار 384بعدی multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده MIT ↗ ۱٫۴۳ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن ۰٫۰۲۳ میلیارد ۲۵۶ توکن بردار 384بعدی en fa: شاهد ثبت نشده Apache-2.0 ↗ — ۱٫۴۳ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن ۰٫۲۷۸ میلیارد ۵۱۲ توکن بردار 768بعدی multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده MIT ↗ ۲٫۸۶ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن ۰٫۵۶ میلیارد ۵۱۲ توکن بردار 1024بعدی multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده MIT ↗ ۳٫۸۱ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن ۰٫۰۳۳ میلیارد ۵۱۲ توکن بردار 384بعدی en fa: شاهد ثبت نشده MIT ↗ — ۱٫۴۳ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی نتایج جست‌وجو ۰٫۲۷۸ میلیارد ۵۱۲ توکن امتیاز ارتباط پرسش و سند en, zh fa: شاهد ثبت نشده MIT ↗ — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن حدود ۰٫۳ میلیارد اسمی شمار کل تأیید نشده ۲٬۰۴۸ توکن بردار 768بعدی multilingual fa: شاهد ثبت نشده gemma ↗ استفادهٔ تجاری مشروط به مجوز — ۲٫۸۶ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن حدود ۰٫۵۷ میلیارد اسمی شمار کل تأیید نشده ۸٬۱۹۲ توکن بردار 1024بعدی multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده CC-BY-NC-4.0 ↗ استفادهٔ تجاری مشروط به مجوز — ۳٫۸۱ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازرتبه‌بندی نتایج جست‌وجو ۰٫۲۷۸ میلیارد ۱٬۰۲۴ توکن امتیاز ارتباط پرسش و سند multilingual fa: شاهد ثبت نشده CC-BY-NC-4.0 ↗ استفادهٔ تجاری مشروط به مجوز — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗GGUF · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن ۰٫۳۳۵ میلیارد ۵۱۲ توکن بردار 1024بعدی en fa: شاهد ثبت نشده Apache-2.0 ↗ — ۳٫۸۱ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · ثالث ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
بازیابی و مشابهت متن ۰٫۱۳۷ میلیارد ۸٬۱۹۲ توکن بردار 768بعدی en fa: شاهد ثبت نشده Apache-2.0 ↗ — ۲٫۸۶ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗ONNX · رسمی ↗GGUF · رسمی ↗OLLAMA · ثالث ↗
صفحهٔ رسمی ↗
تخصصی‌سازی دسته‌بندی و استخراج موجودیت ۰٫۱۵ میلیارد ۸٬۱۹۲ توکن بازنمایی توکن؛ هد وظیفه پس از آموزش en fa: شاهد ثبت نشده Apache-2.0 ↗ — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗ONNX · رسمی ↗PYTORCH · رسمی ↗
صفحهٔ رسمی ↗
بازیابی و شباهت متن ۰٫۵۶ میلیارد ۵۱۲ توکن بردار متراکم af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده mit ↗ ۳٫۸۱ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازیابی و شباهت متن ۰٫۱۲۳ میلیارد ۵۱۲ توکن بردار متراکم fa fa: نتیجهٔ منتشرشده — — ۲٫۸۶ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازیابی و شباهت متن ۰٫۳۵۳ میلیارد ۵۱۲ توکن بردار متراکم fa fa: نتیجهٔ منتشرشده — — ۳٫۸۱ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
پایهٔ آموزش دسته‌بندی و تشخیص موجودیت — ۵۱۲ توکن بازنمایی توکن‌ها؛ سر وظیفه باید آموزش ببیند fa fa: اعلام ناشر — — بردار ثابت ذخیره نمی‌کند
PYTORCH · رسمی ↗
صفحهٔ رسمی ↗
بازیابی متن، تصویر و ویدئو ۲ میلیارد ۳۲٬۷۶۸ توکن بردار با حداکثر 2048 بُعد — fa: شاهد ثبت نشده Apache-2.0 ↗ — ۷٫۶۳ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازیابی متن، تصویر و ویدئو ۸ میلیارد ۳۲٬۷۶۸ توکن بردار با حداکثر 4096 بُعد — fa: شاهد ثبت نشده Apache-2.0 ↗ — ۱۵٫۲۶ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازرتبه‌بند ۲ میلیارد ۳۲٬۷۶۸ توکن — — fa: شاهد ثبت نشده Apache-2.0 ↗ — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
بازرتبه‌بند ۸ میلیارد ۳۲٬۷۶۸ توکن — — fa: شاهد ثبت نشده Apache-2.0 ↗ — بردار ثابت ذخیره نمی‌کند
SAFETENSORS · رسمی ↗
صفحهٔ رسمی ↗
embedding چندوجهی متن، تصویر و صفحهٔ ترکیبی PDF — ۱۲۸٬۰۰۰ توکن 128K اعلامی ناشر؛ کیفیت بلندمتن اندازه‌گیری نشده است. بردار float، int8 یا binary؛ ۲۰۴۸ بُعد پیش‌فرض fa, en, es fa: اعلام ناشر — — ۷٫۶۳ GiB / یک میلیون بردار
صفحهٔ رسمی ↗
embedding چندوجهی متن، تصویر و صفحهٔ ترکیبی PDF — ۱۲۸٬۰۰۰ توکن 128K اعلامی ناشر؛ کیفیت بلندمتن اندازه‌گیری نشده است. بردار float، int8 یا binary؛ ۲۰۴۸ بُعد پیش‌فرض fa, en, es fa: اعلام ناشر — — ۷٫۶۳ GiB / یک میلیون بردار
صفحهٔ رسمی ↗
بازیابی متن، کد و رسانه در فضای مشترک ۰٫۷۴ میلیارد · حدود ۰٫۲۷ میلیارد بخش متنی؛ قابل بارگذاری مستقل ۸٬۱۹۲ توکن بردار ۷۶۸بعدی با MRL؛ کاهش به ۵۱۲، ۲۵۶ یا ۱۲۸ بعد multilingual fa: شاهد ثبت نشده Apache-2.0 ↗ — ۲٫۸۶ GiB / یک میلیون بردار
SAFETENSORS · رسمی ↗

«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.

یادداشت‌های راهنما

انتخاب مدل، حافظه، نرم‌افزار اجرا و ارزیابی کیفیت.

بازگشت به جدول‌ها ↑
۱۸ دقیقه

برای هر کاربرد واقعاً چه اندازه مدلی لازم داریم؟ از مدل تخصصی و SLM تا LLM

برای چت ساده، پاسخ مستند، دستیار کد و تحلیل پیچیده چه اندازه مدلی مناسب است؟ مرور تناسب کاربردها، انتخاب میان RAG، CAG، KAG و تنظیم مدل، و اثر اندازه و طول زمینه بر هزینه و ظرفیت سرویس‌دهی.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۱۹ دقیقه

مدل خوب برای فارسی را چگونه بسنجیم؟

از روانی متن تا درستی پاسخ و موفقیت در کاربرد واقعی؛ راهنمای عملی انتخاب معیار، ساخت نمونه‌های فارسی و استفاده از بنچمارک‌ها، با ارجاع به پژوهش‌های فارسی و کارهای دانشگاهی ایران.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۱۷ دقیقه

RAG، CAG، KAG، Fine-tuning و Instruction tuning؛ چه تفاوتی دارند و کدام را انتخاب کنیم؟

وقتی مدل پاسخ مناسبی نمی‌دهد، واقعاً به آموزش دوباره نیاز داریم یا فقط باید دانش درست را در اختیارش بگذاریم؟ با مثال‌هایی ساده، تفاوت RAG، CAG و KAG را با Fine-tuning و Instruction tuning بررسی می‌کنیم؛ از بازیابی سند و کش‌کردن دانش تا استدلال روی روابط و تغییر رفتار مدل. جدول مقایسه و سناریوهای عملی کمک می‌کنند پیش از صرف هزینهٔ آموزش، تشخیص دهیم مشکل از کمبود دانش است یا شیوهٔ پاسخ‌گویی، و کدام روش یا ترکیب برای پروژه مناسب‌تر است.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۲۰ دقیقه

برای دستیار اسناد سازمانی، مدل زبانی، embedding و reranker را چگونه انتخاب کنیم؟

برای پاسخ‌های روزمره از اسناد سازمان، مدل کوچک اغلب نقطهٔ شروع مناسبی است. معیار انتخاب جداگانهٔ embedding، reranker و پاسخ‌گو، نامزدهای عملی و تشخیص محل خطا را با چهار جدول بررسی می‌کنیم.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۱۸ دقیقه

تکمیل کد، دستیار کد و عامل برنامه‌نویسی؛ سه نیاز با سه معیار انتخاب

تکمیل کد به پیشنهاد سریع، دستیار کد به اصلاح درست و عامل برنامه‌نویسی به انجام موفق کار با ابزار نیاز دارد. چهار جدول برای انتخاب مدل، معیار ارزیابی و زیرساخت متناسب با هر نقش.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۲۰ دقیقه

روی RTX 4090 چه مدل‌هایی اجرا می‌شوند؟ تفاوت ۲۴ و ۴۸ گیگابایت در عمل

کدام مدل‌ها روی ۲۴ و ۴۸ گیگابایت جا می‌شوند، چند 4090 چه زمانی برای سرویس سازمانی کافی‌اند و چه زمانی H100، H200 یا کارت حرفه‌ای ارزش هزینهٔ بیشتر را دارند؟

مطالعهٔ صفحهٔ مستقل مقاله ↗
۱۸ دقیقه

چهاربیتی‌کردن مدل چه چیزی را ارزان می‌کند و چه چیزی را تغییر می‌دهد؟

چهاربیتی‌کردن چگونه حجم وزن‌ها و هزینهٔ اجرا را کاهش می‌دهد و چه اثری بر کیفیت، سرعت، KV cache و ظرفیت سرویس دارد؟ همراه با مقایسهٔ واقعی نسخه‌های Qwen3-8B.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۱۸ دقیقه

AirLLM و اجرای لایه‌به‌لایه؛ مدل بزرگ با حافظهٔ کم، با چه هزینه‌ای؟

AirLLM چگونه مدل بزرگ را با VRAM کم اجرا می‌کند؟ هزینهٔ انتقال وزن، RAM و SSD، حافظهٔ کانتکست و تفاوت کاربرد پژوهشی با سرویس سازمانی؛ همراه با چهار جدول و بررسی آموزش LoRA.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۲۳ دقیقه

Ollama، vLLM، SGLang یا llama.cpp؛ برای اجرای مدل کدام را انتخاب کنیم؟

مقایسهٔ فنی چهار ابزار اجرای مدل؛ از هم‌زمانی و KV cache تا GGUF، چند GPU، پایش و آزمون بار. کجا سادگی Ollama کافی است و چه زمانی vLLM یا SGLang انتخاب مناسب‌تری می‌شود؟

مطالعهٔ صفحهٔ مستقل مقاله ↗
۱۴ دقیقه

چرا سریع‌ترین GPU لزوماً سریع‌ترین پاسخ را نمی‌دهد؟

توان پردازشی بیشتر یا نرخ توکن بالاتر، همیشه به پاسخ سریع‌تر منتهی نمی‌شود. تفاوت زمان آغاز و تکمیل پاسخ، نقش حافظه و همزمانی، تقسیم کار GPU و LPU و هزینهٔ ارتباطات را بررسی می‌کنیم تا معیار انتخاب زیرساخت، ظرفیت خدمت‌دهی با کیفیت و تأخیر مورد نیاز باشد.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۲۱ دقیقه

از یک کاربر تا سرویس سازمانی؛ چه زمانی مدل، تعداد نسخه‌ها یا GPU را تغییر دهیم؟

از صف و کانتکست تا تکثیر مدل و تحمل خرابی؛ راهنمای رشد اقتصادی سرویس سازمانی با GPU متناسب، نمونه‌های مستقل و ظرفیت ابری با پرداخت به‌اندازهٔ مصرف، همراه با مثال‌های عددی.

مطالعهٔ صفحهٔ مستقل مقاله ↗
۱۸ دقیقه

۱۰۰ کاربر هم‌زمان در یک دستیار هوشمند یعنی چه؟

تعداد کاربر، ظرفیت یک دستیار هوشمند را مشخص نمی‌کند. نرخ درخواست، طول متن، صف و KV Cache را با مثال و ابزار تعاملی بررسی می‌کنیم تا انتخاب GPU و آزمون پذیرش به بار واقعی خدمت وصل شوند.
مطالعهٔ صفحهٔ مستقل مقاله ↗