مدل زبانی مناسب ترجمه، دستیار اسناد و Agent را بر اساس زبان، حافظه، سختافزار و هزینه انتخاب کنید؛ مقایسه مدلها و راهنمای اجرای سازمانی.
امروزه بسیاری از افراد و سازمانها تمایل دارند برای کاربردهای مختلف،(LLM یا SLM) یک مدل زبانی محلی در اختیار داشته باشند؛ مدلی که روی رایانه یا سرور خودشان اجرا شود و برای گفتوگو، برنامهنویسی، ترجمه یا پاسخگویی بر اساس اسناد از آن استفاده کنند. حفظ محرمانگی اطلاعات، استقلال از سرویسهای خارجی و کنترل هزینهها از انگیزههای این انتخاب است. اما تنوع مدلها و روشهای اجرای آنها، تصمیمگیری را دشوار میکند: چه مدلی برای کار ما کافی است، روی سختافزار موجود چه چیزی میتوان اجرا کرد و چه زمانی ارتقای زیرساخت ضرورت دارد؟
این مجموعه برای پاسخ به همین پرسشها تهیه شده است. در جدولهای تعاملی میتوانید مدلهای زبانی کوچک و بزرگ، مدلهای تخصصی مرتبط، نیازهای سختافزاری و نرمافزارهای اجرای آنها را مقایسه کنید و به منابع و لینکهای کاربردی دسترسی داشته باشید. مقالههای همراه نیز توضیح میدهند هر انتخاب چه مزایا و محدودیتهایی دارد؛ تا بتوانید متناسب با کاربرد، کیفیت موردانتظار و بودجه خود تصمیم بگیرید و برای قابلیتی که به آن نیاز ندارید، هزینه نکنید.
راهنمای استفاده از مجموعه
از کجا شروع کنیم؟
برای مقایسه، جدول را باز کنید؛ برای شناخت مفاهیم و دلیل انتخاب، یادداشتهای هر مسیر را بخوانید.
راهنمای تعامل
با چند پرسش اصلی شروع کنید؛ برای نتیجهٔ دقیقتر، مشخصات اجرا را بعداً اضافه کنید.
برای تهیهٔ این جدولها، مشخصات مدلها و مستندات نرمافزارها را بررسی کردهایم. اعداد کیفیت و سرعت از آزمونهای منتشرشده نقل شدهاند و حاصل آزمایش ما نیستند. منبع و شرایط هر آزمون هم کنار نتیجه آمده است.
در این مجموعه، مدلهایی برای نوشتن متن، برنامهنویسی، خواندن تصویر و سند، جستوجوی معنایی و مرتبکردن نتایج جستوجو آوردهایم. مدل بزرگتر یا مدلی که چندزبانه معرفی شده، لزوماً برای کار شما یا متن فارسی بهتر نیست؛ باید دید در همان کاربرد و زبان چه نتیجهای داشته است.
اطلاعات سختافزاری و نتایج سرعت این راهنما بیشتر به کارتهای NVIDIA مربوط است. اجرای مدل روی CPU، مکهای مجهز به Apple Silicon یا کارتهای AMD به پشتیبانی نرمافزار بستگی دارد. برای مقایسهٔ سرعت این گزینهها، هنوز آزمونهای کافی با شرایط یکسان در اختیار نداریم. کدام نرمافزار روی سختافزار شما اجرا میشود؟
برای برآورد حافظهٔ لازم، حجم فایل وزنهای مدل، حافظهٔ موقت مدل (KV cache) و فضای اضافهٔ موردنیاز برای اجرا روی هر دستگاه را در نظر گرفتهایم. فرمول معمول KV را برای مدلهای با معماری ترکیبی، MLA یا معماری نامشخص به کار نبردهایم. جزئیات محاسبه در بخش حافظه آمده است.
قاعدهٔ مقایسه: مشاهدهٔ کنارهم همیشه مجاز است؛ محاسبه فقط برای فیلدهای همواحد و انتساب نسخهمند معتبر است.
با × کنار عنوان، ستون را پنهان کنید؛ برای دیدن منابع و شرایط، جزئیات ردیف را باز کنید.
ستونهای پنهان:
مدلهای عرضهشده از طریق API · ۶
این خدمتها برای استفاده از API فهرست شدهاند و وارد تخمین حافظه یا پیشنهاد اجرای محلی نمیشوند.
GPT-6.1 Sol · gpt-6.1-sol
OpenAI · API · ۱٬۰۵۰٬۰۰۰ توکن زمینه · حداکثر خروجی ۱۲۸٬۰۰۰ · 2026-10-03
ورودی: متن و تصویر ← خروجی: متن · وزن قابل دریافت ندارد · فاینتیون پشتیبانی نمیشود.
ابزارهای Responses API: MCP · computer use · code interpreter · file search · web search
تعرفهٔ استاندارد هر یک میلیون توکن؛ ورودی / ورودی کششده / نوشتن کش / خروجی: $2 / $0.1 / $2.5 / $10
اگر ورودی درخواست از ۲۷۲٬۰۰۰ توکن بیشتر شود، نرخ کل همان درخواست بهترتیب $4 / $0.2 / $5 / $15. هزینهٔ ابزارها جداست؛ کیفیت فارسی و ادعاهای عملکرد نیازمند آزمون مستقلاند.
Prototype؛ endpoint رایگان NVIDIA ثبت شده است. ظرفیت پایهٔ 64K از کارت مدل است؛ صفحهٔ API آن را گردشده 66K نشان میدهد. عبارت «Download not available» فقط وضعیت همین پلتفرم است؛ وزنهای عمومی BF16 و GGUF در Hugging Face جداگانه منتشر شدهاند. کیفیت فارسی و دسترسی منطقهای تأیید نشدهاند.
۸ میلیارد فعال هنگام prefill · ۱۶ میلیارد فعال هنگام decode · حدود ۵۵۲ میلیارد بدنهٔ اصلی · حدود ۱۹۶ میلیارد حافظهٔ شرطی Engram · ترکیب متخصصان (MoE) · توجه ترکیبی شمار کل تأیید نشده
۱۲۸٬۰۰۰ توکن 128K اعلامی ناشر؛ کیفیت بلندمتن اندازهگیری نشده است.
فضای برداری مشترک Pro/Fast؛ نمایهسازی آفلاین با Pro و query برخط با Fast، با ابعاد و قالب خروجی یکسان. این سازگاری به معنای سازگاری index نسخهٔ Embed 4 نیست.
۱۲۸٬۰۰۰ توکن 128K اعلامی ناشر؛ کیفیت بلندمتن اندازهگیری نشده است.
فضای برداری مشترک Pro/Fast؛ نمایهسازی آفلاین با Pro و query برخط با Fast، با ابعاد و قالب خروجی یکسان. این سازگاری به معنای سازگاری index نسخهٔ Embed 4 نیست.
نقطهٔ شروع بر پایهٔ مستندات؛ رتبهبندی کیفیت نیست.
شروع انتخاب برای بازیابی فارسی
E5 در MIRACL فارسی و Tooka/Jina در PTEB ارزیابی شدهاند. MIRACL کیفیت بازیابی سند را میسنجد؛ PTEB چند وظیفه را پوشش میدهد و امتیاز کل آن با نتیجهٔ بازیابی یکسان نیست.
برای جستوجوی متن فارسی، با ثبت طول قطعه و پیشوند صحیح هر مدل؛ برای Tooka پرسش با «سوال: » و سند با «متن: » طبق کارت ناشر.
میانگین بالاتر Tooka-Large به معنی بازیابی بهتر از Small نیست.
بازیابی برای اسپانیایی
E5-Small خط پایهٔ کمحجمتری است؛ Large-Instruct در همین گزارش MIRACL اسپانیایی امتیاز بالاتری دارد. شواهد Qwen در این مقایسه تجمیعی و چندزبانهاند، نه مختص اسپانیایی.
پرسش و سند هر دو اسپانیایی باشند؛ بازیابی میانزبانی را جداگانه مشخص کنید.
اختلاف 51.2 تا 53.7 شواهدی برای کیفیت پاسخ نهایی چت یا پوشش تمام گونههای اسپانیایی نیست.
بازیابی برای انگلیسی
Large و Large-Instruct را گونههای مجزا بگیرید: در MIRACL انگلیسی امتیاز Large بالاتر است. برای افزودن reranker، مقایسهٔ Qwen با نامزدهای یکسان قابل استفاده است.
وقتی شواهد تکزبانه مهمتر از میانگین چندزبانه است.
واژهٔ Instruct تضمین برتری در همهٔ وظایف نیست.
افزودن مرحلهٔ بازچینی
از 0.6B بهعنوان گزینهٔ کوچکتر مقایسه شروع کنید. اگر افزایش کیفیتِ همان وظیفه ارزش هزینهٔ مرحلهٔ دوم را داشت، 4B و 8B را بررسی کنید؛ در همهٔ معیارها 8B جلوتر نیست.
وقتی سند مرتبط در نامزدهای مرحلهٔ اول هست ولی رتبهٔ خوبی ندارد؛ تعداد نامزدها بخشی از تصمیم است.
بازچینی سندی را که بازیاب وارد مجموعه نکرده بازیابی نمیکند.
حل مسئله یا ویرایش کد؟
برای دستیار دستورپذیر، معیارهای ویرایش مخزن و حل مسئله را جدا مقایسه کنید. StarCoder2-3B برای تکمیل کد/FIM است؛ HumanEval کیفیت گفتوگو یا عامل ویرایشگر را نمیسنجد.
وقتی رابط و وظیفه مشخص است: تکمیل داخل ادیتور، اصلاح چند فایل یا حل یک مسئله.
پارامتر فعال MoE مبنای حافظهٔ وزنهای مقیم نیست.
مدل کوچک برای کار محدود
LFM گزینهای کوچک برای استخراج و گردشکار محدود است؛ MiniCPM و Granite برای بررسی استدلال و ابزار نیز شواهد دارند. حجم واقعی وزنها ممکن است با عدد گردشدهٔ نام مدل متفاوت باشد.
وقتی دامنهٔ وظیفه، قالب خروجی و محدودیت حافظه روشن است.
امتیاز بالای یک مدل کوچک، تأخیر کمتر یا توان اجرای زمینهٔ حداکثری روی لپتاپ را ثابت نمیکند.
تشخیص نیت و دستهبندی
برای دستهبندی نیت، شواهد MassiveIntent و MTOP را انتخاب کنید. embedding بخشی از سامانهٔ دستهبندی است؛ امتیاز به روش طبقهبندی و دادهٔ آموزش آن هم وابسته است.
برای برچسبهای محدود و مشخص؛ این داده انتخاب نقطهٔ شروع را پشتیبانی میکند.
مدل embedding یا ParsBERT بدون سرِ وظیفه، چتبات آماده نیست.
aya-expanse-8b
پوشش اعلامی ۲۳ زبان، از جمله فارسی و اسپانیایی؛ زمینهٔ ۸٬۱۹۲ توکن و مجوز عمومی غیرتجاری.
تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار
دستیار کوچک با انتخاب حالت فکرکردن
SmolLM3 سهمیلیاردی دو حالت پاسخ مستقیم و استدلال دارد؛ زمینهٔ آموزش ۶۵٬۵۳۶ توکن است و جزئیات آموزش منتشر شدهاند.
برای زمینهٔ بلندتر تنظیم YaRN لازم است. متن کارت شش زبان بومی از جمله آلمانی را نام میبرد، اما برچسبهای مخزن هشت زبان متفاوت دارند؛ فارسی در هیچیک نیست. Transformers نسخهٔ ۴٫۵۳ یا بالاتر لازم است.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی
دستیار ابزارمحور با معماری MoE
Qwen3-30B-A3B از خبرگان انتخابی استفاده میکند و از الگوی Qwen-Agent برای اتصال ابزارها بهره میبرد.
شمار پارامتر فعال، جای حجم کل وزن را در برآورد حافظه نمیگیرد؛ مدل باید با قالب پیام و parser سازگار اجرا شود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
استدلال، برنامهنویسی، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، فراخوانی ابزار
تحلیل چندمرحلهای با نسخهٔ متراکم بزرگ Qwen3
Qwen3-32B برخلاف نسخهٔ 30B-A3B معماری متراکم دارد؛ حالت استدلال را میتوان متناسب با پیچیدگی پرسش تنظیم کرد.
برای مقایسهٔ پاسخ مستقیم و thinking، طول خروجی و شرایط یکسان نگه داشته شود؛ این معرفی رتبهٔ کیفیت نیست.، این مدل عمومی است؛ مدل اختصاصی Coder قالب ابزار و آموزش متفاوت دارد.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار
گفتوگو و کار با متن با کنترل فکرکردن
Qwen3-8B مدل عمومی متراکم با ۸٫۲میلیارد پارامتر اعلامشده است؛ پاسخ مستقیم و reasoning را در قالب پیام انتخاب میکنید.
برای شروع محلی، فایلهای رسمی Q4_K_M و Q8_0 موجودند؛ کیفیت یا حافظهٔ اجرای آنها در این راهنما اندازهگیری نشده است.، بازیابی، درج سند و بررسی استنادها بر عهدهٔ سامانه است؛ این رابطه بنچمارک RAG یا فارسی نیست.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
برنامهنویسی، فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال
اصلاح مخزن کد با دستیار ابزارمحور
Qwen3-Coder-30B-A3B-Instruct برای تولید کد، ویرایش مخزن و گردشکار عامل برنامهنویسی تنظیم شده؛ زمینهٔ بومی ۲۶۲٬۱۴۴ توکن دارد.
این نسخه non-thinking است؛ قالب فراخوانی ابزار مخصوص Coder را رعایت کنید و آن را با Qwen3-30B-A3B عمومی یکی نگیرید.، ابزارهای فایل، آزمون و اجرا در برنامهٔ میزبان فراهم میشوند.، این checkpoint فقط پاسخ مستقیم تولید میکند؛ حالت thinking جداگانه ندارد.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
نسخهٔ ۰٫۶میلیاردی Qwen3-Reranker برای امتیازدادن به ارتباط query و document با دستور وظیفه تنظیم شده است.
قالب مخصوص reranker و امتیاز yes/no لازم است؛ از مسیر chat یا تولید embedding استفاده نکنید.، سازگاری نسخهمند llama.cpp: ورودی RANK بزرگتر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیشانتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمیکند.
Qwen3-Reranker-4B گزینهٔ میانی این خانواده است؛ پرسش، دستور بازیابی و متن سند در محاسبهٔ ارتباط شرکت دارند.
فقط اسناد نامزد را به این مرحله بدهید؛ افزایش تعداد جفتهای پرسش–سند هزینهٔ مرحلهٔ دوم را بالا میبرد.، سازگاری نسخهمند llama.cpp: ورودی RANK بزرگتر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیشانتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمیکند.
Qwen3-Reranker-8B بزرگترین بازرتبهبند این مجموعه است؛ به جفت پرسش و سند امتیاز ارتباط میدهد.
برای انتخاب در برابر نسخهٔ ۴میلیاردی، کیفیت جستوجو و زمان روی اسناد خودتان را بسنجید؛ از اندازه رتبه نسازید.، سازگاری نسخهمند llama.cpp: ورودی RANK بزرگتر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیشانتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمیکند.
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار
نمونهسازی چندوجهی با Qwen3.5 کوچک
Qwen3.5-2B کوچک برای نمونهسازی و تنظیم دقیق وظیفهمحور معرفی شده؛ ورودی بصری را همراه متن میپذیرد.
کیفیت نسخههای بزرگتر خانواده به این مدل دوملیاردی تعمیم داده نمیشود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی
عامل چندوجهی با Qwen3.5 از نوع MoE
نسخهٔ 35B-A3B از پایهٔ یکپارچهٔ متن و تصویر و معماری ترکیبی بهره میبرد و برای گردشکار چندمرحلهای قابل بررسی است.
سرویس میزبانیشدهٔ Qwen3.5-Flash با ابزارها و زمینهٔ پیشفرض متفاوت عرضه میشود؛ مشخصات API را به وزن محلی تعمیم ندهید.، تنظیمات چندوجهی و محدودیت تصویر را از راهنمای همین وزن بخوانید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار
پردازش متن و تصویر در اندازهٔ چهار میلیارد
Qwen3.5-4B از نسل متن–تصویر یکپارچه است؛ برای آزمودن استخراج اطلاعات از سند در اندازهای کوچکتر از 9B قابل بررسی است.
برای سند اسکنشده به مسیر چندوجهی نیاز دارید؛ سقف زمینهٔ متنی، تعداد تصاویر قابل پردازش را تعیین نمیکند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار
دستیار اسناد و تصویر با Qwen3.5 متراکم
نسخهٔ 9B از Qwen3.5 ترکیب متن و تصویر را در معماری متراکم این خانواده عرضه میکند.
مقایسه با 4B باید بر دادهٔ سند یکسان و تنظیم تصویر یکسان باشد؛ شمار پارامترهای بخش زبان و بینایی را جدا بخوانید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی
گردشکار طولانی با عامل متن–تصویر
Qwen3.8-27B مدل متراکم متن–تصویر با کنترل thinking است؛ تمرکز معرفی آن بر کدنویسی، پژوهش و کارهای چندمرحلهای است.
قابلیتهای وعدهدادهشدهٔ سرویس ابری، مانند ابزارهای داخلی و زمینهٔ پیشفرض، جزء تضمین وزن محلی نیستند.، اندازهٔ تصویر و شیوهٔ نمونهبرداری فریمها بخشی از شرایط استفادهاند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار
آزمایش استدلال تقطیرشده از R1-0528
این مدل از پسآموزش Qwen3-8B-Base با زنجیرههای استدلال DeepSeek-R1-0528 به دست آمده؛ با Qwen3-8B معمولی متفاوت است.
بنچمارکهای مدل کامل R1-0528 متعلق به این نسخهٔ هشتمیلیاردی نیستند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی
حل مسئله با تقطیر R1 در اندازهٔ میانی
DeepSeek-R1-Distill-Qwen-14B از Qwen2.5-14B و دادهٔ تولیدی R1 استفاده میکند؛ وزن آن متعلق به مدل کامل R1 نیست.
اعداد گزارششده فقط برای همین نسخه و تنظیمات آزمون معتبرند؛ از مقایسهٔ نامتجانس با پاسخ مستقیم پرهیز کنید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی
تحلیل و کدنویسی با تقطیر متراکم ۳۲میلیاردی
نسخهٔ Qwen-32B مسیر تقطیر R1 را روی پایهٔ Qwen2.5 دنبال میکند.
توان استدلال اعلامشده، ابزارخوانی یا اجرای کد خودکار نیست؛ ابزار و اعتبارسنجی جواب باید در برنامه فراهم شود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی
حل مسئله با نسخهٔ هفتمیلیاردی تقطیر R1
این مدل از Qwen2.5-Math-7B بهعنوان پایه استفاده میکند؛ با تقطیر جدیدتر R1-0528 روی Qwen3 یکی نیست.
قالب و tokenizer همین مخزن را نگه دارید؛ مقایسه با نسخهٔ هشتمیلیاردی نیازمند آزمون مشترک است.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی
پیوند استدلال و ابزار در گردشکار عامل
DeepSeek-V3.2 توجه تنک DSA و پسآموزش عاملمحور را ترکیب میکند؛ قالب چت آن نسبت به نسخههای پیشین تغییر کرده است.
از قالب و مسیر اجرای مخصوص V3.2 استفاده کنید؛ نتایج نسخهٔ Speciale در پروندهٔ این مدل قابل انتقال نیستند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی
عامل چندوجهی برای ورودیهای بسیار بلند
DeepSeek-V4.1-Flash متن و تصویر را در معماری CED پردازش میکند؛ شمار پارامتر فعال در prefill و decode متفاوت است.
پارامتر فعال را یک عدد ثابت فرض نکنید؛ فشردهسازی KV و مسیر اجرای ویژه، بخشی از معماری این نسخهاند.، مسیر اجرای ویژهٔ CED را رعایت کنید؛ این رابطه، نتیجهٔ ارزیابی OCR نیست.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
استدلال، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار
استدلال چندوجهی با Gemma 4 از نوع MoE
Gemma 4 26B-A4B مدل خبرگانی با کنترل thinking و زمینهٔ ۲۶۲٬۱۴۴ توکن است؛ با نسخهٔ کوچک E2B معماری یکسانی ندارد.
این نسخه ورودی صوت ندارد؛ شمار پارامتر فعال با کل وزنهای مدل متفاوت است.، مسیر processor تصویر لازم است؛ قابلیت صوت E2B به این مدل تعمیم داده نشده است.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار
پردازش محلی متن، تصویر و صوت با Gemma 4 کوچک
Gemma 4 E2B برای اجرای روی دستگاه معرفی شده و ورودی صوت را نیز پشتیبانی میکند؛ E2B شمار مؤثر است، نه کل وزنها.
در محاسبهٔ حافظه از شمار کل و فایل واقعی استفاده کنید؛ مسیر صوت و تصویر به processor متناظر نیاز دارد.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
تولید پاسخ از سند، استخراج ساختیافته، تولید متن، برنامهنویسی، فراخوانی ابزار
تولید پاسخ از اسناد بازیابیشده
Granite 3.3 2B Instruct مدل کوچک کسبوکارمحور با RAG، خلاصهسازی، استخراج متن و حالت تفکر است.
سند باید توسط سامانه بازیابی و در پیام درج شود؛ خود مدل جای موتور جستوجو نیست و فارسی جزو ۱۲ زبان اعلامشده نیست.، خروجی را با schema برنامه اعتبارسنجی کنید؛ قالب دلخواه بهتنهایی تضمین JSON معتبر نیست.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
برنامهنویسی، فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، درک تصویر
عامل ویرایش چندفایلی و جستوجوی مخزن
Devstral Small 2 برای مهندسی نرمافزار و استفاده از ابزار برای بررسی و اصلاح کد ساخته شده؛ این نسل ورودی تصویر نیز دارد.
وزن Instruct این مخزن FP8 است؛ قالب Mistral و وابستگیهای اجرای همین نسخه را رعایت کنید، نه تنظیمات عمومی یک مدل چت.، ابزارهای عامل و قالب Mistral باید با نسخهٔ مدل سازگار باشند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
درک تصویر، استخراج ساختیافته، تولید متن، تولید پاسخ از سند، برنامهنویسی، فراخوانی ابزار
دستیار چندزبانهٔ متن و تصویر
Mistral Small 3.1 24B Instruct پردازش تصویر و زمینهٔ بلند را به نسل Small افزوده؛ فارسی در فهرست زبانهای ناشر آمده است.
برای ابزار و خروجی JSON، قالب و parser متناظر لازم است؛ اعداد مدل Base را با Instruct ترکیب نکنید.، parser و اعتبارسنجی schema را در لایهٔ برنامه تنظیم کنید.
پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده
تولید پاسخ از سند، تولید متن، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار
پاسخ از سند با کنترل بودجهٔ استدلال
Nemotron Nano 9B v2 ترکیبی از Mamba-2 و attention است؛ حالت reasoning و بودجهٔ فکرکردن را میتوان کنترل کرد.
سندهای بازیابیشده باید از بیرون وارد شوند؛ شش زبان اعلامشده شامل فارسی نیستند و backend باید معماری ترکیبی را پشتیبانی کند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال
عامل با استدلال قابل تنظیم در نسخهٔ بزرگ gpt-oss
gpt-oss-120b مدل MoE با ۱۱۷میلیارد پارامتر کل و ۵٫۱میلیارد فعال است؛ وزنهای خبرگان با MXFP4 عرضه شدهاند.
قالب harmony برای اجرای درست لازم است؛ ابزار مرورگر یا Python را برنامهٔ میزبان فراهم میکند و حافظهٔ ادعایی ناشر آزمون این سایت نیست.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، فراخوانی ابزار
استدلال محلی با نسخهٔ کوچکتر gpt-oss
gpt-oss-20b با ۲۱میلیارد پارامتر کل و ۳٫۶میلیارد فعال برای کاربرد محلی یا تخصصی معرفی شده؛ سه سطح reasoning دارد.
قالب harmony و backend سازگار با MXFP4 لازماند؛ نام 20B را جای شمار واقعی وزنها در محاسبات نگذارید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.
فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی
عامل برنامهنویسی با استدلال حفظشونده
GLM-4.7-Flash مدل MoE از ردهٔ 30B-A3B است؛ کارت مدل برای کارهای عامل چندمرحلهای به حفظ thinking بین نوبتها اشاره میکند.
مسیرهای vLLM و SGLang به نسخههای توسعهای مشخص وابستهاند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.
تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر
عامل چندوجهی برای کدنویسی از طرح تصویری و تحلیل سند
—
برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد.
تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر
دستیار چندوجهی برای تحلیل، کد و سند
—
برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد.
تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر
مدل کوچک برای نمونهسازی و تخصصیسازی وظیفه
—
برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد.
تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر
مدل چندوجهی MoE برای تحلیل و کار با ابزار
—
برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد.
تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر
دستیار چندوجهی بزرگ برای مسائل پیچیده
—
برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد.
رمزگذار پایه برای آموزش دستهبندی و استخراج موجودیت
—
برای اجرای llama.cpp از b11532+ استفاده شود؛ نسخههای قدیمی hidden_activation=gelu را با تقریب tanh اجرا میکردند. GGUF موجود نیاز به تبدیل دوباره ندارد؛ خروجی buildهای قدیمی باید بازآزمایی شود.، رمزگذار دوسویه؛ خروجی توکن یا هد آموزشدیدهٔ وظیفه
گزینهٔ تخصصیتر برای زبان اسپانیایی و زبانهای ایبری؛ گونهٔ 2B دستورپذیر با نتایج منتشرشدهٔ اسپانیایی. نقطهٔ مرجع زبانی است، نه برندهٔ عمومی یا گزینهٔ اثباتشده برای فارسی.
گزینهٔ تخصصیتر برای زبان اسپانیایی و زبانهای ایبری؛ گونهٔ 7B دستورپذیر با نتایج منتشرشدهٔ اسپانیایی. نقطهٔ مرجع زبانی است، نه برندهٔ عمومی یا گزینهٔ اثباتشده برای فارسی.
مدل کوچکِ دستورپذیر برای بررسی در کارهای استدلال و ابزار؛ اندازهٔ واقعی ثبتشده حدود ۲٫۵۲ میلیارد پارامتر است. امتیازهای ناشر را از امتیازهای نقلشده از Artificial Analysis جدا کنید؛ شاهد فارسی یا اسپانیایی در این بسته ندارد.
گزینهٔ کوچک برای استخراج اطلاعات و کارهای محدود روی دستگاه؛ ناشر آن را برای برنامهنویسی و کارهای دانشمحور توصیه نمیکند. اسپانیایی در زبانهای اعلامشده هست؛ نتیجهٔ اختصاصی فارسی ثبت نشده است.
گونهٔ استدلالی Granite با حالتهای thinking و non-thinking؛ برچسب 3B نام اندازه است و شمار ثبتشدهٔ پارامترها حدود ۳٫۶۶ میلیارد است. حد بومی ۱۲۸K را از ادعای گسترش تا ۵۱۲K جدا نگه دارید.
امتیازدهی به ارتباط پرسش با متن، تصویر یا ویدئو؛ بازرتبهبندی نتایج بازیابی با ورودی تا ۳۲ هزار توکن.
سازگاری نسخهمند llama.cpp: ورودی RANK بزرگتر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیشانتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمیکند.
امتیازدهی به ارتباط پرسش با متن، تصویر یا ویدئو؛ بازرتبهبندی نتایج بازیابی با ورودی تا ۳۲ هزار توکن.
سازگاری نسخهمند llama.cpp: ورودی RANK بزرگتر از n_ubatch به b11223+ حاوی اصلاح #28876 و attention علّی در زمان اجرا نیاز دارد. b11223 پیشانتشار/آزمایشی است؛ این اصلاح پشتیبانی کامل چندوجهی /rerank یا /embedding، کیفیت بلندمتن یا آمادگی تولیدی را تأیید نمیکند.
مدل چندوجهی شیائومی برای کدنویسی، کار با ابزارها و بررسی ورودیهای طولانی؛ وزنهای نسخهٔ RL با مجوز MIT منتشر شدهاند.
حدود ۱٫۰۲ تریلیون پارامتر کل و ۴۲ میلیارد فعال؛ فایلهای وزن ۵۳۴٫۱ GiB هستند. این نسخه برای یک کارت ۲۴ یا ۴۸ گیگابایتی جا نمیشود.، امتیاز ۴۶ در شاخص هوش Artificial Analysis نسخهٔ ۴٫۳٫۲ برای سرویس MiMo-V2.6-Pro؛ این نتیجه آزمون فارسی یا آزمون اجرای محلی نسخهٔ RL نیست.
بردارساز چندوجهی محلی با وزن رسمی Apache-2.0؛ نسل قبلی EmbeddingGemma جدا در جدول میماند.
پیش از انتخاب برای RAG متنی فارسی، بازیابی روی پیکرهٔ فارسی را با پرسشها و اسناد یکسان در ۷۶۸ و ۲۵۶ بعد مقایسه کنید؛ کیفیت فارسی و حافظهٔ واقعی نامعلوماند.
تولید متن، برنامهنویسی، استدلال، فراخوانی ابزار، درک تصویر
استدلال، کدنویسی و تحلیل تصویری
مدل چندوجهی Muse Spark Open با ۸۱۶B کل و ۴۲B فعال؛ دریافت وزن نیازمند تأیید دسترسی و پذیرش مجوز اختصاصی است.
مجوز Muse Model License محدودیت خاص Model-as-a-Service دارد: درآمد تجمیعی بیش از ۲۰ میلیون دلار در هر دورهٔ ۱۲ماهه، برای عرضهٔ مدل در آن کسبوکار به اطلاع Meta و توافق جداگانه نیاز دارد. پذیرش شرایط و بررسی سیاست استفاده لازم است.
تولید متن، برنامهنویسی، استدلال، فراخوانی ابزار، درک تصویر، استخراج ساختیافته
استدلال، کدنویسی و درک سند و ویدئو
مدل دیداری–زبانی ترکیبی Mamba-2/Transformer/MoE با ورودی متن، تصویر و ویدئو و خروجی متن.
مثال کارت از vLLM nightly با commit 3f1bcfd82bb2e93fcd364fc7a5491718453a77e2 استفاده میکند؛ پشتیبانی vLLM 0.31 پایدار از آن نتیجه نمیشود. Ollama 0.40.5 پشتیبانی Super را اعلام کرده است.
تولید متن، برنامهنویسی، استدلال، فراخوانی ابزار، درک تصویر، استخراج ساختیافته
عامل محلی، کدنویسی و درک تصویر
مدل چندوجهی ۷۴B با ۹B فعال و بستهٔ رسمی IQ2 با هدف اجرای ۲۴GB؛ برآورد کامل سرویس ثبت نشده است.
24GB نام بسته و هدف ناشر است؛ جاشدن تمام زمینهٔ 256K تضمین نشده است. وزن، projector، حافظهٔ KV، drafter و سربار باید جدا بودجهبندی شوند.، نمونهٔ vLLM از nightly-77154ca6116ae34cbfe314beef1016bde9b63989 استفاده میکند؛ تأیید v0.31 پایدار نیست. llama.cpp 0.7.0 پشتیبانی Bolt را دارد.
تولید متن، برنامهنویسی، استدلال، فراخوانی ابزار، درک تصویر
استدلال، کدنویسی، عامل و ورودی تصویری
snapshot مستقل ۱۷ اکتبر DeepSeek-V4.1-Flash با وزن Safetensors و مجوز MIT؛ ردیف و نتایج انتشار قبلی حفظ شدهاند.
قالب Jinja در این انتشار نیست؛ encoder مرجع و deepseek-recipe برای ساخت پیام معرفی شدهاند. پشتیبانی موتور نسخهٔ قبلی به snapshot 1017 منتقل نشده است.، پشتیبانی معماری deepseek41 در llama.cpp b11870 اضافه شده است؛ اجرای snapshot 1017 با artifact تبدیلشده و backend منتخب همچنان نیازمند اعتبارسنجی است.
مدل متنی استدلالی MoE با ۲۴٫۰B کل، ۲٫۴۵B فعال و زمینهٔ ۱۳۱٬۰۷۲؛ گونههای رسمی FP8، GGUF و MLX دارد.
۱۲ اکتبر تاریخ ایجاد مخزن اصلی است؛ زمان نخستین انتشار همهٔ گونهها تأیید نشده است. ۲٫۴۵B فعال، حجم ۲۴B وزن کل را تعیین نمیکند.، LFM Open License v1.0 مجوز تجاری بیقید نیست؛ آستانهٔ درآمد سالانهٔ ۱۰ میلیون دلار و تعریف شخصیت حقوقی و استثنای غیرانتفاعی را در مجوز بررسی کنید.
Granite Switch 4.1 مدل پایهٔ متراکم را با adapterهای تصمیم و Guardian و encoder گفتار در یک بسته ترکیب میکند.
گفتوگو، تصمیم نوعدار و Guardian به مسیر adapter و encoder انتخابی وابستهاند؛ این مدل صرفاً classifier نیست.، مسیر رسمی vLLM به افزونهٔ Granite Switch نیاز دارد. پشتیبانی تصمیم در llama.cpp b11700 پس از 0.7.0 افزوده شده؛ به 0.7.0 نسبت داده نمیشود.
Granite Switch 4.1 مدل پایهٔ متراکم را با adapterهای تصمیم و Guardian و encoder گفتار در یک بسته ترکیب میکند.
گفتوگو، تصمیم نوعدار و Guardian به مسیر adapter و encoder انتخابی وابستهاند؛ این مدل صرفاً classifier نیست.، مسیر رسمی vLLM به افزونهٔ Granite Switch نیاز دارد. پشتیبانی تصمیم در llama.cpp b11700 پس از 0.7.0 افزوده شده؛ به 0.7.0 نسبت داده نمیشود.
مدل استدلالی ۴B با اجرای تکراری لایهها و زمینهٔ اعلامی 256K؛ زبان اعلامی انگلیسی است.
مدل recurrent/looped normalized-GPT است؛ تعداد تکرارها و نسخهٔ موتور بر تأخیر اثر دارند. مثال vLLM به PR #60149 و مسیر llama.cpp به fork/commit اختصاصی وابسته است؛ پیشنهاد پیشفرض تا تأیید مسیر اجرا غیرفعال است.
مدل متن، تصویر و ویدئوی MiniCPM-V 4.7 در نسخهٔ 1B؛ برای درک تصویر، OCR، سند و ویدئو. قالبهای رسمی وزن با اندازهٔ واقعی فایل ثبت شدهاند.
زمینهٔ 262144 از پیکربندی است؛ کیفیت در تمام این طول تأیید نشده است. GGUF به projector سازگار نیاز دارد؛ DSpark کمکی است و مدل مستقل نیست. اعداد حافظه و سرعت iPhone به همهٔ GPUها تعمیم داده نمیشوند.
مدل متن، تصویر و ویدئوی MiniCPM-V 4.7 در نسخهٔ 35B-A3B؛ برای درک تصویر، OCR، سند و ویدئو. قالبهای رسمی وزن با اندازهٔ واقعی فایل ثبت شدهاند.
زمینهٔ 262144 از پیکربندی است؛ کیفیت در تمام این طول تأیید نشده است. GGUF به projector سازگار نیاز دارد؛ DSpark کمکی است و مدل مستقل نیست. اعداد حافظه و سرعت iPhone به همهٔ GPUها تعمیم داده نمیشوند.
مدل تصمیم چندوجهی d3، روی متن یا JSON همراه تصویر و ویدئو، پاسخ انتخابی، بله/خیر یا امتیاز احتمالاتی میدهد؛ متن آزاد یا مقادیر دلخواه استخراج نمیکند.
مدل و readout باید با هم دریافت شوند. مسیر Semantic Router در کانال توسعه است و با پشتیبانی مستقیم موتور عمومی vLLM یکی نیست. حجم بستهٔ Ollama، اندازهٔ دانلود است؛ مصرف واقعی VRAM و KV اندازهگیری نشده است.
مدل تصمیم چندوجهی d3، روی متن یا JSON همراه تصویر و ویدئو، پاسخ انتخابی، بله/خیر یا امتیاز احتمالاتی میدهد؛ متن آزاد یا مقادیر دلخواه استخراج نمیکند.
مدل و readout باید با هم دریافت شوند. مسیر Semantic Router در کانال توسعه است و با پشتیبانی مستقیم موتور عمومی vLLM یکی نیست. حجم بستهٔ Ollama، اندازهٔ دانلود است؛ مصرف واقعی VRAM و KV اندازهگیری نشده است.
مدل تصمیم چندوجهی d3، روی متن یا JSON همراه تصویر و ویدئو، پاسخ انتخابی، بله/خیر یا امتیاز احتمالاتی میدهد؛ متن آزاد یا مقادیر دلخواه استخراج نمیکند.
مدل و readout باید با هم دریافت شوند. مسیر Semantic Router در کانال توسعه است و با پشتیبانی مستقیم موتور عمومی vLLM یکی نیست. حجم بستهٔ Ollama، اندازهٔ دانلود است؛ مصرف واقعی VRAM و KV اندازهگیری نشده است.
مدل تصمیم چندوجهی d3، روی متن یا JSON همراه تصویر و ویدئو، پاسخ انتخابی، بله/خیر یا امتیاز احتمالاتی میدهد؛ متن آزاد یا مقادیر دلخواه استخراج نمیکند.
مدل و readout باید با هم دریافت شوند. مسیر Semantic Router در کانال توسعه است و با پشتیبانی مستقیم موتور عمومی vLLM یکی نیست. حجم بستهٔ Ollama، اندازهٔ دانلود است؛ مصرف واقعی VRAM و KV اندازهگیری نشده است.
مدل کوچک Gemma-4-E4B برای گفتوگوی محلی، ابزارخوانی چندمرحلهای و رابط دستگاه؛ 8B کل و 4B مؤثر. وزن BF16 و GGUF رسمی منتشر شدهاند.
مشخصات پایهٔ NVIDIA: متن و 64K. Ollama برای بستهٔ خود تصویر و 128K اعلام میکند؛ این اختلاف تأیید نشده و فیلتر چندوجهی مدل فعال نیست. GGUF اصلی 6,180,446,208 بایت است؛ نام 4GB حجم فایل یا تضمین VRAM نیست. DFlash کمکی است و جداگانه حافظه میخواهد.
بازرتبهبند چندوجهی با برج زبانی bidirectional Ministral3 و رمزگذار بینایی Pixtral؛ جفت پرسش متنی و سند متنی، تصویری یا ترکیبی را امتیاز میدهد.
برای تصویر از Transformers 5.20.0 استفاده کنید؛ 5.17 تا 5.19 با Flash Attention 2 ممکن است خروجی نادرست یا خطای CUDA بدهند. مسیر چندوجهی vLLM 0.32.0 از /classify و قالب query/document استفاده میکند، نه /score یا /rerank. امتیاز خروجی logit است؛ embedding یا احتمال کالیبرهشده نیست.
حجم واقعی فایل وزن + حافظهٔ KV + ذخیرهٔ اجرایی. برای GGUF، مقدار KV با دقت FP16 محاسبه میشود. ذخیرهٔ پیشفرض GPU دو GiB برای هر کارت و ذخیرهٔ CPU چهار GiB است؛ این ذخیره فرض برنامهریزی است.
مدلهای MoE با تمام وزنها محاسبه میشوند. ظرفیت اسمی کارت بهعنوان بودجهٔ GiB استفاده شده؛ برای استقرار دقیق، حافظهٔ آزاد گزارششدهٔ دستگاه ملاک است. مجموع حافظهٔ چند کارت، حافظهٔ یکپارچه نیست.
در مسیر FP32 مدلهای SmolLM2، وزن و KV هر دو FP32 هستند. سناریوهای بزرگتر از زمینهٔ فایل منتخب نمایش داده نمیشوند؛ از جمله Aya Expanse 32B با فایل GGUF منتخب و زمینهٔ حداکثر ۸٬۱۹۲ توکن.
۶۱نتیجه از ۶۱ ردیف
فیلترهای تخصصی ۱ کنترل
همهٔ ردیفها
مقایسهٔ ردیفها و شرایط آن
قاعدهٔ مقایسه: ماتریس سختافزار را داخل یک ردیف همشرط نشان میدهد؛ مقایسهٔ ردیفها فقط با کنترل همهٔ شرایط غیرسختافزاری معتبر است.
با × کنار عنوان، ستون را پنهان کنید؛ برای دیدن منابع و شرایط، جزئیات ردیف را باز کنید.
ماتریس امکان اجرای artifact روی پیکربندی سختافزار
«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.
برای سنجش همزمانی و طول زمینه، مدل و تعداد GPU را در ابزار زیر کنار هم بگذارید. منطق محاسبه و طراحی آزمون خدمت در یادداشت همراه آمده است. ۱۰۰ کاربر همزمان در یک دستیار هوشمند یعنی چه؟
از تعداد کاربر تا بودجهٔ حافظه
این بار روی کدام GPU جا میگیرد؟
مدل و بار را انتخاب کنید. اگر GPU مشخص نکردهاید، چند نامزد برای آزمون پیشنهاد میشود. «جا دارد» در این ابزار، نتیجهٔ برآورد حافظه است؛ تعهد سرعت و کیفیت خدمت به آزمون نیاز دارد.
فرضهای حافظه و فضای آزاد واقعی
مدل آموزشی: ۸ میلیارد پارامتر، وزن خام BF16، ۳۲ لایه، ۸ سر KV و اندازهٔ سر ۱۲۸. هندسهٔ فعلی: ۳۲ لایه، ۸ سر KV، اندازهٔ سر ۱۲۸.
ذخیرهٔ پیشفرض ۲ GiB، فرض برنامهریزی جدول است؛ مقدار اندازهگیریشده یا سقف سربار نیست. کوانتیدهبودن وزن به معنی KV کمدقت نیست؛ پشتیبانی موتور و اثر دقت کش را جدا بررسی کنید. این تخمین برای توجه کامل است و صرفهجویی Prefix Cache، توجه پنجرهای، MLA یا معماری هیبریدی را فرض نمیکند.
اولین نامزد برای مقایسه: ۱ × GeForce RTX 5090
در برآورد حافظه جا دارد
بودجهٔ پُربارترین GPU۲۴٫۹ GiB
کلاس حافظهٔ هر GPU۳۲ GiB
حاشیهٔ حافظهٔ هر GPU۷٫۱ GiB
سقف نظری درخواست فعال از نظر حافظه۱۵
وزن ۱۴٫۹ GiB
KV ۸ GiB
ذخیره و اجزای دیگر ۲ GiB
برای توزیع متوازن، بیشترین سهم هر GPU برابر ۸ درخواست فرض شده است. وزن مدل در هر GPU دوباره بارگذاری میشود؛ صف و توزیع نامتوازن میتوانند این برآورد را تغییر دهند.
کلاس اسمی حافظهٔ جدول برای غربال اولیه، بهصورت بودجهٔ GiB استفاده شده است؛ برای استقرار، عدد واقعی حافظهٔ آزاد دستگاه را وارد کنید. سقف نظری بالا، ظرفیت پاسخگویی با تأخیر قابل قبول نیست.
نامزدها از فهرست فعلی GPU سایت میآیند و با کمترین تعداد دستگاه و سپس ظرفیت حافظه مرتب شدهاند. قیمت، سرعت و سازگاری این بسته با هر موتور هنوز باید بررسی شود. اگر افزایش تعداد لازم باشد، همان تعداد پیشنهادی کنار نام کارت آمده است.
۱ × GeForce RTX 5090۳۲ GB در هر GPU · حاشیهٔ برآوردی ۷٫۱ GiB
۱ × RTX 6000 Ada۴۸ GB در هر GPU · حاشیهٔ برآوردی ۲۳٫۱ GiB
۲ × GeForce RTX 4090 D۲۴ GB در هر GPU · حاشیهٔ برآوردی ۳٫۱ GiB
نسخههای اعلامشده، بردهای غیررسمی، حافظهٔ یکپارچهٔ سامانهها و ظرفیت تجمیعی چند تراشه در پیشنهادها نیستند. برای AMD و Intel، پشتیبانی بسته، کرنل و موتور اجرا را روی همان مدل و سیستمعامل بررسی کنید.
بار کاربران و تقاضای توکن را هم ببینید
درخواست کاربر در ثانیه
۰٫۸۳۳
فراخوانی مدل در ثانیه
۰٫۸۳۳
تقاضای ورودی، توکن/ثانیه
۳٬۵۸۳٫۳۳
تقاضای خروجی، توکن/ثانیه
۲۷۵
درخواست کاربر در جریان؛ قانون لیتل
۶٫۶۷
قانون لیتل، در وضعیت پایدار، صف و همهٔ مراحل گردشکار را هم میشمارد؛ این عدد خودکار به اسلایدر درخواستهای در حال استنتاج منتقل نمیشود. ورودی و خروجی را جدا سنجیدهایم و زمان پاسخ فرضشده، پیشبینی ابزار نیست.
نسبت تقاضا به ظرفیت اندازهگیریشده: Prefill نیازمند آزمون; Decode نیازمند آزمون.
این دو نسبت فقط غربال اولیهاند؛ تداخل مراحل، P95، جهش بار و Goodput باید زیر بار ترکیبی آزموده شوند. ظرفیت اندازهگیریشدهٔ کل همین چیدمان را وارد کنید؛ ابزار سرعت را با تعداد GPU ضرب نمیکند. پس از تغییر مدل، چیدمان یا طول درخواست، عددهای آزمون پاک میشوند تا نتیجهٔ همان حالت را وارد کنید.
بخش چهارم · دو نمای مستقل
نرمافزارهای اجرا و سرویسدهی
۰۴.۱
نمای دادهای
مقایسهٔ نرمافزارها
نرمافزارهای اجرای محلی و سرویسدهی مدلها را مقایسه کنید.
۷۲نتیجه از ۷۲ ردیف
فیلترهای تخصصی ۳۶ کنترل
همهٔ ردیفها
مقایسهٔ ردیفها و شرایط آن
قاعدهٔ مقایسه: نسخهها آزادانه کنار هم دیده میشوند؛ محور رابط backend را ثابت نگه میدارد و محور کل ترکیب اجازهٔ تفاوت backend میدهد.
با × کنار عنوان، ستون را پنهان کنید؛ برای دیدن منابع و شرایط، جزئیات ردیف را باز کنید.
ستونهای پنهان:
جدول مقایسهٔ محصول و نسخهٔ نرمافزارهای اجرا و سرویسدهی
مقایسه
جزئیات
برای چه کاری؟
مزیت کاربردی
شرط انتخاب
شروع کار
Ollama · v0.40.2
موتور / کتابخانهٔ استنتاج، سرور API، مدیر مدل
شروع محلی، توسعه و سرویس کوچک
دریافت و مدیریت مدل و راهاندازی API در یک ابزار
اجرای محلی و ابری جدا هستند؛ OLLAMA_NO_CLOUD=1 مسیرهای ابری را غیرفعال میکند. Ollama v0.40.2 پایدار / Latest: روی Apple Silicon فقط معماریهای تأییدشده بهطور پیشفرض با MLX اجرا میشوند: Qwen3.8، Qwen3.6، Qwen3.5، Gemma 4، Nimble، Tev1، Clef، Clef Flash و EmbeddingGemma 2. این رفتار به همهٔ مدلها، اندازهها، کوانتیزهها، ورودیها یا سیستمعاملها تعمیم داده نشود؛ تگ و فایل سازگار هر مسیر جداگانه بررسی شود. مدلهای تصمیم فقط خروجی نوعدار دارند و برای chat، tools یا thinking نیستند. کیفیت فارسی، سرعت و حافظهٔ واقعی این مسیر آزمون نشدهاند. در نخستین اجرای هر مدل قدیمی، مهاجرت در پسزمینه انجام میشود و نسخهٔ اصلی موقتاً روی دیسک میماند. پیش از ارتقا فضای آزاد دیسک را بررسی کنید؛ حذف خودکار پشتیبانها برای انتشار بعدی وعده داده شده است. شرط Windows/Clef Flash یعنی v0.40.1+ حفظ میشود.
تولید متن، ساخت embedding، خروجی جریانی، خروجی ساختاریافته Ollama v0.40.0 پایدار؛ نسخهٔ تاریخی: روی Apple Silicon فقط معماریهای تأییدشده بهطور پیشفرض با MLX اجرا میشوند: Qwen3.8، Qwen3.6، Qwen3.5، Gemma 4، Nimble، Tev1، Clef، Clef Flash و EmbeddingGemma 2. این رفتار به همهٔ مدلها، اندازهها، کوانتیزهها، ورودیها یا سیستمعاملها تعمیم داده نشود؛ تگ و فایل سازگار هر مسیر جداگانه بررسی شود. مدلهای تصمیم فقط خروجی نوعدار دارند و برای chat، tools یا thinking نیستند. کیفیت فارسی، سرعت و حافظهٔ واقعی این مسیر آزمون نشدهاند.
Ollama v0.40.0 پایدار؛ نسخهٔ تاریخی: روی Apple Silicon فقط معماریهای تأییدشده بهطور پیشفرض با MLX اجرا میشوند: Qwen3.8، Qwen3.6، Qwen3.5، Gemma 4، Nimble، Tev1، Clef، Clef Flash و EmbeddingGemma 2. این رفتار به همهٔ مدلها، اندازهها، کوانتیزهها، ورودیها یا سیستمعاملها تعمیم داده نشود؛ تگ و فایل سازگار هر مسیر جداگانه بررسی شود. مدلهای تصمیم فقط خروجی نوعدار دارند و برای chat، tools یا thinking نیستند. کیفیت فارسی، سرعت و حافظهٔ واقعی این مسیر آزمون نشدهاند.
continuous batching و مدیریت KV cache؛ API سازگار با OpenAI
نسخهٔ تاریخی؛ برای GGUF، افزونهٔ vllm-gguf-plugin جدا نصب میشود؛ پشتیبانی این قالب آزمایشی است. GHSA-x6mc-67gf-chw4: آسیبپذیری مشروط در 0.24.0 تا پیش از 0.30.0؛ frontend پایتون با sampler ویدئویی Qwen2-VL/Qwen3-VL و ورودی media_io_kwargs.video.max_frames و fps میتواند دچار DoS حافظه شود؛ انتخاب sampler از درخواست نیز ممکن است. --limit-mm-per-prompt تعداد اقلام را محدود میکند، نه فریمها؛ در نسخههای متأثر --api-key بهتنهایی /tokenize و /invocations را محافظت نمیکند. Rust frontend این ورودی را رد میکند و فقط از همین مورد متأثر نیست. ارتقا به 0.30.0 رفع اعلامشده است؛ احراز هویت در gateway و محدودیت منابع کنترل تکمیلیاند. GHSA-85xf-c7hm-whqw: خروجی ساختاریافتهٔ معیوب ممکن است EngineCore مشترک را متوقف کند؛ دامنهٔ اعلامشده <0.30.0 است، اما گزارش آزمایش را روی 0.25.1 تأیید میکند و حد پایین را مشخص نکرده است. GHSA-5fj9-pfhr-6j48: فقط Rust frontend فعال، پیش از 0.30.0؛ methodهای دلخواه HTTP در برچسبهای Prometheus رشد حافظه میسازند، حتی پاسخ 405 روی /tokenize. GHSA-58v5-2m8f-94pr: از 0.23.0rc2 تا پیش از 0.30.0؛ مدل ویدئوپذیر با media_io_kwargs و انتخاب GLMGA میتواند پیش از decode مصرف CPU/حافظه را بالا ببرد؛ با API key فعال به کلید معتبر نیاز دارد. هر سه مورد آخر نیز طبق هشدار در 0.30.0 رفع شدهاند.
سرویسدهی مدل زبانی و چندرسانهای روی یک GPU یا خوشه
تولید متن، بستهبندی پیوستهٔ درخواستها، کش پیشوند، خروجی ساختاریافته انتخاب parser ابزار و کرنل کوانت به معماری مدل وابسته است. از 0.5.20 بسته و ایمیج CUDA 12 منتشر نمیشود؛ 0.5.19 آخرین نسخهٔ این مسیر است و ایمیجهای قبلی باقیاند. ذخیرهٔ Responses پیشفرض غیرفعال است؛ بازیابی پاسخ، previous_response_id و درخواست پسزمینه به --enable-response-store نیاز دارند. در استقرار با جداسازی پردازش ورودی و تولید خروجی (PD)، این گزینه قابل فعالسازی نیست.
انتخاب parser ابزار و کرنل کوانت به معماری مدل وابسته است. از 0.5.20 بسته و ایمیج CUDA 12 منتشر نمیشود؛ 0.5.19 آخرین نسخهٔ این مسیر است و ایمیجهای قبلی باقیاند. ذخیرهٔ Responses پیشفرض غیرفعال است؛ بازیابی پاسخ، previous_response_id و درخواست پسزمینه به --enable-response-store نیاز دارند. در استقرار با جداسازی پردازش ورودی و تولید خروجی (PD)، این گزینه قابل فعالسازی نیست.
پشتیبانی ARM64 و SM121 برای GB10 و مسیر اولیهٔ AMD/ROCm اضافه شده است؛ این اعلام به معنی تأیید همهٔ GPUهای AMD نیست. نوع وظیفه و pooling به مدل بستگی دارد.
اجرای محلی و کمدقتسازی مدلهای سازگار روی Apple silicon
تولید متن (مشروط)، خروجی جریانی (مشروط)، کش پیشوند (مشروط)، تقسیم مدل میان GPUها (مشروط) مسیر مستقیم برای اجرای محلی و کمدقتسازی مدلهای سازگار روی Apple silicon. حافظهٔ مشترک را دوباره بهصورت RAM+VRAM جمع نزنید. شرط macOS 15 در README مربوط به memory wiring مدلهای بزرگ است، نه حداقل قطعی همهٔ کاربردهای MLX LM.
مسیر مستقیم برای اجرای محلی و کمدقتسازی مدلهای سازگار روی Apple silicon. حافظهٔ مشترک را دوباره بهصورت RAM+VRAM جمع نزنید. شرط macOS 15 در README مربوط به memory wiring مدلهای بزرگ است، نه حداقل قطعی همهٔ کاربردهای MLX LM.
پایدار؛ رفع GHSA-x6mc-67gf-chw4، GHSA-85xf-c7hm-whqw، GHSA-5fj9-pfhr-6j48 و GHSA-58v5-2m8f-94pr طبق هشدارهای رسمی. هنگام ارتقا از 0.29: GPTQ activation ordering مبتنی بر g_idx حذف شده و g_idx نادیده گرفته میشود؛ checkpoint وابسته به آن نیاز به بازبینی دارد. در vllm serve معمولی، scale-out با --enable-scale-out فعال میشود و VLLM_ENABLE_SCALE_OUT_ENDPOINTS حذف شده؛ launch render و --tokens-only استثنا هستند. بستهٔ پیشفرض CUDA 13.0 و بسته/ایمیج جداگانهٔ CUDA 12.9 عرضه شدهاند؛ سازگاری GPU و درایور با بستهٔ انتخابی بررسی شود. نتایج نسخههای قبلی به این نسخه منتقل نشدهاند.
RPC پروتکل ۷؛ کلاینت و سرورها باید با یکدیگر سازگار باشند.
در اتصال RPC، major کلاینت و همهٔ سرورها باید یکسان باشد و minor سرور از کلاینت بالاتر نباشد. build دو سمت را هماهنگ کنید؛ v0.4.1 با پروتکل ۶ را به v0.5.0 با پروتکل ۷ وصل نکنید. اصلاحها و قابلیتهای پیشانتشار در ردیف نسخهٔ خودشان آمدهاند.
پیشانتشار b11262؛ اصلاح صحت محاسبه در CPU. در مسیر AVX512-FP16، انباشت FP16 در dot productهای F16 ممکن بود overflow کند و logits متفاوتی بدهد؛ b11262 انباشت را به FP32 منتقل میکند. برای این مسیر، خروجی buildهای قدیمیتر را پیش از اتکا روی b11262+ حاوی اصلاح #29545 بازآزمایی کنید. این اصلاح شاهد افزایش سرعت نیست و پیشانتشار، انتخاب پیشفرض تولیدی نمیشود.
نسخهٔ پایدار؛ تصمیمگیری نوعدار با /v1/systemone برای Nimble، Tev1، Clef و Clef Flash
ورودی متن و تصویر Clef/Clef Flash؛ choice، noul و score؛ قابلیت decision
نسخهٔ پایدار v0.35.1: /v1/systemone برای مدل تصمیم سازگار، پرسشهای choice، noul و score را میپذیرد؛ Clef و Clef Flash متن و تصویر را با هم میسنجند. CAPABILITY decision باید برای مدل سازگار اعلام شود؛ کلاینت نباید آن را برای chat، tools یا thinking پیشنهاد کند. این API تولید متن آزاد ندارد. یادداشت انتشار فقط به بهروزرسانی llama.cpp و MLX اشاره میکند و سازگاری تفکیکی backendها را تأیید نمیکند. برای Nimble و Tev1 نیز فایل Safetensors بهتنهایی دلیل اجرای همان فایل با SystemOne نیست؛ artifact سازگار را جداگانه بررسی کنید. آزمون محلی و ارزیابی کیفیت فارسی انجام نشده است.
پیشانتشار؛ اصلاح ایمنی حافظهٔ IQ4_NL در CUDA/HIP/MUSA. برای این مسیر حداقل b11310+ حاوی #29683 لازم است. اگر تعداد عناصر مضرب QK4_NL ولی نه QK_K باشد، آخرین بلوک میتوانست از انتهای ورودی بخواند و بیرون بافر خروجی بنویسد؛ مضربهای QK_K از این خطا متأثر نیستند. در آزمون اشکالزدایی نویسنده با ۱۹۲ عنصر، نوشتن خارجازمحدوده از ۱۲۸ به صفر بایت رسید (CUDA H20-3e و MUSA S5000)؛ HIP از کد مشترک استفاده میکند، نه اینکه آزمون مستقلی گزارش شده باشد. تا بازبینی ۱ اکتبر ۲۰۲۶، منابع بررسیشده CVE یا امکان بهرهبرداری اعلام نکردهاند. این اصلاح شاهد افزایش سرعت یا تغییر نیاز حافظه نیست.
ترتیب layer input؛ KV streamهای جدا و tensor split
پیشانتشار؛ اصلاح ترتیب layer input برای DFlash/DFlash2 و چند sequence. برای concurrency بیش از یک، بهویژه با KV streamهای جدا، از b11307+ حاوی #29019 استفاده کنید؛ اصلاح با tensor split نیز سازگار است. شکستن batch میتوانست hidden state توکن دیگری را به drafter بدهد؛ اصلاح ترتیب اصلی را بازمیگرداند. در SPEED-Bench نویسنده با Qwen3.8-27B و DFlash2، هر دو Q4_K_M و concurrency=16، میانگین طول پذیرش از 3.3531 به 3.9211 رسید (+16.94%). این نتیجه سرعت نهایی، کیفیت فارسی یا عملکرد مدلها و سختافزارهای دیگر را ثابت نمیکند. گزارش #27117 زمینهٔ افت پذیرش است؛ رفع همهٔ موارد آن تأیید نشده است. آزمون محلی انجام نشده و پیشانتشار انتخاب پیشفرض تولیدی نیست.
این ساخت Clef را فقط با متن پشتیبانی میکند؛ تصویر در v0.6.0 اضافه شده است
b11371 پشتیبانی اولیهٔ Clef را فقط برای متن اضافه کرده است. پشتیبانی تصویری در v0.6.0 پایدار با GGUF و projector سازگار اضافه شد؛ محدودیت این ساخت به نسخههای جدید یا Ollama v0.35.1 تعمیم ندارد. b11371 پیشانتشار است؛ آزمون محلی، کارایی و کیفیت فارسی تأیید نشدهاند.
پایدار؛ llama.cpp / llama-server با تصمیمگیری متنی و تصویری Clef
دستهبندی (مشروط) v0.6.0 پایدار پشتیبانی تصویری Clef را با /v1/systemone اضافه میکند. به GGUF با قالب جدید و projector سازگار (--mmproj) نیاز است؛ فایلهای قدیمی ممکن است به تبدیل مجدد نیاز داشته باشند. کل prompt باید در --ubatch-size جا شود؛ تصویر با data URL فرستاده میشود. پاسخها choice، noul یا score هستند و سرور Clef تولید متن آزاد ندارد. اصلاح Vulkan FlashAttention #29988 نیز در این نسخه وجود دارد. کیفیت فارسی، سرعت و مصرف کامل حافظه آزموده نشدهاند.
v0.6.0 پایدار پشتیبانی تصویری Clef را با /v1/systemone اضافه میکند. به GGUF با قالب جدید و projector سازگار (--mmproj) نیاز است؛ فایلهای قدیمی ممکن است به تبدیل مجدد نیاز داشته باشند. کل prompt باید در --ubatch-size جا شود؛ تصویر با data URL فرستاده میشود. پاسخها choice، noul یا score هستند و سرور Clef تولید متن آزاد ندارد. اصلاح Vulkan FlashAttention #29988 نیز در این نسخه وجود دارد. کیفیت فارسی، سرعت و مصرف کامل حافظه آزموده نشدهاند.
اصلاح دسترسی خارج از محدوده در Vulkan FlashAttention
Vulkan + FlashAttention؛ اصلاح نوشتن در حافظهٔ اشتراکی
b11424 اصلاح #29988 را برای نوشتن خارج از محدودهٔ حافظهٔ اشتراکی در Vulkan FlashAttention دارد؛ گزارش رسمی به crash نوع DeviceLost روی NVIDIA اشاره میکند. برای مسیر متأثر از b11424+ حاوی این اصلاح یا نسخهٔ پایدار v0.6.0 استفاده و workload را بازآزمایی کنید. این اصلاح شاهد افزایش سرعت، CVE یا بهرهبرداری اثباتشده نیست؛ تخمین VRAM تغییر نمیکند.
حداقل مسیر llama.cpp برای پنج مدل K2 Horizon با GGUF رسمی
تولید متن (مشروط)، فراخوانی ابزار (مشروط) مدلها در ۳ سپتامبر عرضه شدند؛ b11454 رخداد اجرای تازه در ۶ اکتبر است و پیشانتشار باقی میماند. فقط پنج مدل مجموعهٔ GGUF رسمی در دامنهاند؛ 375B-A23B به این مسیر نسبت داده نمیشود. -sm tensor غیرفعال است. اصلاح ZWNJ/ZWJ و Windows شاهد کیفیت فارسی نیست؛ سرعت و حافظهٔ واقعی آزمون نشدهاند.
مدلها در ۳ سپتامبر عرضه شدند؛ b11454 رخداد اجرای تازه در ۶ اکتبر است و پیشانتشار باقی میماند. فقط پنج مدل مجموعهٔ GGUF رسمی در دامنهاند؛ 375B-A23B به این مسیر نسبت داده نمیشود. -sm tensor غیرفعال است. اصلاح ZWNJ/ZWJ و Windows شاهد کیفیت فارسی نیست؛ سرعت و حافظهٔ واقعی آزمون نشدهاند.
حداقل نسخهٔ شامل هر دو اصلاح ایمنی حافظه و GELU در ModernBERT
b11529+ کنترل offset در ggml_acc_impl پیش از تبدیل به int32_t را اضافه میکند تا نوشتن خارج از محدوده ناشی از سرریز رخ ندهد. گزارش PR امکان ورود offset منفی از RPC GRAPH_COMPUTE را نیز ذکر میکند؛ اصلاح نهایی اعتبارسنجی مستقیم پارامترهای RPC نیست. b11532+ برای ModernBERT با hidden_activation=gelu از GELU دقیق مطابق Transformers استفاده میکند.
در منابع بررسیشده CVE یا بهرهبرداری عملی اعلام نشده است؛ این اصلاح شاهد افزایش سرعت نیست. GGUF موجود ModernBERT نیاز به تبدیل دوباره ندارد و خروجی buildهای قدیمی باید بازآزمایی شود. آزمون ناشر فقط CPU/F32 روی gte-reranker-modernbert-base است: بیشینهٔ خطای فعالسازی از 5.8e-2 به 7.4e-6 رسید؛ GPU آزمایش نشده و تغییر سرعت CPU در محدودهٔ نوسان اجرا بود. این اعداد ارزیابی مستقیم ModernBERT-base نیستند.
حداقل نسخهٔ شامل اصلاح ترتیب گراف embedding پس از رگرسیون mixed-batch
اصلاح #30160 عملگرهای GET_ROWS را پیش از دیگر عملیات ورودی میچیند تا تقسیمهای اضافی گراف و انتقال ناخواسته به CPU کاهش یابد. برای mixed-batch/embedding و بازآزمایی مسیرهای MTP و چند GPU از b11537 یا جدیدتر شروع کنید؛ پشتیبانی هر مدل جدا بررسی شود.
گزارش یک کاربر روی Linux، SYCL و دو Arc Pro B70 با Qwen3.8-Flash-Next / UD-IQ3_XXS: حدود 365 pp و 24 tg به 582.23 pp و 32.75 tg رسید. اعداد پس از اصلاح متعلق به شاخهٔ PR هستند، نه آزمون مستقل باینری b11537. ورودی، شمار تکرار و آزمون مستقل MTP کامل گزارش نشدهاند؛ نتیجه به همهٔ GPUها تعمیم داده نشود.
SYCL MXFP4 MoE optimized decode؛ اصلاح #29809 از decode حسابی و بازچینی وزنها استفاده میکند. گزارش نویسنده: gpt-oss-20b روی یک B70 از 55.84 به 106.64 tok/s و gpt-oss-120b روی دو B70 از 33.27 به 67.14 tok/s رسید.
آزمون اصلی نویسندهٔ PR روی Windows 11، oneAPI 2026.0، CPU مدل EPYC 7402P و Flash Attention روشن است؛ ۲۰B با پنج و ۱۲۰B با دو تکرار. اعداد برای decode هستند؛ به prefill، Linux یا GPUهای دیگر تعمیم داده نشوند. build شامل اصلاح b11540 است، اما این اعداد مستقیماً از شاخهٔ PR گزارش شدهاند و آزمون مستقلی روی سایت انجام نشده است.
اصلاح جداسازی context در llama-server هنگام استفاده از id_slot ثابت و RAM prompt cache
درخواست دارای id_slot ثابت دیگر cache را روی slot مشغول بارگذاری نمیکند و تا آزادشدن آن منتظر میماند. شرط این پیکربندی: pinned id_slot + RAM prompt cache → b11552+. تا ارتقا و قبولی آزمون canary، این ترکیب در سرویس چندکاربره استفاده نشود.
خطای جداسازی context تأیید شده است؛ در release و PR، CVE یا رخداد واقعی افشای اطلاعات گزارش نشده. آزمون محدود upstream: M2 Ultra/Metal، Qwen3.8-27B-UD-Q4_K_M همراه mmproj، --parallel 10، --kv-unified، --no-cache-idle-slots، --cache-ram 8192 و id_slot=7. در b11146، از ۳۰ جفت همزمان ۱ عبور محتوای درخواست دیگر و ۹ پاسخ خراب گزارش شد؛ در شاخهٔ PR (build 11550)، از ۶۰ جفت هر دو عدد صفر بود. یک نوبت timeout سمت کاربر پس از ۶۰ ثانیه داشت. b11552 شامل اصلاح است؛ این اعداد آزمون مستقیم فایل انتشار یا تضمین همهٔ پیکربندیها نیستند. میزان اثر بدون slot pinning نامعلوم است.
با --moe-cache-mib برای expertهای میزبان کش تعیین میشود؛ این نسخه از RPC پروتکل ۸ و tensor split استفاده میکند.
پیش از اتصال RPC، سازگاری پروتکل ۸ را در هر دو سمت بررسی کنید. پورت پیشفرض اجرای مستقیم 9931 است؛ پورت داخلی Docker همچنان 8080 میماند. تغییر chat session API و قالب part-based ممکن است به اصلاح کلاینت نیاز داشته باشد. پشتیبانی Beam در b11701 و Granite در b11700/11707 پس از این نسخه اضافه شده است.
پایدار تاریخی 0.40.5؛ نسخهٔ تازهتر جداگانه ثبت شده است
Nemotron 3.5 Super/Bolt؛ اصلاح Responses با custom tool calls
مهاجرت پسزمینهٔ 0.40.2 در 0.40.3 برای مشکلات کارایی متوقف شد؛ آن رفتار به 0.40.5 تعمیم داده نمیشود. مدلهای تصمیم cloud با اجرای محلی یکی نیستند. نام 24GB در Bolt تضمین زمینهٔ کامل یا حافظهٔ کل نیست؛ نسخه و بستهٔ سازگار بررسی شود.
vLLM پایدار 0.31.0؛ سرویسدهی با کنترل دقیق نسخه و ورودی
اصلاح GHSA-4xqp-c3mv-qff7؛ دامنهٔ اعلامی کمتر از 0.31.0
طبق advisory رسمی، ورودی نامعتبر /inference/v1/generate میتواند سرویس را متوقف کند در حالی که /health سالم بماند؛ دامنهٔ اعلامی <0.31.0 و اصلاح >=0.31.0 است و نمونهٔ اثبات روی 0.29 اجرا شده است. در ارتقا، تغییرهای multimodal kwargs، tokenizer_mode=slow، cache و سایر advisoryهای ۶ اکتبر جدا بررسی شوند. پشتیبانی nightly مدلهای تازه به این نسخهٔ پایدار منتقل نشده است.
SGLang پایدار 0.5.21؛ مسیرهای نسخهمند CUDA و ROCm
پشتیبانی نسخهمند MiMo 2.6 و GLM 5.3 Flash روی MI355X
ایمیجهای ROCm برای خانوادههای GPU جدا هستند؛ پشتیبانی MI355X تأیید همهٔ AMD GPUها نیست. سرعت گزارششده به دیگر مدلها یا شرایط تعمیم داده نمیشود و نتایج تاریخی حفظ شدهاند.
Python ≥3.11؛ نصب بدون شمارهٔ نسخه روی Python 3.10 ممکن است بیسروصدا نسخهٔ قدیمی انتخاب کند. --attn-dp-size N جایگزین --enable-dp-attention است؛ ترکیب قدیمی با هشدار تبدیل میشود. --dp-size شمار replicaهاست؛ در DeepSeek CP موقتاً معنای attention DP دارد و پس از ۲۰۲۶-۱۲-۳۱ رد خواهد شد. ترکیب replica با attention DP یا هر دو نگارش، خطای راهاندازی میدهد. معنای --disaggregation-decode-host-receive-threshold معکوس شده: 1=غیرفعال (پیشفرض)، 0=همیشه دریافت روی میزبان. tc_piecewise حذف شده؛ --cuda-graph-backend-prefill tc_piecewise و تنظیم tc_compiler خطای راهاندازی میدهند.
تاریخها جدا هستند: انتشار GitHub در ۱۹ اکتبر ۲۰۲۶، ۰۲:۵۵ UTC؛ بستهٔ PyPI از ۱۶ اکتبر موجود است. صحت اجرا: رفع ثبت checkpoint نادرست Mamba هنگام ترکیب speculative decoding و خروجی ساختاریافته که میتوانست مدلهای hybrid را از وضعیت اشتباه بازیابی کند (PR #43029). امنیت: رفع Dumper تأیید نشده؛ مسیر eval() در تگ 0.5.22 باقی است و رفع آسیبپذیری قبلی محسوب نمیشود. اطمینان به نسخه، الزامات و تغییرها بالا است؛ کارایی و کیفیت فارسی اینجا آزموده نشدهاند. این ثبت توصیهٔ ارتقای بیآزمون نیست؛ BOM/QPL اختصاصی OEM و کد داخلی ویزارد پوشش کامل ندارند.
از b11722، Flash Attention میتواند چند دنباله را با --no-kv-unified روی Hexagon پردازش کند.
آزمون PR #30218 روی IQ-9075 EVK / Hexagon v73، با Llama-3.2-1B و Qwen3.5-2B در قالب Q4_0 انجام شده است. برای این مسیر --no-kv-unified لازم است. نتیجه، پشتیبانی همهٔ Snapdragonها یا افزایش سرعت تکنشستی را ثابت نمیکند؛ پیش از استفاده روی دستگاه خودتان آزمون کنید. آزمون محلی انجام نشده است.
gguf-split و export-lora اکنون خواندن ناقص دادهٔ تنسور را تشخیص میدهند و با خطا متوقف میشوند.
قبلاً بافرِ استفادهشده میتوانست بخش خواندهنشده را با دادهٔ تنسور قبلی پر کند و خروجی ظاهراً موفق اما خراب بسازد. اصلاح #30497 جلوی این حالت را میگیرد؛ بررسی checksum ورودی همچنان لازم است. فایلهای سالم و کیفیت مدل موضوع این اصلاح نیستند. آزمون محلی انجام نشده است.
پردازش تصویر LFM2 و LFM2.5-VL مطابق مرجع Transformers
تصویر برای کاشیبندی روی شبکه کشیده میشود؛ تغییر اندازه و گردکردن ابعاد نیز از مرجع Python پیروی میکنند. برای ثبت تنظیمات processor_config.json، فایل mmproj را با مبدل جدید دوباره بسازید؛ این مسیر تغییرهای b11767 را هم دارد.
در کد قبلی، چیدمان ۳۱٬۹۲۶ اندازه از حدود ۱۶٫۸ میلیون حالت تا 4096×4096 با مرجع تفاوت داشتند. در نمونهٔ 720×1600، تعداد توکن از 2812 به 2298 رسید. بسته به شکل تصویر، تعداد توکن و زمان اجرا میتواند کمتر یا بیشتر شود. آزمونهای خروجی PR عمدتاً روی مدلهای 450M و خانوادهٔ d1 هستند؛ برای LFM2.5-VL-3B مسیر آزمایشی ثبت شده و باید با تصاویر خودتان آزموده شود. این یادداشت به مدل DSpark نسبت داده نمیشود. آزمون محلی انجام نشده است.
وزن BF16 مدلهای Embed 1B/8B را میتوان به GGUF تبدیل و با llama-embedding اجرا کرد. فایل حاصل تبدیل کاربر است؛ فایل GGUF رسمی آمادهٔ دریافت ثبت نشده است.
آزمون منتشرشده برای یک ورودی متنی مدل 1B، شباهت کسینوسی 0.999847 با PyTorch را گزارش میکند. این عدد سنجهٔ کیفیت بازیابی نیست و صحت همهٔ ورودیها را تضمین نمیکند؛ آزمون انتهابهانتهای تصویر و مدل 8B در شواهد دیده نمیشود. این مسیر شامل Rerank-8B یا NVFP4 نیست. آزمون محلی انجام نشده است.
coopmat1 با پشتیبانی cooperative matrix و INT8 در دستگاه و درایور؛ GGML_VK_DISABLE_COOPMAT نباید آن را غیرفعال کند.
قالبها: q4_0، q4_1، q5_0، q5_1، q8_0، q3_k، q4_k، q5_k، q6_k، mxfp4، nvfp4 و iq4_nl. در RDNA4، مسیر MUL_MAT برای q4_1، q5_1، q4_k، q5_k و nvfp4 فعال نیست؛ nvfp4 در MUL_MAT_ID هم غیرفعال است. آزمون ناشر شامل RDNA3.5 است، اما نتیجه به همهٔ GPUهای AMD تعمیم ندارد. برای اتکا به نتیجهٔ b11160، آزمون صحت و سپس کارایی را روی b11224+ دارای اصلاح #28956 تکرار کنید.
در CUDA روی Blackwell، لایههای NVFP4/MXFP4 با سیاست W4A16 میتوانند W4A8 اجرا شوند؛ وزن FP4 لزوماً فعالسازی چهاربیتی ندارد.
GGML_CUDA_MMQ_PREC=auto از فراداده پیروی میکند؛ q4 و q8 دقت را تحمیل میکنند. q4 ممکن است پردازش prompt را سریعتر و دقت را کمتر کند، پس بدون آزمون انتخاب مناسبی برای پیشفرض نیست. این تغییر به نسخهٔ پایدار v0.5.0 تعلق ندارد.
ورودی بلند برای بازرتبهبندهای علّی Qwen3 و Qwen3-VL
از b11223+ با اصلاح #28876، ورودی RANK با attention علّی میتواند بین چند physical batch تقسیم شود.
قبلاً ورودی بزرگتر از n_ubatch، با پیشفرض ۵۱۲ توکن، رد میشد. cross-encoderهای دوطرفه همچنان باید در یک physical batch جا شوند. این تغییر به معنی پشتیبانی کامل چندوجهی /rerank یا /embedding نیست؛ برای استقرار به آزمون همشرایط نیاز دارد.
اصلاح #28956 خواندن داده در mul_mat و mul_mat_id را برای برخی viewهای cache و expert تصحیح میکند.
گزارش PR شامل حلقهٔ بیپایان SheetSage2 و خطای Qwen3 AR با --no-fa است. روی b11224+ صحت خروجی را با CPU/CUDA، تنظیمات یکسان و رواداری عددی مشخص مقایسه کنید. نتایج قدیمی b11160 هم به بازآزمایی نیاز دارند. این اصلاح شاهد افزایش سرعت یا خرابی همهٔ مدلها نیست.
از b11240+، مسیر /v1/embeddings ورودی تایپشدهٔ OpenAI-style میپذیرد؛ نوع ورودی پشتیبانیشده به مدل وابسته است.
هر شیء {"content": [...]} یک embedding میسازد؛ آرایهٔ content بدون این پوشش پذیرفته نمیشود و API قدیمی حفظ شده است. KV prefix reuse برای embedding/rerank غیرفعال است، پس ظرفیت و سرعت را دوباره بسنجید. مسیر Qwen3-VL-Embedding-2B/8B آزمایشی است و پشتیبانی چندوجهی Reranker را تأیید نمیکند.
b11279 پشتیبانی اولیه را با #27773 اضافه کرد؛ برای آزمایش، اصلاح بعدی #29745 نیز لازم است.
پس از ادغام، data race در CPU/ThreadSanitizer گزارش شد. b11279 اصلاح #29745 را ندارد؛ پیش از آزمایش، وجود آن را در build خود بررسی و صحت خروجی را دوباره بسنجید. این یادداشت پشتیبانی GLM-5.3-BF16 را تأیید نمیکند. آزمون محلی انجام نشده است.
ثبت نوع مدل و projector با مسیر تبدیل MiniCPM-V 4.6؛ این تغییر بهتنهایی انتشار وزن یا مجوز مدل را اثبات نمیکند.
خروجی OCR ممکن است در reasoning_content قرار گیرد؛ برای content از --reasoning off یا reasoning_effort: "none" استفاده کنید. انتشار وزن و مجوز مدل از این اصلاح موتور قابل نتیجهگیری نیست.
تغییر نوع operand از __bf16 به short با الگوی بیتی یکسان؛ رفع شکست build روی gfx1150/1151 و gfx1200/1201 با HIP/ROCm و LLVM تازه.
برای این اهداف با toolchain تازه، b11847 یا جدیدتر؛ آزمون محلی نویسندهٔ PR فقط روی gfx1151 بوده است. همهٔ RDNA3/RDNA4 عملاً آزموده نشدهاند؛ مشخصات GPU و حافظه تغییر نمیکند.
d3 در /v1/systemone؛ Phonon در /v1/audio/speech روی Apple Silicon؛ Flint روی Linux و Windows؛ گزارش خطاهای stream در OpenAI/Anthropic.
Phonon در این نسخه فقط Apple Silicon است و مدل فارسی محسوب نمیشود. مسیر d3 خروجی تصمیم دارد، نه متن آزاد. خطای تولید دیگر نباید پس از خروجی ناقص در stream پنهان بماند؛ آزمون محلی انجام نشده است.
nemotron-3.5-bolt:e4b با DFlash؛ قابلیتهای d3، گفتار و Flint نسخهٔ 0.40.9 نیز حفظ میشوند.
مشخصات پایهٔ NVIDIA: متن و 64K. Ollama برای بستهٔ خود تصویر و 128K اعلام میکند؛ این اختلاف تأیید نشده و فیلتر چندوجهی مدل فعال نیست. GGUF اصلی 6,180,446,208 بایت است؛ نام 4GB حجم فایل یا تضمین VRAM نیست. DFlash کمکی است و جداگانه حافظه میخواهد.
در rdma_recv، دریافت بزرگتر از فضای باقیماندهٔ بافر پیش از memcpy رد میشود؛ جایگاه دریافت دوباره ثبت و اتصال بسته میشود.
دامنه فقط RPC روی RDMA است؛ این اصلاح به HTTP API تعمیم داده نمیشود. نویسندهٔ PR خطا و رفع آن را با ASan و SoftRoCE بازتولید کرده است؛ بهرهبرداری واقعی یا آزمون مستقل محلی تأیید نشده است.
گزینهٔ --split-mode tensor برای mellum و flint غیرفعال شد؛ mistral4 از قبل ممنوع بود. بیشینهٔ موردنیاز مقیاسدهی MoE با برش جزئی ردیف بهدرستی محاسبه نمیشد.
این محدودیت برای همین معماریها و همین روش تقسیم است؛ ممنوعیت همهٔ مدلهای MoE یا همهٔ روشهای چند GPU نیست. آزمون عملی مستقل روی چند GPU انجام نشده است.
وقتی temperature یا top_p ارسال نشود، endpoint سازگار تنظیمات بستهٔ مدل را حفظ میکند. خواندن پاسخ فشردهٔ جستوجوی وب، محتوای /v1/responses و top-k در MLX اصلاح شدهاند.
کلاینتهایی که پارامتر نمونهگیری نمیفرستند، پس از ارتقا از تنظیمات خود مدل استفاده میکنند؛ این تغییر روی بازتولید خروجی اثر دارد.
SGLang 0.5.23؛ Paged Experts و LoRA روی MoE کمدقت
Paged Experts برای MoE بزرگتر از حافظهٔ GPU و موتور LoRA برای FP8/NVFP4 بهصورت اختیاری اضافه شدهاند. مسیر TPU7x از افزونهٔ TorchTPU و مسیر کمتأخیر DeepSeek-V4.1-Flash از افزونههای megakernel یا monokernel استفاده میکند.
کانتینرهای MI35x، MI30x، XPU و TPU جدا هستند؛ Paged Experts و LoRA تازه با فعالسازی صریح کار میکنند.
endpoint بومی /v1/systemone برای choice، noul و score و parser عمومی hf اضافه شدهاند. KV از نوع NVFP4 به SM8x، SM90 و SM12x گسترش یافته و MRV2 روی ROCm پیشفرض شده است.
Python 3.10 حذف شده؛ مبدأهای CORS دیگر بهطور پیشفرض باز نیستند. نسخهٔ Transformers باید >=5.16.1 و <5.20.0 باشد.
یادداشت این تگ PyTorch 2.14 و Triton 3.8، بستههای CUDA 13.0، تصویر پیشفرض ROCm 10 و endpoint تازهٔ /v1/decisions را ثبت میکند. انتشار بستههای CUDA 12.9 متوقف شده است.
پیشانتشار rc3؛ مهاجرت از 0.32.0 به تغییر بستههای CUDA و PyTorch نیاز دارد.
«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.
نتایج آزمونها
مقایسهٔ مدلها در آزمونهای مشترک
دربارهٔ این مقایسهها
در MIRACL فارسی، nDCG@10 از 53.3 برای Small به 59.4 برای Large-Instruct میرسد. در اسپانیایی 51.2 و 53.7 است؛ در انگلیسی Large با 52.9 بالاتر از Large-Instruct با 51.5 گزارش شده است. میانگین چندزبانه جای زبانِ کاربرد را نمیگیرد.
اختلاف امتیاز را فقط برای مدلهایی محاسبه میکنیم که در یک آزمون و با شرایط یکسان بررسی شدهاند.
برای هر کاربرد واقعاً چه اندازه مدلی لازم داریم؟ از مدل تخصصی و SLM تا LLM
برای چت ساده، پاسخ مستند، دستیار کد و تحلیل پیچیده چه اندازه مدلی مناسب است؟ مرور تناسب کاربردها، انتخاب میان RAG، CAG، KAG و تنظیم مدل، و اثر اندازه و طول زمینه بر هزینه و ظرفیت سرویسدهی.
از روانی متن تا درستی پاسخ و موفقیت در کاربرد واقعی؛ راهنمای عملی انتخاب معیار، ساخت نمونههای فارسی و استفاده از بنچمارکها، با ارجاع به پژوهشهای فارسی و کارهای دانشگاهی ایران.
RAG، CAG، KAG، Fine-tuning و Instruction tuning؛ چه تفاوتی دارند و کدام را انتخاب کنیم؟
وقتی مدل پاسخ مناسبی نمیدهد، واقعاً به آموزش دوباره نیاز داریم یا فقط باید دانش درست را در اختیارش بگذاریم؟ با مثالهایی ساده، تفاوت RAG، CAG و KAG را با Fine-tuning و Instruction tuning بررسی میکنیم؛ از بازیابی سند و کشکردن دانش تا استدلال روی روابط و تغییر رفتار مدل. جدول مقایسه و سناریوهای عملی کمک میکنند پیش از صرف هزینهٔ آموزش، تشخیص دهیم مشکل از کمبود دانش است یا شیوهٔ پاسخگویی، و کدام روش یا ترکیب برای پروژه مناسبتر است.
برای دستیار اسناد سازمانی، مدل زبانی، embedding و reranker را چگونه انتخاب کنیم؟
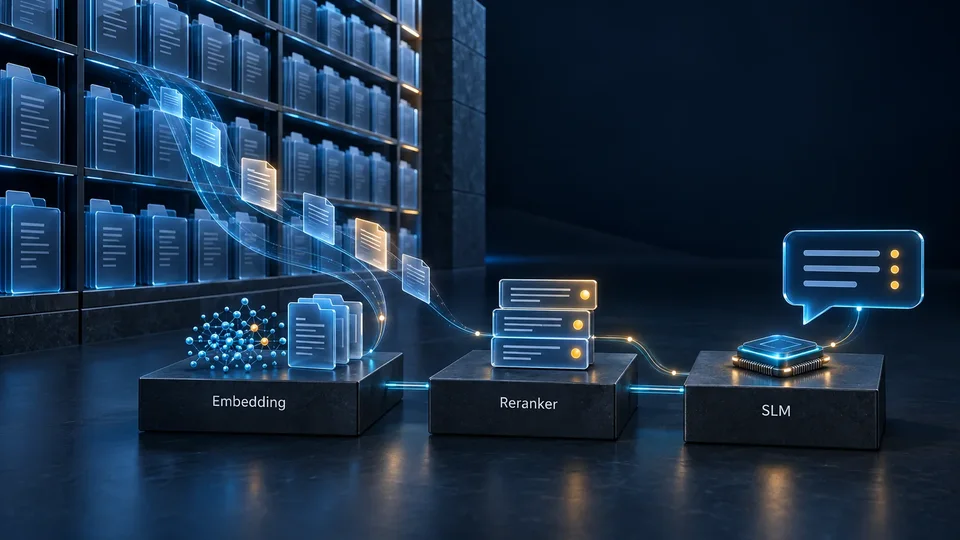
برای پاسخهای روزمره از اسناد سازمان، مدل کوچک اغلب نقطهٔ شروع مناسبی است. معیار انتخاب جداگانهٔ embedding، reranker و پاسخگو، نامزدهای عملی و تشخیص محل خطا را با چهار جدول بررسی میکنیم.
تکمیل کد، دستیار کد و عامل برنامهنویسی؛ سه نیاز با سه معیار انتخاب
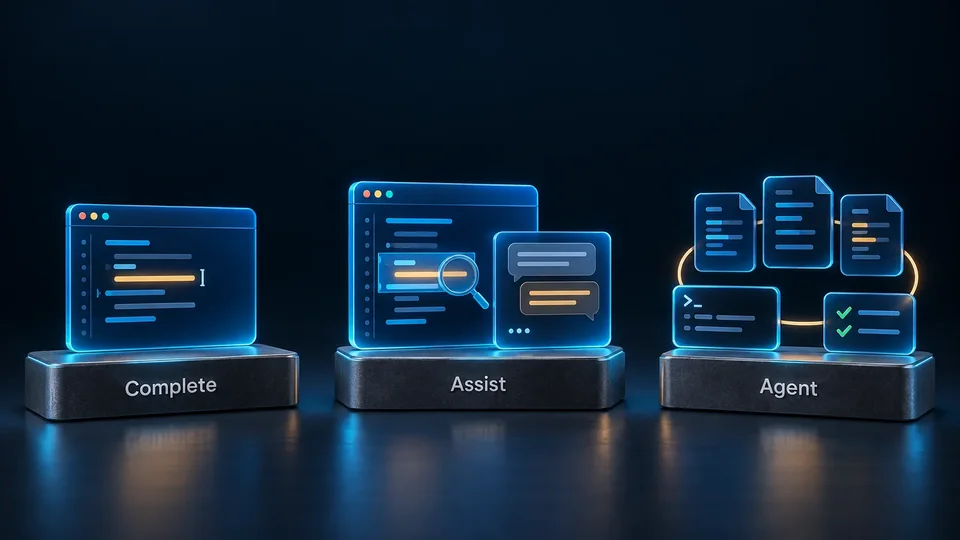
تکمیل کد به پیشنهاد سریع، دستیار کد به اصلاح درست و عامل برنامهنویسی به انجام موفق کار با ابزار نیاز دارد. چهار جدول برای انتخاب مدل، معیار ارزیابی و زیرساخت متناسب با هر نقش.
روی RTX 4090 چه مدلهایی اجرا میشوند؟ تفاوت ۲۴ و ۴۸ گیگابایت در عمل
کدام مدلها روی ۲۴ و ۴۸ گیگابایت جا میشوند، چند 4090 چه زمانی برای سرویس سازمانی کافیاند و چه زمانی H100، H200 یا کارت حرفهای ارزش هزینهٔ بیشتر را دارند؟
چهاربیتیکردن مدل چه چیزی را ارزان میکند و چه چیزی را تغییر میدهد؟
چهاربیتیکردن چگونه حجم وزنها و هزینهٔ اجرا را کاهش میدهد و چه اثری بر کیفیت، سرعت، KV cache و ظرفیت سرویس دارد؟ همراه با مقایسهٔ واقعی نسخههای Qwen3-8B.
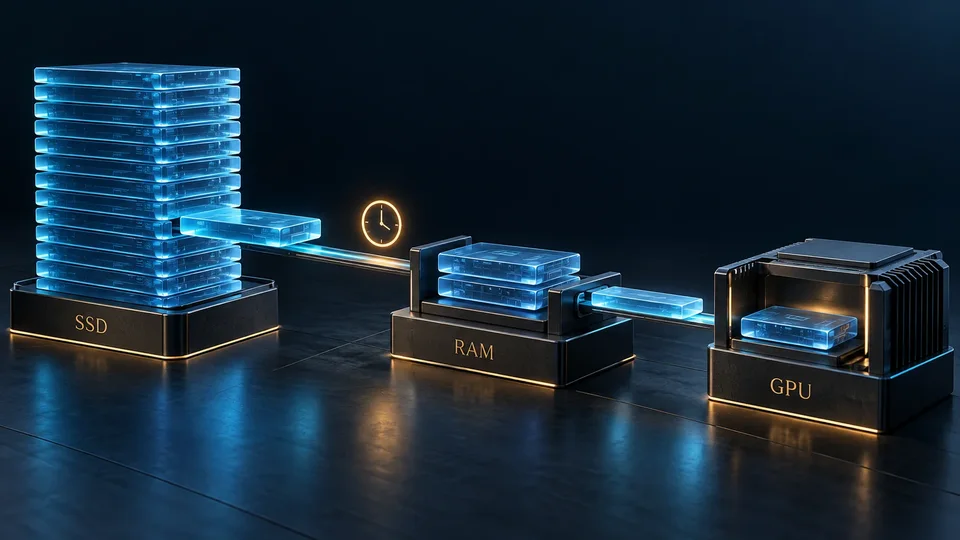
AirLLM و اجرای لایهبهلایه؛ مدل بزرگ با حافظهٔ کم، با چه هزینهای؟
AirLLM چگونه مدل بزرگ را با VRAM کم اجرا میکند؟ هزینهٔ انتقال وزن، RAM و SSD، حافظهٔ کانتکست و تفاوت کاربرد پژوهشی با سرویس سازمانی؛ همراه با چهار جدول و بررسی آموزش LoRA.
Ollama، vLLM، SGLang یا llama.cpp؛ برای اجرای مدل کدام را انتخاب کنیم؟
مقایسهٔ فنی چهار ابزار اجرای مدل؛ از همزمانی و KV cache تا GGUF، چند GPU، پایش و آزمون بار. کجا سادگی Ollama کافی است و چه زمانی vLLM یا SGLang انتخاب مناسبتری میشود؟
چرا سریعترین GPU لزوماً سریعترین پاسخ را نمیدهد؟
توان پردازشی بیشتر یا نرخ توکن بالاتر، همیشه به پاسخ سریعتر منتهی نمیشود. تفاوت زمان آغاز و تکمیل پاسخ، نقش حافظه و همزمانی، تقسیم کار GPU و LPU و هزینهٔ ارتباطات را بررسی میکنیم تا معیار انتخاب زیرساخت، ظرفیت خدمتدهی با کیفیت و تأخیر مورد نیاز باشد.
از یک کاربر تا سرویس سازمانی؛ چه زمانی مدل، تعداد نسخهها یا GPU را تغییر دهیم؟
از صف و کانتکست تا تکثیر مدل و تحمل خرابی؛ راهنمای رشد اقتصادی سرویس سازمانی با GPU متناسب، نمونههای مستقل و ظرفیت ابری با پرداخت بهاندازهٔ مصرف، همراه با مثالهای عددی.
تعداد کاربر، ظرفیت یک دستیار هوشمند را مشخص نمیکند. نرخ درخواست، طول متن، صف و KV Cache را با مثال و ابزار تعاملی بررسی میکنیم تا انتخاب GPU و آزمون پذیرش به بار واقعی خدمت وصل شوند.

 Ollama · v0.40.2
 SGLang · v0.5.20
 llama.cpp / llama-server · v0.4.1
 Text Embeddings Inference (TEI) · v1.9.4
 AirLLM · v4.0.0
 LiteLLM · v1.103.1
 Open WebUI · v0.11.4
 LM Studio · 0.4.24 Build 1
 KTransformers · v0.7.1