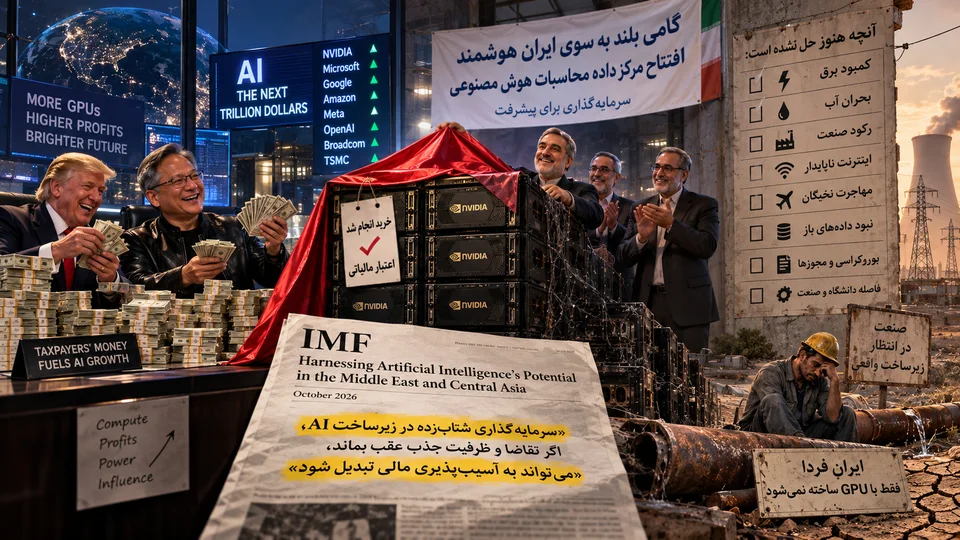
صندوق بینالمللی پول هشدار داده است که سرمایهگذاری شتابزده در زیرساخت هوش مصنوعی، اگر تقاضا و ظرفیت جذب عقب بماند، میتواند به آسیبپذیری مالی تبدیل شود. مسئله، بدبودن GPU نیست؛ مسئله این است که خرید GPU را با ساختن ظرفیت ملی هوش مصنوعی اشتباه نگیریم.
مدتی است هر بار میگوییم «زیرساخت هوش مصنوعی» را نباید به مزرعهٔ GPU تقلیل داد، یک پاسخ آماده میشنویم: مگر بدون توان پردازشی میشود هوش مصنوعی ساخت؟
پاسخ روشن است: نه. بدون توان پردازشی، بسیاری از مدلهای امروز نه آموزش داده میشوند و نه در مقیاس مناسب به کار میافتند. اما گزارهٔ معکوس درست نیست؛ داشتن GPU بهخودیخود نه مدل میسازد، نه مسئلهای را حل میکند، نه بهرهوری را بالا میبرد و نه حتی تضمین میکند سختافزار خریداریشده بهطور مؤثر استفاده شود.
این حرف را پیشتر در یادداشت «بایدها و نبایدهای سرمایهگذاری در هوش مصنوعی» نوشته بودم: سرمایهگذاری ملی فقط خرید H100 و H200 و اخیرا B200 و B300 نیست؛ داده، نیروی انسانی، نرمافزار، دسترسی، حکمرانی و تقاضای واقعی نیز اجزای زیرساختاند. حالا گزارش تازهٔ صندوق بینالمللی پول دربارهٔ ظرفیت هوش مصنوعی در خاورمیانه و آسیای مرکزی، با زبان اقتصاد کلان، همان هشدار را جدیتر تکرار میکند.
IMF دقیقاً چه میگوید؟
گزارش Harnessing Artificial Intelligence’s Potential in the Middle East and Central Asia که در ۲ اکتبر ۲۰۲۶ منتشر شده، اصل سرمایهگذاری در زیرساخت هوش مصنوعی را رد نمیکند. برعکس، توان پردازشی و زیرساخت دیجیتال را بخشی از آمادگی کشورها میداند. اما سه شرط را کنار هم میگذارد: آمادگی، دسترسی و ظرفیت پذیرش.
پیام مهم گزارش این است که منافع هوش مصنوعی میان کشورها یکسان توزیع نمیشود. کشوری که برق، شبکه، داده، مهارت، محیط حقوقی و بنگاههای آمادهٔ استفاده ندارد، صرفاً با واردکردن شتابدهنده به نقطهٔ کشورهای آماده نمیرسد. IMF حتی هشدار میدهد رشد سریع سرمایهگذاریهای مرتبط با AI، اگر میزان پذیرش از انتظار کمتر باشد، میتواند آسیبپذیری مالی ایجاد کند.
این جمله برای ایران باید با صدای بلند خوانده شود. چون معنایش این نیست که «GPU نخریم»؛ معنایش این است که سرمایهگذاری را از تقاضای واقعی، ظرفیت بهرهبرداری و شاخص نتیجه جدا نکنیم.
گزارش، طرحهای بزرگ برخی کشورهای منطقه برای تبدیلشدن به قطب صادرات خدمات هوش مصنوعی را نیز بررسی میکند و موفقیت آنها را مشروط به دو عامل میداند: ظرفیت پذیرش در کشورهای خریدار این خدمات و هماهنگی مقرراتی فرامرزی. بنابراین حتی داشتن مرکز دادهٔ عظیم و انرژی فراوان هم بازار را تضمین نمیکند. سختافزار، عرضه ایجاد میکند؛ اما مشتری، کاربرد، اعتماد و سازگاری حقوقی را نمیسازد.
ایران در این تصویر کجاست؟
در نمایهٔ آمادگی هوش مصنوعی IMF، امتیاز ایران برای سال ۲۰۲۳ برابر ۰٫۳۸ ثبت شده است. این شاخص چهار بُعد را میسنجد: زیرساخت دیجیتال؛ سرمایهٔ انسانی و سیاستهای بازار کار؛ نوآوری و یکپارچگی اقتصادی؛ و مقررات و اخلاق.
خود IMF تأکید میکند که این شاخص برای رتبهبندی قطعی کشورها طراحی نشده، اجزای آن از آخرین دادههای در دسترس در سالهای متفاوت ساخته شدهاند و هنوز استاندارد آماری پذیرفتهشدهای برای اندازهگیری «آمادگی AI» وجود ندارد. بنابراین عدد ۰٫۳۸ نه نمرهٔ امروز ایران است و نه حکمی نهایی دربارهٔ توان کشور. اما یک فایدهٔ بزرگ دارد: یادآوری میکند که آمادگی هوش مصنوعی، یک متغیر تکبعدی به نام «تعداد GPU» نیست.
در ایران معمولاً برای اثبات قدرت نیروی انسانی به رتبههای خوب تولید مقاله و تعداد فارغالتحصیلان مهندسی استناد میشود. این دستاوردها مهماند، اما مقالهٔ علمی، بهتنهایی، معادل تیم عملیات مدل نیست؛ فارغالتحصیل مهندسی نیز الزاماً متخصص سامانههای توزیعشده، CUDA، استنتاج، MLOps، امنیت داده یا مدیریت یک خوشهٔ پرتراکم نیست. همانطور که خرید سرور، بدون این توانمندیها، معادل ایجاد «ظرفیت محاسباتی قابل اتکا» نیست.
تفاوت میان ظرفیت اسمی و ظرفیت قابل استفاده دقیقاً از همینجا آغاز میشود.
مشکل GPU نیست؛ مشکل، ترتیب سرمایهگذاری است
یک پروژهٔ ملی خوب ممکن است به هزاران GPU نیاز داشته باشد. اما ترتیب منطقی آن چنین است: مسئله و متقاضی مشخص میشوند؛ داده و مجوز دسترسی روشن میشود؛ معماری، مدل و نرمافزار اجرا انتخاب میشوند؛ بارکاری تخمین زده میشود؛ و سپس سختافزار متناسب با آن خریداری یا اجاره میشود.
در نسخهٔ معیوب، روند برعکس است: ابتدا بودجه و نام GPU تعیین میشود، بعد دنبال پروژهای میگردیم که خرید انجامشده را توجیه کند.
نتیجه ممکن است چیزی باشد که میتوان آن را «انبار هوش مصنوعی» نامید: تجهیزات گرانقیمتی که در مراسم افتتاح ظرفیت بزرگی دارند، اما در عمل بارکاری پایدار، دادهٔ آماده، تیم بهرهبردار، شبکهٔ کافی یا کاربران متعدد ندارند. آمار تعداد شتابدهنده بالا میرود، ولی شاخص استفادهٔ مفید منتشر نمیشود.
در اقتصادی که همزمان با محدودیت ارزی، تحریم، دشواری تأمین قطعه، فشار انرژی و نااطمینانی زنجیرهٔ پشتیبانی روبهروست، هزینهٔ این اشتباه فقط قیمت خرید نیست. هزینههای زیر نیز باید در تصمیم دیده شوند:
- برق، خنککاری، شبکهٔ پرسرعت، ذخیرهسازی و فضای مرکز داده؛
- قرارداد پشتیبانی، قطعات یدکی و نیروی عملیات شبانهروزی؛
- محدودیت دسترسی به درایور، نرمافزار، سرویس ابری یا بهروزرسانیهای سازنده؛
- قفلشدن به یک فروشنده یا یک پشتهٔ نرمافزاری؛
- افت سریع ارزش تجهیز در اثر ورود نسل بعدی؛
- و مهمتر از همه، هزینهٔ فرصت سرمایهای که میتوانست صرف داده، محصول، آموزش یا دیجیتالیکردن فرایندها شود.
هشدار IMF دقیقاً در همین نقطه اهمیت پیدا میکند: اگر پذیرش واقعی کمتر از انتظار باشد، سرمایهگذاری بزرگ نهفقط کمبازده، بلکه میتواند به ریسک مالی تبدیل شود.
پیش از خرید، این هشت پاسخ باید روی میز باشد
بهجای مسابقه بر سر اینکه چه کسی عدد بزرگتری از GPU اعلام میکند، هر طرح عمومی باید پیش از تخصیص بودجه به این پرسشها پاسخ دهد:
| پرسش | اگر پاسخ روشن نباشد | شاخص قابل انتشار |
|---|---|---|
| کدام مسئله و کدام کاربر؟ | سختافزار پس از خرید دنبال مصرفکننده میگردد | فهرست بارهای کاری، مالک هر پروژه و کاربران متعهد |
| چه دادهای و با چه مجوزی؟ | پروژه در حد نمایش و نمونهٔ آزمایشی میماند | درصد دادهٔ آماده، زمان دسترسی و مبنای حقوقی استفاده |
| آموزش مدل، تنظیم مدل یا استنتاج؟ | نوع و تعداد GPU از روی نامهای مشهور انتخاب میشود | پروفایل واقعی حافظه، ارتباط بین GPUها و الگوی مصرف |
| چرا خرید؛ چرا اجاره یا اشتراک نه؟ | سرمایه برای ظرفیت اوجِ کوتاهمدت قفل میشود | هزینهٔ کل مالکیت در چند سناریوی مصرف |
| چه نرمافزار و چه مدلهایی؟ | سختافزار با موتور اجرا یا قالب عددی مورد نیاز سازگار نیست | ماتریس آزمودهشدهٔ مدل، موتور، precision و درایور |
| چه کسی بهرهبرداری میکند؟ | خوشه با ظرفیت اسمی بالا و دسترسپذیری پایین تحویل میشود | تعداد نیروهای عملیات، SLA، زمان رفع خرابی و برنامهٔ انتقال دانش |
| ظرفیت چگونه میان کاربران تقسیم میشود؟ | منابع در اختیار چند پروژه میماند یا در صفهای مبهم هدر میرود | سیاست سهمیه، زمان انتظار، GPU-hour مصرفشده و نرخ استفاده |
| خروجی اقتصادی یا عمومی چیست؟ | موفقیت با تعداد کارت سنجیده میشود | محصول مستقر، کاربر فعال، صرفهجویی، درآمد یا بهبود خدمت |
این پرسشها مانع خرید نیستند؛ اتفاقاً خرید درست را ممکن میکنند. برای یک بارکاری آموزش مدل بزرگ، اتصال پرسرعت میان GPUها تعیینکننده است. برای استنتاج چند مدل کوچک، ممکن است تقسیمپذیری، حافظه و بهرهوری انرژی مهمتر باشد. برای دانشگاهها، سازوکار دسترسی مشترک میتواند از تکرار خریدهای پراکنده جلوگیری کند. برای خدمات حساس دولتی، محل داده و کنترل دسترسی شاید از رکورد خام FLOPS مهمتر باشد.
یک عدد واحد نمیتواند پاسخ همهٔ این نیازها باشد.
راهحل، توقف زیرساخت نیست؛ تبدیل «مزرعه GPU» به خدمت محاسباتی است
پیشنهاد عملی، کنارگذاشتن پروژههای زیرساختی نیست. باید از مدل «خرید و تحویل تجهیزات» به مدل خدمت محاسباتی قابل سنجش عبور کنیم:
- خرید در چند مرحله و مشروط به تحقق شاخص استفاده انجام شود، نه یک قرارداد بزرگ پیش از شکلگیری تقاضا.
- سبد سختافزار متنوع و متناسب با بارکاری باشد؛ گرانترین GPU لزوماً اقتصادیترین انتخاب برای هر مدل نیست.
- دانشگاه، شرکت و دستگاه دولتی از یک سازوکار شفاف رزرو، سهمیهبندی و حسابداری GPU-hour استفاده کنند.
- هزینهٔ هر پروژه، از انرژی و ذخیرهسازی تا زمان شتابدهنده، قابل مشاهده باشد؛ «رایگانبودن برای کاربر» نباید به معنای «بیحساببودن برای کشور» باشد.
- قابلیت جابهجایی بارکاری میان فروشندگان و محیطهای مختلف از ابتدا در معماری دیده شود.
- بخش خصوصی فقط پیمانکار خرید و نصب نباشد؛ با تعهد سطح خدمت، رقابت بر سر بهرهوری و امکان ارائهٔ محصول وارد شود.
- داشبورد عمومی، بهجای تعداد GPU، نرخ استفاده، زمان انتظار، تعداد محصولات مستقر، پایداری خدمت و هزینهٔ واحد خروجی را نشان دهد.
این همان منطقی است که در یادداشت «سازمان ملی هوش مصنوعی؛ هستهٔ متمرکز یا معماری فدرال؟» نیز بر آن تأکید شده بود: حکمرانی و استاندارد میتواند مرکزی باشد، اما داده، اجرا و ظرفیت نباید الزاماً در یک ساختمان و زیر یک مالک انباشته شود. نخستین محصول حکمرانی باید معماری مرجع و قواعد تعامل باشد، نه صرفاً یک ابررایانه با عکس افتتاحیه.
معیار موفقیت را عوض کنیم
تا وقتی موفقیت پروژه با «چند GPU خریدیم؟» سنجیده شود، مدیر هم برای بزرگترکردن همان عدد انگیزه خواهد داشت. باید واحد گزارشدهی تغییر کند:
- چند درصد ظرفیت در بارکاری واقعی مصرف شد؟
- چند محصول از مرحلهٔ آزمایش به بهرهبرداری رسید؟
- زمان دسترسی پژوهشگر یا شرکت به محاسبات چقدر کاهش یافت؟
- هزینهٔ استنتاج هر میلیون توکن، هر تصویر یا هر درخواست چقدر شد؟
- چند مجموعهدادهٔ قانونی، مستند و قابل استفاده به چرخه وارد شد؟
- چه میزان از دانش عملیات و توسعه در داخل تثبیت شد؟
- و اگر تقاضا کمتر از پیشبینی بود، برنامهٔ کاهش ظرفیت یا تغییر کاربری چیست؟
آخرین پرسش معمولاً پرسیده نمیشود، چون ما برای پروژههای فناوری سناریوی خروج نمینویسیم. اما سختافزار هوش مصنوعی با ساختمان اداری فرق دارد: سریع پیر میشود، هزینهٔ نگهداری دارد و ارزش آن به اکوسیستم نرمافزار و امکان استفاده وابسته است. خرید مرحلهای، اجاره، اشتراک و قرارداد مبتنی بر خدمت، نشانهٔ تردید در فناوری نیست؛ نشانهٔ مدیریت حرفهای ریسک است.
حرف آخر
گزارش IMF مصون از نقد نیست. شاخص آمادگی آن محدودیت روششناختی دارد، دادهٔ آن برای ایران عمدتاً به ۲۰۲۳ بازمیگردد و توصیههای منطقهای را نمیتوان بدون بررسی شرایط کشور نسخهبرداری کرد. اما هشدار اصلی آن روشن و معتبر است: سرمایهگذاری در زیرساخت هوش مصنوعی فقط وقتی به رشد تبدیل میشود که اقتصاد، نهادها، نیروی انسانی و کاربران توان جذب آن را داشته باشند. اگر پذیرش عقب بماند، همان سرمایهگذاری میتواند منشأ آسیبپذیری شود.
پس بحث بر سر این نیست که ایران GPU لازم دارد یا نه؛ روشن است که دارد. بحث بر سر این است که آیا GPU را حلقهای از زنجیرهٔ داده تا محصول میبینیم، یا خودِ زنجیره.
اگر حرف ما را قبول ندارید، گزارش IMF را بخوانید. این بار هشدار از طرف کسانی نیست که با فناوری یا سرمایهگذاری مخالفاند؛ از طرف نهادی است که کارش سنجیدن رشد، بازده سرمایه و ریسک مالی است.
کشور به «تعداد بیشتری GPU» نیاز ندارد؛ به ظرفیت محاسباتیِ بیشتر، قابل دسترستر، قابل اندازهگیریتر و متصل به مسئلهٔ واقعی نیاز دارد. تفاوت این دو، تفاوت میان افتتاح یک انبار گرانقیمت و ساختن زیرساختی است که واقعاً کار میکند.