Publicado 25 de octubre de 2026 · 18 min
Archivo
Artículos
Artículos técnicos y ensayos seleccionados para lectores en español.
Todos los temas y categorías
Vista del archivo
Página 1 / 4 · 38 artículos
Infraestructura de IA Publicado 17 de octubre de 2026 · 17 min
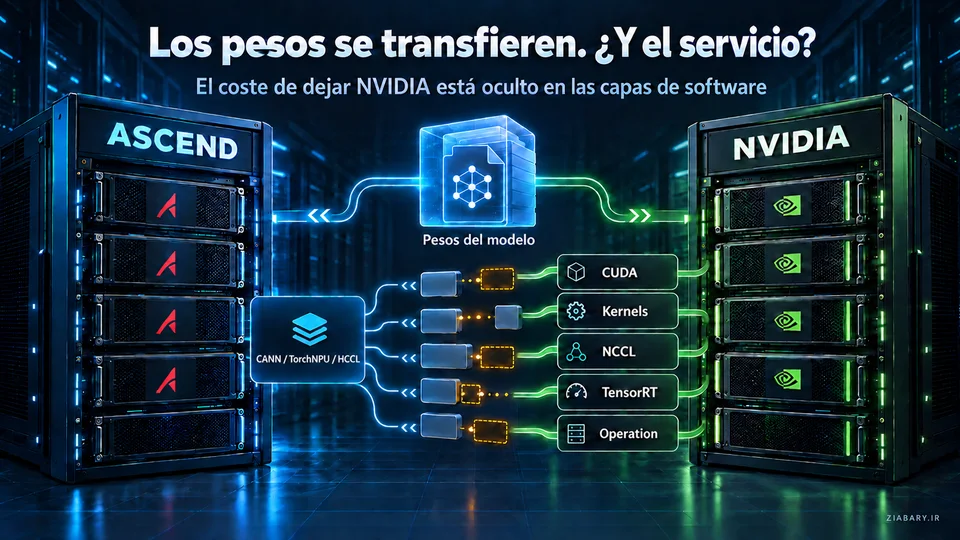
¿Qué se rompe si mañana retiramos NVIDIA?
CUDA es más que una biblioteca. Los kernels, la comunicación entre GPU, los motores de inferencia, la operación y la experiencia del equipo determinan el coste de trasladar un servicio de NVIDIA a Ascend. Leer artículo →
Infraestructura de IA Publicado 13 de octubre de 2026 · 18 min
¿Qué significan 100 usuarios simultáneos en un asistente de IA?
El número de usuarios no define por sí solo la capacidad de un asistente. Ejemplos y una herramienta interactiva relacionan las tasas de solicitud, los tokens, las colas y la caché KV con la elección de GPU y las pruebas de aceptación. Leer artículo →
Modelos de lenguaje Publicado 15 de septiembre de 2026 · Actualizado 11 de octubre de 2026 · 14 min
Ollama, vLLM, SGLang o llama.cpp: cómo elegir el motor de inferencia
Cómo cambian la elección la planificación, la caché KV, los formatos y el control operativo: comparación de cuatro motores con un cálculo de memoria y un método reproducible. Leer artículo →
IA industrial Publicado 10 de octubre de 2026 · 12 min
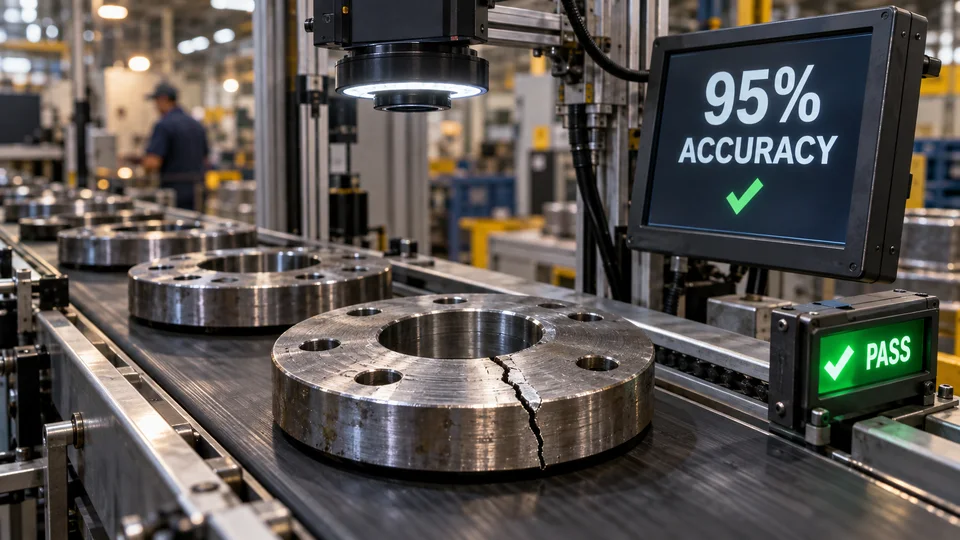
¿Qué significa una exactitud del 95 % para una fábrica?
Dos sistemas de inspección pueden anunciar una exactitud del 95 % y dar resultados muy distintos en la línea de producción. ¿Cómo convertir ese porcentaje en costes de error y criterios de aceptación? Leer artículo →
Infraestructura de IA Publicado 7 de octubre de 2026 · 24 min
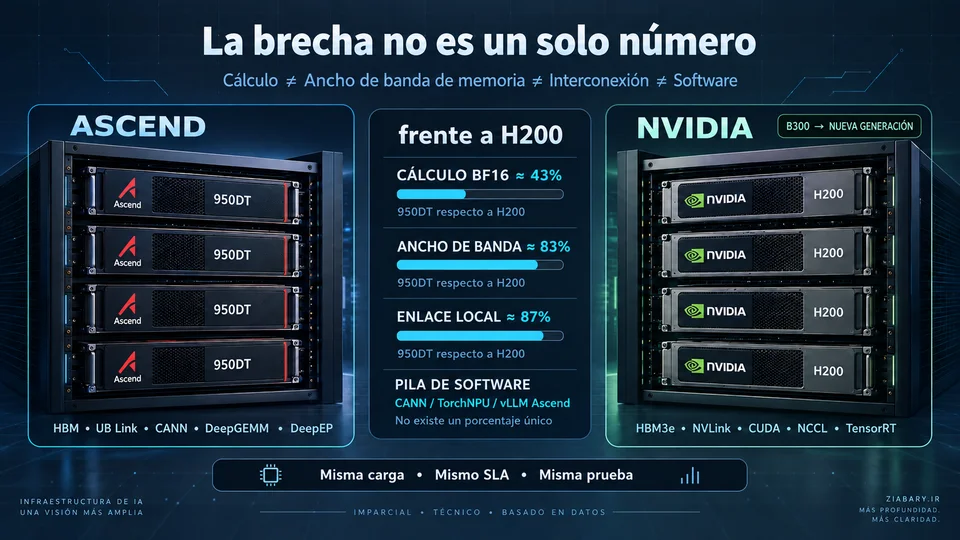
Ascend frente a NVIDIA: ¿cuál es la brecha real de rendimiento?
De Ascend 910C y 950PR/DT a H200 y B300: comparación de especificaciones equivalentes, memoria, kernels, interconexiones, software de inferencia y costes de operación. Leer artículo →
Modelos de lenguaje Publicado 29 de septiembre de 2026 · 7 min
Cuando un modelo de pesos abiertos crea exploits: ¿dónde acaba la defensa y empieza la infraestructura de ataque?
¿Qué revelan las evaluaciones de NIST y Anthropic sobre GLM-5.3 y qué debe cambiar cuando un equipo da acceso a herramientas a un agente de programación? Leer artículo →
Producto y negocio Publicado 26 de septiembre de 2026 · 14 min
Un contrato de IA: ¿qué debemos recibir exactamente?
Un modelo o una demostración que funciona no bastan como entrega de un proyecto de IA. Guía práctica sobre criterios de aceptación, datos, pruebas, seguridad, operación, cambios de versión y salida del proveedor. Leer artículo →
Inteligencia artificial Publicado 26 de septiembre de 2026 · 7 min
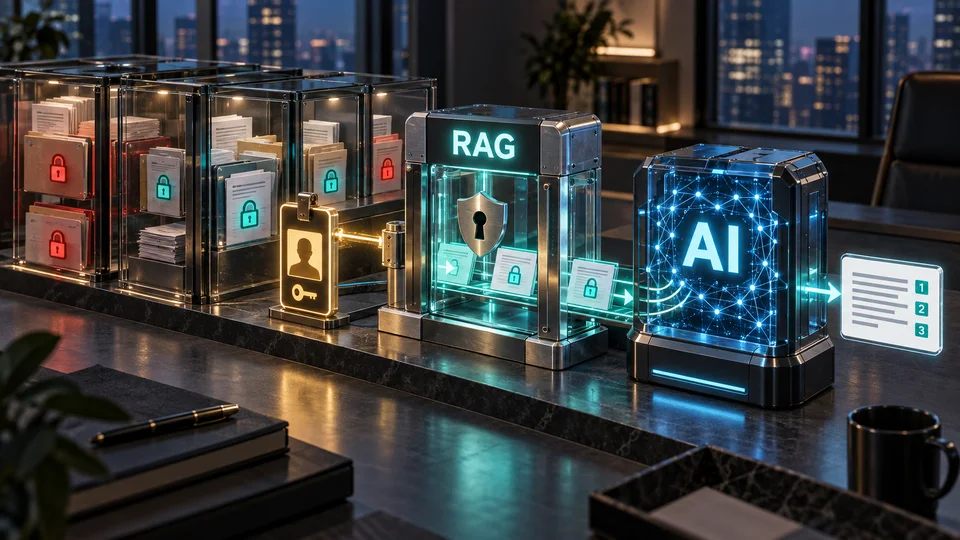
El RAG empresarial necesita más que embeddings: los permisos deben aplicarse en la recuperación
Una respuesta correcta puede proceder de un documento que el usuario no tiene permiso para leer. El anuncio de Compass Cloud permite examinar el control de acceso en la recuperación y distinguirlo del lugar donde se procesan los datos. Leer artículo →
Infraestructura de IA Publicado 19 de septiembre de 2026 · 18 min
¿De dónde viene la sobrecarga de la computación confidencial en GPU?
¿Por qué una pila de inferencia confidencial en B200 pierde un 39 % de rendimiento y otra solo unos pocos puntos? Analizamos las mediciones de envío de comandos, PCIe, NVLink cifrado y software de inferencia. Leer artículo →
Modelos de lenguaje Publicado 16 de septiembre de 2026 · Actualizado 19 de septiembre de 2026 · 14 min
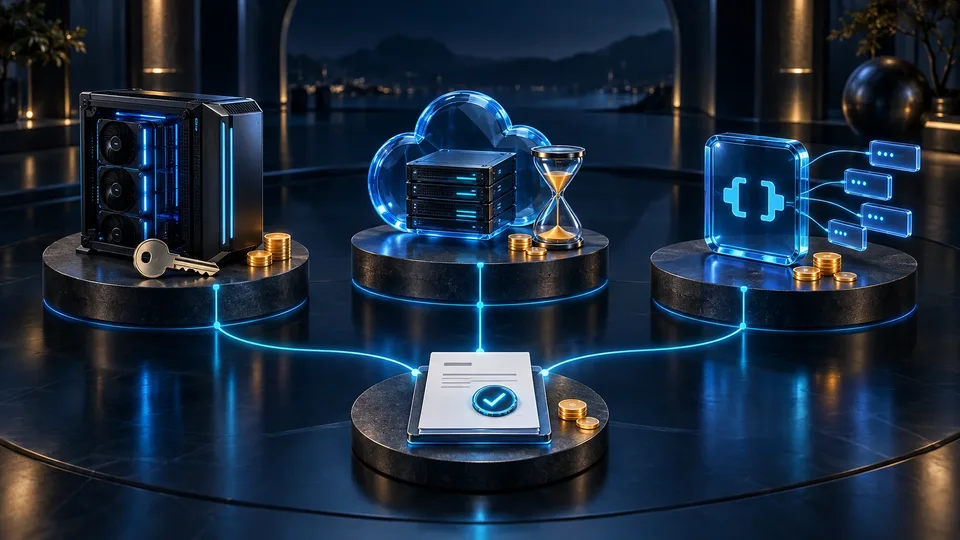
El coste real de ejecutar un LLM: comprar hardware, alquilar GPU o usar una API
Un supuesto calculado en USD para comparar API, alquiler y propiedad, con reintentos, respuestas aceptadas, operación, energía y umbrales económicos condicionados. Leer artículo →
Modelos de lenguaje Publicado 2 de septiembre de 2026 · Actualizado 19 de septiembre de 2026 · 14 min