اواسط فروردین بود که یکی از دو سرورمان از مدار خارج شد و داشت مدل را دوباره بارگذاری میکرد. تمام بار سرویس افتاده بود روی سرور باقیمانده؛ یک RTX 4090 معمولی با ۲۴ گیگابایت حافظه که باید هم ترجمه میکرد، هم خلاصه مینوشت و هم جواب چتها را میداد. در همان شرایط، تعداد درخواستهای همزمان سامانه به حدود ۳۰۰ رسید. برای ما که سالها با محدودیت سختافزار سر کرده بودیم، لحظه آشنایی بود، البته با یک عدد تازه!
همین اول بگم که همه این درخواستها با موفقیت و سرعت مطلوب پاسخ نمیگرفتند. زیر فشار، پاسخها کند میشدند و درخواستهایی که تا ۲۰ ثانیه شروع به پاسخگویی نمیکردند، لغو میشدند. عدد ۳۰۰، تعداد درخواستهای همزمان در آن وضعیت پرفشار است؛ برای تعداد پاسخهای موفق، باید لغوشدنها را هم حساب کرد. چند سال پیش در یادداشت «۷۰ میلیون کلمه ترجمه در روز!» هم همین اتفاق را شرح دادیم: بیش از ۷۲ میلیون کلمه تقاضای ترجمه رسید، بیش از ۶۵ میلیون کلمه ترجمه شد و بقیه به سقف منابع خوردند. این بار هم قصه، هم رسیدن مردم به سرویس بود و هم رسیدن ما به سقف توان پردازشی.
اما این عدد چطور به دست آمد و اصلاً چرا در روزهای جنگ رمضان سراغ چنین سرویسی رفتیم؟ برای توضیحش باید چند ماه به عقب برگردم.
وقتی حتی کد ورود هم نمیرسید
ترگمان را بیشتر با ترجمه ماشینی میشناسند. از اوایل دیماه ۱۴۰۴، سرویس مبتنی بر مدل زبانی را هم راه انداخته بودیم و داشتیم امکاناتش را گسترش میدادیم. حدود ۱۰ اسفند، یک روز پس از حمله آمریکا و رژیم صهیونیستی به کشور، شهادت رهبری عزیز و جمعی از فرماندهان و مسوولین و آغاز جنگ رمضان، شرایط کار عوض شد. ارتباط با اینترنت بینالمللی قطع بود و اختلال پیامک هم باعث شده بود مردم برای ورود به بعضی سرویسهای داخلی گرفتار شوند. ممکن بود خود سرویس در دسترس باشد، اما کد یکبارمصرف ورود به دست کاربر نرسد. در بسته بود، حتی وقتی کسی آن طرف در حضور داشت.
تصمیم گرفتیم دستیار هوشمند ترگمان را کاملاً رایگان و بدون نیاز به ثبتنام در اختیار مردم بگذاریم و معرفی و توسعه امکاناتش را جدیتر دنبال کنیم. بعدتر، ثبتنام از طریق پیامرسان بله را هم اضافه کردیم تا سامانه وابسته به رسیدن پیامک نباشد اما در عین حال با احراز هویت بتوانیم محدودیتهای سرویس رو کاهش بدیم. در آن وضعیت، همین تصمیم به ظاهر ساده به اندازه بعضی انتخابهای فنی اهمیت داشت؛ کاربری که نمیتواند وارد شود، از بهترین مدل دنیا هم استفادهای نمیبرد.
هدفمان این بود که مردم بدون ابزار نمانند. کسی که برای درسش کمک میخواست، متنی برای ترجمه داشت یا میخواست از داخل یک فایل جواب سوالش را پیدا کند، هنوز به این کارها احتیاج داشت. شرایط جنگی این نیازها را از بین نبرده بود؛ دسترسی به ابزارهای انجامشان سخت شده بود.
پشت صفحه ترگمان چه خدماتی بود؟
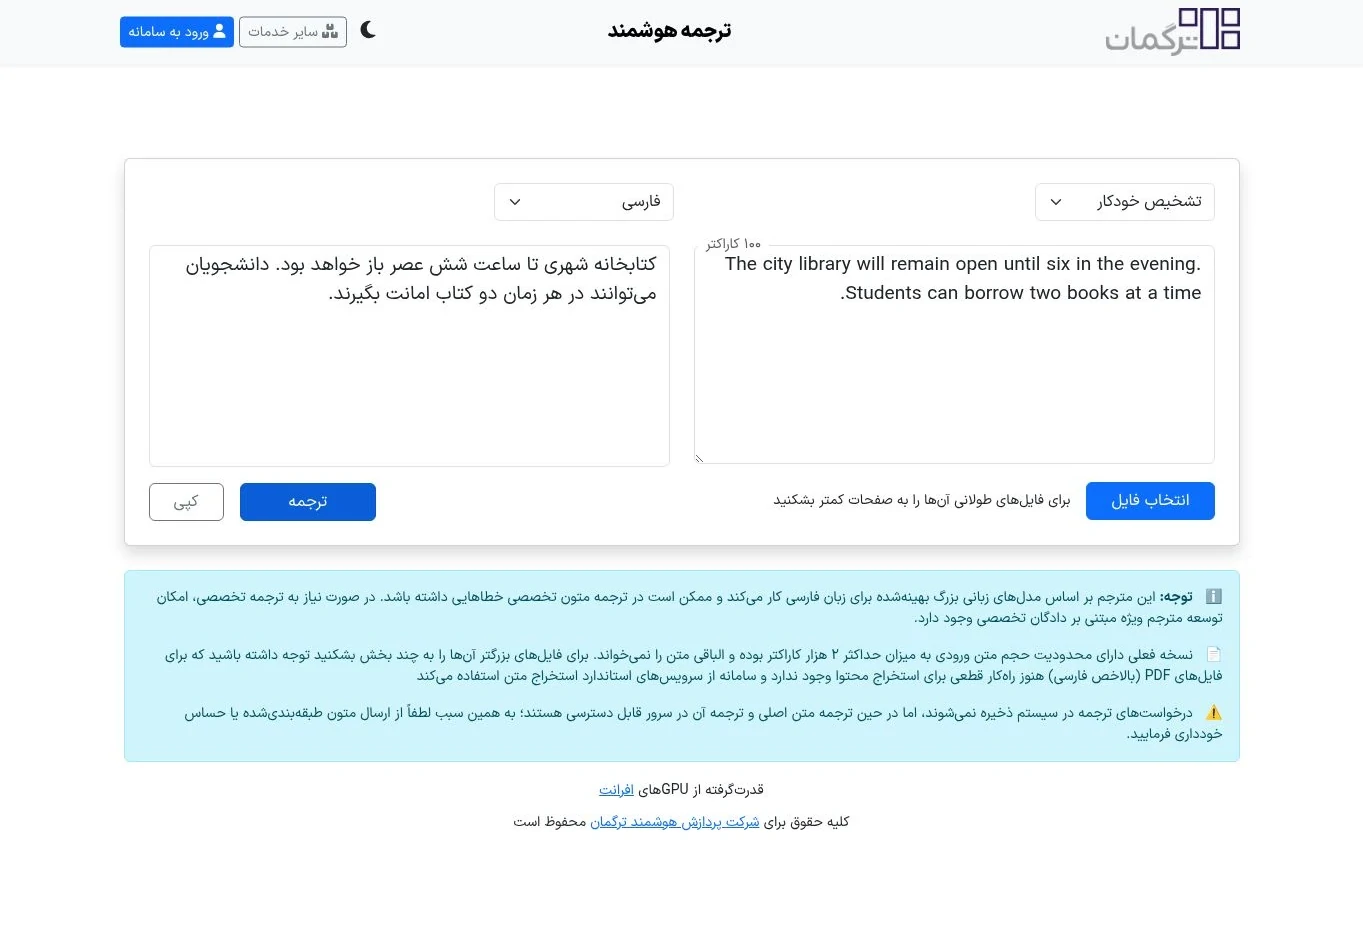
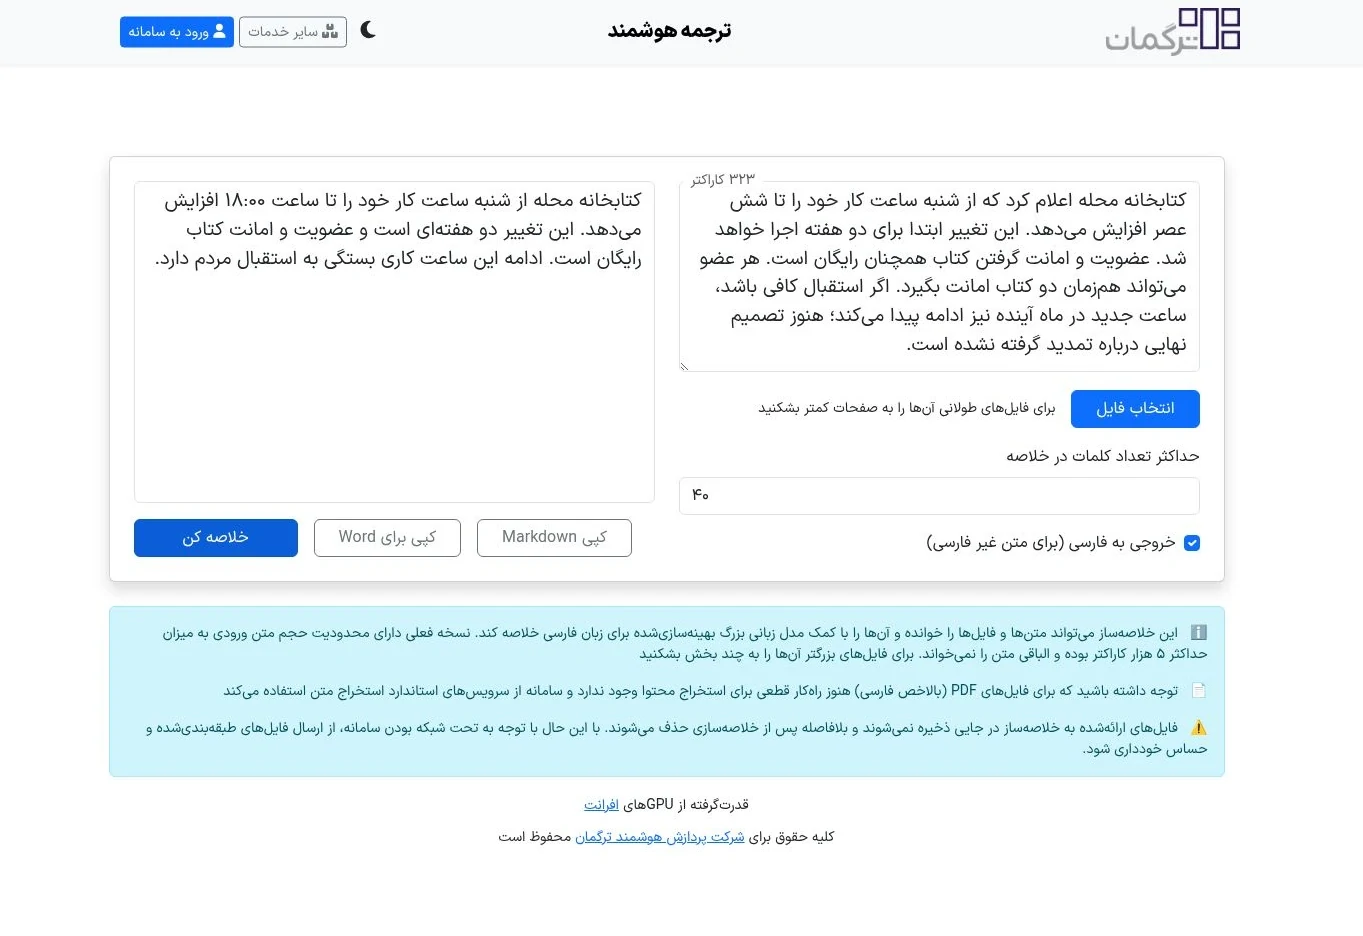
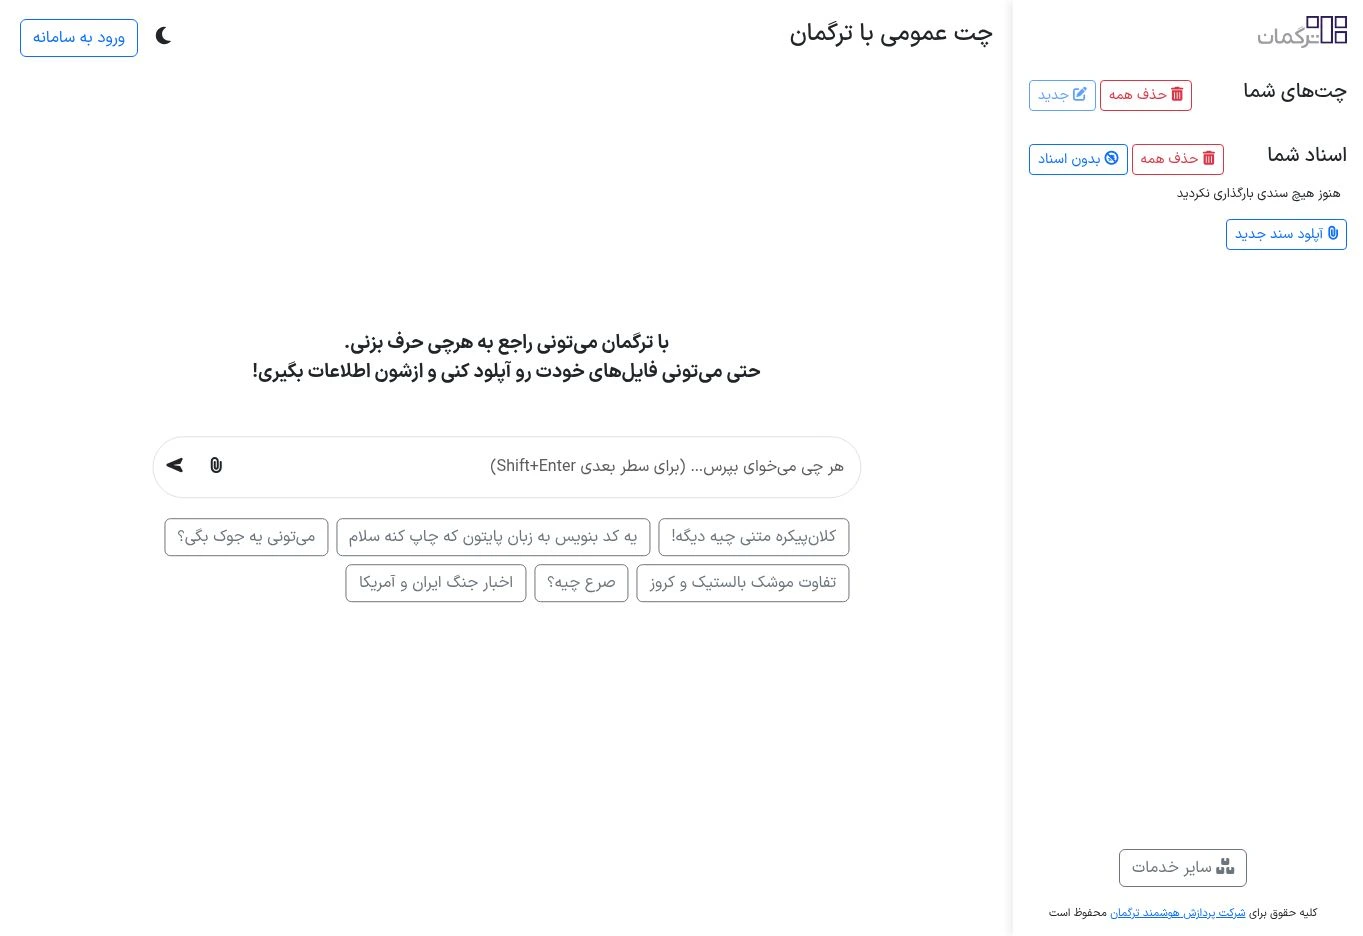
وقتی از خدمت رایگان حرف میزنم، منظور فقط یک کادر برای چتکردن نیست. سه خدمت اصلیِ مبتنی بر مدل زبانی داشتیم و در کنارشان، امکاناتی برای دسترسی به فایلها و مستندات هم در سایت قرار گرفته است. هر کدام به یک نیاز مشخص جواب میدهند؛ از خواندن یک متن خارجی تا پیدا کردن راهنمای یک کتابخانه برنامهنویسی. تصاویر این بخش، نمای رابط خدمات هستند و برای معرفی امکانات آورده شدهاند.
ترجمه؛ همان نیاز قدیمی، با موتور تازه
در بخش ترجمه، کاربر متنش را وارد میکند یا فایل میدهد، زبان مقصد را انتخاب میکند و ترجمه را تحویل میگیرد. برای کسی که یک متن درسی، راهنما یا نامه خارجی جلویش بود، این همان کاری بود که از ترگمان انتظار داشت؛ بدون اینکه لازم باشد درباره مدل و سختافزار چیزی بداند. در این بخش از سرویس جدید، ترجمه متن را مدل زبانی انجام میداد، اما درخواستهای دیکشنری مسیر خودشان را داشتند و بیدلیل وارد مدل نمیشدند.
خلاصهسازی؛ وقتی لازم نیست همه متن را خطبهخط بخوانیم
خلاصهساز ترگمان برای جمعکردن نکات اصلی یک متن یا فایل بود. کاربر میتوانست اندازه مطلوب خلاصه را مشخص کند و برای متن غیرفارسی هم خروجی فارسی بخواهد؛ مثلاً یک گزارش را به خلاصهای کوتاهتر تبدیل کند تا بفهمد موضوعش چیست و کدام بخشها ارزش خواندن دقیقتر دارند. امکان کپی خروجی برای Word و Markdown هم در رابط قرار دارد تا حاصل کار فقط در صفحه سایت باقی نماند.
چت عمومی و چت با فایل؛ سوال خودت را بپرس
در چتبات ترگمان، کاربر میتوانست گفتوگوی عمومی داشته باشد، برای درس و نوشتن متن کمک بگیرد یا فایل خودش را بارگذاری کند و درباره آن سوال بپرسد. در حالت دوم، بخش بازیابی اطلاعات، قسمتهای مرتبط فایل را در اختیار مدل میگذاشت تا پاسخ به محتوای سند تکیه داشته باشد. برای استفاده از این امکان لازم نبود کاربر بداند RAG چیست؛ کافی بود سندش را بدهد و سوالش را بپرسد. البته پیدا کردن جواب در فایل با تضمین درستی هر پاسخ فرق دارد و برای تصمیم مهم، مراجعه به متن اصلی همچنان ضروری است.
اندیشه رهبر شهید؛ همان مدل، با منابعی مشخص
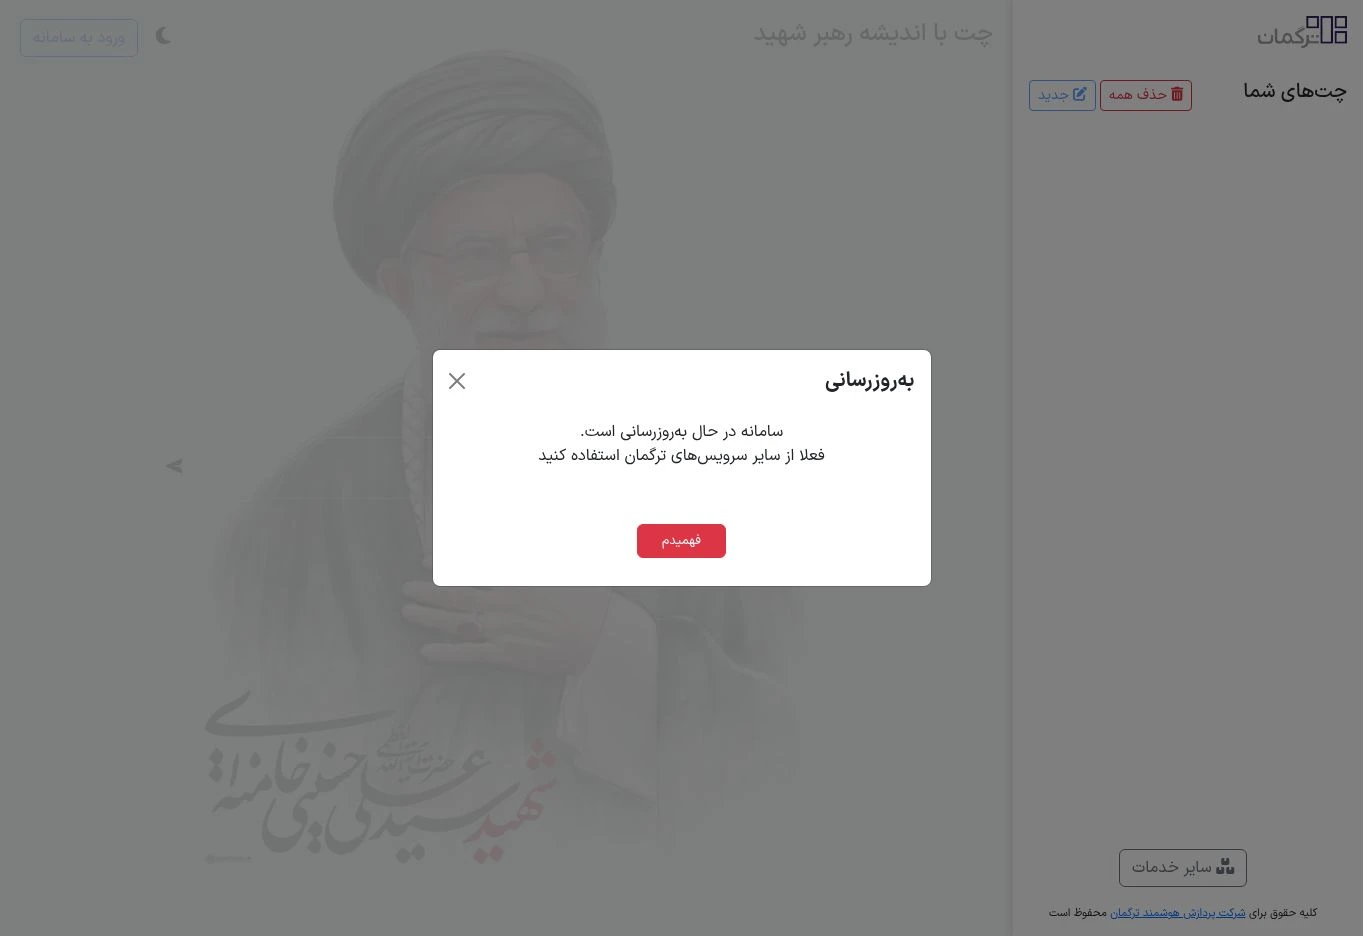
بخش «اندیشه رهبر شهید» هم با استقبال زیادی روبهرو شد. برای این بخش هم همان مدل مشترک را به کار گرفته بودیم، اما محتوای سایتهای khamenei.ir و leader.ir و مجموعهای از مطالب مرتبط با نحوه شهادت و پاسخ به شبهات را از طریق RAG در اختیارش گذاشتیم. کاربرها فقط سوال اطلاعاتی نمیپرسیدند؛ درخواست دلنوشته و گفتوگو با رهبر شهید هم در میان استفادهها دیده میشد. پاسخها، متن تولیدشده توسط سامانه بر پایه منابع بودند و نباید با سخن واقعی یا نقلقول ایشان اشتباه گرفته شوند. این بخش کمتر از دو هفته پس از آغاز سرویسدهی، به درخواست مقامات متوقف شد؛ با این حال همان مدت کوتاه، استفادههایی را نشان داد که با ترجمه و پرسش درسی کاملاً متفاوت بودند.
فایلهای کاربردی؛ گاهی مشکل، نرسیدن به یک بسته نرمافزاری است
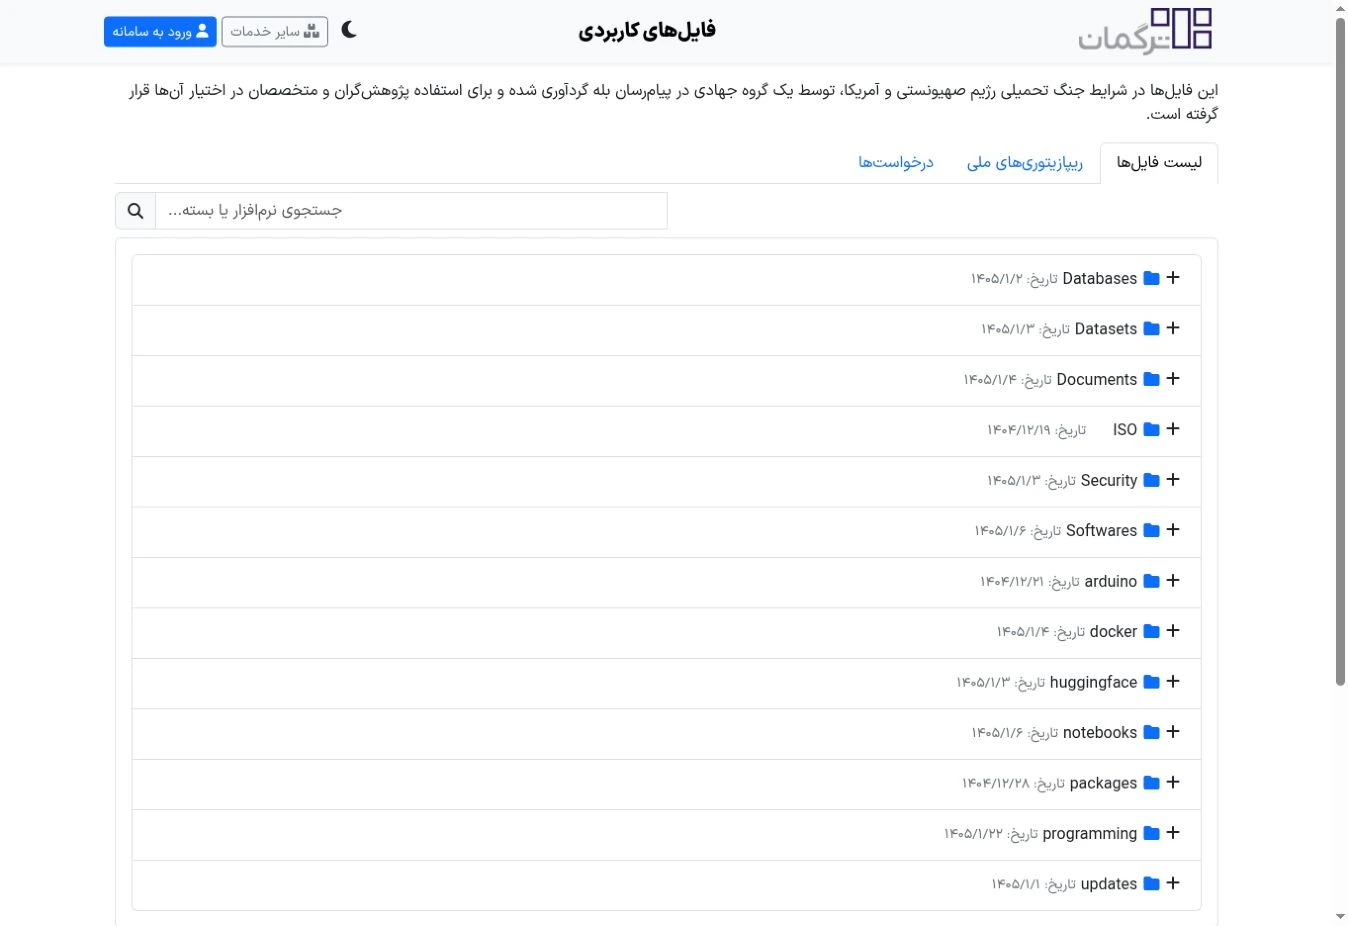
در زمان قطع ارتباط خارجی، داشتن ابزار گفتوگو بهتنهایی همه مشکلات یک برنامهنویس یا پژوهشگر را حل نمیکند. ممکن است کار فقط به خاطر دانلودنشدن یک بسته، مدل یا مجموعهداده متوقف شده باشد. بخش فایلهای کاربردی برای دسترسی به مجموعهای از همین منابع است؛ دستههایی مثل نرمافزار، دادگان، بستههای برنامهنویسی و فایلهای مدل در آن دیده میشود و امکان جستوجو و ثبت درخواست هم دارد. این مجموعه حاصل گردآوری یک گروه جهادی در پیامرسان بله بود و سهم آنها در فراهمکردن منابع شایسته تقدیر است.
راهنمای توسعهدهندگان؛ مستندات هم باید در دسترس باشند
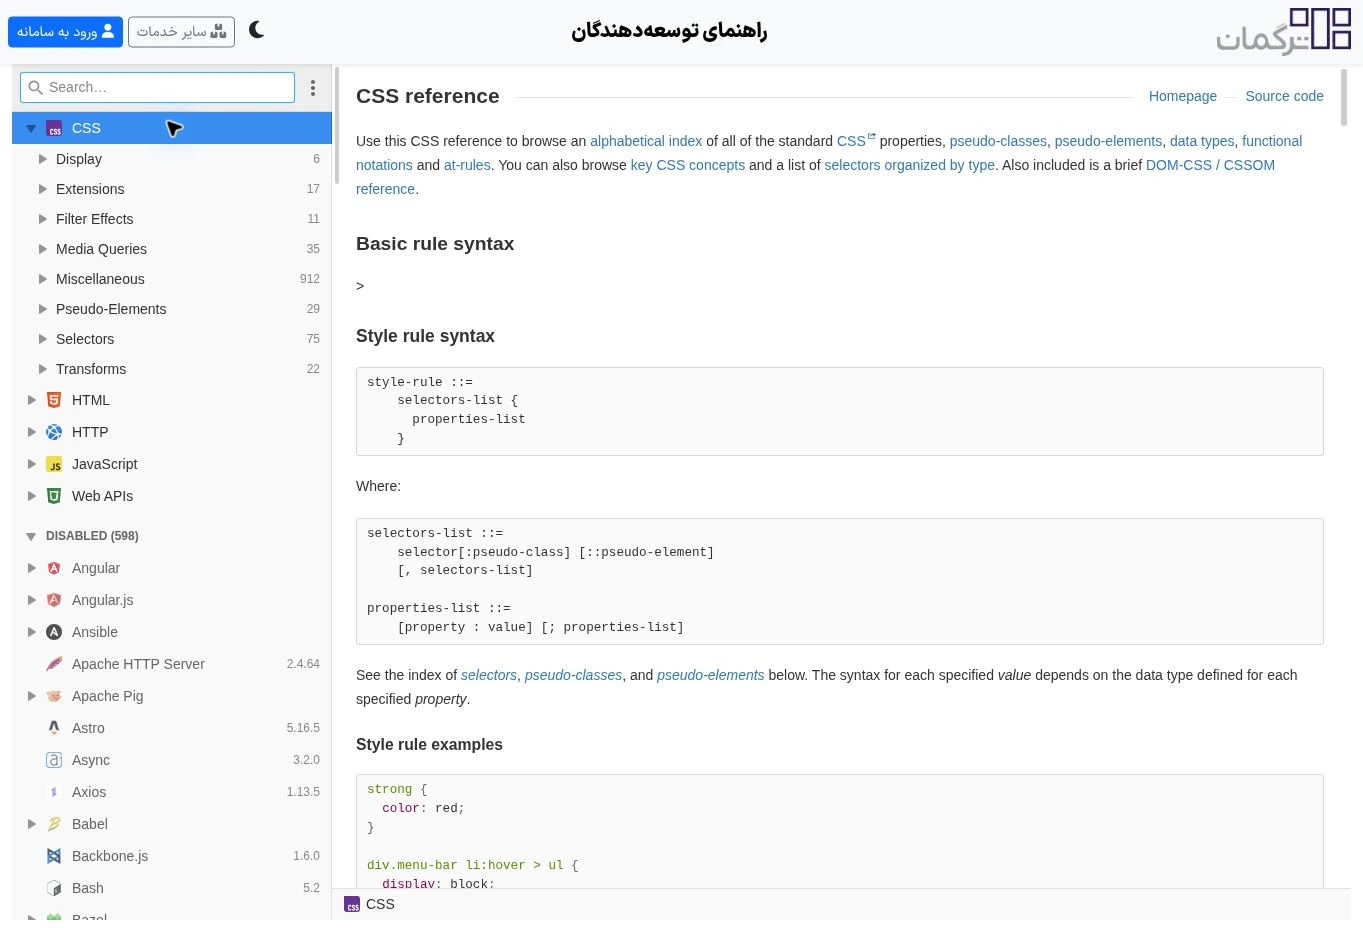
راهنمای توسعهدهندگان محیط DevDocs را از میزبانی ترگمان در اختیار کاربر میگذارد. برای نمونه، مستندات CSS، HTML، JavaScript، HTTP و Web APIها از همین محیط قابل مرور و جستوجو هستند. کسی که میخواهد روش استفاده از یک قابلیت را پیدا کند، اغلب بیشتر از یک پاسخ حدسی به همان مستندات اصلی احتیاج دارد؛ نگهداشتن این راه دسترسی، بخش دیگری از کمک به ادامه کار بود.
راهنمای scikit-learn؛ برای کسانی که خودشان مدل میسازند
راهنمای scikit-learn هم دسترسی به مستندات و مثالهای این کتابخانه یادگیری ماشین را فراهم میکند؛ از طبقهبندی و رگرسیون تا خوشهبندی و انتخاب مدل. این بخش برای دانشجو، پژوهشگر یا برنامهنویسی مفید است که میخواهد کار خودش را ادامه بدهد و برای دیدن راهنمای یک تابع یا مثال آموزشی گرفتار دسترسی خارجی شده است. ارائه این مستندات و فایلهای کاربردی به تولید متن با GPU احتیاج ندارد؛ هزینه و نیاز فنیشان با سه خدمت مبتنی بر مدل زبانی متفاوت است.
سه خدمت، یک مدل مشترک
زیرساخت سرویس دو سرور مستقل بود که در هر کدام یک RTX 4090 با ۲۴ گیگابایت حافظه به ترگمان اختصاص داشت. در حالت عادی هر دو فعال بودند و بار بینشان توزیع میشد. هر سرور میتوانست هر سه خدمت اصلی را ارائه کند؛ ترجمه به یک کارت و چت به کارت دیگر اختصاص نداشت. وقتی یکی از سرورها در حال بارگذاری مجدد مدل بود، سرور باقیمانده هر سه خدمت را ادامه داد و همانجا بود که آن فشار بهیادماندنی را دیدیم.
مدل مشترک، نسخهای فاینتیونشده از Aya Expanse هشتمیلیاردپارامتری بود که با استفاده از دادگان کلانپیکره فارسی ترگمان، TLPC، بهبودش داده بودیم. وزنهای مدل هم کوانتیزه شده بودند تا حافظه کمتری بگیرند و جا برای سرویسدهی باقی بماند. پشت این انتخاب، تجربه کار با متن فارسی قرار داشت؛ همان تجربهای که بخشی از داستانش در «قصه ترگمان: بدون رانت هم مگر میشود؟» آمده است.
برای اجرای مدل از نسخه vLLM منتشرشده توسط NVIDIA استفاده کردیم و تغییرات محدودی در لایه سرویس و API آن دادیم تا کنترل بهتری روی درخواستها داشته باشیم. روی هر سرور، یک موتور مشترک درخواستهای ترجمه، خلاصهسازی و چت را میگرفت. تفاوت خدمتها را منطق برنامه، دستورهایی که به مدل میدادیم و اطلاعاتی که همراه درخواست میفرستادیم، ایجاد میکرد. پردازش دستهای درخواستها، مدیریت حافظه و رسیدگی مرحلهای به ورودیهای طولانی، کمک میکرد از همان کارت استفاده بیشتری ببریم. ذخیرهسازی NVMe هم در زیرساخت داشتیم. اما قرار نیست اینجا فایل تنظیمات سرور را ردیف کنم؛ نکته مهم این است که سه خدمت لزوماً به سه مدل بارگذاریشده و سه کارت جدا احتیاج نداشتند. در این سرویس، یک مدل مشترک توانست پایه هر سه باشد.
برای چت با فایل هم از Qdrant و مدل embedding با نام multilingual-e5-large-instruct استفاده کردیم. مدل embedding روی همان GPU اجرا میشد و کارت جداگانهای برایش نداشتیم. فایلهای متنی، Word، PDF، ODT و Markdown پشتیبانی میشدند، اما OCR نداشتیم؛ بنابراین PDF اسکنشدهای که متن قابل استخراج نداشت، با PDF متنی یکسان نبود. این مرز امکانات برای استفاده واقعی مهمتر از فهرست بلندبالای نام فناوریهاست.
مدلی که از خبرهای روز باخبر بود
یکی از واکنشهای جالب کاربران، تعجب از بهروز بودن پاسخها بود. در شرایطی که ارتباط خارجی قطع شده بود، انتظار نداشتند یک مدل زبانی درباره موضوعات همان روز چیزی بداند. برای ایجاد این تجربه، تاریخ روز را در اختیار مدل میگذاشتیم، خبرهای مهم سایتهای داخلی را هر ساعت میخزیدیم و اطلاعات و توضیحات مرتبط با موضوعات روز را به جریان پاسخگویی اضافه میکردیم.
خبری که یک ساعت قبل منتشر شده بود، طبیعتاً در وزنهای مدلی که از قبل آموزش دیده بود وجود نداشت. برنامه، اطلاعات تازه را به مدل میرساند تا هنگام پاسخدادن از آن استفاده کند. ترکیبی از بازیابی اطلاعات و مهندسی پرامپت، همان چیزهایی که با نامهای RAG و Prompt Engineering شناخته میشوند، باعث میشد گفتوگو برای کاربر زندهتر و مرتبطتر با اتفاقات اطرافش باشد. این هم به معنی درستی تمام پاسخها یا دسترسی به همه خبرها نبود؛ محدوده اطلاعات تازه، همان منابعی بود که گردآوری میکردیم.
در اینجا یک تفکیک مهم وجود دارد: ارتباط بینالمللی قطع بود، اما منابع داخلی در دسترس ما بودند. خزش خبرها از همان منابع انجام میشد و پردازش مدلها هم روی سرورهای خودمان بود. تولید پاسخ به فراخوانی سرویس خارجی وابسته نبود. برای ما، ادامه کار سامانه در آن شرایط شاهد عملی این استقلال بود؛ چیزی که توضیح دادنش در یک جلسه معرفی محصول، به اندازه تجربه کردنش قانعکننده نیست.
لازم نبود برای خبرهای هر ساعت دوباره مدل را آموزش بدهیم. این تجربه نمونه خوبی از کاربرد کنار هم قرارگرفتن آموزش، بازیابی و طراحی پرامپت بود.
مردم با ترگمان چه کار میکردند؟
در زمان اوج، حدود دو هزار کاربر در دقیقه در لاگهای سامانه ثبت شد. این عدد از شمارش شناسه یکتای کاربران در درخواستها، مستقل از نتیجه آنها، به دست آمده بود؛ ضمن اینکه همه درخواستهای سامانه هم وارد مدل زبانی نمیشدند. برای فهم فشار واقعی روی GPU، باید ببینیم مردم از کدام بخشها استفاده میکردند.
حدود ۴۰ درصد استفاده مربوط به ترجمه بود. از همین سهم ترجمه، حدود ۳۰ درصد به دیکشنری مربوط میشد و اساساً نیازی به LLM نداشت. سهم خلاصهسازی کمتر از پنج درصد بود و باقی استفاده به چتبات میرسید. در چت هم کمتر از ۲۰ درصد استفاده مبتنی بر فایلهای تخصصی بود و بیشتر مردم چت عمومی میکردند. این نسبتها تقریبیاند، اما یک نکته روشن دارند: برای سرویسدادن، لازم نبود هر کاری را به مدل زبانی بسپاریم. پاسخ دیکشنری را از مسیر خودش میدادیم و ظرفیت مدل برای کارهایی میماند که به آن احتیاج داشتند.
از بررسی تقریبی گزارشهای گفتوگو، حدود ۴۰ درصد کاربران را دانشآموزانی برآورد کردیم که برای کمک درسی سراغ سامانه آمده بودند. این یک برداشت از محتوای گفتوگوها بود، نه آمار سن احرازشده کاربران. با این حال برای ما معنی روشنی داشت: بخش بزرگی از تقاضا، از طرف کسانی بود که میخواستند درسشان را ادامه بدهند و برای سوالهایشان یک همراه در دسترس داشته باشند.
بالاخره زیر آن فشار چه کیفیتی داشتیم؟
در زمان خلوتی، پاسخ معمولاً در کمتر از یک ثانیه شروع میشد و سرعت خروجی حدود ۳۰ توکن در ثانیه بود؛ این سرعت را از تقسیم تعداد توکنهای پاسخ بر زمان پاسخ در لاگها به دست میآوردیم. در اوج فشار، شروع پاسخ ممکن بود تا مرز ۲۰ ثانیه عقب بیفتد و سرعت پاسخ در مواردی به حدود یک توکن در ثانیه برسد. کسی که منتظر جواب نشسته بود، این افت سرعت را کاملاً حس میکرد.
برای درخواستهایی که تا ۲۰ ثانیه شروع به پاسخگویی نمیکردند، لغو درخواست را به خود vLLM هم میفرستادیم تا موتور به پردازش درخواستی که انتظارش تمام شده ادامه ندهد. با این کار، بخشی از تقاضا ریزش میکرد و منابع آن برای درخواستهای باقیمانده آزاد میشد. خوشایند نبود، اما ادامهدادن پردازش درخواستهایی که کاربر دیگر منتظرشان نبود هم فقط صف را طولانیتر میکرد.
عدد حدود ۳۰۰ درخواست همزمان را باید در همین وضعیت خواند: یک سرور در حال بارگذاری مجدد مدل، یک کارت باقیمانده زیر بار سه خدمت، پاسخهای کندتر و درخواستهایی که لغو میشدند. برای ما اهمیت ماجرا در این بود که سرویس روی همان کارت ادامه پیدا کرد و مردم همچنان میتوانستند از آن استفاده کنند، هرچند با انتظار بیشتر و احتمال بیپاسخماندن درخواست.
سهم مهندسی در کنار سهم سختافزار
این تجربه برای ما پس از بیش از ۱۰ سال ارایه سرویس باز هم آموزنده بود. یک مدل هشتمیلیاردی فشردهشده، وقتی اطلاعات مناسب را در اختیارش بگذاریم و درخواستها را درست مدیریت کنیم، میتواند کارهای متنوع و مفیدی انجام بدهد. ترجمه، خلاصهسازی، کمک درسی و پاسخ بر پایه اسناد، همگی از همان مدل استفاده میکردند. برای کاربری که فقط میخواست متنش را بفهمد یا جواب سوالی را در فایلش پیدا کند، عدد پارامترهای مدل موضوع اصلی نبود؛ نتیجهای که میگرفت اهمیت داشت.
این به معنای کافیبودن 4090 برای هر سازمان و هر حجم باری نیست. خود ما هم با افزایش تقاضا به سقف منابع رسیدیم. اما تجربه نشان داد که برای شروع یک خدمت مفید، انتخاب مدل متناسب و طراحی درست سرویس چقدر میتواند فاصله میان امکانات موجود و نیاز کاربران را کم کند. پیش از خرید سختافزار بیشتر، ارزش دارد ببینیم کدام درخواست واقعاً به مدل احتیاج دارد، چه اطلاعاتی باید در اختیار مدل گذاشته شود و چند خدمت میتوانند از یک موتور مشترک استفاده کنند.
دو سرور مستقل هم فایدهشان را همان روز نشان دادند. وقتی یکی از مدار خارج شد، دیگری امکان ادامه خدمت را فراهم کرد؛ هرچند با ظرفیت و سرعت کمتر. اضافهکردن منابع فقط برای بالابردن عدد پردازش نیست، برای این هم هست که با توقف یک جزء، تمام خدمت متوقف نشود. سرورها در افرانت میزبانی میشدند و از همکاران افرانت هم بابت میزبانی زیرساخت در آن روزها تشکر میکنم.
سالها پیش در «ماجرای استفاده گوگل از ترگمان» از خوشحالی و گرفتاریهای کار روی یک محصول فارسی نوشتم. این بار هم سهم گرفتاری کم نبود: اینترنت قطع، ورود با پیامک مشکلدار، منابع محدود و تقاضایی که به سقف توان میرسید. در میان همین گرفتاریها، ترگمان توانست ابزاری رایگان برای ترجمه، خواندن، یادگرفتن و گفتوگو در دسترس مردم نگه دارد. برای من، خاطره آن یک کارت و حدود ۳۰۰ درخواست همزمان، با همین استفادههای روزمره مردم گره خورده است.