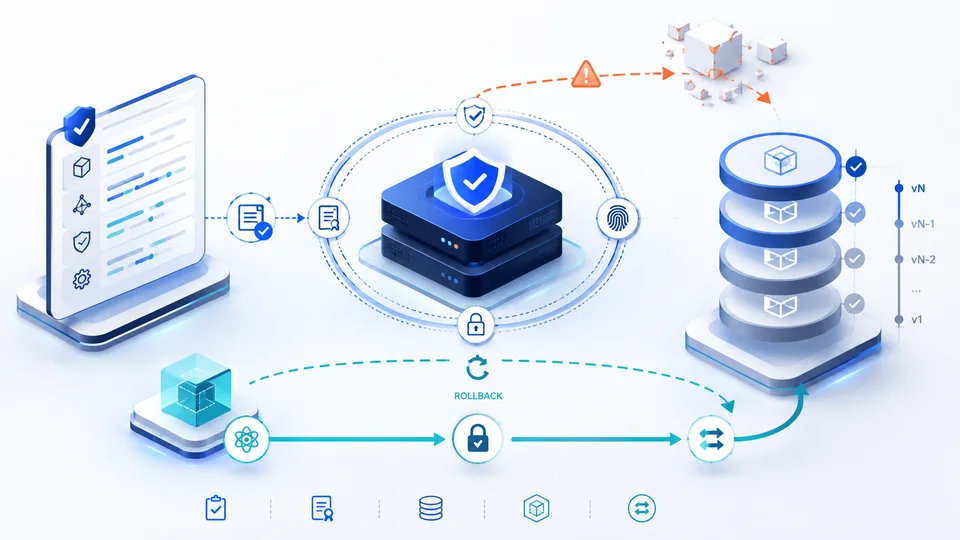
امنبودن در لحظهٔ نصب یا درستپیکربندیشدن در روز اول، تضمینی برای تداوم امنیت نیست. بسیاری از اختلالات جدی نه با یک حملهٔ آشکار، بلکه با تغییرهای کوچک، موجه و ثبتنشده آغاز میشوند. هر تغییر بهتنهایی بیخطر به نظر میرسد، اما مجموع آنها فاصلهٔ میان «آنچه سامانه باید باشد» و «آنچه واقعاً هست» را افزایش میدهد.
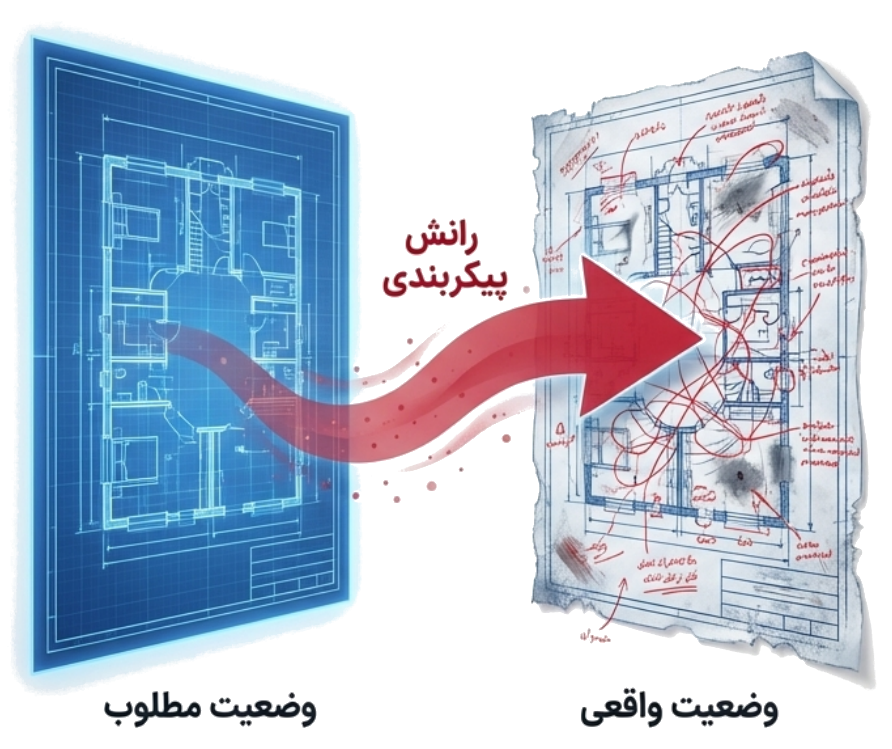
این پدیده رانش پیکربندی است. بهروزرسانی جزئی، اصلاح اضطراری، تفاوت ترتیب نصب بستهها، تغییر permission، فعالماندن یک پورت موقت یا نصب ابزاری برای عیبیابی میتواند دو سروری را که روز نخست یکسان بودهاند، به دو سامانهٔ متفاوت تبدیل کند.
سرور منحصربهفرد، دارایی ارزشمند نیست
در محیطهای طولانیعمر، اصلاحات دستی در لحظهٔ بحران بهتدریج «سرورهای منحصربهفرد» میسازند؛ سامانههایی که دیگر قابل تکثیر، بازسازی یا مقایسه نیستند. شناخت آنها در ذهن یک یا دو مدیر باقی میماند و حتی اسکریپت امنیتی یکسان روی دو میزبان ظاهراً مشابه نتیجهٔ متفاوت میدهد.
از منظر امنیتی، رانش سطح حمله را بیصدا تغییر میدهد. ممکن است سطح وصلهٔ دو سامانه یکسان باشد، اما روی یکی سرویس اضافهای فعال، ماژولی متفاوت بارگذاری یا دسترسی موقتی فراموش شده باشد. گزارش «همهٔ بستهها بهروزند» این تفاوت را نشان نمیدهد.
رانش را نمیتوان فقط با دقت بیشتر یا مستندسازی بهتر حذف کرد. در مقیاس سازمانی و در طول زمان، رانش یک پدیدهٔ طبیعی است. بلوغ سازمان در توان شناسایی، مهار و بازگرداندن سامانه به وضعیت مورد انتظار دیده میشود.
Snapshot و وضعیت اعلامی، پاسخ یکسانی نمیدهند
Snapshot تصویری از وضعیت سامانه در یک نقطهٔ زمانی است. ارزش آن فقط سرعت بازیابی نیست؛ امکان «بازگشت بدون تفسیر» است. وقتی snapshot معتبر وجود دارد، لازم نیست در لحظهٔ بحران حدس بزنیم کدام فایل، بسته یا تنظیم باید بازسازی شود.
اما snapshot میگوید سامانه چه بوده است، نه اینکه چه باید باشد. وضعیت اعلامی این شکاف را پر میکند. در مدل declarative، بستهها، تنظیمات، سرویسها و سیاستهای معتبر بهصورت صریح تعریف میشوند و سامانه با مرجع سنجیده میشود. هر انحراف—even اگر سرویس همچنان کار کند—یک وضعیت غیرعادی است.
دو رویکرد کلی وجود دارد. در رویکرد ترمیمی، ابزارهایی مانند Ansible انحراف را شناسایی و سامانه را به تعریف مرجع نزدیک میکنند. در رویکرد پیشگیرانه، لایههای تغییرناپذیر اساساً اجازه نمیدهند فایلهای حساس خارج از تراکنش مجاز تغییر کنند. انتخاب میان این دو، انتخاب میان ابزارها نیست؛ تعیین میکند سازمان رانش را پس از وقوع اصلاح میکند یا امکان وقوع آن را در لایهای از سامانه محدود میسازد.
پایش با اثبات وضعیت فرق دارد
پایش عملیاتی معمولاً میپرسد سرویس بالا هست یا نه، CPU اشباع شده یا دیسک پر است. این اطلاعات ضروریاند، اما نشان نمیدهند سامانه همان چیزی است که باید باشد.
اثبات وضعیت یا Attestation یعنی تولید شواهد فنی معتبر از وضعیت واقعی، بدون اتکا به ادعای همان لایهای که ممکن است آلوده شده باشد. این توان بر سه پایه استوار است:
- وضعیت مرجع باید دقیق و نسخهگذاریشده باشد.
- انحراف در بوت و زمان اجرا باید قابل مشاهده باشد؛ برای مثال با IMA/EVM و کنترل تمامیت فایلهای حساس.
- شواهد باید با ریشهٔ اعتماد سختافزاری امضا شوند تا مدیر بتواند از بیرون سامانه، سلامت ساختاری آن را ارزیابی کند.
در محیط آفلاین، این قابلیت اهمیت بیشتری دارد؛ زیرا بازرسی انسانی دائم و پایش خارجی برخط همیشه ممکن نیست. سامانه باید بتواند نشان دهد با چه زنجیرهٔ بوت، کرنل و پیکربندیای اجرا شده است.
شکست باید فرض طراحی باشد
بهروزرسانی ممکن است نیمهکاره بماند، درایور جدید با سختافزار سازگار نباشد، وابستگیها به بنبست برسند یا برق در بدترین لحظه قطع شود. معماری بالغ این رخدادها را «استثنای ناممکن» نمیداند؛ برای آنها رفتار تعریفشده دارد.
سیستم نباید اجازه دهد شکست جزئی به وضعیت خاکستری تبدیل شود: نه کاملاً سالم، نه آشکارا شکستخورده و نه قابل تحلیل. تغییر باید یا کامل اعمال شود یا سامانه به وضعیت معتبر قبلی برگردد. این رفتار، بار تصمیم را از لحظهٔ فشار به زمان طراحی منتقل میکند.
بازگشتپذیری واقعی با نسخهٔ پشتیبان یا امکان نصب مجدد یکی نیست. نصب مجدد یک وضعیت تازه میسازد که باید دوباره اعتبارسنجی شود. بازگشت واقعی یعنی رجوع کامل به آخرین وضعیت معتبر و آزمودهشده؛ نه الزاماً جدیدترین وضعیت.
بهروزرسانی اتمیک چه چیزی را عوض میکند؟
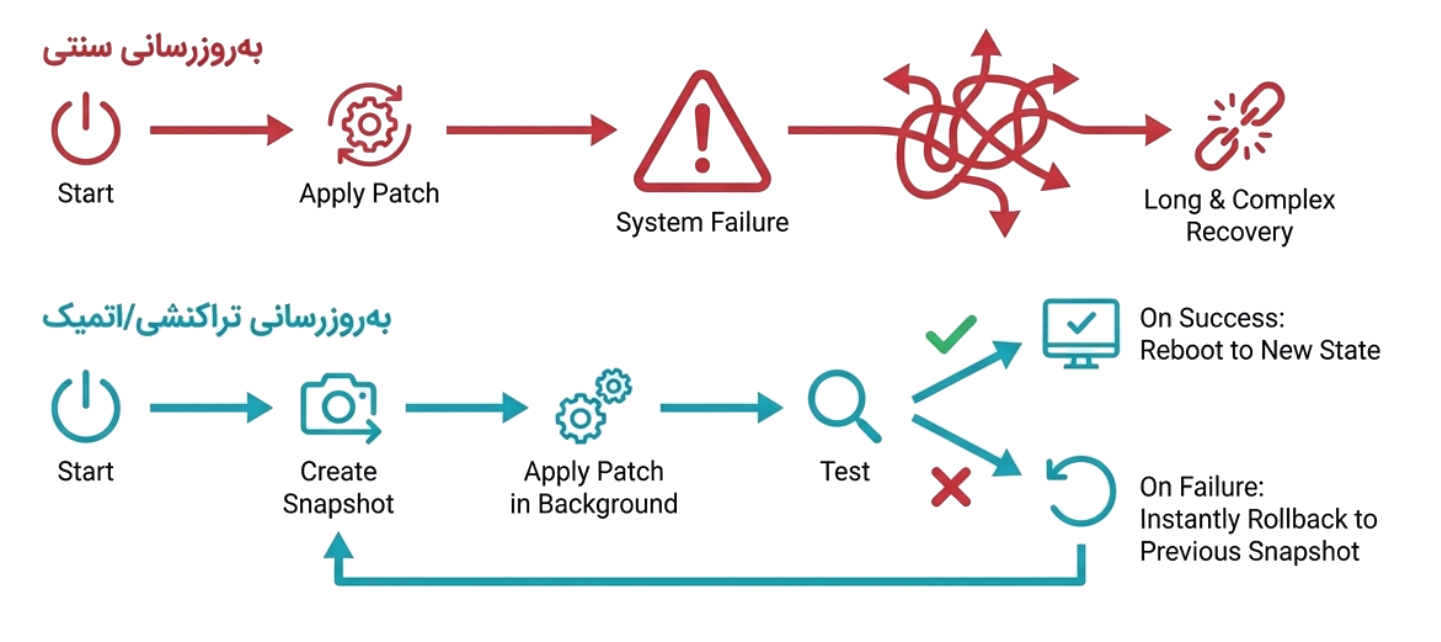
در بهروزرسانی تدریجی، بستهها روی وضعیت جاری تغییر میکنند. اگر تراکنش قطع شود، پایگاه دادهٔ بسته شاید سالم بماند اما فایلها، سرویسها و تنظیمات میتوانند در وضعیتی ناسازگار قرار گیرند. بازگردانی تاریخچهٔ package manager نیز الزاماً تغییرات فایل پیکربندی و اسکریپتهای پس از نصب را خنثی نمیکند.
در مدل اتمیک، تغییر روی یک وضعیت جدا اعمال میشود و وضعیت فعال تا لحظهٔ تأیید دستنخورده میماند. اگر نتیجه معتبر باشد، بوت بعدی به وضعیت جدید میرود؛ در غیر این صورت، سامانه به وضعیت قبلی ادامه میدهد. بازگشت بخشی از رفتار طبیعی سیستم است، نه عملیات اضطراری وابسته به حافظهٔ مدیر.
این مدل اختیار اپراتور را حذف نمیکند. برعکس، اجازه میدهد تغییر اجرا، نتیجه مشاهده و در صورت لزوم بازگردانده شود، بدون آنکه سامانه وارد وضعیت نامعلوم شود. آنچه کم میشود نیاز به تصمیم فوری و پرریسک در لحظهٔ شکست است.
پیشبینیپذیری و بازگشتپذیری مکملاند
پیشبینیپذیری ناظر بر پیش از شکست است: تغییر چه اثری دارد، وابستگی چگونه حل میشود و آیا نتیجه از پیش قابل تصور است. بازگشتپذیری ناظر بر پس از شکست است: اگر فرضها غلط بودند، سامانه چگونه از وضعیت نامطلوب خارج میشود.
اولی احتمال شکست را کم میکند و دومی هزینهٔ آن را محدود میسازد. پایدارترین سامانه نیز با خطای ترکیبی، سختافزار غیرمنتظره یا شرایطی خارج از سناریوی آزمودهشده روبهرو میشود. در آن لحظه، اصرار بر اینکه «نباید شکست میخورد» مأموریت را نجات نمیدهد؛ مسیر خروج از شکست است که اهمیت دارد.
پس از بازگشت نیز شواهد نباید از بین بروند. snapshot شکستخورده، لاگ تغییر و تفاوت آن با وضعیت سالم باید برای تحلیل ریشهای حفظ شوند. سامانهٔ تابآور شکست را محدود، ثبت و قابل تحلیل میکند؛ سامانهٔ شکننده اجازه میدهد شکست به بینظمی عملیاتی تبدیل شود.
ثباتی که فقط با «دست نزدن» حفظ میشود، امنیت نیست. سامانهٔ قابل اعتماد باید بتواند تغییر کند، وضعیت خود را اثبات کند و اگر تغییر نامعتبر بود، بدون قهرمانسازی انسانی به آخرین وضعیت معتبر برگردد. این منطق در معماری کانتینری نیز ادامه پیدا میکند؛ جایی که وضعیت سالم بهجای نگهداری یک نمونه، باید قابل بازتولید باشد.