پاسخی که هیچ دکمهای را فشار نمیداد
مدیرعامل هنوز خودکار را برنداشته بود. پرسش آخر جلسه روی برگهٔ منشور مانده بود: «پاسخ دستیار، کجا مبنای اقدام قرار میگیرد؟»
مدیر فناوری گفت: «در این نسخه به سامانهٔ خرید وصل نیست. هیچ درخواستی رو ثبت یا تأیید نمیکنه. فقط جواب میده.»
مدیر عملیات یکی از پاسخهای نمونه را روی نمایشگر آورد: «با توجه به مبلغ خرید، ثبت این درخواست در اختیار واحد شما نیست.»
پرسید: «اگر کارمند این رو بخونه و درخواستش رو اصلاً ثبت نکنه چی؟»
مدیر فناوری گفت: «باید منبع رو هم ببینه.»
مدیر مالی گفت: «اگر منبع، نسخهٔ قبلی مقررات باشه، ممکنه همون رو معتبر بدونه و کار متوقف بشه.»
مدیر منابع انسانی پرسید: «و ما از کجا میفهمیم چند نفر به خاطر جواب اشتباه، از پیگیری کارشون منصرف شدن؟»
هیچ دکمهای برای رد درخواست وجود نداشت. هیچ فرمانی هم از سامانه صادر نشده بود. با این حال، همه میتوانستند نتیجه را تصور کنند: پاسخی روی صفحه، و کاری که دیگر انجام نمیشود.
مدیرعامل گفت: «پس از اینکه فقط جواب میده، نمیتونیم نتیجه بگیریم اثرش محدوده. ببینیم همین جواب با تصمیم آدمها چه میکنه.»
در درس ششم دیدیم پایلوت باید دربارهٔ امکان فنی، ارزش و قابلیت بهرهبرداری شواهد فراهم کند. منشور پروژه نیز باید تصمیم مورد حمایت، هزینهٔ خطا و دامنهٔ استفاده را روشن کند.
پاسخ روی نمایشگر، هزینهٔ خطا را ملموستر میکند: دستیار هیچ درخواستی را رد نکرده، اما ممکن است کارمند را از ثبت آن منصرف کند. پاسخ و توصیه نیز وارد زنجیرهٔ تصمیم میشوند، حتی وقتی اتصال اجرایی وجود ندارد. برای ارزیابی پایلوت، باید ببینیم همین خروجی چه رفتاری ایجاد میکند و پیامد آن برای چه کسی است.
این درس، آغاز بخش سوم دوره و مبتنی بر اسلایدهای ۴۰ تا ۴۴ است: تفاوت کاربردها، منابع ریسک، ارزش متفاوت خطاها و چهار پرسش برای ارزیابی اثر. در درس بعد، اسلایدهای ۴۵ تا ۴۸ را دنبال میکنیم و این ارزیابی را به حدود اختیار و کنترلهای دستیار وصل خواهیم کرد.
یک مدل مشترک، کاربردهای همریسک نمیسازد
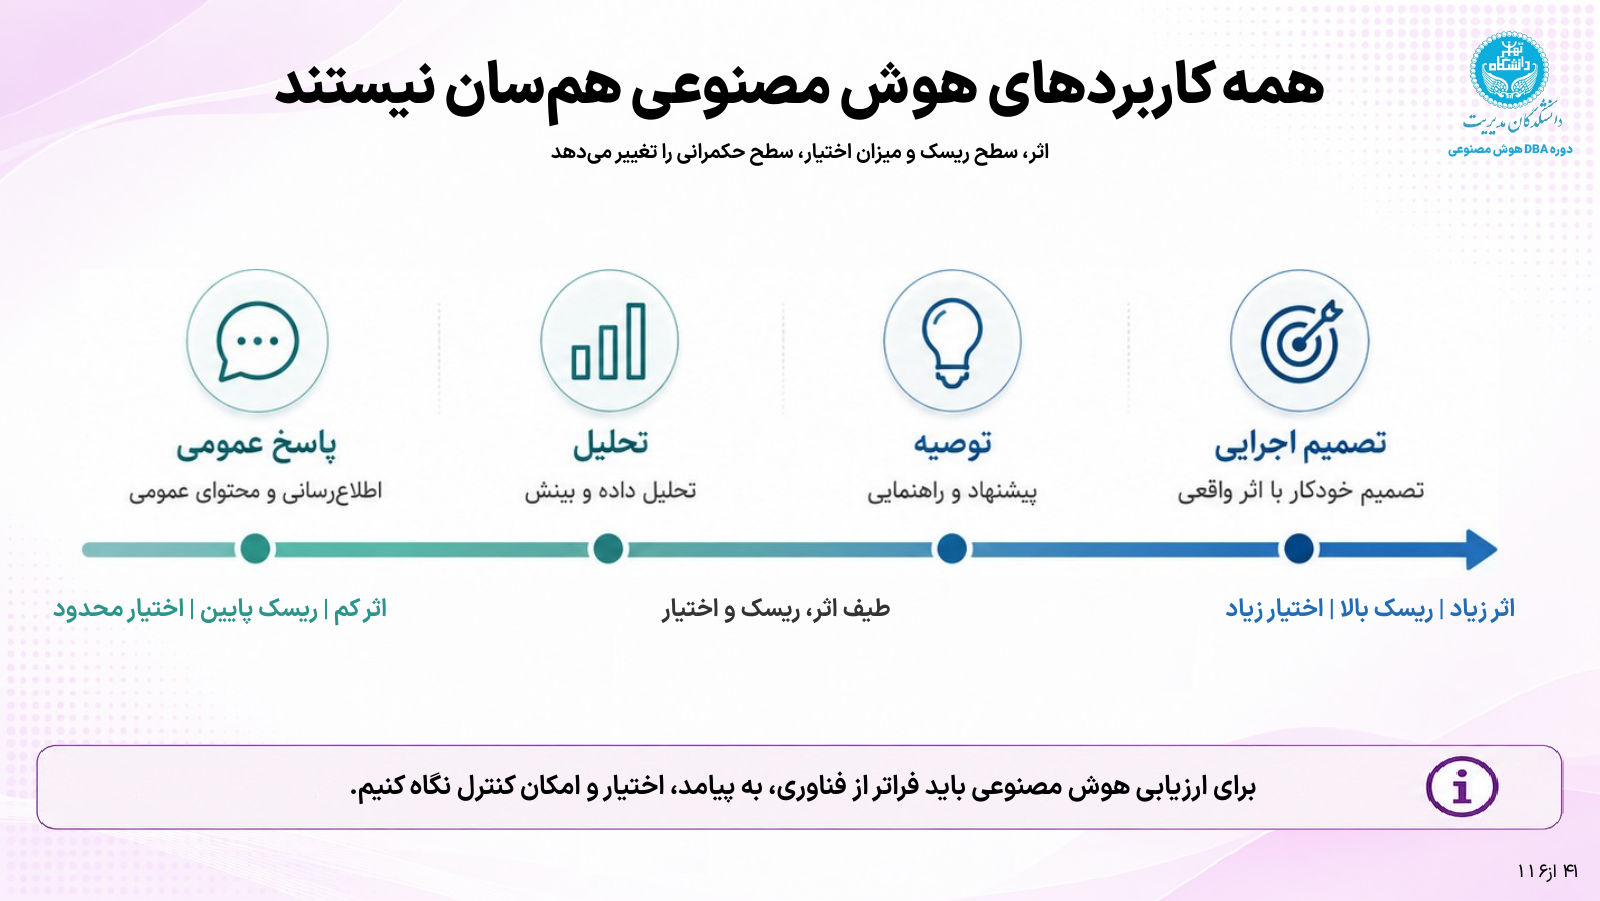
چهار نوع استفاده را میتوان در یک طیف دید: پاسخ عمومی، تحلیل، توصیه و تصمیم اجرایی. در هر قدم باید پرسید خروجی در چه کاری استفاده میشود و چگونه بر نتیجه اثر میگذارد.
ممکن است سامانهای فقط ساعت کار یک واحد را اعلام کند. سامانهای دیگر همان دادههای سازمان را تحلیل کند و الگوی تأخیر را نشان دهد. کاربرد بعدی میتواند پیشنهاد تغییر فرایند باشد؛ و در نهایت، سامانهای ممکن است خود دربارهٔ یک درخواست تصمیم بگیرد و آن را اجرا کند.
این تفاوتها با نام مدل روشن نمیشوند. حتی اگر همه از یک مدل استفاده کنند، نوع ارزیابی، شواهد لازم و نظارت مورد نیازشان میتواند متفاوت باشد.
این طیف، راهنمای توجه به اثر و اختیار است. جایدادن یک کاربرد زیر عنوان «پاسخ عمومی» بهتنهایی برای کمریسکدانستن آن کافی نیست. باید موضوع پاسخ، مخاطب و نحوهٔ اتکای او به خروجی را هم بشناسیم. یک متن اطلاعرسانی دربارهٔ ساعت کار، با پاسخی دربارهٔ شرایط دریافت یک مزیت یا حدود اختیار مالی، پیامد یکسانی ندارد.
از طرف دیگر، وجود تحلیل یا توصیه نیز بهخودیخود به معنای خطر زیاد در همهٔ موقعیتها نیست. باید مسیر استفاده را دنبال کنیم: چه کسی خروجی را میبیند؟ چه تصمیمی بر پایهٔ آن گرفته میشود؟ کدام کنترل پیش از اثرگذاری وجود دارد؟
مدیر فناوری کنار مشخصات نسخه نوشت: «بدون اتصال اجرایی».
مدیرعامل گفت: «این رو نگه داریم، مهمه. ولی یک سطر دیگه هم لازم داریم: کاربران با جوابش چه میکنن؟»
مدیر عملیات گفت: «بعضیها فقط سند رو پیدا میکنن. بعضیها هم از جواب، مجازبودن یا نبودن کارشون رو میفهمن.»
مدیر مالی گفت: «پس این دو نوع استفاده رو در ارزیابی از هم جدا کنیم.»
محدودبودن اختیار فنی، یکی از ویژگیهای سامانه بود. جلسه حالا داشت اثر واقعی استفاده از آن را هم ثبت میکرد.
ریسک را در فرد، سازمان و جامعه ببینیم
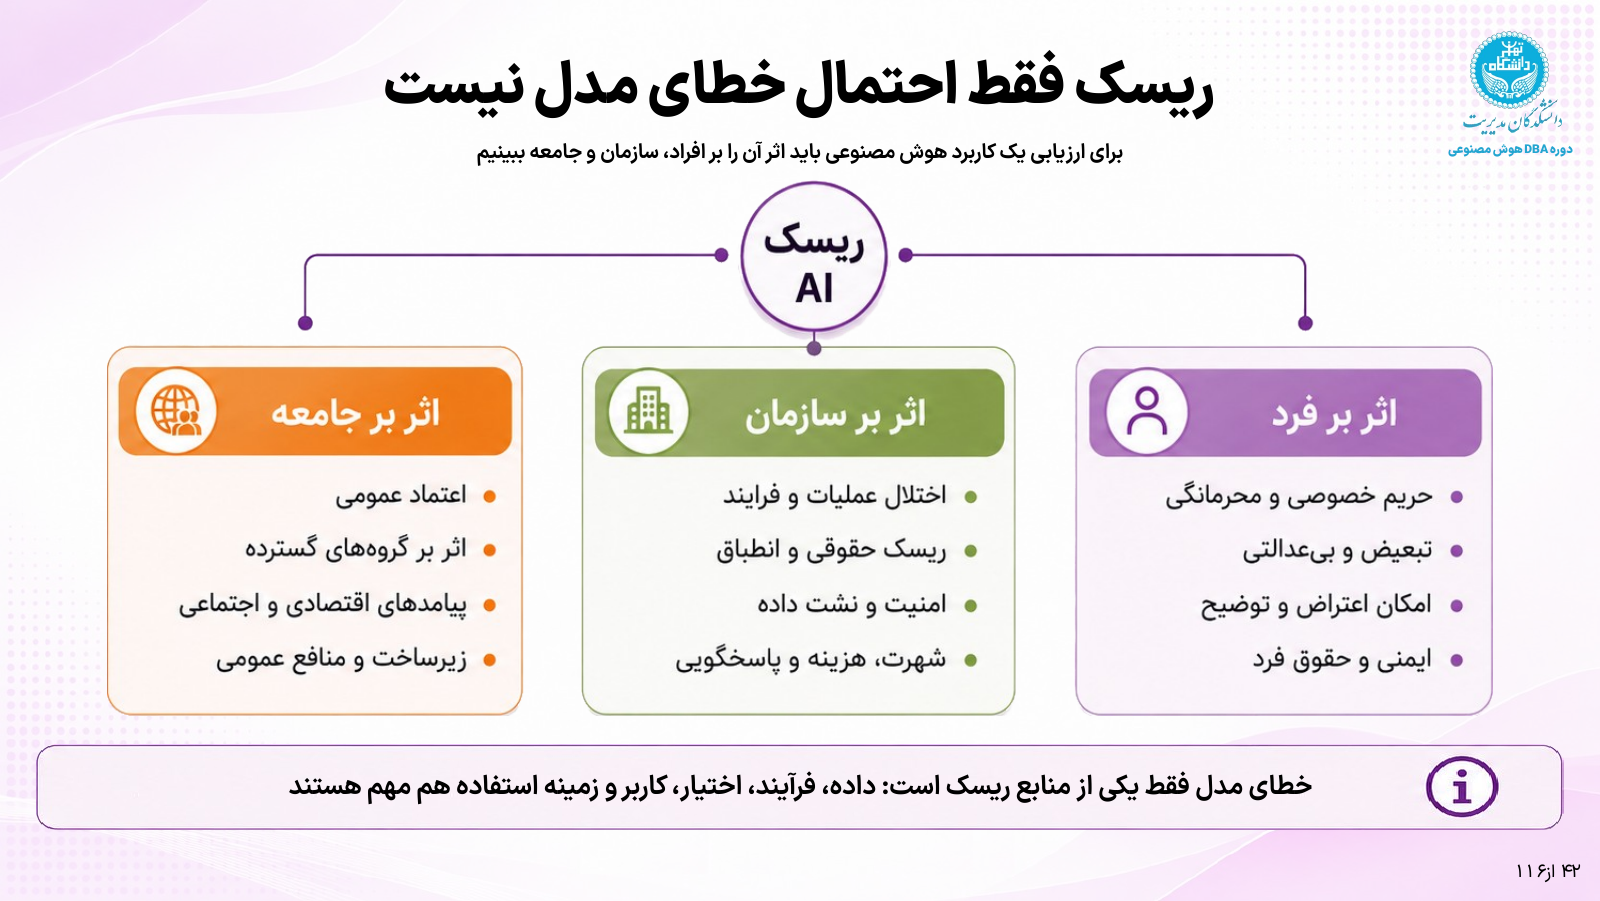
اگر بررسی ریسک را به احتمال پاسخ غلط محدود کنیم، بخشی از مسئله را نمیبینیم. پیامد استفاده را باید در سه سطح فرد، سازمان و جامعه بررسی کنیم.
در سطح فرد، حریم خصوصی و محرمانگی، تبعیض و بیعدالتی، امکان اعتراض و توضیح، و ایمنی و حقوق فرد مطرحاند. برای مثال، دستیار ممکن است پاسخ درستی را به فردی نشان دهد که مجاز به دیدن اطلاعات آن نیست. در این وضعیت، درستبودن پاسخ مشکل را برطرف نمیکند؛ مسئله در دسترسی و محرمانگی است.
در سطح سازمان، اختلال در عملیات، ریسک حقوقی و انطباق، امنیت و نشت داده، و شهرت، هزینه و پاسخگویی اهمیت دارند. پاسخ دستیار ممکن است باعث دوبارهکاری شود، رسیدگی را متوقف کند یا اطلاعاتی را در مسیر نامناسب قرار دهد. برای شناخت این پیامدها باید فرایند و مسئولیتها را هم بررسی کنیم.
در سطح جامعه، اعتماد عمومی، اثر بر گروههای گسترده، پیامدهای اقتصادی و اجتماعی، و زیرساخت و منافع عمومی مطرح میشوند. دامنهٔ ارزیابی باید با کاربرد تناسب داشته باشد. یک دستیار محدود داخلی، با سامانهای که دربارهٔ دسترسی جمعیت بزرگی به خدمات اثر میگذارد، بررسی یکسانی نمیخواهد.
برای دنبالکردن این پرسش که چه کسی داده را تولید میکند، چه کسی از آن تصمیم میسازد و چه کسی پیامد را تحمل میکند، تحلیل بازیگران زیستبوم دادهها نقشها و منافع را در مقیاس گستردهتری کنار هم میگذارد.
این سه سطح جای یکدیگر را نمیگیرند. ممکن است رخدادی برای سازمان هزینهٔ مالی اندکی داشته باشد، اما برای فردی که اطلاعاتش افشا شده یا فرصت مهمی را از دست داده، پیامد سنگینی ایجاد کند. همچنین، رخداد کوچک اما تکرارشونده میتواند در مقیاس گسترده به مسئلهای متفاوت تبدیل شود.
داده، فرایند، اختیار، کاربر و زمینهٔ استفاده هم از منابع ریسکاند. افزایش کیفیت مدل، همهٔ این منابع ریسک را برطرف نمیکند.
مدیر فناوری گفت: «پاسخ نمونه از متن سند گرفته شده. از این نظر، چیزی رو از خودش نساخته.»
مسئول ریسک و انطباق پرسید: «ولی اون سند برای این کاربر و این درخواست معتبر بوده؟ کاربر مجاز بوده همهٔ اطلاعاتش رو ببینه؟»
مدیر مالی گفت: «و اگر جواب باعث توقف کار بشه، چه کسی باید موضوع رو بررسی کنه؟»
مدیرعامل کنار عبارت «کیفیت پاسخ» نوشت: «اعتبار منبع، دسترسی، استفاده و رسیدگی به پیامد».
گزارش فنی هنوز لازم بود؛ حالا پرسشهایی هم داشتند که پاسخشان در گزارش عملکرد مدل پیدا نمیشد.
کدام خطا پرهزینهتر است؟
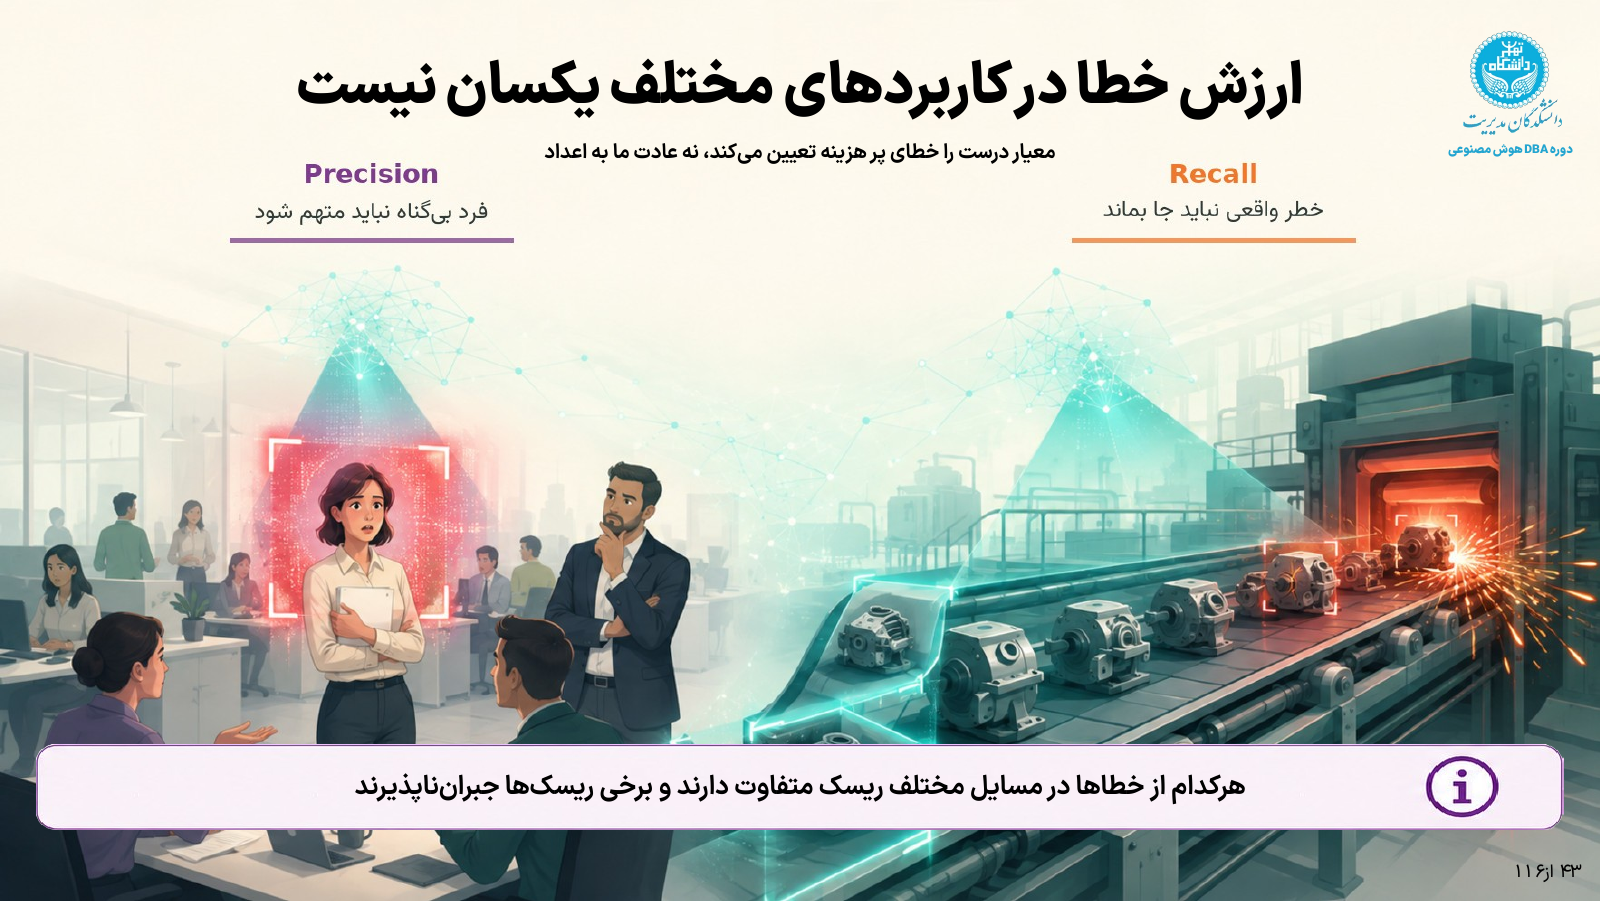
دو سامانه ممکن است درصد موفقیت مشابهی گزارش کنند، اما در خطاهایی که مرتکب میشوند و پیامد آن خطاها تفاوت زیادی داشته باشند. برای انتخاب معیار، باید ابتدا بدانیم کدام اشتباه برای این کاربرد اهمیت بیشتری دارد.
دو مثال را کنار هم بگذاریم: فرد بیگناه نباید متهم شود؛ خطر واقعی نباید از تشخیص جا بماند. در مثال نخست، هشدار بیمبنا میتواند به فرد آسیب بزند. در مثال دوم، کشفنکردن یک وضعیت خطرناک میتواند پیامد جدی داشته باشد.
برای فهم تفاوت Precision و Recall، یک مسئلهٔ طبقهبندی را در نظر بگیریم که خروجی آن «نیازمند بررسی» است:
- Precision میپرسد از مواردی که سامانه علامت زده، چه سهمی واقعاً به آن دسته تعلق داشتهاند؟
- Recall میپرسد از همهٔ موارد واقعی آن دسته، چه سهمی را پیدا کردهایم؟
در یک مثال فرضی، اگر سامانه ۲۰ مورد را علامت بزند و ۱۸ مورد واقعاً نیازمند بررسی باشند، Precision برابر ۹۰ درصد است. اگر در کل ۳۰ مورد واقعی وجود داشته باشد، همان سامانه فقط ۱۸ مورد از ۳۰ مورد را یافته و Recall آن ۶۰ درصد است. دوازده مورد جا ماندهاند. تعریف این دو معیار، با تعریف رسمی آنها در راهنمای ارزیابی طبقهبندی گوگل سازگار است.
این مثال نشان میدهد یک عدد خوب میتواند در کنار یک ضعف مهم قرار بگیرد. البته «نیازمند بررسی» به معنای اثبات تخلف نیست و نباید بیبررسی به حکم علیه فرد تبدیل شود.
در کاربرد صنعتی نیز باید هزینهٔ ندیدن خطر را در کنار هزینهٔ هشدار بیمورد دید. هشدارهای بیمورد میتوانند ظرفیت رسیدگی را مصرف کنند؛ از قلمافتادن خطر هم میتواند پیامد دیگری داشته باشد. انتخاب معیار و آستانهٔ قابل قبول، به همین زمینه وابسته است.
در دقت ۹۵ درصد برای کارخانه چه معنایی دارد؟ همین تفاوت را با یک مثال عددی دنبال کردهام: عیبِ ازدسترفته و هشدار کاذب را به هزینه و ظرفیت رسیدگی تبدیل میکنیم تا معنای عملی معیارها روشن شود.
برای دستیار متنی نیز باید خطاها را به زبان مسئله تعریف کنیم. پاسخ اشتباهی که کاربر را به اقدام غیرمجاز سوق میدهد، با پاسخی که بیدلیل او را از اقدام مجاز بازمیدارد، یک پیامد ندارد. این دو معیار را هم نمیتوان بدون تعریف روشن دستهها و ارزیابی، بهعنوان نمرهٔ کلی کیفیت تمام پاسخهای گفتوگویی به کار برد.
مدیر مالی گفت: «تا الان بیشتر نگران بودیم دستیار بگه اجازهٔ خرید دارید، در حالی که ندارید.»
مدیر عملیات به پاسخ روی نمایشگر اشاره کرد: «ولی این یکی برعکسه. ممکنه اجازه داشته باشی و جواب بگه نداری.»
مدیر منابع انسانی گفت: «اولی شاید با ثبت درخواست و کنترل بعدی پیدا بشه. دومی ممکنه اصلاً به درخواست تبدیل نشه که ببینیمش.»
مدیرعامل گفت: «پس در آزمایش، هر دو رو جدا بررسی کنیم. یک درصد کلی نمیگه کدوم اتفاق افتاده.»
چهار پرسش برای سنجیدن اثر
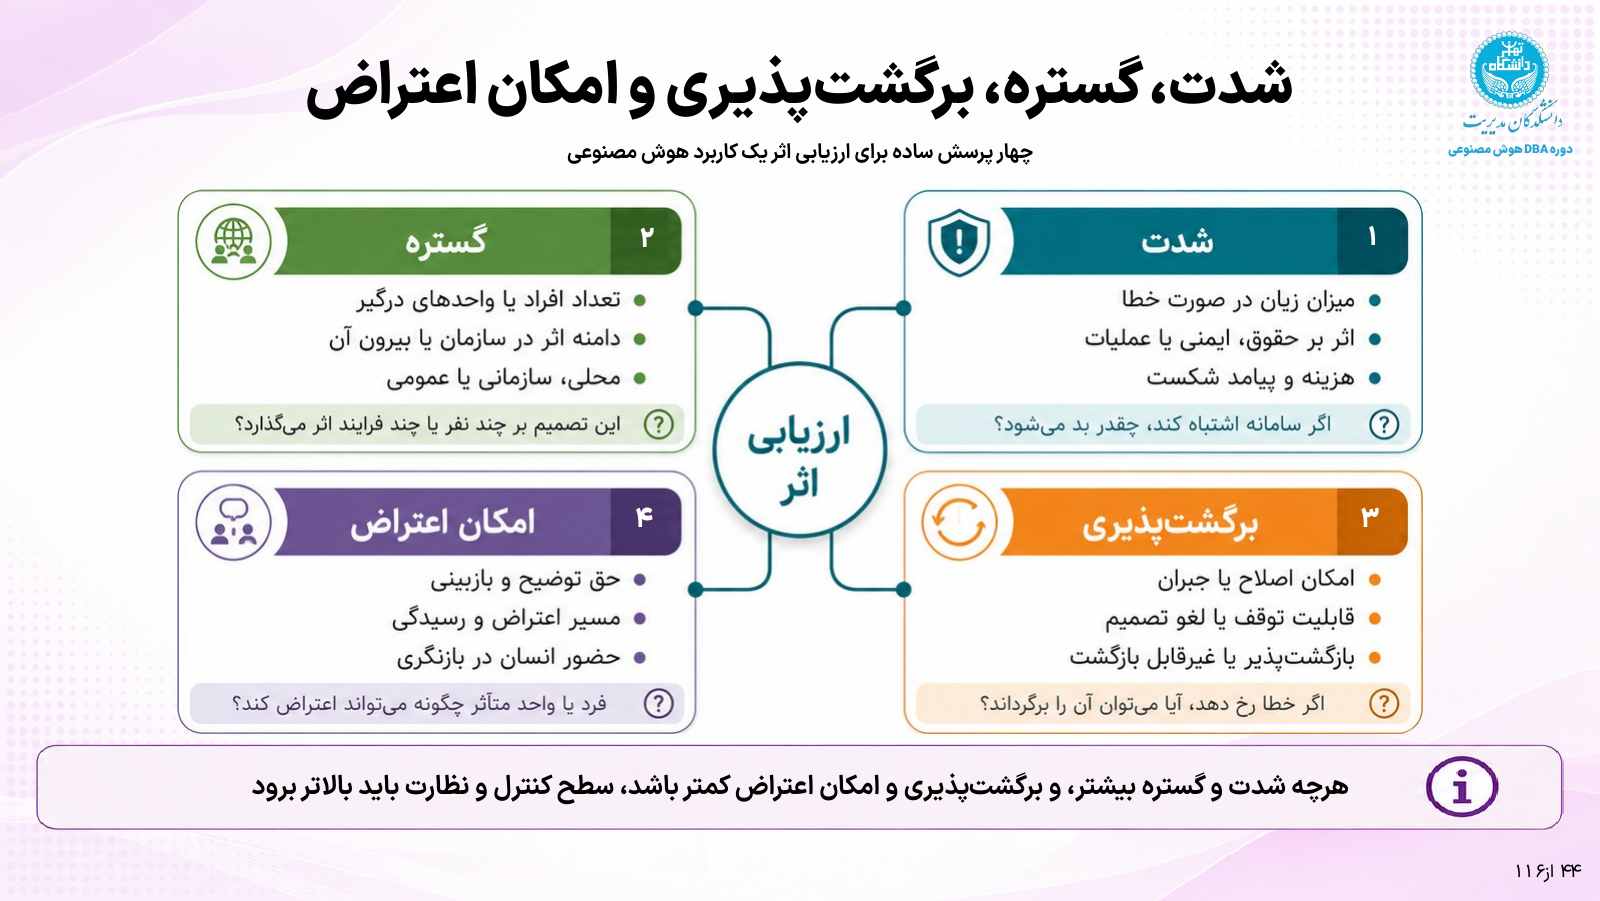
ارزیابی اثر را با چهار پرسش دنبال میکنیم. پاسخ آنها باید به کاربرد مشخص و پیامد واقعی مربوط باشد.
| محور | پرسش اصلی | مصداق در پروندهٔ دستیار |
|---|---|---|
| شدت | اگر سامانه اشتباه کند، زیان چقدر است؟ | پاسخ، چند دقیقه تأخیر ایجاد میکند یا باعث از دسترفتن یک فرصت، افشای اطلاعات یا اختلال مهم میشود؟ |
| گستره | اثر بر چند نفر، واحد یا فرایند وارد میشود؟ | پاسخ برای یک مورد استفاده شده یا میان چند واحد بازنشر و مبنای عمل قرار گرفته است؟ |
| برگشتپذیری | اگر خطا رخ دهد، آیا میتوان آن را اصلاح یا جبران کرد؟ | آیا اصلاح پاسخ هنوز بهموقع است؟ میتوان تصمیم را برگرداند یا مهلت و فرصت از دست رفته است؟ |
| امکان اعتراض | فرد یا واحد متأثر چگونه میتواند اعتراض کند؟ | آیا مسیر رسیدگی، مسئول بازبینی و امکان بررسی انسانی روشن است؟ |
شدت را باید از نگاه متأثران هم دید. کمبودن هزینه برای سازمان، لزوماً به معنای کمبودن خسارت برای فرد نیست. یک رخداد با دامنهٔ محدود نیز میتواند بهدلیل پیامد سنگین، به کنترل جدی نیاز داشته باشد.
گستره فقط شمار کاربران ثبتشده نیست. یک پاسخ ممکن است کپی شود، در گروه کاری بگردد یا به رویهای غیررسمی تبدیل شود. در این صورت، اثر آن از همان گفتوگوی اولیه فراتر میرود.
برگشتپذیری نیز با امکان ویرایش متن یکی نیست. میتوان پاسخ روی صفحه را اصلاح کرد، اما اگر کاربر پیشتر بر اساس آن عمل کرده باشد، باید امکان جبران پیامد را بررسی کرد. تغییر پاسخ، اطلاعات افشاشده را محرمانه نمیکند و همیشه فرصت ازدسترفته را برنمیگرداند.
امکان اعتراض با وجود یک دکمهٔ ثبت نظر کامل نمیشود. باید روشن باشد درخواست بازبینی به چه کسی میرسد، چگونه رسیدگی میشود و آیا پیش از تثبیت پیامد، امکان اصلاح وجود دارد. کسی که متأثر شده، نباید برای پیدا کردن مسئول رسیدگی میان واحدها سرگردان بماند.
این مسئولیتها نیز کلاهاند. ممکن است مسئول محتوای یک حوزه، بازبین پاسخ هم باشد یا چند نفر رسیدگی را با هم انجام دهند. آنچه اهمیت دارد، روشنبودن اختیار و مسئولیت و قابل پیگیریبودن رسیدگی است.
برای این درس لازم نیست چهار محور را بیدلیل به یک امتیاز نهایی تبدیل کنیم. ثبت روشن پاسخها و شواهد، میتواند نشان دهد کجا به بررسی و کنترل بیشتری نیاز داریم. یک پیامد شدید را نباید فقط با کمبودن تعداد افراد متأثر، کماهمیت نشان داد.
اصلاح جواب، پس از پایان مهلت
مدیرعامل پرسید: «اگر جوابِ منع ثبت درخواست اشتباه باشه و فردا اصلاحش کنیم، مسئله حل میشه؟»
مدیر عملیات گفت: «اگر هنوز فرصت ثبت باشه، شاید. اگر مهلت گذشته باشه، فقط متن رو درست کردیم.»
مسئول ریسک و انطباق پرسید: «کاربر از کجا میفهمه میتونه درخواست بازبینی بده؟»
مدیر فناوری گفت: «میتونیم کنار پاسخ، مسیر ارجاع رو نمایش بدیم.»
مدیر مالی گفت: «باید معلوم هم باشه چه کسی به اون ارجاع رسیدگی میکنه. وگرنه فقط یک صف تازه درست کردیم.»
مدیرعامل چهار واژه را پایین برگه نوشت: «شدت، گستره، برگشتپذیری، اعتراض».
بعد به پاسخ نمونه نگاه کرد: «این هنوز فقط متنه. اما اگر همین متن وارد گردش کار بشه و درخواست رو نگه داره، دیگه باید دربارهٔ اختیار سامانه هم تصمیم بگیریم.»
اکنون پرسش پایان درس قبل، دقیقتر شده است. میدانیم باید پیامد خروجی را دنبال کنیم و ببینیم خطا برای چه کسی، در چه مقیاسی و با چه امکان جبرانی هزینه ایجاد میکند.
در درس بعد، اسلایدهای ۴۵ تا ۴۸ را ادامه میدهیم: از پاسخ عمومی تا تصمیم اجرایی، طبقات ریسک، افزایش اختیار و ماتریس ریسک دستیار سازمانی. این بار باید روشن کنیم هر نوع استفاده، به چه سطحی از شواهد و نظارت نیاز دارد.
این درس، هفتمین درس مجموعهٔ «حکمرانی هوش مصنوعی در سازمان» و تشریح اسلایدهای ۴۰ تا ۴۴ دوره است. درس قبل: پایلوت هوش مصنوعی چه چیزی را باید اثبات کند؟؛ اسلایدهای کامل دوره
برای تعریف فنی Precision و Recall: راهنمای ارزیابی طبقهبندی، Google Machine Learning Crash Course.