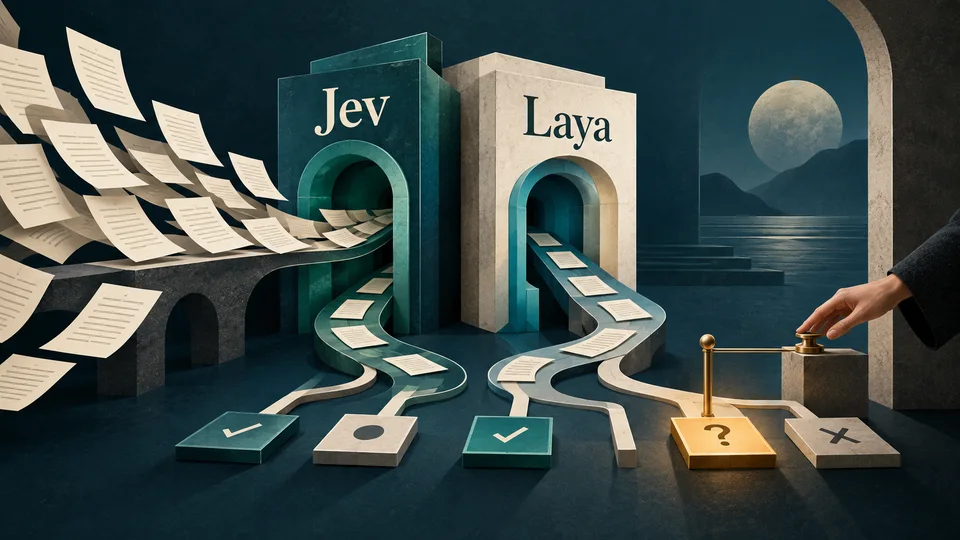
فرض کنید شهروندی درخواست بازبینی یک تصمیم اداری را ثبت کرده است. سامانه در کسری از ثانیه آن را «تکراری» تشخیص میدهد و از صف رسیدگی بیرون میگذارد. هیچ جمله جعلی، منبع ساختگی یا پاسخ نامفهومی تولید نشده است؛ خروجی فقط یک برچسب معتبر بوده. اما ممکن است حقی از دست رفته باشد. برای حکمرانی هوش مصنوعی، این خطا دستکم به اندازه پاسخ نادرست یک چتبات اهمیت دارد.
Jev و Laya را از همین زاویه هم باید بررسی کرد: محصولاتی که قضاوتهای محدود را مستقیماً وارد گردش کار نرمافزار میکنند و فاصله برداشت احتمالی ماشین تا اقدام سازمان را کوتاهتر میکنند. جذابیت فنی آنها روشن است، ولی برای سپردن اختیار به چنین مدلهایی باید بدانیم محدودشدن شکل پاسخ دقیقاً کدام خطاها را حذف میکند و کدام خطاها همچنان باقی میمانند.
دقیقاً درباره چه چیزی صحبت میکنیم؟
TypeSafe در معرفی Jev در ۱۵ سپتامبر ۲۰۲۶، آن را نخستین مدل عمومی خود در خانوادهای با نام System One خواند. شرکت میگوید معماری و روش آموزش را برای تصمیمهای کالیبرهشده بهینه کرده و روش آموزشی خود را RLCD نامیده است. اینها ادعاهای سازنده درباره محصولاند؛ صرف انتشارشان، برتری مدل را اثبات نمیکند.
رابط کار را میتوان با یک نامه توضیح داد. برنامه متن نامه را همراه با چند پرسش میفرستد: به کدام واحد مربوط است، چقدر فوریت دارد و آیا درخواست بازپرداخت در آن آمده است؟ طبق توضیح System One در مستندات، پاسخ میتواند انتخابی از میان گزینهها باشد (Choice)، امتیازی روی سطوح تعریفشده (Score) یا احتمال پاسخ مثبت به یک پرسش دوحالتی (Noul). برنامه این مقادیر را میگیرد و مسیر بعدی را تعیین میکند. نام System One هم از تعبیر تفکر سریع الهام گرفته است، بدون آنکه این نامگذاری بهخودیخود چیزی درباره شباهت شناختی مدل و انسان ثابت کند.
Laya از مسیر دیگری امکان استفاده از این ایده را فراهم میکند: کد و وزنهایش در دسترساند و کارت مدل منتشرشده در حساب Convai Innovations مجوز Apache-2.0 را ذکر میکند. همین کارت سه نسخه را از هم جدا میکند: مدل انگلیسی با ۴۲۱ میلیون پارامتر بر پایه ModernBERT-large، مدل چندزبانه با ۳۲۲ میلیون پارامتر بر پایه mmBERT-base و نسخه ویژه تصمیمهای ساختاریافته. این تفاوت، هنگام خواندن نتایج مهم میشود؛ نمیتوان نتیجه یک نسخه را به نام کل خانواده نوشت.
در مقایسه با LLM، منظور این نوشته مدلهای زبانی مولد رایج است. آنها میتوانند متن و پاسخ باز تولید کنند، درحالیکه این رابط تصمیم، پاسخ را در فضای تعریفشده نگه میدارد. البته خود TypeSafe هم در معرفی محصول میپذیرد که LLM میتواند مقادیر ساختاریافته تولید کند؛ بنابراین ادعای قابل بررسی، مزیتِ بهینهسازی برای این کار است، نه انحصار توانایی ارائه پاسخ ساختاریافته.
از این تفاوت نمیتوان جایگزینی کامل یکی با دیگری را نتیجه گرفت. در همان سامانه رسیدگی به نامه، تشخیص موضوع ممکن است کار مدل تصمیم باشد، تنظیم پیشنویس پاسخ کار مدل مولد و محاسبه مهلت یا کنترل مجوز هم کار کد معمولی؛ کیفیت سامانه به درست تقسیمکردن این وظایف بستگی دارد.
«توهم ندارد» چه چیزی را پنهان میکند؟
وقتی خروجی فقط یکی از چهار برچسب مجاز باشد، مدل از آن مسیر برچسب پنجمی تولید نمیکند. این محدودیت برای نرمافزار مفید است، اما انتخاب گزینه اشتباه همچنان ممکن است: پرونده فوری با قالبی کاملاً صحیح در دسته «عادی» قرار میگیرد. صحت قالب، صحت تصمیم را تضمین نمیکند.
برای دیدن فاصله این دو، کافی است فهرست محدودیتهای Jev 1.13 را بخوانیم. خود سازنده از ضعف در محاسبات دقیق و مقایسه تاریخها، برداشت تحتاللفظی و افت کیفیت با اطلاعات نامرتبط میگوید. از آن مهمتر، تصریح میکند که محتوای خصمانه میتواند پاسخ را تغییر دهد؛ از جمله دستور تزریقشده یا متنی که برای جهت دادن به طبقهبندی نوشته شده است. پس حتی مدلی که متن آزاد تولید نمیکند، ممکن است تحت تأثیر متن ورودی تصمیم نادرستی بگیرد.
در مثال پرونده اداری، این خطا شاید اصلاً روی داشبورد دیده نشود، چون پاسخ با قالب مورد انتظار سازگار بوده و اجرای برنامه هم متوقف نشده است. به همین دلیل باید نرخ پاسخ معتبر را از نرخ تصمیم درست جدا سنجید؛ موفقیت فراخوانی API نمیگوید پرونده به مسیر درستی رفته است.
عدد اطمینان، مجوز اقدام نیست
یک سوءبرداشت ظریفتر به عددی برمیگردد که همراه پاسخ میآید. در تعریف TypeSafe از confidence، این عدد خلاصهای از شکل توزیع احتمال در پاسخهای Choice و Score است، نه مقداری که بتوان بیبررسی آن را «احتمال درست بودن تصمیم» خواند. Noul نیز همین فیلد جداگانه را ندارد. پیش از آنکه بنویسیم «بالاتر از فلان عدد، خودکار عمل کن»، باید معلوم باشد چه چیزی را با آستانه مقایسه میکنیم.
کالیبراسیون هم درباره مجموعه پیشبینیهاست. اگر پاسخهای دارای احتمال حدود ۸۰ درصد، در نمونههای مشابه تقریباً به همان نسبت درست باشند، احتمال اعلامشده با فراوانی مشاهدهشده سازگار است؛ بااینحال هنوز نمیدانیم این پرونده مشخص جزو پاسخهای درست است یا غلط. پژوهش Guo و همکاران درباره کالیبراسیون شبکههای عصبی نیز دقت و کالیبراسیون را دو مسئله جدا بررسی میکند.
در گزارش خود مخزن Laya، نمونهای هست که اهمیت این تمایز را ملموس میکند: نسخه انگلیسی در یک ارزیابی زبان خِمِر، دقت صفر و اطمینان حدود ۰٫۹۵ داشته است. سازنده این مشاهده را دلیلی برای انتخاب نسخه مناسب زبان میداند. نتیجه را نباید به همه نسخهها و کاربردها تعمیم داد، اما همین مورد نشان میدهد عبور از آستانه اطمینان بهتنهایی محافظ کافی نیست. اگر بازبینی فقط به پاسخهای کماطمینان محدود شود، چنین خطاهایی از دید ناظر پنهان میمانند.
برای استفاده از Jev یا Laya در مسیریابی نامه، آستانه را باید با نمونههای همان کار آزمود و از تصمیمهای پراطمینان هم نمونهبرداری کرد. انتقال همان آستانه به کاری مثل کنارگذاشتن اعتراض شهروند، بدون ارزیابی هزینه خطا و امکان بازبینی، پشتوانهای در این اعداد ندارد.
اعداد جذاب را با پاورقی بخوانیم
فایل بنچمارک Laya قیدی دارد که خواندن جدولها بدون آن گمراهکننده است: Jev را مستقیماً اجرا نکرده و اعدادش را از گزارشهای دیگر گرفته است؛ نمونهها و پرسشها یکسان نیستند. بنابراین جدول مقایسه، آزمایش رودرروی دو مدل در شرایط یکسان نیست. در آزمون typed-decisions نیز دقت نسخه تنظیمشده ۷۶٫۶ درصد گزارش شده، درحالیکه نسخه پایه ۳۶٫۱ درصد و مبنای انتخاب کلاس اکثریت ۴۶٫۱ درصد بوده است. نتیجه نسخه تنظیمشده را نمیتوان به استفاده از نسخه پایه نسبت داد.
در همان گزارش، تأخیر ۳۲٫۸ میلیثانیه برای یک پرسش با نسخه چندزبانه روی T4 آمده است. جدول فارسی آزمون MASSIVE با ۲۰ گزینه هم دقت ۳۹ درصد برای نسخه چندزبانه و ۱۴ درصد برای نسخه انگلیسی نشان میدهد؛ ضمن اینکه گزارش هشدار میدهد برخی ستونهای کالیبراسیون پیش از اصلاح دما تولید شدهاند. همه این اعداد به آزمون گزارششده سازنده محدودند.
وجود نتیجه فارسی مفید است، چون چیزی قابل بررسی در اختیارمان میگذارد؛ بااینحال از آن نمیتوان کیفیت تشخیص اعتراض، نفی، کنایه یا اصطلاح اداری را نتیجه گرفت. برای همان مثال ابتدای نوشته باید نامههای واقعیِ مجاز را آزمود، از جمله متنهای ناقص و حاصل از OCR، و دید اشتباههای مدل دقیقاً چه پروندههایی را از مسیر رسیدگی خارج میکند.
در مورد Jev هم صفحه مشخصات مدل دو نکته مرتبط را کنار هم دارد: تعرفه Jev 1.13 در زمان بررسی ۰٫۰۴۲ دلار برای هر میلیون توکن ورودی است و توکن خروجی هزینه ندارد، اما انگلیسی زبان اصلی آموزش و بهترین حوزه زبانی عملکرد فعلی معرفی شده است. ارزانی فراخوانی بهتنهایی انتخاب برای یک خدمت فارسی را توجیه نمیکند. اگر صرفهجویی استنتاج با افزایش بازبینی و اصلاح تصمیمها مصرف شود، هزینه نهایی پایین نیامده است؛ مقایسه اقتصادی باید تا تعیین تکلیف درست پرونده ادامه پیدا کند. سنجش سرعت هم به همین ترتیب باید صف، شبکه و بار واقعی را در بر بگیرد، نه فقط زمان اجرای مدل را.
قدرت اصلی در تعریف گزینههاست
در رابط Choice، توسعهدهنده پیش از دریافت پاسخ تعیین میکند مدل از میان چه گزینههایی انتخاب کند. حالا به پرونده ابتدای نوشته برگردیم: چه کسی «تکراری» را تعریف کرده و چرا این برچسب باید پرونده را از صف بیرون ببرد؟ اگر «اطلاعات ناکافی» یا «نیازمند بررسی مجدد» در طراحی جایی نداشته باشد، یک پاسخ از نظر نرمافزار معتبر میتواند ابهام پرونده را پنهان کند.
در اینجا موضوع حکمرانی مستقیماً در همان رابط فنی حضور دارد. تغییر معیار از «اعتراض فاقد مدرک» به «اعتراض ناموجه» ممکن است هیچ تغییری در قالب خروجی ندهد، ولی معنای تصمیم را عوض کند؛ تعیین این معیار را نمیتوان صرفاً جزئی از تنظیم پرامپت شمرد و مسئولیتش را به برنامهنویس سپرد.
برای قابل بررسی ماندن چنین تصمیمی، ثبت نام مدل کافی نیست. باید معلوم باشد آن نسخه با چه گزینهها و دستورهایی اجرا شده، آستانه اقدام چه بوده و کدام قاعده نرمافزاری خروجی را به حذف پرونده تبدیل کرده است. این ثبت البته مجوز نگهداری بیحد داده شخصی نیست؛ منظور حفظ شواهد لازم برای بازسازی تصمیم است. بدون آن، حتی تغییر کوچک معیارها میتواند رفتار سامانه را عوض کند، بیآنکه مسئول رسیدگی بتواند علت را پیدا کند.
از تشخیص درخواست تا اختیار اجرا
پاسخ مثبت Jev یا Laya به «آیا کاربر درخواست بازپرداخت کرده است؟» فقط یک قضاوت درباره متن است. این پاسخ نه هویت کاربر را اثبات میکند، نه مالکیت حساب را و نه مجوز پرداخت را؛ بنابراین وصلکردن آن به ابزار اجرا، به کنترلهایی مستقل از اطمینان مدل نیاز دارد. در مثال پرونده نیز تشخیص «احتمال تکراری بودن» با اختیار کنارگذاشتن اعتراض یکسان نیست. سازمان باید صریحاً تعیین کند این خروجی صرفاً پیشنهاد بررسی است یا چه اثری بر روند رسیدگی دارد.
مسئله دیگری هم از شکل خروجی این مدلها ناشی میشود: برچسب و توزیع احتمال، شرح دلیل تصمیم نیستند. اگر پس از انتخاب برچسب، یک LLM مأمور شود توضیح قانعکنندهای بنویسد، روانبودن متن ثابت نمیکند که علت واقعی تصمیم را بیان کرده است. توضیح قابل بررسی باید به شواهد پرونده و قاعده اعمالشده متصل بماند؛ وگرنه فقط برای یک خروجی عددی، روایت ساختهایم.
در چنین وضعی، بازبینی انسانی وقتی فایده دارد که فرد بتواند ورودی و معیار را ببیند و تصمیم را تغییر دهد. ارجاع اعتراض به همان مدل با همان گزینهها نیز بهخودیخود بازبینی مستقل ایجاد نمیکند؛ ممکن است همان خطا را با همان اطمینان تکرار کند.
Jev و Laya امکان جالبی برای جداکردن قضاوتهای محدود از تولید متن عرضه میکنند، اما شواهدی که مرور کردیم از پایان LLMها یا حذف خطا خبر نمیدهند. پرسش تعیینکننده این است که یک انتخاب احتمالی در نرمافزار تا کجا اختیار پیدا میکند: پیشنهاد مسیر، تغییر اولویت یا بستن پرونده؟ ارزش این ابزارها را باید همراه با همین حدود اختیار سنجید. تصمیم ارزانتر، مسئولیت ارزانتری ایجاد نمیکند.