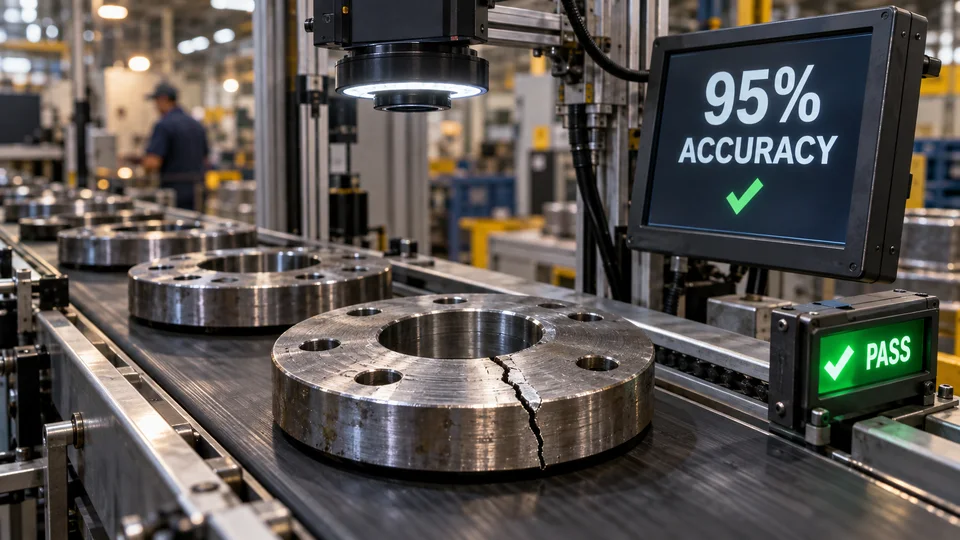
En una reunión, el proveedor dice: «Nuestro sistema de detección de defectos ha alcanzado una exactitud del 95 %». La cifra suena prometedora. El responsable de producción piensa en reducir los descartes, el de finanzas en recuperar la inversión y el de compras en una condición que pueda incluirse en el contrato.
Pero todavía no sabemos si el sistema será útil para la fábrica. Ni siquiera sabemos si encuentra los defectos.
Supongamos que en un turno se producen 10 000 piezas: 9500 buenas y 500 defectuosas. Un sistema que declarase «buenas» todas las piezas, sin mirar una sola imagen, acertaría en el 95 % de los casos. Sin embargo, no encontraría ninguna pieza defectuosa.
Antes de aceptar ese 95 %, tenemos que preguntar: ¿el 95 % de qué, sobre qué piezas, en qué condiciones y con qué consecuencias?
Todos los números de este artículo son hipotéticos y sirven para explicar el problema. No son resultados de una fábrica real ni límites de aceptación propuestos.
Dos sistemas con la misma cifra y resultados distintos
Evaluemos los dos sistemas con las mismas 10 000 piezas. El sistema A las declara buenas a todas. El sistema B detecta parte de los defectos, pero también genera algunas alarmas sobre piezas buenas.
| Resultado sobre 10 000 piezas | Sistema A | Sistema B |
|---|---|---|
| Piezas defectuosas detectadas correctamente | 0 | 400 |
| Piezas defectuosas aceptadas por error como buenas | 500 | 100 |
| Piezas buenas marcadas por error como defectuosas | 0 | 400 |
| Piezas buenas aceptadas correctamente | 9500 | 9100 |
| Total de clasificaciones correctas | 9500 | 9500 |
| Proporción total de aciertos, o Accuracy | 95 % | 95 % |
El sistema B ha encontrado 400 piezas defectuosas, pero también ha señalado 400 piezas buenas. El sistema A no ha dado ninguna alarma y ha dejado pasar todos los defectos. La misma cifra de la presentación comercial tiene dos significados muy diferentes en la línea.
Estos cuatro recuentos suelen presentarse como una matriz de confusión. Para empezar a evaluar, resultan más útiles que un porcentaje aislado. No hace falta ser especialista en aprendizaje automático para preguntar cuántas piezas defectuosas pasaron y cuántas piezas buenas se apartaron sin motivo.
Un defecto no detectado y una falsa alarma tienen consecuencias distintas
Recall, o tasa de detección de defectos, indica qué proporción de las piezas realmente defectuosas se ha encontrado. Para el sistema B son 400 de 500, es decir, el 80 %.
Precision, o proporción de alarmas correctas, indica cuántas de las piezas señaladas como defectuosas tenían realmente un defecto. El sistema B ha generado 800 alarmas y 400 eran correctas: su precisión es del 50 %. Este criterio es distinto de la exactitud global, o Accuracy.
La tasa de falsas alarmas tiene otro denominador: 400 piezas buenas de un total de 9500 piezas buenas, aproximadamente el 4,2 %. «La mitad de las alarmas son incorrectas» no significa «se ha rechazado por error la mitad de las piezas buenas». La guía de evaluación de clasificación de Google explica estos criterios y sus denominadores.
Para calidad, una pieza defectuosa que pasa la inspección puede acabar en una devolución, una reparación o un accidente. Para producción, una falsa alarma puede suponer una revisión adicional, desperdicio de material o una parada de la línea. Llamar a ambas situaciones «un error» no les da el mismo coste.
También importa el tipo de defecto. Un arañazo superficial y una grieta que compromete la seguridad del producto no deberían desaparecer dentro de una media. Un sistema que detecta bien defectos sencillos y frecuentes puede fallar ante uno poco habitual pero crítico. El informe debe mostrar por separado cada grupo importante. Si no hay suficientes ejemplos de un defecto, el resultado es «evidencia insuficiente».
Convertir el porcentaje en coste y capacidad de revisión
Para continuar el ejemplo, supongamos que el coste esperado de dejar pasar cada pieza defectuosa es de un millón de tomanes iraníes y que cada falsa alarma añade 20 000 tomanes. Contando solo esos dos conceptos, el sistema A cuesta 500 millones de tomanes. Para el sistema B, el cálculo es:
100 defectos no detectados × 1 000 000 de tomanes + 400 falsas alarmas × 20 000 tomanes = 108 millones de tomanes.
Los dos sistemas tenían una exactitud del 95 %, pero el coste de estos dos tipos de error era diferente. El cálculo todavía no justifica la compra. No hemos incluido equipos, mantenimiento, gestión de los defectos detectados correctamente ni cambios en el proceso. Además, el sistema A es solo un ejemplo que muestra la debilidad del criterio: la propuesta debe compararse con el método de inspección que ya utiliza la fábrica.
También hay que contar el trabajo. Si cada una de las 800 alarmas del sistema B necesita 30 segundos de revisión humana, las revisiones suman seis horas y cuarenta minutos de trabajo neto. Las alarmas correctas también pueden necesitar confirmación. El cálculo deja fuera el traslado de piezas, el registro de decisiones y la acumulación de alarmas durante los picos de producción.
«Una persona toma la decisión final» solo es una solución práctica si esa persona tiene tiempo, herramientas y autoridad para hacerlo. Añadir una etapa de revisión al diagrama del proceso no crea capacidad para revisar.
En los defectos que afectan a la seguridad, reducir el coste medio tampoco basta. Los límites aceptables y los controles deben responder a las consecuencias de ese defecto concreto. Ahorrar en cientos de errores menores no justifica ignorar un riesgo crítico.
Sobre qué datos se obtuvo la cifra
Una carpeta de imágenes claras de piezas buenas y defectuosas no representa necesariamente la línea de producción. El alcance de la prueba debe especificar productos, iluminación, velocidad de la cinta, materias primas, estado de la cámara y turnos. Un resultado obtenido con una familia de productos no se aplica automáticamente a todos los productos de la fábrica.
Primero hay que definir qué se cuenta. Diez imágenes de una pieza no son diez piezas independientes. Un modelo que funciona bien por imagen puede fallar al combinar las imágenes o al asignar la decisión a la pieza física correcta. El criterio final debe acercarse a la decisión que necesita el proceso, como aceptar o separar cada pieza.
Los datos de prueba también deben ser independientes. Si imágenes muy parecidas de una misma pieza aparecen tanto en el entrenamiento como en la prueba, el resultado puede ser demasiado optimista. Según la aplicación, puede ser necesario separar los datos por pieza, lote de producción o periodo. El conjunto de prueba final no debe utilizarse para ajustar el modelo ni elegir el umbral. La documentación de scikit-learn sobre fuga de datos explica este problema.
También debe conocerse la composición de los datos. Un conjunto preparado con la mitad de piezas defectuosas puede ayudar a evaluar distintos tipos de defecto. Sin embargo, su proporción de alarmas correctas y su carga de revisión humana no pueden trasladarse directamente a una línea donde solo el cinco por ciento de las piezas sean defectuosas.
Junto a cada porcentaje, pidamos el número de muestras correspondiente. Encontrar los cinco ejemplos disponibles de un defecto raro no ofrece el mismo respaldo que una prueba amplia y variada. Miles de piezas buenas no compensan la falta de ejemplos de ese defecto. El informe debe explicar la incertidumbre y las limitaciones de cobertura. No observar errores en la prueba no garantiza un funcionamiento sin errores.
Por último, ¿qué determina si una pieza es buena o defectuosa? ¿El criterio de un inspector, el acuerdo entre especialistas, una medición instrumental o una prueba específica? Si los expertos discrepan sobre casos dudosos, el procedimiento para resolverlos debe acordarse antes de evaluar. Añadir decimales no hace más fiable un porcentaje calculado con etiquetas inciertas.
El umbral de decisión importa
Muchos modelos producen una puntuación y el sistema utiliza un umbral para decidir si una pieza es sospechosa. Con un modelo y unos datos fijos, bajar el umbral puede detectar más defectos y generar más falsas alarmas a la vez. Por eso, el informe de resultados debe registrar el umbral utilizado.
En nuestro ejemplo, quizá se puedan dejar pasar menos defectos a cambio de enviar más piezas al operador. El equilibrio adecuado depende de las consecuencias del error y de la capacidad de la fábrica. No debería ajustarse repetidamente el umbral después de conocer los resultados de la prueba final solo para alcanzar el porcentaje exigido en el contrato.
La versión del modelo, el umbral y el alcance permitido deben estar claros. Cambiar cualquiera de ellos puede exigir otra evaluación. Que la exactitud global se mantenga no demuestra que la distribución de los errores también sea la misma.
Una decisión correcta del modelo puede fallar en la línea
Supongamos que el modelo detecta correctamente un defecto, pero la respuesta llega después de que la pieza haya pasado el mecanismo de separación. O que el identificador de la imagen se asocia a la pieza contigua. En ambos casos, el modelo puede funcionar bien en una prueba de imágenes y dar un mal resultado en la línea.
La prueba de aceptación debe cubrir el recorrido completo: captura de imágenes, procesamiento, transmisión de la decisión, actuador de separación y registro del resultado. También deben aparecer en el informe la latencia en los picos de carga, las piezas sin imagen y las decisiones tardías. Excluirlas del denominador de evaluación oculta parte de los fallos operativos.
La respuesta ante un fallo de la cámara, la red o el procesamiento también debe definirse de antemano. Seguir produciendo, separar temporalmente las piezas, utilizar otra inspección o detener la línea son decisiones que dependen del riesgo y del proceso. Parar automáticamente no siempre es apropiado; dejar pasar piezas sin advertirlo tampoco es una decisión neutral.
El despliegue puede empezar en modo sombra: el sistema hace predicciones, pero no controla la línea. Cuando hay evidencia suficiente, puede pasar a ayudar en las decisiones y después a una automatización limitada. En cada etapa hay que medir tanto el rendimiento del modelo como el resultado del proceso completo. Añadir un operador o un actuador cambia ese resultado y requiere su propia evaluación.
Qué pedir en lugar de una exactitud mínima del 95 %
Los criterios de aceptación deben acordarse antes de la prueba final. En vez de depender de un único porcentaje, convirtamos estas preguntas en la especificación técnica:
| Área | Qué debe quedar claro |
|---|---|
| Objetivo y referencia inicial | ¿Qué problema debe mejorar y qué rendimiento y coste tiene el método actual? |
| Alcance | ¿Qué productos, defectos, líneas, velocidades y condiciones ambientales se cubren? |
| Datos y referencia | ¿Qué independencia tiene la prueba, cuántos ejemplos de cada defecto incluye y cómo se verifican las etiquetas? |
| Errores | ¿Qué límites de defectos no detectados y falsas alarmas se aplican a cada grupo importante? |
| Decisión | ¿Qué versión del modelo y qué umbral se prueban y qué aprobación hace falta para cambiarlos? |
| Operaciones | ¿Qué latencia se acepta, qué capacidad de revisión humana hay y qué ocurre ante un fallo? |
| Aceptación y continuidad | ¿Qué evidencia permite desplegar y qué deterioro exige investigar, restringir el uso o volver a la configuración anterior? |
Un artículo general no puede proporcionar los límites numéricos de estas condiciones. Calidad, producción, seguridad y el equipo técnico deben fijarlos según los riesgos, los datos y la capacidad operativa de esa fábrica. La aceptación debe depender de cumplir las condiciones a la vez: mejorar un indicador no debería ocultar el incumplimiento de otro esencial.
La evaluación continúa después de la entrega. Cambiar el proveedor de materiales, la iluminación o el producto puede introducir condiciones que no estaban en la prueba inicial. La sección Measure del Playbook del Marco de Gestión de Riesgos de IA de NIST también destaca la evaluación en el contexto de uso y el seguimiento después del despliegue. Para una fábrica, eso significa asignar responsabilidades, fijar límites de alarma y definir acciones. Un panel de control por sí solo no basta.
Durante el seguimiento, no revisemos únicamente las piezas que generaron alarmas. Para estimar los defectos no detectados, también hay que muestrear piezas aceptadas conforme a un plan de inspección adecuado. De lo contrario, el sistema podría parecer más tranquilo simplemente porque está dejando pasar más defectos.
La próxima vez que un proveedor diga «el sistema tiene una exactitud del 95 %», pidámosle que traduzca esa cifra al lenguaje de la línea: cuántos defectos pasan por turno, cuántas piezas buenas se señalan, cuántas horas de trabajo se añaden al operador y en qué condiciones son válidas esas estimaciones.
Con respuestas claras, el porcentaje ayuda a decidir. Sin ellas, todavía no sabemos qué va a recibir la fábrica.