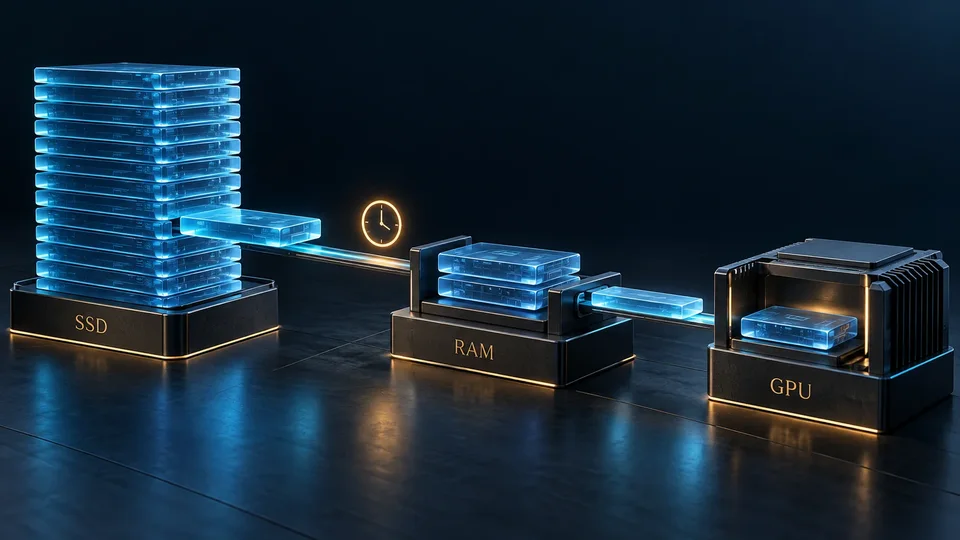
اجرای یک مدل ۷۰ میلیاردپارامتری روی کارت گرافیکی با چند گیگابایت حافظه، در نگاه اول شبیه حذف یک هزینهٔ بزرگ است. اگر چنین مدلی روی یک کارت کوچک اجرا میشود، چرا باید برای GPU پرحافظه، چند کارت یا سرور گرانتر هزینه کرد؟ AirLLM این پرسش را جدی میکند، اما پاسخ به آن در تفاوت میان «امکان اجرای مدل» و «زمان لازم برای انجام کار» قرار دارد. حافظهٔ مورد نیاز مدل ناپدید نمیشود؛ بخش بزرگی از آن بیرون از GPU نگه داشته میشود و هنگام اجرا به پردازنده میرسد.
این جابهجایی برای پژوهشگر، تیمی با سختافزار موجود یا پردازشی که میتواند منتظر بماند، ارزشمند است. برای یک دستیار سازمانی با کاربران همزمان و انتظار پاسخ سریع، ممکن است هزینهٔ زمان و ظرفیت ازدسترفته از صرفهجویی خرید کارت بیشتر شود. بنابراین AirLLM را باید در کنار مدل کوچکتر، کوانتیزهسازی، اجرای ترکیبی CPU و GPU و تقسیم مدل میان چند کارت مقایسه کرد. جایگاه این گزینهها در راهنمای انتخاب مدل زبانی آمده است؛ این یادداشت توضیح میدهد اجرای لایهبهلایه چه چیزی را ممکن میکند و در مقابل چه منابعی میخواهد.
مدل بزرگ چگونه وارد حافظهٔ کوچک میشود؟
در اجرای متداول، وزنهای مدل در حافظهٔ GPU باقی میمانند و بارها برای پردازش ورودی و تولید خروجی استفاده میشوند. در اجرای لایهبهلایه، لازم نیست همهٔ وزنها همزمان در VRAM باشند: وزنهای بخش مورد نیاز وارد GPU میشوند، محاسبه انجام میشود و فضای آن بخش برای بخش بعدی آزاد میشود. خروجی محاسبات بین لایهها منتقل میشود تا مدل همان مسیر پردازش را طی کند. اصل این روش، که نمونهٔ آن در ZeRO-Inference نیز توضیح داده شده است، استفاده از ظرفیت RAM و ذخیرهسازی برای کاهش نیاز به حافظهٔ گرانتر GPU است.
AirLLM این ایده را در قالب یک کتابخانه پیاده میکند. در مسیر عمومی نسخهٔ بررسیشده، بارگذاری و آزادسازی وزن پیرامون اجرای هر ماژول انجام میشود و منطق تولید متن به Transformers واگذار شده است. بعضی بخشها، مانند embedding مشترک ورودی و خروجی در معماریهای مشخص، ممکن است مقیم بمانند. پس روی GPU، علاوه بر بخش فعال مدل، دادههای لازم دیگری هم حضور دارند. این رفتار در کد اجرای AirLLM قابل پیگیری است.
ادعای شناختهشدهٔ پروژه دربارهٔ اجرای مدل ۷۰ میلیاردی با حدود ۴ گیگابایت VRAM، نمونهای از کاهش حافظهٔ همزمان است؛ این عدد را نباید مشخصات کامل یک سرویس دانست. طول ورودی و خروجی، نوع cache، معماری مدل و قالب وزن میتوانند مصرف حافظه را تغییر دهند. صفحهٔ پروژهٔ AirLLM نقطهٔ شروع مناسبی برای مدلها و مثالهای پشتیبانیشده است، اما انتخاب زیرساخت به اطلاعات بیشتری از عدد VRAM نیاز دارد.
حافظه حذف نمیشود؛ محل نگهداری آن تغییر میکند
یک مدل فرضی با دقیقاً ۷۰ میلیارد وزن شانزدهبیتی، فقط برای وزنها حدود ۱۴۰ GB، معادل ۱۳۰٫۴ GiB، فضا میخواهد. این محاسبه سربار قالب فایل، بافرها و دادههای اجرای مدل را شامل نمیشود. اگر قرار باشد همهٔ این وزنها در RAM آماده بمانند، همین مقدار حافظهٔ میزبان لازم است و سیستمعامل و برنامه نیز سهم جداگانه دارند؛ در این مثال حتی ۱۲۸ GiB RAM برای نگهداشتن کامل وزنها کافی نیست. اجرای دیسکی میتواند با RAM کمتر پیش برود، ولی آنوقت خواندن مکرر ذخیرهسازی به بخشی از مسیر پردازش تبدیل میشود.
فضای SSD نیز فقط حجم دانلود مدل نیست. ممکن است نسخهٔ اصلی و فایلهای آمادهشدهٔ لایهها همزمان نگهداری شوند و در حالت ایجاد یک نسخهٔ کامل دیگر، مجموع حجم به حدود دو برابر وزنها برسد. این نسبت همیشگی نیست: قالب فایل، فشردهسازی و امکان استفادهٔ مجدد از فایلها بر آن اثر دارند. کد AirLLM برای بعضی فایلهای مناسب از پیوند یا کپی استفاده میکند و گزینهای برای حذف فایلهای اصلی پس از تبدیل دارد؛ در برنامهریزی فضا باید خودِ فرایند آمادهسازی هم حساب شود. جزئیات در کد تقسیم و ذخیرهٔ وزنها آمده است.
روی GPU نیز باید برای بزرگترین بخش فعال، دادههای میانی، حافظهٔ KV و فضای کاری محاسبات جا وجود داشته باشد. از طرف دیگر، سرعت SSD، پهنای باند RAM و اتصال PCIe میتوانند به اندازهٔ توان محاسباتی کارت در نتیجه مؤثر شوند. اگر کارت بیشتر وقتش را منتظر رسیدن وزنها بماند، خرید GPU سریعتر الزاماً مشکل را حل نمیکند. همین وابستگی است که انتخاب اجزای پلتفرم سرور GPU و مسیرهای PCIe را در اجرای لایهبهلایه پررنگتر میکند.
همهٔ روشهای «اجرای مدل بزرگتر از VRAM» یکسان نیستند
واژهٔ offload برای چند رفتار متفاوت به کار میرود. گاهی وزنها بیرون از GPU نگهداری میشوند ولی محاسبهٔ لایه پس از انتقال روی GPU انجام میشود؛ گاهی بخشی از محاسبات واقعاً روی CPU اجرا میشود. این تفاوت تعیین میکند محدودیت اصلی، سرعت پردازندهٔ مرکزی باشد یا جابهجایی داده. جدول زیر مسیرهای متداول را از همین زاویه کنار هم میگذارد؛ هر موتور ممکن است ترکیبی از آنها را فراهم کند.
| روش | وزنها و محاسبه چگونه توزیع میشوند؟ | هزینهای که باید مقایسه شود |
|---|---|---|
| مدل مقیم روی یک GPU | وزنها در VRAM میمانند و همانجا مصرف میشوند | ظرفیت VRAM، پهنای باند حافظه و فضای باقیمانده برای درخواستها |
| اجرای لایهبهلایه با AirLLM | بخشهای مدل هنگام نیاز از میزبان یا ذخیرهسازی به GPU میرسند | انتقال تکراری وزن، بارگذاری و در صورت فعال بودن، بازکردن وزن فشرده |
| CPU/Disk offload با Accelerate | وزنهای offloadشده هنگام اجرای ماژول روی دستگاه اجرا قرار میگیرند | سیاست جایگذاری، رفتوآمد وزن و حافظهٔ میزبان |
| اجرای ترکیبی در llama.cpp | بخشی از مدل میتواند روی CPU و بخش دیگری روی GPU اجرا شود | محاسبه و پهنای باند RAM برای بخش CPU، همراه با ارتباط بین دو بخش |
| تقسیم مدل میان چند GPU | وزنها میان کارتها توزیع میشوند و در حالت مقیم از دیسک بازخوانی نمیشوند | مجموع حافظه، ارتباط بین کارتها و روش موازیسازی |
مبنای تفاوتها، مستندات offload در Accelerate، قابلیت اجرای ترکیبی در llama.cpp و راهنمای موازیسازی vLLM است. این مقایسه رتبهبندی سرعت نیست: برای مدلی که اندکی از VRAM بزرگتر است، نگهداشتن بخش عمدهٔ آن روی کارت میتواند بررسی ارزشمندی باشد؛ برای مدلی بسیار بزرگتر، شکل مسئله عوض میشود و مقدار دادهٔ خارج از GPU اهمیت بیشتری پیدا میکند.
هزینهٔ اصلی: وزنها چند بار باید جابهجا شوند؟
در تولید معمول و خودرگرسیو متن، هر گام decode برای هر دنباله یک توکن جدید تولید میکند. در یک مدل متراکم که وزنهای لایههای آن پس از اجرا آزاد میشوند، گام بعدی دوباره به همان لایهها نیاز دارد. حافظهٔ KV برخی محاسبات مربوط به توکنهای قبلی را حفظ میکند، اما جایگزین وزنهای شبکه نیست. در نتیجه، برای یک پاسخ طولانی ممکن است بخش بزرگی از وزنها بارها از مسیر انتقال عبور کند؛ تفاوت این روش با بارگذاری یکبارهٔ مدل همینجاست.
برای دیدن بزرگی این هزینه، همان مدل فرضی با ۱۴۰ GB وزن شانزدهبیتی را در نظر بگیریم. فرض کنیم در هر گام تولید یک توکن، تمام این وزنها از میزبان به GPU منتقل شوند و پهنای باند مؤثر این مسیر ۲۰ GB/s باشد. در دو حالت اول جدول، وزنها در cache حافظهٔ میزبان جا نمیمانند و هر بار از SSD خوانده میشوند؛ در حالت سوم، همهٔ وزنها در RAM آمادهاند. اعداد، محاسبهٔ انتقال با فرضهای صریحاند؛ سرعتهای ۳٫۵، ۷ و ۲۰ GB/s ورودی مثال هستند و به مدل خاص SSD، کارت خاص یا بنچمارک AirLLM نسبت داده نمیشوند.
| وضعیت نگهداری وزنها | زمان صرف خواندن وزن از SSD در هر گام | زمان صرف انتقال میزبان به GPU در هر گام | کف خوشبینانهٔ زمان گام با همپوشانی کامل |
|---|---|---|---|
| بازخوانی کامل از SSD با ۳٫۵ GB/s | ۴۰ ثانیه | ۷ ثانیه | دستکم ۴۰ ثانیه |
| بازخوانی کامل از SSD با ۷ GB/s | ۲۰ ثانیه | ۷ ثانیه | دستکم ۲۰ ثانیه |
| وزنهای آماده در RAM؛ بدون بازخوانی فیزیکی SSD | صفر برای خواندن فیزیکی وزن از SSD | ۷ ثانیه | دستکم ۷ ثانیه |
محاسبه از تقسیم حجم داده بر پهنای باند به دست میآید. اگر خواندن، انتقال و محاسبه بتوانند همپوشانی داشته باشند، زمان کل نمیتواند از زمان کندترین بخش کمتر شود؛ به همین دلیل ستون آخر جمع سادهٔ دو ستون قبلی نیست. در مقابل، نبود همپوشانی کامل، شروع و پایان مسیر، پردازش لایهها و انتقال cache زمان بیشتری اضافه میکنند. این جدول برای مدل متراکم، وزن غیرفشرده و یک دنباله نوشته شده است؛ وزنهای مقیم، batch، قالب فشرده یا انتقال انتخابی expertها، مقدار دادهٔ هر گام را تغییر میدهند.
این مثال به یک قاعدهٔ مفید برای طراحی میرسد: اگر هدف فرضی، فاصلهٔ حداکثر ۰٫۲ ثانیه بین توکنها باشد، مسیر ۲۰ GB/s حتی با حذف همهٔ هزینههای دیگر، بیش از ۴ GB داده در آن فاصله منتقل نمیکند. برای وزنهای بسیار حجیم باید مقدار انتقال را کم کرد، استفادهٔ مجدد از وزنها را افزایش داد یا انتظار از تأخیر را تغییر داد. صرف بالاتر بودن توان محاسباتی GPU راهی برای عبور از این محدودیت نیست؛ زمان آغاز پاسخ و فاصلهٔ تولید توکنها باید هزینهٔ همین انتقالها را هم در بر بگیرند.
چرا ورودی بلند، خروجی بلند و چند کاربر نتایج متفاوتی دارند؟
در مرحلهٔ prefill، توکنهای ورودی میتوانند در هر عبور از لایه با هم پردازش شوند؛ در decode معمول، تولید خروجی به گامهای پیاپی وابسته است. بنابراین هزینهٔ انتقال وزن در پردازش دستهای یا ورودی حجیم، امکان سرشکنشدن روی کار محاسباتی بیشتری دارد. همین ایده در طراحی سیستمهای offload با هدف توان عملیاتی بالا استفاده میشود، ولی به معنی بیاهمیت شدن حافظهٔ ورودی یا مناسب بودن هر موتور برای هر اندازهٔ batch نیست.
پژوهش FlexGen نمونهٔ روشنی از تفاوت توان عملیاتی و تجربهٔ یک کاربر ارائه میکند: در آزمایش OPT-175B با فشردهسازی چهاربیتی روی T4 با ۱۶ گیگابایت VRAM، همراه با ۲۰۸ گیگابایت RAM و SSD با ظرفیت ۱٫۵ ترابایت، برای ورودی ۵۱۲توکنی و خروجی ۳۲توکنی، نرخ تجمیعی ۱٫۱۲۲ توکن در ثانیه با batch مؤثر ۱۴۴ و زمان اجرای ۴٬۰۷۲ ثانیه گزارش شده است. در همین آزمایش، فشردهسازی نیاز به خواندن وزن از دیسک را برطرف کرده بود؛ وجود SSD در مشخصات میزبان به معنی استفاده از آن در این اجرای خاص نیست. این نتیجه به معنای یک توکن در ثانیه برای تکتک کاربران نیست. ارزش آن نشان دادن امکان پردازش با منابع محدود و پذیرش تأخیر زیاد است؛ نتیجهٔ همان آزمایش را نیز نمیتوان به سرعت AirLLM نسبت داد.
حافظهٔ زمینه محدودیت جداگانهای ایجاد میکند. برای نمونه، Qwen2.5-72B-Instruct دارای ۸۰ لایه، ۸ سر KV و بُعد ۱۲۸ برای هر سر است. با KV شانزدهبیتی، توجه کامل و بدون اشتراک پیشوند، حافظهٔ خام KV از ضرب «۲ برای K و V × تعداد لایهها × سرهای KV × بُعد سر × ۲ بایت × تعداد توکنها × تعداد دنبالهها» به دست میآید. جدول زیر فقط همین سهم را از روی پیکربندی رسمی مدل محاسبه میکند؛ زمینه، مجموع ورودی، تاریخچه و خروجی نگهداریشده است و هر GiB برابر ۲ به توان ۳۰ بایت است.
| دنبالههای فعال | توکن نگهداریشده برای هر دنباله | حافظهٔ خام KV شانزدهبیتی |
|---|---|---|
| یک دنباله | ۲٬۰۴۸ | ۰٫۶۲۵ GiB |
| یک دنباله | ۸٬۱۹۲ | ۲٫۵ GiB |
| یک دنباله | ۳۲٬۷۶۸ | ۱۰ GiB |
| چهار دنباله | هر کدام ۸٬۱۹۲ | ۱۰ GiB |
اگر این cache روی GPU باقی بماند، باید آن را به حافظهٔ بخش فعال مدل و فضای کاری اضافه کرد. به همین دلیل، اجرای یک نمونهٔ کوتاه روی کارت کوچک، ظرفیت همان کارت برای RAG با اسناد بلند یا چند گفتوگوی همزمان را اثبات نمیکند. Transformers امکان offload کردن KV را برای مسیرهای سازگار فراهم میکند، اما این کار انتقال دیگری میان CPU و GPU ایجاد میکند؛ سازگاری آن باید برای ترکیب مدل و نسخهٔ اجرا بررسی شود. حتی وقتی وزنها از VRAM خارج شدهاند، زمینهٔ هر درخواست همچنان بخشی از بودجهٔ سرویس است.
چهاربیتیکردن و خواندن پیشاپیش چه کمکی میکنند؟
خواندن پیشاپیش یا prefetch تلاش میکند لایهٔ بعدی را هنگام محاسبهٔ لایهٔ فعلی آماده کند. اگر زمان محاسبه برای پوشاندن بخش مهمی از بارگذاری کافی باشد، انتظار GPU کمتر میشود؛ اگر خواندن وزن بسیار طولانیتر باشد، فاصله همچنان باقی میماند. همچنین RAM بیشتر میتواند به نگهداشتن فایلها در cache سیستمعامل کمک کند. «فایل روی SSD است» الزاماً به این معنا نیست که در هر بار دسترسی، همان بایتها از خود SSD خوانده میشوند؛ تفاوت اجرای سرد و اجرای گرم باید در سنجش سرعت ثبت شود.
گزینهٔ compression='4bit' در AirLLM، وزنهای ذخیرهشدهٔ لایهها را با NF4 فشرده میکند. در مسیر بررسیشده، دادهٔ فشرده به CUDA میرود و برای محاسبه باز میشود؛ بنابراین کاهش حجم فایل را نباید با اجرای تمام عملیات در چهار بیت یا چهار برابر شدن سرعت یکسان گرفت. علاوه بر این، در همین نسخه، فعال کردن compression، خواندن پیشاپیش عمومی را غیرفعال میکند. پس دو بهینهسازی لزوماً با هم جمع نمیشوند و باید نتیجهٔ ترکیب واقعی را دید. مبنا، کد فشردهسازی و بازکردن وزنها و تنظیم prefetch در AirLLM است؛ این جزئیات به نسخه وابستهاند.
خودِ جابهجایی لایهها نیازی به حذف پارامتر یا کمدقتکردن وزن ندارد. با حفظ وزن، معماری و دقت مناسب، هدف همان محاسبات مدل اصلی است؛ با این حال یکسان بودن بیتبهبیت خروجی میان مسیرهای مختلف اجرا تضمین نمیشود. اگر فشردهسازی فعال شود، مسئلهٔ خطای کوانتیزهسازی هم اضافه میشود و کیفیت باید برای کاربرد مورد نظر سنجیده شود. رابطهٔ دقت ذخیرهسازی، حافظه و کیفیت در «چهاربیتیکردن مدل چه چیزی را ارزان میکند و چه چیزی را تغییر میدهد؟» جداگانه بررسی شده است.
برای چه کاری انتخاب معقولی است؟
ارزش AirLLM وقتی بیشتر میشود که استفاده از مدل بزرگ واقعاً تفاوت مفیدی در خروجی ایجاد کند و زمان انتظار قابل پذیرش باشد. «پردازش آفلاین» هم بهتنهایی کافی نیست: اگر صف کار تا صبح تمام نشود، سامانه برای همان کاربرد نیز ظرفیت کافی ندارد. جدول زیر پیشنهاد برای ترتیب بررسی گزینههاست؛ نتیجهٔ نهایی به کیفیت مورد نیاز، حجم کار و مهلت تحویل وابسته است.
| کاربرد | جایگاه اجرای لایهبهلایه | مقایسهای که تصمیم را روشن میکند |
|---|---|---|
| بررسی محدود یک مدل بزرگ برای پژوهش یا انتخاب اولیه | گزینهای مفید برای دسترسی با سختافزار موجود | زمان آمادهسازی و اجرای چند نمونه در برابر دسترسی موقت به سختافزار پرحافظه |
| استخراج اطلاعات یا تولید داده با حجم محدود و مهلت آزاد | قابل بررسی، بهویژه اگر مدل کوچکتر کیفیت لازم را ندهد | تعداد خروجی پذیرفتنی در ساعت و مدت تکمیل کل مجموعه |
| پردازش شبانهٔ اسناد سازمان | وابسته به ظرفیت واقعی صف و امکان استفاده از batch | پایان یافتن کار در پنجرهٔ زمانی تعیینشده، با طول ورودی و خروجی واقعی |
| چتبات و RAG تعاملی برای چند کاربر | معمولاً گزینهٔ آغاز مناسبی برای مدل متراکم بسیار بزرگ نیست | مدل کوچکترِ مقیم روی GPU، کیفیت بازیابی و تأخیر پاسخ در بار همزمان |
| دستیار کدنویسی یا عامل با چند فراخوانی متوالی | حساس به جمع شدن تأخیر هر مرحله | زمان تکمیل کل کار؛ مدل تخصصی مقیم یا مسیر اجرای سریعتر |
| آزمایش آداپتر روی معماری پشتیبانیشده | گزینهٔ پژوهشی قابل بررسی در نسخههای دارای پشتیبانی آموزش | زمان هر گام، زمان رسیدن به کیفیت هدف و هزینهٔ تکرار آزمایشها |
برای یک دستیار دانش سازمانی، گاهی کیفیت بازیابی سند و انتخاب مدل مناسبتر از افزایش تعداد پارامترها اثر دارد. اگر یک مدل ۳ یا ۸ میلیاردی کیفیت لازم را فراهم کند، مقیم ماندن آن روی کارت ارزانتر میتواند فضای بیشتری برای زمینه و پردازش درخواستها باقی بگذارد؛ با چند کارت نیز میتوان نسخههای مستقل سرویس داشت. این انتخاب باید با نمونههای واقعی انجام شود، چون تحلیل چندمرحلهای، اسناد دشوار یا زمینهٔ بلند ممکن است به توان بیشتری نیاز داشته باشند. نقطهٔ شروع این بررسی در یادداشت اندازهٔ مناسب مدل برای هر کاربرد و مقایسهٔ مدلها روی RTX 4090 توضیح داده شده است.
سازگاری مدل، فایل وزن و نرمافزار سرویس
AirLLM، Ollama و vLLM را نمیتوان صرفاً سه نام برای یک کار یکسان دانست. AirLLM در بحث حاضر راهی برای مدیریت حافظه و اجرای مدل است؛ یک سرویس علاوه بر آن به صف درخواست، محدود کردن همزمانی، کنترل طول زمینه و مدیریت بار نیاز دارد. برای نمونه، Ollama تنظیمات مشخصی برای صف و درخواستهای موازی دارد. قراردادن یک API جلوی AirLLM، محدودیت انتقال داده را از بین نمیبرد؛ نقش موتور، سرور API و ابزار مدیریت مدل در جدول نرمافزارهای اجرا و سرویسدهی جدا شده است.
برای دریافت مدل، باید مخزن وزن اصلی، معماری، قالب فایل و نسخهٔ وابستگیها مشخص باشند. وجود نسخهٔ GGUF برای یک مدل، بهخودیخود به معنی قابلاستفاده بودن همان فایل در AirLLM نیست؛ مسیر متداول AirLLM از checkpointهای سازگار با Transformers و فایلهای لایهای خودش استفاده میکند. کد انتخاب کلاس مدل نیز نشان میدهد بعضی معماریها مسیر اختصاصی دارند. نسخهٔ دقیق AirLLM و Transformers را باید همراه با شناسهٔ مدل ثبت کرد؛ صرف ذکر خانوادهٔ «Qwen» یا «DeepSeek» برای بازتولید اجرا کافی نیست.
در مدلهای MoE، تعداد پارامترهای فعال لزوماً حجم وزن منتقلشده را مشخص نمیکند. AirLLM برای معماریهای دارای مسیر مناسب، بارگذاری انتخابی expertها دارد که با خواندن لایهٔ کامل فرق میکند. expertهای مورد نیاز یک batch نیز ممکن است از یک توکن منفرد بیشتر باشند. پس جدول انتقال ۱۴۰ GB به همهٔ مدلهای MoE تعمیمپذیر نیست؛ پارامترهای کل، اندازهٔ وزنهای قابل نگهداری را تعیین میکنند و پارامترهای فعال، بخش مصرفشده در هر گام را توصیف میکنند. مقدار انتقال به انتخاب expertها و استفادهٔ مجدد از وزنها نیز وابسته است.
آیا آموزش مدل هم ممکن است؟
توصیف AirLLM بهعنوان ابزاری که «فقط استنتاج میکند» با کد فعلی پروژه کامل نیست. در زمان تدوین این یادداشت، مسیر آموزش LoRA برای Qwen3.5 و Qwen3.8 متراکمِ چندوجهی در حالت فقطمتن، و مسیر Qwen4Exp برای Qwen3.8-Flash-Next وجود دارد. در این مسیرها بخش بینایی روی دستگاه مجازی meta باقی میماند و آموزش تصویر انجام نمیشود: وزنهای پایه ثابت میمانند و لایهبهلایه بارگذاری میشوند، آداپترها و وضعیت بهینهساز آنها روی GPU نگهداری میشوند و بخشی از دادههای میانی به CPU میرود. در پیادهسازی آموزش AirLLM، محاسبهٔ دوباره هنگام backward نیز بخشی از کاهش مصرف حافظه است؛ دامنهٔ این مسیر با فهرست همهٔ مدلهای قابل استنتاج یکسان نیست.
این قابلیت، امکان آزمایش آداپتر را گسترش میدهد، اما معادل آموزش کامل همهٔ وزنها یا پیشآموزش مدل بزرگ روی کارت کوچک نیست. انتقال دوباره، محاسبهٔ دوباره و تعداد زیاد گامها میتوانند هزینهٔ زمانی قابل توجهی داشته باشند. اگر آزمایشها مرتب تکرار میشوند یا مهلت تحویل مهم است، سختافزار پرحافظهتر ممکن است با تمام کردن سریعتر آموزش اقتصادیتر باشد؛ معیار مقایسه، هزینهٔ رسیدن به کیفیت هدف است. پیش از آن نیز باید روشن شود مسئله با بازیابی دانش حل میشود یا واقعاً تغییر رفتار مدل لازم است؛ این انتخاب در مقایسهٔ RAG، CAG، KAG، Fine-tuning و Instruction tuning بررسی شده است.
هزینه را با کار تکمیلشده بسنجیم
برای تصمیمگیری، اجرای موفق یک prompt کوتاه کافی نیست؛ در عین حال نیازی هم نیست انتخاب اولیه به یک پروژهٔ آزمایشگاهی بزرگ تبدیل شود. چند ورودی نماینده از کار واقعی، یک ورودی نزدیک به طول مورد نیاز و حجم محدودی از صف واقعی، تصویر بسیار مفیدتری میدهند. زمان دانلود و آمادهسازی را از اجرای عادی جدا کنید و در اجرای عادی، زمان رسیدن نخستین توکن، سرعت ادامهٔ پاسخ، مدت تکمیل کار و اوج RAM و VRAM را ثبت کنید. مقایسهٔ اجرای سرد و گرم نیز نشان میدهد چه مقدار از نتیجه به cache میزبان وابسته است.
در سرویس تعاملی، این بررسی باید با بار همزمان مورد انتظار تکرار شود و علاوه بر میانگین، پاسخهای کندتر و رشد صف هم دیده شوند. در پردازش آفلاین، معیار روشنتر میتواند «هزینهٔ هر هزار خروجی پذیرفتنی» باشد: هزینهٔ سختافزار یا اجاره، انرژی و زمان عملیاتی را در برابر تعداد کارهای تکمیلشده با کیفیت لازم قرار دهید. مصرف برق لحظهای کمتر، بهتنهایی انرژی کمتر برای کل کار را ثابت نمیکند؛ زمان طولانیتر میتواند آن مزیت را خنثی کند. AirLLM با هزینهٔ اولیهٔ پایینتر ممکن است برای استفادهٔ گاهبهگاه مناسب باشد و همان پیکربندی برای کار مداوم انتخاب ضعیفتری شود.
بهترین نقطهٔ شروع، مدل و مسیر اجرایی است که کیفیت لازم را با ظرفیت و زمان پاسخ مناسب فراهم کند. AirLLM زمانی جایگاه روشنی پیدا میکند که مدل بزرگتر به کار ارزش اضافه کند، محدودیت حافظه مانع دسترسی باشد و هزینهٔ انتظار قابل پذیرش بماند. در چنین وضعیتی، اجرای لایهبهلایه میتواند از سختافزار موجود استفادهٔ تازهای بسازد؛ برای خرید بعدی نیز جدول تناسب مدل و سختافزار کمک میکند افزایش حافظه، انتخاب مدل کوچکتر و تغییر روش اجرا در کنار هم سنجیده شوند.