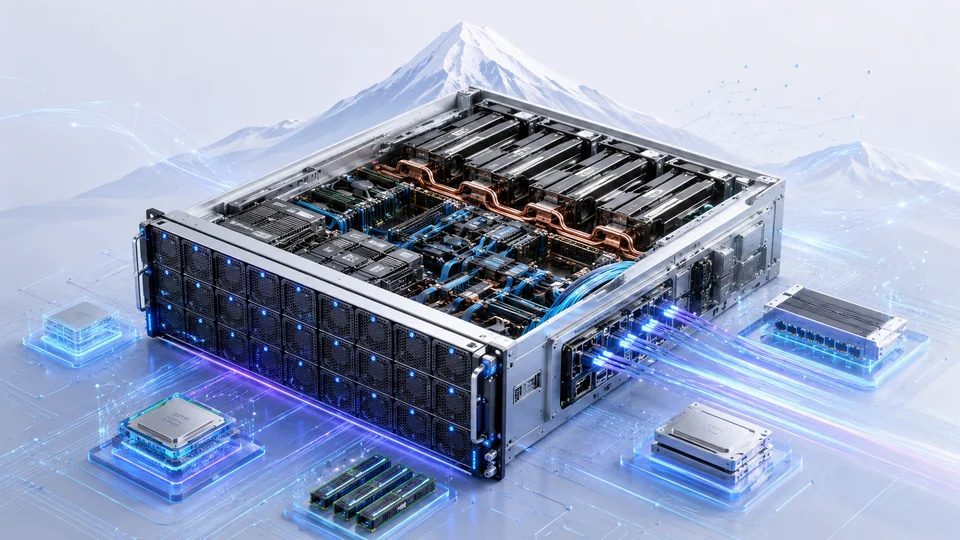
سرورهای مناسب کارتهای گرافیکی
در انتخاب سکوی پردازشی، تعداد کارتهای گرافیکی که میتوانند بهصورت همزمان روی یک سکو نصب شوند عامل تعیینکنندهای است. استفاده از چند کارت میتواند با بهرهگیری از موازیسازی، سرعت اجرای بسیاری از آزمایشها را افزایش دهد. هرچند این افزایش سرعت برای همهٔ الگوریتمها میسر نیست و لازم است کتابخانههای نرمافزاری توان استفاده از چند پردازنده را داشته باشند، حتی در صورت عدم پشتیبانی یک کار واحد نیز میتوان چند کار مستقل را همزمان اجرا کرد و هزینهٔ شاسی، برق و فضای اشغالشده را میان آنها تقسیم کرد. در این مقاله، مستقل از مدل شاسی، پردازنده، حافظه، ذخیرهسازی و ارتباطات شبکه بررسی میشوند.
پردازندهٔ مرکزی
با وجود آنکه در پردازشهای هوش مصنوعی بار اصلی بر عهدهٔ پردازندههای گرافیکی است، پردازندهٔ مرکزی نیز به سبب توزیع وظایف، آمادهسازی داده و گردآوری نتایج اهمیت دارد. بیشتر سرورهای تخصصی هوش مصنوعی از یک یا دو پردازندهٔ مرکزی پشتیبانی میکنند و تمرکز اصلی آنها روی تعداد پردازندههای گرافیکی است. کاربر یک سیستم پردازشی باید بتواند میان وظایفی که صرفاً به پردازندهٔ مرکزی نیاز دارند با وظایف مناسب GPU تمایز قائل شود و کارهایی از قبیل بخشی از پیشپردازش یا نمایش دادهها را در صورت امکان روی سرورهای معمولی انجام دهد.
در نسخهٔ اولیه، AMD EPYC به دلیل تعداد هستهٔ بیشتر در کلاس قیمتی مشابه بر Intel Xeon ترجیح داده شده و فرکانس پایهٔ ۲٫۲ گیگاهرتز بهعنوان یک حد پیشنهاد شده بود. با تغییر نسل پردازندهها، این توصیه دیگر عمومی و دقیق نیست. در یک سرور چندGPU، تعداد laneهای PCIe، نحوهٔ توزیع اسلاتها میان دو CPU، کانال و پهنایباند حافظه و سازگاری پردازنده با BOM شاسی میتوانند از تعداد هسته یا فرکانس اسمی مهمتر باشند. انتخاب نهایی باید با توجه به نوع بار کاری و شاسی منتخب انجام شود و در این بخش نمیتوان یک برند یا مدل خاص را برای همه پیشنهاد کرد.
حافظهٔ سیستم
همانند پردازندهٔ مرکزی، میزان حافظهٔ اصلی سیستم نیز تابع نوع استفاده است. در کاربردی که فعالیت آموزش یا استنتاج برای GPU بهینه شده و تمام مدل و دادهٔ فعال در حافظهٔ کارت قرار میگیرد، مصرف RAM میتواند کم باشد. در مقابل، data loader، cache، preprocessing، offload و چند کاربر همزمان میتوانند نیاز حافظه را بهسرعت افزایش دهند. در نسخهٔ اولیه پیشنهاد شده بود حجم RAM دستکم ۲۵ درصد بیشتر از مجموع حافظهٔ کارتها باشد؛ این نسبت ممکن است برای برآورد اولیه مفید باشد، اما اصل فنی ثابتی نیست و باید با اندازهگیری بار کاری جایگزین شود.
بهرهگیری از سرور تخصصی هوش مصنوعی مستلزم آموزش بهرهبرداران برای استفادهٔ بهینه از امکانات است تا موجب اتلاف منابع نشود. در یک آزمایش واقعی مشاهده شد که نیروهای غیرمتخصص بدون توجه به اشکال موجود در کد، بیش از یک ترابایت حافظهٔ سیستم مصرف کردند و معتقد بودند حافظهٔ سیستم کم است؛ پس از خطایابی و رفع اشکال مشخص شد تنها به حدود ۶۴ گیگابایت حافظه نیاز داشتهاند. این مثال به معنی کافیبودن ۶۴ گیگابایت برای همه نیست؛ نشان میدهد کد غیربهینه میتواند خود را به شکل کمبود سختافزار نشان دهد.
ذخیرهسازی
در حوزهٔ ذخیرهسازی با سه نوع فضا در ارتباط هستیم:
- دیسک سیستمعامل و بخشهای حیاتی باید سریع و باکیفیت باشد. ظرفیت آن را اندازهٔ سیستمعامل، درایورها و ابزارهای مدیریتی تعیین میکند و دیگر نمیتوان حد ثابت ۲۵۶ تا ۵۱۲ گیگابایت را برای همهٔ سرورها توصیه کرد. اگر بازیابی سریع اهمیت دارد، RAID1 یا راهکار جایگزین آن باید در معماری دیده شود.
- فضای کانتینرها، لاگها، cache و ذخیرهسازی موقت به ظرفیت و سرعت مناسب نیاز دارد. تعداد دیسک و نوع RAID باید از نسبت خواندن و نوشتن، تحمل خرابی و زمان بازسازی به دست آید؛ ترکیب شش دیسک و RAID5 که در نسخهٔ اولیه پیشنهاد شده بود، نسخهٔ عمومی همهٔ بارهای هوش مصنوعی نیست.
- فضای مدلها و دادگان ممکن است محلی یا مشترک باشد. ظرفیتهای ۲۰ ترابایت برای هر سرور و ۱۰۰ ترابایت مشترک در متن اولیه تنها یک برآورد پروژهای بودند و باید از حجم داده، رشد، تعداد نسخهها و سیاست نگهداری محاسبه شوند. داده یا checkpointی که قابل بازتولید نیست کماهمیت محسوب نمیشود و به افزونگی و نسخهٔ پشتیبان مستقل نیاز دارد.
ارتباطات شبکه
ارتباطات شبکه میان سرورها بسته به نوع کاربرد میتواند بسیار مهم باشد. در صورت استفاده از سرورهای مستقل از هم، عملاً به شبکهٔ محاسباتی بسیار پرظرفیت نیاز نیست، اما برای اجرای یک کار توزیعشده میان چند سرور باید شبکه نیز جزئی از موتور محاسبه در نظر گرفته شود. بهصورت کلی سه شبکه باید از هم تفکیک شوند:
- شبکهٔ مدیریتی برای ارتباط خارج از باند باید ایزوله و از سوییچ و مسیریابی مستقل برخوردار باشد. سرعت آن را ابزارهای مدیریتی تعیین میکنند و عدد ۱Gbps نسخهٔ اولیه دیگر یک الزام عمومی نیست.
- شبکهٔ دسترسی کاربران و اینترنت باید بر اساس حجم تبادل، سیاست امنیتی و محل داده طراحی شود و لزوماً همان شبکهٔ مدیریت یا ذخیرهسازی نیست.
- شبکهٔ ارتباطی میان سرورها در صورت اجرای job مشترک به پهنایباند و تأخیر مناسب نیاز دارد. اعداد ثابت ۱۰، ۴۰ یا ۱۰۰Gbps که در نسخهٔ قبلی پیشنهاد شده بودند بدون دانستن نوع parallelism، تعداد GPU، RDMA و GPUDirect قابل دفاع نیستند. کتابخانهٔ NCCL ارتباط چندGPU را داخل و میان nodeها روی PCIe، NVLink، InfiniBand و IP پیاده میکند، اما مقیاسپذیری نهایی باید با همان کد اندازهگیری شود.
یک خطای فنی نسخهٔ اولیه نیز باید اصلاح شود: NVSwitch در سامانههای H100 و H200 اتصال GPUهای داخل یک سرور HGX/DGX را فراهم میکند و جای شبکهٔ میان سرورها نیست. معماری DGX SuperPOD برای اتصال nodeها علاوه بر DGX، شبکههای InfiniBand و Ethernet، گرههای مدیریتی و ذخیرهسازی را بهعنوان اجزای مستقل معرفی میکند. در نتیجه پهنایباند NVLink/NVSwitch را نباید بهعنوان سرعت شبکهٔ بین دو سرور در استعلام خرید نوشت.