Alibaba Cloud Model Studio · API · ۱٬۰۰۰٬۰۰۰ توکن زمینه · 2026-09-20
منبع رسمی و وضعیت عرضه ↗LLM & SLM
راهنمای انتخاب مدل زبانی بزرگ و کوچک
مدل زبانی مناسب ترجمه، دستیار اسناد و Agent را بر اساس زبان، حافظه، سختافزار و هزینه انتخاب کنید؛ مقایسه مدلها و راهنمای اجرای سازمانی.
امروزه بسیاری از افراد و سازمانها تمایل دارند برای کاربردهای مختلف،(LLM یا SLM) یک مدل زبانی محلی در اختیار داشته باشند؛ مدلی که روی رایانه یا سرور خودشان اجرا شود و برای گفتوگو، برنامهنویسی، ترجمه یا پاسخگویی بر اساس اسناد از آن استفاده کنند. حفظ محرمانگی اطلاعات، استقلال از سرویسهای خارجی و کنترل هزینهها از انگیزههای این انتخاب است. اما تنوع مدلها و روشهای اجرای آنها، تصمیمگیری را دشوار میکند: چه مدلی برای کار ما کافی است، روی سختافزار موجود چه چیزی میتوان اجرا کرد و چه زمانی ارتقای زیرساخت ضرورت دارد؟
این مجموعه برای پاسخ به همین پرسشها تهیه شده است. در جدولهای تعاملی میتوانید مدلهای زبانی کوچک و بزرگ، مدلهای تخصصی مرتبط، نیازهای سختافزاری و نرمافزارهای اجرای آنها را مقایسه کنید و به منابع و لینکهای کاربردی دسترسی داشته باشید. مقالههای همراه نیز توضیح میدهند هر انتخاب چه مزایا و محدودیتهایی دارد؛ تا بتوانید متناسب با کاربرد، کیفیت موردانتظار و بودجه خود تصمیم بگیرید و برای قابلیتی که به آن نیاز ندارید، هزینه نکنید.
از کجا شروع کنیم؟
برای مقایسه، جدول را باز کنید؛ برای شناخت مفاهیم و دلیل انتخاب، یادداشتهای هر مسیر را بخوانید.
راهنمای تعامل
با چند پرسش اصلی شروع کنید؛ برای نتیجهٔ دقیقتر، مشخصات اجرا را بعداً اضافه کنید.
پس از مشخصشدن مدل و حافظهٔ لازم، کارت گرافیک و سرور مناسب را مقایسه کنید.
دربارهٔ اطلاعات این راهنما
برای تهیهٔ این جدولها، مشخصات مدلها و مستندات نرمافزارها را بررسی کردهایم. اعداد کیفیت و سرعت از آزمونهای منتشرشده نقل شدهاند و حاصل آزمایش ما نیستند. منبع و شرایط هر آزمون هم کنار نتیجه آمده است.
در این مجموعه، مدلهایی برای نوشتن متن، برنامهنویسی، خواندن تصویر و سند، جستوجوی معنایی و مرتبکردن نتایج جستوجو آوردهایم. مدل بزرگتر یا مدلی که چندزبانه معرفی شده، لزوماً برای کار شما یا متن فارسی بهتر نیست؛ باید دید در همان کاربرد و زبان چه نتیجهای داشته است.
اطلاعات سختافزاری و نتایج سرعت این راهنما بیشتر به کارتهای NVIDIA مربوط است. اجرای مدل روی CPU، مکهای مجهز به Apple Silicon یا کارتهای AMD به پشتیبانی نرمافزار بستگی دارد. برای مقایسهٔ سرعت این گزینهها، هنوز آزمونهای کافی با شرایط یکسان در اختیار نداریم. کدام نرمافزار روی سختافزار شما اجرا میشود؟
برای برآورد حافظهٔ لازم، حجم فایل وزنهای مدل، حافظهٔ موقت مدل (KV cache) و فضای اضافهٔ موردنیاز برای اجرا روی هر دستگاه را در نظر گرفتهایم. فرمول معمول KV را برای مدلهای با معماری ترکیبی، MLA یا معماری نامشخص به کار نبردهایم. جزئیات محاسبه در بخش حافظه آمده است.
آخرین بررسی دادهها: · اگر اشتباهی دیدید، به من خبر بدهید
نمای دادهای
شناسنامهٔ مدلها
مدلهای با وزن قابل دریافت: اندازه، معماری، طول متن و مجوز؛ سرویسهای API در این فهرست نیستند.
آزمونِ ستون نتیجه: MIRACL · nDCG@10 · fa
این انتخاب برای ستون نتیجهٔ همهٔ جدولهاست. شرایط اجرا در جزئیات هر مدل آمده است.
دیدن نتایج به تفکیک آزمون ←۱۲۵ نتیجه از ۱۲۵ ردیف
فیلترهای تخصصی ۱۵ کنترل
همهٔ ردیفها
مقایسهٔ ردیفها و شرایط آن
قاعدهٔ مقایسه: مشاهدهٔ کنارهم همیشه مجاز است؛ محاسبه فقط برای فیلدهای همواحد و انتساب نسخهمند معتبر است.
مدلهای عرضهشده از طریق API · ۴
برای این نسخهها وزن قابل نصب در این بررسی تأیید نشده است؛ آنها در پیشنهاد اجرای محلی وارد نمیشوند.
Alibaba Cloud Model Studio · API · ۱٬۰۰۰٬۰۰۰ توکن زمینه · 2026-09-20
منبع رسمی و وضعیت عرضه ↗Alibaba Cloud Model Studio · API · ۸٬۱۹۲ توکن ورودی · 2026-09-20
منبع رسمی و وضعیت عرضه ↗Alibaba Cloud Model Studio · API · ۸٬۱۹۲ توکن ورودی · 2026-09-20
منبع رسمی و وضعیت عرضه ↗| مقایسه | جزئیات | ورودی ← خروجی | کاربردهای شاخص | مجوز | دریافت و اجرای مدل | ||||
|---|---|---|---|---|---|---|---|---|---|
 | BGE · BAAI | حدود ۰٫۵۶۹ میلیارد · متراکم | متن ← بردار | ۸٬۱۹۲ توکن | بازیابی ترکیبی سند در RAG | MIT ↗ | |||
| | BGE · BAAI | حدود ۰٫۵۶۸ میلیارد · متراکم | متن ← دادهٔ ساختاریافته | ۸٬۱۹۲ توکن | مرتبکردن دوبارهٔ اسناد بازیابیشده | Apache-2.0 ↗ | |||
 | Aya / Cohere · Cohere Labs | حدود ۳۲ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | نگارش و گفتوگوی چندزبانه با اسناد بلند | CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ | |||
| | Aya / Cohere · Cohere Labs | حدود ۸ میلیارد · متراکم | متن ← متن | ۸٬۱۹۲ توکن | دستیار نوشتن و بازنویسی چندزبانه | CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ | |||
| | Aya / Cohere · Cohere Labs | حدود ۳٫۳۵ میلیارد · متراکم | متن ← متن | ۸٬۱۹۲ توکن | گفتوگوی محلی در زبانهای گوناگون | CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ | |||
 | SmolLM · Hugging Face | حدود ۱٫۷ میلیارد · متراکم | متن ← متن | ۸٬۱۹۲ توکن | نمونهسازی دستیار کوچک با فراخوانی تابع | Apache-2.0 ↗ | |||
| | SmolLM · Hugging Face | حدود ۰٫۱۳۵ میلیارد · متراکم | متن ← متن | ۸٬۱۹۲ توکن | آزمایش پیروی از دستور با مدل بسیار کوچک | Apache-2.0 ↗ | |||
| | SmolLM · Hugging Face | حدود ۰٫۳۶ میلیارد · متراکم | متن ← متن | ۸٬۱۹۲ توکن | بازنویسی و خلاصهسازی متن کوتاه | Apache-2.0 ↗ | |||
| | SmolLM · Hugging Face | حدود ۳ میلیارد · متراکم | متن ← متن | ۶۵٬۵۳۶ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN و افزایش max_position_embeddings | دستیار کوچک با انتخاب حالت فکرکردن | Apache-2.0 ↗ | |||
 | Qwen · Qwen / Alibaba Cloud | حدود ۰٫۶ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن | نمونهسازی گفتوگو با کوچکترین Qwen3 | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۱٫۷ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن | دستیار متنی کوچک با کنترل استدلال | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۱۴٫۸ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN | تولید و تحلیل متن با Qwen3 متراکم | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۳۰٫۵ میلیارد · ۳٫۳ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN | دستیار ابزارمحور با معماری MoE | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۳۲٫۸ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN | تحلیل چندمرحلهای با نسخهٔ متراکم بزرگ Qwen3 | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۴ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN | دستیار عمومی در اندازهٔ چهار میلیارد | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۸٫۲ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن تا ۱۳۱٬۰۷۲ توکن با تنظیم YaRN | گفتوگو و کار با متن با کنترل فکرکردن | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۳۰٫۵ میلیارد · ۳٫۳ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | ۲۶۲٬۱۴۴ توکن تا ۱٬۰۴۸٬۵۷۶ توکن با تنظیم YaRN | اصلاح مخزن کد با دستیار ابزارمحور | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۰٫۶ میلیارد · متراکم | متن ← بردار | ۳۲٬۷۶۸ توکن | بازیابی برداری با کوچکترین Qwen3 Embedding | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۴ میلیارد · متراکم | متن ← بردار | ۳۲٬۷۶۸ توکن | نمایهسازی چندزبانه با بردار قابل تنظیم | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۸ میلیارد · متراکم | متن ← بردار | ۳۲٬۷۶۸ توکن | بازیابی سند با بزرگترین Qwen3 Embedding فهرست | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۰٫۶ میلیارد · متراکم | متن ← دادهٔ ساختاریافته | ۳۲٬۷۶۸ توکن | بازرتبهبندی سبکتر در خانوادهٔ Qwen3 | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۴ میلیارد · متراکم | متن ← دادهٔ ساختاریافته | ۳۲٬۷۶۸ توکن | بازرتبهبندی دستورپذیر اسناد نامزد | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۸ میلیارد · متراکم | متن ← دادهٔ ساختاریافته | ۳۲٬۷۶۸ توکن | بازرتبهبندی با نسخهٔ هشتمیلیاردی Qwen3 | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۸ میلیارد اسمی · متراکم شمار کل تأیید نشده | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | خواندن تصویر و سند با Qwen3-VL | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۲ میلیارد · حدود ۲ میلیارد جزء زبانی · متراکم · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | نمونهسازی چندوجهی با Qwen3.5 کوچک | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۳۵ میلیارد · ۳ میلیارد فعال · حدود ۳۵ میلیارد جزء زبانی · ترکیب متخصصان (MoE) · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با افزایش زمینه با YaRN | عامل چندوجهی با Qwen3.5 از نوع MoE | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۴ میلیارد · حدود ۴ میلیارد جزء زبانی · متراکم · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با افزایش زمینه با YaRN | پردازش متن و تصویر در اندازهٔ چهار میلیارد | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۹ میلیارد · حدود ۹ میلیارد جزء زبانی · متراکم · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با افزایش زمینه با YaRN | دستیار اسناد و تصویر با Qwen3.5 متراکم | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۲۷ میلیارد · حدود ۲۷ میلیارد جزء زبانی · ترکیبی · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن تا ۱٬۰۰۰٬۰۰۰ توکن با افزایش زمینه با YaRN | گردشکار طولانی با عامل متن–تصویر | Apache-2.0 ↗ | |||
 | OLMo · Allen Institute for AI | حدود ۷ میلیارد · متراکم | متن ← متن | ۶۵٬۵۳۶ توکن | پژوهش دستورپذیری با مسیر آموزش قابل بررسی | Apache-2.0 ↗ | |||
 | DeepSeek · DeepSeek | حدود ۸ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | آزمایش استدلال تقطیرشده از R1-0528 | MIT ↗ | |||
| | DeepSeek · DeepSeek | حدود ۷۰ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | استدلال تقطیرشده روی پایهٔ Llama 70B | MIT + underlying Llama 3.3 terms ↗ | |||
| | DeepSeek · DeepSeek | حدود ۱٫۵ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | آزمایش مرز استدلال در مدل تقطیری بسیار کوچک | MIT ↗ | |||
| | DeepSeek · DeepSeek | حدود ۱۴ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | حل مسئله با تقطیر R1 در اندازهٔ میانی | MIT ↗ | |||
| | DeepSeek · DeepSeek | حدود ۳۲ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | تحلیل و کدنویسی با تقطیر متراکم ۳۲میلیاردی | MIT ↗ | |||
| | DeepSeek · DeepSeek | حدود ۷ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | حل مسئله با نسخهٔ هفتمیلیاردی تقطیر R1 | MIT ↗ | |||
| | DeepSeek · DeepSeek | ۶۸۵٫۳۹۷ میلیارد عنصر در فایل وزن · ترکیب متخصصان (MoE) شمار ذخیرهشده در checkpoint؛ شامل مؤلفههای اضافی، نه شمار فعال در تولید هر توکن. | متن ← متن | ۱۶۳٬۸۴۰ توکن | پیوند استدلال و ابزار در گردشکار عامل | MIT ↗ | |||
| | DeepSeek · DeepSeek | ۸ میلیارد فعال هنگام prefill · ۱۶ میلیارد فعال هنگام decode · حدود ۵۵۲ میلیارد بدنهٔ اصلی · حدود ۱۹۶ میلیارد حافظهٔ شرطی Engram · ترکیب متخصصان (MoE) · توجه ترکیبی شمار کل تأیید نشده | متن، تصویر ← متن | ۱٬۰۰۰٬۰۰۰ توکن | عامل چندوجهی برای ورودیهای بسیار بلند | MIT ↗ | |||
 | Gemma · Google DeepMind | حدود ۱۲ میلیارد · متراکم | متن، تصویر ← متن | ۱۳۱٬۰۷۲ توکن | پرسش از تصویر و متن با Gemma 3 میانی | gemma ↗ | |||
| | Gemma · Google DeepMind | حدود ۱ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن | دستیار متنی کوچک از خانوادهٔ Gemma 3 | gemma ↗ | |||
| | Gemma · Google DeepMind | حدود ۲۷ میلیارد · متراکم | متن، تصویر ← متن | ۱۳۱٬۰۷۲ توکن | درک متن و تصویر با بزرگترین Gemma 3 فهرست | gemma ↗ | |||
| | Gemma · Google DeepMind | حدود ۴ میلیارد · متراکم | متن، تصویر ← متن | ۱۳۱٬۰۷۲ توکن | ورود به پردازش تصویر در خانوادهٔ Gemma 3 | gemma ↗ | |||
| | Gemma · Google DeepMind | حدود ۲۶ میلیارد اسمی · حدود ۲۵٫۲ میلیارد جزء زبانیِ جدول ناشر · ترکیب متخصصان (MoE) شمار کل تأیید نشده | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | استدلال چندوجهی با Gemma 4 از نوع MoE | Apache-2.0 ↗ | |||
| | Gemma · Google DeepMind | حدود ۲٫۳ میلیارد مؤثر بدون جدول embedding · حدود ۵٫۱ میلیارد جزء زبانی با embedding · حدود ۰٫۳ میلیارد رمزگذار صوت · متراکم شمار کل تأیید نشده | متن، تصویر، صوت، ویدیو ← متن | ۱۳۱٬۰۷۲ توکن | پردازش محلی متن، تصویر و صوت با Gemma 4 کوچک | Apache-2.0 ↗ | |||
 | Granite · IBM | حدود ۲ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | تولید پاسخ از اسناد بازیابیشده | Apache-2.0 ↗ | |||
 | E5 · intfloat / multilingual E5 authors | ۰٫۱۱۸ میلیارد · متراکم | متن ← بردار | ۵۱۲ توکن | بازیابی چندزبانه با بردار کمبُعد | MIT ↗ | |||
 | Llama · Meta | حدود ۷۰ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | دستیار عمومی با Llama 3.1 بزرگ | llama3.1 ↗ | |||
| | Llama · Meta | حدود ۸ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | گفتوگو و کار با متن با Llama 3.1 هشتمیلیاردی | llama3.1 ↗ | |||
| | Llama · Meta | حدود ۱ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | بازنویسی و خلاصهسازی محلی با Llama کوچک | llama3.2 ↗ | |||
| | Llama · Meta | حدود ۳ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | دستیار متنی روی دستگاه با Llama سهمیلیاردی | llama3.2 ↗ | |||
| | Phi · Microsoft | حدود ۳٫۸ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | تحلیل و منطق در محیط محدودتر | MIT ↗ | |||
 | Mistral · Mistral AI | حدود ۲۴ میلیارد · متراکم | متن، تصویر ← متن | ۲۶۲٬۱۴۴ توکن | عامل ویرایش چندفایلی و جستوجوی مخزن | Apache-2.0 ↗ | |||
| | Mistral · Mistral AI | حدود ۳٫۴ میلیارد جزء زبانی · متراکم شمار کل تأیید نشده | متن، تصویر ← متن | ۲۶۲٬۱۴۴ توکن وزن منتشرشده FP8؛ ظرفیت اجرا به precision و حافظهٔ زمینه وابسته است. | دستیار چندوجهی برای استقرار لبه | Apache-2.0 ↗ | |||
| | Mistral · Mistral AI | حدود ۷ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن | دستیار متنی با قالب فراخوانی تابع Mistral | Apache-2.0 ↗ | |||
| | Mistral · Mistral AI | حدود ۲۴ میلیارد · متراکم | متن، تصویر ← متن | ۱۳۱٬۰۷۲ توکن | دستیار چندزبانهٔ متن و تصویر | Apache-2.0 ↗ | |||
 | Nemotron · NVIDIA | حدود ۹ میلیارد · ترکیبی · توجه ترکیبی | متن ← متن | ۱۳۱٬۰۷۲ توکن | پاسخ از سند با کنترل بودجهٔ استدلال | nvidia-open-model-license ↗ | |||
 | gpt-oss · OpenAI | حدود ۱۱۷ میلیارد · ۵٫۱ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | ۱۳۱٬۰۷۲ توکن با تنظیمات YaRN همراه مدل منتشرشده | عامل با استدلال قابل تنظیم در نسخهٔ بزرگ gpt-oss | Apache-2.0 ↗ | |||
| | gpt-oss · OpenAI | حدود ۲۱ میلیارد · ۳٫۶ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | ۱۳۱٬۰۷۲ توکن با تنظیمات YaRN همراه مدل منتشرشده | استدلال محلی با نسخهٔ کوچکتر gpt-oss | Apache-2.0 ↗ | |||
 | GLM · Z.ai | حدود ۳۰ میلیارد · ۳ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | ۲۰۲٬۷۵۲ توکن | عامل برنامهنویسی با استدلال حفظشونده | MIT ↗ | |||
 | Kimi · Moonshot AI | حدود ۱٬۰۰۰ میلیارد اسمی · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده | متن ← متن | ۱۳۱٬۰۷۲ توکن | عامل متنی برای برنامهنویسی و گردشکارهای ابزارمحور | Modified MIT ↗ | |||
| | Kimi · Moonshot AI | حدود ۱٬۰۰۰ میلیارد اسمی · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده | متن ← متن | ۲۶۲٬۱۴۴ توکن | عامل استدلالی برای زنجیرههای طولانی ابزار و تحلیل | Modified MIT ↗ | |||
| | Kimi · Moonshot AI | حدود ۱٬۰۰۰ میلیارد اسمی · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | عامل چندوجهی برای کدنویسی از طرح تصویری و تحلیل سند | Modified MIT ↗ | |||
 | MiniMax · MiniMax | حدود ۲۳۰ میلیارد اسمی · ۱۰ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده | متن ← متن | ۱۹۶٬۶۰۸ توکن | دستیار توسعه نرمافزار و گردشکارهای ابزارمحور | Modified MIT ↗ | |||
| | MiniMax · MiniMax | حدود ۲۳۰ میلیارد اسمی · ۱۰ میلیارد فعال · ترکیب متخصصان (MoE) شمار کل تأیید نشده | متن ← متن | ۱۹۶٬۶۰۸ توکن | مدل ابزارمحور برای کدنویسی و برنامهریزی چندمرحلهای | Modified MIT ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۲۳۵ میلیارد · ۲۲ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | ۲۶۲٬۱۴۴ توکن | دستیار بزرگ با پاسخ مستقیم و زمینهٔ بلند | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۴۸۰ میلیارد · ۳۵ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | ۲۶۲٬۱۴۴ توکن | عامل کدنویسی برای مخزنهای بزرگ و چندفایلی | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۲۷ میلیارد · متراکم · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | دستیار چندوجهی برای تحلیل، کد و سند | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۰٫۸ میلیارد · متراکم · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | مدل کوچک برای نمونهسازی و تخصصیسازی وظیفه | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۱۲۲ میلیارد · ۱۰ میلیارد فعال · ترکیب متخصصان (MoE) | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | مدل چندوجهی MoE برای تحلیل و کار با ابزار | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۳۹۷ میلیارد · ۱۷ میلیارد فعال · ترکیب متخصصان (MoE) | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | دستیار چندوجهی بزرگ برای مسائل پیچیده | Apache-2.0 ↗ | |||
| | Llama · Meta | حدود ۷۰ میلیارد اسمی · متراکم شمار کل تأیید نشده | متن ← متن | ۱۳۱٬۰۷۲ توکن | دستیار متنی چندزبانه برای پاسخگویی و کار سازمانی | llama3.3 ↗ | |||
| | Phi · Microsoft | حدود ۱۴ میلیارد اسمی · متراکم شمار کل تأیید نشده | متن ← متن | ۱۶٬۳۸۴ توکن | مدل انگلیسی برای ریاضی، منطق و تولید متن | MIT ↗ | |||
| | SmolVLM · Hugging Face | حدود ۲٫۲ میلیارد اسمی · متراکم شمار کل تأیید نشده | متن، تصویر، ویدیو ← متن | ۸٬۱۹۲ توکن | مدل کوچک برای پرسش از تصویر و ویدئو | Apache-2.0 ↗ | |||
 | MiniLM · Sentence Transformers | ۰٫۰۲۳ میلیارد · متراکم | متن ← بردار | ۲۵۶ توکن | بردارساز سبک انگلیسی برای جستوجو و خوشهبندی | Apache-2.0 ↗ | |||
| | E5 · intfloat / multilingual E5 authors | ۰٫۲۷۸ میلیارد · متراکم | متن ← بردار | ۵۱۲ توکن | بردارساز چندزبانه با پیشوند مجزای پرسش و سند | MIT ↗ | |||
| | E5 · intfloat / multilingual E5 authors | ۰٫۵۶ میلیارد · متراکم | متن ← بردار | ۵۱۲ توکن | بردارساز چندزبانه برای جستوجوی معنایی | MIT ↗ | |||
| | BGE · BAAI | ۰٫۰۳۳ میلیارد · متراکم | متن ← بردار | ۵۱۲ توکن | بردارساز کوچک انگلیسی برای بازیابی اسناد | MIT ↗ | |||
| | BGE · BAAI | ۰٫۲۷۸ میلیارد · متراکم | متن ← دادهٔ ساختاریافته | ۵۱۲ توکن | بازرتبهبند انگلیسی و چینی برای نتایج جستوجو | MIT ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۷٫۶۱ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن | دستیار کدنویسی کوچک برای توضیح و اصلاح کد | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۱۴٫۷ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن | دستیار کدنویسی برای تولید، توضیح و رفع خطا | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | حدود ۳۲٫۵ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن | دستیار کدنویسی با ظرفیت بیشتر برای مسائل دشوار | Apache-2.0 ↗ | |||
| | EmbeddingGemma · Google DeepMind | حدود ۰٫۳ میلیارد اسمی · متراکم شمار کل تأیید نشده | متن ← بردار | ۲٬۰۴۸ توکن | بردارساز چندزبانه کوچک برای اجرا روی دستگاه | gemma ↗ | |||
 | Jina · Jina AI | حدود ۰٫۵۷ میلیارد اسمی · متراکم شمار کل تأیید نشده | متن ← بردار | ۸٬۱۹۲ توکن | بردارساز چندزبانه با آداپترهای وابسته به وظیفه | CC-BY-NC-4.0 ↗ | |||
| | Jina · Jina AI | ۰٫۲۷۸ میلیارد · متراکم | متن ← دادهٔ ساختاریافته | ۱٬۰۲۴ توکن | بازرتبهبند چندزبانه برای اسناد بلندتر | CC-BY-NC-4.0 ↗ | |||
 | Mixedbread · Mixedbread | ۰٫۳۳۵ میلیارد · متراکم | متن ← بردار | ۵۱۲ توکن | بردارساز انگلیسی برای بازیابی با دستور پرسش | Apache-2.0 ↗ | |||
 | Nomic · Nomic AI | ۰٫۱۳۷ میلیارد · متراکم | متن ← بردار | ۸٬۱۹۲ توکن | بردارساز انگلیسی با زمینهٔ بلند و ابعاد قابل کاهش | Apache-2.0 ↗ | |||
 | ModernBERT · Answer.AI / LightOn | ۰٫۱۵ میلیارد · متراکم | متن ← دادهٔ ساختاریافته | ۸٬۱۹۲ توکن | رمزگذار پایه برای آموزش دستهبندی و استخراج موجودیت | Apache-2.0 ↗ | |||
| | Qwen · Qwen | ۱٫۵۴ میلیارد · متراکم | متن ← متن | ۳۲٬۷۶۸ توکن | تکمیل کد و پرکردن جای خالی | apache-2.0 ↗ | |||
 | StarCoder2 · bigcode | ۳ میلیارد · متراکم | متن ← متن | ۱۶٬۳۸۴ توکن توجه محلی با پنجرهٔ ۴٬۰۹۶ توکنی. | تکمیل کد با پنجرهٔ لغزان | bigcode-openrail-m ↗ | |||
| | Qwen · Qwen | ۸۰ میلیارد · ۳ میلیارد فعال · ترکیب متخصصان (MoE) · توجه ترکیبی | متن ← متن | ۲۶۲٬۱۴۴ توکن | عامل برنامهنویسی | apache-2.0 ↗ | |||
| | E5 · intfloat | ۰٫۵۶ میلیارد · متراکم | متن ← بردار | ۵۱۲ توکن | بازیابی چندزبانه با دستور وظیفه | mit ↗ | |||
| | Qwen · Qwen | ۴ میلیارد · متراکم | متن ← متن | ۲۶۲٬۱۴۴ توکن | دستیار کوچک با پاسخ مستقیم | apache-2.0 ↗ | |||
 | Tooka · PartAI | ۰٫۱۲۳ میلیارد · متراکم | متن ← بردار | ۵۱۲ توکن | بردارسازی متن فارسی | — | |||
| | Tooka · PartAI | ۰٫۳۵۳ میلیارد · متراکم | متن ← بردار | ۵۱۲ توکن | بردارسازی متن فارسی | — | |||
 | ParsBERT · HooshvareLab | متراکم شمار پارامتر ثبت نشده | متن ← دادهٔ ساختاریافته | ۵۱۲ توکن | پایهٔ آموزش وظایف فارسی | — | |||
 | Salamandra · BSC-LT | ۲٫۲۵۳ میلیارد · متراکم | متن ← متن | ۸٬۱۹۲ توکن | تولید متن به زبانهای ایبری | Apache-2.0 ↗ | |||
| | Salamandra · BSC-LT | ۷٫۷۶۸ میلیارد · متراکم | متن ← متن | ۸٬۱۹۲ توکن | تولید متن به زبانهای ایبری | Apache-2.0 ↗ | |||
 | MiniCPM · openbmb | ۲٫۵۱۷ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | استدلال با مدل کوچک | Apache-2.0 ↗ | |||
 | LFM · LiquidAI | ۱٫۱۷ میلیارد · ترکیبی | متن ← متن | ۳۲٬۷۶۸ توکن | استخراج اطلاعات روی دستگاه | LFM Open License 1.0 ↗ | |||
| | Granite · ibm-granite | ۳٫۶۶ میلیارد · متراکم | متن ← متن | ۱۳۱٬۰۷۲ توکن | استدلال با مدل کوچک | Apache-2.0 ↗ | |||
| | GLM · Z.ai | ۷۴۴ میلیارد · ۴۰ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | ۲۰۲٬۷۵۲ توکن | کدنویسی و استفاده از ابزار | MIT ↗ | |||
| | GLM · Z.ai | ۷۵۳٫۸۶۴ میلیارد عنصر در فایل وزن · ترکیب متخصصان (MoE) شمار ذخیرهشده در checkpoint؛ شامل مؤلفههای اضافی، نه شمار فعال در تولید هر توکن. | متن ← متن | ۲۰۲٬۷۵۲ توکن | کدنویسی و استفاده از ابزار | MIT ↗ | |||
| | GLM · Z.ai | ۷۵۳٫۳۳ میلیارد عنصر در فایل وزن · ترکیب متخصصان (MoE) شمار ذخیرهشده در checkpoint؛ شامل مؤلفههای اضافی، نه شمار فعال در تولید هر توکن. | متن ← متن | ۱٬۰۴۸٬۵۷۶ توکن | کدنویسی و استفاده از ابزار | MIT ↗ | |||
| | GLM · Z.ai | ترکیب متخصصان (MoE) شمار پارامتر ثبت نشده | متن ← متن | ۱٬۰۴۸٬۵۷۶ توکن | کدنویسی و استفاده از ابزار | GLM-5.3 License ↗ | |||
| | Kimi · Moonshot AI | ۱٬۰۰۰ میلیارد · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | کدنویسی و استفاده از ابزار | Modified MIT ↗ | |||
| | Kimi · Moonshot AI | ۱٬۰۰۰ میلیارد · ۳۲ میلیارد فعال · ترکیب متخصصان (MoE) | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن | کدنویسی و استفاده از ابزار | Modified MIT ↗ | |||
| | Kimi · Moonshot AI | ۲٬۸۰۰ میلیارد · ۱۰۴ میلیارد فعال · ترکیب متخصصان (MoE) | متن، تصویر، ویدیو ← متن | ۱٬۰۴۸٬۵۷۶ توکن | کدنویسی و استفاده از ابزار | Kimi K3 License ↗ | |||
| | Qwen · Qwen | ۲ میلیارد · متراکم | متن، تصویر، ویدیو ← بردار | ۳۲٬۷۶۸ توکن | بازیابی چندوجهی | Apache-2.0 ↗ | |||
| | Qwen · Qwen | ۸ میلیارد · متراکم | متن، تصویر، ویدیو ← بردار | ۳۲٬۷۶۸ توکن | بازیابی چندوجهی | Apache-2.0 ↗ | |||
| | Qwen · Qwen | ۲ میلیارد · متراکم | متن، تصویر، ویدیو ← دادهٔ ساختاریافته | ۳۲٬۷۶۸ توکن | بازرتبهبندی چندوجهی | Apache-2.0 ↗ | |||
| | Qwen · Qwen | ۸ میلیارد · متراکم | متن، تصویر، ویدیو ← دادهٔ ساختاریافته | ۳۲٬۷۶۸ توکن | بازرتبهبندی چندوجهی | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | ۲۷٫۷۸۱ میلیارد · حدود ۲۷ میلیارد جزء زبانی؛ شمار گردشدهٔ ناشر · متراکم · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با نیازمند تنظیم YaRN؛ سقف بومی ۲۶۲٬۱۴۴ توکن است. | مدل متن و تصویر با توجه ترکیبی | Apache-2.0 ↗ | |||
| | Qwen · Qwen / Alibaba Cloud | ۳۵٫۹۵۲ میلیارد · ۳ میلیارد فعال · حدود ۳۵ میلیارد جزء زبانی؛ شمار گردشدهٔ ناشر · ترکیب متخصصان (MoE) · توجه ترکیبی | متن، تصویر، ویدیو ← متن | ۲۶۲٬۱۴۴ توکن تا ۱٬۰۱۰٬۰۰۰ توکن با نیازمند تنظیم YaRN؛ سقف بومی ۲۶۲٬۱۴۴ توکن است. | مدل متن و تصویر با توجه ترکیبی | Apache-2.0 ↗ | |||
| HY-MT · Tencent | ۱٫۸ میلیارد · متراکم | متن ← متن | — | ترجمهٔ تخصصی متن | Tencent HY Community License ↗ | ||||
| HY-MT · Tencent | ۷ میلیارد · متراکم | متن ← متن | — | ترجمهٔ تخصصی متن | Tencent HY Community License ↗ | ||||
| HY-MT · Tencent | ۱٫۸ میلیارد · متراکم | متن ← متن | — | ترجمهٔ تخصصی | Apache-2.0 ↗ | ||||
| HY-MT · Tencent | ۷ میلیارد · متراکم | متن ← متن | — | ترجمهٔ تخصصی | Apache-2.0 ↗ | ||||
| HY-MT · Tencent | ۳۰ میلیارد · ۳ میلیارد فعال · ترکیب متخصصان (MoE) | متن ← متن | — | ترجمهٔ تخصصی | Apache-2.0 ↗ | ||||
| | Gemma · Google | ۴ میلیارد · متراکم | متن، تصویر ← متن | — | ترجمهٔ تخصصی | Gemma terms ↗ | |||
| | Gemma · Google | ۱۲ میلیارد · متراکم | متن، تصویر ← متن | — | ترجمهٔ تخصصی | Gemma terms ↗ | |||
| | Gemma · Google | ۲۷ میلیارد · متراکم | متن، تصویر ← متن | — | ترجمهٔ تخصصی | Gemma terms ↗ | |||
| MADLAD · Google | ۳ میلیارد · متراکم | متن ← متن | — | ترجمهٔ تخصصی | Apache-2.0 ↗ | ||||
| NLLB · Meta | ۰٫۶ میلیارد · متراکم | متن ← متن | — | ترجمهٔ تخصصی | CC-BY-NC-4.0 ↗ | ||||
| | Qwen-Image · Qwen / Alibaba | حدود ۷ میلیارد مولد تصویر DiT · حدود ۸ میلیارد رمزگذار Qwen3-VL · سایر شمار کل تأیید نشده | متن، تصویر ← تصویر | — | ساخت و ویرایش تصویر | Qwen Research License — غیرتجاری ↗ | |||
 | MiMo · Xiaomi MiMo | ۱٬۰۲۰ میلیارد · ۴۲ میلیارد فعال · ترکیب متخصصان (MoE) · توجه ترکیبی | متن، تصویر، ویدیو، صوت ← متن | ۱٬۰۴۸٬۵۷۶ توکن | کدنویسی، عاملهای نرمافزاری و تحلیل متن و تصویر | MIT ↗ |
«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.
برای RAG، نقش بازیابی، بازرتبهبندی و تولید پاسخ را جدا بررسی کنید.
نمای دادهای
تناسب مدل با کاربرد
مدل مناسب برای گفتوگو، برنامهنویسی، جستوجو و کار با اسناد.
آزمونِ ستون نتیجه: MIRACL · nDCG@10 · fa
این انتخاب برای ستون نتیجهٔ همهٔ جدولهاست. شرایط اجرا در جزئیات هر مدل آمده است.
دیدن نتایج به تفکیک آزمون ←کدام مدل برای کار من مناسب است؟
نقطهٔ شروع بر پایهٔ مستندات؛ رتبهبندی کیفیت نیست.
شروع انتخاب برای بازیابی فارسی
E5 در MIRACL فارسی و Tooka/Jina در PTEB ارزیابی شدهاند. MIRACL کیفیت بازیابی سند را میسنجد؛ PTEB چند وظیفه را پوشش میدهد و امتیاز کل آن با نتیجهٔ بازیابی یکسان نیست.
برای جستوجوی متن فارسی، با ثبت طول قطعه و پیشوند صحیح هر مدل؛ برای Tooka پرسش با «سوال: » و سند با «متن: » طبق کارت ناشر.
میانگین بالاتر Tooka-Large به معنی بازیابی بهتر از Small نیست.
بازیابی برای اسپانیایی
E5-Small خط پایهٔ کمحجمتری است؛ Large-Instruct در همین گزارش MIRACL اسپانیایی امتیاز بالاتری دارد. شواهد Qwen در این مقایسه تجمیعی و چندزبانهاند، نه مختص اسپانیایی.
پرسش و سند هر دو اسپانیایی باشند؛ بازیابی میانزبانی را جداگانه مشخص کنید.
اختلاف 51.2 تا 53.7 شواهدی برای کیفیت پاسخ نهایی چت یا پوشش تمام گونههای اسپانیایی نیست.
بازیابی برای انگلیسی
Large و Large-Instruct را گونههای مجزا بگیرید: در MIRACL انگلیسی امتیاز Large بالاتر است. برای افزودن reranker، مقایسهٔ Qwen با نامزدهای یکسان قابل استفاده است.
وقتی شواهد تکزبانه مهمتر از میانگین چندزبانه است.
واژهٔ Instruct تضمین برتری در همهٔ وظایف نیست.
افزودن مرحلهٔ بازچینی
از 0.6B بهعنوان گزینهٔ کوچکتر مقایسه شروع کنید. اگر افزایش کیفیتِ همان وظیفه ارزش هزینهٔ مرحلهٔ دوم را داشت، 4B و 8B را بررسی کنید؛ در همهٔ معیارها 8B جلوتر نیست.
وقتی سند مرتبط در نامزدهای مرحلهٔ اول هست ولی رتبهٔ خوبی ندارد؛ تعداد نامزدها بخشی از تصمیم است.
بازچینی سندی را که بازیاب وارد مجموعه نکرده بازیابی نمیکند.
حل مسئله یا ویرایش کد؟
برای دستیار دستورپذیر، معیارهای ویرایش مخزن و حل مسئله را جدا مقایسه کنید. StarCoder2-3B برای تکمیل کد/FIM است؛ HumanEval کیفیت گفتوگو یا عامل ویرایشگر را نمیسنجد.
وقتی رابط و وظیفه مشخص است: تکمیل داخل ادیتور، اصلاح چند فایل یا حل یک مسئله.
پارامتر فعال MoE مبنای حافظهٔ وزنهای مقیم نیست.
مدل کوچک برای کار محدود
LFM گزینهای کوچک برای استخراج و گردشکار محدود است؛ MiniCPM و Granite برای بررسی استدلال و ابزار نیز شواهد دارند. حجم واقعی وزنها ممکن است با عدد گردشدهٔ نام مدل متفاوت باشد.
وقتی دامنهٔ وظیفه، قالب خروجی و محدودیت حافظه روشن است.
امتیاز بالای یک مدل کوچک، تأخیر کمتر یا توان اجرای زمینهٔ حداکثری روی لپتاپ را ثابت نمیکند.
تشخیص نیت و دستهبندی
برای دستهبندی نیت، شواهد MassiveIntent و MTOP را انتخاب کنید. embedding بخشی از سامانهٔ دستهبندی است؛ امتیاز به روش طبقهبندی و دادهٔ آموزش آن هم وابسته است.
برای برچسبهای محدود و مشخص؛ این داده انتخاب نقطهٔ شروع را پشتیبانی میکند.
مدل embedding یا ParsBERT بدون سرِ وظیفه، چتبات آماده نیست.
aya-expanse-8bپوشش اعلامی ۲۳ زبان، از جمله فارسی و اسپانیایی؛ زمینهٔ ۸٬۱۹۲ توکن و مجوز عمومی غیرتجاری.
fa: اعلام ناشرaya-expanse-8b — model card · گزارش ناشر
https://huggingface.co/CohereLabs/aya-expanse-8b ↗- ناشر / نویسنده
- Cohere Labs
- تاریخ دسترسی
- 2026-09-15
- بخش مرتبط در منبع
- README.md: model description / architecture / intended use; matching lines 14, 27, 116, 124, 143
- اعداد پارامتر معرفی مدل، گردشدهاند؛ safetensors.total شمار عناصر ذخیرهشده است و الزاماً پارامتر یکتا نیست.
- کارت عمومی در تاریخ دسترسی خوانده شده؛ متن کارت به commit وزنها پین نشده است.
aya-expanse-8b — Hub metadata · گزارش ناشر
https://huggingface.co/api/models/CohereLabs/aya-expanse-8b?blobs=true ↗- ناشر / نویسنده
- Cohere Labs
- تاریخ دسترسی
- 2026-09-15
- نسخه / commit
- 5062468bf9bc0c6035fd64e06274333ec127d980
- بخش مرتبط در منبع
- $.sha; $.id; $.pipeline_tag; $.cardData; $.safetensors; $.siblings
- فهرست فایل و شمار tensorها معادل حافظهٔ اجرا یا شمار پارامتر یکتا نیست.
aya-expanse-8b — parameter specification · گزارش ناشر
https://huggingface.co/CohereLabs/aya-expanse-8b ↗- ناشر / نویسنده
- Cohere Labs
- تاریخ دسترسی
- 2026-09-15
- بخش مرتبط در منبع
- README.md: parameter count / named model variant; matching lines 27, 65
- اعداد پارامتر معرفی مدل، گردشدهاند؛ safetensors.total شمار عناصر ذخیرهشده است و الزاماً پارامتر یکتا نیست.
- کارت عمومی در تاریخ دسترسی خوانده شده؛ متن کارت به commit وزنها پین نشده است.
aya-expanse-8b — license declaration · گزارش ناشر
https://huggingface.co/CohereLabs/aya-expanse-8b ↗- ناشر / نویسنده
- Cohere Labs
- تاریخ دسترسی
- 2026-09-15
- بخش مرتبط در منبع
- README.md: license / underlying-model terms; Hub $.cardData.license; matching lines 1, 23, 167
aya-expanse-8b — context declaration · گزارش ناشر
https://huggingface.co/CohereLabs/aya-expanse-8b ↗- ناشر / نویسنده
- Cohere Labs
- تاریخ دسترسی
- 2026-09-15
- بخش مرتبط در منبع
- README.md: context length / model specification / usage limits; matching lines 128
- CohereLabs/aya-expanse-8b؛ طول زمینهٔ اعلامشده، جدا از مقدار پیکربندی و طول آزمودهشده.
- KV cache، توکن تصویر و خروجی تولیدی نیز باید در سناریوی واقعی حساب شوند.
Aya Expanse release · گزارش ناشر
https://cohere.com/blog/aya-expanse-connecting-our-world ↗- ناشر / نویسنده
- Cohere
- تاریخ دسترسی
- 2026-09-15
- بخش مرتبط در منبع
- October 24 2024; 8B and 32B downloadable models
- تاریخ انتشار گونههای نامبرده؛ تاریخ ساخت مخزن یا برداشت داده نیست.
CohereLabs/aya-expanse-8b — model card · گزارش ناشر
https://huggingface.co/CohereLabs/aya-expanse-8b ↗- ناشر / نویسنده
- Cohere Labs
- تاریخ دسترسی
- 2026-09-15
- بخش مرتبط در منبع
- Description; model details; usage
CohereLabs/aya-expanse-8b — repository metadata · گزارش ناشر
https://huggingface.co/api/models/CohereLabs/aya-expanse-8b?blobs=true ↗- ناشر / نویسنده
- Cohere Labs
- تاریخ دسترسی
- 2026-09-15
- بخش مرتبط در منبع
- cardData; sha; safetensors; siblings
۱۱۷ نتیجه از ۱۱۷ ردیف
فیلترهای تخصصی ۳ کنترل
همهٔ ردیفها
مقایسهٔ ردیفها و شرایط آن
قاعدهٔ مقایسه: محور مدل میتواند متفاوت باشد؛ کاربرد، زبان، داده، نسخهٔ آزمون، معیار و واحد باید کنترل یا افشا شوند.
| مقایسه | جزئیات | نقش در سامانه | کاربرد اصلی | ویژگی و دلیل بررسی | شرط مهم استفاده | مبنای پیشنهاد | شروع کار | |
|---|---|---|---|---|---|---|---|---|
| | بازیابی سند | بازیابی ترکیبی سند در RAG | سه خروجی متراکم، تنک و چندبرداری در یک مدل؛ بیش از ۱۰۰ زبان، ورودی ۸٬۱۹۲ توکن و بردار متراکم ۱٬۰۲۴بُعدی. | برای استفادهٔ همزمان از هر سه خروجی، مسیر FlagEmbedding را انتخاب کنید؛ خروجی بستهٔ GGUF یا Ollama به backend بستگی دارد. | پیشنهاد تحلیلی راهنما | |||
| | بازرتبهبندی سند | مرتبکردن دوبارهٔ اسناد بازیابیشده | پرسش و سند را با هم میخواند و امتیاز ارتباط میدهد؛ مکمل مرحلهٔ بازیابی BGE-M3 است. | ابتدا تعداد محدودی سند بازیابی کنید؛ امتیاز sigmoid احتمال درستی پاسخ نیست و خروجی مدل، embedding نیست. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته | نگارش و گفتوگوی چندزبانه با اسناد بلند | نسخهٔ ۳۲میلیاردی Aya Expanse با زمینهٔ ۱۳۱٬۰۷۲ توکن؛ فارسی در فهرست ۲۳ زبان ناشر آمده است. | دقت پاسخ در ورودی بلند را با پرسشهایی از ابتدا، میانه و انتهای سند بسنجید. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته | دستیار نوشتن و بازنویسی چندزبانه | نسخهٔ ۸میلیاردی Aya Expanse، با زمینهٔ ۸٬۱۹۲ توکن و آموزش ترجیحات چندزبانه، برای آزمایش نگارش فارسی نیز قابل بررسی است. | نتایج نسخهٔ ۸ میلیاردی را جدا از نسخهٔ ۳۲ میلیاردی مقایسه کنید؛ سقف ورودی این دو یکسان نیست. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | گفتوگوی محلی در زبانهای گوناگون | شاخهٔ Global از Tiny Aya برای پوشش عمومی زبانها عرضه شده؛ با نسخههای منطقهای Earth،Fire و Water یکی نیست. | برای کاربرد فارسی نمونههای خود را ارزیابی کنید؛ نسخهٔ منطقهای یا مدل پایه را جایگزین بیبررسی این checkpoint نکنید. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | نمونهسازی دستیار کوچک با فراخوانی تابع | بزرگترین نسخهٔ SmolLM2 در این فهرست، علاوه بر پیروی از دستور، قالب فراخوانی تابع دارد؛ این ویژگی به دو نسخهٔ کوچکتر تعمیم ندارد. | مدل عمدتاً انگلیسی است؛ اجرای تابع را برنامهٔ میزبان انجام میدهد و باید آرگومانها را اعتبارسنجی کند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته | آزمایش پیروی از دستور با مدل بسیار کوچک | نسخهٔ ۱۳۵میلیونپارامتری SmolLM2 برای نمونهسازی سادهٔ تولید متن و بررسی محدودیت مدلهای کمحجم مناسب است. | دامنهٔ کار را به متن کوتاه و وظیفهٔ محدود ببندید؛ از آن انتظار دانش گسترده یا ابزارخوانی نسخهٔ ۱٫۷میلیاردی نداشته باشید. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته | بازنویسی و خلاصهسازی متن کوتاه | نسخهٔ ۳۶۰میلیونپارامتری SmolLM2 با SFT و DPO برای دستورپذیری تنظیم شده و نمونهٔ اجرای CPU در کارت مدل دارد. | تمرکز زبانی انگلیسی است؛ سرعت یا کیفیت فارسی از کوچکبودن مدل نتیجه نمیشود. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | دستیار کوچک با انتخاب حالت فکرکردن | SmolLM3 سهمیلیاردی دو حالت پاسخ مستقیم و استدلال دارد؛ زمینهٔ آموزش ۶۵٬۵۳۶ توکن است و جزئیات آموزش منتشر شدهاند. | برای زمینهٔ بلندتر تنظیم YaRN لازم است. متن کارت شش زبان بومی از جمله آلمانی را نام میبرد، اما برچسبهای مخزن هشت زبان متفاوت دارند؛ فارسی در هیچیک نیست. Transformers نسخهٔ ۴٫۵۳ یا بالاتر لازم است.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | نمونهسازی گفتوگو با کوچکترین Qwen3 | نسخهٔ متراکم ۰٫۶میلیاردی Qwen3 هر دو حالت thinking و non-thinking را دارد؛ فایل رسمی Q8_0 نیز موجود است. | بودجهٔ خروجی را محدود کنید؛ توانایی حل مسئلهٔ نسخههای بزرگتر از نام مشترک خانواده استنتاج نمیشود.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | دستیار متنی کوچک با کنترل استدلال | Qwen3-1.7B میان گزینههای زیر دو میلیارد پارامتر این فهرست قرار میگیرد؛ حالت پاسخ مستقیم را میتوان از قالب پیام انتخاب کرد. | در حالت thinking، توکنهای استدلال نیز جزو هزینه و طول خروجیاند؛ GGUF رسمی این رکورد Q8_0 است.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | تولید و تحلیل متن با Qwen3 متراکم | Qwen3-14B یک مدل متراکم با دو حالت پاسخ است؛ نسخههای رسمی GGUF برای انتخاب دقت وزن در دسترساند. | بستههای Q4_K_M و Q8_0 در دسترساند؛ سرعت و کیفیت آنها در این راهنما آزموده نشده است.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی | دستیار ابزارمحور با معماری MoE | Qwen3-30B-A3B از خبرگان انتخابی استفاده میکند و از الگوی Qwen-Agent برای اتصال ابزارها بهره میبرد. | شمار پارامتر فعال، جای حجم کل وزن را در برآورد حافظه نمیگیرد؛ مدل باید با قالب پیام و parser سازگار اجرا شود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، برنامهنویسی، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، فراخوانی ابزار | تحلیل چندمرحلهای با نسخهٔ متراکم بزرگ Qwen3 | Qwen3-32B برخلاف نسخهٔ 30B-A3B معماری متراکم دارد؛ حالت استدلال را میتوان متناسب با پیچیدگی پرسش تنظیم کرد. | برای مقایسهٔ پاسخ مستقیم و thinking، طول خروجی و شرایط یکسان نگه داشته شود؛ این معرفی رتبهٔ کیفیت نیست.، این مدل عمومی است؛ مدل اختصاصی Coder قالب ابزار و آموزش متفاوت دارد.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | دستیار عمومی در اندازهٔ چهار میلیارد | Qwen3-4B امکان تغییر حالت thinking را در یک checkpoint ارائه میکند؛ GGUF رسمی با چند روش کوانت دارد. | زمینهٔ بومی ۳۲٬۷۶۸ توکن است؛ افزایش آن به تنظیمات توسعهٔ زمینه وابسته است.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | گفتوگو و کار با متن با کنترل فکرکردن | Qwen3-8B مدل عمومی متراکم با ۸٫۲میلیارد پارامتر اعلامشده است؛ پاسخ مستقیم و reasoning را در قالب پیام انتخاب میکنید. | برای شروع محلی، فایلهای رسمی Q4_K_M و Q8_0 موجودند؛ کیفیت یا حافظهٔ اجرای آنها در این راهنما اندازهگیری نشده است.، بازیابی، درج سند و بررسی استنادها بر عهدهٔ سامانه است؛ این رابطه بنچمارک RAG یا فارسی نیست.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | برنامهنویسی، فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال | اصلاح مخزن کد با دستیار ابزارمحور | Qwen3-Coder-30B-A3B-Instruct برای تولید کد، ویرایش مخزن و گردشکار عامل برنامهنویسی تنظیم شده؛ زمینهٔ بومی ۲۶۲٬۱۴۴ توکن دارد. | این نسخه non-thinking است؛ قالب فراخوانی ابزار مخصوص Coder را رعایت کنید و آن را با Qwen3-30B-A3B عمومی یکی نگیرید.، ابزارهای فایل، آزمون و اجرا در برنامهٔ میزبان فراهم میشوند.، این checkpoint فقط پاسخ مستقیم تولید میکند؛ حالت thinking جداگانه ندارد. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بازیابی برداری با کوچکترین Qwen3 Embedding | نسخهٔ ۰٫۶میلیاردی، embedding دستورپذیر با حداکثر ۱٬۰۲۴ بُعد و ورودی ۳۲٬۷۶۸ توکن تولید میکند. | دستور وظیفه را به query اضافه کنید؛ سندها باید با همان مدل و تنظیم ابعاد نمایهسازی شوند. | پیشنهاد تحلیلی راهنما | |||
| | بازیابی سند | نمایهسازی چندزبانه با بردار قابل تنظیم | Qwen3-Embedding-4B خروجی تا ۲٬۵۶۰ بُعد دارد و برای تطبیق بردار با وظیفه از دستور query استفاده میکند. | کاهش بُعد نیازمند آزمون کیفیت بازیابی روی مجموعهٔ واقعی شماست؛ عدد MTEB جانشین این آزمون نیست. | پیشنهاد تحلیلی راهنما | |||
| | بازیابی سند | بازیابی سند با بزرگترین Qwen3 Embedding فهرست | Qwen3-Embedding-8B تا ۴٬۰۹۶ بُعد و زمینهٔ ۳۲٬۷۶۸ توکن دارد؛ ورودی آن متن و خروجی آن بردار است. | هزینهٔ نمایهسازی و ذخیرهٔ بردار را جدا از هزینهٔ پاسخ مدل مولد حساب کنید؛ این مدل پاسخ نهایی نمینویسد. | پیشنهاد تحلیلی راهنما | |||
| | بازرتبهبندی سند | بازرتبهبندی سبکتر در خانوادهٔ Qwen3 | نسخهٔ ۰٫۶میلیاردی Qwen3-Reranker برای امتیازدادن به ارتباط query و document با دستور وظیفه تنظیم شده است. | قالب مخصوص reranker و امتیاز yes/no لازم است؛ از مسیر chat یا تولید embedding استفاده نکنید. | پیشنهاد تحلیلی راهنما | |||
| | بازرتبهبندی سند | بازرتبهبندی دستورپذیر اسناد نامزد | Qwen3-Reranker-4B گزینهٔ میانی این خانواده است؛ پرسش، دستور بازیابی و متن سند در محاسبهٔ ارتباط شرکت دارند. | فقط اسناد نامزد را به این مرحله بدهید؛ افزایش تعداد جفتهای پرسش–سند هزینهٔ مرحلهٔ دوم را بالا میبرد. | پیشنهاد تحلیلی راهنما | |||
| | بازرتبهبندی سند | بازرتبهبندی با نسخهٔ هشتمیلیاردی Qwen3 | Qwen3-Reranker-8B بزرگترین بازرتبهبند این مجموعه است؛ به جفت پرسش و سند امتیاز ارتباط میدهد. | برای انتخاب در برابر نسخهٔ ۴میلیاردی، کیفیت جستوجو و زمان روی اسناد خودتان را بسنجید؛ از اندازه رتبه نسازید. | پیشنهاد تحلیلی راهنما | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | خواندن تصویر و سند با Qwen3-VL | نسخهٔ Instruct هشتمیلیاردی Qwen3-VL ورودی متن، تصویر و ویدئو را برای درک بصری و کار با سند ترکیب میکند. | از processor و قالب پیام چندوجهی استفاده کنید؛ checkpointهای Thinking و Instruct رفتار یکسان ندارند. | پیشنهاد تحلیلی راهنما | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | نمونهسازی چندوجهی با Qwen3.5 کوچک | Qwen3.5-2B کوچک برای نمونهسازی و تنظیم دقیق وظیفهمحور معرفی شده؛ ورودی بصری را همراه متن میپذیرد. | کیفیت نسخههای بزرگتر خانواده به این مدل دوملیاردی تعمیم داده نمیشود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی | عامل چندوجهی با Qwen3.5 از نوع MoE | نسخهٔ 35B-A3B از پایهٔ یکپارچهٔ متن و تصویر و معماری ترکیبی بهره میبرد و برای گردشکار چندمرحلهای قابل بررسی است. | سرویس میزبانیشدهٔ Qwen3.5-Flash با ابزارها و زمینهٔ پیشفرض متفاوت عرضه میشود؛ مشخصات API را به وزن محلی تعمیم ندهید.، تنظیمات چندوجهی و محدودیت تصویر را از راهنمای همین وزن بخوانید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | پردازش متن و تصویر در اندازهٔ چهار میلیارد | Qwen3.5-4B از نسل متن–تصویر یکپارچه است؛ برای آزمودن استخراج اطلاعات از سند در اندازهای کوچکتر از 9B قابل بررسی است. | برای سند اسکنشده به مسیر چندوجهی نیاز دارید؛ سقف زمینهٔ متنی، تعداد تصاویر قابل پردازش را تعیین نمیکند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | دستیار اسناد و تصویر با Qwen3.5 متراکم | نسخهٔ 9B از Qwen3.5 ترکیب متن و تصویر را در معماری متراکم این خانواده عرضه میکند. | مقایسه با 4B باید بر دادهٔ سند یکسان و تنظیم تصویر یکسان باشد؛ شمار پارامترهای بخش زبان و بینایی را جدا بخوانید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی | گردشکار طولانی با عامل متن–تصویر | Qwen3.8-27B مدل متراکم متن–تصویر با کنترل thinking است؛ تمرکز معرفی آن بر کدنویسی، پژوهش و کارهای چندمرحلهای است. | قابلیتهای وعدهدادهشدهٔ سرویس ابری، مانند ابزارهای داخلی و زمینهٔ پیشفرض، جزء تضمین وزن محلی نیستند.، اندازهٔ تصویر و شیوهٔ نمونهبرداری فریمها بخشی از شرایط استفادهاند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | پژوهش دستورپذیری با مسیر آموزش قابل بررسی | Olmo 3 7B Instruct با دادههای Dolma 3 و Dolci عرضه شده و انتشار جزئیات آموزش، آن را برای پژوهش بازتولیدپذیر متمایز میکند. | این checkpoint از نوع Instruct است؛ نتایج Olmo Think را به آن نسبت ندهید. Transformers نسخهٔ ۴٫۵۷ یا بالاتر لازم است. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | آزمایش استدلال تقطیرشده از R1-0528 | این مدل از پسآموزش Qwen3-8B-Base با زنجیرههای استدلال DeepSeek-R1-0528 به دست آمده؛ با Qwen3-8B معمولی متفاوت است. | بنچمارکهای مدل کامل R1-0528 متعلق به این نسخهٔ هشتمیلیاردی نیستند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | استدلال تقطیرشده روی پایهٔ Llama 70B | این checkpoint مسیر تقطیر R1 را روی پایهٔ Llama اجرا میکند و بزرگترین نسخهٔ تقطیری این فهرست است. | حجم وزن و طول زنجیرهٔ فکر را جداگانه برآورد کنید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | آزمایش مرز استدلال در مدل تقطیری بسیار کوچک | نسخهٔ ۱٫۵میلیاردی از تقطیر R1 روی Qwen2.5-Math ساخته شده و برای بررسی انتقال رفتار استدلال به مدل کوچک جالب است. | پاسخهای طولانی ممکن است وارد تکرار شوند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | حل مسئله با تقطیر R1 در اندازهٔ میانی | DeepSeek-R1-Distill-Qwen-14B از Qwen2.5-14B و دادهٔ تولیدی R1 استفاده میکند؛ وزن آن متعلق به مدل کامل R1 نیست. | اعداد گزارششده فقط برای همین نسخه و تنظیمات آزمون معتبرند؛ از مقایسهٔ نامتجانس با پاسخ مستقیم پرهیز کنید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | تحلیل و کدنویسی با تقطیر متراکم ۳۲میلیاردی | نسخهٔ Qwen-32B مسیر تقطیر R1 را روی پایهٔ Qwen2.5 دنبال میکند. | توان استدلال اعلامشده، ابزارخوانی یا اجرای کد خودکار نیست؛ ابزار و اعتبارسنجی جواب باید در برنامه فراهم شود.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | حل مسئله با نسخهٔ هفتمیلیاردی تقطیر R1 | این مدل از Qwen2.5-Math-7B بهعنوان پایه استفاده میکند؛ با تقطیر جدیدتر R1-0528 روی Qwen3 یکی نیست. | قالب و tokenizer همین مخزن را نگه دارید؛ مقایسه با نسخهٔ هشتمیلیاردی نیازمند آزمون مشترک است.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی | پیوند استدلال و ابزار در گردشکار عامل | DeepSeek-V3.2 توجه تنک DSA و پسآموزش عاملمحور را ترکیب میکند؛ قالب چت آن نسبت به نسخههای پیشین تغییر کرده است. | از قالب و مسیر اجرای مخصوص V3.2 استفاده کنید؛ نتایج نسخهٔ Speciale در پروندهٔ این مدل قابل انتقال نیستند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی | عامل چندوجهی برای ورودیهای بسیار بلند | DeepSeek-V4.1-Flash متن و تصویر را در معماری CED پردازش میکند؛ شمار پارامتر فعال در prefill و decode متفاوت است. | پارامتر فعال را یک عدد ثابت فرض نکنید؛ فشردهسازی KV و مسیر اجرای ویژه، بخشی از معماری این نسخهاند.، مسیر اجرای ویژهٔ CED را رعایت کنید؛ این رابطه، نتیجهٔ ارزیابی OCR نیست.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | پرسش از تصویر و متن با Gemma 3 میانی | Gemma 3 12B IT نسخهٔ دستورپذیر چندوجهی با زمینهٔ ۱۳۱٬۰۷۲ توکن است؛ ورودی تصویر را به پاسخ متنی پیوند میدهد. | Processor بینایی و قالب Gemma 3 لازم است؛ حداکثر زمینه به معنی کیفیت ثابت فهم سند بلند نیست. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | دستیار متنی کوچک از خانوادهٔ Gemma 3 | Gemma 3 1B IT برخلاف نسخههای بزرگتر این نسل فقط متن میگیرد و زمینهٔ ۳۲٬۷۶۸ توکن دارد. | برای تصویر اسکنشده ابتدا OCR بیرونی لازم است؛ ویژگی چندوجهی 4B و بالاتر را به این نسخه تعمیم ندهید. | پیشنهاد تحلیلی راهنما | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | درک متن و تصویر با بزرگترین Gemma 3 فهرست | Gemma 3 27B IT نسخهٔ متراکم بزرگ این نسل با ورودی بصری و پوشش چندزبانه است. | برای ورودی تصویری، قالب پیام و پردازشگر Gemma 3 لازم است. | پیشنهاد تحلیلی راهنما | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | ورود به پردازش تصویر در خانوادهٔ Gemma 3 | Gemma 3 4B IT کوچکترین مدل چندوجهی این نسل در فهرست است؛ برخلاف 1B میتواند تصویر را همراه متن بخواند. | وزن و processor نسخهٔ 4B را با هم دریافت کنید؛ متن خروجی را برای استخراج دقیق اعداد سند اعتبارسنجی کنید. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | استدلال چندوجهی با Gemma 4 از نوع MoE | Gemma 4 26B-A4B مدل خبرگانی با کنترل thinking و زمینهٔ ۲۶۲٬۱۴۴ توکن است؛ با نسخهٔ کوچک E2B معماری یکسانی ندارد. | این نسخه ورودی صوت ندارد؛ شمار پارامتر فعال با کل وزنهای مدل متفاوت است.، مسیر processor تصویر لازم است؛ قابلیت صوت E2B به این مدل تعمیم داده نشده است.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | پردازش محلی متن، تصویر و صوت با Gemma 4 کوچک | Gemma 4 E2B برای اجرای روی دستگاه معرفی شده و ورودی صوت را نیز پشتیبانی میکند؛ E2B شمار مؤثر است، نه کل وزنها. | در محاسبهٔ حافظه از شمار کل و فایل واقعی استفاده کنید؛ مسیر صوت و تصویر به processor متناظر نیاز دارد.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید پاسخ از سند، استخراج ساختیافته، تولید متن، برنامهنویسی، فراخوانی ابزار | تولید پاسخ از اسناد بازیابیشده | Granite 3.3 2B Instruct مدل کوچک کسبوکارمحور با RAG، خلاصهسازی، استخراج متن و حالت تفکر است. | سند باید توسط سامانه بازیابی و در پیام درج شود؛ خود مدل جای موتور جستوجو نیست و فارسی جزو ۱۲ زبان اعلامشده نیست.، خروجی را با schema برنامه اعتبارسنجی کنید؛ قالب دلخواه بهتنهایی تضمین JSON معتبر نیست. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بازیابی چندزبانه با بردار کمبُعد | Multilingual E5 Small متن را به بردار ۳۸۴بُعدی تبدیل میکند و سقف ورودی آن ۵۱۲ توکن است؛ برای تکههای کوتاه سند قابل بررسی است. | پیشوندهای query: و passage: حتی برای زبانهای غیرانگلیسی لازماند؛ متن بلند را پیش از نمایهسازی قطعهبندی کنید. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | دستیار عمومی با Llama 3.1 بزرگ | Llama 3.1 70B Instruct برای گفتوگوی چندزبانه و کار با متن با زمینهٔ ۱۳۱٬۰۷۲ توکن عرضه شده است. | ورودی این نسخه متن است. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | گفتوگو و کار با متن با Llama 3.1 هشتمیلیاردی | نسخهٔ 8B از Llama 3.1 برای دستیار عمومی و پیروی از دستور تنظیم شده و با مدل پایهٔ همان اندازه فرق دارد. | قالب پیام و tokenizer نسخهٔ Instruct را حفظ کنید؛ زمینهٔ بلند، کیفیت جواب از سند را تضمین نمیکند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | بازنویسی و خلاصهسازی محلی با Llama کوچک | Llama 3.2 1B Instruct مدل متنی کوچک این نسل است؛ برای کارهای محدود روی متن در دستگاههای محلی معرفی شده است. | تصویر را مستقیماً نمیگیرد؛ مدلهای Vision خانوادهٔ Llama 3.2 محصول جداگانهاند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | دستیار متنی روی دستگاه با Llama سهمیلیاردی | Llama 3.2 3B Instruct برای گفتوگو، بازنویسی و خلاصهسازی تنظیم شده و از نسخهٔ 1B ظرفیت پارامتری بیشتری دارد. | تفاوت کیفیت و زمان را روی کار خود بسنجید؛ هیچیک از دو مدل متنی 1B و 3B ورودی تصویر ندارند. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | تحلیل و منطق در محیط محدودتر | Phi-4-mini-instruct با تمرکز بر دادههای استدلالی و پیروی از دستور ساخته شده و زمینهٔ ۱۳۱٬۰۷۲ توکن دارد. | این نسخه با mini-reasoning و multimodal-instruct متفاوت است؛ نمونههای ریاضی یا منطق را با نام دقیق همین نسخه مقایسه کنید. | پیشنهاد تحلیلی راهنما | |||
| | برنامهنویسی، فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، درک تصویر | عامل ویرایش چندفایلی و جستوجوی مخزن | Devstral Small 2 برای مهندسی نرمافزار و استفاده از ابزار برای بررسی و اصلاح کد ساخته شده؛ این نسل ورودی تصویر نیز دارد. | وزن Instruct این مخزن FP8 است؛ قالب Mistral و وابستگیهای اجرای همین نسخه را رعایت کنید، نه تنظیمات عمومی یک مدل چت.، ابزارهای عامل و قالب Mistral باید با نسخهٔ مدل سازگار باشند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | درک تصویر، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | دستیار چندوجهی برای استقرار لبه | Ministral 3 3B Instruct مدل کوچک متن–تصویر این خانواده است؛ بخش زبان ۳٫۴ و رمزگذار تصویر ۰٫۴میلیارد پارامتر دارند. | وزن رسمی FP8 است؛ عدد 3B در نام مدل، همهٔ پارامترهای بخش زبان و بینایی را نمیشمارد. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته | دستیار متنی با قالب فراخوانی تابع Mistral | Mistral 7B Instruct v0.3 tokenizer نسخهٔ سوم و قابلیت فراخوانی تابع را به این مدل متنی اضافه کرده است. | قالب ابزار و tokenizer v3 باید همراه checkpoint باشند؛ ورودی تصویر در این نسخه وجود ندارد. | پیشنهاد تحلیلی راهنما | |||
| | درک تصویر، استخراج ساختیافته، تولید متن، تولید پاسخ از سند، برنامهنویسی، فراخوانی ابزار | دستیار چندزبانهٔ متن و تصویر | Mistral Small 3.1 24B Instruct پردازش تصویر و زمینهٔ بلند را به نسل Small افزوده؛ فارسی در فهرست زبانهای ناشر آمده است. | برای ابزار و خروجی JSON، قالب و parser متناظر لازم است؛ اعداد مدل Base را با Instruct ترکیب نکنید.، parser و اعتبارسنجی schema را در لایهٔ برنامه تنظیم کنید. | پیشنهاد تحلیلی راهنما، کاربرد معرفیشده توسط سازنده | |||
| | تولید پاسخ از سند، تولید متن، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | پاسخ از سند با کنترل بودجهٔ استدلال | Nemotron Nano 9B v2 ترکیبی از Mamba-2 و attention است؛ حالت reasoning و بودجهٔ فکرکردن را میتوان کنترل کرد. | سندهای بازیابیشده باید از بیرون وارد شوند؛ شش زبان اعلامشده شامل فارسی نیستند و backend باید معماری ترکیبی را پشتیبانی کند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال | عامل با استدلال قابل تنظیم در نسخهٔ بزرگ gpt-oss | gpt-oss-120b مدل MoE با ۱۱۷میلیارد پارامتر کل و ۵٫۱میلیارد فعال است؛ وزنهای خبرگان با MXFP4 عرضه شدهاند. | قالب harmony برای اجرای درست لازم است؛ ابزار مرورگر یا Python را برنامهٔ میزبان فراهم میکند و حافظهٔ ادعایی ناشر آزمون این سایت نیست.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | استدلال، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، فراخوانی ابزار | استدلال محلی با نسخهٔ کوچکتر gpt-oss | gpt-oss-20b با ۲۱میلیارد پارامتر کل و ۳٫۶میلیارد فعال برای کاربرد محلی یا تخصصی معرفی شده؛ سه سطح reasoning دارد. | قالب harmony و backend سازگار با MXFP4 لازماند؛ نام 20B را جای شمار واقعی وزنها در محاسبات نگذارید.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید. | پیشنهاد تحلیلی راهنما | |||
| | فراخوانی ابزار، تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی | عامل برنامهنویسی با استدلال حفظشونده | GLM-4.7-Flash مدل MoE از ردهٔ 30B-A3B است؛ کارت مدل برای کارهای عامل چندمرحلهای به حفظ thinking بین نوبتها اشاره میکند. | مسیرهای vLLM و SGLang به نسخههای توسعهای مشخص وابستهاند.، برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | عامل متنی برای برنامهنویسی و گردشکارهای ابزارمحور | — | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | عامل استدلالی برای زنجیرههای طولانی ابزار و تحلیل | — | برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر | عامل چندوجهی برای کدنویسی از طرح تصویری و تحلیل سند | — | برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | دستیار توسعه نرمافزار و گردشکارهای ابزارمحور | — | برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | مدل ابزارمحور برای کدنویسی و برنامهریزی چندمرحلهای | — | برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | دستیار بزرگ با پاسخ مستقیم و زمینهٔ بلند | — | این checkpoint فقط پاسخ مستقیم تولید میکند؛ حالت thinking جداگانه ندارد. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | عامل کدنویسی برای مخزنهای بزرگ و چندفایلی | — | این checkpoint فقط پاسخ مستقیم تولید میکند؛ حالت thinking جداگانه ندارد. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر | دستیار چندوجهی برای تحلیل، کد و سند | — | برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر | مدل کوچک برای نمونهسازی و تخصصیسازی وظیفه | — | برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر | مدل چندوجهی MoE برای تحلیل و کار با ابزار | — | برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار، درک تصویر | دستیار چندوجهی بزرگ برای مسائل پیچیده | — | برای پاسخ ساده، حالت تفکر را در صورت پشتیبانی خاموش یا بودجهٔ خروجی را محدود کنید.، توکنهای تفکر در زمان پاسخ و زمینه حساب شوند.، پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد. | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی، فراخوانی ابزار | دستیار متنی چندزبانه برای پاسخگویی و کار سازمانی | — | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | مدل انگلیسی برای ریاضی، منطق و تولید متن | — | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، درک تصویر | مدل کوچک برای پرسش از تصویر و ویدئو | — | پردازشگر تصویر و اجزای بینایی همین نسخه لازماند؛ تعداد تصویر، وضوح و فریمها مصرف حافظه را تغییر میدهد. | پیشنهاد تحلیلی راهنما | |||
| | بازیابی سند | بردارساز سبک انگلیسی برای جستوجو و خوشهبندی | — | میانگین توکنها با attention mask و نرمالسازی L2 | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بردارساز چندزبانه با پیشوند مجزای پرسش و سند | — | میانگین با mask و L2؛ query: برای پرسش و passage: برای سند | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بردارساز چندزبانه برای جستوجوی معنایی | — | میانگین با mask و L2؛ query: برای پرسش و passage: برای سند | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بردارساز کوچک انگلیسی برای بازیابی اسناد | — | CLS و نرمالسازی؛ دستور retrieval فقط روی پرسش | کاربرد معرفیشده توسط سازنده | |||
| | بازرتبهبندی سند | بازرتبهبند انگلیسی و چینی برای نتایج جستوجو | — | Cross-encoder روی زوج پرسش و سند؛ امتیاز ارتباط | کاربرد معرفیشده توسط سازنده | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | دستیار کدنویسی کوچک برای توضیح و اصلاح کد | — | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | دستیار کدنویسی برای تولید، توضیح و رفع خطا | — | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، تولید پاسخ از سند، استخراج ساختیافته، برنامهنویسی | دستیار کدنویسی با ظرفیت بیشتر برای مسائل دشوار | — | — | پیشنهاد تحلیلی راهنما | |||
| | بازیابی سند | بردارساز چندزبانه کوچک برای اجرا روی دستگاه | — | بیش از ۱۰۰ زبان؛ کاهش بعد با Matryoshka تا ۱۲۸ بعد | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بردارساز چندزبانه با آداپترهای وابسته به وظیفه | — | آداپتر retrieval.query / retrieval.passage؛ میانگین توکنها و L2 | کاربرد معرفیشده توسط سازنده | |||
| | بازرتبهبندی سند | بازرتبهبند چندزبانه برای اسناد بلندتر | — | بازرتبهبندی چندزبانه با ورودی تا ۱۰۲۴ توکن | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بردارساز انگلیسی برای بازیابی با دستور پرسش | — | دستور Represent this sentence for searching relevant passages: روی پرسش | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بردارساز انگلیسی با زمینهٔ بلند و ابعاد قابل کاهش | — | پیشوند search_query: برای پرسش و search_document: برای سند؛ نرمالسازی و کاهش بُعد | کاربرد معرفیشده توسط سازنده | |||
| | استخراج ساختیافته | رمزگذار پایه برای آموزش دستهبندی و استخراج موجودیت | — | رمزگذار دوسویه؛ خروجی توکن یا هد آموزشدیدهٔ وظیفه | کاربرد معرفیشده توسط سازنده | |||
| | تکمیل کد / FIM | تکمیل کد و پرکردن جای خالی | مدل پایهٔ کدنویسی با حدود ۱٫۵۴ میلیارد پارامتر؛ برای FIM و ادامهٔ کد، نه گفتوگوی دستورپذیر. | از قالب تکمیل کد / FIM همین مدل استفاده کنید؛ chat template مدل دستورپذیر را جایگزین نکنید. | کاربرد معرفیشده توسط سازنده | |||
| | تکمیل کد / FIM | تکمیل کد با پنجرهٔ لغزان | مدل پایهٔ کدنویسی؛ ورودی ۱۶٬۳۸۴ توکنی با پنجرهٔ توجه ۴٬۰۹۶ توکنی. برای تکمیل کد، نه دستیار گفتوگو. | از قالب تکمیل کد / FIM همین مدل استفاده کنید؛ chat template مدل دستورپذیر را جایگزین نکنید. | کاربرد معرفیشده توسط سازنده | |||
| | برنامهنویسی | عامل برنامهنویسی | مدل MoE با ۸۰ میلیارد پارامتر و ۳ میلیارد پارامتر فعال، توجه ترکیبی و پاسخ مستقیم؛ حافظهٔ وزن از کل مدل میآید. | — | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بازیابی چندزبانه با دستور وظیفه | بردارساز ۱۰۲۴بعدی؛ دستور یکجملهای به پرسش اضافه میشود و سند بدون دستور وارد میشود. | قالب پرسش Instruct: … Query: …؛ سند بدون دستور. masked mean pooling و نرمالسازی L2؛ حداکثر ۵۱۲ توکن. | کاربرد معرفیشده توسط سازنده | |||
| | تولید متن | دستیار کوچک با پاسخ مستقیم | نسخهٔ دستورپذیر چهارمیلیاردی با سقف متن ۲۶۲٬۱۴۴ توکن؛ این checkpoint حالت thinking ندارد. | — | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بردارسازی متن فارسی | نسخهٔ کوچک Tooka-SBERT-V2 با بردار ۷۶۸بعدی؛ نامزد بومی برای بازیابی و شباهت متن فارسی. | برای Tooka، پرسش با «سوال: » و سند با «متن: » به مدل داده میشود. | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بردارسازی متن فارسی | نسخهٔ بزرگ Tooka-SBERT-V2 با بردار ۱۰۲۴بعدی؛ نتیجهٔ PTEB با آزمونهای دیگر قابل رتبهبندی مستقیم نیست. | برای Tooka، پرسش با «سوال: » و سند با «متن: » به مدل داده میشود. | کاربرد معرفیشده توسط سازنده | |||
| | استخراج ساختیافته | پایهٔ آموزش وظایف فارسی | ParsBERT پایه برای درک متن فارسی؛ دستهبندی و تشخیص موجودیت به سر وظیفه و آموزش نیاز دارند. بردارساز آمادهٔ بازیابی نیست. | وزن پایه بهتنهایی دستهبند یا NER آماده نیست.، برای برچسبگذاری، سر طبقهبندیِ آموزشدیده روی encoder لازم است. | کاربرد معرفیشده توسط سازنده | |||
| | تولید متن | تولید متن به زبانهای ایبری | گزینهٔ تخصصیتر برای زبان اسپانیایی و زبانهای ایبری؛ گونهٔ 2B دستورپذیر با نتایج منتشرشدهٔ اسپانیایی. نقطهٔ مرجع زبانی است، نه برندهٔ عمومی یا گزینهٔ اثباتشده برای فارسی. | — | کاربرد معرفیشده توسط سازنده | |||
| | تولید متن | تولید متن به زبانهای ایبری | گزینهٔ تخصصیتر برای زبان اسپانیایی و زبانهای ایبری؛ گونهٔ 7B دستورپذیر با نتایج منتشرشدهٔ اسپانیایی. نقطهٔ مرجع زبانی است، نه برندهٔ عمومی یا گزینهٔ اثباتشده برای فارسی. | — | کاربرد معرفیشده توسط سازنده | |||
| | استدلال | استدلال با مدل کوچک | مدل کوچکِ دستورپذیر برای بررسی در کارهای استدلال و ابزار؛ اندازهٔ واقعی ثبتشده حدود ۲٫۵۲ میلیارد پارامتر است. امتیازهای ناشر را از امتیازهای نقلشده از Artificial Analysis جدا کنید؛ شاهد فارسی یا اسپانیایی در این بسته ندارد. | — | کاربرد معرفیشده توسط سازنده | |||
| | استخراج ساختیافته | استخراج اطلاعات روی دستگاه | گزینهٔ کوچک برای استخراج اطلاعات و کارهای محدود روی دستگاه؛ ناشر آن را برای برنامهنویسی و کارهای دانشمحور توصیه نمیکند. اسپانیایی در زبانهای اعلامشده هست؛ نتیجهٔ اختصاصی فارسی ثبت نشده است. | — | کاربرد معرفیشده توسط سازنده | |||
| | استدلال | استدلال با مدل کوچک | گونهٔ استدلالی Granite با حالتهای thinking و non-thinking؛ برچسب 3B نام اندازه است و شمار ثبتشدهٔ پارامترها حدود ۳٫۶۶ میلیارد است. حد بومی ۱۲۸K را از ادعای گسترش تا ۵۱۲K جدا نگه دارید. | — | کاربرد معرفیشده توسط سازنده | |||
| | بازیابی سند | بازیابی چندوجهی | بازیابی متن، تصویر و ویدئو با بردارهایی در ابعاد ۶۴ تا 2048؛ ورودی وظیفه تا ۳۲ هزار توکن. | — | پیشنهاد تحلیلی راهنما | |||
| | بازیابی سند | بازیابی چندوجهی | بازیابی متن، تصویر و ویدئو با بردارهایی در ابعاد ۶۴ تا 4096؛ ورودی وظیفه تا ۳۲ هزار توکن. | — | پیشنهاد تحلیلی راهنما | |||
| | بازرتبهبندی سند | بازرتبهبندی چندوجهی | امتیازدهی به ارتباط پرسش با متن، تصویر یا ویدئو؛ بازرتبهبندی نتایج بازیابی با ورودی تا ۳۲ هزار توکن. | — | پیشنهاد تحلیلی راهنما | |||
| | بازرتبهبندی سند | بازرتبهبندی چندوجهی | امتیازدهی به ارتباط پرسش با متن، تصویر یا ویدئو؛ بازرتبهبندی نتایج بازیابی با ورودی تا ۳۲ هزار توکن. | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، درک تصویر، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | مدل متن و تصویر با توجه ترکیبی | Qwen3.6-27B متن، تصویر و ویدئو را میخواند. وزن رسمی BF16 ثبت شده؛ حافظهٔ اجرای توجه ترکیبی باید با موتور واقعی سنجیده شود. | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن، درک تصویر، تولید پاسخ از سند، استخراج ساختیافته، استدلال، برنامهنویسی، فراخوانی ابزار | مدل متن و تصویر با توجه ترکیبی | Qwen3.6-35B-A3B متن، تصویر و ویدئو را میخواند. وزن رسمی BF16 ثبت شده؛ حافظهٔ اجرای توجه ترکیبی باید با موتور واقعی سنجیده شود. | — | پیشنهاد تحلیلی راهنما | |||
| تولید متن | ترجمهٔ تخصصی متن | مدل تخصصی ترجمه با امکان تعیین معادل اصطلاحات و دادن متن زمینه؛ برای گفتوگوی عمومی یا پاسخگویی از اسناد انتخاب نشده است. | — | پیشنهاد تحلیلی راهنما | ||||
| تولید متن | ترجمهٔ تخصصی متن | مدل تخصصی ترجمه با امکان تعیین معادل اصطلاحات و دادن متن زمینه؛ برای گفتوگوی عمومی یا پاسخگویی از اسناد انتخاب نشده است. | — | پیشنهاد تحلیلی راهنما | ||||
| تولید متن | ترجمهٔ تخصصی | نسل دوم مترجم Hy-MT با دستورهای ترجمه و حفظ اصطلاحات. | — | پیشنهاد تحلیلی راهنما | ||||
| تولید متن | ترجمهٔ تخصصی | نسل دوم مترجم Hy-MT با دستورهای ترجمه و حفظ اصطلاحات. | — | پیشنهاد تحلیلی راهنما | ||||
| تولید متن | ترجمهٔ تخصصی | نسل دوم مترجم Hy-MT با دستورهای ترجمه و حفظ اصطلاحات. | — | پیشنهاد تحلیلی راهنما | ||||
| | تولید متن | ترجمهٔ تخصصی | مترجم متن و نوشتههای تصویر با ورودی حداکثر ۲هزار توکن؛ قالب ویژهٔ ترجمه دارد. | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن | ترجمهٔ تخصصی | مترجم متن و نوشتههای تصویر با ورودی حداکثر ۲هزار توکن؛ قالب ویژهٔ ترجمه دارد. | — | پیشنهاد تحلیلی راهنما | |||
| | تولید متن | ترجمهٔ تخصصی | مترجم متن و نوشتههای تصویر با ورودی حداکثر ۲هزار توکن؛ قالب ویژهٔ ترجمه دارد. | — | پیشنهاد تحلیلی راهنما | |||
| تولید متن | ترجمهٔ تخصصی | مترجم مبتنی بر T5 با دامنهٔ زبانی گسترده؛ پیشوند زبان مقصد بخشی از ورودی است. | — | پیشنهاد تحلیلی راهنما | ||||
| تولید متن | ترجمهٔ تخصصی | مدل مرجع پژوهشی ترجمه؛ مجوز غیرتجاری و ورودی آموزشی تا ۵۱۲ توکن دارد. | — | پیشنهاد تحلیلی راهنما | ||||
| | برنامهنویسی | کدنویسی، عاملهای نرمافزاری و تحلیل متن و تصویر | مدل چندوجهی شیائومی برای کدنویسی، کار با ابزارها و بررسی ورودیهای طولانی؛ وزنهای نسخهٔ RL با مجوز MIT منتشر شدهاند. | حدود ۱٫۰۲ تریلیون پارامتر کل و ۴۲ میلیارد فعال؛ فایلهای وزن ۵۳۴٫۱ GiB هستند. این نسخه برای یک کارت ۲۴ یا ۴۸ گیگابایتی جا نمیشود.، امتیاز ۴۶ در شاخص هوش Artificial Analysis نسخهٔ ۴٫۳٫۲ برای سرویس MiMo-V2.6-Pro؛ این نتیجه آزمون فارسی یا آزمون اجرای محلی نسخهٔ RL نیست. | پیشنهاد تحلیلی راهنما |
«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.
نمای دادهای
امکان اجرا روی سختافزار
حافظهٔ لازم برای وزنها، KV و اجرای مدل با تنظیمات انتخابشده.
محاسبه از مشخصات · زمینه شامل تاریخچه، ورودی و خروجی است. درخواست فعال با تعداد کاربران روزانه تفاوت دارد.
کارتهای جدول · ۳ آرایش انتخاب شده
مشخصات کارتها در راهنمای GPU ←روش محاسبه و محدودیت سناریو
حجم واقعی فایل وزن + حافظهٔ KV + ذخیرهٔ اجرایی. برای GGUF، مقدار KV با دقت FP16 محاسبه میشود. ذخیرهٔ پیشفرض GPU دو GiB برای هر کارت و ذخیرهٔ CPU چهار GiB است؛ این ذخیره فرض برنامهریزی است.
مدلهای MoE با تمام وزنها محاسبه میشوند. ظرفیت اسمی کارت بهعنوان بودجهٔ GiB استفاده شده؛ برای استقرار دقیق، حافظهٔ آزاد گزارششدهٔ دستگاه ملاک است. مجموع حافظهٔ چند کارت، حافظهٔ یکپارچه نیست.
در مسیر FP32 مدلهای SmolLM2، وزن و KV هر دو FP32 هستند. سناریوهای بزرگتر از زمینهٔ فایل منتخب نمایش داده نمیشوند؛ از جمله Aya Expanse 32B با فایل GGUF منتخب و زمینهٔ حداکثر ۸٬۱۹۲ توکن.
۵۶ نتیجه از ۵۶ ردیف
فیلترهای تخصصی ۱ کنترل
همهٔ ردیفها
مقایسهٔ ردیفها و شرایط آن
قاعدهٔ مقایسه: ماتریس سختافزار را داخل یک ردیف همشرط نشان میدهد؛ مقایسهٔ ردیفها فقط با کنترل همهٔ شرایط غیرسختافزاری معتبر است.
| مقایسه | جزئیات | مدل | نسخهٔ وزن | RTX 4090 24GB | RTX 5090 32GB | RTX 6000 Ada 48GB | |||
|---|---|---|---|---|---|---|---|---|---|
| | Q8_0 | ۳٫۴۷ GiB | ۰٫۶ GiB | ۰٫۸۸ GiB | |||||
| | Q8_0 | ۴٫۵۸ GiB | ۱٫۷۱ GiB | ۰٫۸۸ GiB | |||||
| | Q4_K_M | ۵٫۴۵ GiB | ۲٫۳۳ GiB | ۱٫۱۳ GiB | |||||
| | Q8_0 | ۷٫۱۱ GiB | ۳٫۹۹ GiB | ۱٫۱۳ GiB | |||||
| | Q4_K_M | ۷٫۸۱ GiB | ۴٫۶۸ GiB | ۱٫۱۳ GiB | |||||
| | Q8_0 | ۱۱٫۲۴ GiB | ۸٫۱۱ GiB | ۱٫۱۳ GiB | |||||
| | Q4_K_M | ۱۱٫۶۳ GiB | ۸٫۳۸ GiB | ۱٫۲۵ GiB | |||||
| | Q8_0 | ۱۷٫۸۷ GiB | ۱۴٫۶۲ GiB | ۱٫۲۵ GiB | |||||
| | Q4_K_M | ۲۰٫۰۳ GiB | ۱۷٫۲۸ GiB | ۰٫۷۵ GiB | |||||
| | Q8_0 | ۳۳ GiB | ۳۰٫۲۵ GiB | ۰٫۷۵ GiB | |||||
| | Q4_K_M | ۲۲٫۴ GiB | ۱۸٫۴ GiB | ۲ GiB | |||||
| | Q8_0 | ۳۶٫۴۳ GiB | ۳۲٫۴۳ GiB | ۲ GiB | |||||
| | Q4_K_M | ۴۴٫۱ GiB | ۳۹٫۶ GiB | ۲٫۵ GiB | |||||
| | Q8_0 | ۷۴٫۳۳ GiB | ۶۹٫۸۳ GiB | ۲٫۵ GiB | |||||
| | Q4_K_M | ۱۱٫۸۷ GiB | ۸٫۳۷ GiB | ۱٫۵ GiB | |||||
| | Q8_0 | ۱۸٫۱۲ GiB | ۱۴٫۶۲ GiB | ۱٫۵ GiB | |||||
| | Q4_K_M | ۲۲٫۴۹ GiB | ۱۸٫۴۹ GiB | ۲ GiB | |||||
| | Q8_0 | ۳۶٫۴۳ GiB | ۳۲٫۴۳ GiB | ۲ GiB | |||||
| | Q4_K_M | ۶٫۸ GiB | ۴٫۳۶ GiB | ۰٫۴۴ GiB | |||||
| | Q8_0 | ۹٫۹۸ GiB | ۷٫۵۴ GiB | ۰٫۴۴ GiB | |||||
| | Q4_K_M | ۴۴٫۱ GiB | ۳۹٫۶ GiB | ۲٫۵ GiB | |||||
| | Q8_0 | ۷۴٫۳۳ GiB | ۶۹٫۸۳ GiB | ۲٫۵ GiB | |||||
| | Q4_K_M | ۷٫۵۸ GiB | ۴٫۵۸ GiB | ۱ GiB | |||||
| | Q8_0 | ۱۰٫۹۵ GiB | ۷٫۹۵ GiB | ۱ GiB | |||||
| | Q4_K_M | ۲۱٫۶۹ GiB | ۱۸٫۴۴ GiB | ۱٫۲۵ GiB | |||||
| | Q8_0 | ۳۵٫۲۲ GiB | ۳۱٫۹۷ GiB | ۱٫۲۵ GiB | |||||
| | Q4_K_M | ۷٫۷۱ GiB | ۴٫۷۱ GiB | ۱ GiB | |||||
| | Q8_0 | ۱۰٫۹۵ GiB | ۷٫۹۵ GiB | ۱ GiB | |||||
| | Q4_K_M | ۴٫۴۸ GiB | ۰٫۹۸ GiB | ۱٫۵ GiB | |||||
| | Q4_K_M | ۲٫۲۷ GiB | ۰٫۱ GiB | ۰٫۱۸ GiB | |||||
| | Q8_0 | ۲٫۳۱ GiB | ۰٫۱۳ GiB | ۰٫۱۸ GiB | |||||
| | Q8_0 | ۲٫۶۷ GiB | ۰٫۳۶ GiB | ۰٫۳۱ GiB | |||||
| | Q4_K_M | ۲۰٫۰۳ GiB | ۱۷٫۲۸ GiB | ۰٫۷۵ GiB | |||||
| | Q8_0 | ۳۳ GiB | ۳۰٫۲۵ GiB | ۰٫۷۵ GiB | |||||
| | Q4_K_M | ۷٫۸۱ GiB | ۴٫۶۸ GiB | ۱٫۱۳ GiB | |||||
| | Q8_0 | ۱۱٫۲۴ GiB | ۸٫۱۱ GiB | ۱٫۱۳ GiB | |||||
| | Q4_K_M | ۳٫۲۶ GiB | ۱٫۰۴ GiB | ۰٫۲۲ GiB | |||||
| | Q8_0 | ۳٫۹۸ GiB | ۱٫۷۶ GiB | ۰٫۲۲ GiB | |||||
| | Q4_K_M | ۴٫۰۶ GiB | ۱٫۴۴ GiB | ۰٫۶۳ GiB | |||||
| | Q8_0 | ۵٫۱۳ GiB | ۲٫۵۱ GiB | ۰٫۶۳ GiB | |||||
| | Q4_K_M | ۵٫۳۲ GiB | ۲٫۳۲ GiB | ۱ GiB | |||||
| | Q8_0 | ۶٫۸ GiB | ۳٫۸ GiB | ۱ GiB | |||||
| | Q4_K_M | ۷٫۰۷ GiB | ۴٫۰۷ GiB | ۱ GiB | |||||
| | Q8_0 | ۱۰٫۱۷ GiB | ۷٫۱۷ GiB | ۱ GiB | |||||
| | Q4_K_M | ۱۳۶٫۳۲ GiB | ۱۳۲٫۸۵ GiB | ۱٫۴۷ GiB | |||||
| | Q8_0 | ۲۳۶٫۲۴ GiB | ۲۳۲٫۷۷ GiB | ۱٫۴۷ GiB | |||||
| | Q4_K_M | ۲۷۴٫۸ GiB | ۲۷۰٫۸۶ GiB | ۱٫۹۴ GiB | |||||
| | Q8_0 | ۴۷۹٫۲۴ GiB | ۴۷۵٫۳ GiB | ۱٫۹۴ GiB | |||||
| | Q4_K_M | ۱۱٫۹۹ GiB | ۸٫۴۳ GiB | ۱٫۵۶ GiB | |||||
| | Q8_0 | ۱۸٫۰۷ GiB | ۱۴٫۵۱ GiB | ۱٫۵۶ GiB | |||||
| | Q4_K_M | ۶٫۸ GiB | ۴٫۳۶ GiB | ۰٫۴۴ GiB | |||||
| | Q8_0 | ۹٫۹۸ GiB | ۷٫۵۴ GiB | ۰٫۴۴ GiB | |||||
| | Q4_K_M | ۱۱٫۸۷ GiB | ۸٫۳۷ GiB | ۱٫۵ GiB | |||||
| | Q8_0 | ۱۸٫۱۲ GiB | ۱۴٫۶۲ GiB | ۱٫۵ GiB | |||||
| | Q4_K_M | ۲۲٫۴۹ GiB | ۱۸٫۴۹ GiB | ۲ GiB | |||||
| | Q8_0 | ۳۶٫۴۳ GiB | ۳۲٫۴۳ GiB | ۲ GiB |
«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.
نرمافزارهای اجرا و سرویسدهی
نمای دادهای
مقایسهٔ نرمافزارها
نرمافزارهای اجرای محلی و سرویسدهی مدلها را مقایسه کنید.
۱۸ نتیجه از ۱۸ ردیف
فیلترهای تخصصی ۳۶ کنترل
همهٔ ردیفها
مقایسهٔ ردیفها و شرایط آن
قاعدهٔ مقایسه: نسخهها آزادانه کنار هم دیده میشوند؛ محور رابط backend را ثابت نگه میدارد و محور کل ترکیب اجازهٔ تفاوت backend میدهد.
| مقایسه | جزئیات | برای چه کاری؟ | مزیت کاربردی | شرط انتخاب | شروع کار | ||
|---|---|---|---|---|---|---|---|
 Ollama · v0.34.0 | موتور / کتابخانهٔ استنتاج، سرور API، مدیر مدل | شروع محلی، توسعه و سرویس کوچک | دریافت و مدیریت مدل و راهاندازی API در یک ابزار | اجرای محلی و ابری جدا هستند؛ OLLAMA_NO_CLOUD=1 مسیرهای ابری را غیرفعال میکند. | راهنمای شروع ↗ | ||
 vLLM · v0.29.0 | موتور / کتابخانهٔ استنتاج، سرور API | API مدل زبانی با درخواستهای همزمان | continuous batching و مدیریت KV cache؛ API سازگار با OpenAI | برای GGUF، افزونهٔ vllm-gguf-plugin جدا نصب میشود؛ پشتیبانی این قالب آزمایشی است. | راهنمای شروع ↗ | ||
 SGLang · v0.5.20 | موتور / کتابخانهٔ استنتاج، سرور API | سرویسدهی مدل زبانی و چندرسانهای روی یک GPU یا خوشه | تولید متن، بستهبندی پیوستهٔ درخواستها، کش پیشوند، خروجی ساختاریافته انتخاب parser ابزار و کرنل کوانت به معماری مدل وابسته است. از 0.5.20 بسته و ایمیج CUDA 12 منتشر نمیشود؛ 0.5.19 آخرین نسخهٔ این مسیر است و ایمیجهای قبلی باقیاند. ذخیرهٔ Responses پیشفرض غیرفعال است؛ بازیابی پاسخ، previous_response_id و درخواست پسزمینه به --enable-response-store نیاز دارند. در استقرار با جداسازی پردازش ورودی و تولید خروجی (PD)، این گزینه قابل فعالسازی نیست. | انتخاب parser ابزار و کرنل کوانت به معماری مدل وابسته است. از 0.5.20 بسته و ایمیج CUDA 12 منتشر نمیشود؛ 0.5.19 آخرین نسخهٔ این مسیر است و ایمیجهای قبلی باقیاند. ذخیرهٔ Responses پیشفرض غیرفعال است؛ بازیابی پاسخ، previous_response_id و درخواست پسزمینه به --enable-response-store نیاز دارند. در استقرار با جداسازی پردازش ورودی و تولید خروجی (PD)، این گزینه قابل فعالسازی نیست. | راهنمای شروع ↗ | ||
| SGLang · v0.5.19 | موتور / کتابخانهٔ استنتاج، سرور API | سرویس چندکاربره و بار دارای پیشوند مشترک | batching و prefix caching؛ تنظیم برای نوع بار | پشتیبانی parser ابزار و کرنل کوانت به معماری مدل وابسته است؛ نسخه و تنظیمات هر ردیف بنچمارک را کنار نتیجه ببینید. | راهنمای شروع ↗ | ||
 llama.cpp / llama-server · v0.4.1 | موتور / کتابخانهٔ استنتاج، سرور API | GGUF روی CPU، GPU و ترکیب RAM/VRAM | کنترل کوانتیزاسیون، تقسیم لایهها و اجرای CPU | اجرای جزئی روی CPU با بارگذاری لایهای AirLLM یک روش واحد نیست. | راهنمای شروع ↗ | ||
| TensorRT-LLM · v1.2.1 | موتور / کتابخانهٔ استنتاج، سرور API | استقرار تخصصی روی GPUهای NVIDIA | بهینهسازی مدل، کرنل و اجرای سرویس | مسیر پشتیبانی و تنظیمات برای هر نسخه و معماری متفاوت است. | راهنمای شروع ↗ | ||
| Triton Inference Server · v2.72.0 | سرور API، مدیر استقرار | مدیریت سرویس مدلها و pipelineهای inference | مدیریت مدل، زمانبندی و اتصال backendهای تخصصی | انتشار ۲٫۷۲٫۰ کانتینر backendِ TensorRT-LLM را همراه ندارد. | راهنمای شروع ↗ | ||
 Text Embeddings Inference (TEI) · v1.9.3 | موتور / کتابخانهٔ استنتاج، سرور API | سرویس بردارسازی اسناد و پرسشها | batching و API برای embedding؛ imageهای CPU و GPU | پشتیبانی reranking برای همهٔ معماریها از پشتیبانی embedding نتیجه نمیشود. | راهنمای شروع ↗ | ||
 AirLLM · v4.0.0 | موتور / کتابخانهٔ استنتاج | امکان اجرای مدل بزرگ با VRAM کم | بارگذاری و تخلیهٔ لایهها با تکیه بر میزبان و دیسک | هدف اصلی کاهش حافظهٔ GPU است؛ برای چت همزمان از بنچمارک همان بار استفاده کنید. | راهنمای شروع ↗ | ||
| Transformers · v5.17.0 | موتور / کتابخانهٔ استنتاج، سرور API | پژوهش، کنترل مستقیم مدل و مسیرهای سفارشی | دسترسی مستقیم به مدل و منطق پردازش | سرعت یک مسیر سادهٔ Transformers نمایندهٔ همهٔ موتورهای همان مدل نیست. | راهنمای شروع ↗ | ||
 LiteLLM · v1.101.0 | درگاه مدلها، سرور API | مدیریت چند ارائهدهنده و backend | API مشترک، مسیریابی و مدیریت مصرف | توان اجرای وزن مدل از backend میآید. | راهنمای شروع ↗ | ||
 Open WebUI · v0.11.3 | رابط گفتگو | پنل گفتوگو و کار با backendهای مدل | رابط چت برای کاربران و اتصال به موتور اجرا | حافظه و سرعت مدل را باید به backend متصل نسبت داد. | راهنمای شروع ↗ | ||
| Text Generation Inference (TGI) · v3.3.7 | موتور / کتابخانهٔ استنتاج، سرور API | نگهداری سرویس تولید متن برای مدلهای پشتیبانیشده | تولید متن، تقسیم مدل میان GPUها (مشروط)، خروجی جریانی، بستهبندی پیوستهٔ درخواستها مخزن از ۲۱ مارس ۲۰۲۶ آرشیو و فقطخواندنی است. | مخزن از ۲۱ مارس ۲۰۲۶ آرشیو و فقطخواندنی است. | راهنمای شروع ↗ | ||
 LM Studio · 0.4.24 Build 1 | رابط گفتگو، مدیر مدل، سرور API | دریافت مدل، گفتگو و راهاندازی API محلی | بارگذاری و تخلیهٔ مدل، خروجی جریانی، خروجی ساختاریافته، درخواستهای همزمان قابلیت و قالب مدل به runtime انتخابشده وابسته است. | قابلیت و قالب مدل به runtime انتخابشده وابسته است. | راهنمای شروع ↗ | ||
 KTransformers · v0.7.1 | موتور / کتابخانهٔ استنتاج | وقتی ترکیب حافظهٔ میزبان و GPU و پشتیبانی همان مدل، بخشی از طراحی اجراست. | اجرای ناهمگون مدل روی CPU و GPU، از جمله مسیرهای بهینهشده برای مدلهای MoE پشتیبانیشده. | نتیجه به پیکربندی، حافظه و قابلیت پردازنده وابسته است؛ از یک بنچمارک، سرعت عمومی نتیجه نمیشود. | راهنمای شروع ↗ | ||
| Sentence Transformers · v6.0.1 | موتور / کتابخانهٔ استنتاج | وقتی به پیادهسازی یا تنظیم بخش بازیابی و ارزیابی مدلهای تخصصی نیاز دارید. | تولید embedding برای جستوجوی معنایی و استفاده از CrossEncoder برای امتیازدهی و بازرتبهبندی. | انتخاب کتابخانه، کیفیت مدل در زبان و دادهٔ شما یا وجود یک سرویس آمادهٔ چت را تضمین نمیکند. | راهنمای شروع ↗ | ||
| FlagEmbedding · v1.4.2 | موتور / کتابخانهٔ استنتاج | اجرای خانوادهٔ BGE و بازرتبهبندها | خروجیهای dense، sparse و چندبرداری BGE-M3 | سه خروجی BGE-M3 مصرف و ساخت نمایهٔ متفاوت دارند؛ فقط dense را نمیتوان جای هر سه خروجی استفاده کرد. | راهنمای شروع ↗ | ||
MLX LM · v0.31.3 | موتور / کتابخانهٔ استنتاج | اجرای محلی و کمدقتسازی مدلهای سازگار روی Apple silicon | تولید متن (مشروط)، خروجی جریانی (مشروط)، کش پیشوند (مشروط)، تقسیم مدل میان GPUها (مشروط) مسیر مستقیم برای اجرای محلی و کمدقتسازی مدلهای سازگار روی Apple silicon. حافظهٔ مشترک را دوباره بهصورت RAM+VRAM جمع نزنید. شرط macOS 15 در README مربوط به memory wiring مدلهای بزرگ است، نه حداقل قطعی همهٔ کاربردهای MLX LM. | مسیر مستقیم برای اجرای محلی و کمدقتسازی مدلهای سازگار روی Apple silicon. حافظهٔ مشترک را دوباره بهصورت RAM+VRAM جمع نزنید. شرط macOS 15 در README مربوط به memory wiring مدلهای بزرگ است، نه حداقل قطعی همهٔ کاربردهای MLX LM. | راهنمای شروع ↗ |
«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.
نتایج آزمونها
مقایسهٔ مدلها در آزمونهای مشترک
دربارهٔ این مقایسهها
در MIRACL فارسی، nDCG@10 از 53.3 برای Small به 59.4 برای Large-Instruct میرسد. در اسپانیایی 51.2 و 53.7 است؛ در انگلیسی Large با 52.9 بالاتر از Large-Instruct با 51.5 گزارش شده است. میانگین چندزبانه جای زبانِ کاربرد را نمیگیرد.
اختلاف امتیاز را فقط برای مدلهایی محاسبه میکنیم که در یک آزمون و با شرایط یکسان بررسی شدهاند.
MIRACL · nDCG@10· فارسی
| مدل | امتیاز | اختلاف با ردیف نخست | جزئیات آزمون |
|---|---|---|---|
| ۵۳٫۳ امتیاز از ۱۰۰ | — | جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدلAppendix / detailed MIRACL results / language=fa / column=1
| |
| ۵۷٫۴ امتیاز از ۱۰۰ | ۴٫۱ | جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدلAppendix / detailed MIRACL results / language=fa / column=2
| |
| ۵۹ امتیاز از ۱۰۰ | ۵٫۷ | جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدلAppendix / detailed MIRACL results / language=fa / column=3
| |
| ۵۹٫۴ امتیاز از ۱۰۰ | ۶٫۱ | جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدلAppendix / detailed MIRACL results / language=fa / column=4
|
MIRACL · Recall@100· فارسی
| مدل | امتیاز | اختلاف با ردیف نخست | جزئیات آزمون |
|---|---|---|---|
| ۹۰٫۴ امتیاز از ۱۰۰ | — | جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدلAppendix / detailed MIRACL results / language=fa / column=5
| |
| ۹۱٫۲ امتیاز از ۱۰۰ | ۰٫۸ | جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدلAppendix / detailed MIRACL results / language=fa / column=6
| |
| ۹۲٫۹ امتیاز از ۱۰۰ | ۲٫۵ | جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدلAppendix / detailed MIRACL results / language=fa / column=7
| |
| ۹۲٫۹ امتیاز از ۱۰۰ | ۲٫۵ | جزئیات آزمونMultilingual E5 technical report, arXiv:2402.05672v1 ↗گزارش ناشر مدلAppendix / detailed MIRACL results / language=fa / column=8
|
نتایج کیفیت مدلها
MIRACL · nDCG@10 · فارسی · امتیاز
| انتخاب برای مقایسه | مدل | امتیاز | حالت آزمون | گزارشدهنده | منبع |
|---|---|---|---|---|---|
| ۵۷٫۷ امتیاز0..100 as printed | —dev · fa | BAAIگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۵۷٫۷گزارش ناشر · BAAI· فارسی· بردار متراکم
bge-m3 — published evaluation · گزارش ناشرhttps://arxiv.org/html/2402.03216v1 ↗
| ||
| ۴۵٫۲ امتیاز0..100 as printed | —dev · fa | BAAIگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۴۵٫۲گزارش ناشر · BAAI· فارسی· بازنمایی تنک
bge-m3 — published evaluation · گزارش ناشرhttps://arxiv.org/html/2402.03216v1 ↗
| ||
| ۵۸٫۸ امتیاز0..100 as printed | —dev · fa | BAAIگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۵۸٫۸گزارش ناشر · BAAI· فارسی· چندبرداری
bge-m3 — published evaluation · گزارش ناشرhttps://arxiv.org/html/2402.03216v1 ↗
| ||
| ۵۹٫۲ امتیاز0..100 as printed | —dev · fa | BAAIگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۵۹٫۲گزارش ناشر · BAAI· فارسی· ترکیب متراکم و تنک
bge-m3 — published evaluation · گزارش ناشرhttps://arxiv.org/html/2402.03216v1 ↗
| ||
| ۶۰٫۳ امتیاز0..100 as printed | —dev · fa | BAAIگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۶۰٫۳گزارش ناشر · BAAI· فارسی· ترکیب سه روش
bge-m3 — published evaluation · گزارش ناشرhttps://arxiv.org/html/2402.03216v1 ↗
|
MIRACL · nDCG@10 · فارسی · از ۱۰۰
| انتخاب برای مقایسه | مدل | امتیاز | حالت آزمون | گزارشدهنده | منبع |
|---|---|---|---|---|---|
| ۵۳٫۳ از ۱۰۰ | —development | Microsoft E5 authorsگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۵۳٫۳گزارش ناشر · Microsoft E5 authors· فارسی
Multilingual E5 technical report, arXiv:2402.05672v1 · گزارش ناشرhttps://arxiv.org/html/2402.05672v1 ↗
| ||
| ۵۷٫۴ از ۱۰۰ | —development | Microsoft E5 authorsگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۵۷٫۴گزارش ناشر · Microsoft E5 authors· فارسی
Multilingual E5 technical report, arXiv:2402.05672v1 · گزارش ناشرhttps://arxiv.org/html/2402.05672v1 ↗
| ||
| ۵۹ از ۱۰۰ | —development | Microsoft E5 authorsگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۵۹گزارش ناشر · Microsoft E5 authors· فارسی
Multilingual E5 technical report, arXiv:2402.05672v1 · گزارش ناشرhttps://arxiv.org/html/2402.05672v1 ↗
| ||
| ۵۹٫۴ از ۱۰۰ | —development | Microsoft E5 authorsگزارش ناشر | جزئیات آزمونMIRACL · nDCG@10: ۵۹٫۴گزارش ناشر · Microsoft E5 authors· فارسی
Multilingual E5 technical report, arXiv:2402.05672v1 · گزارش ناشرhttps://arxiv.org/html/2402.05672v1 ↗
|
نمای دادهای
مدلهای کوچک و تخصصی مکمل
نقش مدل تخصصی، طول ورودی، ابعاد بردار و نتایج مرتبط با زبان انتخابی را مقایسه کنید.
آزمونِ ستون نتیجه: MIRACL · nDCG@10 · fa
این انتخاب برای ستون نتیجهٔ همهٔ جدولهاست. شرایط اجرا در جزئیات هر مدل آمده است.
دیدن نتایج به تفکیک آزمون ←۲۸ نتیجه از ۲۸ ردیف
فیلترهای تخصصی ۶ کنترل
همهٔ ردیفها
مقایسهٔ ردیفها و شرایط آن
قاعدهٔ مقایسه: معیار و واحد باید متناسب با یک وظیفه باشند؛ document/s هیچگاه ضمنی به token/s تبدیل نمیشود.
| مقایسه | جزئیات | وظیفهٔ دقیق | نوع / ابعاد خروجی | زبانها و شاهد زبان انتخابی | مجوز | نتیجهٔ مرتبط با زبان انتخابی | دریافت و راهاندازی | ||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| | بازیابی متراکم، تنک و چندبرداری | حدود ۰٫۵۶۹ میلیارد | ۸٬۱۹۲ توکن | بردار متراکم ۱۰۲۴بُعدی + وزن توکن + چندبرداری | multilingual fa: نتیجهٔ منتشرشده | MIT ↗ | ۳٫۸۱ GiB / یک میلیون بردار | ||||
| | بازرتبهبندی زوج پرسش و سند | حدود ۰٫۵۶۸ میلیارد | ۸٬۱۹۲ توکن | امتیاز ارتباط؛ sigmoid اختیاری در بازهٔ ۰ تا ۱ | multilingual fa: نتیجهٔ منتشرشده | Apache-2.0 ↗ | — | بردار ثابت ذخیره نمیکند | |||
| | بازیابی معنایی و ساخت بردار متن | حدود ۰٫۶ میلیارد | ۳۲٬۷۶۸ توکن | بردار متراکم؛ ۱۰۲۴ بُعد پیشفرض / حداکثر | multilingual fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | ۳٫۸۱ GiB / یک میلیون بردار | |||
| | بازیابی معنایی و ساخت بردار متن | حدود ۴ میلیارد | ۳۲٬۷۶۸ توکن | بردار متراکم؛ ۲۵۶۰ بُعد پیشفرض / حداکثر | multilingual fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | ۹٫۵۴ GiB / یک میلیون بردار | |||
| | بازیابی معنایی و ساخت بردار متن | حدود ۸ میلیارد | ۳۲٬۷۶۸ توکن | بردار متراکم؛ ۴۰۹۶ بُعد پیشفرض / حداکثر | multilingual fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | ۱۵٫۲۶ GiB / یک میلیون بردار | |||
| | بازرتبهبندی زوج پرسش و سند | حدود ۰٫۶ میلیارد | ۳۲٬۷۶۸ توکن | امتیاز ارتباط زوج متن؛ بدون embedding | multilingual fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | بردار ثابت ذخیره نمیکند | |||
| | بازرتبهبندی زوج پرسش و سند | حدود ۴ میلیارد | ۳۲٬۷۶۸ توکن | امتیاز ارتباط زوج متن؛ بدون embedding | multilingual fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | بردار ثابت ذخیره نمیکند | |||
| | بازرتبهبندی زوج پرسش و سند | حدود ۸ میلیارد | ۳۲٬۷۶۸ توکن | امتیاز ارتباط زوج متن؛ بدون embedding | multilingual fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | بردار ثابت ذخیره نمیکند | |||
| | بازیابی و مشابهت متن | ۰٫۱۱۸ میلیارد | ۵۱۲ توکن | بردار 384بعدی | multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده | MIT ↗ | ۱٫۴۳ GiB / یک میلیون بردار | ||||
| | بازیابی و مشابهت متن | ۰٫۰۲۳ میلیارد | ۲۵۶ توکن | بردار 384بعدی | en fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | ۱٫۴۳ GiB / یک میلیون بردار | |||
| | بازیابی و مشابهت متن | ۰٫۲۷۸ میلیارد | ۵۱۲ توکن | بردار 768بعدی | multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده | MIT ↗ | ۲٫۸۶ GiB / یک میلیون بردار | ||||
| | بازیابی و مشابهت متن | ۰٫۵۶ میلیارد | ۵۱۲ توکن | بردار 1024بعدی | multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده | MIT ↗ | ۳٫۸۱ GiB / یک میلیون بردار | ||||
| | بازیابی و مشابهت متن | ۰٫۰۳۳ میلیارد | ۵۱۲ توکن | بردار 384بعدی | en fa: شاهد ثبت نشده | MIT ↗ | — | ۱٫۴۳ GiB / یک میلیون بردار | |||
| | بازرتبهبندی نتایج جستوجو | ۰٫۲۷۸ میلیارد | ۵۱۲ توکن | امتیاز ارتباط پرسش و سند | en, zh fa: شاهد ثبت نشده | MIT ↗ | — | بردار ثابت ذخیره نمیکند | |||
| | بازیابی و مشابهت متن | حدود ۰٫۳ میلیارد اسمی شمار کل تأیید نشده | ۲٬۰۴۸ توکن | بردار 768بعدی | multilingual fa: شاهد ثبت نشده | gemma ↗ | — | ۲٫۸۶ GiB / یک میلیون بردار | |||
| | بازیابی و مشابهت متن | حدود ۰٫۵۷ میلیارد اسمی شمار کل تأیید نشده | ۸٬۱۹۲ توکن | بردار 1024بعدی | multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده | CC-BY-NC-4.0 ↗ | — | ۳٫۸۱ GiB / یک میلیون بردار | |||
| | بازرتبهبندی نتایج جستوجو | ۰٫۲۷۸ میلیارد | ۱٬۰۲۴ توکن | امتیاز ارتباط پرسش و سند | multilingual fa: شاهد ثبت نشده | CC-BY-NC-4.0 ↗ | — | بردار ثابت ذخیره نمیکند | |||
| | بازیابی و مشابهت متن | ۰٫۳۳۵ میلیارد | ۵۱۲ توکن | بردار 1024بعدی | en fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | ۳٫۸۱ GiB / یک میلیون بردار | |||
| | بازیابی و مشابهت متن | ۰٫۱۳۷ میلیارد | ۸٬۱۹۲ توکن | بردار 768بعدی | en fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | ۲٫۸۶ GiB / یک میلیون بردار | |||
| | تخصصیسازی دستهبندی و استخراج موجودیت | ۰٫۱۵ میلیارد | ۸٬۱۹۲ توکن | بازنمایی توکن؛ هد وظیفه پس از آموزش | en fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | بردار ثابت ذخیره نمیکند | |||
| | بازیابی و شباهت متن | ۰٫۵۶ میلیارد | ۵۱۲ توکن | بردار متراکم | af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh fa: نتیجهٔ منتشرشده | mit ↗ | ۳٫۸۱ GiB / یک میلیون بردار | ||||
| | بازیابی و شباهت متن | ۰٫۱۲۳ میلیارد | ۵۱۲ توکن | بردار متراکم | fa fa: نتیجهٔ منتشرشده | — | — | ۲٫۸۶ GiB / یک میلیون بردار | |||
| | بازیابی و شباهت متن | ۰٫۳۵۳ میلیارد | ۵۱۲ توکن | بردار متراکم | fa fa: نتیجهٔ منتشرشده | — | — | ۳٫۸۱ GiB / یک میلیون بردار | |||
| | پایهٔ آموزش دستهبندی و تشخیص موجودیت | — | ۵۱۲ توکن | بازنمایی توکنها؛ سر وظیفه باید آموزش ببیند | fa fa: اعلام ناشر | — | — | بردار ثابت ذخیره نمیکند | |||
| | بازیابی متن، تصویر و ویدئو | ۲ میلیارد | ۳۲٬۷۶۸ توکن | بردار با حداکثر 2048 بُعد | — fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | ۷٫۶۳ GiB / یک میلیون بردار | |||
| | بازیابی متن، تصویر و ویدئو | ۸ میلیارد | ۳۲٬۷۶۸ توکن | بردار با حداکثر 4096 بُعد | — fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | ۱۵٫۲۶ GiB / یک میلیون بردار | |||
| | بازرتبهبند | ۲ میلیارد | ۳۲٬۷۶۸ توکن | — | — fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | بردار ثابت ذخیره نمیکند | |||
| | بازرتبهبند | ۸ میلیارد | ۳۲٬۷۶۸ توکن | — | — fa: شاهد ثبت نشده | Apache-2.0 ↗ | — | بردار ثابت ذخیره نمیکند |
«—» یعنی اطلاعات موجود نیست؛ نه اینکه مدل این قابلیت را ندارد.
یادداشتهای راهنما
انتخاب مدل، حافظه، نرمافزار اجرا و ارزیابی کیفیت.
برای هر کاربرد واقعاً چه اندازه مدلی لازم داریم؟ از مدل تخصصی و SLM تا LLM
برای چت ساده، پاسخ مستند، دستیار کد و تحلیل پیچیده چه اندازه مدلی مناسب است؟ مرور تناسب کاربردها، انتخاب میان RAG، CAG، KAG و تنظیم مدل، و اثر اندازه و طول زمینه بر هزینه و ظرفیت سرویسدهی.
برای هر کاربرد واقعاً چه اندازه مدلی لازم داریم؟ از مدل تخصصی و SLM تا LLM
برای چت ساده، پاسخ مستند، دستیار کد و تحلیل پیچیده چه اندازه مدلی مناسب است؟ مرور تناسب کاربردها، انتخاب میان RAG، CAG، KAG و تنظیم مدل، و اثر اندازه و طول زمینه بر هزینه و ظرفیت سرویسدهی.
مدل خوب برای فارسی را چگونه بسنجیم؟
از روانی متن تا درستی پاسخ و موفقیت در کاربرد واقعی؛ راهنمای عملی انتخاب معیار، ساخت نمونههای فارسی و استفاده از بنچمارکها، با ارجاع به پژوهشهای فارسی و کارهای دانشگاهی ایران.
مدل خوب برای فارسی را چگونه بسنجیم؟
از روانی متن تا درستی پاسخ و موفقیت در کاربرد واقعی؛ راهنمای عملی انتخاب معیار، ساخت نمونههای فارسی و استفاده از بنچمارکها، با ارجاع به پژوهشهای فارسی و کارهای دانشگاهی ایران.
RAG، CAG، KAG، Fine-tuning و Instruction tuning؛ چه تفاوتی دارند و کدام را انتخاب کنیم؟
وقتی مدل پاسخ مناسبی نمیدهد، واقعاً به آموزش دوباره نیاز داریم یا فقط باید دانش درست را در اختیارش بگذاریم؟ با مثالهایی ساده، تفاوت RAG، CAG و KAG را با Fine-tuning و Instruction tuning بررسی میکنیم؛ از بازیابی سند و کشکردن دانش تا استدلال روی روابط و تغییر رفتار مدل. جدول مقایسه و سناریوهای عملی کمک میکنند پیش از صرف هزینهٔ آموزش، تشخیص دهیم مشکل از کمبود دانش است یا شیوهٔ پاسخگویی، و کدام روش یا ترکیب برای پروژه مناسبتر است.
RAG، CAG، KAG، Fine-tuning و Instruction tuning؛ چه تفاوتی دارند و کدام را انتخاب کنیم؟
وقتی مدل پاسخ مناسبی نمیدهد، واقعاً به آموزش دوباره نیاز داریم یا فقط باید دانش درست را در اختیارش بگذاریم؟ با مثالهایی ساده، تفاوت RAG، CAG و KAG را با Fine-tuning و Instruction tuning بررسی میکنیم؛ از بازیابی سند و کشکردن دانش تا استدلال روی روابط و تغییر رفتار مدل. جدول مقایسه و سناریوهای عملی کمک میکنند پیش از صرف هزینهٔ آموزش، تشخیص دهیم مشکل از کمبود دانش است یا شیوهٔ پاسخگویی، و کدام روش یا ترکیب برای پروژه مناسبتر است.
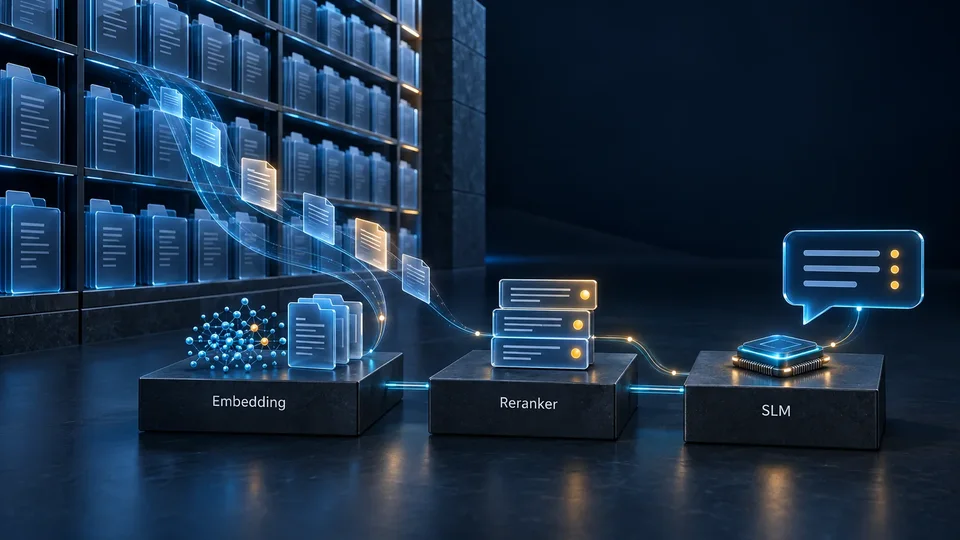
برای دستیار اسناد سازمانی، مدل زبانی، embedding و reranker را چگونه انتخاب کنیم؟
برای پاسخهای روزمره از اسناد سازمان، مدل کوچک اغلب نقطهٔ شروع مناسبی است. معیار انتخاب جداگانهٔ embedding، reranker و پاسخگو، نامزدهای عملی و تشخیص محل خطا را با چهار جدول بررسی میکنیم.
برای دستیار اسناد سازمانی، مدل زبانی، embedding و reranker را چگونه انتخاب کنیم؟
برای پاسخهای روزمره از اسناد سازمان، مدل کوچک اغلب نقطهٔ شروع مناسبی است. معیار انتخاب جداگانهٔ embedding، reranker و پاسخگو، نامزدهای عملی و تشخیص محل خطا را با چهار جدول بررسی میکنیم.
تکمیل کد، دستیار کد و عامل برنامهنویسی؛ سه نیاز با سه معیار انتخاب
تکمیل کد به پیشنهاد سریع، دستیار کد به اصلاح درست و عامل برنامهنویسی به انجام موفق کار با ابزار نیاز دارد. چهار جدول برای انتخاب مدل، معیار ارزیابی و زیرساخت متناسب با هر نقش.
تکمیل کد، دستیار کد و عامل برنامهنویسی؛ سه نیاز با سه معیار انتخاب
تکمیل کد به پیشنهاد سریع، دستیار کد به اصلاح درست و عامل برنامهنویسی به انجام موفق کار با ابزار نیاز دارد. چهار جدول برای انتخاب مدل، معیار ارزیابی و زیرساخت متناسب با هر نقش.
روی RTX 4090 چه مدلهایی اجرا میشوند؟ تفاوت ۲۴ و ۴۸ گیگابایت در عمل
کدام مدلها روی ۲۴ و ۴۸ گیگابایت جا میشوند، چند 4090 چه زمانی برای سرویس سازمانی کافیاند و چه زمانی H100، H200 یا کارت حرفهای ارزش هزینهٔ بیشتر را دارند؟
روی RTX 4090 چه مدلهایی اجرا میشوند؟ تفاوت ۲۴ و ۴۸ گیگابایت در عمل
کدام مدلها روی ۲۴ و ۴۸ گیگابایت جا میشوند، چند 4090 چه زمانی برای سرویس سازمانی کافیاند و چه زمانی H100، H200 یا کارت حرفهای ارزش هزینهٔ بیشتر را دارند؟
چهاربیتیکردن مدل چه چیزی را ارزان میکند و چه چیزی را تغییر میدهد؟
چهاربیتیکردن چگونه حجم وزنها و هزینهٔ اجرا را کاهش میدهد و چه اثری بر کیفیت، سرعت، KV cache و ظرفیت سرویس دارد؟ همراه با مقایسهٔ واقعی نسخههای Qwen3-8B.
چهاربیتیکردن مدل چه چیزی را ارزان میکند و چه چیزی را تغییر میدهد؟
چهاربیتیکردن چگونه حجم وزنها و هزینهٔ اجرا را کاهش میدهد و چه اثری بر کیفیت، سرعت، KV cache و ظرفیت سرویس دارد؟ همراه با مقایسهٔ واقعی نسخههای Qwen3-8B.
INT8 یا FP8؛ پشتیبانی واقعی GPU در اجرای مدلهای زبانی
تفاوت قالب هشتبیتی مدل با مسیر اجرای آن روی GPU؛ بررسی H200، B200 و B300 و نقش کرنل، حافظه و کیفیت در انتخاب زیرساخت استنتاج.
INT8 یا FP8؛ پشتیبانی واقعی GPU در اجرای مدلهای زبانی
تفاوت قالب هشتبیتی مدل با مسیر اجرای آن روی GPU؛ بررسی H200، B200 و B300 و نقش کرنل، حافظه و کیفیت در انتخاب زیرساخت استنتاج.
AirLLM و اجرای لایهبهلایه؛ مدل بزرگ با حافظهٔ کم، با چه هزینهای؟
AirLLM چگونه مدل بزرگ را با VRAM کم اجرا میکند؟ هزینهٔ انتقال وزن، RAM و SSD، حافظهٔ کانتکست و تفاوت کاربرد پژوهشی با سرویس سازمانی؛ همراه با چهار جدول و بررسی آموزش LoRA.
AirLLM و اجرای لایهبهلایه؛ مدل بزرگ با حافظهٔ کم، با چه هزینهای؟
AirLLM چگونه مدل بزرگ را با VRAM کم اجرا میکند؟ هزینهٔ انتقال وزن، RAM و SSD، حافظهٔ کانتکست و تفاوت کاربرد پژوهشی با سرویس سازمانی؛ همراه با چهار جدول و بررسی آموزش LoRA.
Ollama، vLLM، SGLang یا llama.cpp؛ برای اجرای مدل کدام را انتخاب کنیم؟
مقایسهٔ فنی چهار ابزار اجرای مدل؛ از همزمانی و KV cache تا GGUF، چند GPU، پایش و آزمون بار. کجا سادگی Ollama کافی است و چه زمانی vLLM یا SGLang انتخاب مناسبتری میشود؟
Ollama، vLLM، SGLang یا llama.cpp؛ برای اجرای مدل کدام را انتخاب کنیم؟
مقایسهٔ فنی چهار ابزار اجرای مدل؛ از همزمانی و KV cache تا GGUF، چند GPU، پایش و آزمون بار. کجا سادگی Ollama کافی است و چه زمانی vLLM یا SGLang انتخاب مناسبتری میشود؟
چرا سریعترین GPU لزوماً سریعترین پاسخ را نمیدهد؟
توان پردازشی بیشتر یا نرخ توکن بالاتر، همیشه به پاسخ سریعتر منتهی نمیشود. تفاوت زمان آغاز و تکمیل پاسخ، نقش حافظه و همزمانی، تقسیم کار GPU و LPU و هزینهٔ ارتباطات را بررسی میکنیم تا معیار انتخاب زیرساخت، ظرفیت خدمتدهی با کیفیت و تأخیر مورد نیاز باشد.
چرا سریعترین GPU لزوماً سریعترین پاسخ را نمیدهد؟
توان پردازشی بیشتر یا نرخ توکن بالاتر، همیشه به پاسخ سریعتر منتهی نمیشود. تفاوت زمان آغاز و تکمیل پاسخ، نقش حافظه و همزمانی، تقسیم کار GPU و LPU و هزینهٔ ارتباطات را بررسی میکنیم تا معیار انتخاب زیرساخت، ظرفیت خدمتدهی با کیفیت و تأخیر مورد نیاز باشد.
از یک کاربر تا سرویس سازمانی؛ چه زمانی مدل، تعداد نسخهها یا GPU را تغییر دهیم؟
از صف و کانتکست تا تکثیر مدل و تحمل خرابی؛ راهنمای رشد اقتصادی سرویس سازمانی با GPU متناسب، نمونههای مستقل و ظرفیت ابری با پرداخت بهاندازهٔ مصرف، همراه با مثالهای عددی.
از یک کاربر تا سرویس سازمانی؛ چه زمانی مدل، تعداد نسخهها یا GPU را تغییر دهیم؟
از صف و کانتکست تا تکثیر مدل و تحمل خرابی؛ راهنمای رشد اقتصادی سرویس سازمانی با GPU متناسب، نمونههای مستقل و ظرفیت ابری با پرداخت بهاندازهٔ مصرف، همراه با مثالهای عددی.
ترگمان زیر فشار ۳۰۰ درخواست همزمان؛ تجربهٔ سرویسدهی با تنها یک RTX 4090
تجربهٔ خدمت رایگان ترگمان با یک RTX 4090؛ رسیدن به حدود ۳۰۰ درخواست همزمان، صف، کندی پاسخ و لغو بخشی از درخواستها.
ترگمان زیر فشار ۳۰۰ درخواست همزمان؛ تجربهٔ سرویسدهی با تنها یک RTX 4090
تجربهٔ خدمت رایگان ترگمان با یک RTX 4090؛ رسیدن به حدود ۳۰۰ درخواست همزمان، صف، کندی پاسخ و لغو بخشی از درخواستها.
هزینهٔ واقعی اجرای مدل زبانی؛ خرید، اجاره یا API
خرید سرور، اجارهٔ GPU یا API برای یک کسبوکار ایرانی؟ مقایسهٔ هزینه با تعرفههای سرویسهای ایرانی، قیمت قطعات سیستم 4090 و محاسبهٔ دوسالهٔ مالکیت.
هزینهٔ واقعی اجرای مدل زبانی؛ خرید، اجاره یا API
خرید سرور، اجارهٔ GPU یا API برای یک کسبوکار ایرانی؟ مقایسهٔ هزینه با تعرفههای سرویسهای ایرانی، قیمت قطعات سیستم 4090 و محاسبهٔ دوسالهٔ مالکیت.