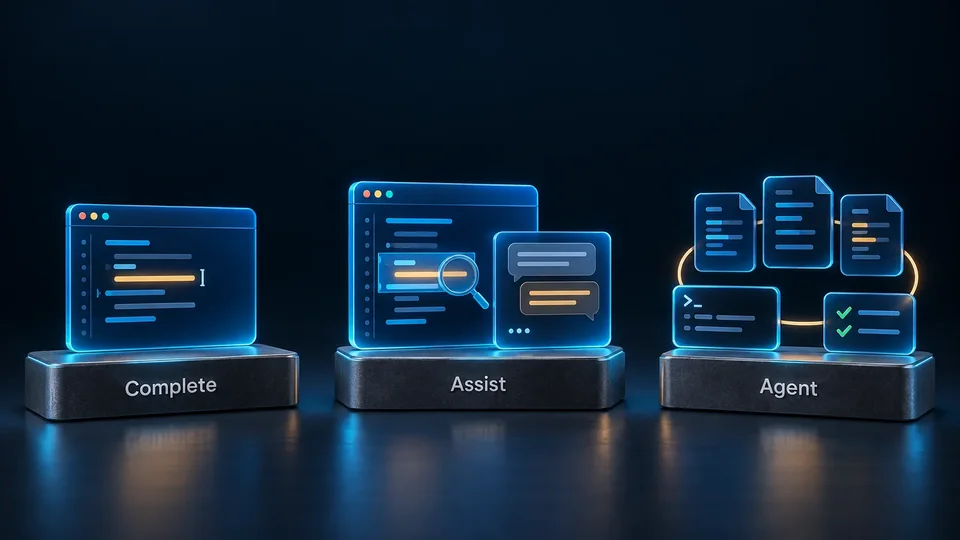
یک تیم نرمافزاری ممکن است هر سه خواسته را با عبارت «هوش مصنوعی برای کدنویسی» مطرح کند: هنگام تایپ، چند خط بعدی پیشنهاد شود؛ خطای یک تابع توضیح داده و اصلاح شود؛ یا یک مسئله از فهرست کارهای پروژه برداشته شود و تغییرات لازم تا مرحلهٔ اجرای آزمونها پیش برود. این درخواستها به یک میزان حافظه، یک نوع مدل و یک معیار کیفیت نیاز ندارند. انتخاب یک مدل بزرگ برای همهٔ آنها میتواند هزینه و تأخیر را بالا ببرد، بدون آنکه به همان نسبت کار بیشتری انجام شود.
برای تکمیلهای کوتاه و بخشی از کمکهای روزمره به برنامهنویس، مدل تخصصی کوچک نقطهٔ شروع معقولی است. هرچه کار به فهم وابستگیهای چند فایل، تشخیص علت خطا، تصمیمگیری میان راهحلها و اصلاحهای پیاپی نزدیک شود، توان استدلال و استفاده از ابزار اهمیت بیشتری پیدا میکند. همین تفکیک در مقالهٔ «برای هر کاربرد واقعاً چه اندازه مدلی لازم داریم؟ از مدل تخصصی و SLM تا LLM» توضیح داده شده است؛ در اینجا معیار آن را به سه کار مشخص در توسعهٔ نرمافزار تبدیل میکنیم.
سه کار متفاوت پشت یک پنجرهٔ ویرایشگر
مرز این سه کاربرد را باید از نوع کار و میزان اختیاری که به نرمافزار داده میشود شناخت. یک محصول ممکن است هر سه حالت را داشته باشد و حتی برای هر حالت مدل جداگانهای فراخوانی کند. نمایش پاسخ در محیط توسعه، بهخودیخود آن را به عامل برنامهنویسی تبدیل نمیکند؛ همانطور که ویرایش یک قطعهٔ انتخابشده الزاماً به معنای واگذاری یک کار چندمرحلهای نیست.
| نیاز | نمونهٔ درخواست | خروجی مورد انتظار | معیار اصلی انتخاب |
|---|---|---|---|
| تکمیل کد | «ادامهٔ این عبارت یا بدنهٔ این تابع را پیشنهاد بده» | پیشنهاد کوتاه و سازگار با کد اطراف نشانگر | زمان رسیدن پیشنهاد قابل استفاده و مقدار کدی که پذیرفته میشود و باقی میماند |
| دستیار کد | «علت این خطا را توضیح بده و همین بخش را اصلاح کن» | توضیح درست، کد یا تغییر مشخص با هدایت برنامهنویس | درستی اصلاح و کاهش زمانی که صرف فهم و بازبینی میشود |
| عامل برنامهنویسی | «این مسئله را در مخزن پیدا کن، اصلاح کن و آزمونها را اجرا کن» | مجموعهتغییر قابل بازبینی پس از چند مرحلهٔ جستوجو، ویرایش و اجرا | سهم کارهای درست حلشده، زمان پایان کار و هزینهٔ هر کار موفق |
این تقسیمبندی، ترتیب «خوب، بهتر، بهترین» نیست. عامل چندمرحلهای برای تکمیل نام یک متغیر انتخاب مناسبی نیست و مدل سریعِ تکمیل کد نیز صرفاً به دلیل نوشتن چند تابع درست، گزینهٔ اثباتشدهای برای تغییر معماری یک سامانه محسوب نمیشود. انتخاب باید از ترکیب درخواستهای واقعی تیم آغاز شود، نه از پیشرفتهترین حالتی که یک محصول در صفحهٔ معرفی خود نمایش میدهد.
برای هر مسیر، شاهد همان مسیر را بخوانید
کارت StarCoder2-3B برای HumanEval مقدار pass@1 برابر 31.7 و برای HumanEval+ برابر 27.4 گزارش میکند. این مدل پایه برای تکمیل کد است. امتیازهای آن را با موفقیت عاملِ ویرایش چند فایل یا رضایت از گفتوگو یکی نکنید. برای انتخاب بین دستیارهای دستورپذیر، جدول Qwen نمونهٔ روشنی دارد: رتبهٔ LiveCodeBench و Aider-Polyglot یکسان نیست. وقتی harness، ابزارها یا بودجهٔ تلاش متفاوتاند، یکسان بودن نام بنچمارک برای ساخت رتبهٔ مشترک کافی نیست.
حل مسئله یا ویرایش کد؟
برای دستیار دستورپذیر، معیارهای ویرایش مخزن و حل مسئله را جدا مقایسه کنید. StarCoder2-3B برای تکمیل کد/FIM است؛ HumanEval کیفیت گفتوگو یا عامل ویرایشگر را نمیسنجد.
وقتی رابط و وظیفه مشخص است: تکمیل داخل ادیتور، اصلاح چند فایل یا حل یک مسئله.
پارامتر فعال MoE مبنای حافظهٔ وزنهای مقیم نیست.
تکمیل کد: پیشنهاد باید پیش از ادامهٔ کار برسد
در تکمیل کد، برنامهنویس معمولاً منتظر یک پاسخ بلند نمیماند. اگر پیشنهاد زمانی ظاهر شود که او عبارت را نوشته یا نشانگر را جابهجا کرده است، کیفیت آن دیگر ارزش قبلی را ندارد. بنابراین زمان مشاهدهٔ پیشنهاد قابل استفاده، از لحظهٔ درخواست در ویرایشگر، مهمتر از یک عدد جداافتاده برای سرعت تولید توکن است. این زمان، آمادهسازی زمینه، ارتباط شبکه، انتظار در صف و تولید پاسخ را نیز دربر میگیرد؛ بهتر است رفتار آن در ساعات شلوغ و صدک ۹۵ تأخیر هم دیده شود.
مدل باید بداند پیش و پس از محل درج چه چیزی وجود دارد. در روش Fill-in-the-Middle یا FIM، بخش قبل و بعد از جای خالی با قالب مخصوص مدل ارائه میشوند تا قسمت میانی تولید شود. برای نمونه، وقتی امضای تابع و عبارت بازگشت از قبل وجود دارند، پیشنهاد باید با هر دو سازگار باشد. کارت رسمی Qwen2.5-Coder-1.5B کاربرد FIM را برای نسخهٔ پایه ذکر میکند و آن را برای گفتوگو توصیه نمیکند؛ StarCoder2-3B نیز با هدف FIM آموزش دیده و نسخهٔ instruction-tuned نیست.
برای این کار، شروع مقایسه با مدلهای تخصصی حدود ۱ تا ۳ میلیارد پارامتر و افزودن یک گزینهٔ حدود ۷ میلیاردی، پیشنهاد عملی مناسبی است. این بازه حداقل فنی یا تضمین کیفیت نیست؛ هدف آن است که پیش از تحمیل هزینهٔ یک مدل بزرگ، امکان پاسخگویی سریع با مدل کوچک بررسی شود. مستندات انتخاب مدل تکمیل کد در Continue نیز نسخههای ۱٫۵ و ۷ میلیاردی Qwen2.5-Coder را در گزینههای متنباز این نقش قرار میدهد.
نرخ پذیرش پیشنهاد بهتنهایی کافی نیست. کاربر ممکن است پیشنهادی را بپذیرد و چند ثانیه بعد بیشتر آن را حذف کند؛ همچنین افزایش تعداد یا طول پیشنهادها میتواند این نرخ را گمراهکننده کند. در کنار تأخیر، باید مقدار کد باقیمانده پس از یک بازهٔ تعریفشده و مزاحمت پیشنهادها سنجیده شود. لغو درخواستهای قدیمی هنگام ادامهٔ تایپ و محدودکردن طول خروجی نیز بخشی از طراحی یک سرویس تکمیل خوب است، نه ویژگیای که صرفاً با بزرگترکردن مدل به دست بیاید.
دستیار کد: ارزش پاسخ به اصلاح درست است
دستیار کد با پرسش و دستور کار میکند: توضیح یک تابع، پیدا کردن علت خطا، نوشتن آزمون، تبدیل یک الگوی تکراری یا پیشنهاد اصلاحی محدود. برای این نقش معمولاً نسخهٔ Instruct یا Chat نقطهٔ شروع مناسبتری از نسخهٔ پایهٔ مخصوص ادامهدادن کد است. در کارهای محدود، میتوان مقایسه را از مدلهای تخصصی حدود ۳ تا ۸ میلیارد پارامتر آغاز کرد و برای درخواستهای دشوارتر یک گزینهٔ حدود ۱۴ میلیاردی یا قویتر در نظر گرفت؛ نتیجهٔ مقایسه باید به نوع درخواست تفکیک شود.
اطلاعاتی که به دستیار میرسد، بخش بزرگی از مسئله است. مدلی که فقط پیام خطا را دیده، ممکن است API یا نوع دادهٔ اشتباهی فرض کند؛ همان مدل با دیدن امضای تابع، نوع ورودی، نسخهٔ کتابخانه و آزمون مرتبط میتواند اصلاح قابل استفادهتری پیشنهاد دهد. «کانتکست بزرگ» نیز زمانی مفید است که اطلاعات لازم در آن باشد. افزودن دهها فایل نامرتبط، جای پیدا کردن تعریف درست و وابستگیهای واقعی را نمیگیرد.
برای مثال، نوشتن یک تبدیل سادهٔ JSON با schema معلوم، با یافتن خطای همزمانی در چند سرویس همسطح نیست. در اولی دامنه محدود و نتیجه نسبتاً روشن است؛ در دومی باید ترتیب رخدادها، اثر جانبی، فرضهای سیستم و شواهد ناقص کنار هم قرار گیرند. مدل کوچک برای بخشی از کار اول میتواند کافی باشد، اما تعمیم همان نتیجه به تحلیل معماری یا خطاهای پیچیده، تصمیم قابل اتکایی نیست. اگر درخواست فقط تغییر نام یک نماد یا قالببندی قطعی است، ابزار refactoring و formatter ویرایشگر نیز باید پیش از افزودن مدل در نظر گرفته شوند.
کیفیت دستیار را میتوان با مجموعهای از خطاها و تغییرات واقعی تیم سنجید: آیا اصلاح کامپایل میشود، آزمون مرتبط را میگذراند، رفتار مورد انتظار را حفظ میکند و بازبینی آن چه زمانی میگیرد؟ روانی توضیح فارسی، درستی کد و شناخت چارچوب سه ویژگی جدا هستند. برای تیمی که فارسی سؤال میپرسد و با کد و مستندات انگلیسی کار میکند، این ترکیب باید در نمونهها حضور داشته باشد؛
عامل برنامهنویسی: انتخاب یک سامانه، فراتر از انتخاب وزن مدل
عامل برنامهنویسی باید پس از دریافت یک کار، گامهای بعدی را بر اساس نتیجهٔ گام قبلی انتخاب کند. ممکن است ابتدا در مخزن جستوجو کند، چند فایل را بخواند، فرضی دربارهٔ علت خطا بسازد، تغییری بدهد، آزمون اجرا کند و پس از دیدن شکست، مسیرش را اصلاح کند. در اینجا فقط تولید کد مطرح نیست؛ انتخاب ابزار، نگهداشتن اطلاعات لازم و بازگشت از یک مسیر ناموفق نیز بر نتیجه اثر میگذارند.
لایهای که این چرخه را اداره میکند، معمولاً agent framework یا scaffold نامیده میشود. این لایه تعیین میکند چه ابزارهایی وجود دارند، پیام خطا چگونه به مدل بازگردد، تاریخچه چگونه مدیریت شود و کار چه زمانی پایان یابد. برای نمونه، mini-SWE-agent یک طراحی ساده با اجرای فرمانهای bash و تاریخچهٔ خطی ارائه میکند و الزاماً از رابط اختصاصی tool calling مدل استفاده نمیکند. بنابراین وجود برچسب «پشتیبانی از ابزار» تنها راه ساخت عامل نیست؛ سازگاری مدل با قرارداد عملیِ همان عامل اهمیت دارد.
وقتی عامل از فراخوانی ساختاریافتهٔ ابزار استفاده میکند، قالب گفتوگو، قالب آرگومانها و مفسر خروجی ابزار نیز باید با مدل هماهنگ باشند. مستندات tool calling در vLLM برای خانوادههای مختلف، تنظیمها و parserهای متفاوتی معرفی میکند. دریافت پاسخ از یک API سازگار با OpenAI بهتنهایی نشان نمیدهد که همان ترکیب، فراخوانی ابزار و ادامهٔ چرخهٔ عامل را هم درست انجام میدهد.
برای کارهایی مانند اصلاح محدود و نوشتن آزمون یک تابع، مدل کوچک همچنان نامزد قابل بررسی است. اما برای کار مبهم، تغییر چند فایل وابسته، مهاجرت کتابخانه یا اشکالی که به چند دور آزمایش نیاز دارد، باید مدلهای آموزشدیده برای کار با ابزار و وظایف چندمرحلهای نیز وارد مقایسه شوند. معیار، هزینهٔ انجام درست همان کار است: مدلی که در هر فراخوانی ارزانتر است ولی بارها تغییر نامربوط میدهد یا به مداخلهٔ مداوم نیاز دارد، لزوماً عامل ارزانتری نمیسازد.
چند مدل مشخص برای شروع مقایسه
مدلهای جدول زیر برای مقایسهٔ تکمیل کد، دستیار و عامل انتخاب شدهاند. تعداد پارامترها از کارت رسمی هر مدل گردآوری شده و کاربرد پیشنهادی بر اساس نوع آموزش و امکانات آن مشخص شده است؛ کیفیت هر مدل باید در همان نقش سنجیده شود. برای گزینههای بیشتر، قالبهای انتشار و تناسب سختافزار، باید به جدولهای راهنمای مدلهای زبانی مراجعه کرد؛ نام خانواده بهتنهایی جای شناسهٔ دقیق مدل را نمیگیرد.
| مدل و لینک رسمی | اندازهٔ اعلامی | نقش مناسب برای آغاز مقایسه | نکتهٔ تعیینکننده |
|---|---|---|---|
| Qwen2.5-Coder-1.5B | ۱٫۵۴ میلیارد | تکمیل کد با FIM | نسخهٔ پایه است؛ برای جایگزینی مستقیم مدل چت انتخاب نشده است |
| StarCoder2-3B | ۳ میلیارد | تکمیل کد و مقایسهٔ کیفیت پیشنهادهای محلی | آموزش FIM دارد؛ آموزش پیروی از دستور ندارد |
| Qwen2.5-Coder-7B-Instruct | ۷٫۶۱ میلیارد | توضیح کد، رفع خطای محدود و پیشنهاد تغییر با هدایت برنامهنویس | نسخهٔ Instruct است؛ موفقیت در این نقش، موفقیت خودکار در عامل چندمرحلهای را ثابت نمیکند |
| Qwen3-Coder-30B-A3B-Instruct | ۳۰٫۵ میلیارد کل؛ ۳٫۳ میلیارد فعال | دستیار پیشرفته و عامل برنامهنویسی | MoE و دارای قالب اختصاصی فراخوانی ابزار؛ حافظهٔ وزنها بر اساس شمار کل بررسی میشود |
| Devstral-Small-2-24B-Instruct-2512 | ۲۴ میلیارد | عامل برنامهنویسی و تغییرات در مخزن | برای کارهای agentic طراحی شده است؛ واژهٔ Small در نام، به معنای مدل چندمیلیاردی بسیار کوچک نیست |
| Qwen3-Coder-Next | ۸۰ میلیارد کل؛ ۳ میلیارد فعال | کارهای عامل با توجه به ظرفیت حافظهٔ استقرار | معماری ترکیبی و MoE دارد؛ ۳ میلیارد فعال، آن را از نظر حافظه هماندازهٔ مدل dense سهمیلیاردی نمیکند |
مجوز نیز متعلق به همان نسخه است: در کارتهای این جدول، مدلهای Qwen و Devstral با Apache-2.0 و StarCoder2 با BigCode OpenRAIL-M معرفی شدهاند. هنگام انتخاب نسخهٔ کوانتیزه، مخزن ناشر آن، مدل پایه، نوع کوانتیزهسازی و قالب مورد انتظار نرمافزار اجرا را کنار هم ببینید. وجود فایل GGUF بهتنهایی تضمین نمیکند که افزونهٔ ویرایشگر، قالب FIM یا فراخوانی ابزار آن مدل را درست به کار میگیرد؛ لینک مدل و نسخههای قابل استفاده باید از راهنمای LLM دنبال شوند.
کدام بنچمارک به کدام نیاز پاسخ میدهد؟
در مقایسهٔ مدلهای کد، یک نمرهٔ واحد میتواند سه سؤال متفاوت را مخلوط کند. LiveCodeBench از مسائل برنامهنویسی با زمان انتشار مشخص استفاده میکند و وظایفی مانند تولید کد و اصلاح آن را میسنجد؛ چنین آزمونی برای توان حل مسئله مفید است، اما زمان ظاهرشدن پیشنهاد در IDE یا کیفیت تغییر در یک مخزن سازمانی را مستقیماً اندازه نمیگیرد. نسخه و بازهٔ زمانی مجموعهٔ مسئلهها نیز بخشی از معنای نتیجه است.
در مقابل، SWE-bench بر حل مسئلههای مخزن تمرکز دارد و معیار اصلی آن سهم مسائل حلشده است. نسخهٔ Verified شامل ۵۰۰ مسئلهٔ پالایششدهٔ انسانی است؛ نمای Bash Only نیز مدلها را در محیط مشترک mini-SWE-agent مقایسه میکند. از این طراحی میتوان یک قاعدهٔ عملی گرفت: برای نسبتدادن تفاوت نتیجه به مدل، عامل و محیط باید کنترل شوند؛ برای انتخاب محصول نهایی، باید کل ترکیب مدل و عامل با هم سنجیده شود.
در تفسیر این امتیاز، نقد روش آزمون هم مهم است. OpenAI در ممیزی SWE-bench Verified از آزمونهای معیوب و آلودگی داده گزارش داد و در بازبینی ژوئیهٔ ۲۰۲۶ پیشنهاد قبلی خود دربارهٔ جایگزینی آن با SWE-bench Pro را نیز پس گرفت. این نقدِ یک گزارشدهنده است؛ برای انتخاب عامل، نتیجهٔ حل مسئله روی مخزن و آزمونهای خودمان همچنان لازم است.
| موضوع مقایسه | آزمون نزدیک به نیاز واقعی | چیزی که باید ثبت شود | استنتاجی که نباید از آن کرد |
|---|---|---|---|
| تکمیل کد | بازپخش جایگاههای درج از پروژه و سپس استفادهٔ واقعی در IDE | تأخیر تا پیشنهاد مفید، پذیرش و ماندگاری پیشنهاد، زبان و نوع فایل | نمرهٔ حل مسئلهٔ الگوریتمی، تجربهٔ سریع تایپ را تضمین نمیکند |
| دستیار کد | سؤالها، خطاها و تغییرات محدود تیم؛ همراه با آزمونهای اجرایی | صحت اصلاح، حفظ رفتار، زمان بازبینی و نسخهٔ وابستگیها | توضیح قانعکننده یا کامپایلشدن، بهتنهایی درستی رفتار را ثابت نمیکند |
| عامل برنامهنویسی | مسئلههای مخزن با معیار پذیرش؛ در کنار بنچمارکی مانند SWE-bench | مدل و عامل، ابزارها، محیط، سقف زمان و تلاش، موفقیت و هزینه | درصد موفقیت دو ترکیب متفاوت را نمیتوان بدون دیدن شرایط به وزن مدل نسبت داد |
برای عامل، عبور از آزمونهایی که خودش نوشته کافی نیست. تغییر باید با نیاز مسئله سازگار باشد و آزمونهای معتبر قبلی را نیز حفظ کند؛ پاککردن یک آزمون شکستخورده یا ضعیفکردن شرط آن، حل مسئله به شمار نمیآید. همچنین آزمونهای عمومی ممکن است همهٔ نیازهای پروژه را پوشش ندهند. چند کار نماینده از مخزن خود تیم، همراه با بازبینی تغییر نهایی، فاصلهٔ میان نمرهٔ بنچمارک و ارزش واقعی را روشنتر میکند.
کد کمتر اما مرتبطتر؛ پیش از فاینتیون
برای آشناکردن دستیار با یک پروژه، اولین اقدام لزوماً آموزش مجدد مدل نیست. جستوجوی نام نمادها، دنبالکردن تعریف و محل استفاده با ابزار زبان، خواندن خطای کامپایل و بازیابی مستندات نسخهٔ درست میتوانند اطلاعات مورد نیاز را در زمان درخواست فراهم کنند. جستوجوی معنایی نیز برای یافتن مفهوم یا توضیح مفید است، اما جای جستوجوی دقیق یک نام تابع، مسیر یا پیام خطا را نمیگیرد. در یک مخزن، ترکیب این مسیرها از تکیهٔ کامل بر embedding کاربردیتر است.
همان اصل انتخاب مستقل بازیاب و پاسخگو در مقالهٔ انتخاب مدل زبانی، embedding و reranker برای دستیار اسناد سازمانی توضیح داده شده است؛ در کد باید ساختار نمادها و وابستگیها نیز به آن افزوده شود. اگر مشکل مدل، ندیدن تعریف تازهٔ یک API داخلی است، رساندن همان تعریف معمولاً قدم مستقیمتری از فاینتیون است. اگر مشکل، رعایتنکردن یک قالب ثابت یا الگوی تکراری با وجود اطلاعات کافی باشد، تنظیم دقیق با دادهٔ مناسب ارزش بررسی پیدا میکند؛ تفکیک این انتخابها در مقالهٔ RAG، CAG، KAG، Fine-tuning و Instruction tuning آمده است.
از یک اجرای محلی تا سرویس مشترک تیم
اجرای موفق یک درخواست روی GPU با ارائهٔ سرویس به چند برنامهنویس تفاوت دارد. تکمیل کد معمولاً درخواستهای کوتاه و پرتعداد دارد، در حالی که یک عامل میتواند ورودی بلند، چندین دور تولید و فاصلههایی برای اجرای ابزار داشته باشد. اگر همه در یک صف بدون اولویت مناسب قرار بگیرند، کار طولانی عامل میتواند پاسخ کوتاه و حساس به تأخیر را عقب بیندازد. تفکیک صفها و در صورت نیاز اختصاص منابع جدا، بخشی از انتخاب زیرساخت است.
مزیت مدل کوچک در اینجا فقط کمشدن حجم دانلود نیست. وزنهای کوچکتر، با فرض تناسب معماری و موتور اجرا، امکان بررسی GPU ارزانتر، نگهداشتن ظرفیت بیشتری برای زمینهٔ درخواستها یا افزودن replica برای درخواستهای مستقل را فراهم میکنند. البته تعداد اعضای تیم، تعداد کاربران فعال همزمان و تعداد درخواستهای واقعاً در حال تولید، یک عدد نیستند. ظرفیت سرویس باید با طول ورودی و خروجی و الگوی ترافیک سنجیده شود؛
| الگوی کار تیم | چیدمان مناسب برای بررسی | محل اصلی هزینه یا محدودیت |
|---|---|---|
| پیشنهاد کد برای تعداد زیادی ویرایشگر | مدل FIM کوچک، آمادهٔ پاسخ و دارای صف کوتاه؛ افزودن replica در صورت نیاز | تأخیر شبکه و صف، سرعت پیشنهاد کوتاه و بار لحظهای |
| گفتوگو دربارهٔ کد و اصلاحهای محدود | مدل Instruct کوچک یا متوسط با زمینهٔ مرتبط و امکان ارجاع کار دشوارتر | کیفیت اصلاح، طول ورودی و حافظهٔ درخواستهای فعال |
| عامل برای مسئلههای چندفایلی | مدل مناسب ابزار، محیط اجرای مستقل برای هر کار و سقف منابع مشخص | موفقیت هر کار، مجموع تلاشها، زمان آزمونها و مصرف CPU، RAM و GPU |
Ollama، vLLM، SGLang و llama.cpp در لایهٔ اجرای مدل و ارائهٔ رابط قرار میگیرند؛ افزونهٔ IDE و نرمافزار عامل، تجربهٔ تکمیل، گفتوگو و چرخهٔ ابزار را میسازند. برای انتخاب بین آنها باید پشتیبانی همان نسخهٔ مدل، قالب وزن، FIM، ابزارها و رفتار تحت بار بررسی شود. نام نرمافزار بهتنهایی ظرفیت کاربران را تعیین نمیکند؛ نقش و قابلیت موتورهای اجرا را در جدول نرمافزارهای سرویسدهی مقایسه کنید.
حافظهٔ GPU و هزینهٔ انجام کار
برای تکمیل کوچک و بسیاری از اصلاحهای محدود، بررسی یک کارت ۲۴ گیگابایتی مانند RTX 4090 نقطهٔ شروع قابل دفاعی است. مناسببودن مدل همچنان به قالب وزن، حافظهٔ زمان اجرا، طول زمینه و تعداد درخواستهای فعال بستگی دارد؛ جاگرفتن وزنها، وعدهٔ پشتیبانی از کانتکست حداکثری یا تعداد معینی کاربر نیست. تفاوت یک کارت ۲۴ گیگابایتی، کارت دارای ۴۸ گیگابایت حافظه و دو کارت ۲۴ گیگابایتی نیز در مقالهٔ اجرای مدلها روی RTX 4090 و تفاوت ۲۴ و ۴۸ گیگابایت بررسی شده است.
در مدلهای MoE باید شمار کل و فعال را جدا دید. بر اساس اندازههای گردشدهٔ ناشران، Qwen3-Coder-30B-A3B حدود ۳۰٫۵ میلیارد پارامتر کل و Qwen3-Coder-Next حدود ۸۰ میلیارد دارد؛ اگر صرفاً برای محاسبهٔ حجم خام، هر پارامتر را دقیقاً چهار بیت فرض کنیم، وزنها بهترتیب حدود ۱۵٫۲۵ GB و ۴۰ GB میشوند. این برآورد با واحد دهدهی است و سربار کوانتیزهسازی، بخشهای دارای دقت متفاوت، حافظهٔ زمینه و فضای کاری را شامل نمیشود؛ اندازهٔ فایل واقعی یا حداقل VRAM نیست. نزدیکبودن پارامترهای فعال این دو مدل، این تفاوت حافظه را حذف نمیکند.
کوانتیزهسازی میتواند اجرای یک مدل را روی کارت ارزانتر ممکن کند، اما نسخهٔ چهاربیتی باید در همان نقش بررسی شود: برای تکمیل، ماندگاری پیشنهاد؛ برای دستیار، درستی اصلاح؛ و برای عامل، موفقیت کل کار. صرف رسیدن به خروجی متنی کافی نیست و افزایش سرعت نیز به پشتیبانی موتور و سختافزار وابسته است. جزئیات این مبادله در مقالهٔ «چهاربیتیکردن مدل چه چیزی را ارزان میکند و چه چیزی را تغییر میدهد؟» آمده است.
برای عامل، هزینهٔ واقعی را بهتر است چنین تعریف کنیم: مجموع هزینهٔ اجرا، تلاشهای ناموفق و بازبینی انسانی، تقسیم بر تعداد کارهای پذیرفتهشده با معیار کیفیت ثابت. در یک مقایسه باید سقف زمان و منابع و نرخ موفقیت نیز کنار این عدد باشند؛ حذف کارهای دشوار نباید ظاهراً یک سامانه را ارزانتر نشان دهد. یک مدل قویتر ممکن است با تلاش کمتر بهصرفهتر باشد، و یک مدل کوچکتر ممکن است در کارهای محدود همان کیفیت را با منابع کمتر تحویل دهد.
خرید GPU قویتر نیز همهٔ زمان یک عامل را کوتاه نمیکند. اگر کار منتظر نصب وابستگی، ساخت پروژه، آزمون مرورگر یا اجرای مجموعهآزمون طولانی باشد، CPU، RAM، دیسک و محیط اجرا هم باید بررسی شوند. کارت حرفهای یا دیتاسنتری زمانی توجیه پیدا میکند که ظرفیت حافظه، بار همزمان، پایداری یا نیازهای استقرار آن در نتیجهٔ کار اثر قابل مشاهده داشته باشد؛ ملاک انتخاب، صرفاً وجود واژهٔ «عامل» در نام سرویس نیست.
یک انتخاب عملی برای تیم توسعه
برای شروع، درخواستهای تیم را در همین سه گروه جدا کنید و برای هر گروه چند کار نماینده با معیار پذیرش روشن داشته باشید. تکمیل را با یک مدل FIM کوچک، دستیار را با یک مدل کد Instruct کوچک یا متوسط، و عامل را با دو ترکیب مدل و محیط اجرا مقایسه کنید. آزمون عامل باید امکان خواندن فایل، اعمال تغییر، اجرای فرمان، دریافت خطا و ادامهٔ کار را پوشش دهد؛ آزمون تکمیل نیز باید در ویرایشگر و با رفتار واقعی تایپ انجام شود. شکست یک نقش، دلیل کافی برای کنارگذاشتن همان مدل در نقش دیگر نیست.
در استقرار عامل، محدودهٔ مخزن و ابزارها نیز بخشی از طراحی محصول است. اجرای هر کار در محیط جدا، حفظ امکان بازبینی تغییر و ندادن دسترسی بینیاز به اسرار یا محیط عملیاتی، اثر خطای احتمالی را محدود میکند؛ متن داخل مخزن نیز نباید خودبهخود به دستور معتبر برای گسترش دسترسی تبدیل شود. پس از این تفکیک، انتخاب نهایی میتواند سه مدل یا حتی دو مدل مشترک باشد؛ شرط آن است که هر نقش، با معیار خودش، زمان و هزینهٔ قابل قبولی برای تیم ایجاد کند.