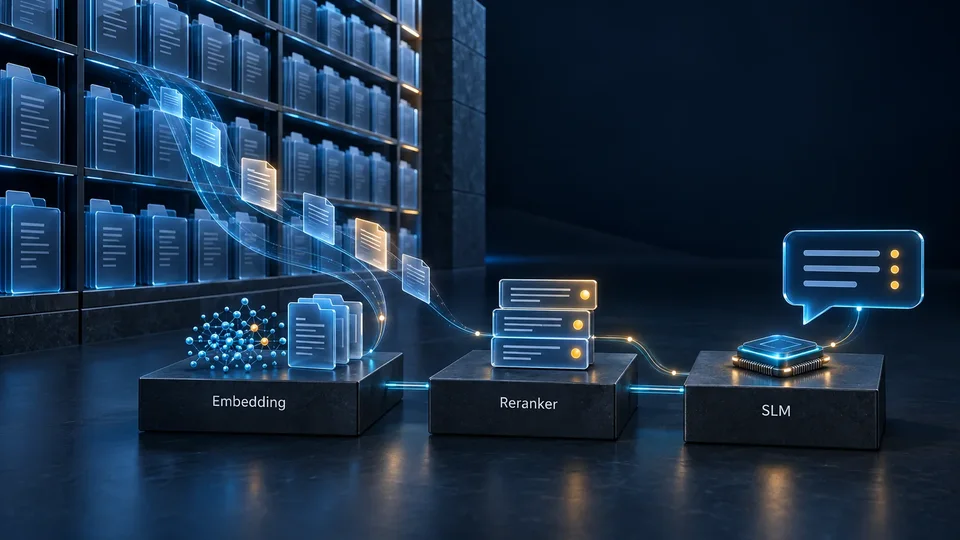
کارمندی میپرسد «برای تمدید این قرارداد چه تأییدهایی لازم است؟»، کارشناس پشتیبانی دنبال روش رفع یک خطا میگردد و همکار تازهوارد میخواهد مراحل ثبت درخواست مأموریت را بداند. پاسخ این پرسشها معمولاً در اسناد سازمان وجود دارد. دستیار باید سند معتبر را پیدا کند، بندهای مرتبط را درست بخواند و پاسخ کوتاهی بدهد که بتوان منبع آن را دید. برای این کار، توان تحلیل یک مدل بسیار بزرگ همیشه لازم نیست؛ کیفیت رساندن اطلاعات درست به مدل، بخش مهمتری از مسئله است.
اگر عمدهٔ درخواستهای یک سازمان از جنس یافتن دستورالعمل، پاسخ مستقیم از چند بند، استخراج اطلاعات روشن و خلاصهسازی محدود باشد، مدلهای کوچک میتوانند پاسخگوی بخش عمدهٔ همین نیازها باشند. در چنین دستیارهایی، مدل ۳ یا ۴ میلیاردی در کنار یک مدل ۷ یا ۸ میلیاردی، نقطهٔ شروع معقولی برای مقایسه است. رفتن سراغ مدلهای بزرگتر زمانی توجیه پیدا میکند که کیفیت مورد نیاز با طراحی مناسب بازیابی و مدل کوچکتر حاصل نشود؛ منطق این انتخاب در «برای هر کاربرد واقعاً چه اندازه مدلی لازم داریم؟ از مدل تخصصی و SLM تا LLM» توضیح داده شده است.
برای رسیدن به این نتیجه، باید انتخاب مدل پاسخگو را از انتخاب embedding و reranker جدا کرد. هر سه میتوانند مدلهای یادگیری ماشین باشند، اما کار یکسانی انجام نمیدهند و بزرگتر کردن یکی، نقص دیگری را خودبهخود برطرف نمیکند. این یادداشت معیار انتخاب هر جزء، چند گزینهٔ عملی برای شروع و روشی برای تشخیص محل خطا را کنار هم قرار میدهد؛ گزینههای بیشتر برای جستوجو و بازچینش در جدول مدلهای embedding و reranker آمده است.
سند متنی، اسکن و اطلاعات زنده یک مسیر ندارند
اگر PDF متن قابل استخراج دارد، ابتدا همان متن را با عنوان، شمارهٔ صفحه و نسخهٔ سند نمایه کنید. اگر پاسخ به نمودار، چیدمان یا رابطهٔ سلولهای جدول وابسته است، کیفیت OCR و بازیابی تصویری را روی نمونهٔ همان اسناد مقایسه کنید. بازیاب تصویری صفحهٔ مرتبط را پیدا میکند؛ مدل پاسخگو باید مشخص کند پاسخ از کدام بخش سند گرفته شده است. جمع فروش یا موجودی امروز نیز باید از محاسبه روی دادهٔ معتبر و اتصال به سامانه برسد، نه از چند قطعهٔ بازیابیشده.
| نوع داده | مسیر شروع | شاهد لازم در پاسخ |
|---|---|---|
| متن PDF، نامه و آییننامه | استخراج متن با عنوان، صفحه و نسخه؛ جستوجوی واژهای و در صورت نیاز برداری | بند و صفحهٔ معتبر سند |
| اسکن، نمودار و جدول تصویری | OCR با حفظ چیدمان؛ مقایسه با بازیابی تصویری روی نمونهٔ سند | متن استخراجشده یا ناحیهٔ قابل بازبینی صفحه |
| اطلاعات زندهٔ CRM و ERP | اتصال با دسترسی محدود و پرسوجوی مجاز | رکورد منبع و زمان دریافت |
| جمع، شمارش و گزارش جدولها | SQL، ابزار BI یا کد روی تمام ردیفهای معتبر؛ مدل برای توضیح نتیجه | محاسبهٔ قابل تکرار و دامنهٔ داده |
برای آزمون مسیر تصویری، Qwen3-VL-Embedding-2B صفحههای مرتبط را بازیابی میکند و Qwen3-VL-Reranker-2B نامزدها را دوباره امتیاز میدهد؛ هیچکدام پاسخ مولد نمینویسند. نسخههای ۸ میلیاردی گزینهٔ مقایسهاند، نه نقطهٔ شروع اجباری. حد ورودی اعلامشده برای این وظیفه ۳۲ هزار توکن است و پشتیبانی کمدقتسازی در کارت embedding به بردار خروجی مربوط است. امتیاز MMEB یا ViDoRe هم ارزیابی اختصاصی فارسی نیست.
برای مبلغ، شناسه و بند قرارداد، پاسخ باید به متن یا بخش مشخصی از صفحه وصل باشد. در مقایسهٔ OCR و مسیر تصویری، علاوه بر پیدا شدن صفحهٔ درست، زمان نمایهسازی، حجم نمایه و تأخیر هر پرسش را ثبت کنید؛ مدل تصویری ۲ میلیاردی الزاماً هزینهٔ اجرای یک مدل متنی هماندازه را ندارد.
سه جزء با سه مسئولیت متفاوت
در یک مسیر متداول RAG، اسناد ابتدا آماده و قطعهبندی میشوند و برای قطعهها بردار ساخته میشود. هنگام پرسش، سامانه نامزدهای مرتبط را پیدا میکند؛ reranker میتواند همین نامزدها را دقیقتر مرتب کند و در پایان، مدل پاسخگو از شواهد انتخابشده پاسخ میسازد. همهٔ درخواستها الزاماً به تمام این مراحل نیاز ندارند: برای پیدا کردن شمارهٔ دقیق یک بخشنامه، جستوجوی شناسه ممکن است کافی باشد و برای نمایش بند مربوط، شاید تولید متن تازه اصلاً لازم نباشد.
| جزء | مسئولیت اصلی | خروجیای که به مرحلهٔ بعد میدهد |
|---|---|---|
| مدل embedding و نمایهٔ جستوجو | بازنمایی متن برای پیدا کردن قطعههای مرتبط؛ معمولاً در کنار جستوجوی واژگانی | فهرستی از نامزدهای بازیابیشده |
| مدل reranker یا بازرتبهبند | بررسی ارتباط پرسش با هر نامزد و مرتبکردن دوبارهٔ آنها | فهرستی مرتبتر برای انتخاب شواهد |
| مدل زبانی پاسخگو | خواندن شواهد، پاسخ به پرسش، حفظ قیود و ارجاع به منبع | پاسخ قابل استفاده و قابل پیگیری |
در الگوی رایج، embedding متن پرسش و سند را جداگانه به بردار تبدیل میکند؛ به همین دلیل بردار اسناد را میتوان از قبل ساخت. یک reranker از نوع cross-encoder، پرسش و قطعهٔ سند را با هم بررسی میکند و نمرهٔ ارتباط میدهد، بنابراین هزینهٔ آن برای هر جفت پرسش و سند تکرار میشود. همین تفاوت توضیح میدهد چرا جستوجوی اولیه روی آرشیو بزرگ و بازرتبهبندی تعداد محدودی نامزد از هم جدا میشوند. نمونهٔ روشن این معماری در راهنمای Retrieve & Re-Rank در Sentence Transformers آمده است.
چرا دستیار اسناد اغلب به مدل پاسخگوی بزرگ نیاز ندارد؟
در پاسخگویی مستند، قرار نیست مدل همهٔ آییننامهها، قراردادها و دستورالعملهای سازمان را در وزنهای خود حفظ کرده باشد. اطلاعات مرتبط هنگام درخواست در اختیار آن قرار میگیرد و کار مدل، استفادهٔ درست از همین اطلاعات است. یک آرشیو یکمیلیونصفحهای الزاماً مدل پاسخگوی بزرگتری از آرشیو دههزارصفحهای نمیخواهد؛ رشد آرشیو ابتدا بر نمایه، کیفیت جستوجو و مدیریت نسخهها اثر میگذارد. آنچه نیاز به توان مدل را بیشتر میکند، دشواری فهم و ترکیب شواهدی است که برای پاسخ لازماند.
در پیادهسازی چت با فایل در ترگمان، پاسخگو همان Aya Expanse هشتمیلیاردیِ فاینتیونشده بود و برای بازیابی از Qdrant و مدل multilingual-e5-large-instruct استفاده کردیم. مدل embedding روی همان GPU اجرا میشد؛ بنابراین در بودجهٔ حافظه فقط وزنهای پاسخگو مطرح نبود. همچنین OCR نداشتیم و PDF اسکنشدهٔ فاقد متن قابل استخراج، ورودی قابل استفادهای برای این مسیر نبود. این تجربه نشان میدهد انتخاب مدل پاسخگو باید همراه با طراحی بازیابی، مصرف منابع اجزا و مسیر استخراج متن انجام شود.
تفاوت را میتوان در همان مثال قرارداد دید. پرسش «طبق این دستورالعمل، چه کسی درخواست تمدید را تأیید میکند؟» ممکن است با خواندن یک بند روشن پاسخ داده شود. پرسش «با توجه به سه قرارداد، دو الحاقیه و استثنای مربوط به این واحد، آیا تمدید بدون تأیید جدید مجاز است؟» به تشخیص رابطهٔ اسناد، تقدم نسخهها و تحلیل استثنا نیاز دارد. نام هر دو کاربرد «دستیار اسناد» است، اما بار شناختی آنها یکسان نیست و نباید سختافزار همهٔ درخواستهای ساده را از روی دشوارترین نمونه انتخاب کرد.
پژوهشها نیز نشان میدهند تخصص و طراحی سامانه میتواند فاصلهٔ اندازه را جبران کند. برای نمونه، نویسندگان Pleias-RAG برای مدلهای تخصصی ۳۵۰ میلیون و یک میلیاردپارامتری، در آزمونهای مشخص RAG مانند HotPotQA و 2Wiki، نتایج قابل رقابت با برخی مدلهای عمومی بزرگتر گزارش کردهاند. این نتیجه به آموزش ویژهٔ آن مدلها و دامنهٔ ارزیابی مربوط است؛ بهویژه پشتیبانی زبانی مطرحشده در آن پژوهش را نباید تضمین کیفیت فارسی دانست. پیام کاربردی آن برای انتخاب، اهمیت توان پاسخگویی مستند در کنار تعداد پارامترهاست.
جدول زیر پیشنهاد برای شروع مقایسه است. بازهها مرز قطعی توانایی نیستند؛ کیفیت آموزش، زبان، طول زمینه و پیچیدگی دستور میتوانند نتیجه را تغییر دهند. برای کاربردهای مستقیم، ابتدا مدل کوچک را با شاهد درست امتحان کنید؛ برای کار تحلیلی، مقایسهٔ مدل قویتر از ابتدا ارزش دارد.
| نوع درخواست | نقطهٔ شروع برای مدل پاسخگو | چه زمانی توان بیشتری لازم میشود؟ |
|---|---|---|
| پیدا کردن سند، بند یا شناسهٔ دقیق | جستوجو و نمایش منبع؛ گاهی بدون مدل مولد | اگر پرسش مبهم باشد یا بازنویسی و توضیح لازم شود |
| پاسخ مستقیم از چند بند روشن | مدل دستورپذیر حدود ۳ تا ۸ میلیاردی | اگر زبان تخصصی، قیود متعدد یا متن مبهم باعث خطای پایدار شود |
| استخراج فیلد و تبدیل به قالب مشخص | قواعد یا مدل تخصصی؛ سپس مدل ۱ تا ۴ میلیاردی برای دامنهٔ محدود | تنوع زیاد قالب و نیاز به استنباط اطلاعاتی که صریح نوشته نشدهاند |
| خلاصهٔ کوتاه و مقایسهٔ محدود چند متن | مقایسهٔ مدل ۴ و ۸ میلیاردی | اگر حفظ جزئیات، استثناها یا پوشش همهٔ بندها دشوار باشد |
| جمعبندی چند سند متعارض یا تحلیل چندمرحلهای | مقایسهٔ مدلهای ۸ تا ۱۴ میلیاردی با نامزدی قویتر، مثلاً ۳۲ میلیاردی | اگر با شواهد کامل هم استدلال، تقدم نسخه یا نتیجهگیری نادرست بماند |
| شمارش، جمعزدن و گزارش جامع از کل آرشیو | پرسوجوی ساختاریافته و پردازش کامل داده؛ مدل برای تفسیر و بیان نتیجه | اگر مسئله به استخراج ساختار یا تحلیل پیچیده نیاز داشته باشد؛ بزرگکردن مدل جای پوشش کامل داده را نمیگیرد |
embedding را با جستوجوی واقعی سازمان انتخاب کنیم
برای embedding، پرسش اصلی این است که آیا قطعهٔ درست وارد فهرست نامزدها میشود یا نه. مدل ممکن است در یک جدول رتبهبندی عمومی امتیاز خوبی داشته باشد، اما در اصطلاحات داخلی، کد قطعات، نام فرمها یا پرسش فارسی دربارهٔ سند انگلیسی ضعیفتر عمل کند. مجموعهٔ آزمون باید همین تفاوتها را نشان دهد: فارسی رسمی و محاورهای، متن ترکیبی فارسی و انگلیسی، نام محصول، اختصار و غلطهای متداول. مجموعهٔ MIRACL آزمون بازیابی فارسی هم دارد و برای مقایسهٔ اولیه مفید است، ولی جای نمونههای واقعی اسناد سازمان را نمیگیرد.
جستوجوی معنایی نیز تمام مسئلهٔ جستوجو نیست. شباهت مفهومی برای «مرخصی استعلاجی» و بیان محاورهای همان نیاز مفید است، اما شمارهٔ قرارداد، کد تجهیز و شمارهٔ نسخه باید دقیق حفظ شوند. ترکیب بازیابی برداری با جستوجوی واژگانی مانند BM25، گزینهٔ مهمی برای این محیط است. نتایج دو روش را میتوان با روشی مانند RRF ترکیب کرد؛ مستندات RRF در Elasticsearch نمونهای از ادغام رتبهها را نشان میدهد. جمع کردن مستقیم نمرهٔ BM25 با cosine similarity، بدون توجه به مقیاس و تنظیم روش، معادل چنین ادغامی نیست.
نحوهٔ استفاده از مدل به اندازهٔ انتخاب نام آن اهمیت دارد. برای نمونه، multilingual-e5-small در بازیابی نامتقارن به پیشوندهای query: و passage: متکی است و متنهای بلند را تا سقف ورودی خود میبُرد؛ Qwen3-Embedding برای پرسش از قالب دستور مشخص استفاده میکند. pooling، نرمالسازی، طول مجاز و قالب ورودی باید مطابق همان مدل باشند. همچنین encoder پرسش و سند باید در فضای برداری سازگار کار کنند؛ برابر بودن تعداد ابعاد دو بردار، سازگاری دو مدل متفاوت را ثابت نمیکند. دستورهای هر دو خانواده در راهنمای E5 و کارت Qwen3-Embedding آمدهاند.
تعداد ابعاد نیز بخشی از هزینه است. برای یک میلیون قطعه، ذخیرهٔ یک بردار ۳۸۴بعدی float32 برای هر قطعه حدود ۱٫۵۴ GB فضای خام میخواهد؛ با ۱۰۲۴ بُعد این مقدار حدود ۴٫۱۰ GB میشود. این اعداد از ضرب تعداد قطعهها در ابعاد و چهار بایت به دست میآیند و متن، فراداده، ساختار نمایه و نسخههای اضافی را شامل نمیشوند. این بردارها الزاماً در VRAM نگهداری نمیشوند. کاهش بُعد با روش پشتیبانیشدهٔ مدل میتواند هزینه را کم کند، اما بریدن دلخواه ابعاد هر embedding، روش عمومی و تضمینشدهای نیست.
هزینهٔ تغییر انتخاب را هم باید دید. تعویض مدل embedding معمولاً به ساخت دوبارهٔ بردارهای اسناد و نمایهٔ سازگار نیاز دارد؛ تغییر قطعهبندی نیز میتواند همین اثر را داشته باشد. در مقابل، تعویض پاسخگو یا reranker، تا وقتی بازنمایی اسناد و قطعهبندی ثابت مانده، معمولاً چنین بازسازیای نمیخواهد. این تفاوت، ثبت نسخهٔ مدل، تنظیمات آمادهسازی و طرح نمایه را از ابتدا ارزشمند میکند.
برای بازیابی، زبان و وظیفه را جدا ببینید
گزارش E5 روی MIRACL فارسی، nDCG@10 را برای Small برابر 53.3، Base برابر 57.4، Large برابر 59.0 و Large-Instruct برابر 59.4 گزارش میکند. در اسپانیایی این اعداد 51.2، 51.5، 52.9 و 53.7 هستند. اینها نتایج بازیابیاند، نه کیفیت پاسخ تولیدشده. همچنین در PTEB، Tooka-Large با میانگین کل 72.05 بالاتر از Small با 70.62 است، ولی امتیاز بازیابی Small بالاتر است: 61.24 در برابر 59.80. امتیاز تجمیعی وظایف PTEB با nDCG یک مجموعهٔ بازیابی قابل جمع یا رتبهبندی مشترک نیست.
شروع انتخاب برای بازیابی فارسی
E5 در MIRACL فارسی و Tooka/Jina در PTEB ارزیابی شدهاند. MIRACL کیفیت بازیابی سند را میسنجد؛ PTEB چند وظیفه را پوشش میدهد و امتیاز کل آن با نتیجهٔ بازیابی یکسان نیست.
برای جستوجوی متن فارسی، با ثبت طول قطعه و پیشوند صحیح هر مدل؛ برای Tooka پرسش با «سوال: » و سند با «متن: » طبق کارت ناشر.
میانگین بالاتر Tooka-Large به معنی بازیابی بهتر از Small نیست.
بازیابی برای اسپانیایی
E5-Small خط پایهٔ کمحجمتری است؛ Large-Instruct در همین گزارش MIRACL اسپانیایی امتیاز بالاتری دارد. شواهد Qwen در این مقایسه تجمیعی و چندزبانهاند، نه مختص اسپانیایی.
پرسش و سند هر دو اسپانیایی باشند؛ بازیابی میانزبانی را جداگانه مشخص کنید.
اختلاف 51.2 تا 53.7 شواهدی برای کیفیت پاسخ نهایی چت یا پوشش تمام گونههای اسپانیایی نیست.
بازیابی برای انگلیسی
Large و Large-Instruct را گونههای مجزا بگیرید: در MIRACL انگلیسی امتیاز Large بالاتر است. برای افزودن reranker، مقایسهٔ Qwen با نامزدهای یکسان قابل استفاده است.
وقتی شواهد تکزبانه مهمتر از میانگین چندزبانه است.
واژهٔ Instruct تضمین برتری در همهٔ وظایف نیست.
reranker چه چیزی را بهتر میکند و چه چیزی را نمیتواند جبران کند؟
فرض کنیم جستوجوی اولیه چند بند دربارهٔ «تمدید قرارداد» پیدا کرده است. یکی نسخهٔ قدیمی دستورالعمل است، یکی دربارهٔ قرارداد تأمینکننده است و دیگری دقیقاً به نوع قرارداد مورد پرسش مربوط میشود. reranker میتواند با دیدن پرسش و متن هر نامزد، ارتباط آنها را دقیقتر بررسی کند. اعتبار زمانی و نوع قرارداد هم باید از فراداده و قواعد سند کمک بگیرند؛ نباید تمام تشخیص معتبر بودن سند را به نمرهٔ شباهت واگذار کرد.
محدودیت مهم این مرحله روشن است: بازرتبهبندیِ همان فهرست نمیتواند سندی را که اصلاً بازیابی نشده وارد پاسخ کند. از سوی دیگر، reranker هزینهٔ محاسباتی اضافه میکند؛ تعداد نامزدها، طول هر جفت پرسش و سند و batch روی تأخیر آن اثر دارند. برای نمونهٔ اولیه میتوان ۳۰ تا ۵۰ نامزد را بررسی کرد و تعداد کمتری شاهد به مدل داد، اما این بازه صرفاً تنظیم آغازین است. معیار بهتر، حفظ شواهد لازم در بودجهٔ زمانی و توکنی سامانه است، نه بیشترین تعداد نامزد ممکن.
وجود reranker هم برای همهٔ درخواستها الزامی نیست. اگر جستوجوی یک شناسهٔ یکتا سند درست را پیدا کرده یا بازیابی اولیه در دامنهٔ محدود از قبل کیفیت کافی دارد، سود مرحلهٔ اضافه ممکن است کم باشد. در مقابل، برای آرشیوی با بندهای مشابه، عبارتهای تکراری و اسناد نزدیک به هم، ارزش آن بیشتر میشود. راهنمای BGE reranker نیز خروجی را نمرهٔ ارتباط معرفی میکند؛ حتی اگر نمره به بازهٔ صفر تا یک تبدیل شده باشد، نباید آن را احتمال صحت پاسخ نهایی فرض کرد.
مقایسهٔ بازچینی با نامزدهای یکسان
در آزمایش Qwen، همهٔ rerankerها ۱۰۰ نامزدِ بازیابیشده با Qwen3-Embedding-0.6B را دریافت میکنند. در MTEB-R، خط پایه 61.82 و نتیجه با reranker-0.6B برابر 65.80 است: 3.98 واحد اختلافِ امتیاز، نه «۳٫۹۸ درصد بهبود کیفیت پاسخ». 4B با 69.76 از 8B با 69.02 جلوتر است، ولی MMTEB-R برای 8B اندکی بالاتر است. انتخاب نهایی به زبان، مجموعهٔ سند و بودجهٔ مرحلهٔ دوم وابسته است؛ این جدول زمان پاسخ را اندازه نگرفته است.
افزودن مرحلهٔ بازچینی
از 0.6B بهعنوان گزینهٔ کوچکتر مقایسه شروع کنید. اگر افزایش کیفیتِ همان وظیفه ارزش هزینهٔ مرحلهٔ دوم را داشت، 4B و 8B را بررسی کنید؛ در همهٔ معیارها 8B جلوتر نیست.
وقتی سند مرتبط در نامزدهای مرحلهٔ اول هست ولی رتبهٔ خوبی ندارد؛ تعداد نامزدها بخشی از تصمیم است.
بازچینی سندی را که بازیاب وارد مجموعه نکرده بازیابی نمیکند.
چند گزینهٔ مشخص برای شروع
برای embedding و reranker لازم نیست از ابتدا سراغ مدلهای چندمیلیاردی برویم. گزینههای زیر امکان ساخت یک مقایسهٔ اولیهٔ سبک را میدهند و لینک هر ردیف به مدل اصلی میرسد. کاربرد هر مدل در جدول مشخص شده است؛ کیفیت فارسی آنها باید با پرسشها و اسناد سازمان مقایسه شود.
| مدل | نقش | ویژگی مشخص | چرا در مقایسهٔ اولیه باشد؟ |
|---|---|---|---|
| multilingual-e5-small | embedding | حدود ۱۱۸ میلیون پارامتر، بردار ۳۸۴بعدی و سقف ۵۱۲ توکن | خط مبنای کوچک برای قطعههای کوتاه و بررسی هزینهٔ اجرای CPU |
| BGE-M3 | embedding و بازیابی | بردار متراکم ۱۰۲۴بعدی، ورودی تا ۸٬۱۹۲ توکن؛ پشتیبانی از بازیابی sparse و چندبرداری | بررسی بازیابی چندزبانه و ترکیب چند روش در یک خانواده |
| Qwen3-Embedding-0.6B | embedding | حدود ۰٫۶ میلیارد پارامتر، تا ۱۰۲۴ بُعد و ظرفیت ورودی ۳۲٬۷۶۸ توکن | نامزد کوچک برای بازیابی مبتنی بر دستور و مقایسهٔ طول و بُعد خروجی |
| bge-reranker-v2-m3 | reranker | حدود ۵۶۸ میلیون پارامتر؛ امتیازدهی چندزبانه به جفت پرسش و متن | خط مبنا برای بازرتبهبندی با مدلی کمتر از یک میلیارد پارامتر |
| Qwen3-Reranker-0.6B | reranker | حدود ۰٫۶ میلیارد پارامتر؛ پشتیبانی از دستور و ورودی ۳۲٬۷۶۸ توکن | مقایسه با بازرتبهبند مبتنی بر Qwen، بدون شروع از نسخههای ۴ یا ۸ میلیاردی |
سقف طول ورودی، اندازهٔ پیشنهادی قطعه نیست. قطعهٔ ۳۲هزارتوکنی ممکن است چند موضوع نامرتبط را در خود جمع کند و هزینهٔ زیادی بسازد؛ در reranker نیز پرسش، دستور و متن نامزد باید در بودجهٔ ورودی جا شوند. BGE-M3 علاوه بر بردار متراکم، مسیرهای دیگری دارد، اما استفاده از API معمول embedding الزاماً همهٔ آنها را فعال نمیکند. تفاوت این مسیرها در مقالهٔ BGE-M3 توضیح داده شده است؛ برای مقایسه باید روشن باشد کدام قابلیت واقعاً در موتور انتخابی استفاده میشود.
برای پاسخگو نیز میتوان نامزدهایی مانند Qwen3-4B-Instruct-2507 و Qwen3-8B را با همان شواهد مقایسه کرد. اولی نسخهٔ دستورپذیر بدون حالت thinking است و دومی امکان انتخاب حالت thinking و non-thinking دارد؛ این تفاوت باید در سنجش زمان پاسخ ثبت شود. برای پاسخ مستقیم از سند، تولید استدلال طولانی نباید پیشفرض بیبررسی باشد. نام این مدلها نقطهٔ شروع مقایسه است؛ انتخاب نسخهٔ وزن، GGUF یا مسیر دیگر و سازگاری موتور در جدول مدلها و جدول نرمافزارهای اجرا دنبال میشود.
همخانواده بودن این سه مدل شرط نیست. برای مثال، میتوان embedding از یک خانواده، reranker از خانوادهای دیگر و پاسخگوی مستقلی داشت؛ هر جزء باید با ورودی و خروجی درست استفاده شود و نتیجهٔ کل ترکیب سنجیده شود. سازگاری فضای برداری مربوط به encoderهای پرسش و سند است، نه الزام به انتخاب همهٔ اجزا از یک ناشر.
کیفیت سند، شرط استفادهٔ موفق از مدل کوچک است
وقتی عنوان جدول از ردیفهای آن جدا شده، تبصره در قطعهٔ دیگری افتاده یا OCR مقدار «۱۰» را «۱» خوانده است، مدل پاسخگو اطلاعات سالم دریافت نمیکند. قطعهبندی بهتر است ساختار سند را تا جای ممکن حفظ کند: عنوان بخش، شمارهٔ بند، جدول همراه با سرستون، شناسهٔ سند و محل ارجاع. راهکارهایی مانند Docling به پردازش ساختار و چیدمان سند میپردازند؛ انتخاب و کیفیت استخراج فارسی همچنان باید روی فایلهای واقعی بررسی شود. برای صفحات تصویری یا نمودارهای ضروری نیز ممکن است OCR یا مدل بینایی جداگانه لازم باشد، بدون اینکه تمام پاسخها به یک مدل چندوجهی بزرگ سپرده شوند.
همهٔ دادههای استخراجشده را هم نباید به زمینهٔ مدل اضافه کرد. شش قطعهٔ ۷۰۰توکنی حدود ۴٬۲۰۰ توکن متن سند میسازند، در حالی که پنجاه قطعه با همین اندازه حدود ۳۵هزار توکن میشوند؛ دستور، پرسش، تاریخچه و خروجی هم سهم خود را دارند. انتخاب شواهد کمتر اما کافی، کار مدل کوچک را آسانتر و هزینهٔ خواندن ورودی را کمتر میکند. در پرسش چندسندی، «کمتر» نباید به حذف شاهد لازم یا استثنای تعیینکننده منجر شود؛ معیار، کفایت مجموعهٔ شواهد است.
این ۷۰۰ توکن، مثال بودجهٔ ورودیِ مدل پاسخگوست. در E5-large-instruct، متن پس از ۵۱۲ توکن بریده میشود؛ بنابراین اندازهٔ قطعه را با توکنایزر embedding نیز کنترل میکنیم. ورودی reranker هم پرسش و سند را با هم میگیرد. شمارش توکنِ این سه جزء الزاماً یکسان نیست.
نسخه، تاریخ اعتبار و دسترسی نیز بخشی از آمادهسازیاند. سند منسوخ نباید فقط به دلیل شباهت بیشتر جای سند معتبر را بگیرد و قطعهٔ خارج از مجوز کاربر نباید به مدل پاسخگو برسد؛ اگر reranker بیرون از مرز مجاز داده اجرا میشود، همین قاعده برای آن هم برقرار است. محتوای سند نیز دادهٔ مرجع است و نباید صرفاً به دلیل بازیابیشدن، اختیار تغییر دستور سامانه را پیدا کند. کوچک بودن مدل، جای کنترل دسترسی و مدیریت منبع را نمیگیرد.
مزیت مدل کوچک در سرویسدهی آشکارتر میشود
سه مدل این سامانه الزاماً به سه GPU اختصاصی نیاز ندارند. ساخت اولیهٔ embedding اسناد، کاری جدا از پاسخگویی برخط است و پس از آن معمولاً اسناد جدید یا تغییرکرده به پردازش مجدد نیاز دارند. مدل embedding کوچک ممکن است برای بار محدود روی CPU کافی باشد؛ در بار بیشتر، پردازش دستهای روی GPU ارزش پیدا میکند. reranker و پاسخگو نیز میتوانند، در صورت کفایت حافظه و تأخیر، یک GPU را به اشتراک بگذارند یا به سرویسهای مستقل تبدیل شوند. موتورهایی مانند Text Embeddings Inference برای سرویس مدلهای embedding طراحی شدهاند؛ پشتیبانی از مدل و نقش دقیق باید در موتور انتخابی بررسی شود.
کاهش اندازهٔ پاسخگو میتواند فضای بیشتری از VRAM آزاد کند، اما ظرفیت کاربران فقط از روی اندازهٔ فایل مدل به دست نمیآید. برای نمونه، با هندسهٔ Qwen3-4B-Instruct-2507، حافظهٔ خام KV شانزدهبیتی برای یک دنبالهٔ ۸٬۱۹۲توکنی حدود ۱٫۱۲۵ GiB است؛ چهار دنبالهٔ مستقل با همین طول حدود ۴٫۵ GiB میخواهند. این محاسبه از ۳۶ لایه، ۸ سر KV و بُعد ۱۲۸ به دست میآید و وزنها، activationها و فضای کاری را شامل نمیشود. پس حتی مدل ۴ میلیاردی هم با زمینه و همزمانی نامحدود روی یک کارت کوچک سرویس نمیدهد.
در مقابل، اگر کیفیت یک مدل کوچک کافی باشد، میتوان همان سرویس را روی چند کارت اقتصادی تکثیر کرد و ظرفیت را با تعداد درخواستهای فعال افزایش داد. این تصمیم با تقسیم یک مدل بزرگ میان چند کارت فرق دارد و باید با تأخیر، توان عملیاتی و هزینهٔ نگهداری مقایسه شود. برای بسیاری از پیکربندیهای سبک، بررسی یک کارت ردهٔ ۲۴ گیگابایت مانند RTX 4090 نقطهٔ آغاز معقولی است؛ ظرفیت نهایی به ترکیب سه جزء و بار واقعی وابسته خواهد بود. جزئیات انتخاب در یادداشت RTX 4090 و تفاوت حافظهٔ ۲۴ و ۴۸ گیگابایت و اثر دقت وزن در یادداشت چهاربیتیکردن مدل آمده است.
پیش از بزرگکردن مدل، محل خطا را پیدا کنیم
آزمون بسیار مفیدی وجود دارد: برای پرسشی که سامانه خراب پاسخ داده، قطعههای صحیح و کافی را دستی در اختیار همان مدل کوچک قرار دهید. اگر اکنون پاسخ درست شد، شاهدی دارید که مشکل اصلی آن نمونه در مسیر بازیابی یا انتخاب زمینه بوده است. اگر با شواهد کامل هم خطا ادامه داشت، دستور، زبان، قالب خروجی و توان مدل پاسخگو را بررسی کنید. این آزمایش علت همهٔ خطاها را یکباره ثابت نمیکند، اما جلوی تعویض پرهزینهٔ جزء اشتباه را میگیرد.
| نشانهٔ خطا | نخست کدام بخش بررسی شود؟ | اصلاحی که پیش از افزایش اندازهٔ پاسخگو ارزش دارد |
|---|---|---|
| شاهد درست در نامزدهای اولیه نیست | استخراج سند، قطعهبندی، embedding و جستوجو | اصلاح متن، حفظ شناسهها، بازیابی ترکیبی و بررسی تعداد نامزدها |
| شاهد درست پیدا شده ولی به زمینهٔ نهایی نمیرسد | reranker و انتخاب شواهد | اصلاح قالب ورودی، بازرتبهبندی، تنوع شواهد و بودجهٔ توکن |
| پاسخ به نسخهٔ قدیمی یا سند نامرتبط تکیه میکند | فراداده و قواعد اعتبار سند | فیلتر نسخه، تاریخ، نوع سند و دامنهٔ دسترسی |
| شاهد کامل حاضر است ولی پاسخ ساده اشتباه است | مدل پاسخگو، دستور و پردازش خروجی | اصلاح دستور و قالب؛ سپس مقایسهٔ مدل کوچک دیگری یا مدل قویتر |
| شواهد درستاند اما ترکیب استثناها یا استدلال شکست میخورد | طراحی فرایند و توان تحلیل مدل | تجزیهٔ مسئله، استفاده از ابزار یا مسیر ارجاع به مدل قویتر |
برای مقایسهٔ عملی، مجموعهای از پرسشهای واقعی همراه با سند و پاسخ مرجع بسازید؛ چندصد نمونهٔ متنوع برای شروع مفیدتر از تعداد زیادی سؤال تکراری است. پرسشهای بدون پاسخ در آرشیو، موارد نیازمند پرسش روشنکننده، سند منسوخ و پرسش خارج از مجوز را هم وارد کنید. بخشی از نمونهها باید برای آزمون نهایی کنار بماند و در تنظیم مدل یا انتخاب آستانهها استفاده نشود. در فارسی، صورت محاورهای سؤال، نیمفاصله، تفاوت «ی/ي» و «ک/ك»، اعداد و متن ترکیبی نیز ارزش بررسی جداگانه دارند؛
در بازیابی، ببینید چه سهمی از شواهد لازم در k نتیجهٔ اول حاضر است؛ برای پاسخهایی که چند شاهد لازم دارند، وجود یک قطعهٔ مرتبط کافی نیست. در بازرتبهبندی، ترتیب و پوشش شواهد در ورودی نهایی اهمیت دارد. در پاسخگو، درستی پاسخ، پشتیبانی ادعاها توسط منابع، صحت ارجاعها و رفتار هنگام نبود شاهد را بسنجید. زمان اولین توکن، مدت پاسخ و رفتار صف در بار همزمان هم باید ثبت شوند؛ یک امتیاز کلی بهتنهایی نشان نمیدهد کدام جزء ارزش هزینهٔ بیشتر را دارد.
تنظیم مجدد مدل نیز باید متناسب با همین تشخیص باشد. اگر نامهای داخلی و زبان پرسش باعث شکست بازیابی میشوند، آموزش embedding یا reranker با جفتهای مرتبط و نامرتبط میتواند موضوع بررسی باشد. اگر بازیابی درست است ولی پاسخگو قالب یا رفتار مطلوب را رعایت نمیکند، Instruction tuning یا تنظیم آداپتر ممکن است مفید باشد. تغییر روزمرهٔ یک آییننامه معمولاً به بهروزرسانی منبع و نمایه نیاز دارد، نه آموزش دوبارهٔ همهٔ اجزا؛ تفاوت این انتخابها در مقایسهٔ RAG، CAG، KAG، Fine-tuning و Instruction tuning توضیح داده شده است.
برای سازمانی با پرسشهای عمدتاً مستقیم و مستند، ترکیب یک embedding کوچک، بازرتبهبند کوچک در صورت نیاز و پاسخگوی ۳ تا ۸ میلیاردی، انتخابی جدی برای شروع است. مدل قویتر میتواند برای درخواستهای دشوار، با قواعد ارجاع و آزمون مستقل، به سامانه اضافه شود؛ نمرهٔ شباهت یا اظهار اطمینان خود مدل بهتنهایی معیار کافی برای این ارجاع نیست. معیار انتخاب نهایی، کمهزینهترین ترکیبی است که پاسخ درست و مستند را در زمان مورد نیاز ارائه کند. این نگاه هم ظرفیت سرویس را بهتر استفاده میکند و هم هزینهٔ مدل بزرگ را به کاری اختصاص میدهد که واقعاً از آن سود میبرد.