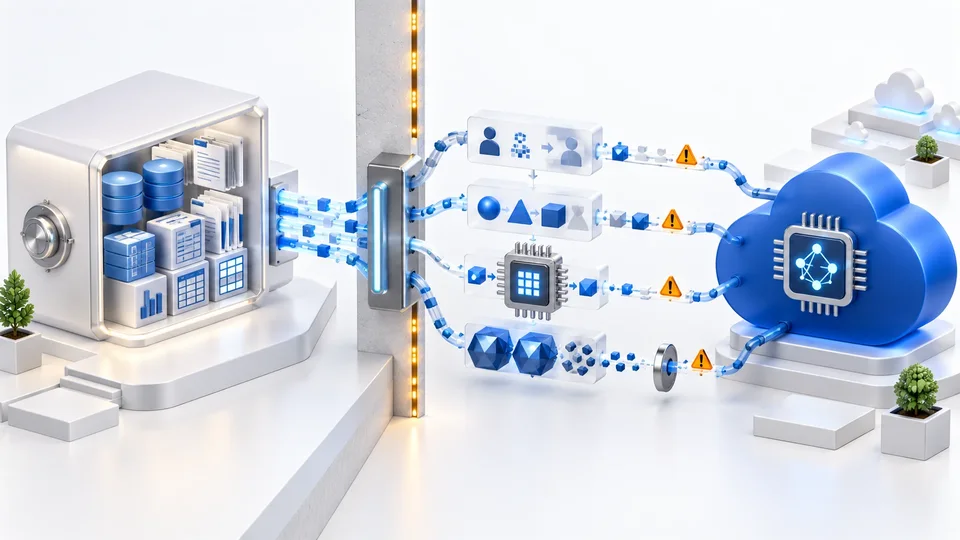
مدلهای زبانی عمومی، از تحلیل قرارداد و گزارش مالی تا پاسخگویی به مشتری و بررسی رخدادهای امنیتی، تواناییهایی در اختیار سازمان میگذارند که ساختن معادل داخلی آنها همیشه ممکن یا اقتصادی نیست. مسئله از جایی آغاز میشود که کیفیت پاسخ مدل به دیدن همان جزئیاتی وابسته است که سازمان اجازه خروج آنها را ندارد: نام اشخاص، ارقام واقعی، روابط میان رویدادها، منطق یک فرایند، متن قرارداد یا حتی پرسشی که درباره یک پروژه محرمانه مطرح شده است.
در یک کاربرد ساده شاید بتوان نام مشتری را حذف کرد و متن را به API فرستاد، اما کاربردهای جدی هوش مصنوعی معمولا با یک نام و شماره سروکار ندارند. یک پرونده پزشکی، گزارش بازرسی یا مجموعه لاگ میتواند بدون هیچ شناسه صریحی نیز هویت فرد، ضعف یک سامانه یا تصمیم آینده سازمان را آشکار کند. از سوی دیگر، اگر همه نشانههای معنادار حذف شوند، مدلی که قرار بود روی روابط و زمینه استدلال کند دیگر ماده کافی برای پاسخ مفید در اختیار ندارد. به همین دلیل، محرمانگی در استفاده از API عمومی صرفا یک قابلیت امنیتی نیست؛ مسئلهای درباره مرز میان حفظ معنا و جلوگیری از افشای همان معناست.
رمزگذاری مسیر ارتباط، داده را از شنودگر میان راه پنهان میکند؛ نه از سرویسی که برای پردازش، ناچار است آن را دریافت کند.
API عمومی؛ مرز اعتماد تازه سازمان
منظور از API عمومی در این یادداشت، لزوما یک سرویس رایگان یا گفتوگوی عمومی نیست. هر API مدل که پردازش اصلی آن بیرون از محیط تحت کنترل سازمان و روی زیرساخت یک ارائهدهنده انجام شود، مرز اعتماد تازهای ایجاد میکند. کلید API، TLS، کنترل دسترسی و رمزگذاری داده در حال انتقال ضروریاند، اما در معماری متعارف، رمزگذاری در سمت ارائهدهنده پایان مییابد و متن درخواست برای انجام استنتاج در اختیار سامانه او قرار میگیرد.
این خروج داده لزوما به معنای سوءاستفاده ارائهدهنده نیست. بسیاری از سرویسهای تجاری تعهد میدهند داده API را برای آموزش مدل به کار نبرند و برای نگهداری، محل پردازش یا دسترسی انسانی کنترلهایی عرضه میکنند. با این حال، سه گزاره را نباید یکی دانست: «داده برای آموزش استفاده نمیشود»، «داده پس از پردازش نگهداری نمیشود» و «ارائهدهنده از نظر فنی قادر به مشاهده داده نیست». برای نمونه، مستندات فعلی OpenAI میان عدم استفاده از داده API برای آموزش، لاگهای پایش سوءاستفاده و کنترل Zero Data Retention تفکیک میکند؛ Anthropic نیز برای API سازمانی دوره استاندارد نگهداری و استثناهای جداگانه دارد؛ و مستندات Google نشان میدهد حتی امکان دستیابی به نگهداری صفر میتواند به مدل، قابلیت و تنظیمات هر درخواست وابسته باشد. بنابراین «سیاست مناسب» ریسک را کاهش میدهد، اما هممعنای محرمانگی رمزنگاریشده نیست. (OpenAI، Anthropic، Google Cloud)
مرز اعتماد فقط به خود مدل هم محدود نمیماند. درخواست ممکن است در پراکسی سازمان، سامانه ثبت رخداد، ابزار مشاهدهپذیری، حافظه مکالمه، کش پرامپت، مخزن فایل یا سرویس جانبی ثبت شود. در سامانههای عاملمحور، جستوجوی وب، ابزارهای سازمانی و سرورهای MCP نیز به زنجیره پردازش اضافه میشوند و هر یک سیاست و سطح دسترسی جداگانهای دارند. به همین دلیل، عبارت مبهم «داده را به مدل دادیم» گاهی یک زنجیره چندمرحلهای از دریافتکنندگان و نسخههای موقت داده را پنهان میکند.
دقیقا چه چیزی باید محرمانه بماند؟
پیش از مقایسه روشها باید روشن باشد که محرمانگی فقط به حذف اطلاعات هویتی محدود نیست. در یک سند واحد، دستکم چند نوع راز میتواند همزمان وجود داشته باشد: شناسههای صریح مانند نام و شماره ملی؛ مقادیر حساس مانند مبلغ، سن یا نتیجه آزمایش؛ روابط میان اشخاص و رویدادها؛ محتوای معنایی مانند تشخیص پزشکی، قصد خرید شرکت یا وجود یک آسیبپذیری؛ و در نهایت نتیجهای که مدل از ترکیب دادههای ظاهرا بیخطر استنباط میکند.
این تفکیک مهم است، چون هر روش فقط بخشی از مسئله را میپوشاند. جایگزین کردن نام بیمار، هویت صریح او را پنهان میکند اما بیماری نادر، محل سکونت و تاریخ مراجعه ممکن است برای بازشناسی کافی باشد. تغییر چند عدد میتواند مقدار واقعی را مخفی کند اما تحلیل مالی را منحرف سازد. حتی موضوع یک پرسش نیز ممکن است محرمانه باشد؛ برای مثال، درخواست ارزیابی ریسک ادغام با یک شرکت خاص، پیش از آنکه هیچ سندی ضمیمه شود، اطلاعات مهمی درباره تصمیم آینده سازمان آشکار میکند.
خانواده روشهای موجود
روشهای موجود را میتوان در چند خانواده دید که از تعهد قراردادی تا محاسبه روی داده رمزشده امتداد دارند. این روشها رقیب کامل یکدیگر نیستند و هر کدام مدل تهدید متفاوتی را هدف میگیرند. برخی فقط احتمال استفاده ثانویه از داده را کم میکنند، برخی بخش مشخصی از ورودی را پنهان میسازند و برخی میکوشند خود ارائهدهنده نیز نتواند محتوای پردازششده را ببیند.
کنترلهای قراردادی و عملیاتی
این خانواده شامل عدم استفاده از داده برای آموزش، محدودیت نگهداری، انتخاب منطقه پردازش، ثبت ممیزی، محدودیت دسترسی کارکنان و قراردادهای ویژه سازمانی است. مزیت اصلی آن بلوغ و سازگاری کامل با مدلهای قدرتمند عمومی است، اما اتکای آن به تعهد، فرایند و ممیزی ارائهدهنده باقی میماند. داده همچنان در زمان استنتاج به صورت قابل پردازش در زیرساخت بیرونی حضور دارد، حتی اگر اجازه استفاده دیگری از آن وجود نداشته باشد.
کمینهسازی، حذف هویت و نام مستعار
در این رویکرد، بخشهایی که مدل به مقدار واقعی آنها نیاز ندارد، پیش از ارسال حذف یا با نشانههای ساختگی جایگزین میشوند. روشهای دقیقتر میتوانند قالب یک شناسه را حفظ کنند تا مدل نوع داده را تشخیص دهد و سپس خروجی را در محیط مورد اعتماد به شناسه اصلی بازگردانند. پژوهش Prεεmpt نمونهای از این خانواده است که میان دادههای وابسته به قالب و دادههای وابسته به مقدار تفکیک میگذارد. این رویکرد برای شناسههای مشخص امیدوارکننده است، اما اگر راز در کل معنای جمله یا رابطه میان چند داده نهفته باشد، حذف نامها به تنهایی کافی نیست.
اغتشاش آماری و حریم خصوصی تفاضلی
به جای ارسال مقدار دقیق، میتوان داده را با نویز کنترلشده، بازهبندی یا سازوکارهای حریم خصوصی تفاضلی تغییر داد. این روشها در شرایط تعریفشده تضمین ریاضی عرضه میکنند، اما تضمین آنها دقیقا به همان راز، بودجه حریم خصوصی و مدل مهاجمی مربوط است که در طراحی تعریف شده است. هرچه حفاظت قویتر شود، احتمال تغییر نتیجه نیز بیشتر میشود؛ بهویژه در حسابرسی، پزشکی یا تحلیل رخداد که اختلاف کوچک در مقدار میتواند نتیجه تصمیم را عوض کند.
تبدیل یا پنهانسازی معنایی
ایده تازهتری که گاهی «رمزنگاری معنایی» نامیده میشود، متن را در محیط محلی به زمینهای دیگر با ساختار منطقی مشابه تبدیل میکند، پاسخ مدل عمومی را میگیرد و آن را دوباره به زمینه اصلی بازمیگرداند. پژوهش Semantic Encryption نمونه مشخص این رویکرد است و نشان میدهد یک مدل کوچک محلی میتواند نقش رمزگذار و رمزگشا را بازی کند. جذابیت روش در سازگاری با API متنی معمولی است، اما واژه «رمزنگاری» نباید باعث اشتباه شود: متفاوت شدن واژگان یا داستان، به خودی خود اثبات رمزنگاری استاندارد نیست و ساختار منطقی، مقادیر یا روابط ممکن است همچنان قابل استنتاج باشند.
تفکیک استدلال از اجرای داده
در برخی معماریها، مدل عمومی به جای دیدن رکوردهای واقعی، فقط ساختار مسئله، شمای داده یا نمونه مصنوعی را میبیند و دستور تحلیل، پرسوجو یا برنامه لازم را تولید میکند؛ اجرای واقعی در محیط مورد اعتماد انجام میشود. این خانواده میتواند خروج داده خام را بهشدت محدود کند و با APIهای عادی نیز سازگار باشد، اما برای کارهایی که به خواندن دقیق متن، درک ظرافتهای پرونده یا کشف رابطهای ناشناخته در داده وابستهاند همیشه کافی نیست. همچنین شمای پایگاه داده، نام فیلدها و خروجی تجمیعی نیز ممکن است خود اطلاعات سازمانی مهمی را آشکار کنند.
نمایشهای میانی حفاظتشده و استنتاج شکافته
به جای متن خام، بخشی از مدل در محیط مشتری اجرا میشود و نمایش میانی یا embedding حفاظتشده برای ادامه پردازش به ابر میرود. سامانه پژوهشی NOIR نمونهای از این رویکرد است که encoder و decoder را نزد مشتری نگه میدارد و بخش میانی مدل را در ابر اجرا میکند. نکته کلیدی این است که embedding معمولی رمزنگاری نیست و میتواند هدف حملات بازسازی قرار گیرد؛ افزون بر آن، چنین معماریای به همکاری ارائهدهنده و تقسیم مدل نیاز دارد و روی یک API متنی بسته و متعارف قابل افزودن نیست.
محاسبات محرمانه و محیط اجرای مورد اعتماد
در Confidential Computing، داده هنگام پردازش داخل یک محیط اجرای مورد اعتماد یا TEE قرار میگیرد و با سازوکارهایی مانند attestation میتوان درباره نرمافزار و محیط اجرا اطمینان بیشتری به دست آورد. این مسیر از نظر کارایی به استفاده عملی نزدیکتر شده و ارزیابیهای جدید، امکان اجرای LLM روی TEEهای CPU و GPU را بررسی کردهاند. با این حال، حفاظت آن به پیادهسازی سختافزار، زنجیره اعتماد، تنظیم درست و مقاومت در برابر کانالهای جانبی وابسته است و فقط زمانی برای یک API عمومی معنا دارد که خود ارائهدهنده چنین قابلیتی را عرضه کند. (ارزیابی TEE برای استنتاج LLM)
رمزنگاری همریخت و محاسبه چندجانبه امن
رمزنگاری کاملا همریخت یا FHE اجازه میدهد بخشی از محاسبه مستقیما روی داده رمزشده انجام شود و محاسبه چندجانبه امن یا MPC نیز پردازش را میان چند طرف به شکلی تقسیم میکند که هیچ طرف به تنهایی همه داده را نبیند. از نظر رمزنگاری، این خانواده به ایده «استنتاج بدون مشاهده داده» نزدیکتر است، اما اجرای مدلهای بزرگ با توالیهای طولانی همچنان بسیار پرهزینه و پیچیده است. پژوهشهای جدید توانستهاند اندازه مدل و طول ورودی قابل پشتیبانی را افزایش دهند، ولی این روش به پیادهسازی ویژه مدل نیاز دارد و نمیتوان ciphertext را به یک API معمولی GPT فرستاد و انتظار پاسخ معنادار داشت. (نمونه پژوهش FHE برای Llama-3-8B)
مقایسه روشها در یک نگاه
| خانواده روش | سازگاری با API عادی | چه چیزی را عمدتا محافظت میکند؟ | نوع اتکا | وضعیت عملی امروز | محدودیت اصلی |
|---|---|---|---|---|---|
| کنترل قراردادی، عدم آموزش و محدودیت نگهداری | کامل | استفاده ثانویه، نگهداری و دسترسی عملیاتی | حقوقی و فرایندی | بالغ | ارائهدهنده در زمان پردازش داده را دریافت میکند |
| کمینهسازی، حذف هویت، نام مستعار و FPE | کامل | شناسهها و فیلدهای از پیش شناختهشده | فنی و تا حدی رمزنگاری | عملی | معنا و روابط حساس ممکن است باقی بماند |
| نویز و حریم خصوصی تفاضلی | معمولا ممکن | مقادیر یا ویژگیهای تعریفشده | ریاضی در مدل تهدید مشخص | عملی در کاربردهای محدود | مبادله مستقیم میان محرمانگی و دقت |
| تبدیل معنایی | کامل در سطح متن | واژگان و زمینه صریح | پنهانسازی مبتنی بر مدل | پژوهشی | تضمین رمزنگاری عمومی ندارد و ممکن است معنا نشت کند |
| تفکیک استدلال از اجرای داده | کامل | رکورد خام و جزئیات عملیاتی | معماری | عملی برای مسائل ساختیافته | برای تحلیل آزاد متن و روابط ناشناخته محدود است |
| استنتاج شکافته و embedding حفاظتشده | ندارد؛ سرویس باید تغییر کند | متن خام و بخشی از خروجی | معماری، تصادفیسازی و مدل محلی | پژوهشی و تخصصی | embedding خام امن نیست و همکاری میزبان لازم است |
| TEE و Confidential Computing | فقط با پشتیبانی ارائهدهنده | داده در حال استفاده در برابر میزبان | سختافزار و attestation | نوظهور اما قابل استفاده | اعتماد به سختافزار، پیادهسازی و کنترل کانال جانبی |
| FHE و MPC | با API عادی سازگار نیست | محتوای داده هنگام محاسبه | رمزنگاری | عمدتا پژوهشی برای LLMهای بزرگ | هزینه محاسباتی، تاخیر و محدودیت عملیات |
| استقرار خصوصی یا محلی | موضوع API عمومی را حذف میکند | داده، مدل و زنجیره پردازش | کنترل مستقیم سازمان | بالغ با هزینه زیرساخت | هزینه، نگهداری و فاصله احتمالی با مدلهای مرزی |
این جدول یک برنده مطلق ندارد، چون «سطح حفاظت» بدون مشخص کردن مهاجم معنای دقیقی ندارد. روشی که در برابر ثبت تصادفی نام اشخاص مفید است، لزوما در برابر ارائهدهنده کنجکاو، مهاجم دارای دسترسی به لاگها یا تحلیلگری که چند منبع را برای بازشناسایی ترکیب میکند مقاوم نیست. حتی تضمینهای رسمی نیز معمولا برای دامنهای محدود، نوع دادهای مشخص و مجموعهای از فرضها صادر میشوند.
مخاطرات و محدودیتهایی که معمولا دیده نمیشوند
حذف شناسه با حذف معنا یکسان نیست
بزرگترین خطر، تقلیل محرمانگی به تشخیص چند موجودیت نامدار است. ابزار حذف اطلاعات شخصی ممکن است نام و شماره تماس را درست پیدا کند، اما عنوان شغلی کمیاب، تاریخ یک رخداد و عدد قرارداد کنار هم همان فرد یا سازمان را آشکار کنند. پژوهشهای حریم خصوصی معنایی نیز بر همین شکاف تاکید دارند: اطلاعات حساس میتواند ضمنی، زمینهای یا از ترکیب چند بخش قابل استنتاج باشد، بیآنکه به صورت یک رشته مشخص در متن حضور داشته باشد. (مرور Semantic Privacy در LLMها)
هر واسطهای میتواند خطا کند
Sanitizer، مدل کوچک محلی، نگاشت نامهای مستعار و سازوکار بازگردانی خروجی همگی به زنجیره جدیدی از نرمافزار و مدل تبدیل میشوند. اگر تشخیص داده حساس یک مورد را جا بیندازد، همان یک خطا میتواند متن اصلی را از مرز اعتماد عبور دهد؛ اگر نگاشت خروجی اشتباه شود، پاسخ ظاهرا روان اما مربوط به شخص، مبلغ یا سند دیگری خواهد بود. در چنین سامانهای، محرمانگی و صحت از هم جدا نیستند و خطای حفاظتی میتواند مستقیما به خطای تصمیم منجر شود.
embedding و کدگذاری لزوما رمزنگاری نیستند
تبدیل متن به token ID، embedding، hash ساده یا نمایش فشرده ممکن است برای انسان ناخوانا باشد، اما ناخوانا بودن با محرمانه بودن تفاوت دارد. نمایشهای میانی اغلب بخشی از ساختار معنایی ورودی را حفظ میکنند، زیرا مدل دقیقا برای استفاده از همان ساختار به آنها نیاز دارد. اگر مهاجم مدل، واژگان یا نمونههای کافی در اختیار داشته باشد، بازسازی یا استنتاج بخشی از متن اصلی ممکن است؛ به همین دلیل، ارسال embedding خام نباید بدون تحلیل حمله به عنوان راهکار محرمانگی معرفی شود.
حفاظت ورودی، خروجی و ابزارها را پوشش نمیدهد
حتی اگر ورودی بهخوبی پنهان شود، پاسخ مدل میتواند واقعیت حساس را تکرار یا از داده استنباط کند. در معماریهای RAG و Agent، خطر دیگری نیز وجود دارد: محتوای بازیابیشده میتواند مدل را وادار کند داده را به ابزار یا مقصدی خارج از مسیر مورد انتظار بفرستد. بنابراین محرمانگی پرامپت فقط یکی از لایههاست و کنترل انتشار خروجی، دسترسی ابزارها و حافظه مکالمه مسئلههای جداگانهای باقی میمانند.
ادعاهای امنیتی اغلب از مدل تهدید خود فراتر برده میشوند
یک مقاله ممکن است در برابر مهاجم «کنجکاو ولی تابع پروتکل» نتیجه خوبی نشان دهد، در حالی که سامانه واقعی با ارائهدهنده مخرب، کتابخانه آلوده، کارمند دارای دسترسی، حمله کانال جانبی یا درخواستهای تطبیقی روبهرو شود. به همین ترتیب، پایین بودن شباهت واژگانی میان متن اصلی و متن تبدیلشده اثبات نمیکند که مفهوم، عدد یا رابطه حساس قابل استنتاج نیست. نام روش، وجود فرمول و حتی نتیجه خوب روی چند benchmark جای تعریف دقیق راز، مهاجم و معیار نشت را نمیگیرد.
قابلیتهای جدید میتوانند سیاست داده را تغییر دهند
حافظه پایدار، فایل، کش طولانیتر، اجرای پسزمینه، جستوجوی وب و اتصال به ابزارهای ثالث ارزش کاربردی API را افزایش میدهند، اما هر قابلیت میتواند مسیر و دوره نگهداری متفاوتی داشته باشد. ممکن است قرارداد پایه مناسب باشد، ولی فعال کردن یک endpoint یا ابزار خاص داده را وارد مخزن دیگری کند. در نتیجه، ارزیابی محرمانگی یک بار برای نام ارائهدهنده انجام نمیشود؛ باید برای مدل، endpoint، قابلیت، منطقه و پیکربندی واقعی صورت گیرد.
از پرسش «آیا API امن است؟» عبور کنیم
تقسیم سرویسها به «امن» و «ناامن» صورت مسئله را بیش از حد ساده میکند. پرسش دقیقتر این است که کدام بخش از داده، در برابر چه کسی، در کدام مرحله و با چه درجهای از اطمینان باید پنهان بماند؛ و چه مقدار افت دقت، تاخیر و هزینه برای آن پذیرفتنی است. پاسخ یک سامانه پاسخگویی عمومی با تحلیل پرونده پزشکی، کد منبع محصول یا برنامه ادغام دو شرکت یکسان نخواهد بود.
امروز برای استفاده محرمانه از مدلهای عمومی، طیفی از کنترلهای قراردادی، کمینهسازی داده، نام مستعار، اغتشاش آماری، تبدیل معنایی، تفکیک وظیفه از داده، استنتاج شکافته، محیط اجرای مورد اعتماد و رمزنگاری محاسباتی وجود دارد. بعضی از آنها همین حالا عملیاند اما فقط بخش محدودی از راز را میپوشانند؛ بعضی تضمین قویتری میدهند اما به API متعارف متصل نمیشوند؛ و برخی هنوز بیش از آنکه محصول عمومی باشند، موضوع پژوهشاند. شناخت این تفاوت نخستین گام است تا سازمان میان «کاهش احتمال افشا» و «جلوگیری فنی از مشاهده داده» اشتباه نکند.
یادداشتهای تکمیلی این مجموعه میتوانند هر یک از این خانوادهها را جداگانه بررسی کنند: از نام مستعار و حریم خصوصی تفاضلی تا رمزنگاری معنایی، استنتاج شکافته، TEE و FHE. در آن مرحله باید برای هر روش، مدل تهدید، معماری، کیفیت خروجی، هزینه و شواهد امنیتی با جزئیات سنجیده شود؛ اما پیش از انتخاب ابزار، لازم است خود مسئله محرمانگی درست تعریف شده باشد.