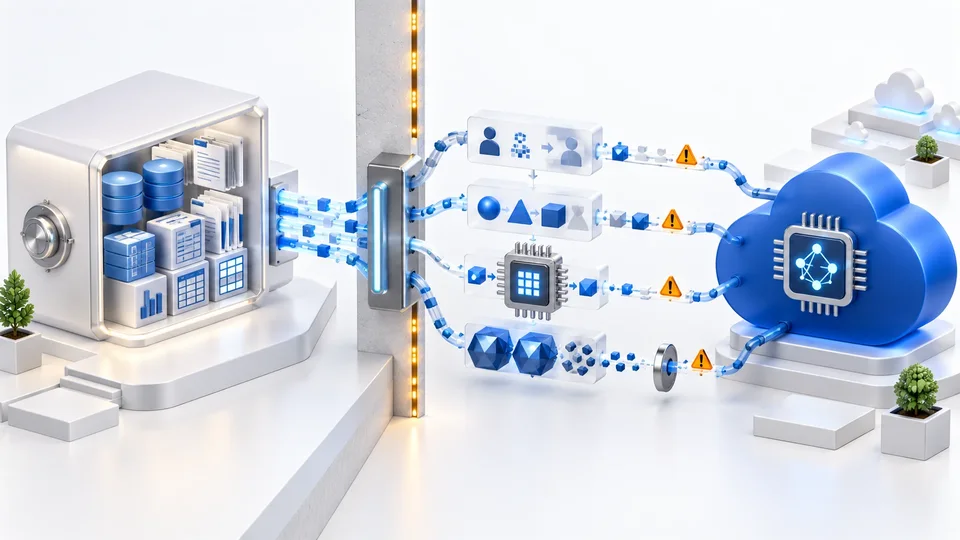
Los modelos de lenguaje de acceso público ofrecen a las organizaciones capacidades que abarcan desde el análisis de contratos e informes financieros hasta la atención al cliente y la investigación de incidentes de seguridad. Desarrollar un equivalente interno no siempre es viable ni rentable. El problema comienza cuando la calidad de la respuesta depende de ver precisamente los detalles que la organización no puede permitir que salgan de su control: nombres de personas, cifras reales, relaciones entre sucesos, la lógica de un proceso, el texto de un contrato o incluso una pregunta sobre un proyecto confidencial.
En un caso sencillo, quizá baste con eliminar el nombre del cliente antes de enviar el texto a la API. Sin embargo, las aplicaciones de IA más exigentes suelen manejar mucho más que un nombre y un número. Un historial clínico, un informe de inspección o un conjunto de registros puede revelar la identidad de una persona, la debilidad de un sistema o una decisión futura de la organización sin contener ningún identificador explícito. Por otra parte, si se eliminan todas las pistas significativas, el modelo que debía razonar sobre las relaciones y el contexto deja de disponer del material necesario para dar una respuesta útil. Por eso, la confidencialidad al utilizar una API pública es más que una función de seguridad: plantea dónde situar el límite entre conservar el significado e impedir que ese mismo significado se revele.
Cifrar el canal de comunicación oculta los datos a quien los intercepte durante el trayecto, pero no al servicio que debe recibirlos para procesarlos.
Las API públicas: un nuevo límite de confianza para la organización
En este artículo, una API pública no significa necesariamente un servicio gratuito o una conversación pública. Cualquier API de modelos cuyo procesamiento principal se realice fuera del entorno controlado por la organización, en la infraestructura de un proveedor, establece un nuevo límite de confianza. Las claves de API, TLS, el control de acceso y el cifrado de los datos en tránsito son necesarios. Sin embargo, en una arquitectura convencional, el cifrado termina en el proveedor y el texto de la solicitud queda disponible para sus sistemas durante la inferencia.
Que los datos salgan de la organización no implica necesariamente que el proveedor vaya a utilizarlos indebidamente. Muchos servicios comerciales se comprometen a no emplear los datos de la API para entrenar modelos y ofrecen controles sobre su conservación, el lugar de procesamiento o el acceso humano. Aun así, conviene distinguir tres afirmaciones: «los datos no se utilizan para entrenar», «los datos no se conservan después del procesamiento» y «el proveedor es técnicamente incapaz de ver los datos». Por ejemplo, la documentación actual de OpenAI diferencia entre no utilizar los datos de la API para entrenamiento, los registros de supervisión de abusos y los controles de Zero Data Retention. Anthropic también establece un plazo de conservación estándar y excepciones específicas para su API destinada a organizaciones. La documentación de Google muestra que incluso la posibilidad de no conservar datos puede depender del modelo, la función y la configuración de cada solicitud. Una política adecuada reduce el riesgo, pero no equivale a confidencialidad criptográfica. (OpenAI, Anthropic, Google Cloud)
El límite de confianza tampoco se reduce al propio modelo. Una solicitud puede quedar registrada en el proxy de la organización, un sistema de registros, una herramienta de observabilidad, la memoria de conversación, la caché de prompts, un repositorio de archivos o un servicio auxiliar. En los sistemas basados en agentes, la búsqueda web, las herramientas de la organización y los servidores MCP se incorporan a la cadena de procesamiento, cada uno con sus propias políticas y permisos de acceso. La expresión imprecisa «hemos dado los datos al modelo» puede ocultar así una cadena de múltiples destinatarios y copias temporales.
¿Qué debe permanecer confidencial exactamente?
Antes de comparar métodos, es necesario reconocer que la confidencialidad no se limita a eliminar información identificativa. Un mismo documento puede contener varios tipos de secretos: identificadores explícitos, como un nombre o un número de identificación nacional; valores sensibles, como un importe, una edad o el resultado de una prueba; relaciones entre personas y sucesos; contenido semántico, como un diagnóstico médico, la intención de adquirir una empresa o la existencia de una vulnerabilidad; y, finalmente, conclusiones que el modelo puede inferir al combinar datos aparentemente inofensivos.
Esta distinción importa porque cada método aborda solo una parte del problema. Sustituir el nombre de un paciente oculta su identidad explícita, pero una enfermedad rara, su lugar de residencia y la fecha de una consulta pueden bastar para reidentificarlo. Alterar algunas cifras puede ocultar sus valores reales y, al mismo tiempo, distorsionar un análisis financiero. Incluso el tema de una pregunta puede ser confidencial. Por ejemplo, solicitar una evaluación de los riesgos de fusionarse con una empresa concreta revela información importante sobre una decisión futura de la organización antes de adjuntar documento alguno.
Familias de métodos disponibles
Los métodos disponibles se agrupan en varias familias que van desde los compromisos contractuales hasta el cálculo sobre datos cifrados. No son sustitutos completos entre sí: cada uno responde a un modelo de amenazas diferente. Algunos solo reducen la probabilidad de usos secundarios, otros ocultan una parte concreta de la entrada y otros intentan impedir que el propio proveedor vea el contenido procesado.
Controles contractuales y operativos
Esta familia incluye el compromiso de no utilizar los datos para entrenamiento, los límites de conservación, la elección de una región de procesamiento, los registros de auditoría, las restricciones de acceso del personal y los acuerdos específicos para empresas. Sus principales ventajas son la madurez y la plena compatibilidad con modelos públicos potentes, aunque sigue dependiendo de los compromisos, los procesos y las auditorías del proveedor. Durante la inferencia, los datos continúan presentes en un formato procesable en la infraestructura externa, aunque no se permita ningún otro uso.
Minimización, desidentificación y seudónimos
En este enfoque, los campos cuyos valores reales no necesita el modelo se eliminan o se sustituyen por marcadores ficticios antes del envío. Los métodos más precisos pueden conservar el formato de un identificador para que el modelo reconozca el tipo de dato y, después, restituir el identificador original en la salida dentro de un entorno de confianza. La investigación Prεεmpt es un ejemplo de esta familia que distingue entre datos dependientes del formato y datos dependientes del valor. El enfoque resulta prometedor para identificadores concretos, pero eliminar nombres no basta cuando el secreto reside en el significado global de una frase o en la relación entre varios datos.
Perturbación estadística y privacidad diferencial
En lugar de enviar valores exactos, los datos pueden modificarse mediante ruido controlado, agrupación en intervalos o mecanismos de privacidad diferencial. En condiciones definidas, estos métodos ofrecen garantías matemáticas. No obstante, dichas garantías se aplican precisamente al secreto, al presupuesto de privacidad y al modelo de adversario establecidos en el diseño. Cuanto mayor sea la protección, mayor será la posibilidad de alterar el resultado, especialmente en auditoría, medicina o análisis de incidentes, donde una pequeña diferencia puede cambiar una decisión.
Transformación u ocultación semántica
Una idea más reciente, a veces denominada «cifrado semántico», transforma el texto localmente en otro contexto con una estructura lógica similar, obtiene la respuesta del modelo público y la devuelve al contexto original. El estudio Semantic Encryption ofrece un ejemplo concreto y muestra cómo un pequeño modelo local puede actuar como codificador y decodificador. Su atractivo reside en la compatibilidad con una API de texto convencional. Sin embargo, la palabra «cifrado» no debe inducir a error: cambiar el vocabulario o el relato no constituye por sí solo una demostración criptográfica estándar, y la estructura lógica, los valores o las relaciones pueden seguir siendo inferibles.
Separar el razonamiento de la ejecución sobre los datos
En algunas arquitecturas, el modelo público no ve los registros reales, sino únicamente la estructura del problema, el esquema de los datos o ejemplos sintéticos. Genera las instrucciones de análisis, la consulta o el programa necesarios, mientras que la ejecución real se realiza en un entorno de confianza. Esta familia puede reducir considerablemente la salida de datos en bruto y es compatible con las API convencionales. Sin embargo, no siempre basta para tareas que requieren leer un texto con detalle, comprender los matices de un expediente o descubrir una relación desconocida en los datos. Además, el esquema de una base de datos, los nombres de los campos y los resultados agregados pueden revelar por sí mismos información importante de la organización.
Representaciones intermedias protegidas e inferencia dividida
En lugar de enviar texto en bruto, una parte del modelo se ejecuta en el entorno del cliente y una representación intermedia o embedding protegido se envía a la nube para continuar el procesamiento. El sistema de investigación NOIR ilustra este enfoque: el cliente conserva el codificador y el decodificador, mientras que la parte intermedia del modelo se ejecuta en la nube. Lo fundamental es que un embedding convencional no es cifrado y puede ser objeto de ataques de reconstrucción. Además, esta arquitectura requiere la cooperación del proveedor y la división del modelo; no puede añadirse sin más a una API de texto cerrada y convencional.
Computación confidencial y entornos de ejecución de confianza
En la computación confidencial, los datos se procesan dentro de un entorno de ejecución de confianza, o TEE. Mecanismos como la atestación permiten obtener mayores garantías sobre el software y el entorno de ejecución. Los avances en rendimiento han acercado este enfoque al uso práctico, y evaluaciones recientes han estudiado la ejecución de LLM en TEE de CPU y GPU. Aun así, la protección depende de la implementación del hardware, la cadena de confianza, una configuración correcta y la resistencia a canales laterales. Solo es aplicable a una API pública cuando el propio proveedor ofrece esa capacidad. (Evaluación de TEE para inferencia de LLM)
Cifrado homomórfico y computación multipartita segura
El cifrado totalmente homomórfico, o FHE, permite realizar cálculos directamente sobre datos cifrados. La computación multipartita segura, o MPC, distribuye el procesamiento entre varias partes de modo que ninguna vea por sí sola todos los datos. Desde el punto de vista criptográfico, esta familia se acerca más a la idea de «inferencia sin ver los datos», pero ejecutar modelos grandes con secuencias largas sigue siendo muy costoso y complejo. Investigaciones recientes han aumentado el tamaño de los modelos y la longitud de entrada admitidos, aunque estos métodos requieren una implementación específica del modelo. Enviar texto cifrado a una API de GPT convencional no producirá una respuesta útil. (Ejemplo de investigación sobre FHE para Llama-3-8B)
Comparación de los métodos de un vistazo
| Familia de métodos | Compatibilidad con una API convencional | ¿Qué protege principalmente? | Fundamento de la confianza | Situación práctica actual | Limitación principal |
|---|---|---|---|---|---|
| Controles contractuales, exclusión del entrenamiento y límites de conservación | Plena | Usos secundarios, conservación y acceso operativo | Jurídico y de procedimientos | Madura | El proveedor recibe los datos durante el procesamiento |
| Minimización, desidentificación, seudónimos y cifrado que preserva el formato (FPE) | Plena | Identificadores y campos definidos previamente | Técnico y, en parte, criptográfico | Aplicable en la práctica | Pueden persistir significados y relaciones sensibles |
| Ruido y privacidad diferencial | Generalmente posible | Valores o características definidos | Matemático, dentro de un modelo de amenazas concreto | Aplicable en casos limitados | Compromiso directo entre confidencialidad y precisión |
| Transformación semántica | Plena en el nivel textual | Vocabulario y contexto explícito | Ocultación basada en modelos | Investigación | No ofrece una garantía criptográfica general; puede filtrar significado |
| Separación del razonamiento y la ejecución sobre los datos | Plena | Registros en bruto y detalles operativos | Arquitectónico | Aplicable a problemas estructurados | Limitada para el análisis abierto de texto y relaciones desconocidas |
| Inferencia dividida y embeddings protegidos | Ninguna sin modificar el servicio | Texto en bruto y parte de la salida | Arquitectura, aleatorización y modelo local | Investigación y aplicaciones especializadas | Los embeddings sin protección no son seguros; se requiere cooperación del proveedor |
| TEE y computación confidencial | Solo con soporte del proveedor | Datos en uso frente al anfitrión | Hardware y atestación | Emergente, pero utilizable | Confianza en el hardware, la implementación y el control de canales laterales |
| FHE y MPC | Incompatible con una API convencional | Contenido de los datos durante el cálculo | Criptográfico | Principalmente investigación para LLM grandes | Coste computacional, latencia y limitaciones de las operaciones |
| Despliegue privado o local | Elimina la API pública del problema | Datos, modelo y cadena de procesamiento | Control directo de la organización | Madura, con costes de infraestructura | Coste, mantenimiento y posible distancia respecto a los modelos de frontera |
La tabla no tiene un ganador absoluto, porque un «nivel de protección» carece de significado preciso si no se identifica al adversario. Un método útil para evitar el registro accidental de nombres no es necesariamente resistente a un proveedor curioso, a un atacante con acceso a los registros o a un analista que combine varias fuentes para reidentificar a alguien. Incluso las garantías formales suelen limitarse a un ámbito, un tipo de datos y un conjunto de supuestos concretos.
Riesgos y limitaciones que suelen pasar inadvertidos
Eliminar identificadores no equivale a eliminar significado
El mayor riesgo es reducir la confidencialidad a detectar unas pocas entidades con nombre. Una herramienta de eliminación de información personal puede identificar correctamente los nombres y teléfonos, mientras que un puesto de trabajo poco común, la fecha de un suceso y una cifra contractual, combinados, revelan a la misma persona u organización. La investigación sobre privacidad semántica destaca precisamente esta brecha: la información sensible puede ser implícita, depender del contexto o inferirse al combinar varios fragmentos, sin aparecer como una cadena concreta en el texto. (Revisión de la privacidad semántica en los LLM)
Cualquier intermediario puede fallar
El componente de saneamiento de datos, el pequeño modelo local, la correspondencia de seudónimos y el mecanismo que restituye la salida forman una nueva cadena de software y modelos. Si la detección de datos sensibles pasa por alto un solo caso, ese error puede hacer que el texto original cruce el límite de confianza. Si se restituye incorrectamente una correspondencia, la respuesta puede resultar fluida, pero referirse a otra persona, otro importe u otro documento. En estos sistemas, confidencialidad y corrección son inseparables, y un fallo de protección puede provocar directamente un error de decisión.
Los embeddings y la codificación no son necesariamente cifrado
Convertir texto en identificadores de tokens, embeddings, un hash simple o una representación comprimida puede hacerlo ilegible para una persona. Sin embargo, ser ilegible no equivale a ser confidencial. Las representaciones intermedias suelen conservar parte de la estructura semántica de la entrada porque el modelo necesita precisamente esa estructura. Si un atacante dispone del modelo, del vocabulario o de suficientes ejemplos, puede ser posible reconstruir o inferir parte del texto original. Por ello, enviar embeddings sin protección no debe presentarse como una solución de confidencialidad sin analizar posibles ataques.
Proteger la entrada no cubre las salidas ni las herramientas
Aunque la entrada esté bien oculta, la respuesta del modelo puede repetir un hecho sensible o inferirlo a partir de los datos. Las arquitecturas RAG y de agentes añaden otro riesgo: el contenido recuperado puede inducir al modelo a enviar datos a una herramienta o un destino fuera del recorrido previsto. La confidencialidad del prompt es, por tanto, solo una capa. Controlar la divulgación de las salidas, el acceso a las herramientas y la memoria de conversación sigue planteando problemas separados.
Las afirmaciones de seguridad suelen exceder su modelo de amenazas
Un artículo puede mostrar buenos resultados frente a un adversario «honesto, pero curioso», mientras que el sistema real se enfrenta a un proveedor malicioso, una biblioteca comprometida, un empleado con acceso, un ataque de canal lateral o solicitudes adaptativas. Del mismo modo, una baja similitud léxica entre el texto original y el transformado no demuestra que sea imposible inferir un concepto, una cifra o una relación sensible. El nombre del método, la presencia de fórmulas e incluso buenos resultados en varias pruebas de referencia no sustituyen una definición precisa del secreto, del adversario y del criterio de filtración.
Las nuevas funciones pueden modificar las políticas de datos
La memoria persistente, los archivos, las cachés de mayor duración, la ejecución en segundo plano, la búsqueda web y las conexiones con herramientas de terceros aumentan la utilidad de una API. Sin embargo, cada función puede introducir un recorrido y un plazo de conservación distintos. El contrato básico puede ser adecuado, pero activar un endpoint o una herramienta concreta puede trasladar los datos a otro repositorio. Por eso, la confidencialidad no se evalúa una sola vez para el nombre de un proveedor: debe examinarse para el modelo, el endpoint, la función, la región y la configuración reales.
Más allá de «¿Es segura la API?»
Dividir los servicios en «seguros» e «inseguros» simplifica demasiado el problema. La pregunta más precisa es qué parte de los datos debe permanecer oculta, frente a quién, en qué fase y con qué grado de garantía, y cuánta pérdida de precisión, latencia y coste resultan aceptables a cambio. La respuesta para un sistema de atención al público no será la misma que para el análisis de historiales clínicos, código fuente de un producto o planes de fusión entre empresas.
Actualmente, las opciones para utilizar modelos públicos de forma confidencial abarcan controles contractuales, minimización de datos, seudónimos, perturbación estadística, transformación semántica, separación de tareas y datos, inferencia dividida, entornos de ejecución de confianza y cálculo criptográfico. Algunas ya son prácticas, pero solo protegen una parte limitada del secreto. Otras ofrecen garantías más fuertes, pero no se conectan a una API convencional. Otras siguen siendo principalmente temas de investigación, más que productos de disponibilidad general. Comprender estas diferencias es el primer paso para distinguir entre «reducir la probabilidad de divulgación» e «impedir técnicamente que los datos puedan verse».
Otros artículos de esta colección pueden examinar cada familia por separado, desde los seudónimos y la privacidad diferencial hasta el cifrado semántico, la inferencia dividida, los TEE y el FHE. En esa etapa, será necesario evaluar en detalle el modelo de amenazas, la arquitectura, la calidad de la salida, el coste y la evidencia de seguridad de cada método. Antes de elegir una herramienta, sin embargo, hay que definir correctamente el propio problema de confidencialidad.