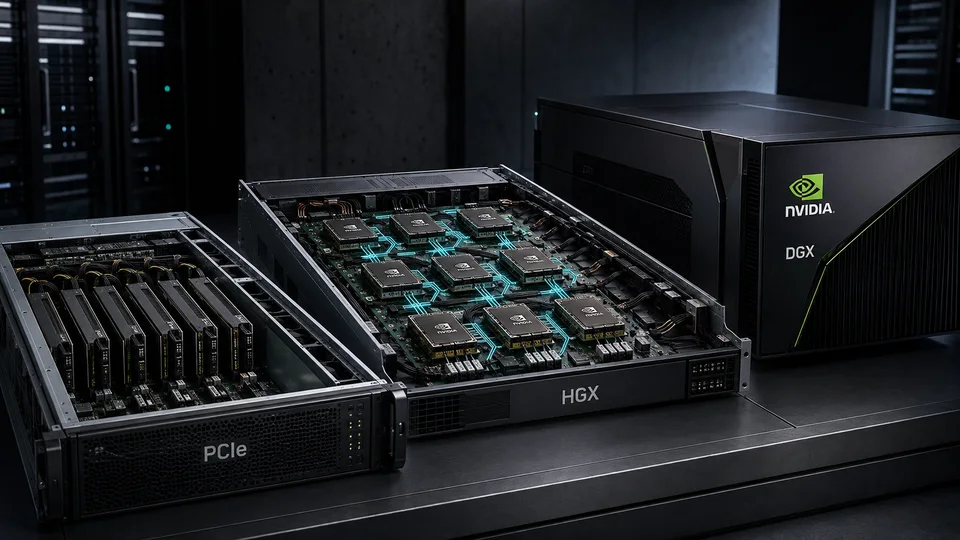
نام DGX در بازار زیرساخت هوش مصنوعی گاهی چنان به کار میرود که گویی نام فنی هر سرور پرقدرت GPU است. این تصور هم از نظر فنی اشتباه است و هم میتواند یک خطای گران در خرید ایجاد کند. سازمان ممکن است به تصور دریافت قدرت محاسباتی متفاوت، بهای DGX را بپردازد؛ در حالی که بخش اصلی کارایی سختافزاری آن از همان سکوی HGX میآید و تفاوت مهم DGX در یکپارچگی محصول، نرمافزار و خدمات پیرامونی است.
تفاوتی که باید پیش از استعلام روشن شود
| گزینه | ماهیت محصول | ارزش اصلی |
|---|---|---|
| DGX | سرور کامل و برندشدهٔ NVIDIA با سختافزار، DGX OS، firmware، ابزارهای مدیریتی و پشتیبانی یکپارچه | کاهش ریسک طراحی و نگهداشت یک پشتهٔ ازپیشاعتبارسنجیشده |
| HGX | سکوی محاسباتی چندGPU شامل GPUهای SXM، برد پایه، NVLink و NVSwitch که داخل سرور یک OEM قرار میگیرد | ارتباط پرسرعت GPU به GPU و امکان اجرای یک job بزرگ روی چند GPU |
| سرور PCIe | شاسی یک سازندهٔ سرور با کارتهای افزونهٔ PCIe | انعطاف در تعداد و نوع GPU، رشد مرحلهای و هزینهٔ ورودی کمتر |
در نسل H100 و H200، DGX یک سامانهٔ کامل هشتGPU است. راهنمای رسمی DGX H100/H200 اجزایی مانند دو CPU، حافظه، ذخیرهسازی، شبکه و چهار NVSwitch را در کنار هشت GPU معرفی میکند. یک سرور OEM مبتنی بر HGX نیز میتواند همان برد پایهٔ هشتGPU و همان ارتباط داخلی NVSwitch را در شاسی خود قرار دهد. ازاینرو DGX را نمیتوان «HGX قویتر» دانست. DGX یک پیادهسازی کامل و استانداردشده از سکویی است که بخش محاسباتی آن در خانوادهٔ HGX قرار میگیرد.
پول اضافهٔ DGX عمدتاً بابت چیزهایی خارج از تعداد GPU پرداخت میشود: BOM و firmware آزمودهشده، سیستمعامل و ابزارهای تشخیص و پایش، فرایند نصب، ثبت محصول و دسترسی به پشتیبانی یکپارچه. NVIDIA نیز در منابع نرمافزاری DGX توضیح میدهد که DGX OS یک Ubuntu سفارشیشده با تنظیمات، درایورها و ابزارهای مخصوص DGX است؛ در همان صفحه تصریح شده که اجزای این پشته را میتوان روی Ubuntu و Red Hat معمولی نیز نصب کرد. بنابراین ارزش DGX در وجود جادویی نرمافزاری غیرقابلدسترس نیست؛ در این است که NVIDIA ترکیب مشخصی از سختافزار و نرمافزار را یکجا آزموده و پشتیبانی میکند.
مخزن مدلهای NVIDIA دلیل کافی برای خرید DGX نیست
یکی از استدلالهایی که برای DGX شنیده میشود، دسترسی به NGC و مدلها و ابزارهای NVIDIA است. این استدلال چند موضوع متفاوت را با هم مخلوط میکند. NGC Catalog حتی برای کاربر مهمان نیز مجموعهای از کانتینرها، مدلها، SDKها و منابع عمومی را نمایش میدهد. بخش دیگری از نرمافزار، NIMها و مدلهای پشتیبانیشده زیر چتر NVIDIA AI Enterprise قرار دارد و اشتراک آن خدمات و چرخهٔ پشتیبانی سازمانی را نیز شامل میشود.
طبق راهنمای رسمی مجوز NVIDIA AI Enterprise، هر H100 PCIe یا H100 NVL و هر H200 NVL یک اشتراک پنجساله دارد که باید فعال شود و به همان GPU و سامانهٔ تأییدشده وابسته است. در نتیجه نه خرید هر H100 یا H200 بهطور خودکار «کل مخزن مدلها» را رایگان میکند و نه برای برخورداری از این اشتراک الزاماً باید DGX خرید. یک سرور NVIDIA-Certified با SKU مشمول نیز میتواند همان اشتراک را داشته باشد.
مهمتر آنکه برای بسیاری از سازمانهای ایرانی، خود این مجموعهٔ مدلها مزیت تعیینکنندهای ایجاد نمیکند. عمدهٔ تیمها کار را با مدلهای عمومی و وزنبازی مانند خانوادههای Llama، Qwen، Mistral یا مدلهای تخصصی منتشرشده در مخازن عمومی آغاز میکنند. دریافت نسخهای از همان مدل یا یک کانتینر بهینهشده از NGC میتواند نصب و پشتیبانی را سادهتر کند، اما مالکیت یک DGX شرط دسترسی به مدل پایه نیست. اگر محصول سازمان بر مدل عمومی، کد داخلی و موتورهای رایج متنباز استوار است، باید نشان داد کدام جزء مشخص AI Enterprise هزینه یا زمان عملیاتی را کاهش میدهد؛ صرف طولانیبودن فهرست محصولات NVIDIA ارزش اقتصادی محسوب نمیشود.
این همان جایی است که ممکن است سازمان پول DGX بدهد و در نهایت فقط کارایی HGX بگیرد. سختافزار هشتGPU کار میکند، اما خدمات و نرمافزار اضافهای که تفاوت تجاری DGX را میسازند یا استفاده نمیشوند یا جایگزینهای عمومی آنها از قبل در اختیار تیم است. تحریم و دشواری ثبت، پشتیبانی و RMA این عدم تناسب را تشدید میکند، ولی علت اصلی توصیهنکردن DGX نیست؛ حتی اگر مسئلهٔ تحریم را موقتاً کنار بگذاریم، خرید خدمتی که تیم به آن نیاز ندارد تصمیم درستی نمیشود.
HGX نیز فقط با داشتن هشت GPU توجیه نمیشود
کنارگذاشتن برند DGX به معنی توصیهٔ خودکار HGX نیست. ارزش HGX در fabric پرسرعت داخل سرور است. این ارزش هنگامی مصرف میشود که یک مدل یا یک آموزش واحد میان چند GPU تقسیم شود و حجم قابلتوجهی از داده در عملیات collective جابهجا شود. اگر هشت برنامهنویس هرکدام یک مدل را روی یک GPU مستقل اجرا کنند، NVSwitch تقریباً همان بخش گران و کماستفادهٔ سامانه خواهد بود.
بیشتر برنامهنویسان سازمانی مدلهای عمومی را از صفر آموزش نمیدهند. آنها مدل آماده را سرو میکنند، RAG میسازند یا fine-tuning محدود انجام میدهند. در این بارها، تا زمانی که مدل روی یک یا دو GPU جا میشود یا هر GPU کار مستقلی دارد، هشت GPU متصل الزاماً مزیت چشمگیری نسبت به چند کارت PCIe ایجاد نمیکند. حتی وقتی چارچوبهایی مانند PyTorch، vLLM یا کتابخانهٔ NCCL امکان چندGPU را فراهم میکنند، رسیدن از «قابل اجرا بودن» به «مقیاسپذیری اقتصادی» نیازمند انتخاب نوع parallelism، تنظیم batch، نگاشت GPU و اندازهگیری راندمان است.
این مسئله در ارتباط میان دو سرور جدیتر میشود. NVSwitch در DGX/HGX H100 و H200 ارتباط داخل node را فراهم میکند؛ عبور از یک سرور به سرور دیگر به شبکهٔ محاسباتی، NIC، RDMA، ذخیرهسازی و تنظیمات نرمافزاری جداگانه نیاز دارد. معماری رسمی DGX SuperPOD نیز SuperPOD را ترکیبی از DGX، شبکههای InfiniBand و Ethernet، گرههای مدیریتی و ذخیرهسازی میداند. معدود بارهایی ــ عمدتاً آموزش توزیعشدهٔ مدلهای بسیار بزرگ و برخی HPCها ــ میتوانند هزینهٔ چنین زیرساختی را با کاهش زمان اجرا توجیه کنند. داشتن کدی که فقط روی یک GPU نوشته شده، با خرید کابل و سوییچ به کد چندسروری تبدیل نمیشود.
پیشنهاد برای سازمان ایرانی
برای بیشتر سازمانها نقطهٔ شروع منطقی یک سرور PCIe قابل توسعه است؛ بهویژه وقتی بار غالب استنتاج، توسعه، RAG و fine-tuning محدود است. اگر اندازهگیری روی workload واقعی نشان داد مدل در حافظهٔ یک یا دو کارت جا نمیشود، ارتباط میان GPUها سهم بزرگی از زمان اجرا دارد و افزایش از دو به چهار و هشت GPU راندمان قابل قبول ایجاد میکند، آنگاه HGX باید بررسی شود.
DGX یک مرحله پس از این تصمیم قرار دارد، نه پیش از آن. سازمان باید علاوه بر اثبات نیاز به HGX، نشان دهد که استانداردسازی، DGX OS، پشتیبانی و خدمات رسمی NVIDIA برایش ارزش قابل مصرفی دارد و این ارزش از تفاوت قیمت بیشتر است. در غیر این صورت، DGX محصول بدی نیست؛ محصولی است که مزیت اصلی آن خریداری میشود اما مصرف نمیشود. برای سازمان ایرانی توصیهٔ من این است که ابتدا ضرورت HGX را با benchmark ثابت کند و سپس، جداگانه، ارزش افزودهٔ DGX را. در اغلب موارد پاسخ مرحلهٔ دوم منفی خواهد بود.