نحوه انتخاب پردازندهٔ گرافیکی
در زمان تدوین نسخهٔ اولیهٔ این مقاله، پردازندههای خانوادهٔ RTX 6000 Ada، A100 و H100 در زمرهٔ مهمترین گزینههای مناسب برای الگوریتمهای یادگیری عمیق بودند. ویژگی این پردازندهها در آن است که بهصورت تخصصی برای پردازشهای موازی توسعه یافتهاند و مدلهای مرکز دادهٔ آنها نیز بهصورت رسمی برای نصب روی سرور تأیید میشوند. اکنون H200 و نسلهای Blackwell نیز به بازار آمدهاند و مشخصات فنی بالاتری دارند، اما اصل انتخاب تغییر نکرده است: جدیدتر و قویتر بودن یک کارت الزاماً به معنی مناسبتر بودن آن برای بار کاری سازمان نیست.
با وجود قدرتمند بودن پردازندههای معرفیشده، سه اشکال در استفادهٔ بدون ارزیابی از آنها وجود دارد:
- قیمت این پردازندهها، بالاخص با در نظر گرفتن هزینهٔ سرورهای اختصاصی مورد نیاز، بسیار بالا است. در نتیجه ممکن است هزینهٔ تمامشده در قیاس با کارایی بهدستآمده مقرونبهصرفه نباشد.
- بسیاری از الگوریتمها، بهویژه الگوریتمهای غیرموازی یا سبک، نمیتوانند از تمام ظرفیت پردازشی این GPUها بهره ببرند.
- بسیاری از الگوریتمهای تحقیقاتی برای یک GPU یا کارتهای عمومی توسعه یافتهاند و استفاده از چند GPU یا یک سکوی متراکم برای آنها نیازمند تغییر و بهینهسازی نرمافزار است.
در نتیجه، برای کاربری عمومی و با توجه به مخاطبان داخلی بهتر است علاوه بر پردازندههای صنعتی، کارتهای عمومی و حرفهای نیز مد نظر قرار گیرند. تهیهٔ زیرساخت بدون توجه به نسبت آورده به هزینه، موجب اتلاف منابع محدود میشود و کارایی مورد نظر را هم ایجاد نمیکند. همانگونه که در نمودار زیر دیده میشود، در ارزیابی تاریخی سال ۲۰۲۳ کارتهایی مانند RTX 4090 از نظر نسبت عملکرد به هزینه، بهویژه برای بارهای سبکتر، بالاتر از A100 قرار گرفتهاند. این موضوع برای بسیاری از فعالیتهای هوش مصنوعی صادق است؛ در مقابل، معدودی از کارها نظیر آموزش مدلهای زبانی بسیار بزرگ به حافظه و خوشههای عظیم پردازندهٔ گرافیکی نیاز دارند.
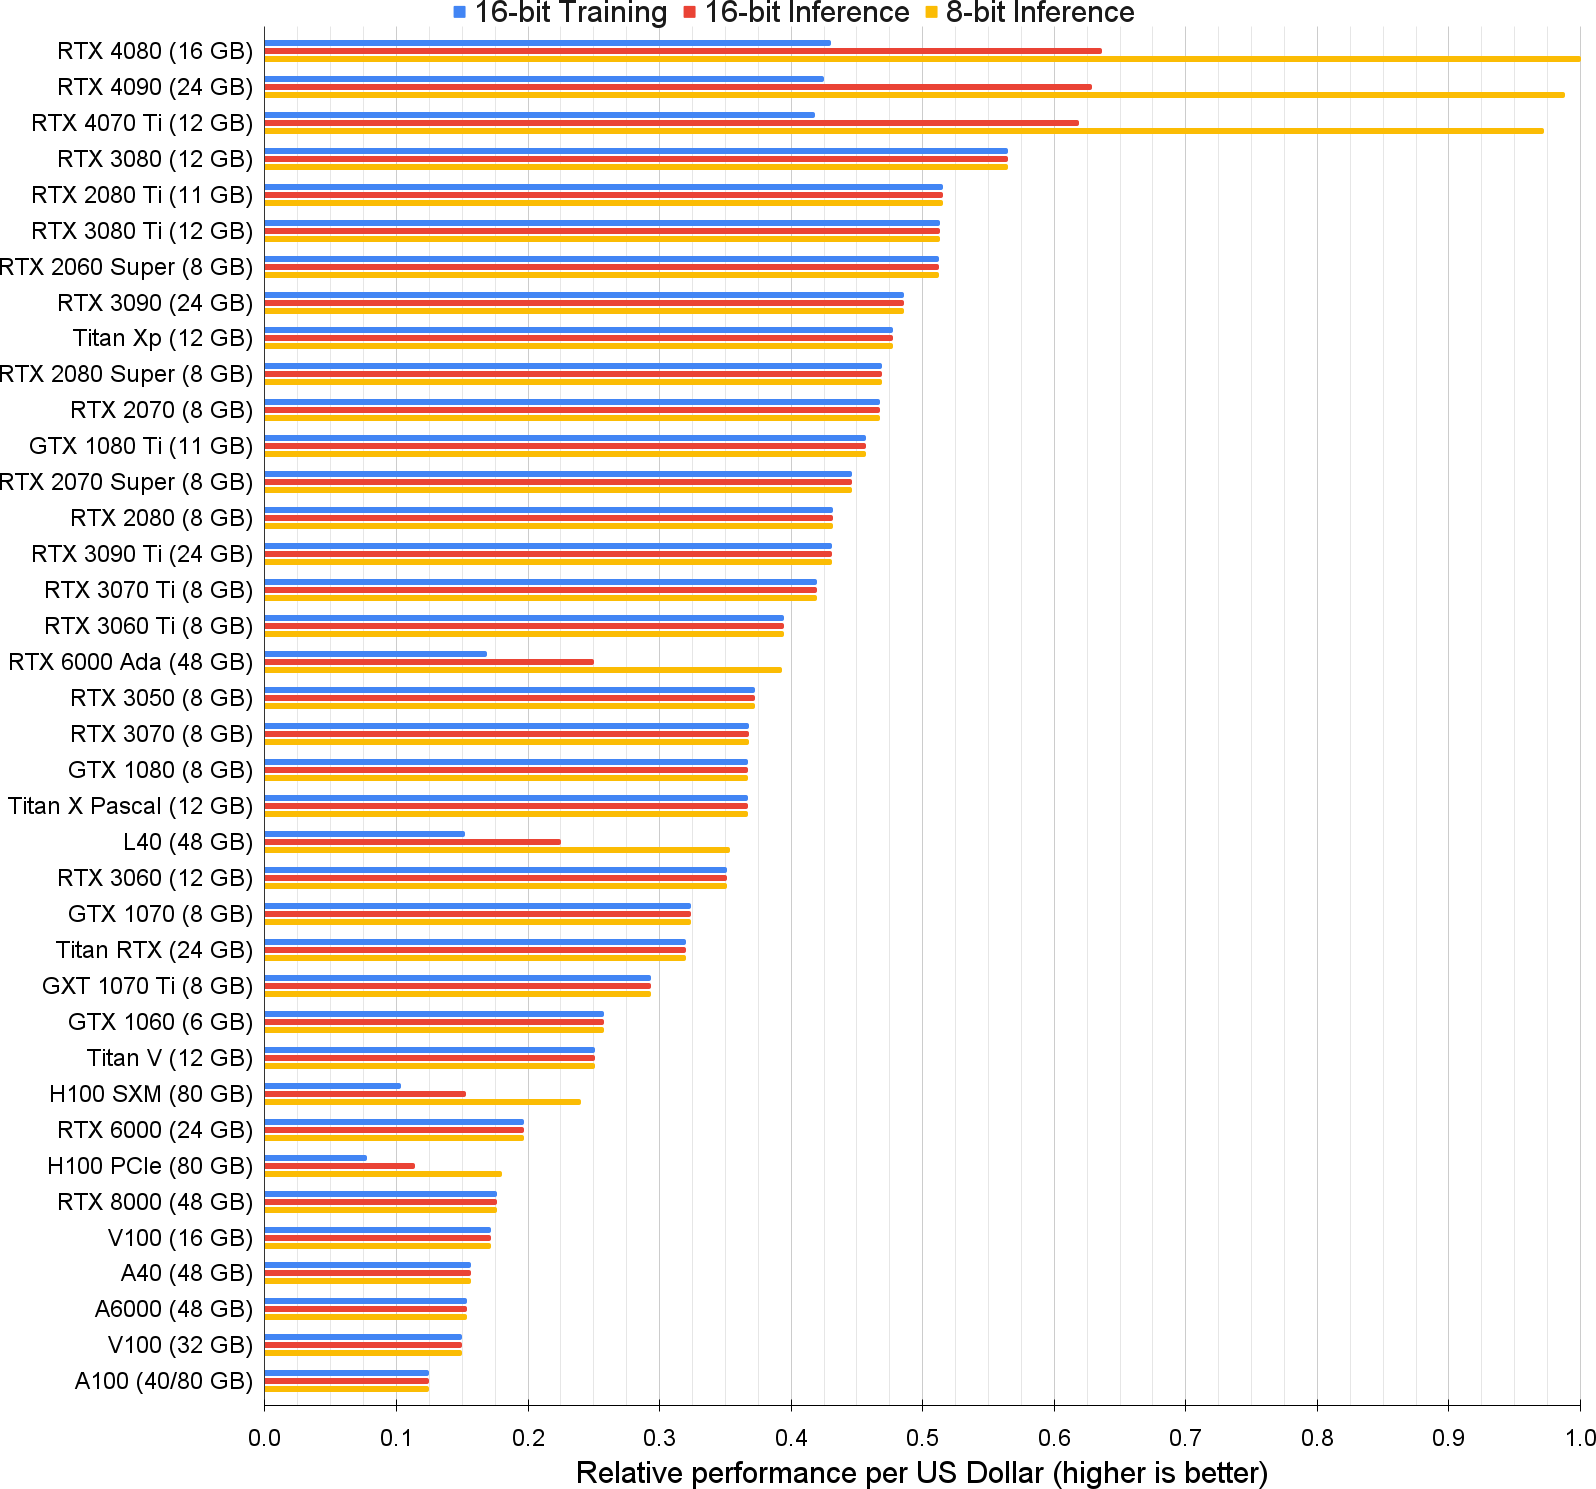
منبع نمودار بالا تحلیل Tim Dettmers دربارهٔ انتخاب GPU برای یادگیری عمیق است. قیمتها و نسل کارتها متعلق به زمان انتشارند و نمودار باید برای فهم روش مقایسه خوانده شود، نه بهعنوان قیمتنامهٔ امروز.
تفاوت کارایی کارتهای گرافیکی حتی در کاربردهای جدید، بالاخص مدلهای زبانی، نیز مشاهده میشود. در دو تصویر بعدی و در حوزهٔ استنتاج مدلهای زبانی، استفاده از کارتهای ارزانقیمت RTX 3090 و RTX 4090 صرفهٔ اقتصادی بهمراتب بالاتری نسبت به کارتهای صنعتی نشان میدهد. اما در تصویر چهارم، هنگام آموزش Mistral 7B ترتیب تغییر میکند و کارتهای میانردهای نظیر L40 و RTX 6000 Ada کارایی به قیمت متفاوتی از خود نشان میدهند.
علت این تفاوت در ماهیت دو بار کاری است. در استنتاج، وزنهای مدل ازپیشآموزشدیده اجرا میشوند و مسئله معمولاً بر سر جاگرفتن مدل و KV cache در حافظه، تعداد درخواست همزمان و تأخیر پاسخ است. در آموزش، علاوه بر وزنها باید گرادیانها، activationها و وضعیت optimizer نگهداری شوند و در آموزش توزیعشده کارتها مرتب با یکدیگر داده مبادله میکنند. بنابراین نتیجهٔ benchmark استنتاج را نمیتوان به آموزش تعمیم داد و حتی در هر یک از این دو حوزه نیز مدل، batch، دقت عددی و میزان حافظه میتوانند نتیجه را عوض کنند.
تفاوت میان دقت درجشده در مشخصات کارت و مسیر واقعی اجرای مدل در مقالهٔ INT8 یا FP8؛ پشتیبانی واقعی GPU بررسی شده است.
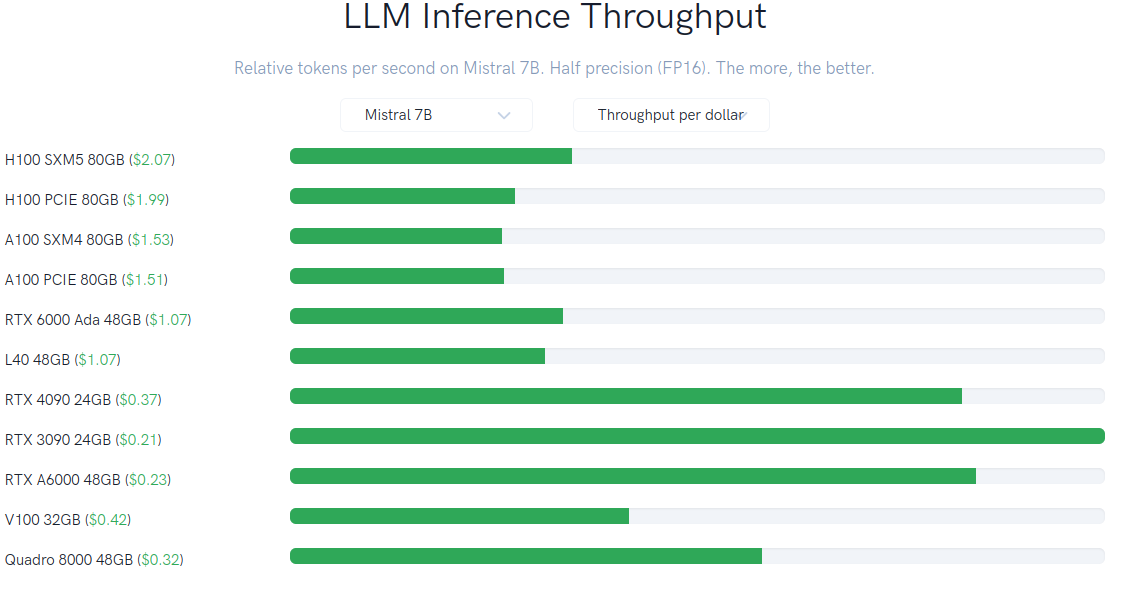
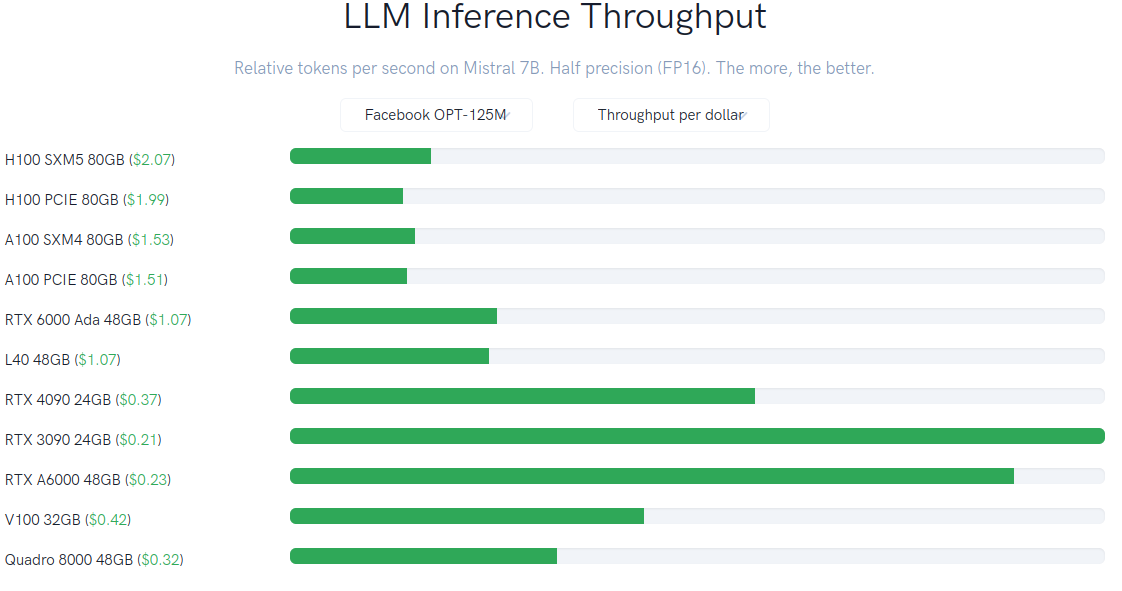
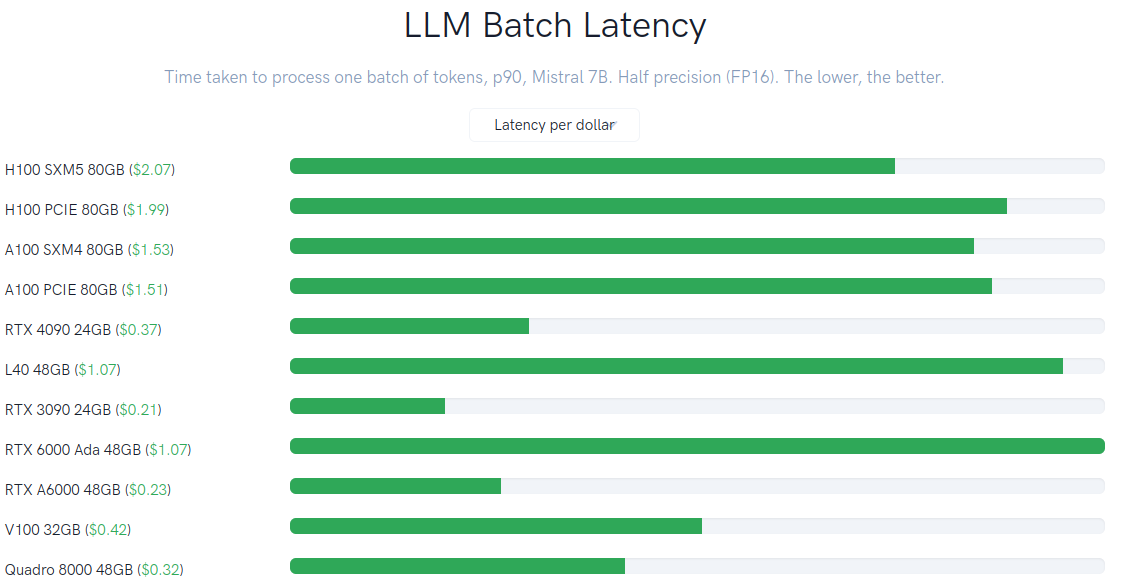
سه تصویر اخیر، نماهای ثبتشده از ارزیابیهای TensorDock در زمان تدوین نسخهٔ اولیهاند. قیمت اجاره، نسخهٔ درایور، موتور اجرا و مدل benchmark از آن زمان تغییر کردهاند؛ ازاینرو ارزش این تصاویر در نشاندادن تفاوت بارهای کاری و کارایی به قیمت است، نه در تکرار اعداد آنها برای خرید امروز.
شرکت NVIDIA بهعنوان سازندهٔ تراشه، بخشی از کارتهای عمومی را بهصورت مرجع عرضه میکند و تولید عمده و تجاری آنها را شرکتهایی نظیر MSI، ASUS و Gigabyte انجام میدهند. ازاینرو قیمت این کارتها بر اساس عواملی غیر از خود پردازنده، بالاخص سیستم خنککننده، نیز تعیین میشود. چون هدف اصلی تولید این کارتها اجرای بازیهای رایانهای است، رقابت میان سازندگان عمدتاً بر سر کاهش نویز صوتی و ارائهٔ خدمات جانبیای شکل میگیرد که مستقیماً با پردازش هوش مصنوعی ارتباط ندارند. در این حوزه لازم است کیفیت ساخت و قیمت بیش از امکانات جانبی مد نظر قرار گیرند.
در عین حال نصب این کارتها روی هر سروری میسر نیست و باید الزامات خنککاری، ابعاد و اتصال برق PCIe در نظر گرفته شود. برای مثال، بسیاری از RTX 4090ها به دلیل طول و عرض زیاد و خنککنندهٔ open-air برای نصب متراکم در سرور مناسب نیستند. مدلهای فشرده یا blower از برخی سازندگان وجود دارند، اما سازگاری باید با part number دقیق کارت بررسی شود؛ عنوانهایی مانند «RTX 4090D Turbo» که در نسخهٔ قبلی آمده بود نام یک SKU رسمی و قابل تعمیم نیست.
بهعنوان جمعبندی، برای یک مرکز پردازش سریع نمیتوان از پیش تنها روی یک نوع کارت سرمایهگذاری کرد. لازم است سبدی محدود اما متنوع از پردازندهها در اختیار مشتریان قرار گیرد و هر دسته برای بار کاری مناسب خود به کار رود. ارزیابیهای کارایی به قیمت سابقهای طولانی دارند؛ برای نمونه Lambda Labs در مقایسهٔ کارتهای RTX 2080 Ti، V100 و نسلهای همزمان آنها throughput را بر هزینهٔ کل سیستم تقسیم کرده است. اعداد آن ارزیابی امروز مبنای خرید نیستند، اما روش آن همچنان معتبر است: تمامی آزمایشها، چه در آموزش و چه در استنتاج، تفاوتهای فاحشی میان انواع کارتها در کاربردهای مختلف نشان میدهند. «قویترین کارت» الزاماً بهترین خرید نیست؛ کارتی مناسبتر است که بار کاری واقعی را با کمترین هزینهٔ قابل دفاع اجرا کند.