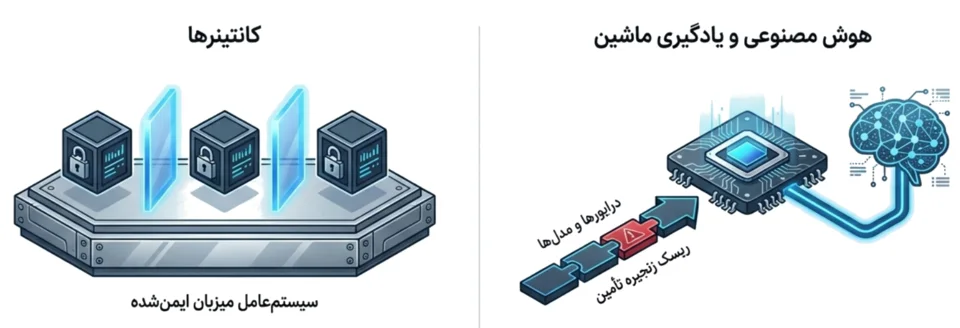
En inteligencia artificial y computación de alto rendimiento, el sistema operativo hace más que alojar una aplicación. Participa en el movimiento de datos, la planificación del cálculo, el acceso a memoria y el funcionamiento correcto del sistema. Cambiar el kernel, un controlador o una biblioteca de bajo nivel puede alterar el rendimiento, el consumo de memoria, la estabilidad e incluso la reproducibilidad sin modificar el código del modelo.
La seguridad de la infraestructura sigue esa misma cadena. Si el kernel, el controlador de GPU, el entorno de ejecución de contenedores y las herramientas de asignación de recursos no son compatibles ni se pueden auditar conjuntamente, los controles del modelo se apoyan en una base frágil. La seguridad de la IA empieza por el kernel y la GPU, aunque abarca mucho más.
Una incompatibilidad silenciosa puede ser peor que un fallo evidente
Una incompatibilidad binaria no siempre provoca un bloqueo inmediato. El sistema arranca, el servicio se inicia y la carga se ejecuta, pero la planificación, la gestión de memoria o las interrupciones se comportan de forma ligeramente distinta. En un entrenamiento prolongado o una simulación HPC, esa diferencia puede causar una pérdida de rendimiento, un fallo intermitente o un resultado irreproducible.
La interfaz binaria entre el kernel y sus módulos es un contrato invisible. Algunos ecosistemas lo conservan durante un ciclo de soporte largo mediante una ABI estable y la adaptación de parches a versiones anteriores. Otros aceptan cambios y los controlan con paquetes de módulos, pruebas y procedimientos de reversión. Ningún enfoque es superior por sí mismo: la organización debe saber qué permanece estable, qué cambia y cómo validará el resultado.
En un entorno sin conexión, la dificultad aumenta. Si un controlador necesita compilarse localmente tras actualizar el kernel, hay que incorporar compilador, cabeceras, código fuente y herramientas de desarrollo al sistema de producción. Esto amplía la superficie de ataque y permite que un fallo de compilación deje la GPU completamente inaccesible. Un paquete precompilado y probado puede reducir el riesgo, siempre que su cadena de construcción y firma sea fiable.
Una GPU no es un periférico cualquiera
En una carga convencional, perder un acelerador puede limitarse a reducir el rendimiento. En IA, la GPU puede ser lo que permite ejecutar el modelo. La capacidad y el ancho de banda de memoria condicionan lo que admite el sistema; la topología de interconexión afecta a la escala del entrenamiento; y el controlador y el entorno de ejecución gobiernan el acceso de todas las cargas a ese recurso.
Elegir hardware exige distinguir familias de tarjetas, formatos, potencia, interconexiones y aplicaciones. La guía de selección de GPU aborda estas decisiones de despliegue. Desde la seguridad también importa la lista final de componentes: modelo y número de pieza reales de la tarjeta, firmware, versión del controlador, servidor compatible y ruta de actualización deben validarse como una configuración conjunta.
Funciones como MIG en determinadas GPU de centro de datos permiten dividir una tarjeta física en instancias de hardware con cuotas definidas de cálculo, caché y memoria. En entornos con varios clientes, ofrecen una separación más fuerte que el reparto temporal por software. Sin embargo, activarlas y mantenerlas exige coordinación entre kernel, controlador, herramientas de gestión y entorno de contenedores. Una configuración MIG que desaparece tras reiniciar o cambia al actualizar el controlador no constituye un control persistente.
El contenedor no elimina la dependencia de la GPU respecto al host
NVIDIA Container Toolkit y otras herramientas permiten que una aplicación dentro de un contenedor acceda a la GPU del host. Las bibliotecas de espacio de usuario pueden estar en la imagen, pero el controlador del kernel sigue en el anfitrión. Por tanto, las versiones de la imagen, libnvidia-container, el entorno de ejecución y el controlador deben ser compatibles.
Aquí falla la idea de que el contenedor ha fijado todo el entorno. La imagen de la aplicación puede ser inmutable mientras el host y el controlador siguen cambiando. Si ambos ciclos se gestionan por separado y sin pruebas conjuntas, un parche de seguridad del kernel puede interrumpir el acceso a la GPU, y una actualización del controlador puede modificar el entorno donde se validó el modelo.
Conviene registrar la imagen del modelo y del software, el controlador, el kernel, el firmware y la configuración de GPU como un perfil de ejecución aprobado. Las pruebas de aceptación deben ir más allá de comprobar que nvidia-smi reconoce la tarjeta: hay que probar la carga real, la asignación de memoria, la ejecución compartida entre clientes, el reinicio y la reversión. Los contenedores no son fronteras de seguridad independientes (en persa) explica con más detalle el papel del host.
Datos, modelos y GPU son activos conectados
La arquitectura tradicional situaba los datos en la base de datos, el software en el código y el hardware como plataforma subyacente. En IA, esas divisiones resultan menos útiles. Los datos moldean el comportamiento del modelo; este concentra la inversión en datos y cálculo; y las GPU permiten entrenar o realizar inferencia a la escala necesaria.
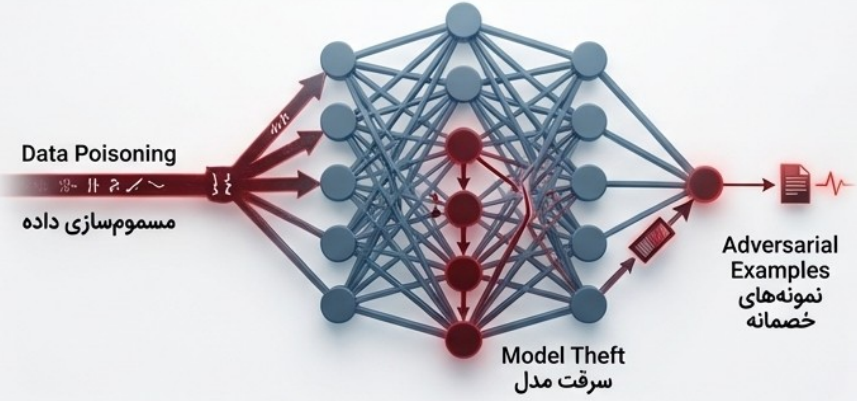
- Los datos pueden ser clasificados, únicos o proceder de operaciones reales. Su envenenamiento puede alterar las decisiones del sistema; su filtración expone la información subyacente.
- El modelo es más que un archivo ejecutable. Sus pesos y arquitectura son activos intelectuales y operativos. Robarlos puede transferir la inversión de la organización a un atacante.
- La GPU es un recurso escaso, costoso y dependiente de su cadena de suministro. El cálculo no autorizado, una interrupción del servicio o un fallo del controlador pueden eliminar capacidad operativa sin destruir datos.
La política de acceso debe contemplar estos activos de forma conjunta. Tener permiso para ejecutar un trabajo no implica necesariamente acceso directo a los datos originales ni a los archivos de pesos. Un servicio que carga el modelo no debería poder modificar la imagen o el controlador del host. El administrador de infraestructura tampoco necesita necesariamente ver los datos de entrenamiento. Esta separación conecta la seguridad de infraestructura con los principios de Zero Trust AI.
Un ataque no exige una intrusión convencional
En el software tradicional, el comportamiento se expresa principalmente en código explícito. En IA, parte de la lógica reside en los datos de entrenamiento y los pesos. Un atacante puede envenenar datos, inferir información a partir de las salidas, desviar una decisión mediante un ejemplo adversario o atacar una actualización del modelo sin instalar malware ni escapar de un contenedor.
Proteger la ejecución no basta, por tanto, para proteger las decisiones. El kernel y la GPU deben ser seguros y estables, pero la preparación de datos, el entrenamiento, la evaluación, el despliegue y las salidas también requieren procedencia, autorización y evidencias. De la arquitectura Zero Trust a Zero Trust AI explica la diferencia entre ambos ámbitos.
Incluyamos la cadena de suministro del hardware en el modelo de amenazas
Las GPU de gama alta pasan por cadenas de suministro complejas y están sujetas a restricciones de exportación. Una organización sensible debe evaluar la autenticidad del firmware, la procedencia, los propietarios anteriores, las posibilidades de actualización y la dependencia de los servicios del fabricante. No se trata de atribuir un mecanismo oculto a un producto concreto, sino de considerar la manipulación, la retirada del soporte o las restricciones de acceso como amenazas posibles.
Diversificar proveedores, probar el hardware antes del despliegue, aislar la red de gestión, registrar versiones de firmware y vigilar comportamientos anómalos puede reducir estos riesgos. Las tarjetas de consumo y de centro de datos no son sustitutos completos. La diversificación debe satisfacer necesidades reales de memoria, fiabilidad y escala, en vez de limitarse a añadir marcas a la lista de compra.
Estabilidad no significa congelar la pila para siempre
Congelar las versiones de kernel y controlador proporciona reproducibilidad a corto plazo, pero acumula vulnerabilidades e incompatibilidades con hardware nuevo. Las actualizaciones constantes también pueden desestabilizar un entorno validado. Un ciclo de cambios controlado necesita perfiles de versiones, un repositorio interno, un entorno de pruebas equivalente, cargas reales, instantáneas, despliegue gradual y una ruta de reversión definida de antemano.
La seguridad de la infraestructura de IA no termina al comprar una GPU ni empieza al instalar su controlador. Depende de una cadena verificable que va del firmware y el kernel a los datos, el modelo y la salida. Un cambio sin control en cualquiera de esos eslabones puede invalidar la capacidad de IA de toda la organización.