Notas técnicas / Infraestructura de cómputo
GPU y servidores de IA: ¿qué elegir y por qué?
Comparar aceleradores y servidores, comprobar el soporte de software y evaluar el rendimiento por coste a partir de cargas de trabajo reales.
¿Por dónde empezar?
Comience por el trabajo que debe realizar el sistema. Las tablas permiten comparar opciones; los artículos explican qué significan las diferencias. Elija el recorrido que corresponda a su decisión.
¿Qué recorrido se ajusta a mis necesidades?
Empiece por la carga: memoria del modelo, formato numérico, patrón de comunicación y objetivos del servicio. Utilice las tablas para comparar hardware y las guías para evaluar compatibilidad de software, recursos anfitriones y coste completo del despliegue.
Para ejecutar modelos de lenguaje, compare modelos según memoria y hardware; el tamaño del modelo, la entrada y la concurrencia determinan la capacidad de GPU necesaria.
Referencia de aceleradores de IA
Comparar las GPU según el trabajo que deben realizar
Explore tarjetas, módulos, procesadores, sistemas completos de aceleración y servicios en la nube para IA.
Última revisión de los datos3 November 2026
Cómo leer esta tablaEl tipo de producto distingue tarjetas, módulos, procesadores, sistemas completos y servicios en la nube. En las columnas FP8 y FP16, la primera tasa es densa y la segunda, cuando existe, utiliza dispersión. FP32 y FP64 muestran tasas vectoriales de propósito general, que no son directamente comparables con las tasas Tensor/Matrix de IA; por eso se presentan por separado.
Filtros detallados 65 Resultados
Grupos de columnas:
Resultados65de 65 modelos
Mayor memoria480GB
Mayor ancho de banda80TB/s; compare los tipos de memoria
Menor consumo80RTX Spark N1X (6144-core, laptop)
| Comparar | Detalles | Tipo | Cargas de trabajo | ||||||
|---|---|---|---|---|---|---|---|---|---|
 Intel | Tarjeta | Escala de rack | Especificaciones preliminaresFabricante | Hasta 480 GB; tarjeta Intel: 160 GBLPDDR5X | 1,5TB/s | 350W | Inferencia empresarial | ||
 INSTINCT | Módulo | Escala de rack | Especificaciones preliminaresFabricante | 432HBM4 | 23,3TB/s | No publicado por el fabricanteSin cifra independiente | HPCEntrenamiento de modelos grandesInferencia empresarial | ||
| INSTINCT | Módulo | Escala de rack | Solo sistema completoFabricante | 432HBM4 | 23,3TB/s | No publicado por el fabricanteSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
 Microsoft | Nube | Escala de rack | Especificaciones preliminaresDocumentación técnica del fabricante | 288HBM4 | 18TB/s | 950W | Inferencia empresarial | ||
 NVIDIA | Módulo | Escala de rack | Generación actualFabricante | 288HBM3e | 8TB/s | 1400W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| INSTINCT | Módulo | Escala de rack | Generación actualFabricante | 288HBM3e | 8TB/s | 1000W | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
| INSTINCT | Módulo | Escala de rack | Generación actualFabricante | 288HBM3e | 8TB/s | 1400W | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
| NVIDIA | Módulo | Escala de rack | Solo sistema completoFabricante | 288HBM4 | 22TB/s | No publicado por el fabricanteSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
| INSTINCT | Módulo | Escala de rack | Generación actualFabricante | 256HBM3e | 6TB/s | 1000W | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
 Google | Nube | Escala de rack | Generación actualDocumentación técnica del fabricante | 192HBM; 96 GB por chiplet | 7,4TB/s | No aplicableSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
| INSTINCT | Módulo | Escala de rack | Generación actualFabricante | 192HBM3 | 5,3TB/s | 750W | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
| NVIDIA | Módulo | Escala de rack | Generación actualFabricante | 180HBM3e | 7,7TB/s | 1000W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| NVIDIA | Tarjeta | Escala de rack | Generación actualFabricante | 141HBM3e | 4,8TB/s | 600W | Inferencia empresarialHPCMultiusuario | ||
| NVIDIA | Procesador | Centro de datos | Generación actualFabricante | 141HBM3e | 4,8TB/s | 700W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
 Qualcomm | Tarjeta | Escala de rack | Generación actualFabricante | 128LPDDR4X | 0,5TB/s | 150W | Inferencia empresarial | ||
| Intel | Tarjeta | Escala de rack | Generación actualFabricante | 128HBM2e | 3,7TB/s | 600W | Entrenamiento de modelos grandesInferencia empresarial | ||
| INSTINCT | Módulo | Centro de datos | Generación anteriorFabricante | 128HBM2e | 3,2TB/s | 560W | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
| NVIDIA | Procesador | Consumo | Solo sistema completoFabricante | Hasta 128LPDDR5X (unified) | No publicado por el fabricanteSin cifra pública | 80W | IA localGráficos y renderizado | ||
 Huawei | Tarjeta | Escala de rack | Generación actualFabricante | 112HBM | 1,4TB/s | 600W | Inferencia empresarialEntrenamiento de modelos grandes | ||
| Huawei | Procesador | Escala de rack | Solo sistema completoFabricante | 96HBM | 4TB/s | No publicado por el fabricanteSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
| Huawei | Tarjeta | Escala de rack | Generación actualFabricante | 48 o 96LPDDR4X | 0,4TB/s | 150W | Inferencia empresarial | ||
| NVIDIA | Tarjeta | Escala de rack | Generación actualFabricante | 96GDDR7 | 1,6TB/s | 600W | Inferencia empresarialGráficos y renderizadoMultiusuario | ||
 AWS | Nube | Escala de rack | Generación actualFabricante | 96HBM3 | 2,9TB/s | No aplicableSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarial | ||
| Google | Nube | Escala de rack | Generación actualDocumentación técnica del fabricante | 95HBM | 2,8TB/s | No aplicableSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarial | ||
| NVIDIA | Tarjeta | Escala de rack | Generación actualFabricante | 94HBM3 | 3,9TB/s | 400W | Inferencia empresarialHPCMultiusuario | ||
| NVIDIA | Tarjeta | Escala de rack | Generación anteriorFabricante | 80HBM2e | 1,9TB/s | 300W | Inferencia empresarialHPCMultiusuario | ||
| NVIDIA | Procesador | Centro de datos | Generación anteriorFabricante | 80HBM2e | 2TB/s | 400W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| NVIDIA | Tarjeta | Escala de rack | Generación anteriorDocumentación técnica del fabricante | 80HBM2e | 2TB/s | 300W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| NVIDIA | Tarjeta | Centro de datos | Generación anteriorDocumentación técnica del fabricante | 80HBM2e | 1,9TB/s | 300W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| NVIDIA | Tarjeta | Centro de datos | Generación actualFabricante | 80HBM2e | 2TB/s | 350W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| NVIDIA | Procesador | Centro de datos | Generación actualFabricante | 80HBM3 | 3,4TB/s | 700W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| Huawei | Procesador | Centro de datos | Generación actualDocumentación técnica del fabricante | 64HBM | No publicado por el fabricanteSin cifra pública | No publicado por el fabricanteSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarial | ||
| NVIDIA | Sistema | Estación de trabajo | Especificaciones preliminaresFabricante | 64Memoria unificada compartida por CPU y GPU | No publicado por el fabricanteSin cifra pública | No publicado por el fabricanteSin cifra independiente | IA local | ||
| INSTINCT | Tarjeta | Escala de rack | Generación anteriorFabricante | 64HBM2e | 1,6TB/s | 300W | HPCInferencia empresarial | ||
| NVIDIA | Tarjeta | Consumo | Placa modificada no oficialVendedor de la placa modificada | 48GDDR6X | 1TB/s | No publicado por el fabricanteSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Escala de rack | Generación actualDocumentación técnica del fabricante | 48GDDR6 | 0,9TB/s | 300W | Entrenamiento de modelos grandesInferencia empresarialGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Escala de rack | Generación actualFabricante | 48GDDR6 | 0,9TB/s | 350W | Inferencia empresarialGráficos y renderizado | ||
| NVIDIA | Tarjeta | Estación de trabajo | Generación anteriorDocumentación técnica del fabricante | 48GDDR6 | 0,7TB/s | 295W | Inferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Estación de trabajo | Generación actualFabricante | 48GDDR6 | 1TB/s | 300W | IA localGráficos y renderizado | ||
| NVIDIA | Tarjeta | Estación de trabajo | Generación anteriorFabricante | 48GDDR6 | 0,8TB/s | 300W | Entrenamiento de modelos grandesInferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Centro de datos | Generación anteriorDocumentación técnica del fabricante | 40HBM2 | 1,6TB/s | 250W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
 Tenstorrent | Tarjeta | Estación de trabajo | Generación actualFabricante | 32GDDR6 | 0,5TB/s | 300W | IA localInferencia empresarial | ||
| Google | Nube | Escala de rack | Generación actualDocumentación técnica del fabricante | 32HBM | 1,6TB/s | No aplicableSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarial | ||
| NVIDIA | Tarjeta | Consumo | Generación actualFabricante | 32GDDR7 | 1,8TB/s | 575W | IA localGráficos y renderizado | ||
| INSTINCT | Tarjeta | Centro de datos | Generación anteriorFabricante | 32HBM2 | 1,2TB/s | 300W | Entrenamiento de modelos grandesInferencia empresarialHPC | ||
| AMD | Tarjeta | Estación de trabajo | Generación actualFabricante | 32GDDR6 | 0,6TB/s | 300W | IA localGráficos y renderizado | ||
| NVIDIA | Tarjeta | Escala de rack | Generación actualFabricante | 32GDDR7 | 0,8TB/s | 165W | Inferencia empresarialGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Centro de datos | Generación anteriorDocumentación técnica del fabricante | 16 o 32HBM2 | 0,9TB/s | 250W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| NVIDIA | Módulo | Centro de datos | Generación anteriorDocumentación técnica del fabricante | 16 o 32HBM2 | 0,9TB/s | 300W | Entrenamiento de modelos grandesInferencia empresarialHPCMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación anteriorFabricante | 24GDDR6X | 0,9TB/s | 350W | Entrenamiento de modelos grandesInferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación anteriorFabricante | 24GDDR6X | 1TB/s | 450W | Entrenamiento de modelos grandesInferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación anteriorFabricante | 24GDDR6X | 1TB/s | 450W | IA localGráficos y renderizado | ||
| NVIDIA | Tarjeta | Consumo | Generación actualDocumentación técnica del fabricante | 24GDDR6X | 1TB/s | 425W | Entrenamiento de modelos grandesInferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| Tenstorrent | Tarjeta | Estación de trabajo | Generación actualDocumentación técnica del fabricante | 24GDDR6 | 0,6TB/s | 300W | IA localInferencia empresarial | ||
| NVIDIA | Tarjeta | Consumo | Generación actualFabricante | 16GDDR6X | 0,7TB/s | 320W | Entrenamiento de modelos grandesInferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación anteriorFabricante | 12GDDR6 | 0,4TB/s | 170W | Inferencia empresarialIA localMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación actualFabricante | 12GDDR6X | 0,5TB/s | 200W | Inferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación anteriorDocumentación técnica del fabricante | 11GDDR6 | 0,6TB/s | 250W | Inferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación anteriorFabricante | 10GDDR6X | 0,8TB/s | 320W | Inferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación anteriorFabricante | 8GDDR6 | 0,4TB/s | 215W | Inferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| NVIDIA | Tarjeta | Consumo | Generación anteriorFabricante | 8GDDR6 | 0,4TB/s | 220W | Inferencia empresarialIA localGráficos y renderizadoMultiusuario | ||
| Huawei | Procesador | Escala de rack | Solo sistema completoFabricante | No publicado por el fabricanteHBM; capacidad según referencia | No publicado por el fabricanteSin cifra pública | No publicado por el fabricanteSin cifra independiente | Entrenamiento de modelos grandesInferencia empresarial | ||
 Cerebras | Sistema | Escala de rack | Generación actualFabricante | No aplicableSRAM en la oblea y MemoryX desagregada | No aplicableTB/s | 23.000W | Entrenamiento de modelos grandesHPC | ||
| NVIDIA | Sistema | Escala de rack | Solo sistema completoFabricante | No aplicableSRAM distribuida del rack; 500 MB por LPU | No aplicableTB/s | No publicado por el fabricanteSin cifra independiente | Inferencia empresarial | ||
 Groq | Sistema | Escala de rack | Solo sistema completoFabricante | No publicado por el fabricanteSRAM en el chip; capacidad por referencia no publicada | 80TB/s | No publicado por el fabricanteSin cifra independiente | Inferencia empresarial |
Tipos de GPU para IA: consumo, estaciones de trabajo y centros de datos
Cómo se diferencian las familias de GPU en memoria, soporte de software y requisitos de despliegue, y cuándo resulta práctica cada una.
Una GPU comercializada para videojuegos puede ser útil para IA, y un acelerador de centro de datos puede resultar una forma costosa de ejecutar un modelo pequeño. La categoría del producto indica algo sobre el entorno de funcionamiento previsto. Por sí sola, no permite saber qué tarjeta dará el mejor resultado con una carga de trabajo concreta.
GPGPU significa computación de propósito general en unidades de procesamiento gráfico. Describe el uso de una GPU para cálculos que van más allá de los gráficos; no es una familia de productos independiente. Para planificar una infraestructura, resulta más útil distinguir entre tarjetas de consumo, tarjetas profesionales para estaciones de trabajo y aceleradores de centro de datos.
GPU de consumo
Las GPU de consumo se diseñan principalmente para videojuegos y ordenadores personales. También pueden servir para desarrollo, investigación, inferencia y ajuste fino cuando la carga de trabajo cabe dentro de sus límites de memoria y software. La gama GeForce RTX de NVIDIA es un ejemplo conocido. Las tarjetas AMD también pueden ser adecuadas, pero hay que comprobar la GPU exacta, el sistema operativo y las bibliotecas necesarias frente al entorno de software compatible.
Conviene considerar tarjetas como las RTX 3090, RTX 4090 y RTX 5090 cuando el trabajo cabe en una sola tarjeta o puede dividirse en tareas independientes. En la configuración adecuada, su rendimiento por unidad de coste puede ser atractivo frente a equipos de centro de datos más antiguos. La comparación cambia cuando una tarea necesita más memoria, mucha comunicación entre GPU o funciones operativas que la tarjeta de consumo no ofrece. El método importa más que recomendar permanentemente un modelo concreto; véase cómo elegir una GPU según la carga de trabajo.
Una tarjeta para videojuegos también impone requisitos mecánicos y térmicos que es fácil pasar por alto. Los grandes disipadores, los conectores de alimentación y los ventiladores que expulsan aire dentro del chasis pueden dificultar una instalación densa en un servidor. Tener suficientes ranuras PCIe no garantiza la compatibilidad. La guía de selección de servidores PCIe explica por qué hay que comprobarla para la tarjeta exacta y la lista de componentes del servidor.
GPU profesionales para estaciones de trabajo
Los productos gráficos profesionales de NVIDIA han pasado por denominaciones como Quadro, RTX A, RTX Ada y RTX PRO. Las familias equivalentes de AMD han incluido FirePro y Radeon PRO. Estas tarjetas se orientan a aplicaciones como visualización, ingeniería y creación de contenidos, con controladores profesionales y configuraciones adaptadas a esos entornos.
También pueden ser útiles para IA. Por ejemplo, las RTX A6000 y RTX 6000 Ada ofrecen 48 GB de memoria, lo que permite ejecutar trabajos que no caben en una tarjeta de consumo más pequeña. Una tarjeta profesional también puede proporcionar un formato físico más conveniente o una configuración de estación de trabajo oficialmente compatible.
La pregunta es si esas capacidades justifican el precio para el servicio previsto. La etiqueta profesional no garantiza una mejor relación entre rendimiento y coste en entrenamiento o inferencia. Hay que comparar la referencia exacta, la memoria utilizable, los formatos numéricos admitidos, la refrigeración y la vía de ejecución del software. Las ediciones para estaciones de trabajo y para servidores de una misma familia pueden diferir considerablemente.
Aceleradores de centro de datos
Los aceleradores de centro de datos se diseñan para cargas de cálculo sostenidas y para integrarse en plataformas de servidor. Según el producto, sus ventajas pueden incluir memoria de gran ancho de banda, mayor capacidad de memoria, funciones de fiabilidad y gestión, y comunicación más rápida entre aceleradores. Estas capacidades importan al entrenar modelos grandes, realizar inferencia con mucha demanda de memoria y ejecutar determinadas cargas de computación de altas prestaciones.
Esta categoría incluye varias generaciones de aceleradores NVIDIA, desde A100 hasta H100, H200 y Blackwell, además de la familia Instinct de AMD. Aun así, hay que comprobar las especificaciones, el software compatible y la validación del servidor para cada referencia. Una arquitectura más reciente no es automáticamente más adecuada para un modelo o motor de ejecución existente.
El formato de despliegue es otra decisión. Algunos aceleradores son tarjetas PCIe; otros forman parte de una plataforma integrada con varias GPU. La comparación entre PCIe y SXM explica cómo influye esta elección en la ampliación, la alimentación, la refrigeración y la comunicación entre GPU.
Empezar por el trabajo que hará la máquina
Para desarrollo y tareas de inferencia independientes, una tarjeta de consumo o de estación de trabajo puede ser un punto de partida razonable. Para un modelo que necesita más memoria o dedica una parte importante de su ejecución a intercambiar datos entre GPU, una plataforma de centro de datos puede justificar su mayor coste. En ambos casos, el servidor anfitrión necesita suficiente CPU, RAM, almacenamiento y ancho de banda de red para mantener ocupados los aceleradores; estos requisitos se explican en la guía de la plataforma de servidor.
Conviene pagar por capacidades que la carga de trabajo pueda utilizar. Más memoria puede hacer viable un despliegue que de otro modo sería imposible. Una interconexión que el software nunca utiliza añade coste sin aumentar la capacidad útil.
PCIe o SXM: elegir una plataforma de GPU para IA
Cómo influyen la memoria, las interconexiones, la alimentación y las necesidades de ampliación al elegir entre tarjetas PCIe y plataformas SXM integradas.
Dos sistemas pueden llevar GPU de la misma familia y comportarse de manera muy distinta. La diferencia puede estar en la variante de GPU, su límite de potencia, su memoria o los enlaces que la conectan con otras GPU. Comparar PCIe y SXM exige, por tanto, comparar configuraciones completas, además de los conectores.
Una tarjeta frente a una plataforma integrada
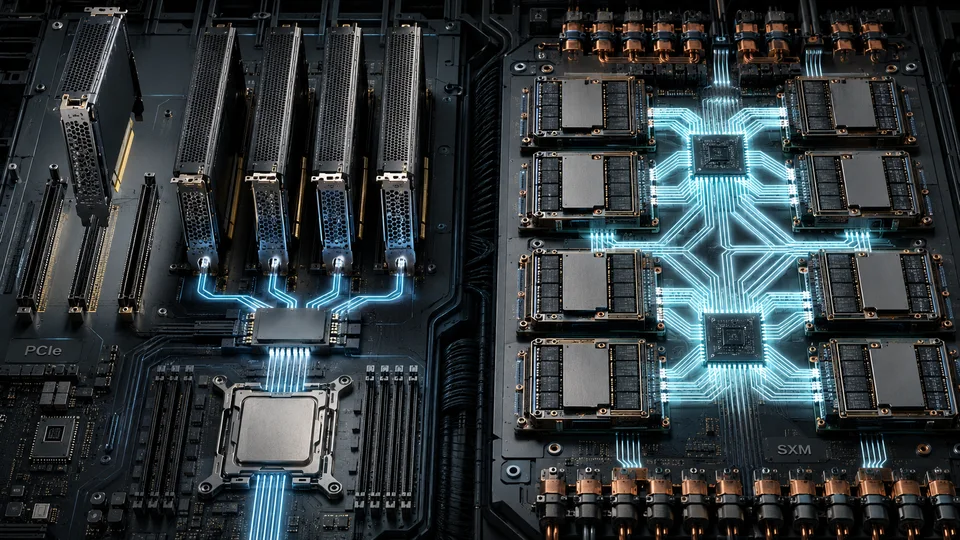
Una GPU PCIe es una tarjeta de expansión instalada en un servidor o estación de trabajo compatible. SXM es el formato de módulo de NVIDIA para GPU montadas sobre una placa base específica. Un módulo SXM no se puede insertar en una ranura PCIe: necesita una plataforma diseñada para él, incluida su alimentación y refrigeración.
En los sistemas HGX H100 y H200 de ocho GPU, los módulos SXM se comunican mediante NVLink y NVSwitch. Esto proporciona una red de interconexión de gran ancho de banda dentro del servidor. Su valor depende de si la carga de trabajo realmente mueve grandes cantidades de datos entre GPU.
Algunas variantes PCIe también admiten puentes NVLink. El número de GPU y la disposición de los puentes compatibles dependen del producto y de la configuración del servidor. No debe suponerse que toda tarjeta PCIe admite NVLink ni que una pareja conectada por un puente ofrece la misma topología que una placa HGX de ocho GPU. Cuando las GPU se comunican por PCIe, también importan la conexión con las CPU, los conmutadores PCIe y la distribución NUMA.
Cuándo compensa una comunicación rápida entre GPU
Un modelo grande repartido entre varias GPU puede necesitar comunicación frecuente durante el entrenamiento o la inferencia. En esas condiciones, reducir el tiempo de comunicación puede mejorar considerablemente la utilidad de cada GPU adicional. Conviene evaluar una plataforma SXM integrada cuando las mediciones identifican esa comunicación como un cuello de botella.
Las tareas independientes plantean otra situación. Si ocho usuarios ejecutan cada uno un modelo en una GPU distinta, sus trabajos pueden compartir pocos datos, o ninguno, a través de la interconexión entre GPU. Pueden beneficiarse de un servidor denso sin aprovechar mucho NVSwitch. La comparación de servidores DGX, HGX y PCIe distingue el valor de la interconexión del valor del sistema completo y sus servicios de soporte.
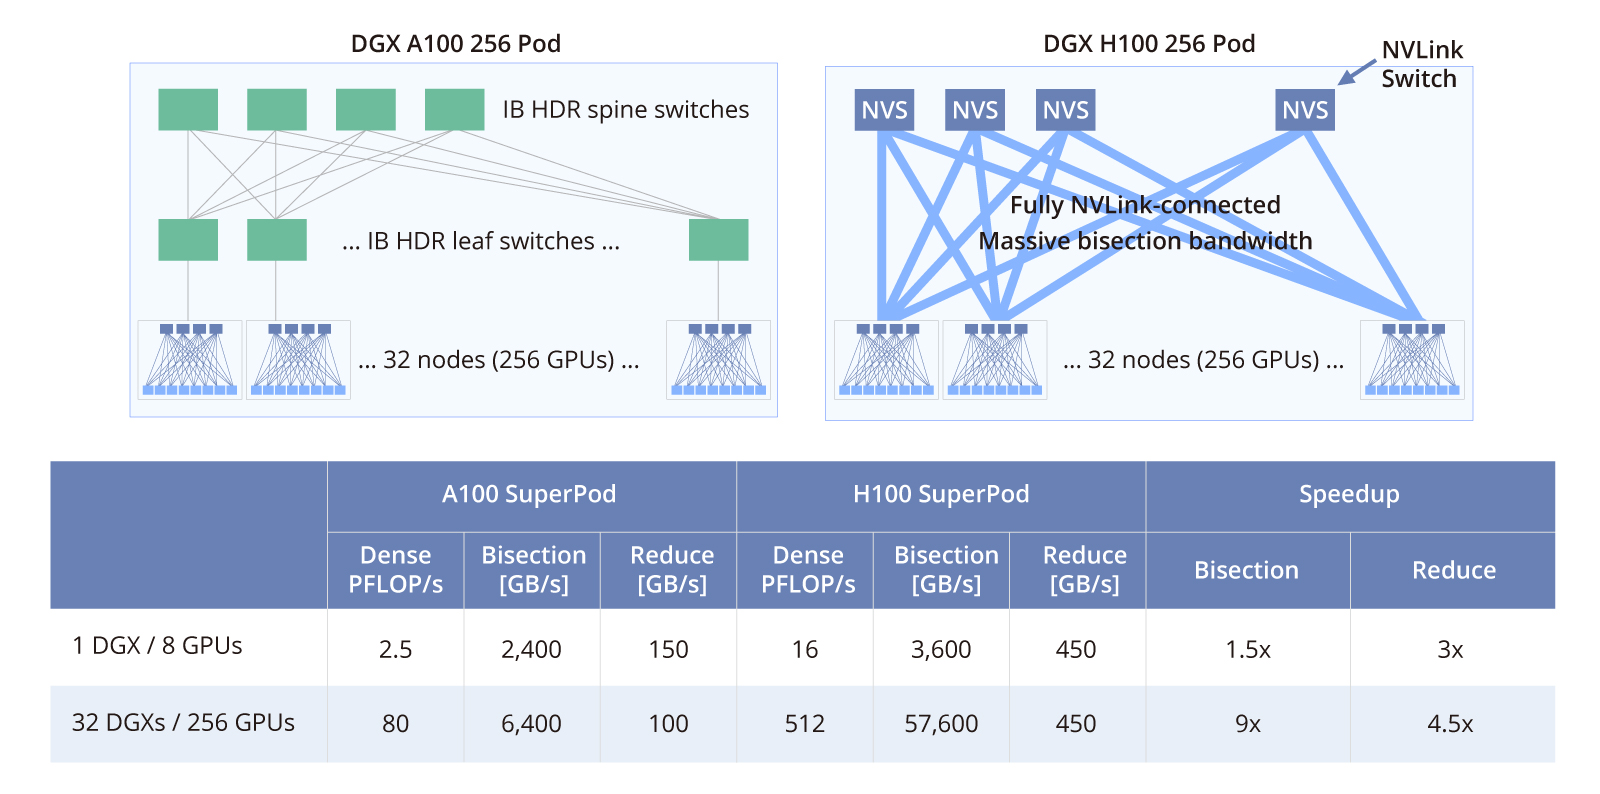
Importa delimitar la interconexión. En los sistemas H100 y H200 tratados aquí, NVSwitch conecta las GPU dentro de un nodo. La comunicación entre servidores también requiere una red de cómputo, tarjetas de red adecuadas y software configurado para utilizarlas. La arquitectura de referencia DGX SuperPOD de NVIDIA describe por separado las redes de cómputo, almacenamiento y gestión. Los sistemas NVLink a escala de rack de otras generaciones deben evaluarse según su propia arquitectura; su topología no se puede deducir de este ejemplo de ocho GPU.
Ampliación y utilización
A menudo se puede adquirir un servidor PCIe compatible con menos GPU y ampliarlo más adelante. Esa flexibilidad resulta útil cuando la demanda crece gradualmente, los usuarios necesitan distintos tipos de tarjeta o aún se está caracterizando la carga de trabajo. La ampliación sigue dependiendo de la configuración aprobada del servidor: puede ser necesario especificar desde el principio las fuentes de alimentación, las tarjetas elevadoras, los kits de refrigeración y las combinaciones de GPU admitidas.
Un sistema SXM integrado concentra una mayor parte de la inversión inicial. La estandarización puede simplificar la operación del conjunto de equipos, pero las GPU inactivas y la capacidad de interconexión sin utilizar siguen siendo costes reales. Antes de elegirlo, hay que medir si la aplicación escala eficazmente de una o dos GPU a cuatro y ocho.
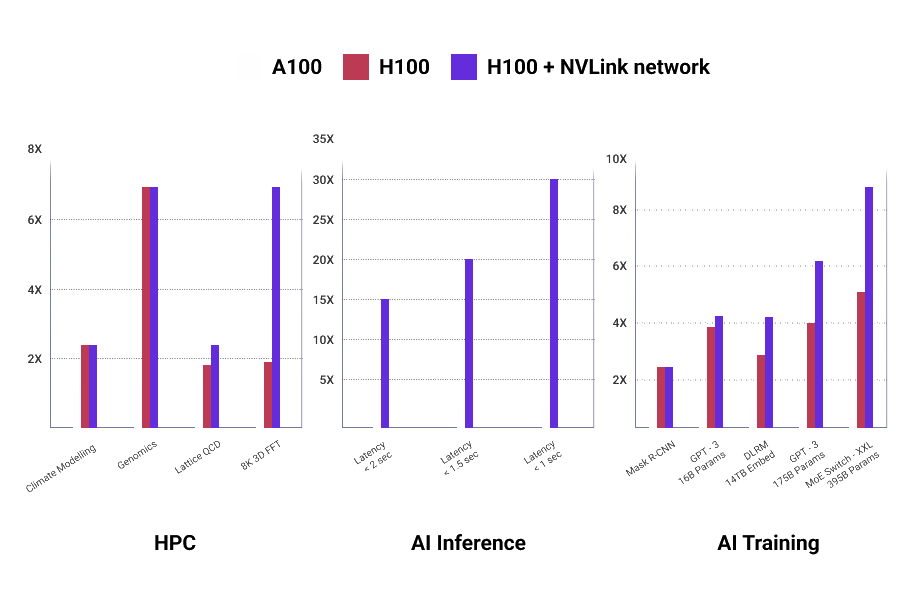
Memoria y potencia: comparar las variantes exactas
La H100 PCIe original de 80 GB utiliza HBM2e, según la ficha de producto H100 PCIe de NVIDIA. La H100 SXM de 80 GB utiliza HBM3. La hoja de datos H100 indica anchos de banda nominales de memoria de aproximadamente 2 TB/s y 3,35 TB/s, respectivamente. H100 NVL es otra configuración; sus especificaciones no deben sustituir a las de la tarjeta PCIe de 80 GB.
El límite de potencia también cambia: la H100 PCIe de 80 GB llega a 350 W, mientras que las configuraciones H100 SXM pueden alcanzar 700 W por GPU. El servidor debe estar diseñado para el punto de funcionamiento elegido. Estas cifras, por sí solas, no determinan la eficiencia energética. Una GPU de mayor potencia puede terminar antes una tarea adecuada; otra poco utilizada puede consumir más energía sin acortar suficientemente la ejecución. Hay que medir la energía y el coste por tarea completada, además del tiempo transcurrido.
La capacidad y el ancho de banda de memoria, así como la capacidad de cálculo, pueden cambiar entre variantes y generaciones. El soporte de formatos numéricos añade otra dimensión: INT8 y FP8 en la práctica explica por qué una especificación de hardware no garantiza una vía de ejecución utilizable.
Ajustar la plataforma al patrón de comunicación
| Característica de la carga | Qué evaluar primero |
|---|---|
| Tareas independientes de inferencia, desarrollo o análisis | Tarjetas PCIe con suficiente memoria y una configuración anfitriona adecuada |
| Un modelo que cabe en una o dos GPU | La configuración compatible más sencilla que cumpla los objetivos de latencia y rendimiento |
| Entrenamiento o inferencia con mucha comunicación entre varias GPU | SXM/HGX junto con alternativas PCIe medidas |
| Computación científica distribuida | El patrón real de comunicación, los requisitos numéricos y la eficiencia de escalado de la aplicación |
| Un trabajo repartido entre varios servidores | La arquitectura completa de red y almacenamiento, además de la interconexión de GPU |
Las etiquetas de aplicación son demasiado amplias para decidir la plataforma. La imagen médica, los modelos de lenguaje y la computación científica pueden incluir tanto tareas independientes como trabajos estrechamente acoplados. Hay que partir del modelo y de su patrón de ejecución, medir el cuello de botella y calcular después el coste del hardware que lo elimina. Para una selección PCIe, continúe con cómo elegir el servidor adecuado para la tarjeta.
Elegir una GPU para IA: rendimiento, coste y carga de trabajo real
Comparar el rendimiento útil con el coste completo del despliegue: memoria, software, servidor anfitrión y forma de utilizar el servicio.
Cuando se elaboró la primera versión de esta guía, las RTX 6000 Ada, A100 y H100 eran opciones destacadas para infraestructuras de aprendizaje profundo. H200 y Blackwell han ampliado desde entonces las alternativas. El criterio de decisión sigue siendo el mismo: una GPU más reciente o potente compensa únicamente si la carga de trabajo prevista puede aprovechar lo que ofrece.
Comprar un acelerador de gama alta sin evaluar la aplicación suele provocar tres problemas:
- La GPU y la plataforma de servidor que necesita pueden costar mucho más de lo que justifica su rendimiento útil.
- Las tareas pequeñas o poco paralelizadas pueden dejar inactiva gran parte de la capacidad de cálculo.
- El software diseñado para una sola GPU puede necesitar cambios importantes antes de beneficiarse de un sistema con varias GPU.
Por eso, para un equipo de desarrollo con presupuesto limitado, un servicio de inferencia o una instalación de investigación compartida, las tarjetas de consumo y de estación de trabajo deben figurar entre las candidatas junto con los aceleradores de centro de datos. La cuestión es cuánta capacidad utilizable proporciona la inversión completa.
Qué enseñan las pruebas históricas
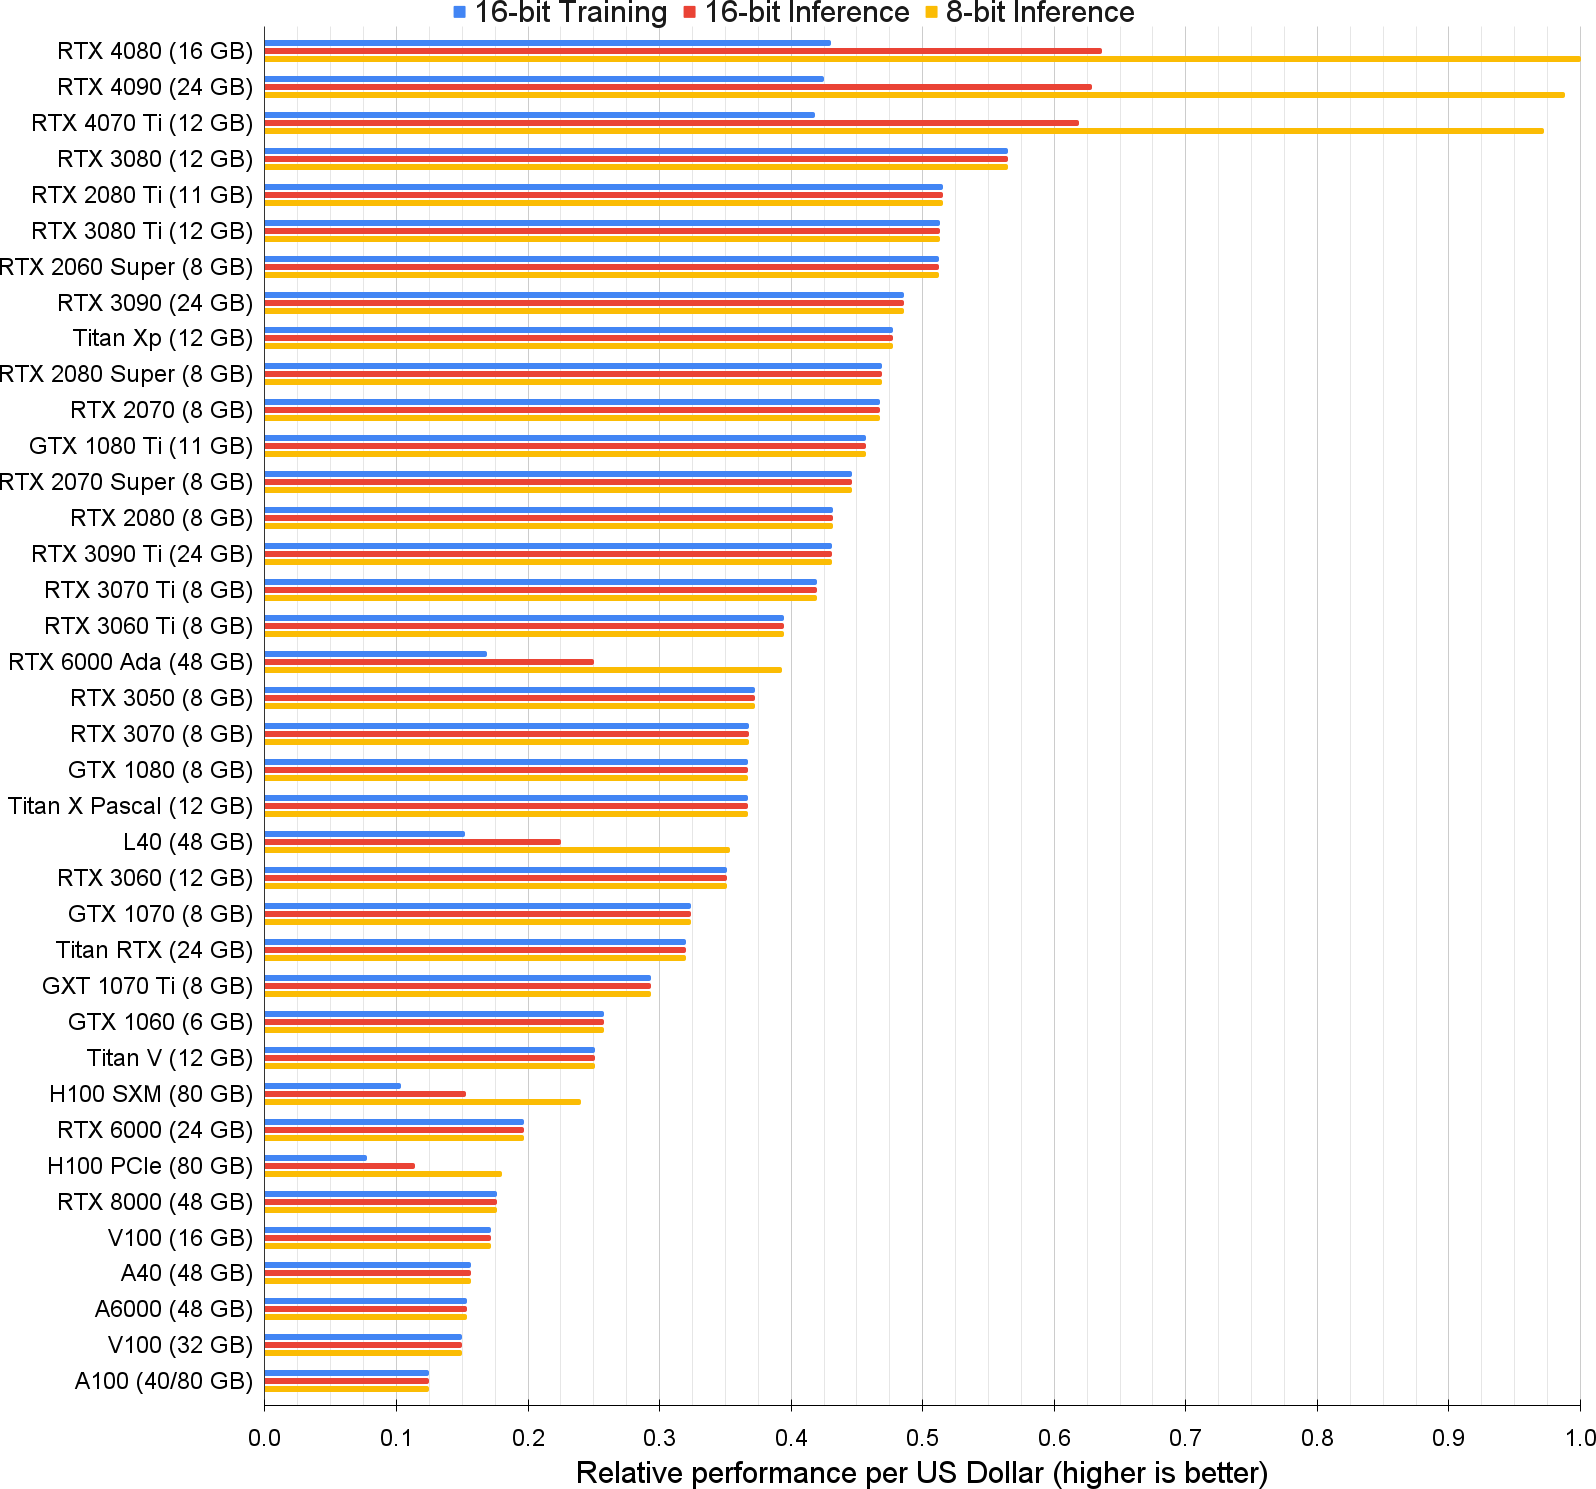
El siguiente gráfico procede del análisis de GPU para aprendizaje profundo publicado por Tim Dettmers en 2023. Con las cargas y los precios considerados, tarjetas como la RTX 4090 ofrecían una relación atractiva entre rendimiento y coste frente a la A100. Los resultados ilustran un método de comparación; no son precios actuales ni una clasificación válida para todos los modelos.
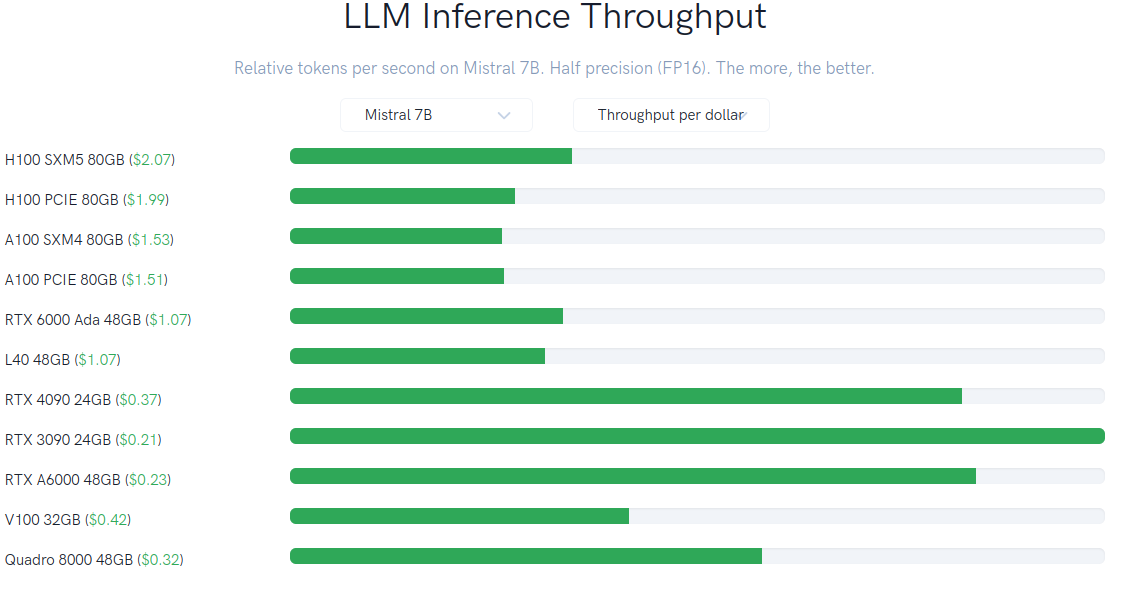
Las siguientes capturas de las pruebas de TensorDock muestran la misma idea para cargas concretas de modelos de lenguaje. Una tarjeta económica puede obtener buenos resultados en una prueba, mientras que otra carga cambia el orden. Son capturas conservadas del artículo original: los precios de alquiler, los controladores y los motores de ejecución han cambiado desde que se obtuvieron.
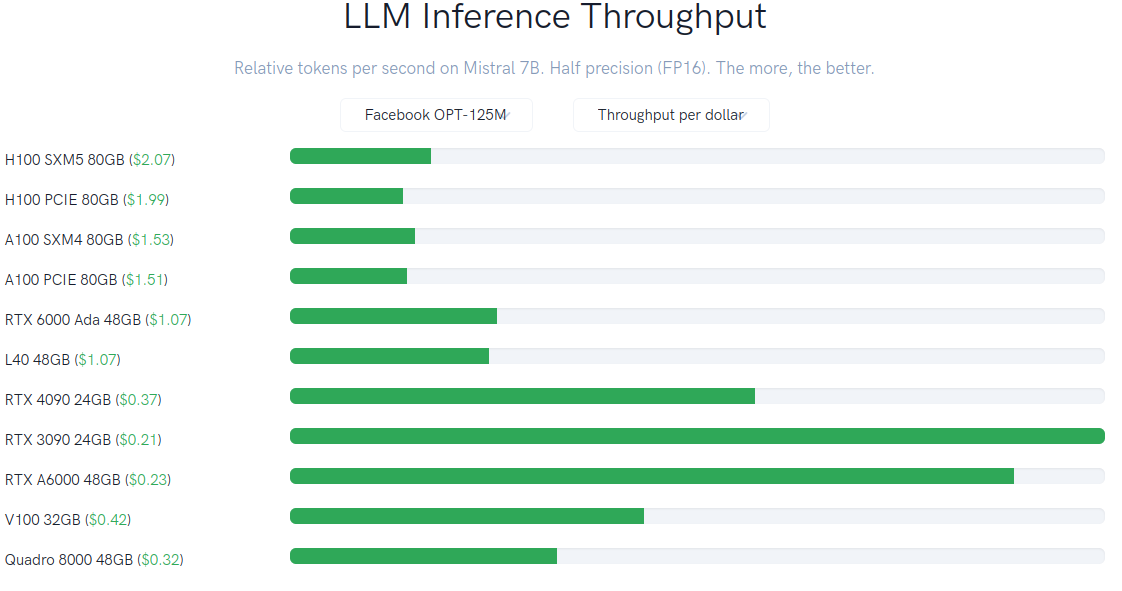
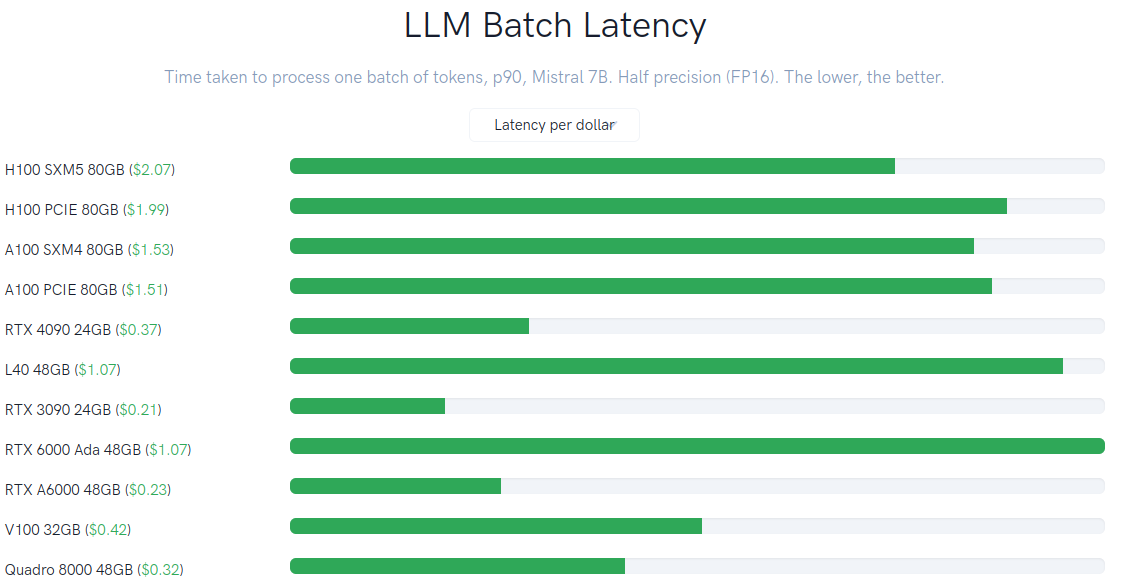
El entrenamiento y la inferencia exigen cosas distintas al hardware. En inferencia suele importar si caben los pesos y la caché KV, cuántas solicitudes se pueden atender a la vez y cuánto tarda cada usuario en recibir una respuesta. El entrenamiento necesita además gradientes, activaciones y estados del optimizador. El entrenamiento distribuido añade comunicación recurrente entre GPU.
Por tanto, un resultado de inferencia no se puede trasladar al entrenamiento. Incluso dentro de cada categoría, el tamaño del modelo, el tamaño de lote, la precisión numérica y la memoria disponible pueden cambiar el resultado. La diferencia entre un formato que figura en una ficha técnica y el que realmente utiliza el motor de ejecución se explica en INT8 o FP8: soporte real de la GPU.
Comparar el despliegue completo
NVIDIA ofrece algunas tarjetas de consumo como diseños de referencia, mientras que fabricantes asociados como ASUS, MSI y Gigabyte comercializan sus propias versiones. El precio refleja algo más que el procesador: pueden variar el disipador, las dimensiones, la alimentación, el ruido y otras características. Una función útil en un ordenador para videojuegos puede aportar poco a una máquina dedicada a IA.
La calidad de construcción, el precio y los requisitos de integración merecen más atención que los elementos decorativos. Muchas variantes de RTX 4090 son demasiado grandes o tienen un flujo de aire inadecuado para un despliegue denso en servidores. Incluso una tarjeta compacta o con ventilador de turbina debe comprobarse por su número de pieza exacto. La denominación comercial de un distribuidor no sustituye a una especificación oficial ni a una configuración admitida por el fabricante del servidor. La selección de servidores para GPU PCIe detalla las comprobaciones mecánicas, térmicas y eléctricas.
El coste debe incluir el servidor anfitrión, la refrigeración, la alimentación, la preparación del software y la utilización prevista. Una GPU barata que exige mucho trabajo de integración puede salir cara al operarla. A la inversa, un sistema integrado costoso puede aportar poco si cada trabajo se ejecuta de forma independiente en una tarjeta.
Un conjunto reducido y deliberado de configuraciones
Un servicio de cómputo compartido no necesita necesariamente un único modelo de GPU para todos sus clientes. Un conjunto limitado de configuraciones puede atender distintas necesidades de memoria y rendimiento sin complicar demasiado la operación. Conviene estandarizar donde se reduzca el trabajo de soporte e introducir otro tipo de tarjeta cuando una carga diferenciada lo justifique.
Las comparaciones de rendimiento por coste tienen una larga historia. Por ejemplo, la comparación de Lambda entre RTX 2080 Ti, V100 y otras GPU de la época dividía el rendimiento por el coste total del sistema. Las cifras son históricas, pero el método sigue siendo útil.
Para una compra actual, hay que ejecutar el modelo previsto con sus longitudes de entrada, tamaños de lote y objetivos de servicio reales. Después se compara el coste de la capacidad que supera esas pruebas. La tarjeta más potente sobre el papel puede ser la elección correcta, pero debe demostrarlo con la carga de trabajo.
INT8 o FP8: qué puede ejecutar realmente una GPU
Un formato de modelo de ocho bits no define su vía de ejecución. Hay que examinar los kernels, la memoria y la calidad antes de elegir hardware para inferencia de modelos de lenguaje.
La selección de GPU suele comenzar por la capacidad de memoria y el rendimiento máximo de cálculo. Si los pesos del modelo caben y su formato numérico aparece en la ficha técnica, la compatibilidad puede parecer resuelta. Trasladar un modelo INT8 a una GPU más reciente puede revelar el fallo de esa suposición: el modelo puede fallar al ejecutarse o rendir de forma muy distinta a la esperada.
La guía de selección de GPU utiliza la adecuación a la carga y el coste operativo como criterios principales. Este artículo examina un detalle de esa decisión: si el software utiliza realmente la capacidad que se está comprando. Se centra en la inferencia de modelos de lenguaje. El entrenamiento y otras cargas de cálculo entero requieren una evaluación propia.
INT8 y FP8 representan números distintos
INT8 y FP8 utilizan ocho bits para la representación básica de cada valor, pero no lo codifican igual. En los esquemas habituales de cuantización INT8, un entero y una escala aproximan un número real. Los valores reconstruidos dentro de un grupo que comparte escala están espaciados uniformemente. FP8 dedica algunos bits a un exponente, por lo que el espaciado cambia con la magnitud. FP8 también suele necesitar escalado, como explica la documentación de cuantización de TensorRT.
FP8 tiene varias representaciones. E4M3 utiliza cuatro bits de exponente y tres de mantisa; E5M2 utiliza cinco y dos, sacrificando precisión a cambio de un rango mayor. La introducción a Transformer Engine de NVIDIA explica la diferencia. La representación en coma flotante no garantiza por sí sola un error menor en un modelo concreto.
En las denominaciones de modelos cuantizados, W se refiere a los pesos y A a las activaciones: los valores intermedios que pasan por las capas. W8A8 especifica el número de bits de ambos grupos. Por sí solo, no identifica si el cálculo utiliza enteros o coma flotante.
| Descripción del modelo | Significado | Qué falta comprobar |
|---|---|---|
| INT8 W8A8 | Los pesos y las activaciones de las operaciones cuantizadas utilizan enteros de ocho bits | Escalado, soporte de kernels y capas excluidas |
| FP8 W8A8 | Los pesos y las activaciones de las operaciones cuantizadas utilizan coma flotante de ocho bits | Variante FP8, formato de escala y operaciones cubiertas |
| W8A16 con pesos INT8 | Los pesos están comprimidos; las activaciones utilizan dieciséis bits | Reconstrucción de los pesos y precisión real de la multiplicación de matrices |
| Caché KV en FP8 | Se cuantizan las claves y los valores de atención | Los formatos de pesos y el cálculo de las capas se configuran por separado |
Estas diferencias también aparecen en la documentación de cuantización de vLLM. La precisión de acumulación es otra elección independiente: por ejemplo, entradas INT8 pueden utilizar acumulación INT32. Un modelo de ocho bits no ejecuta necesariamente todas sus operaciones con esa precisión.
La memoria de los pesos es solo una parte
Exactamente 70.000 millones de parámetros almacenados a un byte cada uno ocupan 70 GB decimales, unos 65,2 GiB. La cifra bruta es igual para INT8 y FP8. No incluye escalas, capas de mayor precisión, búferes temporales ni memoria del motor de ejecución.
La caché KV también crece con la longitud del contexto y las solicitudes activas. Como explica la guía de caché KV de vLLM, su formato se configura por separado. Cuantizar los pesos a ocho bits no cuantiza automáticamente la caché.
Hay que medir la memoria con la longitud de entrada, la longitud de salida y la concurrencia requeridas. Cargar correctamente un modelo no demuestra la capacidad de servirlo. Esto amplía la comparación de familias de GPU: más memoria puede hacer posible el despliegue, pero la capacidad de servicio depende del conjunto completo de datos de trabajo.
La relación entre INT8 y FP8 cambia en B300
La diferencia entre B200 y B300 ofrece un ejemplo útil. Las cifras siguientes son tasas nominales densas por GPU. Para B200 y B300 proceden de la tabla 3, página 25, del informe técnico de arquitectura Blackwell de NVIDIA. Las cifras de H200 SXM se obtienen eliminando el multiplicador por dispersión de los valores publicados por el fabricante.
| GPU y configuración de referencia | FP8 denso, TFLOPS | INT8 denso, TOPS | Relación nominal FP8/INT8 |
|---|---|---|---|
| H200 SXM | 1979 | 1979 | 1:1 |
| B200 en HGX | 4500 | 4500 | 1:1 |
| B300 en HGX | 4500 | 150 | Aproximadamente 30:1 |
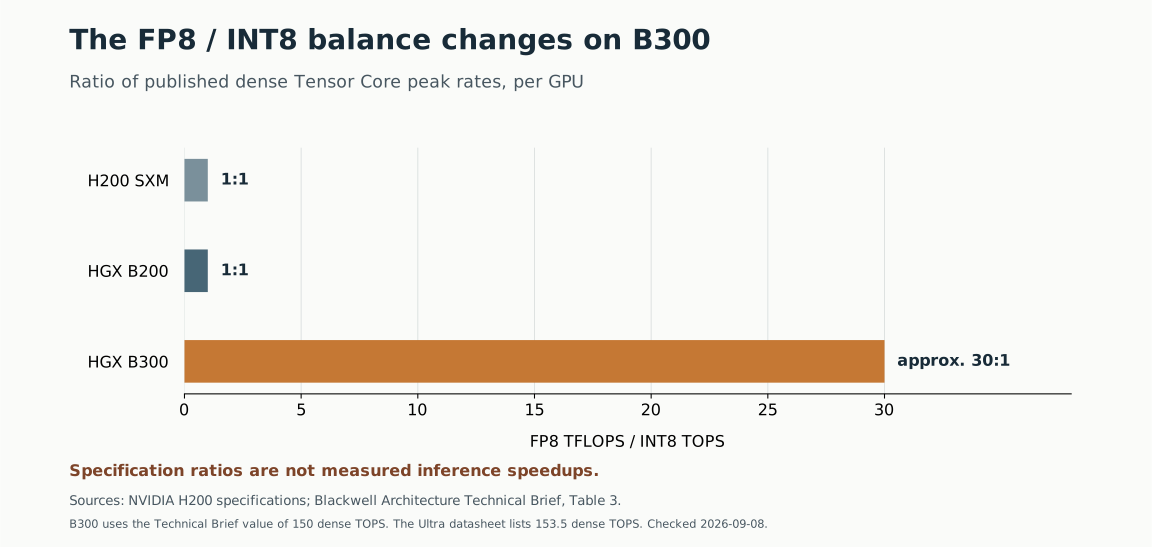
La hoja de datos Blackwell Ultra, página 5, indica 307 TOPS INT8 con dispersión para HGX B300, equivalentes a 153,5 TOPS densos. El informe técnico utiliza el valor redondeado de 150, base de este gráfico. No deben mezclarse estas cifras con la columna GB300 NVL72 ni con otras configuraciones. La comparación de DGX y HGX explica por qué importa distinguir las plataformas.
También hay una diferencia entre esos documentos y la tabla de producto HGX en línea, consultada el 9 de septiembre de 2026. Esta última indica 3 POPS INT8 con dispersión para un HGX B300 de ocho GPU, equivalentes a 187,5 TOPS densos por GPU. Esa es la base de la comparación interactiva de esta colección; frente a 4500 TFLOPS FP8 densos, la relación es 24:1. El gráfico anterior conserva deliberadamente la base de 150 TOPS del informe técnico. Las cifras publicadas no son idénticas: cada comparación debe conservar su fuente y configuración, y una compra requiere confirmar la especificación aplicable.
La reducción de la tasa nominal INT8 en este ejemplo se produce entre B200 y B300; no afecta a todos los productos Blackwell. Además, TFLOPS y TOPS describen aquí operaciones de tipos distintos. Su relación no significa que un modelo INT8 vaya a ejecutarse treinta veces más despacio.
De la ficha técnica a un kernel ejecutable
Aquí, un kernel es una función de cálculo ejecutada en la GPU, como la multiplicación de matrices de una capa; no se refiere al núcleo del sistema operativo. Deben coincidir tres cosas: la instrucción ha de ser válida para la arquitectura de destino, la biblioteca debe proporcionar una implementación adecuada y el motor de ejecución debe seleccionarla para el modelo.
La versión 2 de la prepublicación de agosto de 2026 Spec Sheets Are Not Kernels examina esa cadena en Blackwell Ultra. Revisa documentación y código de versiones concretas; no presenta pruebas de velocidad ni de calidad de modelos. Sus resultados deben interpretarse dentro de ese alcance.
| Capa | Resultado del estudio de caso | Límite de la conclusión |
|---|---|---|
| Instrucción de GPU | PTX 9.3 enumera tcgen05.mma con .kind::i8 para sm_100a, pero no para sm_103a | La ausencia de esta vía de quinta generación no elimina toda capacidad INT8 |
| CUTLASS | En el commit dcf215a, el generador excluye la generación de INT8 UMMA para el destino 103a | No puede suponerse que SM103 se comporte como SM100 |
| vLLM | La vía SM100 W8A8 del commit 6c95a641 no tiene implementación INT8 | Incluso la capacidad de hardware de B200 puede quedar sin utilizar en esta vía |
| SGLang | El kernel INT8 examinado en el commit b20c375 cubre arquitecturas hasta Hopper | El resultado se refiere a ese kernel, no a todos los métodos INT8 de SGLang |
Las referencias directas son el manual de instrucciones PTX, el generador de CUTLASS, el código de selección de operaciones de vLLM y el kernel de SGLang. Los enlaces de código fijan deliberadamente commits concretos. Hay que revisar por separado la versión instalada.
En el caso de vLLM, la comprobación inicial de compatibilidad puede superarse antes de que la primera ejecución revele la ausencia de una vía de cálculo. Por eso, una prueba de compatibilidad debe llegar al menos a producir una salida. Un modelo más pequeño con el mismo método de cuantización puede revelar el problema antes, pero la aceptación final exige el modelo previsto: las dimensiones de las matrices y su arquitectura pueden cambiar la selección de kernels.
El estudio también trata la desactivación de un kernel CUTLASS mediante VLLM_DISABLED_KERNELS y el examen de una alternativa Triton. Ese mecanismo se probó en Ada, sin una medición de rendimiento en B300. La existencia de una alternativa no basta para recomendarla en un despliegue B300.
Las versiones del controlador, las bibliotecas y el motor de ejecución deben acompañar a los resultados. Las implicaciones de mantenimiento y seguridad de esta cadena se explican en La seguridad de la infraestructura de IA empieza por el núcleo y la GPU.
Las tasas máximas no determinan el tiempo de respuesta
El tiempo de ejecución depende del tráfico de memoria, las dimensiones de las matrices, el paralelismo y la calidad de la implementación. La guía de rendimiento de multiplicación de matrices de NVIDIA explica cómo la relación entre operaciones y datos transferidos ayuda a determinar si una operación está limitada por cálculo o por memoria.
El procesamiento inicial del contexto —prefill— y la generación token a token —decode— tienen patrones distintos. Aumentar la concurrencia puede mejorar la utilización del cálculo, pero también cambia el consumo de memoria y la espera en cola. Cuando FP8 e INT8 utilizan implementaciones distintas, la prueba compara configuraciones completas; no se puede atribuir toda la diferencia al formato numérico.
La ejecución con varias GPU añade costes de comunicación. Hay que evaluar la conectividad PCIe y SXM junto con la precisión. Un máximo aritmético mayor no compensa un cuello de botella en otra parte de la ejecución.
Cambiar de formato exige evaluar la calidad
Si FP8 dispone de una vía mejor soportada en el hardware de destino, merece la pena probar la migración. Reinterpretar bytes INT8 como FP8 no convierte válidamente un modelo: el mapeo numérico y las escalas son distintos. Cuando existen pesos de mayor precisión, preparar la cuantización de destino a partir de ellos evita añadir otra conversión sobre una representación ya cuantizada.
La calidad depende del método de preparación. Por ejemplo, SmoothQuant trata valores atípicos de las activaciones para permitir W8A8 con poca degradación en sus evaluaciones publicadas. Un estudio de ACL de 2025 sobre calidad y eficiencia de la cuantización examina varios formatos de la familia Llama-3.1 bajo distintas condiciones de despliegue. Ninguno garantiza la calidad para los documentos, la combinación de idiomas o la terminología especializada de una organización concreta.
Los datos de prueba deben reflejar el trabajo: extraer importes y nombres, conservar negaciones y condiciones, responder con evidencia y devolver resultados estructurados. Un cambio inocuo de redacción no equivale a omitir una condición contractual o modificar un importe. La comparación con el modelo de referencia debe distinguir esos errores. En servicios multilingües o especializados, hay que incluir los sistemas de escritura, los términos y las estructuras documentales que realmente presentan los usuarios.
Solicitar una prueba de servicio reproducible
Una solicitud de compra debe identificar una configuración ejecutable: versión del modelo, método de cuantización, motor, GPU y carga de trabajo. La información siguiente permite comparar propuestas con sentido.
| Área | Qué debe registrar el informe |
|---|---|
| Modelo y entorno | Versión o hash de los pesos, método de cuantización, modelo de GPU, versiones del controlador y del motor |
| Ejecución real | Salida del modelo previsto y kernels seleccionados para las operaciones dominantes |
| Capacidad | Uso de memoria con las longitudes de entrada y salida y la concurrencia previstas |
| Calidad | Errores relevantes para la aplicación frente al modelo de referencia con datos representativos |
| Respuesta | Tiempo hasta el primer token, tiempos de los tokens posteriores y percentiles de latencia |
| Coste | Capacidad útil de servicio, conversión del modelo y mantenimiento de la configuración |
La explicación de las métricas de servicio de vLLM distingue la tasa bruta de salida de goodput: la capacidad que cumple los objetivos del servicio. En una aplicación interactiva, el número de solicitudes atendidas dentro de límites aceptables de calidad y latencia es más útil que la tasa máxima de tokens de una ejecución aislada. Los tiempos de carga y calentamiento deben informarse por separado de las mediciones en régimen estable.
Si un despliegue INT8 existente satisface las necesidades del servicio, la aparición de otra generación de GPU no justifica por sí sola una migración. Para un despliegue nuevo, la comparación debe incluir la preparación del modelo, las pruebas de calidad y el mantenimiento del software. Una GPU más cara con una vía FP8 madura puede costar menos al operarla; también puede ser preferible conservar la infraestructura actual. La misma prueba de modelo y servicio debe decidir entre ambas opciones.
Fuentes y base numérica
Las fuentes se enlazan junto a las afirmaciones que sustentan. El gráfico utiliza las especificaciones H200 y la tabla 3 del informe técnico Blackwell; sus datos descargables registran la base de cada fila. La revisión numérica del artículo de origen es del 8 de septiembre de 2026.
Los resultados de software se refieren a las versiones examinadas en el estudio de agosto de 2026. Este artículo no presenta una prueba independiente de B300, y el estudio de base no auditó TensorRT-LLM. La referencia inicial a TensorRT se utiliza únicamente para explicar los formatos numéricos.
Por qué la GPU más rápida no siempre ofrece la respuesta más rápida
Más capacidad de cálculo y una mayor tasa de tokens no siempre se traducen en una respuesta más rápida. Analizamos el tiempo hasta el primer token y hasta completar la respuesta, la memoria, la concurrencia, el reparto entre GPU y LPU y el coste de comunicación para elegir infraestructura según la capacidad de atender solicitudes con la calidad y latencia necesarias.
Del tiempo hasta el primer token a la velocidad de generación: cómo la memoria, la concurrencia y la comunicación determinan el rendimiento real de la inferencia
Un sistema de inferencia puede producir más tokens por segundo y, aun así, hacer que el usuario espere más para recibir una respuesta. Incluso puede empezar a escribir antes y terminar después. Estas diferencias no son contradicciones: surgen al medir cosas distintas bajo una misma etiqueta, «velocidad».
El artículo anterior, «INT8 o FP8: qué puede ejecutar realmente una GPU», examinaba por qué el rendimiento anunciado en las especificaciones del hardware no siempre está disponible en la vía real de ejecución del modelo. Aquí avanzamos un paso más: aunque el modelo utilice el kernel adecuado y la aceleración del hardware, la capacidad de cálculo de la tarjeta sigue sin permitir predecir el tiempo de respuesta del servicio.
Para elegir infraestructura hay que saber qué tiempo se pretende reducir, cuántas solicitudes simultáneas deben cumplir ese objetivo y cuánto costará conseguirlo. Este artículo, el segundo de esta secuencia dentro de la colección de selección de GPU e infraestructura de IA, estudia esa relación.
Cuando decimos «rápido», ¿qué estamos midiendo?
El usuario envía una solicitud, espera, ve la primera parte de la respuesta y después recibe el resto. Esa experiencia comprende al menos dos medidas temporales distintas: la espera hasta el inicio de la respuesta y los intervalos de producción de sus partes posteriores.
| Métrica | Definición operativa | Utilidad |
|---|---|---|
| TTFT: tiempo hasta el primer token | Intervalo entre el envío de la solicitud y la recepción del primer token de contenido | Medir la espera inicial |
| TPOT: tiempo por token de salida | Tiempo medio de producción de los tokens posteriores al primero | Medir el ritmo de continuación de la respuesta |
| ITL: latencia entre tokens | Intervalos de recepción durante el flujo de salida, teniendo en cuenta los tokens de cada fragmento | Detectar pausas y variaciones |
| Tasa de tokens por usuario | Número de tokens posteriores al primero, dividido entre el tiempo empleado en recibirlos | Medir la velocidad de generación de una solicitud |
| Rendimiento total de salida | Total de tokens de salida en el intervalo de medición, dividido entre su duración | Medir la capacidad total del servicio |
| Latencia de extremo a extremo | Intervalo entre el envío de la solicitud y la recepción del último token | Medir el tiempo hasta completar la respuesta |
Esta distinción es coherente con las herramientas de evaluación de inferencia, pero los resultados deben ir acompañados de las definiciones precisas de cada herramienta. Algunas miden el intervalo entre fragmentos de respuesta, y cada fragmento puede contener varios tokens. Documentación de métricas de GenAI-Perf
En este artículo, sean el instante de envío de la solicitud, la llegada del primer token, la llegada del último y el número de tokens de salida:
Para esta solicitud y esta convención de medición, la tasa de generación por usuario es, por tanto, el inverso del TPOT. Sin embargo, el inverso del TPOT medio de varias solicitudes no tiene por qué coincidir con la media de sus tasas de generación.
El TTFT medido en el cliente tampoco es solo tiempo de ejecución de la GPU: incluye las colas, la red y el procesamiento de la solicitud. En modelos de razonamiento, el primer token de razonamiento puede llegar mucho antes que la primera parte de la respuesta final. AIPerf dispone de una métrica independiente de «tiempo hasta el primer token de salida que no sea de razonamiento» para distinguirlos. Definición de métricas de AIPerf
Por ello, «una respuesta en medio segundo» es una descripción incompleta si no se especifica dónde termina la medición.
Empezar antes no garantiza terminar antes
Consideremos dos configuraciones hipotéticas:
| Configuración | TTFT | TPOT | Tasa de generación después del primer token | Final de una respuesta de 101 tokens | Final de una respuesta de 1001 tokens |
|---|---|---|---|---|---|
| A | 0,4 s | 40 ms | 25 tokens/s | 4,4 s | 40,4 s |
| B | 1 s | 20 ms | 50 tokens/s | 3 s | 21 s |
Las cifras son ilustrativas y no corresponden a un hardware concreto. Se supone que las longitudes de salida son iguales y que los TPOT indicados se mantienen en ambas longitudes. El tiempo hasta completar la respuesta se calcula así:
La configuración A empieza antes; la B termina antes las respuestas largas. En este ejemplo, ambas terminan al mismo tiempo una salida de 31 tokens; a partir de ahí, B se adelanta.
Esta diferencia importa al definir los requisitos. Para mostrar una respuesta corta, la espera inicial puede ser el problema principal. Al generar un informe o encadenar llamadas dependientes, cobra más importancia el tiempo de finalización. En un sistema basado en agentes también deben mantenerse en el cálculo el número de pasos, la longitud de salida de cada uno y el tiempo de las herramientas. Acelerar la generación de tokens no reduce la duración de todos los componentes del proceso.
La inferencia no es una carga de trabajo uniforme
En la ejecución habitual de un modelo de lenguaje autorregresivo, prefill procesa la entrada y almacena las claves y los valores de las capas de atención en la caché KV. El resultado de ese procesamiento también se utiliza para seleccionar el primer token. Después, decode continúa la generación utilizando el estado anterior y amplía la caché KV.
Durante prefill, muchos tokens de entrada pueden participar en los cálculos matriciales. En decode convencional, cada solicitud avanza un token por paso, por lo que cambia la oportunidad de utilizar simultáneamente las unidades de cálculo. Decode con lotes pequeños puede ser sensible a la lectura de los pesos y de la caché KV, mientras que un prefill largo suele ofrecer más posibilidades de aprovechar la capacidad de cálculo. Es una tendencia: la longitud del contexto, la arquitectura del modelo, el tamaño del lote y el método de ejecución pueden cambiar el cuello de botella. Análisis de inferencia de transformers en How To Scale Your Model
Por tanto, un buen resultado al procesar entradas largas no implica necesariamente una generación más rápida para un usuario. Una prueba que solo informe de la suma de tokens de entrada y salida también puede mostrar una cifra mayor al aumentar la entrada, sin acelerar la continuación de la respuesta para el usuario.
La memoria no es solo el lugar donde cabe el modelo
Al evaluar la memoria hay que separar tres preguntas: ¿caben los datos?, ¿a qué velocidad pueden leerse? y ¿cuánto tarda el acceso al dato necesario?
Una capacidad mayor puede permitir alojar el modelo, un contexto más largo o más solicitudes activas. Pero esa capacidad, por sí sola, no reduce el tiempo de lectura de los pesos. El ancho de banda describe una tasa de transferencia y no equivale a la latencia de acceso.
Para una operación, una primera aproximación es:
Aquí, es el número de operaciones de cálculo, la tasa de cálculo, el volumen de datos intercambiado con el nivel de memoria examinado y el ancho de banda de ese nivel. La aproximación supone que cálculo y transferencia pueden solaparse; la sobrecarga de ejecución y la falta de paralelismo pueden aumentar el tiempo. Guía oficial de NVIDIA sobre limitaciones de cálculo, memoria y latencia
Si la lectura de datos domina la ruta crítica, duplicar el rendimiento de multiplicación matricial no reduce necesariamente a la mitad el tiempo de la operación.
Por ejemplo, supongamos que un paso de decode necesita leer exactamente 70 GB de memoria y que el ancho de banda efectivo es de 2 TB/s. Con unidades decimales, el límite inferior de esa lectura es de 35 milisegundos:
Este cálculo no predice la velocidad de un modelo de 70 000 millones de parámetros. Parte de una hipótesis concreta sobre el volumen real leído en cada paso y no contabiliza por separado la atención, la comunicación ni las sobrecargas. Su utilidad consiste en mostrar un límite que el aumento de FLOPS, por sí solo, no elimina.
La caché KV también debe incluirse en el presupuesto de memoria. En la atención convencional sobre todo el contexto, su demanda crece con la longitud de la secuencia y el número de solicitudes activas. Cuantizar la caché o trasladarla a la memoria del anfitrión puede reducir el consumo de memoria de la GPU, pero tiene sus propios efectos sobre el rendimiento; también importan el tipo de atención y la estrategia de caché. Guía de estrategias de caché KV en Transformers
Que los pesos quepan no demuestra la capacidad de atender solicitudes.
¿Por qué una mayor capacidad total puede ralentizar a cada usuario?
Ejecutar varias solicitudes en un lote puede mejorar el aprovechamiento de los pesos y los recursos de cálculo. Sin embargo, el objetivo del sistema puede ser maximizar la salida conjunta, aunque aumente el intervalo entre tokens de cada solicitud.
Para aclarar la diferencia, consideremos un intervalo estable y totalmente hipotético en el que todas las solicitudes están en decode:
| Caso | Solicitudes activas en decode | Tasa por solicitud | Tasa total de salida |
|---|---|---|---|
| A | 20 | 80 tokens/s | 1600 tokens/s |
| B | 100 | 30 tokens/s | 3000 tokens/s |
El caso B produce aproximadamente 1,9 veces más tokens en total, pero cada usuario del caso A recibe la salida unas 2,7 veces más rápido. La tabla muestra la aritmética de una situación hipotética; no establece una ley sobre cómo cambia la velocidad al aumentar la concurrencia.
En un servicio real, las solicitudes entran y salen continuamente y tienen longitudes distintas. La planificación también importa. Por ejemplo, la documentación de vLLM explica que chunked prefill divide las entradas largas en fragmentos pequeños y los planifica junto con decode. Cambiar el presupuesto de tokens de esa planificación puede alterar el equilibrio entre TTFT y latencia entre tokens. Documentación de optimización de vLLM
Así, dos pruebas con el mismo hardware y modelo, pero con políticas de planificación diferentes, pueden ofrecer experiencias de usuario distintas.
LPX: repartir el trabajo incluso dentro de decode
En la arquitectura anunciada de Vera Rubin con Groq 3 LPX, NVIDIA asigna prefill y la atención de decode a la GPU, y las operaciones FFN/MoE de decode a la LPU. Por tanto, no se traslada todo decode a la LPU. Ambas partes intercambian datos intermedios. Explicación oficial de la arquitectura de NVIDIA
El siguiente diagrama reconstruye conceptualmente ese reparto. Omite operaciones auxiliares como la normalización, las conexiones residuales y los detalles de distribución de tensores:
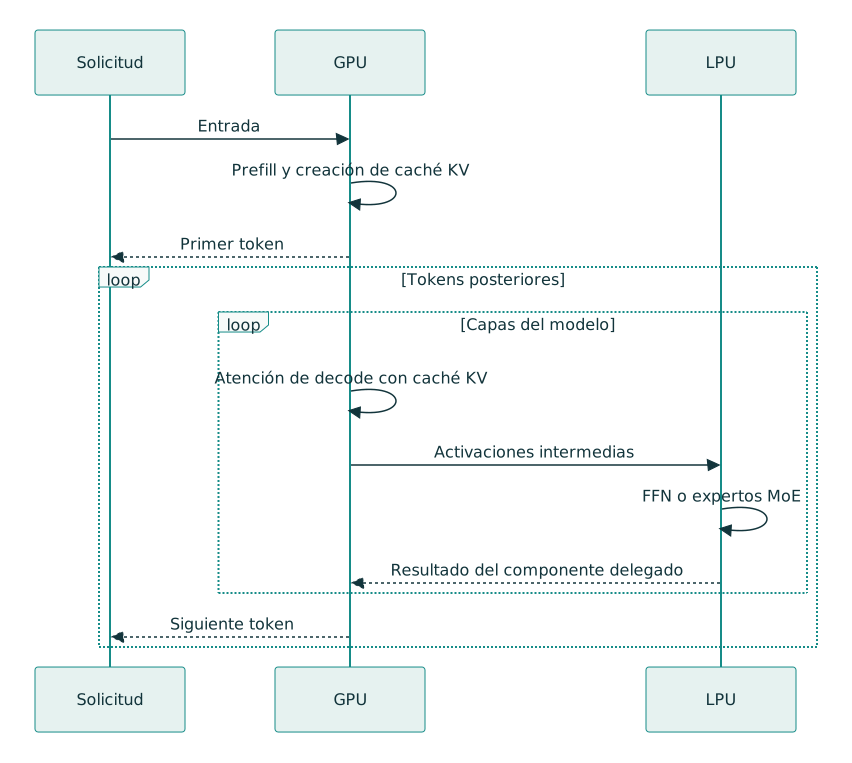
Descargar el código Mermaid del diagrama
Esto no equivale a separar prefill y decode en dos grupos de procesadores. DistServe es un ejemplo de separación de ambas fases para controlar su interferencia y optimizar el servicio bajo restricciones de latencia; LPX lleva el reparto hasta los componentes internos de decode. Artículo original de DistServe
El interés del ejemplo es arquitectónico, más allá del nombre del producto: las distintas partes de una solicitud no necesitan las mismas proporciones de capacidad de memoria, ancho de banda y potencia de cálculo.
Leer las cifras de memoria en la escala adecuada
La página oficial de LPX anuncia las siguientes especificaciones:
| Especificación anunciada | Escala |
|---|---|
| 500 MB de SRAM | Por LPU |
| 150 TB/s de ancho de banda de SRAM | Por LPU |
| 256 chips LPU | Un rack LPX |
| 128 GB de SRAM y 12 TB de DDR5 | Un rack LPX |
| Aproximadamente 40 PB/s de ancho de banda de SRAM | Agregado del rack |
| 640 TB/s de ancho de banda de scale-up | A escala de rack |
Fuente: Página oficial de NVIDIA Groq 3 LPX
Son especificaciones anunciadas por el fabricante. El ancho de banda agregado de SRAM de un rack no puede compararse directamente con el de la HBM de una sola GPU. La capacidad DDR5 tampoco es capacidad SRAM, y la tasa de scale-up interna del rack no determina la tasa aprovechable de un intercambio concreto entre GPU y LPU.
Un total de 128 GB de SRAM tampoco permite concluir que todos los pesos de un modelo muy grande quepan siempre en SRAM. La ubicación de los datos, su distribución y la frecuencia con la que se mueven deben seguir formando parte del análisis.
La comunicación determina el coste del reparto
Dividir una operación entre dos aceleradores resulta útil cuando el ahorro de ejecución supera el coste adicional de transferencia y coordinación.
El tiempo de un intercambio puede aproximarse así:
Aquí, es la latencia fija de inicio y entrega, el tamaño del mensaje y el ancho de banda efectivo de la ruta. Este modelo simple no recoge por completo la congestión ni la variabilidad de ejecución, pero aclara una distinción: para mensajes pequeños, reducir la latencia fija puede importar más que aumentar el ancho de banda.
Por ejemplo, supongamos que un diseño hipotético necesita 80 viajes de ida y vuelta dependientes para generar cada token y que el coste fijo total de cada uno es de 10 microsegundos. La contribución fija de la comunicación, antes de contar el volumen de datos, es de 0,8 milisegundos. Si cada ida y vuelta tarda 50 microsegundos, esa contribución aumenta a 4 milisegundos.
Este ejemplo no describe las especificaciones de LPX. Muestra por qué incluso los intercambios de pocos datos pueden importar en un bucle que se repite con frecuencia.
Sin solapamiento, una condición simple para que compense delegar una parte es:
En una implementación real deben medirse los costes que permanecen en la ruta crítica después del solapamiento.
La misma consideración se aplica al añadir GPU. Aumentar el paralelismo de tensores puede liberar más memoria, pero exige más coordinación; la documentación de vLLM señala expresamente esa sobrecarga. Consideraciones de paralelismo en vLLM
Por tanto, «el modelo se ejecuta en cuatro tarjetas» no significa «cada usuario recibe una respuesta cuatro veces más rápido».
¿Cuáles son los límites de una afirmación del fabricante?
Para la combinación de Vera Rubin NVL72 y LPX, NVIDIA anuncia hasta 35 veces más rendimiento por megavatio que GB200 NVL72 en un punto de aproximadamente 400 tokens por segundo y usuario. Es una afirmación del fabricante sobre la configuración y el escenario presentados; no significa que el tiempo de respuesta de cada solicitud se reduzca 35 veces ni que LPX sea superior en todos los casos. Gráfico y explicación de NVIDIA
Para utilizar esa afirmación como criterio de compra deben conocerse el modelo, la precisión numérica, las longitudes de entrada y salida, la concurrencia, el número de racks, los límites de la medición de potencia y la restricción de latencia. Una cifra de «tokens por megavatio» tampoco recoge por sí sola el precio de compra, el coste de red, la operación ni el aprovechamiento real de la capacidad.
Entre las fuentes examinadas para este artículo, la descripción de LPX se basa en la documentación de NVIDIA. Sus cifras no se presentan aquí como resultados reproducidos de forma independiente.
¿Qué capacidad se puede vender o utilizar realmente?
Un servicio puede alcanzar una tasa elevada en una prueba mientras una parte considerable de las solicitudes supera la latencia permitida. La capacidad nominal de esa prueba no es una capacidad fiable de servicio.
En nuestra experiencia con Targoman bajo carga (informe en persa), las respuestas solían comenzar en menos de un segundo con poca carga; bajo presión, la espera podía alcanzar el límite de 20 segundos, tras el cual se cancelaba la solicitud si la respuesta aún no había comenzado. Durante aquel episodio, el sistema tenía unas 300 solicitudes concurrentes, pero no todas terminaban correctamente. Por eso, la capacidad útil debe contar las respuestas entregadas en un tiempo aceptable, no solo las solicitudes presentes en el sistema.
La métrica goodput aborda este problema contando las solicitudes que cumplen las restricciones establecidas. En AIPerf también se distingue de la proporción de solicitudes que las cumplen: un servicio que rechaza muchas solicitudes no debería considerarse exitoso solo porque las respuestas restantes sean rápidas. Guía de goodput de AIPerf
Para un servicio concreto podría plantearse inicialmente este objetivo: «Al menos el 95 % de las solicitudes deben tener tanto un TTFT inferior a dos segundos como un TPOT inferior a 50 milisegundos». Las cifras son ejemplos y deben derivarse de las necesidades del producto.
La exigencia de cumplir ambas condiciones es deliberada. Informar por separado del percentil 95 de cada métrica no garantiza que el mismo 95 % de las solicitudes cumpla las dos.
La calidad de la respuesta también requiere una evaluación independiente. Acortar la salida o cambiar el modelo puede mejorar los tiempos, pero la comparación solo sigue siendo válida si la salida satisface las necesidades de la aplicación.
Definir las pruebas de aceptación a partir del servicio
Antes de comparar tarjetas, las especificaciones de la prueba deben ser fijas y reproducibles:
| Área de la prueba | Qué registrar |
|---|---|
| Modelo y calidad | Versión de los pesos, tokenizer, cuantización y criterios de aceptación de la respuesta |
| Entrada y salida | Distribución de longitudes, idioma, contexto de varios turnos y longitud real de salida |
| Carga entrante | Tasa de llegada, concurrencia, picos de tráfico y duración de la prueba |
| Motor de ejecución | Versiones, lotes, paralelismo, chunked prefill y configuración de caché |
| Funciones de aceleración | Estado de prefix caching y speculative decoding |
| Latencia | Distribuciones de TTFT y TPOT, pausas del flujo y tiempo de finalización |
| Capacidad | Tasa total de salida, solicitudes exitosas, errores, timeouts y goodput |
| Infraestructura y coste | Número de tarjetas y servidores, topología, consumo eléctrico y coste total de la configuración |
Una prueba con un solo usuario ayuda a conocer el límite inferior de latencia, pero no determina la capacidad del servicio. Hay que aumentar la carga e identificar el punto a partir del cual dejan de cumplirse las restricciones de experiencia de usuario. También debe distinguirse una prueba con concurrencia fija de otra con tasa de llegada fija: en la primera, un servicio más lento puede retrasar automáticamente el envío de la siguiente solicitud y reducir la presión aplicada.
Para contenido en persa, la muestra debe incluir entradas reales en persa. «Tokens por segundo» no representa necesariamente el mismo volumen de texto con dos tokenizers distintos; por eso, comparar modelos diferentes también exige evaluar la calidad y el tiempo necesario para completar una tarea común.
Asimismo, debe quedar claro si se pretende aislar el efecto del hardware o comparar el mejor servicio que pueda desplegarse. En el primer caso, la configuración debe ser lo más parecida posible. En el segundo, puede optimizarse cada pila de software, siempre que se documenten las diferencias y se mantenga el criterio de calidad.
Elegir GPU empieza por definir la respuesta deseada
Al comprar infraestructura de inferencia, preguntar «¿qué tarjeta es más rápida?» resulta prematuro. Primero hay que determinar si las respuestas son cortas o largas, cuántas solicitudes simultáneas habrá, qué latencia es aceptable y qué parte de la ejecución consume el tiempo.
LPX ejemplifica una respuesta arquitectónica a las distintas necesidades de los componentes de inferencia. Su existencia no implica que todo servicio necesite hardware heterogéneo. A veces basta con mejorar la planificación, elegir la pila de software adecuada o reducir la presión sobre la memoria; otras veces, el reparto entre procesadores compensa el coste de comunicación.
El criterio de compra debe ser la capacidad de atender solicitudes con la calidad y la latencia necesarias. El cálculo, la memoria y la red son medios para conseguirlo. Una posición superior en una de esas columnas, por sí sola, no garantiza un mejor rendimiento de respuesta.
Ascend frente a NVIDIA: ¿cuál es la brecha real de rendimiento?
De Ascend 910C y 950PR/DT a H200 y B300: comparación de especificaciones equivalentes, memoria, kernels, interconexiones, software de inferencia y costes de operación.
Un acelerador se convierte en una alternativa práctica cuando puede ejecutar el modelo y las bibliotecas necesarios, cumple los objetivos del servicio y justifica el trabajo de ingeniería requerido para migrar. Los FLOPS máximos no bastan para resolver esa cuestión. También importan el soporte del software, el consumo energético, la densidad de cálculo y el comportamiento del sistema completo.
Para esta comparación, supongamos que disponemos en el laboratorio de un sistema NVIDIA y otro Ascend. La pregunta es directa:
¿Cuál es la brecha técnica entre Ascend y NVIDIA?
Si NVIDIA es más rápido, la medición debe reflejarlo. Si consume menos energía por token útil, ese resultado debe registrarse. Del mismo modo, si Ascend ejecuta una carga dentro del acuerdo de nivel de servicio (SLA) exigido, la ausencia de CUDA no convierte por sí sola al sistema en una opción inutilizable.
Antes de comparar el hardware, conviene precisar el alcance: los modelos de lenguaje grandes (LLM) son solo una parte de la IA. El mantenimiento predictivo, la detección de anomalías en sensores, la previsión de demanda, la inspección de calidad y la optimización energética también son aplicaciones importantes. A la escala habitual de una organización, muchos modelos especializados para estas tareas no necesitan grandes cantidades de GPU durante la inferencia. Puede bastar una CPU, un acelerador pequeño o un número reducido de GPU. El entrenamiento debe evaluarse por separado; el tamaño del modelo, la tasa de solicitudes y los límites de latencia siguen determinando la capacidad necesaria. Este mismo criterio de partir de la carga real guía la elección de una GPU para IA.
Esta diferencia explica por qué aquí me centro en los modelos de lenguaje. Servir LLM grandes puede exigir mucha memoria y numerosos aceleradores para almacenar los pesos, mantener una caché de claves y valores (KV) que crece con el contexto y las solicitudes simultáneas, generar tokens de forma secuencial e intercambiar datos entre aceleradores. A esa escala, el ancho de banda de memoria, las interconexiones, los kernels y el motor de inferencia afectan directamente a la capacidad del servicio y al coste. Por eso concentro la comparación en el entrenamiento y la inferencia de modelos de lenguaje, especialmente en el servicio de modelos grandes. Los modelos pequeños tampoco necesitan automáticamente grandes clústeres: elegir el tamaño adecuado para la tarea sigue siendo el punto de partida. Las demás aplicaciones de IA necesitan mediciones de sus propias cargas.
Primero, definamos qué estamos comparando
«Ascend frente a NVIDIA» es una expresión demasiado amplia para comparar hardware con precisión.
Ascend 910C, utilizado en CloudMatrix384 y en la generación A3, no es lo mismo que Ascend 950PR o 950DT. Incluso 950PR y 950DT, pertenecientes a la misma generación, se dirigen a cargas diferentes. Huawei diseñó 950PR para el procesamiento inicial de la entrada —prefill— y los sistemas de recomendación, y 950DT para la generación de tokens —decode— y el entrenamiento, debido a sus distintas necesidades de cálculo y ancho de banda. Huawei
En NVIDIA, H200 y B300 también pertenecen a generaciones distintas. H200 es una referencia útil para infraestructuras de centros de datos ya instaladas; B300 representa Blackwell Ultra, con mucha más capacidad de cálculo, memoria e interconexión. H200 ofrece 141GB de HBM3e, 4.8TB/s de ancho de banda de memoria y 900GB/s mediante NVLink. Para B300 en HGX, los documentos oficiales indican 270–288GB y 7.7–8TB/s según el documento o la configuración; NVLink de quinta generación proporciona 1.8TB/s por GPU. Especificaciones de H200 · Ficha de Blackwell Ultra
Utilizo cuatro referencias: Atlas 350 con 950PR para prefill, Atlas 650E con 950DT, H200 como representante consolidado de Hopper y B300 como referencia más reciente de NVIDIA.
Las especificaciones del chip y las del producto son distintas
Un primer ejemplo muestra por qué comparar fichas técnicas no es tan sencillo como parece.
Para el procesador 950PR, Huawei anuncia hasta 128GB de memoria, 1.6TB/s de ancho de banda y 1,784TFLOPS. Pero Atlas 350, la tarjeta real basada en ese procesador, ofrece 112GB, 1.4TB/s, 425TFLOPS en BF16/FP16 y 804TFLOPS en mxFP8. Su consumo máximo es de 600W. Especificaciones de los procesadores Ascend · Tarjetas Atlas
Para 950DT, la hoja de ruta de Huawei de 2025 describía 144GB de memoria HiZQ 2.0 con 4TB/s. Sin embargo, la página actual de Atlas 650E especifica 8×96GB para sus ocho procesadores 950DT: el mismo ancho de banda, pero menos capacidad. Tomo como referencia el producto actual, porque no he encontrado una explicación pública clara de esa diferencia. Hoja de ruta de Huawei · Especificaciones de Atlas 650E
La misma regla se aplica a NVIDIA: las capacidades de la arquitectura, los máximos del chip y la configuración instalada en un servidor concreto son tres cosas diferentes.
Comparación de especificaciones: la brecha no es un solo número
La tabla compara productos de la forma más coherente que permiten los datos disponibles. Cuando NVIDIA anuncia rendimiento de Tensor Cores suponiendo dispersión de los datos, utilizo el valor para cálculo denso.
| Métrica | Ascend 950PR en Atlas 350 | Ascend 950DT en Atlas 650E, por NPU | H200 SXM | B300 en HGX, por GPU |
|---|---|---|---|---|
| Carga objetivo | Prefill / recomendación | Decode / entrenamiento | Entrenamiento e inferencia generales | Entrenamiento e inferencia generales |
| BF16/FP16 teórico | 425 TFLOPS | 425 TFLOPS | ≈990 TFLOPS densos | ≈2.25 PFLOPS densos |
| FP8 o familia comparable | 804 TFLOPS | ≈804 TFLOPS | ≈1.98 PFLOPS densos | ≈4.5 PFLOPS densos |
| Memoria del acelerador | 112GB | 96GB en el Atlas 650E actual | 141GB | 270–288GB |
| Ancho de banda de memoria | 1.4TB/s | 4.0TB/s | 4.8TB/s | 7.7–8TB/s |
| Interconexión dentro del sistema | 318GB/s por tarjeta en una malla completa de cuatro tarjetas | 784GB/s/NPU bidireccionales en el servidor de ocho NPU | 900GB/s NVLink | 1.8TB/s NVLink |
| Especificación de potencia | ≤600W por tarjeta | 14.5kW para el servidor completo de ocho NPU | ≤700W por GPU; DGX H200 completo: 10.2kW | Hasta ≈1.1kW en HGX; DGX B300: consumo declarado de 14.5kW, entrada máxima de 15kW |
Nota sobre B300: Los documentos oficiales de NVIDIA indican estos dos conjuntos de valores según el documento o la configuración: 288GB y 8TB/s en la arquitectura de referencia de HGX B300, y 270GB y 7.7TB/s en la ficha de Blackwell Ultra. Arquitectura de referencia de NVIDIA · Ficha de Blackwell Ultra
Los datos de Ascend proceden de las páginas actuales de Atlas 350 y Atlas 650E; los de NVIDIA, de la documentación oficial de H200, HGX y DGX. Las cifras de potencia no corresponden al mismo nivel de medida. Aquí no disponemos de una potencia de diseño térmico (TDP) pública e independiente para 950DT, mientras Huawei proporciona la potencia del servidor completo. Por tanto, esta tabla no permite calcular directamente la eficiencia por chip. Especificaciones de Ascend · Guía de DGX B300
La tabla muestra algo más útil que un ganador.
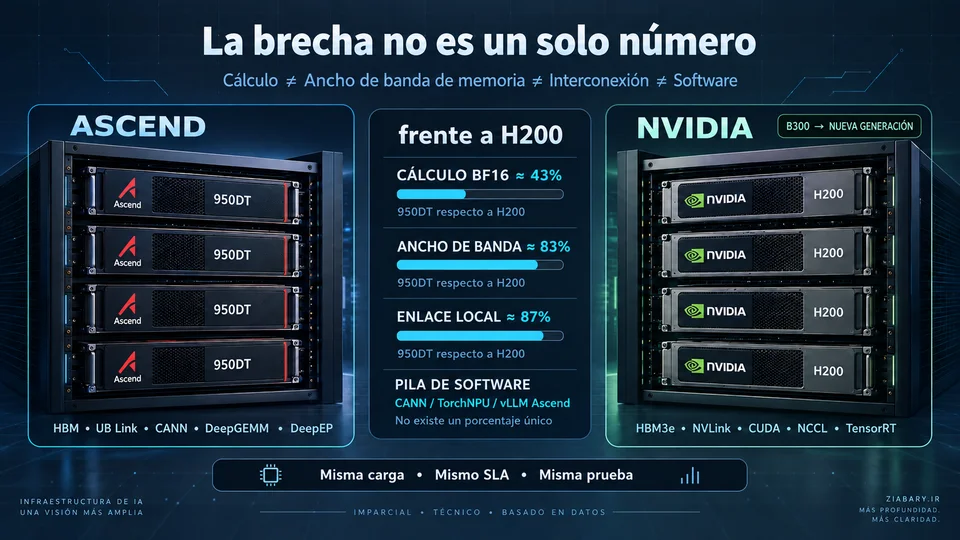
El 950DT actual ofrece aproximadamente el 43% del rendimiento BF16 teórico de H200 y el 41% de su rendimiento FP8. Sin embargo, alcanza alrededor del 83% de su ancho de banda de memoria y del 87% del ancho de banda local anunciado. Frente a B300, la diferencia de cálculo es mucho mayor: 950DT tiene menos de una quinta parte del cálculo bruto, aproximadamente la mitad del ancho de banda de memoria y cerca de un tercio de la capacidad de memoria en el Atlas 650E actual.
Ascend puede tener alrededor del 40% de la capacidad de cálculo de NVIDIA y más del 80% de su ancho de banda de memoria. La relación que importa depende de la carga.
Por qué los 4TB/s de 950DT importan más de lo que parece
En el artículo sobre latencia y capacidad de inferencia, utilicé una aproximación sencilla:
representa la cantidad de cálculo; , la capacidad de cálculo; , los datos que deben transferirse; y , el ancho de banda de memoria. Si domina el segundo término, añadir FLOPS no acelera necesariamente la operación.
La misma relación permite obtener un umbral sencillo:
Un kernel con intensidad aritmética por debajo de este umbral tiene más probabilidades de estar limitado por la memoria; por encima, la capacidad de cálculo cobra mayor importancia.
Con el rendimiento BF16 teórico, los valores aproximados son:
| Acelerador | BF16 | Ancho de banda de memoria | aproximado |
|---|---|---|---|
| Ascend 950PR / Atlas 350 | 425TFLOPS | 1.4TB/s | ≈304 FLOP/Byte |
| Ascend 950DT / Atlas 650E | 425TFLOPS | 4.0TB/s | ≈106 FLOP/Byte |
| H200 SXM | ≈990TFLOPS | 4.8TB/s | ≈206 FLOP/Byte |
| B300 HGX | ≈2.25PFLOPS | 7.7–8TB/s | ≈281–292 FLOP/Byte |
Estos valores no son resultados de pruebas: son cocientes entre especificaciones teóricas. Aun así, ayudan a entender los distintos diseños de 950PR y 950DT.
Durante prefill, especialmente con lotes grandes, las operaciones matriciales tienen mayor intensidad aritmética, de modo que resulta útil disponer de más capacidad de cálculo. 950PR se dirige a esta fase y mantiene 1.4TB/s de ancho de banda de memoria.
Durante decode, sobre todo con lotes pequeños, el procesador lee repetidamente los pesos y la caché KV. El ancho de banda cobra más importancia. En las especificaciones de Atlas 650E, 950DT aumenta el ancho de banda de 1.4 a 4TB/s sin elevar el rendimiento BF16 respecto a Atlas 350.
Para la generación de tokens, Huawei cambió el equilibrio entre cálculo y memoria, en lugar de confiar únicamente en más FLOPS.
Las etiquetas FP4 y FP8 no garantizan una ejecución comparable
La dificultad de comparar bajas precisiones numéricas va más allá del cálculo disperso frente al denso.
Huawei admite mxFP4, mxFP8 y HiF8; NVIDIA utiliza NVFP4 y sus formatos FP8 en Blackwell. El mismo número de bits no implica la misma representación numérica, factores de escala, granularidad de esos factores, kernels o precisión del resultado.
Afirmar que Atlas 350 supera varias veces a H20 en FP4 tiene un valor limitado si no se explica la ruta numérica. H20 no fue diseñado para esa misma ruta FP4, por lo que la relación no establece cuánto más rápido se ejecutará un modelo real. Los formatos y el kernel utilizados deben acompañar la comparación. Especificaciones de Ascend · Ficha de Blackwell Ultra
En la práctica, hay que registrar conjuntamente el formato de los pesos, las activaciones, los factores de escala y el kernel. Como expliqué en «INT8 o FP8», llamar «FP8» o «INT8» a los pesos no garantiza que la multiplicación matricial utilice esa misma ruta. BF16 sirve aquí como referencia porque facilita una comparación arquitectónica coherente, no porque todos los despliegues deban utilizarlo.
Más allá de la ficha técnica: ¿funciona bien la carga completa?
Una página de producto con 4TB/s y 804TFLOPS no demuestra un buen rendimiento con un modelo real. Las pruebas públicas disponibles tienen distinto alcance y distinta solidez. En esta tabla, TPOT significa tiempo por token de salida.
| Evidencia | Hardware | Qué mide | Resultado | Calidad de la evidencia |
|---|---|---|---|---|
| MLPerf Inference 6.1 | NVIDIA y otros fabricantes | Modelos y cargas estandarizados | Datos amplios y comparables | Reglas de presentación y revisión; Huawei no participa |
| CloudMatrix-Infer | 910C | Servicio completo de DeepSeek-R1 | 1,943 tokens/s/NPU con TPOT≈49.4ms | Artículo técnico de Huawei y SiliconFlow; no es una prueba independiente |
| DeepGEMM-Ascend | 950DT | Kernel de multiplicación matricial (GEMM) | Hasta el 99.8% del máximo declarado del kernel | Código abierto y reproducible; no mide el modelo completo |
| DeepEP-Ascend | 950DT | Comunicación en modelos MoE | Aproximadamente el 90–95% del máximo de ancho de banda útil hasta EP32 | Código abierto; probado en PoC HDK, con limitaciones pendientes |
MLPerf Inference v6.1 se publicó en septiembre de 2026 con 30 participantes y 120 sistemas. Su Closed Division está concebida para comparar bajo condiciones comunes. NVIDIA tiene una presencia amplia, pero Huawei no figura entre los participantes. Por tanto, estos resultados no contienen una comparación oficial de MLPerf entre H200 y 950DT. Esta es una carencia importante de los datos públicos sobre Ascend. MLCommons
La ausencia de una prueba estandarizada no significa que el hardware no pueda ejecutar la carga. Tampoco permite cubrir ese vacío con pruebas del fabricante y llamarlas comparaciones independientes.
910C: la evidencia pública más sólida sobre la ejecución completa
Para la generación 950 todavía falta una prueba independiente y completa comparable con MLPerf. Para evaluar la madurez del software de Ascend al servir modelos grandes, CloudMatrix384 basado en 910C sigue siendo especialmente útil.
Serving Large Language Models on Huawei CloudMatrix384 estudia DeepSeek-R1 en un sistema con 384 NPU y 192 CPU. Con entradas de 4K, el rendimiento de prefill predeterminado es de 5,655 tokens/s por NPU. El valor de 6,688 corresponde a la configuración idealizada Perfect EPLB, no a la ejecución predeterminada. Durante decode, con un lote de 96, una caché KV de longitud 4096 y un TPOT de 49.4ms, se obtienen aproximadamente 1,943 tokens/s por NPU.
El artículo también incluye referencias de H800 y H100. SGLang en H100, con un lote de 128, registra unos 2,172 tokens/s y TPOT≈55.6ms; CloudMatrix, con un lote de 96, registra 1,943 tokens/s y 49.4ms. Tabla 4 del artículo
Estas cifras no justifican decir que Ascend es simplemente «un 10% más lento que H100». Cambian el lote, la precisión numérica y el software. También deben controlarse la generación especulativa y la predicción de múltiples tokens (MTP). El artículo supone explícitamente una aceptación efectiva del 70% para un token especulativo, tanto en el MTP simulado de SGLang como en CloudMatrix-Infer. Esa condición debe acompañar al resultado.
La evidencia permite una conclusión más limitada:
910C y su software pueden servir DeepSeek-R1 a una escala considerable con un tiempo por token competitivo.
Esto importa para la comparación técnica. Una conclusión más fuerte exigiría una prueba común.
950DT: los kernels matriciales ya no son el punto débil evidente
La generación 950 es más reciente y todavía no acumula tanta evidencia sobre modelos completos como 910C. Una prueba reciente de DeepSeek permite, sin embargo, observar su ruta de cálculo.
DeepGEMM-Ascend se publicó el 30 de septiembre de 2026. El README revisado documenta pruebas reproducibles en Ascend 950DT con CANN 9.20. Para las grandes matrices indicadas, BF16 GEMM alcanza 431TFLOPS de un máximo de 432TFLOPS: el 99.8%. FP8×FP8 alcanza 861 de 865TFLOPS, y FP4×FP4, aproximadamente 1701 de 1730TFLOPS. README de DeepGEMM-Ascend
Esto no demuestra que 950DT supere a H200 o B300: NVIDIA no participa en la prueba. Demuestra que, con dimensiones matriciales adecuadas, el kernel disponible puede utilizar casi toda la capacidad matricial declarada de esta NPU. Un rendimiento bajo en esas rutas ya no puede atribuirse automáticamente a un compilador Ascend deficiente.
Ejecutar un LLM implica mucho más que unas pocas multiplicaciones grandes. La atención, la normalización, el muestreo, la gestión de la caché, la comunicación, la planificación y las operaciones pequeñas todavía pueden convertirse en cuellos de botella.
MoE necesita comunicación rápida además de cálculo
En los modelos de mezcla de expertos (MoE), la comunicación puede importar tanto como el cálculo. Los tokens se distribuyen entre expertos y después se combinan sus resultados. Con paralelismo de expertos, los intercambios entre todos los participantes pueden ocupar una parte considerable del tiempo de generación.
DeepEP-Ascend en 950DT registra unos 373–375GB/s en la distribución de tokens con EP=8 y mantiene 335–340GB/s con EP=32. El proyecto declara aproximadamente un 90–95% del máximo físico de ancho de banda para datos útiles hasta EP32. El rendimiento sigue cayendo con EP64 y EP128; la combinación de resultados también empeora, y los desarrolladores señalan que continúan optimizando estas partes. Aquí EP indica el tamaño del grupo de paralelismo de expertos. DeepEP-Ascend
Las mediciones se realizaron en kits de desarrollo de hardware de prueba de concepto (PoC HDK), con un firmware concreto. No debe suponerse que un Atlas 650E de producción reproduce esos valores sin cambios. La prueba es prometedora y el método es público, pero el estado del hardware y las versiones del software deben acompañar a las cifras.
Software: la brecha puede importar más que el hardware
«¿Funcionarán las bibliotecas necesarias?» puede ser una pregunta más útil que comparar FLOPS.
PyTorch en Ascend es una opción real y práctica, pero la compatibilidad con CUDA no es completa.
TorchNPU 26.1 admite oficialmente 950DT. Huawei conserva buena parte de la API y del flujo de desarrollo de PyTorch; algunas interfaces se conectan a la NPU mediante modificaciones de las funciones durante la ejecución. Documentación de TorchNPU
Migrar código basado en operadores estándar de PyTorch puede ser relativamente sencillo. Una aplicación que utiliza extensiones CUDA, kernels propios, bibliotecas específicas de CUDA, comportamientos particulares de NCCL u operadores ausentes en CANN/TorchNPU es otro caso. Huawei documenta un proceso de adaptación de operadores, reconociendo que no todos se trasladan sin trabajo adicional. Guía de adaptación de operadores
Cambiar .cuda() por .npu() puede bastar en una demostración sencilla. No permite estimar con fiabilidad el esfuerzo para migrar una aplicación de producción.
vLLM: un soporte mucho más sustancial que un experimento periférico
Para servir LLM, la situación actual resulta más alentadora.
La tabla de soporte de vLLM Ascend para 950DT incluye DeepSeek V4, DeepSeek-V3.1 y GLM-5.1, con funciones como W8A8, prefill por bloques, reutilización de prefijos en caché, generación especulativa, paralelismo de expertos, paralelismo de datos y separación entre prefill y decode. Tabla de soporte de vLLM Ascend
La imagen oficial de contenedor vllm-ascend:v0.23.0-a5 está documentada para 950DT, con instrucciones de despliegue en varios nodos para modelos como GLM-5/5.1.
Sin embargo, no todas las combinaciones tienen soporte completo. Algunos modelos son experimentales, ciertas funciones no se han probado y LoRA o el paralelismo por etapas tienen restricciones en determinadas configuraciones. «Se admite vLLM» no basta. La pregunta útil es:
¿Qué modelo, con qué cuantización, qué funciones y en qué generación de Ascend?
La misma disciplina se aplica a una afirmación genérica de que una GPU «admite FP8».
Entrenamiento: los datos públicos no demuestran igualdad
950DT se dirige a la generación de tokens y al entrenamiento, con mucho más ancho de banda de memoria e interconexión que su predecesor. TorchNPU proporciona una vía de entrenamiento con PyTorch. Afirmar que no se pueden entrenar modelos en Ascend es incorrecto. Huawei
Pero la viabilidad es solo la primera pregunta. En un entrenamiento grande importa la utilización de FLOPS del modelo:
¿Cuánta utilización se mantiene con 64, 256 o varios miles de aceleradores? ¿Qué cuestan las operaciones colectivas? ¿Cómo afecta la recuperación tras fallos? ¿Cómo se guardan los puntos de control y se reparte el estado del optimizador? ¿Cuánto intercambio introduce el paralelismo de expertos? ¿Qué parte de la capacidad teórica conserva el compilador con el modelo real?
Para NVIDIA existen numerosos resultados de MLPerf Training, experiencia pública con clústeres y herramientas de desarrollo y supervisión. Las cargas recientes de entrenamiento de MLPerf también incluyen MoE y DeepSeek-V3. MLCommons
Para Ascend, los resultados públicos estandarizados todavía no sitúan 950DT junto a B300 o H200 bajo las mismas condiciones.
DeepGEMM demuestra un uso eficaz del cálculo matricial. DeepEP demuestra un software de comunicación sustancial. Juntos todavía no constituyen una prueba del proceso completo de entrenamiento. Para elegir hardware destinado al preentrenamiento a muy gran escala, los datos públicos de NVIDIA siguen siendo mucho más completos.
Inferencia: donde la comparación puede acercarse mucho más
La inferencia, especialmente la generación de tokens, cambia el panorama.
El 950DT actual tiene aproximadamente el 43% del rendimiento BF16 de H200, pero el 83% de su ancho de banda de memoria. Si decode está limitado principalmente por ese ancho de banda, el rendimiento real no tiene por qué guardar la misma proporción que el cálculo.
Los resultados de CloudMatrix con el anterior 910C refuerzan esta idea. Con kernels, memoria, comunicación y software adecuados, una NPU con menos cálculo máximo que H100 puede ofrecer una capacidad y un tiempo por token competitivos para una carga concreta.
El diseño de 950 también distingue estas necesidades: los 1.4TB/s de 950PR se dirigen a una fase más intensiva en cálculo, mientras los 4TB/s de 950DT se orientan a cargas más dependientes de la memoria y la comunicación. Huawei
Para servir LLM, esta diferenciación aporta más información que aumentar los FLOPS por sí solos. El soporte de vLLM Ascend para separar prefill y decode en 950DT sigue esa dirección. Tabla de soporte de vLLM
Interconexiones: NVLink sigue importando, pero la comparación no es sencilla
H200 proporciona hasta 900GB/s mediante NVLink de cuarta generación; B300 ofrece 1.8TB/s con la quinta. En HGX B300, ocho GPU se conectan mediante NVSwitch con un ancho de banda agregado de 14.4TB/s. NVIDIA HGX
En Atlas 650E, cada NPU dispone de 784GB/s bidireccionales mediante UB dentro del servidor de ocho NPU. Dos servidores pueden formar una malla completa de 16 NPU, con hasta 1.68TB/s por NPU. UBoE y RoCE proporcionan además 400Gbps cada uno por NPU para la comunicación entre sistemas. Atlas 650E
Comparar 784 con 900 sugiere una brecha pequeña, pero resulta insuficiente. Importan la topología, la latencia, las operaciones colectivas, el número de participantes y el patrón de comunicación en el que está disponible ese ancho de banda. En MoE es especialmente relevante el tiempo real de distribución de tokens y combinación de resultados con paralelismo de expertos. El comportamiento medido por DeepEP aporta más información que el valor de 784GB/s por sí solo.
La escala también puede compensar chips individuales menos potentes
CloudMatrix384 ilustra esta estrategia: Huawei conecta 384 NPU dentro de un gran dominio de comunicación. SemiAnalysis estimó aproximadamente 300PFLOPS BF16 densos, 49TB de memoria y más de 1.2PB/s de ancho de banda agregado, por encima de GB200 NVL72 a escala de sistema. El mismo análisis señala el coste: muchos más aceleradores y un consumo eléctrico varias veces mayor. Son estimaciones del sistema completo, no evidencia de igualdad por chip. Comparación de SemiAnalysis
Huawei puede compensar parte de la brecha por chip mediante un sistema con más aceleradores interconectados.
Es una estrategia arquitectónica válida, pero tiene costes: más racks, equipos ópticos, complejidad de red, un dominio de fallo mayor y más demanda eléctrica contribuyen al coste total de propiedad.
Coste total de propiedad: el acelerador es solo una partida
Una comparación económica útil necesita presupuestos reales para las configuraciones propuestas, no una relación genérica entre precios de tarjetas. El coste total de propiedad incluye el acelerador, el servidor anfitrión, la red, la electricidad, la refrigeración, el software, la migración, el soporte y los repuestos:
Para un servicio de inferencia, el coste por token entregado dentro del objetivo acordado resulta más útil que el coste total por sí solo:
Un sistema que produce el doble de tokens no ofrece necesariamente más capacidad útil si el tiempo por token supera el límite acordado.
Ascend no es automáticamente la opción de menor consumo. Atlas 650E con ocho 950DT declara unos 14.5kW para el sistema completo. DGX H200 con ocho GPU especifica hasta 10.2kW. DGX B300 indica 14.5kW de consumo, mientras su guía fija 15kW como potencia máxima de entrada. Consumo declarado y entrada máxima son especificaciones diferentes. Las diferencias de CPU, red y diseño del sistema tampoco permiten deducir el rendimiento por vatio solo con esas cifras. Atlas 650E · Guía de DGX B300
Hay que medir tokens por julio, tokens por segundo por rack y tokens por segundo por dólar, con el mismo modelo, distribución de longitudes de contexto, concurrencia y objetivos de servicio. Sin esas condiciones, comparar precios de tarjetas resulta insuficiente.
¿Cuál es, entonces, la brecha real?
La evidencia disponible permite evaluar cada capa por separado:
| Capa | Situación técnica actual |
|---|---|
| Cálculo bruto por acelerador | Ventaja clara de NVIDIA; el 950DT actual ofrece alrededor del 40% de H200 en BF16/FP8 y menos del 20% de B300 |
| Ancho de banda de memoria | Mucho más cercano a H200: 4 frente a 4.8TB/s |
| Capacidad de memoria | El 950DT del Atlas 650E actual queda por detrás de H200 y B300; 950PR está más cerca de H200 |
| Generación de tokens en LLM | La brecha puede ser mucho menor que la diferencia de FLOPS |
| Prefill | La capacidad de cálculo pesa más; 950PR se dirige específicamente a esta fase |
| Comunicación MoE | Software operativo y resultados prometedores, pero los grupos grandes de expertos necesitan mejoras |
| PyTorch | Soporte oficial; no se garantiza la ejecución sin cambios de código dependiente de CUDA |
| vLLM | Soporte activo y sustancial, con diferencias en modelos y funciones disponibles |
| Entrenamiento a gran escala | Viable, pero la evidencia pública independiente no demuestra igualdad |
| Pruebas estandarizadas | Carencia importante para Ascend; Huawei no aparece en los resultados actuales de MLPerf |
| Inferencia del modelo completo | Hay resultados reales, principalmente del fabricante o sus socios |
| Coste total de propiedad | Requiere medir la carga y conocer el precio real de las configuraciones |
La evidencia no justifica afirmar que Ascend ha alcanzado a NVIDIA en todos los aspectos. Tampoco permite descartarlo como una opción técnicamente inutilizable.
El 950DT actual tiene una diferencia importante de cálculo bruto frente a H200, y especialmente frente a B300, pero una brecha mucho menor en ancho de banda de memoria y de conexión local anunciado. Por eso, decode y algunas cargas con mucha comunicación pueden mostrar una diferencia de rendimiento completo menor de lo que sugieren los TFLOPS.
Para entrenamientos enormes o aplicaciones que dependen de extensiones CUDA propias, kernels muy optimizados y herramientas maduras, el software puede importar todavía más que las especificaciones del chip. Aquí la comparación teórica debe dar paso a la medición.
La prueba que me gustaría realizar
Con un Atlas 650E, o incluso un sistema A3, migraría una carga real que hoy se ejecuta en NVIDIA a Ascend sin simplificarla. Mantendría el mismo modelo, tokenizador, distribución de longitudes de contexto, pruebas con los mismos niveles de concurrencia y objetivos de servicio.
Registraría el tiempo hasta el primer token (TTFT), el tiempo por token de salida (TPOT), la tasa de tokens de salida, las solicitudes en curso, la utilización de HBM, la capacidad de caché KV, la potencia del sistema y los fallos durante una ejecución de 24 o 72 horas.
También mediría el tiempo de ingeniería de la migración. ¿Cuántas líneas cambiaron? ¿Qué operadores fallaron? ¿Qué kernels hubo que sustituir? ¿Qué rutas de cuantización no estaban disponibles? Una vez ejecutado el modelo, ¿cuántos días de ajuste hicieron falta para obtener un rendimiento aceptable?
Ese esfuerzo forma parte de la prueba porque afecta a la decisión de despliegue.
La brecha entre Ascend y NVIDIA no es un único porcentaje. BF16, memoria, generación de tokens y ecosistema de software producen comparaciones diferentes.
La pregunta útil es:
Para este modelo, este motor, este objetivo de servicio y esta escala, ¿a qué renunciamos con Ascend y cuánta de la capacidad necesaria puede entregar realmente?
Hasta medirlo en hardware real, tanto afirmar una equivalencia general como descartar la alternativa resulta prematuro. La respuesta necesita una prueba con la carga real.
¿De dónde viene la sobrecarga de la computación confidencial en GPU?
¿Por qué una pila de inferencia confidencial en B200 pierde un 39 % de rendimiento y otra solo unos pocos puntos? Analizamos las mediciones de envío de comandos, PCIe, NVLink cifrado y software de inferencia.
Del envío de comandos y las transferencias PCIe a NVLink cifrado y la arquitectura de la pila de inferencia
La computación confidencial busca proteger los datos, los pesos del modelo y los estados intermedios de ejecución incluso frente al administrador de infraestructura, el sistema operativo anfitrión y el hipervisor. Para evaluar su coste hay que preguntar qué partes de la ejecución soportan sobrecarga, qué proporción de cada solicitud transcurre en ellas y cómo el software oculta o amplifica ese coste.
Un preprint reciente sobre computación confidencial en NVIDIA B200 presenta dos resultados aparentemente contradictorios: una sobrecarga de inferencia de aproximadamente el 1–3 % con una pila bien configurada y pérdidas del 30–40 % de rendimiento en algunas configuraciones sin corregir.
En el artículo sobre compatibilidad real con INT8 y FP8 vimos que admitir nominalmente un formato no garantiza su uso efectivo. En el de latencia y capacidad de procesamiento explicamos por qué la GPU más rápida no siempre produce la respuesta más rápida. Esta tercera entrega de la secuencia, dentro de la guía de selección de GPU, profundiza un nivel más: incluso manteniendo el hardware y el modelo, la arquitectura de seguridad y el software de inferencia determinan cuánto cuesta proteger los datos.
¿Qué se vuelve confidencial exactamente?
En el sistema estudiado, una máquina virtual confidencial con Intel TDX protege la memoria y el estado de la CPU frente al anfitrión. NVIDIA Confidential Computing extiende esa protección a la GPU.
La reflexión sobre seguridad de infraestructura desde el kernel hasta la GPU examinó el acceso a través de las capas inferiores. Aquí interesa el coste de proteger esas mismas fronteras:
- la memoria de la máquina virtual y el estado de la CPU;
- las transferencias entre la memoria del anfitrión y la GPU mediante PCIe;
- la memoria de la GPU;
- el envío de comandos al procesador de gestión de la GPU;
- la comunicación entre GPU mediante NVLink;
- y la cadena de atestación del hardware, el firmware y el entorno de ejecución.
En Intel TDX, la memoria privada de la máquina virtual se aísla del monitor de máquinas virtuales, o VMM, y del software anfitrión.
Según la guía de computación confidencial de NVIDIA, Blackwell admite NVLink cifrado en modo multi-GPU. Las transferencias CPU–GPU pueden utilizar búferes intermedios cifrados o, en plataformas compatibles, TDISP/IDE.
Activar el cifrado afecta, por tanto, a varias fronteras con patrones de coste distintos.
¿A qué sistema corresponden las mediciones?
Este artículo analiza la segunda versión del preprint, publicada el 1 de septiembre de 2026. Las mediciones son de sus autores; no son experimentos realizados para este artículo.
| Componente | Configuración del ensayo |
|---|---|
| Anfitrión | Servidor de dos procesadores Intel Xeon 6767P |
| GPU | Ocho NVIDIA B200 conectadas mediante NVLink |
| Entorno confidencial | Intel TDX y NVIDIA CC |
| Sistema operativo | Ubuntu 24.04.3 |
| Controlador del invitado | NVIDIA 595.71.05 Open Driver |
| Motores de inferencia | SGLang 0.5.13.post1 y una rama corregida; vLLM 0.21.0 y 0.22.0 |
| Modelos | Modelos densos y MoE con NVFP4, FP8, AWQ y bf16 |
| Comparación | Ejecuciones emparejadas con y sin CC en el mismo anfitrión, disco y GPU |
En cada comparación se conserva el hardware y se cambia el estado de TDX y CC. Sin embargo, las versiones del software, los modelos y las configuraciones difieren entre experimentos. Comparar los valores de una misma fila resulta más informativo que tratar filas distintas como si fueran intercambiables.
Los autores también explican que las mediciones limpias exigían reiniciar. El estado residual de la GPU produjo una sobrecarga aparente del 16 % en una ejecución; tras un inicio limpio, la misma carga mostró alrededor del 2 %. El estado acumulado puede introducir una diferencia mucho mayor que la sobrecarga que se intenta medir.
El cálculo no es el principal cuello de botella
El hallazgo central es que la multiplicación de matrices, GEMM y el acceso a HBM no fueron las fuentes principales de sobrecarga en esta configuración. El coste apareció sobre todo en las fronteras de comunicación:
- envío de comandos del anfitrión a la GPU;
- transferencias CPU–GPU por PCIe;
- comunicación entre GPU por NVLink cifrado.
La aritmética no se volvió necesariamente más lenta. Lo que se encareció fue entregar los comandos y los datos, y coordinar las GPU.
Primer coste: cada comando pequeño tiene un precio fijo
Cuando el anfitrión lanza un kernel, el comando atraviesa una ruta de control protegida hasta el GPU System Processor, o GSP. El estudio midió unos 12 microsegundos adicionales por envío de kernel en una GPU:
| Operación | CC desactivado | CC activado | Diferencia |
|---|---|---|---|
| Envío de un kernel | 3,45 µs | 15,7 µs | Unos 12 µs |
| Sincronización sin envío | 1,62 µs | 1,67 µs | Casi cero |
Doce microsegundos importan cuando un paso de decodificación contiene decenas o cientos de envíos separados. En el microbenchmark del estudio, cada paso tenía unos 181 kernels. La ejecución inmediata, o eager, volvía a enviarlos en cada paso:
| Modo de ejecución | CC desactivado | CC activado | Relación de tiempos |
|---|---|---|---|
| Eager | 2644 µs por paso | 6358 µs | 2,41× |
| Grafo CUDA completo | 2500 µs | 2589 µs | 1,04× |
Un grafo CUDA registra previamente las operaciones y reproduce el grafo en lugar de enviar cientos de comandos individuales. En este ensayo, una penalización grande en la ruta de control se redujo así a unos pocos puntos porcentuales.
Pero «grafos CUDA activados» no describe lo suficiente. Si el software fragmenta el grafo en cada capa de atención, todavía pueden quedar unos 185 envíos del anfitrión por paso. Importa el número real de envíos, no el nombre del ajuste.
Podemos aproximar este coste mediante:
Cuanto más corto sea el cálculo de un paso y más envíos contenga, mayor será el peso de ese coste fijo.
Segundo coste: PCIe cifrado no es solo ancho de banda
Esta pila transfiere datos entre anfitrión y GPU mediante AES-GCM y búferes intermedios gestionados por el controlador. En transferencias grandes, el coste es aproximadamente proporcional al número de bytes. En las pequeñas, pesan más la preparación criptográfica y el coste de la llamada.
En los ensayos:
- la tasa fue de 7,21 GB/s para 1 MB y de unos 9,4–9,6 GB/s para 16 y 64 MB;
- las transferencias de 64 KB o menos dependían más de una sobrecarga fija de unos 3–6 µs;
- añadir hilos del anfitrión no mejoró la velocidad de cifrado de una sesión de GPU.
La limitación se aprecia al cargar los pesos. Si después los pesos y la caché KV permanecen en la GPU, no tiene por qué repetirse en la ruta crítica de cada token.
El problema más dañino apareció al recuperar desde la GPU el resultado del muestreo al final de cada paso de decodificación. En la pila sin corregir, una pequeña copia del dispositivo al anfitrión que debía solaparse con el cálculo siguiente pasó a ser, en la práctica, síncrona. El planificador se detenía, la GPU esperaba y su utilización caía. La pérdida de rendimiento superaba el tiempo dedicado al cálculo AES.
Aquí aparece el resultado del 30–40 %.
¿Por qué un experimento muestra un 39 % y otro menos del 1 %?
Con SGLang publicado y sin corregir, Qwen3-8B en una B200, con solapamiento activado, produjo:
| Concurrencia | Sin CC, tokens/s | Con CC, tokens/s | Pérdida de rendimiento |
|---|---|---|---|
| 16 | 3828 | 2513 | 34,4 % |
| 32 | 6931 | 4534 | 34,6 % |
| 64 | 11 137 | 6805 | 38,9 % |
Con concurrencia 64, el tiempo por token de salida pasó de 5,48 a 8,28 ms y el tiempo hasta el primer token, de 259 a 409 ms. El «39 %» se refiere a la pérdida de rendimiento; algunas latencias aumentaron todavía más.
La copia D2H dejó de ocultarse tras el cálculo, la planificación se serializó y la utilización de la GPU cayó del 74 al 57 %.
Después de trasladar las copias D2H a un trabajador asíncrono y aplicar correcciones compatibles con CC, otro experimento con una GPU y Qwen2.5-72B-AWQ mostró entre −0,2 y +0,6 % de sobrecarga al variar la concurrencia: prácticamente ruido de medición. Era otro modelo, no una comparación antes y después sobre el mismo modelo. En diez combinaciones de entrada y salida, la mediana fue del 1,2 % y el peor resultado, del 6,5 %.
La pérdida del 30–40 % no es, por tanto, un coste intrínseco del cifrado de la GPU. Surge de la interacción entre el modo confidencial y una pila concreta sin corregir. El resultado cercano a cero también depende del software, el modelo y la forma de la carga.
Tercer coste: NVLink cifrado
Una segunda GPU añade otra ruta: operaciones colectivas como all-reduce y all-to-all deben recorrer NVLink cifrado.
Un microbenchmark con cuatro B200 en un nodo NUMA informó de lo siguiente:
| Métrica | CC activado, GB/s | CC desactivado, GB/s | Reducción calculada |
|---|---|---|---|
| Copy Engine, lectura unidireccional | 8070 | 9170 | 12,0 % |
| Copy Engine, escritura unidireccional | 8278 | 9292 | 10,9 % |
| Lectura mediante SM | 7693 | 9388 | 18,1 % |
| NCCL all-reduce | 156 | 185 | 15,7 % |
| NCCL all-to-all | 130 | 149 | 12,8 % |
Los porcentajes NCCL se calculan a partir de cada fila: las etiquetas «10 %» de la tabla original no coinciden con esos valores. Las filas Copy Engine y SM son métricas del ensayo D2D, no especificaciones de ancho de banda de una conexión NVLink individual. La mediana de latencia de una escritura P2P pequeña también subió de 3,7 a 14,5 µs, casi cuatro veces.
Esto no implica perder un 10–18 % de rendimiento en todo el servicio. El efecto final depende de cuánto tiempo de cada paso se dedica a comunicar las GPU.
Si una operación colectiva ocupa solo el 20 % de la ruta crítica y el cifrado la ralentiza un 10 %, su aportación directa al tiempo total es muy inferior al 10 %. Una carga casi totalmente limitada por la comunicación se acerca más a la penalización de la comunicación pura.
Por eso la diferencia entre PCIe y SXM va más allá del montaje: la ruta y el volumen de comunicación también afectan al coste de la ejecución confidencial.
Dos dimensiones independientes de la sobrecarga
| Dimensión del coste | Comportamiento | Cómo reducirlo |
|---|---|---|
| Operaciones fijas del anfitrión | Se repiten con los envíos, la sincronización y las lecturas de resultados | Grafos CUDA más completos, menos fragmentación, trabajador D2H asíncrono |
| Tráfico NVLink | Varía con el tráfico cifrado entre GPU | Menos operaciones colectivas innecesarias y paralelismo adecuado |
Los lotes grandes reparten el coste fijo de los envíos entre más solicitudes, pero también pueden aumentar el tráfico colectivo. El procesamiento por lotes mejora una dimensión y puede hacer más visible la otra hasta alcanzar una meseta. No existe un tamaño que minimice ambos costes para todas las cargas.
¿En qué condiciones se obtuvo el 1–3 %?
El principal resultado multi-GPU corresponde a MiniMax-M2.7, un modelo MoE con unos 229 000 millones de parámetros totales y 6000 millones activos, en ocho B200.
En el punto de referencia, con 1024 tokens de entrada, 2048 de salida y concurrencia 32:
- TP8 mostró un 2,8 y un 3,6 % de sobrecarga en dos conjuntos de cinco repeticiones;
- TP4 mostró alrededor del 1,5 %;
- al reducir a la mitad el grado de paralelismo tensorial, TP4 conservó el 94 % del rendimiento de TP8.
«Alrededor del 1–3 %» describe un régimen concreto: pila corregida, grafos CUDA por segmentos, solapamiento activado, carga dominada por la decodificación y paralelismo adecuado para el modelo. No es un resultado universal ni se cumple con cualquier configuración del mismo servidor.
| Escenario medido | Sobrecarga informada | Mecanismo principal |
|---|---|---|
| Una GPU, sin solapamiento | Un 2 % aproximadamente | Coste residual de la ruta de comandos |
| Una GPU, solapamiento y pila sin corregir | 34–39 % | Pérdida del solapamiento entre cálculo y copia |
| Una GPU, grafos y pila corregida | Menos del 1 % en el barrido principal | Coste retirado de la ruta crítica |
| MoE con TP8 | Aproximadamente 2,8–3,6 % | All-reduce cifrado |
| MoE con TP4 | Un 1,5 % aproximadamente | Menos tráfico NVLink |
| Qwen3.5 con DP-attention y EP, entrada de 32 768 tokens | Un 2 % aproximadamente | Sin all-reduce en la atención |
| Entrenamiento con ocho GPU | Pasos un 11–24 % más largos | Operaciones colectivas frecuentes |
Las filas de inferencia miden pérdida de rendimiento; las de entrenamiento, aumento de la duración del paso. Los denominadores son distintos. También hay diferencias sustanciales entre los ensayos de entrenamiento:
| Ensayo en ocho GPU | Tiempo por paso sin CC | Tiempo por paso con CC | Aumento |
|---|---|---|---|
| Modelo denso, bf16 y TP8 | 13,95 s | 15,8 s | 13,3 % |
| Modelo denso, delayed FP8 y TP8 | 14,5 s | 18,0 s | 24,1 % |
| MoE ajustado con EP8 | 2,16 s | 2,40 s | 11,1 % |
Los porcentajes se calculan con los tiempos publicados. El experimento FP8 presenta el mayor incremento.
¿Cómo cambia el resultado con la longitud de salida?
En un barrido de MiniMax-M2.7 con TP8, 1024 tokens de entrada y concurrencia 32, una salida más larga repartió el coste del prefill cifrado entre más pasos de decodificación:
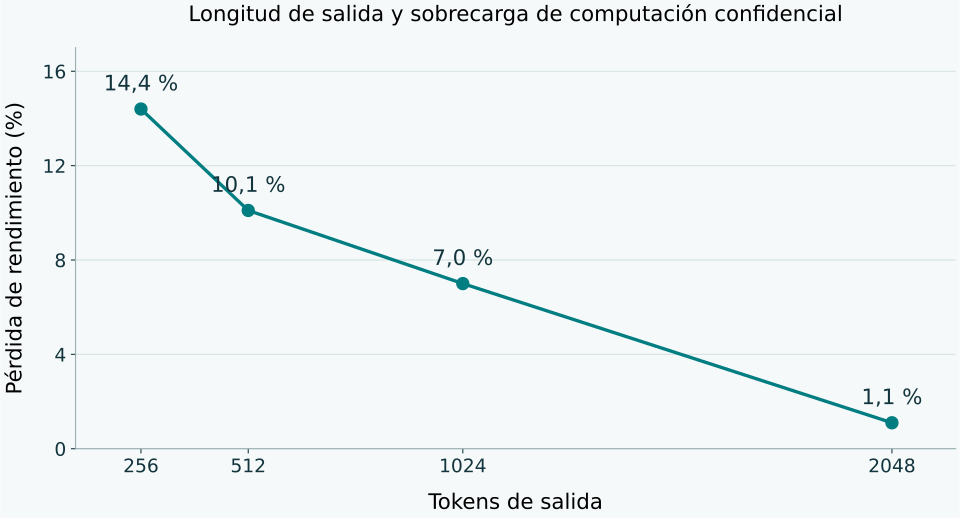
| Tokens de salida | Sin CC, tokens/s | Con CC, tokens/s | Pérdida de rendimiento |
|---|---|---|---|
| 256 | 1701,0 | 1456,0 | 14,4 % |
| 512 | 2300,5 | 2068,4 | 10,1 % |
| 1024 | 2551,4 | 2371,6 | 7,0 % |
| 2048 | 2530,7 | 2504,0 | 1,1 % |
El gráfico utiliza los valores del barrido del artículo. La mayoría de los puntos eran ejecuciones únicas sobre datos aleatorios; los autores indican una variación de unos dos puntos porcentuales. Las mediciones con cinco repeticiones de la misma combinación de 1024 tokens de entrada y 2048 de salida dieron un 2,8–3,6 %, no un 1,1 %. El gráfico sustenta mejor la dirección del cambio que el último decimal de cada punto.
En este ensayo, el procesamiento inicial de la entrada, o prefill, ocupaba una parte mayor del tiempo en respuestas cortas. Al prolongarse la generación de salida, o decode, su contribución relativa disminuía.
Un contexto más largo no siempre reduce la sobrecarga
El efecto depende del paralelismo. En el ensayo de MiniMax-M2.7 con NVFP4, cuatro GPU y TP2/EP4/DP2, ampliar la entrada de 4096 a 32 768 tokens elevó la sobrecarga del 9 al 14,5 %, asociada a más tráfico all-reduce durante el prefill.
En cambio, en Qwen3.5-397B-A17B con FP8, ocho GPU y DP8/EP8, la atención no necesitaba all-reduce entre GPU. En el mismo intervalo de entrada, la sobrecarga cayó del 11,1 al 1,9 %. El cálculo adicional amortizó los costes fijos y la comunicación entre expertos.
Son modelos, formatos numéricos y cantidades de GPU distintos; no se puede atribuir toda la diferencia al paralelismo. Ambos ensayos usaron 256 tokens de salida y concurrencia 32.
Decir que «un contexto largo reduce la sobrecarga de CC» es tan incompleto como afirmar lo contrario. La cuestión es cuánto cálculo adicional y cuánta comunicación cifrada crea ese contexto.
Más paralelismo no siempre es mejor
El paralelismo tensorial intercambia partes de las activaciones entre GPU en cada capa, normalmente mediante all-reduce. En modo confidencial, ese tráfico se cifra. Si el modelo funciona adecuadamente sin TP de ocho vías, distribuirlo entre más participantes puede limitarse a aumentar la comunicación.
En el punto de referencia del estudio, pasar de TP8 a TP4 redujo aproximadamente a la mitad la sobrecarga de CC, hasta el 1,5 %, y conservó el 94 % del rendimiento.
La conclusión no es simplemente utilizar menos GPU. El número de GPU y la anchura de un grupo de paralelismo tensorial son conceptos distintos. Un despliegue mayor puede mantener cada réplica o grupo TP en el tamaño que realmente necesita el modelo.
En modelos MoE, el paralelismo de expertos y de datos también puede requerir menos comunicación síncrona que el tensorial. Hay que probarlo con el modelo, el lote, el contexto y la topología reales.
El software forma parte de la arquitectura de seguridad
La comparación de Ollama, vLLM, SGLang y llama.cpp parte de las necesidades del servicio. Para una ejecución confidencial, el comportamiento de transferencia de una versión concreta del software añade otro criterio. El framework determina cuántas veces se repite un pequeño coste del hardware y en qué punto de la ruta crítica aparece.
El estudio destaca estas medidas:
- utilizar grafos CUDA y reducir su fragmentación;
- trasladar la lectura de tokens a un trabajador asíncrono;
- no solicitar memoria fijada del anfitrión cuando la pila no la admite;
- usar el temporizador global en vez de eventos CUDA en el ajuste automático;
- elegir fusiones que no dependan del multicast bloqueado en modo CC;
- mantener los pesos y la caché KV en la GPU;
- evitar la transferencia continua de pesos, la descarga de expertos a CPU y la descarga de KV en la ruta crítica;
- dimensionar TP según el modelo, no según las GPU disponibles.
Un informe de NVIDIA del 2 de julio de 2026 también destaca el trabajador D2H asíncrono, los temporizadores compatibles con CC y los grafos CUDA por segmentos. Sus pruebas de HGX B300 con Qwen3.5 muestran un impacto aproximado del 1–8 % en distintas cargas. No se deben combinar esos valores con los de B200 ni sustituir unos por otros, pero ambos evidencian el peso de la versión y la configuración del software.
¿Qué no midió el estudio?
Arranque y atestación
No se midieron la creación de la máquina virtual confidencial, la inicialización de GPU, el establecimiento de sesiones seguras, la atestación de CPU/GPU ni la entrega de claves.
La atestación suele preceder a la entrega de secretos y al inicio de la carga, en lugar de repetirse con cada solicitud. Aun así, el arranque puede ser importante en cargas efímeras, escalado automático intenso o servicios sin servidor. El estudio no aporta una cifra para ello.
Comunicación entre anfitriones
Todos los resultados proceden de un anfitrión físico. No se evaluaron RDMA, comunicación de GPU entre servidores, separación de prefill y decode ni transferencia de caché KV entre nodos.
El artículo explica que CC restringe GPUDirect RDMA y los búferes fijados convencionales en la pila probada. Una transferencia puede acabar recorriendo GPU–CPU–CPU–GPU. Es un problema arquitectónico, no una medición cuantitativa de un clúster multinodo.
Garantías de seguridad
El trabajo no auditó ni demostró propiedades de seguridad. Quedaron fuera la resistencia frente a un adversario concreto, el firmware, la cadena de suministro, las claves, la política de atestación y los canales laterales.
Los poderes del administrador, los registros y la información recuperable de las salidas requieren un análisis separado del acceso indirecto a los datos.
Otros equipos
Los resultados corresponden a B200, Intel TDX y versiones específicas de controladores y frameworks. No se trasladan directamente a H100, B300, otras GPU, AMD SEV-SNP, plataformas TDISP/IDE ni generaciones posteriores del software.
¿Qué debe registrar una prueba de aceptación?
Una prueba para adquirir o aceptar infraestructura debería recoger, como mínimo:
| Área | Datos necesarios |
|---|---|
| Hardware | CPU/GPU, cantidad de GPU, topología NUMA y NVLink |
| Seguridad | Tipo de TEE, modo CC, versión de firmware y método de atestación |
| Software | Versiones del controlador, CUDA, NCCL, framework y parches CC |
| Modelo | Versión de pesos, precisión y arquitectura densa o MoE |
| Carga | Distribución de longitudes de entrada/salida, lote y tasa de llegada |
| Paralelismo | TP, PP, DP y EP, con el tamaño de cada grupo |
| Planificación | Grafos CUDA completos o por segmentos, solapamiento y prefill por bloques |
| Memoria | Ubicación de pesos/caché KV y configuración de descarga |
| Resultados | TTFT, TPOT, rendimiento, goodput, errores y utilización |
| Ciclo de vida | Tiempo de arranque, atestación y entrega de claves cuando importe |
| Escala | Uno o varios anfitriones y rutas reales de comunicación |
Ejecute la misma carga con y sin CC sobre idénticos datos y hardware. Repita cada punto y presente la dispersión junto a la media o mediana. Una diferencia del uno o dos por ciento en una sola ejecución puede ser únicamente ruido de medición.
Antes de elegir una configuración
Si la pérdida de rendimiento aumenta del 34 al 39 % con la concurrencia y baja la utilización de GPU, revise primero la lectura de resultados y el planificador. Si crece con la longitud de entrada y el tráfico colectivo, cobran importancia el grado de TP y la comunicación entre GPU. Son problemas que requieren correcciones distintas.
En la configuración de referencia, TP4 conservó cerca del 94 % del rendimiento de TP8 con menos sobrecarga de confidencialidad. Esta comparación resulta más útil que un «coste de CC» universal: ¿qué configuración atiende la carga real con la latencia y la capacidad necesarias?
Servidores y equipos de IA
De portátiles y sobremesas a servidores de rack
La inferencia local puede requerir un sobremesa, un portátil o un servidor de rack. Esta tabla reúne ambos tipos. Si compra una GPU independiente, elija «Mi tarjeta» para ver chasis adecuados; los sistemas integrados se comparan con sus propios aceleradores. Cada fila enlaza una fuente oficial.
Última revisión de los datos3 de noviembre de 2026
Qué significa aquí la validaciónLa validación del fabricante solo se indica cuando el modelo exacto de GPU aparece en la página oficial del servidor, sus QuickSpecs o su QPL. Si coinciden dimensiones y potencia pero no hay validación explícita de la tarjeta, se exige confirmar la lista de componentes.
Filtros de selección y compatibilidad 57 Resultados
Resultados57de 57 modelos de referencia
Sistemas de tarjetas PCIe23Tras aplicar los filtros
Validación explícita de la tarjeta—Seleccione primero Mi GPU
Seleccionados para comparar0Hasta 4 servidores
| Comparar | Detalles | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
MicrosoftAzure Maia 300 rackAnunciadoAnunciado; despliegue en Azure previsto desde 2027. | Rack exclusivo de nube | Anunciado | Integrado | 96 × Maia 300 | No anunciado | Placa integrada / interconexión dedicada | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
 LenovoVera Rubin NVL72Generación actualLenovo anunció envíos globales de NVL72 el 12 de octubre; el resto de la plataforma de cinco racks sigue en acceso anticipado. | Rack integrado | Generación actual | Integrado | 72 × NVIDIA Rubin | No anunciado | NVLink 6 / 72 GPU + 36 CPU | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
 SupermicroVera Rubin NVL72Generación actual | Aceleradores integrados | Generación actual | Integrado | 72 GPU NVIDIA Rubin integradas en un rack; no son tarjetas PCIe instalables | No anunciado | Placa integrada / interconexión dedicada | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
 NVIDIAVera Rubin NVL72 (OCI)Generación actualDisponible en OCI desde el 27 de octubre de 2026. | Rack integrado en la nube | Generación actual | Integrado | 72 × NVIDIA Rubin | No anunciado | 72 GPU en un dominio NVLink; red OCI Supercluster entre racks | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
 ASRock Rack4U10G-ROME2/2TGeneración anterior | Tarjetas de expansión PCIe | Generación anterior | PCIe Gen4 | 10 doble ranura · 20 una ranura | 4U | Directo a la CPU | Pasiva | Requiere lista de componentes | Compruebe el modelo exacto en el configurador/QPL | ||
 DellPowerEdge XE7745Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 16 una ranura | 4U | Mediante un conmutador PCIe | Pasiva | 600 W | NVIDIA H200 NVL PCIe, NVIDIA RTX PRO 6000 Blackwell Server Edition | ||
 GIGABYTEG495-DB1-AM1Anunciado | Tarjetas de expansión PCIe | Anunciado | PCIe Gen6 | 10 doble ranura | 4U | Mediante un conmutador PCIe | Pasiva | Requiere lista de componentes | Compruebe el modelo exacto en el configurador/QPL | ||
| SupermicroGPU A+ Server AS-4125GS-TNRT2Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 10 doble ranura · 10 una ranura | 4U · 737 mm | Mediante un conmutador PCIe | Passive / Active | Requiere lista de componentes | NVIDIA L4 (≤8), NVIDIA L40S (≤10), NVIDIA RTX PRO 4500 Blackwell Server Edition (≤8) | ||
| SupermicroGPU SuperServer SYS-420GP-TNRGeneración anterior | Tarjetas de expansión PCIe | Generación anterior | PCIe Gen4 | 10 doble ranura · 10 una ranura | 4U · 737 mm | Mediante un conmutador PCIe | Passive / Active | Requiere lista de componentes | NVIDIA H100 PCIe, NVIDIA A100 PCIe, NVIDIA A40, NVIDIA A10, NVIDIA L40S, NVIDIA RTX A6000 | ||
| SupermicroGPU SuperServer SYS-422GA-NRTGeneración actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 10 una ranura · 2 triple ranura | 4U · 737 mm | Mediante un conmutador PCIe | Passive / Active | 600 W | NVIDIA H200 NVL PCIe (≤8), NVIDIA RTX PRO 6000 Blackwell Server Edition (≤8), NVIDIA RTX PRO 4500 Blackwell Server Edition (≤8) | ||
 HPEProLiant Compute DL380a Gen12Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 10 doble ranura | 4U | Mediante un conmutador PCIe | Pasiva | 600 W | NVIDIA H200 NVL PCIe, NVIDIA H100 NVL PCIe, NVIDIA RTX PRO 6000 Blackwell Server Edition (≤8), NVIDIA L40S, NVIDIA L4 | ||
| HPEProLiant DL380a Gen11Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 4 doble ranura · 8 una ranura | 2U · 816 mm | Directo a la CPU | Passive / Active | Requiere lista de componentes | NVIDIA L40S, NVIDIA L4, NVIDIA A10, NVIDIA RTX 6000 Ada | ||
| LenovoThinkSystem SR655 V3Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 3 doble ranura · 8 una ranura | 2U | Directo a la CPU | Passive / Active | Requiere lista de componentes | NVIDIA L40S, NVIDIA L4, NVIDIA A10, NVIDIA RTX 6000 Ada | ||
| LenovoThinkSystem SR675 V3Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 8 una ranura | 3U · 892 mm | Mediante un conmutador PCIe | Passive / Active | 600 W | NVIDIA H200 NVL PCIe, NVIDIA RTX PRO 6000 Blackwell Server Edition, NVIDIA L40S | ||
| ASRock Rack4U8G-EGS2Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura | 4U | Directo a la CPU | Pasiva | Requiere lista de componentes | Compruebe el modelo exacto en el configurador/QPL | ||
HuaweiAtlas 800I A2Generación actual | Servidor de rack con NPU integradas | Generación actual | Integrado | 8 módulos NPU Ascend | 4U / 175 × 447 × 790 mm | Interconexión interna de NPU; variante full-mesh opcional. | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
 ASUSESC8000A-E11Generación anterior | Tarjetas de expansión PCIe | Generación anterior | PCIe Gen4 | 8 doble ranura · 8 una ranura | 4U | Directo a la CPU | Passive / Active | Requiere lista de componentes | NVIDIA A100 PCIe, NVIDIA A40, NVIDIA A10, NVIDIA RTX A6000 | ||
| ASUSESC8000A-E12Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 8 una ranura | 4U | Directo a la CPU | Passive / Active | Requiere lista de componentes | NVIDIA H100 PCIe, NVIDIA L40S | ||
| ASUSESC8000A-E13Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 8 una ranura | 4U | Directo a la CPU | Passive / Active | 600 W | NVIDIA H200 NVL PCIe, NVIDIA RTX PRO 6000 Blackwell Server Edition, NVIDIA RTX PRO 4500 Blackwell Server Edition | ||
| GIGABYTEG492-H80Generación anterior | Tarjetas de expansión PCIe | Generación anterior | PCIe Gen4 | 8 doble ranura · 8 una ranura | 4U | Directo a la CPU | Pasiva | Requiere lista de componentes | NVIDIA A100 PCIe, NVIDIA A40, NVIDIA A10 | ||
| GIGABYTEG494-SB0-AAP2Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 8 una ranura | 4U | Mediante un conmutador PCIe | Pasiva | 600 W | NVIDIA H200 NVL PCIe, NVIDIA RTX PRO 6000 Blackwell Server Edition | ||
| GIGABYTEG494-ZB4-AAP2Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 8 una ranura | 4U | Mediante un conmutador PCIe | Pasiva | 600 W | NVIDIA H200 NVL PCIe, NVIDIA RTX PRO 6000 Blackwell Server Edition | ||
| SupermicroGPU SuperServer SYS-421GE-TNRT3Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 8 una ranura | 4U | Mediante un conmutador PCIe | Passive / Active | Requiere lista de componentes | NVIDIA A100 PCIe, NVIDIA H100 NVL PCIe, NVIDIA H100 PCIe, NVIDIA L40S, NVIDIA L4 | ||
| DellPowerEdge XE7740Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura · 8 una ranura | 4U · 886,7 mm | Mediante un conmutador PCIe | Pasiva | 600 W | NVIDIA H200 NVL PCIe, NVIDIA H100 NVL PCIe, NVIDIA RTX PRO 6000 Blackwell Server Edition, NVIDIA L40S, NVIDIA L4 | ||
 FujitsuPRIMERGY GX2550 M8sGeneración actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 8 doble ranura | 4U · 737 mm | Mediante un conmutador PCIe | Pasiva | 600 W | NVIDIA H200 NVL PCIe, NVIDIA RTX PRO 6000 Blackwell Server Edition | ||
HuaweiAtlas 800I A3Generación actual | Servidor de rack con NPU integradas | Generación actual | Integrado | 8 × Ascend 910 / 1024GB de memoria NPU total | 10U / 442 × 447 × 920 mm | NPU D2D / 784GB/s bidirectional | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
HuaweiAtlas 650E (Ascend 950DT)Generación actual | Servidor de rack con NPU integradas | Generación actual | Integrado | 8 × Ascend 950DT / 768GB de HBM total | 14U / 618.8 × 447 × 920 mm | Lingqu / NPU full-mesh | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| NVIDIAHGX Rubin NVL8 (OCI)AnunciadoConfiguración OCI anunciada el 27 de octubre; sin fecha de disponibilidad. | Servidor integrado en la nube | Anunciado | Integrado | 8 × NVIDIA Rubin / NVLink 6 | No anunciado | 8-GPU NVLink domain / x86 host | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| HPEProLiant DL585a Gen13AnunciadoAnunciado el 7 de octubre; disponibilidad prevista a principios de 2027 | Servidor GPU anunciado | Anunciado | PCIe Gen6 | 8 doble ranura | No anunciado | Directo a la CPU | Sin tarjetas independientes | Requiere lista de componentes | Compruebe el modelo exacto en el configurador/QPL | ||
| HPEProLiant Compute DL345 Gen12Generación actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 4 doble ranura · 6 una ranura | 2U | Directo a la CPU | Pasiva | Requiere lista de componentes | NVIDIA RTX PRO 4500 Blackwell Server Edition (≤4), NVIDIA L40S (≤4), NVIDIA L4 (≤6) | ||
| SupermicroSuperWorkstation SYS-532AW-CGeneración actual | Tarjetas de expansión PCIe | Generación actual | PCIe Gen5 | 1 doble ranura · 1 una ranura · 1 triple ranura | 4U | Directo a la CPU | Activa | 600 W | GeForce RTX 5090 | ||
HPZGX Fury AI Station (GB300 / Windows)AnunciadoEdición Windows anunciada para finales de 2026; las especificaciones actuales corresponden a Ubuntu. | Estación de trabajo con GB300 integrado | Anunciado | Integrado | 1 × GB300 Grace Blackwell Ultra / 252GB HBM3e | Torre; montaje en rack de 5U con raíles del fabricante | GB300 / NVLink-C2C | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| NVIDIADGX Spark 128GBGeneración actual | Equipo de escritorio integrado | Generación actual | Integrado | 1 × NVIDIA GB10 Blackwell / 128GB UMA | 150 × 150 × 50.5 mm | GB10 / NVLink-C2C | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| NVIDIADGX Spark 64GB (OEM)AnunciadoDisponibilidad prevista mediante socios desde el 23 de octubre de 2026 | Equipo de escritorio integrado | Anunciado | Integrado | 1 × NVIDIA GB10 Blackwell / 64GB UMA | Sobremesa; altura de rack no especificada para esta configuración | GB10 / NVLink-C2C | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
GMKtecEVO-X2 (Ryzen AI Max+ 395)Generación actual | Equipo de escritorio integrado | Generación actual | Integrado | 1 × AMD Radeon 8060S / shared LPDDR5x | 193 × 185.8 × 77 mm | AMD UMA / integrated Radeon | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
MinisforumMS-S1 MAX (Ryzen AI Max+ 395)Generación actual | Equipo de escritorio integrado | Generación actual | Integrado | 1 × AMD Radeon 8060S / shared LPDDR5x | Sobremesa; altura de rack no especificada para esta configuración | AMD UMA / integrated Radeon | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
HPOmniBook Ultra 16 (RTX Spark)Generación actualDisponible desde el 16 de octubre de 2026; figura en el anuncio de lanzamiento de NVIDIA. | Portátil con acelerador integrado | Generación actual | Integrado | 1 × NVIDIA RTX Spark Blackwell | Portátil; dimensiones exactas según modelo y configuración. | RTX Spark / CPU–GPU unified memory | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
MSIPrestige N16 Flip AI+ (RTX Spark)Generación actualDisponible desde el 16 de octubre de 2026; figura en el anuncio de lanzamiento de NVIDIA. | Portátil con acelerador integrado | Generación actual | Integrado | 1 × NVIDIA RTX Spark Blackwell | Portátil; dimensiones exactas según modelo y configuración. | RTX Spark / CPU–GPU unified memory | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| DellPro Precision with GB300 (Windows)AnunciadoEdición Windows anunciada para finales de 2026; las especificaciones actuales corresponden a Ubuntu. | Estación de trabajo con GB300 integrado | Anunciado | Integrado | 1 × GB300 Grace Blackwell Ultra / 252GB HBM3e | 569 × 231.6 × 610.5 mm | GB300 / NVLink-C2C | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| ASUSProArt P14 (RTX Spark)AnunciadoReservas desde el 7 de octubre; envíos desde el 16 de octubre de 2026 | Portátil con acelerador integrado | Anunciado | Integrado | 1 × NVIDIA RTX Spark Blackwell | Portátil; dimensiones exactas según modelo y configuración. | RTX Spark / CPU–GPU unified memory | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| ASUSProArt P16 (RTX Spark)Generación actualDisponible desde el 16 de octubre de 2026; figura en el anuncio de lanzamiento de NVIDIA. | Portátil con acelerador integrado | Generación actual | Integrado | 1 × NVIDIA RTX Spark Blackwell | Portátil; dimensiones exactas según modelo y configuración. | RTX Spark / CPU–GPU unified memory | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
AMDRyzen AI Halo / Max+ PRO 495AnunciadoAnunciado el 12 de octubre; envíos y precio no verificados en el anuncio. | Equipo de desarrollo de escritorio con memoria compartida | Anunciado | Integrado | 40 CU / RDNA 3.5 | No anunciado | Directo a la CPU | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
MicrosoftSurface Laptop Ultra (RTX Spark)Generación actualDisponible desde el 16 de octubre de 2026; figura en el anuncio de lanzamiento de NVIDIA. | Portátil con acelerador integrado | Generación actual | Integrado | 1 × NVIDIA RTX Spark Blackwell | Pantalla de 15 pulgadas; grosor inferior a 18 mm | RTX Spark / CPU–GPU unified memory | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
MicrosoftSurface RTX Spark Dev BoxAnunciadoReservas desde el 7 de octubre; envíos en EE. UU. desde noviembre de 2026 | Equipo de escritorio integrado | Anunciado | Integrado | 1 × NVIDIA RTX Spark Blackwell | Sobremesa; altura de rack no especificada para esta configuración | RTX Spark / CPU–GPU unified memory | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| DellXPS 16 Creator Edition (RTX Spark)Generación actualDisponible desde el 16 de octubre de 2026; figura en el anuncio de lanzamiento de NVIDIA. | Portátil con acelerador integrado | Generación actual | Integrado | 1 × NVIDIA RTX Spark Blackwell | Portátil; dimensiones exactas según modelo y configuración. | RTX Spark / CPU–GPU unified memory | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| LenovoYoga 9n 2-in-1 (RTX Spark)AnunciadoReservas desde el 7 de octubre; envíos desde el 16 de octubre de 2026 | Portátil con acelerador integrado | Anunciado | Integrado | 1 × NVIDIA RTX Spark Blackwell | Portátil; dimensiones exactas según modelo y configuración. | RTX Spark / CPU–GPU unified memory | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| DellPowerEdge XE9680LGeneración actual | Aceleradores integrados | Generación actual | Integrado | 8 × H200 o B200 HGX en un chasis 4U con refrigeración líquida | 4U | Placa integrada / interconexión dedicada | Sin tarjetas independientes | 1000 W | Esta fila no sirve para elegir una tarjeta independiente | ||
| HPECray XD670Generación actual | Aceleradores integrados | Generación actual | Integrado | 8 × H100 o H200 SXM5; no admite tarjetas de GPU PCIe | 5U | Placa integrada / interconexión dedicada | Sin tarjetas independientes | 700 W | Esta fila no sirve para elegir una tarjeta independiente | ||
| DellPowerEdge XE9680Generación actual | Aceleradores integrados | Generación actual | Integrado | 8 × H100/H200 SXM5 o MI300X/Gaudi3 OAM | 6U · 995 mm | Placa integrada / interconexión dedicada | Sin tarjetas independientes | 900 W | Esta fila no sirve para elegir una tarjeta independiente | ||
| HPEProLiant Compute XD685Generación actual | Aceleradores integrados | Generación actual | Integrado | 8 × B300/B200/H200 o AMD MI355X | 6U | Placa integrada / interconexión dedicada | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
 QCTQuantaGrid D75T-7UGeneración actual | Aceleradores integrados | Generación actual | Integrado | 8 aceleradores AMD MI325X o NVIDIA H200 SXM5 integrados en 7U | 7U · 950 mm | Placa integrada / interconexión dedicada | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| FujitsuPRIMERGY GX2580 M8sGeneración actual | Aceleradores integrados | Generación actual | Integrado | 8 × B300 HGX; 2.3 TB HBM3e en el sistema completo | 8U · 950 mm | Placa integrada / interconexión dedicada | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| LenovoThinkSystem SR680a V3 (H100/H200)Generación anterior | Aceleradores integrados | Generación anterior | Integrado | 8 aceleradores HGX integrados en un chasis 8U refrigerado por aire | 8U | Placa integrada / interconexión dedicada | Sin tarjetas independientes | 700 W | Esta fila no sirve para elegir una tarjeta independiente | ||
| LenovoThinkSystem SR680a V4Generación actual | Aceleradores integrados | Generación actual | Integrado | 8 GPU B300 HGX integradas en un chasis 8U refrigerado por aire | 8U | Placa integrada / interconexión dedicada | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente | ||
| LenovoThinkSystem SR685a V3Generación anterior | Aceleradores integrados | Generación anterior | Integrado | 8 aceleradores H100/H200 o MI300X integrados | 8U | Placa integrada / interconexión dedicada | Sin tarjetas independientes | 750 W | Esta fila no sirve para elegir una tarjeta independiente | ||
| NVIDIADGX B200Generación actual | Aceleradores integrados | Generación actual | Integrado | 8 GPU B200 integradas; 1,440 GB de memoria de GPU total | 10U · 897,1 mm | Placa integrada / interconexión dedicada | Sin tarjetas independientes | 1000 W | Esta fila no sirve para elegir una tarjeta independiente | ||
AMDHelion reference rackAnunciadoEn desarrollo; disponibilidad prevista para noviembre de 2026 | Diseño de referencia de rack | Anunciado | Integrado | CPU-only o EPYC / MI350P; sin número fijo de GPU | No anunciado | Placa integrada / interconexión dedicada | Sin tarjetas independientes | Requiere lista de componentes | Esta fila no sirve para elegir una tarjeta independiente |
La compatibilidad con generaciones PCIe anteriores no conserva la velocidad
Una tarjeta Gen4 funciona a Gen4 en una ranura Gen5. Una tarjeta Gen5 puede negociar Gen4, pero la tabla lo excluye por defecto para evitar aceptar un posible cuello de botella de ancho de banda.
La capacidad del chasis no autoriza la instalación
Ocho posiciones de doble ranura describen la disposición básica. La potencia de las tarjetas, su refrigeración activa o pasiva, la temperatura ambiente, el cableado y la QPL pueden reducir el número admitido.
Importan las referencias exactas del fabricante del servidor
El nombre del modelo de GPU no basta en un servidor empresarial: la tarjeta del mercado general puede diferir de la versión con referencia o código FRU del fabricante del servidor.
Más allá de la GPU: CPU, memoria, almacenamiento y red
Dimensionar el resto del servidor según la preparación de datos, el uso de memoria, el tráfico de almacenamiento y el patrón de comunicación de la aplicación.
Un servidor con varias GPU puede acelerar un trabajo paralelo o ejecutar varias tareas independientes a la vez. El segundo uso resulta valioso incluso cuando la aplicación no puede distribuir una tarea entre GPU: los usuarios pueden compartir chasis, alimentación y espacio de rack. En ambos casos, la plataforma anfitriona debe suministrar datos y servicios con suficiente rapidez para aprovechar los aceleradores.
Este artículo trata la CPU, la memoria del sistema, el almacenamiento y la red. Para instalar físicamente tarjetas concretas, consulte la guía de selección de servidores PCIe.
Capacidad y topología de CPU
Aunque las GPU realizan gran parte del cálculo en muchas cargas de IA, las CPU siguen preparando los datos, planificando las tareas y recogiendo los resultados. La tokenización, la decodificación, el aumento de datos y determinadas etapas de recuperación de información pueden consumir bastante tiempo de CPU. Algunas tareas que no necesitan GPU pueden ejecutarse en servidores convencionales, reservando los aceleradores para el trabajo que sí se beneficia de ellos.
No existe una marca de CPU ni una frecuencia mínima universal para un servidor de GPU. En una configuración con varios aceleradores, el número de líneas PCIe, la conexión de las ranuras a cada CPU, los canales de memoria y su ancho de banda pueden importar más que el número nominal de núcleos. El procesador también debe ser compatible con la configuración de chasis elegida.
La topología NUMA requiere especial atención en un servidor de dos zócalos. Una GPU, el proceso que carga sus datos y su tarjeta de red pueden estar conectados a CPU distintas. Los recorridos de tráfico resultantes afectan al rendimiento incluso cuando las especificaciones principales parecen suficientes. La topología propuesta debe evaluarse con la aplicación, sin tratar la CPU como una compra aislada.
Memoria del sistema
La RAM necesaria depende de cómo utiliza la aplicación el equipo anfitrión. Una carga de inferencia bien optimizada puede mantener el modelo y el conjunto activo de datos en la GPU y necesitar relativamente poca memoria del sistema. Los cargadores de datos, las cachés, el preprocesamiento, la descarga de trabajo a CPU y los usuarios concurrentes pueden cambiar mucho ese requisito.
Una proporción fija entre RAM del sistema y memoria total de las GPU es solo una aproximación de planificación. No sustituye a las mediciones. Son más útiles la cantidad de datos retenidos en memoria, el número de procesos de trabajo y el comportamiento de las asignaciones de memoria de la aplicación.
En un despliegue que examiné, un equipo utilizaba más de un terabyte de memoria del sistema y concluyó que debía ampliar el servidor. La depuración redujo la necesidad a unos 64 GB. Esto no es una recomendación de dimensionamiento para otras cargas: muestra cómo un fallo de software puede parecer una falta de hardware. Conviene analizar el uso de memoria antes de convertir cada agotamiento de RAM en una solicitud de compra.
Tres funciones del almacenamiento
Separar tres funciones ayuda a diseñar el almacenamiento:
- Sistema operativo y herramientas esenciales. Dimensionar estos discos para el sistema operativo, los controladores y el software de gestión. Utilizar dispositivos fiables y definir el procedimiento de recuperación. La duplicación en espejo puede mejorar la disponibilidad, pero el diseño adecuado depende de cuánto tiempo puede tardar la máquina en volver al servicio.
- Contenedores, registros, cachés y espacio temporal. La capacidad y el rendimiento de entrada/salida dependen de la carga y de su patrón de lectura y escritura. Hay que elegir la disposición de unidades y el esquema RAID considerando la tolerancia a fallos y el tiempo de reconstrucción; ni un número fijo de discos ni un nivel concreto de RAID constituyen una configuración universal para IA.
- Modelos, conjuntos de datos y puntos de control. Pueden ser locales o compartidos. La capacidad se calcula a partir del volumen de datos, su crecimiento, las versiones conservadas y la política de retención. Los datos o puntos de control que no se pueden reproducir necesitan redundancia adecuada y una copia de seguridad independiente.
El almacenamiento compartido también impone requisitos a la red. Un SSD local de gran capacidad no resuelve un cuello de botella provocado por leer repetidamente datos de entrenamiento desde un servicio compartido saturado. Hay que medir el recorrido completo durante el arranque, la ejecución sostenida y la escritura de puntos de control.
Separar las funciones de la red
Los trabajos independientes pueden exigir poco a la red de cómputo, aunque el acceso a datos siga siendo intenso. En una tarea distribuida entre varios servidores, la red pasa a formar parte del propio cálculo.
Al diseñar el sistema conviene distinguir tres funciones:
- Gestión fuera de banda. Separar el acceso de gestión del tráfico de las aplicaciones, con una red dedicada cuando lo exija el modelo operativo. Dimensionarla para las herramientas de administración y los procedimientos de recuperación.
- Acceso de usuarios y servicios. Diseñarlo según las transferencias de datos, la política de seguridad y la ubicación de clientes y conjuntos de datos. No tiene por qué compartir la red de gestión ni la de cómputo.
- Comunicación entre nodos de cómputo. Fijar objetivos de ancho de banda y latencia según la estrategia de paralelismo, el número de GPU, las operaciones colectivas y el uso de RDMA o GPUDirect. Una velocidad Ethernet conocida no basta para determinar su idoneidad.
La documentación de NCCL de NVIDIA describe la comunicación entre GPU dentro de un nodo y entre nodos mediante PCIe, NVLink, InfiniBand y redes IP. Que una biblioteca pueda utilizar esos transportes no demuestra cuánto escalará una aplicación concreta. Hay que probar el código y la configuración previstos.
En los sistemas HGX/DGX H100 y H200, NVSwitch conecta las GPU dentro del servidor. No sustituye a la red entre servidores. La arquitectura de referencia DGX SuperPOD especifica por separado los nodos de cómputo, las redes, la gestión y el almacenamiento. Por ello, el ancho de banda interno de NVLink nunca debe figurar en una solicitud de compra como si fuera el disponible entre dos servidores.
Una plataforma equilibrada es aquella cuyos componentes sostienen juntos la carga prevista. Conviene comenzar con una ejecución representativa, identificar dónde esperan las GPU y dimensionar la CPU, la memoria, el almacenamiento y la red para reducir esas esperas. El artículo sobre selección de GPU aplica el mismo razonamiento al acelerador.
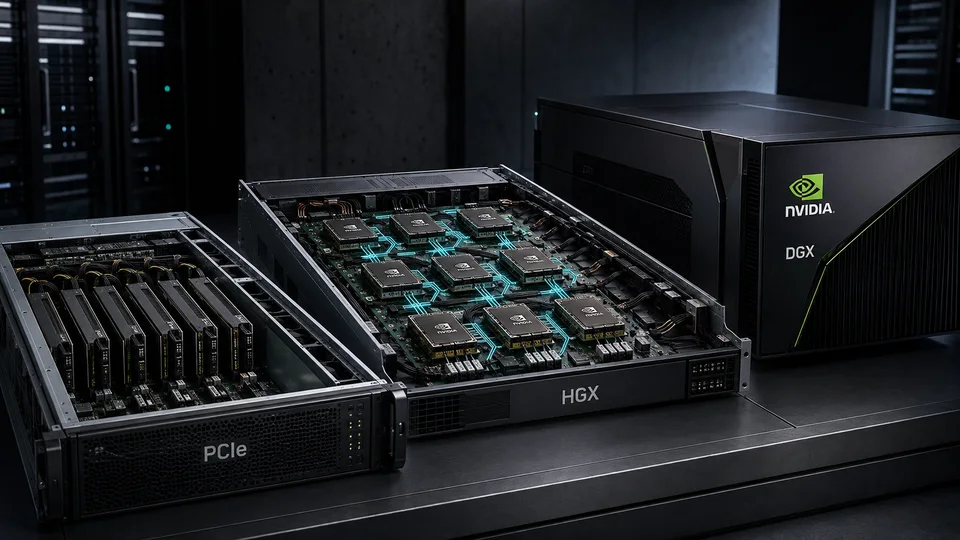
¿DGX, HGX o un servidor de GPU PCIe?
Distinguir la necesidad de una interconexión rápida entre GPU del valor de un sistema integrado, su software y su contrato de soporte.
A veces se utiliza DGX como si fuera el nombre técnico de cualquier servidor potente con GPU. Esa confusión puede convertirse en un error de compra costoso. El comprador puede esperar una capacidad de cálculo de otra categoría, cuando buena parte de esa capacidad procede de una plataforma HGX que también está disponible en servidores de otros fabricantes. El valor adicional de DGX está en el producto completo: integración, software, validación y servicios.
La distinción resulta especialmente útil para equipos que sirven modelos de pesos abiertos, construyen sistemas de generación aumentada por recuperación o amplían su capacidad gradualmente. Deben determinar tanto si necesitan una plataforma con varias GPU estrechamente conectadas como si pueden aprovechar los servicios que se venden con ella.
Precisar qué incluye la oferta
| Opción | Qué es | Valor principal |
|---|---|---|
| DGX | Un sistema completo de marca NVIDIA con hardware, DGX OS, firmware, herramientas de gestión y soporte integrado | Una configuración validada y un modelo coordinado de operación y soporte |
| HGX | Una plataforma de cómputo con varias GPU integrada en un servidor de otro fabricante; en los ejemplos H100/H200 de este artículo, GPU SXM, placa base, NVLink y NVSwitch | Comunicación rápida entre GPU para trabajos repartidos entre varios aceleradores |
| Servidor de GPU PCIe | Un chasis de servidor equipado con tarjetas de expansión PCIe | Flexibilidad en el número y tipo de tarjetas, con opciones de crecimiento gradual |
La guía de usuario DGX H100/H200 describe un sistema de ocho GPU con CPU, memoria, almacenamiento, red y cuatro NVSwitch. Un servidor de otro fabricante basado en la plataforma HGX equivalente de ocho GPU puede ofrecer la misma clase de interconexión interna. Hay que comparar configuraciones completas, pero el nombre DGX no permite tratarlo como un HGX más rápido.
Parte de lo que se adquiere con DGX es una lista de componentes probada, firmware, diagnósticos, supervisión y un proceso definido de instalación y soporte. Los recursos de software DGX describen DGX OS como una distribución Ubuntu personalizada y explican que también se pueden instalar componentes del entorno de software sobre sistemas Ubuntu o Red Hat estándar. La justificación económica de DGX depende del valor de esa combinación probada y respaldada.
Un catálogo de modelos no basta para justificar el sistema
A veces se propone el acceso a modelos y herramientas de NVIDIA como motivo para comprar DGX. Ese argumento mezcla productos y derechos de uso distintos. El catálogo público NGC incluye contenedores, modelos, SDK y otros recursos. NVIDIA AI Enterprise añade una oferta comercial de software y soporte cuyas condiciones de licencia deben evaluarse por separado.
La guía de licencias de NVIDIA enumera suscripciones de cinco años a AI Enterprise con las GPU H100 PCIe, H100 NVL y H200 NVL. Siguen siendo relevantes la activación y las condiciones aplicables a la GPU y al sistema certificado. Esto no significa que cualquier producto llamado H100 o H200 dé acceso ilimitado a todos los modelos, ni que DGX sea la única vía para obtener una suscripción incluida. La oferta debe confirmar la referencia exacta, los derechos de uso, la fecha de inicio y la elegibilidad para soporte.
Un equipo que trabaja con modelos de pesos abiertos como Llama, Qwen o Mistral quizá ya pueda obtener el modelo en un repositorio público bajo su propia licencia. Un contenedor optimizado o un motor de ejecución con soporte puede reducir el trabajo de instalación y mantenimiento, pero poseer un DGX no es un requisito general para acceder a esos pesos.
La pregunta útil es concreta: ¿qué componente de la oferta comercial de software y soporte reducirá el coste operativo, el tiempo de despliegue o el riesgo del servicio de este equipo? Una lista extensa de productos no lo demuestra. Si el servicio ya utiliza un motor de código abierto y herramientas internas, la sustitución propuesta necesita un beneficio verificable.
La disponibilidad de los servicios forma parte de la misma evaluación. Los requisitos de registro, la cobertura del soporte, el acceso a actualizaciones y el procedimiento práctico de devolución del hardware pueden variar según el proveedor y el despliegue. Un servicio que no se puede activar o utilizar aporta poco valor operativo. Incluso cuando todos los servicios están disponibles, pagar por uno que el equipo no necesita requiere justificación.
HGX también necesita una carga de trabajo que lo justifique
Elegir un sistema HGX de otro fabricante en lugar de DGX no hace automáticamente adecuada la inversión. Su principal ventaja de hardware es la interconexión de gran ancho de banda dentro del servidor. Resulta útil cuando un modelo o un trabajo de entrenamiento se reparte entre GPU y las operaciones colectivas mueven cantidades importantes de datos.
Ocho tareas independientes, cada una en una GPU, pueden aprovechar poco NVSwitch. De igual modo, servir un modelo que cabe holgadamente en una o dos GPU quizá no se beneficie lo suficiente de una interconexión de ocho aceleradores para justificar su coste adicional. El resultado depende del tamaño del modelo, la concurrencia, la latencia exigida y el motor de ejecución, además del tipo de aplicación.
Entornos como PyTorch y vLLM, y bibliotecas de comunicación como NCCL, ofrecen mecanismos de ejecución con varias GPU. Escalar de forma rentable sigue requiriendo una estrategia de paralelismo adecuada, configuración de lotes, asignación de GPU y mediciones. Que el programa arranque en ocho GPU aporta menos evidencia que una mejora útil del coste por trabajo completado o solicitud atendida.
Cruzar el límite entre servidores añade otra capa. En las configuraciones H100/H200 de este artículo, NVSwitch proporciona la interconexión interna. La ejecución multinodo también necesita tarjetas de red adecuadas, una red de cómputo, almacenamiento y ajuste del software. La arquitectura de referencia DGX SuperPOD trata estos elementos como partes diferenciadas del despliegue. El entrenamiento distribuido a gran escala y algunas cargas de HPC pueden justificar la inversión; instalar los cables y conmutadores necesarios no hará que las tareas independientes escalen entre nodos.
Elegir en dos etapas
Para inferencia, desarrollo, RAG y ajuste fino limitado, un servidor PCIe ampliable suele ser una buena configuración de partida para las pruebas. Conviene evaluar HGX cuando el trabajo real necesita los recursos combinados de varias GPU y la comunicación entre ellas afecta de forma importante al tiempo de ejecución. Hay que medir las configuraciones propuestas, incluida la eficiencia al pasar de dos GPU a cuatro y ocho.
Después se evalúa por separado la oferta del sistema completo. Se compara DGX con alternativas de otros fabricantes que dispongan de soporte, considerando instalación, mantenimiento, derechos de software, cobertura del soporte y diferencia de precio. La guía de la plataforma anfitriona trata los requisitos de CPU, almacenamiento y red que deben figurar en ambas ofertas.
La compra se justifica cuando la carga aprovecha el hardware y el equipo de operación utiliza los servicios. Comprobar ambas partes por separado permite defender mejor la decisión que elegir primero una gama de producto y buscar después una razón para comprarla.
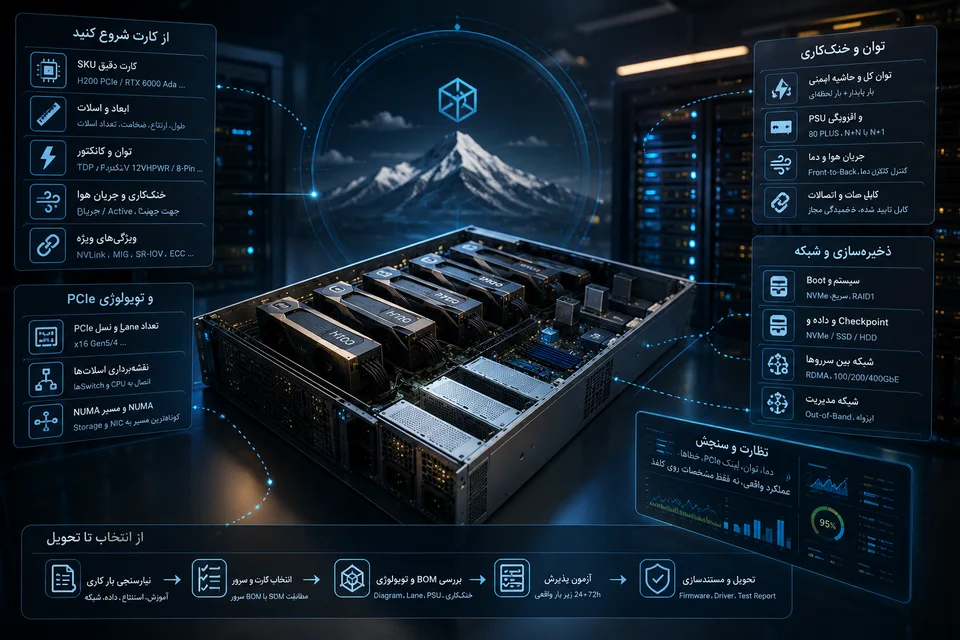
Elegir un servidor para GPU PCIe: espacio, topología, alimentación y refrigeración
Comprobar la GPU y la configuración exactas del servidor, y verificar el rendimiento sostenido antes de aceptar el sistema.
La expresión «servidor para ocho GPU» es un punto de partida para consultar al proveedor, no una declaración de compatibilidad. Esa cifra puede ser válida únicamente para determinadas tarjetas, límites de potencia, tarjetas elevadoras y kits de refrigeración. Una compra adecuada especifica la lista exacta de componentes del servidor y los números de pieza de las GPU que funcionarán juntas.
Identificar la tarjeta antes de elegir el chasis
Los nombres de familia ocultan diferencias importantes. H100 PCIe, H100 NVL y H100 SXM no son intercambiables. Las tarjetas de consumo basadas en una misma GPU también pueden variar en longitud, anchura, disipador y posición de los conectores. Estas diferencias determinan si caben, si dejan utilizables las ranuras adyacentes y si el servidor puede evacuar su calor.
Las tarjetas pasivas dependen del servidor para forzar aire a través de sus disipadores. Muchas tarjetas de consumo usan refrigeración abierta, diseñada para mover aire dentro de una caja de sobremesa. Tener ventilador propio no hace automáticamente adecuada una tarjeta para un chasis de rack muy denso. Hay que comprobar el recorrido del aire, las condiciones de entrada, el espacio alrededor de los conectores y el necesario para colocar los cables de forma segura.
Una tarjeta que ocupa tres o cuatro ranuras puede bloquear tanto otra posición de GPU como una tarjeta de red esencial. La guía de tipos de GPU explica las categorías generales, pero la compatibilidad física siempre depende del número de pieza real.
Leer la topología PCIe
Los dispositivos PCIe suelen poder negociar una generación de enlace compatible con ambos extremos, pero eso no implica que el fabricante haya validado la tarjeta en ese servidor. Una ranura físicamente x16 también puede tener menos líneas eléctricas, o estar disponible únicamente con determinada CPU o tarjeta elevadora instalada.
Hay que preguntar cómo se conecta cada GPU a las CPU y si comparte un enlace ascendente mediante un conmutador PCIe. En un servidor de dos zócalos, debe registrarse a qué CPU pertenece cada GPU y cada tarjeta de red. Esto importa cuando la aplicación transfiere datos entre GPU, descarga trabajo a CPU o utiliza recorridos de almacenamiento y red que dependen del tráfico PCIe.
Los diagramas de bloques del fabricante describen la topología prevista. En un sistema NVIDIA configurado, nvidia-smi topo -m ayuda a inspeccionar las relaciones visibles entre dispositivos. Conviene comparar esa salida con el diseño propuesto y probar las transferencias que realmente hace la aplicación. La comparación PCIe/SXM explica cuándo aporta valor una interconexión de GPU más rápida.
Dimensionar la alimentación para el funcionamiento completo
Sumar las potencias nominales de las GPU no basta para dimensionar un servidor. Las CPU, la memoria, los discos, las tarjetas de red y los ventiladores también consumen energía. Deben incluirse los límites de funcionamiento previstos, la demanda transitoria, la eficiencia de las fuentes y la política de redundancia.
Una configuración anunciada con fuentes redundantes puede no conservar toda la capacidad de cálculo si falla una fuente o una entrada de alimentación. Hay que preguntar si la configuración ofertada mantiene la carga exigida en la condición de fallo especificada o si debe reducir la potencia de las GPU. La instalación eléctrica del rack debe sostener las mismas hipótesis.
Los cables de alimentación y los kits de habilitación de GPU forman parte de la configuración. Sus conectores, capacidades y recorridos deben aparecer en la lista de materiales. Son componentes necesarios del sistema, no accesorios que resolver cuando lleguen las tarjetas.
La refrigeración debe funcionar bajo carga sostenida
Hay que comprobar el kit de refrigeración admitido por el fabricante, los límites de temperatura ambiente y las reglas de ocupación de tarjetas. Una configuración puede admitir una GPU únicamente por debajo de cierta temperatura de entrada, o con una disposición concreta de ventiladores, disipadores y paneles de cierre.
La refrigeración líquida añade trabajo de integración: distribución de refrigerante o radiadores, bombas, mantenimiento y gestión de fallos. Refrigerar el encapsulado de la GPU no elimina la necesidad de refrigerar la memoria, los reguladores de tensión y los demás componentes. La solución elegida debe cubrir el sistema completo.
Las pruebas de aceptación deben demostrar que el servidor mantiene la carga prevista sin reducciones inaceptables de rendimiento por temperatura o potencia. Una demostración breve que carga el modelo y produce una respuesta no acredita un funcionamiento estable en producción.
Proporcionar los recursos anfitriones que utiliza la aplicación
No hay una proporción fija de núcleos de CPU o RAM por GPU adecuada para todas las cargas. La tokenización, la decodificación de imágenes, el aumento de datos, la recuperación, las cachés y la descarga de trabajo a CPU pueden cambiar esos requisitos. Conviene comenzar con una ejecución representativa y medir los recursos utilizados por el número previsto de trabajos concurrentes.
El almacenamiento necesita una distinción similar entre sistema operativo, espacio temporal local y conjuntos de datos o puntos de control persistentes. La red debe soportar después el movimiento real de esos datos. Elegir por costumbre una red de 10, 100 o 400 Gb/s deja sin responder la pregunta principal: qué tráfico debe atravesarla y en qué momento. La ejecución distribuida también puede exigir una configuración RDMA adecuada y una sobresuscripción de red aceptable. La guía de la plataforma de servidor desarrolla estos componentes.
Usar las tablas para seleccionar candidatos
El número máximo de GPU anunciado por un fabricante o una tabla comparativa pueden reducir las alternativas. Ninguno certifica la configuración final. Programas como NVIDIA-Certified Systems son referencias útiles, pero la combinación admitida puede depender de la CPU, el firmware, las tarjetas elevadoras, los puentes de GPU, los adaptadores de almacenamiento, las fuentes y los kits de refrigeración.
| Antes de hacer el pedido | Evidencia que debe solicitarse |
|---|---|
| Configuración exacta del hardware | Referencias del servidor y de las GPU, kits, cables, tarjetas elevadoras y disposición de fuentes |
| Compatibilidad oficial | Configuración admitida por el fabricante o confirmación escrita que cubra la lista propuesta de componentes |
| Topología de dispositivos | Diagrama CPU/GPU/red, número de líneas PCIe y enlaces ascendentes compartidos de los conmutadores |
| Software y firmware | Versiones propuestas de BIOS, BMC, controlador de GPU y motor de ejecución |
| Funcionamiento sostenido | Límites de potencia, condiciones de entrada de aire y carga de aceptación previstos |
| Ampliación futura | Piezas adicionales y reglas de ocupación admitidas para la ampliación prevista |
El mismo criterio debe aplicarse al comparar DGX, HGX y sistemas PCIe convencionales. Una familia de productos no constituye una lista completa de componentes.
Acordar las pruebas de aceptación antes de la entrega
Una prueba práctica de aceptación puede durar entre 24 y 72 horas, según el despliegue y el acuerdo de soporte. Debe utilizar la aplicación real junto con comprobaciones específicas del hardware. Conviene registrar temperatura, comportamiento de las frecuencias, límites de potencia, enlaces PCIe negociados y errores PCIe AER, NVIDIA Xid o ECC pertinentes. Si la carga abarca varias GPU, la prueba debe incluir su patrón de comunicación y sus operaciones colectivas.
Si el sistema está diseñado para mantener el servicio tras el fallo de una fuente o alimentación, debe incluirse una prueba controlada de esa situación conforme al procedimiento operativo acordado. Hay que verificar que el rendimiento útil y el comportamiento eléctrico coinciden con lo prometido en la oferta.
Los criterios de aceptación deben definirse antes de la entrega. El resultado relevante es una configuración estable, con soporte, que cumpla los objetivos de la carga. Ese acuerdo deja explícita la responsabilidad de integración y evita descubrir después de la instalación que un conjunto de piezas nominalmente compatibles todavía necesita mucho trabajo de ingeniería.