La rápida adopción de la IA ha incorporado datos sensibles, propiedad intelectual valiosa y decisiones de importancia a sistemas difíciles de proteger únicamente mediante defensas perimetrales. Un servicio de IA rara vez consiste solo en un modelo detrás de una API. Incluye preparación de datos, código de entrenamiento, dependencias externas, artefactos del modelo, infraestructura de despliegue y personas con distintos tipos de acceso.
Los diseños de seguridad tradicionales solían considerar la red interna un espacio relativamente fiable. Esa suposición resulta especialmente débil en los flujos de trabajo distribuidos de IA. Además de las amenazas habituales de ciberseguridad, estos sistemas se enfrentan al envenenamiento de datos, la inversión de modelos y las entradas adversarias. Un atacante puede alterar una decisión sin tomar el control de un servidor, o extraer información mediante una interfaz del modelo que, por lo demás, es legítima.
En esta colección, IA de confianza cero (Zero Trust AI, ZTAI) significa aplicar los principios de confianza cero a los problemas de ingeniería específicos de la IA. Es el enfoque arquitectónico desarrollado aquí, no el nombre de una norma de seguridad independiente y aprobada. Su alcance abarca los procesos de datos, el ciclo de vida del modelo y las operaciones, además de las identidades y el acceso.
Por qué la seguridad perimetral resultó insuficiente
Las arquitecturas de red anteriores dividían habitualmente el entorno en un interior fiable y un exterior no fiable. Las redes aisladas y los controles en sus puntos de entrada y salida constituían la principal frontera defensiva. Los cortafuegos de aplicaciones web, los sistemas de detección y prevención de intrusiones y las herramientas de prevención de pérdida de datos añadían otras capas.
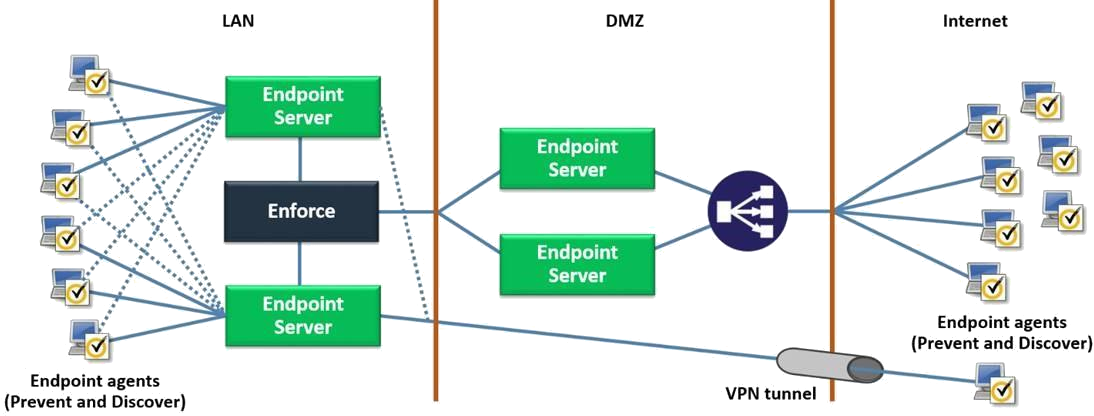
Estas capas no eliminaron las filtraciones ni los servidores comprometidos. Un empleado podía divulgar datos y una conexión aparentemente legítima podía transportar un ataque. La infraestructura en la nube, el trabajo remoto y los dispositivos personales también hicieron cada vez menos fiable la distinción entre dentro y fuera.
John Kindervag presentó el modelo de confianza cero en Forrester en 2010. Su fórmula más conocida es «nunca confiar, verificar siempre»: un usuario, dispositivo o aplicación no debe recibir acceso por el mero hecho de estar dentro de la red de una organización. Hay que establecer su identidad, autorizar la acción solicitada y limitar el acceso a lo que necesita la tarea. La autenticación inicia esa decisión; no concede permiso para utilizar todos los recursos.
La identidad robusta, el mínimo privilegio, la segmentación, la evaluación del estado de los dispositivos y la supervisión continua sostienen este enfoque. Las decisiones deben tener en cuenta los cambios del usuario, el dispositivo, la carga de trabajo y las condiciones operativas durante toda la sesión.
La arquitectura de NIST separa la decisión de política de su aplicación. Un motor de políticas evalúa el acceso; un administrador de políticas establece o termina la comunicación; y un punto de aplicación de políticas hace efectiva la decisión. La información de identidad, el estado de los activos, la inteligencia de amenazas, las políticas de acceso y los registros de actividad alimentan el proceso.
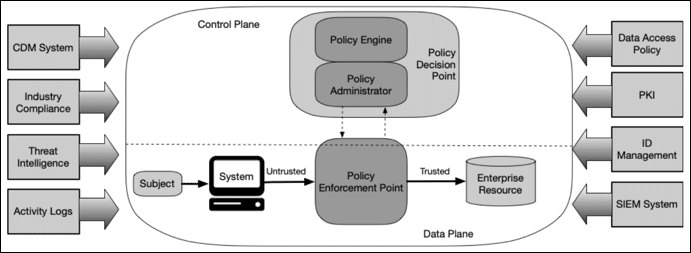
NIST ya incluye recursos, servicios y flujos de trabajo dentro de la confianza cero. La discusión específica sobre IA concreta los controles para el ciclo de vida de un modelo; no implica que la confianza cero se limitara originalmente a proteger el tráfico de red.
Qué cambia con la IA
La primera diferencia es el flujo de trabajo. Desarrollar y operar un servicio de aprendizaje automático implica varios equipos, marcos y tecnologías. Una debilidad puede entrar a través de un conjunto de datos, un cuaderno de trabajo, una dependencia de entrenamiento, un registro de modelos o una configuración de inferencia. Proteger el punto de acceso de la aplicación deja gran parte de esa cadena sin abordar.
La segunda diferencia son los datos. Un modelo puede consumir grandes cantidades de información sensible durante la recopilación, el preprocesamiento, el entrenamiento y la inferencia. La protección debe continuar mientras esa información se transforma. Un conjunto procesado, un índice de representaciones vectoriales o un modelo entrenado no se vuelve automáticamente apto para compartir porque ya no se parezca a los registros originales.
La integración del desarrollo de IA con la ingeniería de software y DevSecOps también es desigual. Los proyectos externalizados pueden dejar vacíos en las responsabilidades de propiedad, revisión y publicación. Los paquetes de código abierto son esenciales, pero su rápida evolución dificulta el seguimiento del riesgo de las dependencias. Las herramientas de seguridad concebidas para aplicaciones convencionales pueden no inspeccionar adecuadamente los artefactos del modelo o las transformaciones de datos.
Un modelo no es un artefacto de software corriente. Los equipos necesitan saber cómo se produjo, cómo se carga y qué capacidades de ejecución requieren su formato y sus dependencias. Un equipo de operaciones que desconozca esa cadena puede introducir vulnerabilidades mediante decisiones de despliegue aparentemente rutinarias.
Por último, el comportamiento del modelo depende de los datos y suele ser probabilístico. Una compilación correcta y un solicitante autenticado no demuestran que una respuesta sea correcta, adecuada o esté libre de información confidencial. Son propiedades adicionales que necesitan sus propias pruebas.
Amenazas específicas de la IA
El envenenamiento de datos manipula los datos usados para entrenar o actualizar un modelo, alterando su comportamiento o introduciendo un fallo dirigido. La inversión de modelos intenta inferir información sensible sobre los datos subyacentes a partir del comportamiento o las respuestas del modelo. Lo que se recupera depende del ataque y del modelo; no debe suponerse que permite reproducir todos los registros de entrenamiento.
El robo de modelos incluye la adquisición o reproducción no autorizada de un modelo entrenado. Los ejemplos adversarios son entradas construidas para engañarlo, a veces mediante cambios difíciles de percibir para una persona.
Una actualización envenenada puede introducir código malicioso o modificar el comportamiento mediante una vía de actualización comprometida. La filtración de información ocurre cuando una respuesta revela información sensible de la entrada o del entrenamiento. Estos riesgos convierten la integridad de los datos, modelos y procesos en una preocupación continua, no en una comprobación única al admitir una conexión.
Aplicar confianza cero al ciclo de vida de la IA
| Área | Cuestión general de confianza cero | Aplicación específica a la IA en esta colección |
|---|---|---|
| Principio central | No conceder confianza implícita por ubicación o propiedad | No suponer que los datos, modelos o resultados son fiables porque proceden de un proceso interno |
| Recursos protegidos | Activos, servicios, identidades y flujos de trabajo | Conjuntos de datos, trabajos de entrenamiento, artefactos, almacenes de recuperación y servicios de inferencia |
| Autorización | Conceder a una identidad verificada solo el acceso necesario | Vincular cada trabajo a datos, operación, entorno de ejecución y destino de salida aprobados |
| Supuestos de confianza | Reevaluar el acceso cuando cambia el contexto | Reevaluar cambios en datos, dependencias, modelos y condiciones de despliegue |
| Controles de apoyo | Identidad, segmentación, mínimo privilegio y supervisión | Añadir procedencia de datos, integridad del modelo, evaluación adversaria y revisión de resultados según el riesgo |
| Amenazas | Acceso no autorizado, movimiento lateral y abuso interno | Considerar también envenenamiento, extracción, entradas adversarias, actualizaciones inseguras, divulgación y uso de IA no aprobado |
| Ciclo operativo | Aplicar la política al recurso y a su uso | Integrar controles en recopilación, entrenamiento, evaluación, despliegue, supervisión y reentrenamiento |
La cuestión práctica no es solo quién puede consultar un modelo. También importa quién puede cambiar el procesamiento, qué información puede utilizar y qué pueden revelar sus resultados. MLOps como base de la IA de confianza cero explica cómo un ciclo de vida trazable permite implantar estos controles. La secuencia completa está en la colección técnica de ZTAI.