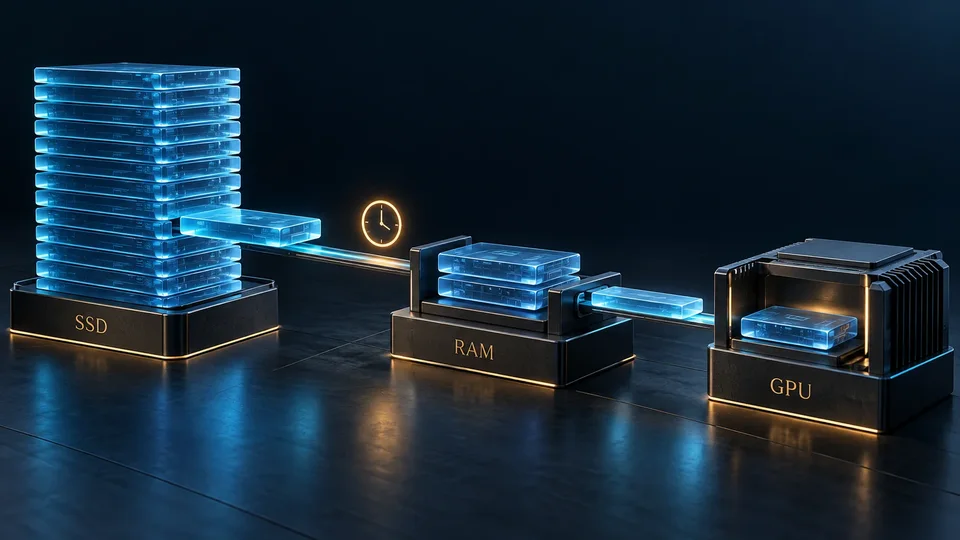
Ejecutar un modelo de 70 mil millones de parámetros en una GPU con pocos GiB parece eliminar un gran gasto de infraestructura. AirLLM permite estudiar esa posibilidad, pero la distinción decisiva es entre ejecutar el modelo y terminar trabajo útil a tiempo. Los pesos no desaparecen: gran parte de su almacenamiento sale de la GPU y la ejecución debe recuperar los datos necesarios.
Puede ser valioso para investigación, uso ocasional del equipo disponible o tareas con un plazo flexible. En un asistente interactivo, las transferencias y la capacidad perdida pueden costar más que la memoria ahorrada. Conviene comparar ejecución por capas con un modelo menor residente, cuantización, ejecución mixta CPU/GPU y reparto entre tarjetas. La guía de modelos de lenguaje los presenta como estrategias diferentes.
Cómo pasa un modelo grande por una GPU pequeña
En inferencia residente, los pesos permanecen en VRAM y se reutilizan al procesar la entrada y generar texto. En ejecución por capas se carga la parte necesaria, se calcula y se libera antes de continuar. La idea, descrita también en ZeRO-Inference, intercambia residencia en GPU por capacidad de RAM o almacenamiento y movimiento de datos.
La implementación de AirLLM revisada organiza carga y liberación alrededor de la ejecución de módulos, mientras Transformers dirige la generación. Algunos módulos pueden permanecer residentes. Por eso el máximo de VRAM incluye más que una capa abstracta: estado intermedio, espacio de trabajo y política de caché también cuentan.
El ejemplo destacado del proyecto, un modelo de 70B con unos 4 GB de VRAM, describe una posibilidad con poca residencia simultánea. No es una especificación completa de servicio. Arquitectura, longitudes de entrada y salida, caché y representación de pesos pueden cambiar la necesidad.
La memoria se desplaza a otro lugar
Un modelo hipotético con exactamente 70 mil millones de pesos de dieciséis bits necesita 140 GB, unos 130,4 GiB, solo para pesos sin sobrecarga. Si todos deben estar preparados en RAM, 128 GiB no bastan incluso antes del sistema operativo y la aplicación. Una ruta apoyada en disco puede usar menos RAM, pero entonces las lecturas repetidas forman parte del procesamiento.
La capacidad SSD puede superar la descarga original. Conservar pesos originales y archivos por capas preparados puede acercarse al doble si se crea una segunda copia completa. No es un multiplicador universal: compresión, enlaces y reutilización modifican el resultado. El código de preparación de AirLLM contiene rutas de enlace o copia y una opción para borrar originales después de convertir. Hay que prever el máximo durante la preparación además del tamaño final.
En VRAM siguen debiendo caber la parte activa mayor, datos intermedios, KV y espacio de cálculo. Rendimiento del SSD, ancho de banda de RAM y transferencia al dispositivo pueden dominar. Una GPU más rápida ayuda poco si espera los pesos; por eso los componentes de la plataforma de servidor influyen directamente.
«Mayor que la VRAM» incluye métodos distintos
A veces offload significa conservar pesos en el lado del host y moverlos a la GPU para calcular. En otros sistemas parte del cálculo se realiza realmente en CPU. La diferencia cambia el cuello de botella.
| Método | Ubicación y cálculo | Recurso principal que revisar |
|---|---|---|
| Modelo residente en una GPU | Pesos y cálculo permanecen en VRAM | Capacidad, ancho de banda y margen para peticiones |
| Ejecución por capas con AirLLM | Las partes llegan desde RAM o almacenamiento cuando hacen falta | Transferencias repetidas, carga y descompresión opcional |
| Offload CPU/disco con Accelerate | Los pesos del módulo pasan al dispositivo de ejecución | Política de ubicación, transferencias y RAM |
| Ejecución mixta de llama.cpp | Algunas capas pueden calcularse en CPU y otras en GPU | Cómputo y ancho de banda de RAM, más comunicación entre partes |
| Modelo repartido entre GPU | Las particiones residentes no exigen releer disco | Capacidad por tarjeta, interconexión y paralelismo |
La distinción procede de la documentación de offload de Accelerate, las opciones de llama.cpp y la guía de paralelismo de vLLM. No es una clasificación de velocidad. Un modelo que supera ligeramente la VRAM plantea otro problema que uno varias veces mayor.
¿Cuántas veces deben viajar los pesos?
La generación autorregresiva habitual produce un token nuevo por secuencia en cada paso. Si un modelo denso descarta los pesos de las capas después de usarlos, el siguiente paso vuelve a necesitarlos. La caché KV conserva cálculos del contexto; no reemplaza los pesos de la red. Una respuesta larga puede hacer pasar repetidamente un volumen considerable por la conexión.
Veamos un cálculo educativo de transferencia, no un benchmark de AirLLM. Supongamos que los 140 GB completos de pesos densos sin comprimir viajan del host a la GPU en cada paso de generación para una secuencia, a 20 GB/s efectivos. En los dos primeros casos también se releen físicamente desde SSD; en el tercero están disponibles en RAM. Los anchos de banda son entradas explícitas del ejemplo, no especificaciones de un dispositivo identificado.
| Ubicación de pesos | Lectura SSD por paso | Transferencia host–GPU por paso | Límite inferior optimista con solapamiento completo |
|---|---|---|---|
| Relectura completa desde SSD a 3,5 GB/s | 40 s | 7 s | Al menos 40 s |
| Relectura completa desde SSD a 7 GB/s | 20 s | 7 s | Al menos 20 s |
| Preparados en RAM, sin relectura física SSD | 0 s | 7 s | Al menos 7 s |
Cada tiempo sale de dividir volumen entre ancho de banda efectivo. Con solapamiento perfecto, el proceso no puede ser más rápido que la etapa más lenta; por eso la última columna no suma las anteriores. Solapamiento incompleto, arranque y final del recorrido, cálculo y transferencia de caché añaden tiempo. Pesos residentes, lotes, compresión o carga selectiva de expertos cambian el volumen e impiden aplicar literalmente el ejemplo.
El mismo cálculo da un límite práctico. Si el objetivo hipotético fuera un máximo de 0,2 segundos entre tokens, una ruta de 20 GB/s solo podría transportar 4 GB durante ese intervalo, antes de cualquier otro trabajo. Un volumen mucho mayor obliga a transferir menos, reutilizar más o cambiar el objetivo de latencia. Más capacidad aritmética no elimina ese límite.
Entrada, longitud de salida y lotes producen efectos diferentes
En prefill, varios tokens de entrada pueden aprovechar una capa en una pasada. En decode habitual, la salida depende de pasos sucesivos. Más trabajo por transferencia puede mejorar el rendimiento agregado mientras cada petición sigue esperando mucho.
FlexGen ilustra esa diferencia con OPT-175B y compresión de cuatro bits: una configuración publicada utiliza T4 de 16 GB, 208 GB de RAM y SSD de 1,5 TB, con 512 tokens de entrada y 32 de salida. Informa de 1,122 tokens/s agregados, lote efectivo 144 y 4.072 segundos de latencia. En esa ejecución comprimida los pesos ya no necesitaban offload a disco. No es una velocidad por usuario ni una medición de AirLLM.
KV sigue siendo otro presupuesto. La configuración de Qwen2.5-72B-Instruct especifica 80 capas, 8 cabezas KV y dimensión 128 por cabeza. Con KV de dieciséis bits, atención completa y sin prefijos compartidos, los bytes sin sobrecarga son:
2 × 80 × 8 × 128 × 2 × tokens retenidos × secuencias activas
| Secuencias activas | Tokens retenidos por secuencia | KV de dieciséis bits sin sobrecarga |
|---|---|---|
| Una | 2.048 | 0,625 GiB |
| Una | 8.192 | 2,5 GiB |
| Una | 32.768 | 10 GiB |
| Cuatro | 8.192 cada una | 10 GiB |
Si la caché permanece en GPU se añade a los pesos activos y al espacio de trabajo. Una demostración corta con poca memoria no acredita RAG con documentos largos ni varias conversaciones. El offload de caché de Transformers puede mover ese estado en configuraciones compatibles, añadiendo otra corriente de transferencias. Modelo y motor deben admitir la implementación elegida.
Compresión y precarga no suman sus ventajas automáticamente
La precarga o prefetch prepara la siguiente capa mientras se calcula la actual. Reduce esperas cuando el cálculo puede cubrir suficiente tiempo de carga; una transferencia mucho más lenta sigue marcando el ritmo. Más RAM también puede mantener archivos en la caché del sistema operativo. Estar almacenado en SSD no implica leer físicamente el dispositivo en cada acceso. Conviene registrar ejecuciones en frío y en caliente por separado.
En la revisión estudiada de AirLLM, compression='4bit' utiliza NF4 para almacenar capas y reconstruye valores para calcular después de transferir datos comprimidos a CUDA. No transforma todas las operaciones en aritmética de cuatro bits. Esa revisión también desactiva la precarga general cuando hay compresión: no se pueden sumar ambas ventajas sin examinar la ruta real. El código de compresión y la implementación de carga fijan ese comportamiento.
Mover capas no obliga por sí mismo a borrar parámetros ni reducir precisión. Comprimir añade otra aproximación numérica. Dos rutas no tienen por qué generar salidas idénticas bit a bit; importa el éxito de la tarea, no reproducir exactamente la redacción. El artículo sobre cuatro bits separa tamaño, precisión de cálculo, KV y calidad.
Dónde puede resultar útil
El mejor caso aparece cuando el modelo mayor aporta calidad necesaria, la memoria impide acceder a él y esperar es aceptable. «Sin interacción» tampoco basta: una cola nocturna que no acaba antes de la mañana carece de capacidad para su plazo.
| Trabajo | Papel de la ejecución por capas | Comparación decisiva |
|---|---|---|
| Investigación limitada con un modelo grande | Acceso útil mediante el equipo disponible | Preparación y muestras frente a acceso temporal a más memoria |
| Extracción o generación de datos de poco volumen | Interesante si el modelo menor falla en calidad | Salidas aceptadas por hora y duración total |
| Procesamiento nocturno de documentos | Depende de lotes y tamaño de cola | Finalizar dentro de la ventana real |
| Conversación o RAG interactivo multiusuario | Punto de partida normalmente débil para un modelo denso enorme transferido por capas | Modelo menor residente, recuperación y latencia bajo demanda |
| Agente de código con llamadas sucesivas | Cada etapa acumula latencia de transferencia | Duración completa frente a un especialista residente |
| Experimentos con adaptadores en arquitecturas soportadas | Posibilidad de investigación con la implementación de entrenamiento | Tiempo por paso, calidad objetivo y coste de repetir |
En un asistente documental, mejorar recuperación o elegir un modelo menor más adecuado puede mejorar respuestas sin transferir uno enorme. Un modelo residente de 3B u 8B deja espacio para contexto y peticiones; réplicas en GPU separadas ofrecen otra vía de crecimiento. El artículo sobre tamaño de modelo y la comparación de RTX 4090 desarrollan esas alternativas.
Comprobar la ruta, no solo el nombre de familia
AirLLM, Ollama y vLLM no describen la misma capa del sistema. La técnica de memoria no aporta por sí sola todas las funciones de servicio: colas, límites de admisión, controles de contexto y gestión de carga siguen siendo necesarios. Añadir una API HTTP a un modelo transferido por capas no elimina su límite de transferencia. La tabla de programas distingue ejecución, servicio y gestión.
Deben identificarse checkpoint original, arquitectura, formato y versiones de dependencias. Que exista un GGUF no demuestra que ese archivo funcione en la ruta de AirLLM basada en checkpoints de Transformers y fragmentos por capa. Su selección de clases de modelo incluye rutas específicas de arquitectura. Anotar solo «Qwen» o «DeepSeek» no reproduce la configuración.
MoE añade otra diferencia. El código revisado tiene rutas de carga selectiva de expertos para arquitecturas admitidas. El número de parámetros activos no determina por sí solo los bytes transferidos: un lote puede seleccionar más expertos que un token y la reutilización de expertos residentes importa. El ejemplo denso de 140 GB no debe aplicarse indiscriminadamente a MoE. El total de pesos sigue determinando el almacenamiento completo.
¿También permite entrenar?
Describir la revisión estudiada como exclusivamente de inferencia omitiría su implementación LoRA. El código contiene rutas solo de texto para modelos VL densos Qwen3.5/Qwen3.8 y una ruta Qwen4Exp para Qwen3.8-Flash-Next. La parte visual permanece en meta: no se entrenan imágenes. Los pesos base congelados se cargan por capas; adaptadores y estado de su optimizador quedan en GPU, y la gestión de datos intermedios y el recálculo durante backward reducen residencia.
Es una capacidad del código de esa versión, no validación de todos los modelos admitidos para inferencia. Tampoco equivale a entrenar todos los pesos ni a preentrenar un modelo grande con una tarjeta diminuta. Transferencias repetidas, recálculo y muchos pasos pueden alargar considerablemente el proceso. Comparemos el coste de llegar a la calidad objetivo y repetir experimentos con el acceso temporal a un sistema de más memoria.
Medir el trabajo terminado
Hay que separar descarga y preparación de la ejecución habitual. Sirven entradas representativas, una cercana al contexto necesario y una cola pequeña pero realista. Se registran tiempo hasta el primer token, ritmo posterior, duración total y máximos de RAM y VRAM. La comparación en frío y en caliente revela cuánto depende el resultado de la caché del host.
Para servicio interactivo se incluyen demanda concurrente prevista, peticiones lentas y crecimiento de la cola. En trabajo sin interacción puede ser más claro el coste por mil salidas aceptadas: infraestructura, energía y operación divididas por trabajos útiles completados. Menor potencia instantánea no acredita menos energía por tarea cuando la ejecución dura mucho más.
AirLLM tiene un papel concreto cuando el modelo mayor aporta calidad, la VRAM impide usarlo y el plazo tolera las transferencias. La tabla de viabilidad de hardware ayuda a compararlo con más memoria, un modelo menor u otra ubicación de pesos, manteniendo la estimación de memoria separada de una medición de velocidad.