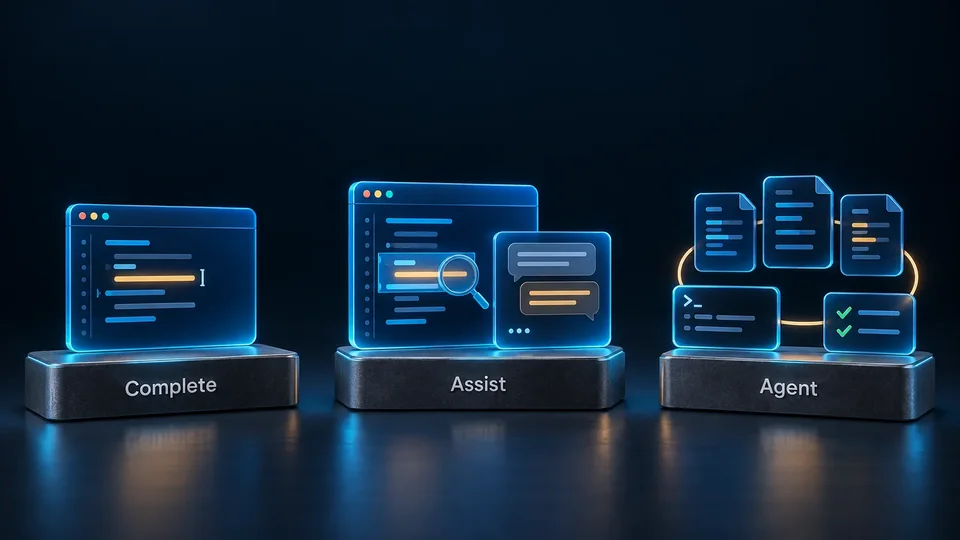
Un equipo puede decir «IA para programar» y referirse a tres peticiones: sugerir las próximas líneas mientras escribe, explicar y corregir una función, o resolver una incidencia buscando en el repositorio, editando y ejecutando pruebas. No necesitan el mismo modelo, memoria ni criterio de calidad. Elegir un modelo grande para todo puede aumentar latencia y coste sin un aumento equivalente del trabajo terminado.
Un especialista pequeño es un candidato serio para completar código y ayudar en cambios acotados. Al pasar a dependencias entre archivos, causas inciertas y uso repetido de herramientas, pesan más razonamiento y recuperación de errores. La guía de tamaño de modelo explica la lógica general; aquí cada función recibe criterios propios.
Tres funciones detrás de la misma ventana del editor
| Función | Petición de ejemplo | Salida esperada | Criterio principal |
|---|---|---|---|
| Autocompletado | Sugerir el resto de una expresión o función | Código breve compatible con lo que rodea al cursor | Tiempo hasta una sugerencia útil y código aceptado que permanece |
| Asistente | Explicar el fallo y corregir esta sección | Explicación correcta o cambio limitado bajo dirección humana | Corrección del cambio y reducción del tiempo de comprensión y revisión |
| Agente de programación | Localizar el problema, arreglarlo y ejecutar pruebas | Parche revisable tras búsqueda, edición y ejecución | Tareas aceptadas, duración y coste por éxito |
Son trabajos diferentes, no escalones de inferior a superior. Un agente de varios pasos sobra para completar una variable. Un modelo rápido de autocompletado no demuestra razonamiento sobre repositorios por haber escrito varias funciones correctas. Un producto puede usar modelos distintos para cada modo.
Consulte evidencia del flujo de programación previsto
La ficha de StarCoder2-3B publica pass@1 de 31,7 en HumanEval y 27,4 en HumanEval+. Mantenga este modelo base en la categoría de autocompletado; esas cifras no miden el éxito de un agente que modifica varios archivos ni la utilidad de una conversación. El distinto orden de Qwen en LiveCodeBench y Aider-Polyglot ilustra por qué no basta una sola clasificación de programación. Si cambian herramientas, intentos o entorno del agente, compartir el nombre del benchmark no basta para unir resultados.
¿Ejercicios de programación o edición de código?
Para un asistente que sigue instrucciones, separa edición de repositorios y ejercicios de programación. StarCoder2-3B sirve para autocompletado/FIM; HumanEval no mide conversación ni calidad de un agente editor.
Una vez definida la interfaz: autocompletado, cambios en varios archivos o resolución de un ejercicio.
Los parámetros activos de un MoE no determinan la memoria de todos sus pesos residentes.
La sugerencia debe llegar antes de que la persona continúe
Si aparece cuando el usuario ya ha escrito la expresión o cambiado de posición, pierde gran parte de su valor. Conviene medir desde la petición del editor hasta una sugerencia útil, incluyendo preparación del contexto, red, cola y generación. Las horas de carga y el percentil 95 revelan retrasos ocultos por una media de tokens por segundo.
Fill-in-the-middle, FIM, entrega el prefijo y el sufijo alrededor del punto de inserción con el formato específico del modelo. El cuerpo propuesto debe encajar con una firma y con el código posterior. Qwen2.5-Coder-1.5B documenta FIM para su checkpoint base y no lo recomienda como sustituto directo de chat. StarCoder2-3B también se entrenó para FIM, sin ajuste de seguimiento de instrucciones.
Una comparación inicial puede incluir especialistas de unos 1–3B y un candidato de 7B. Es una selección de partida, no garantía de rendimiento. La configuración de autocompletado de Continue ilustra la elección por función en lugar de reutilizar una única selección de chat.
La tasa de aceptación puede engañar: alguien acepta una sugerencia y borra casi todo inmediatamente. Conviene medir código retenido después de un intervalo definido, latencia y molestias. Cancelar solicitudes obsoletas al continuar escribiendo y limitar la longitud forman parte del producto; un checkpoint mayor no añade esas funciones automáticamente.
El asistente aporta valor cuando corrige bien
Para explicaciones, pruebas y cambios limitados, un checkpoint Instruct o Chat suele ser más adecuado que un modelo base de continuación. Comparemos un modelo de código de 3–8B con otro más capaz para las categorías difíciles, en lugar de mezclar todo el trabajo en una puntuación.
El contexto puede determinar la utilidad. Una traza de error aislada facilita suposiciones falsas sobre API o tipos. El mismo modelo con firma de función, tipos relevantes, versión de dependencia y prueba fallida recibe un problema más concreto. Un contexto amplio solo ayuda si contiene lo necesario: muchos archivos ajenos no reemplazan la definición correcta.
Transformar JSON con un esquema fijo difiere de diagnosticar concurrencia entre servicios. Lo segundo exige ordenar sucesos, efectos secundarios y evidencia incompleta. Para renombrados deterministas o formato también deben considerarse herramientas de refactorización y formateadores existentes.
Evaluemos fallos y cambios reales: si el parche compila, pasa pruebas pertinentes, conserva comportamiento requerido y reduce tiempo de revisión. Fluidez en español, corrección del código y conocimiento del framework son propiedades distintas. Las muestras deben reflejar la mezcla de preguntas en español, comentarios, código y documentación que utiliza el equipo, sin asumir que todo el material comparte idioma.
Un agente es modelo más sistema de ejecución
El agente elige su próxima acción a partir del resultado anterior. Puede buscar archivos, leerlos, formular una hipótesis, editar, ejecutar pruebas y rectificar tras un fallo. La selección de herramientas, la conservación de información relevante y la recuperación de un camino equivocado influyen en el éxito.
El framework o scaffold define herramientas, devolución de errores, historial y condiciones de finalización. mini-SWE-agent muestra un ciclo sencillo basado en bash e historial lineal; una interfaz estructurada de llamadas a herramientas no es la única forma de construir un agente. Importa que el modelo respete el contrato real de interacción.
Con llamadas estructuradas deben coincidir plantilla de conversación, argumentos y parser de salida. La documentación de herramientas de vLLM describe configuraciones y parsers específicos. Obtener una respuesta HTTP compatible con OpenAI no acredita la ejecución correcta de herramientas ni la continuación del ciclo.
Los modelos pequeños siguen siendo candidatos para correcciones acotadas. Incidencias ambiguas, archivos dependientes, migraciones y depuración repetida justifican incluir modelos entrenados para programación con agentes. Una llamada barata puede producir una tarea cara si causa cambios irrelevantes, reintentos o intervención humana continua.
Candidatos concretos por función
La tabla ilustra diferencias de función; no es una clasificación completa del mercado. Los tamaños corresponden a los checkpoints enlazados. B significa mil millones de parámetros.
| Modelo | Tamaño publicado | Función inicial | Diferencia decisiva |
|---|---|---|---|
| Qwen2.5-Coder-1.5B | 1,54B | Autocompletado FIM | Checkpoint base, no sustituto directo de chat |
| StarCoder2-3B | 3B | Completar código y sugerencias locales | Entrenamiento FIM, sin ajuste por instrucciones |
| Qwen2.5-Coder-7B-Instruct | 7,61B | Explicaciones, depuración limitada y cambios guiados | El éxito como asistente no acredita el de un agente de varios pasos |
| Qwen3-Coder-30B-A3B-Instruct | 30,5B totales; 3,3B activos | Asistencia avanzada y agentes | MoE y formato de herramientas propio; memoria según pesos totales |
| Devstral-Small-2-24B-Instruct-2512 | 24B | Cambios de repositorio y agentes | «Small» es una denominación de familia, no unos pocos miles de millones |
| Qwen3-Coder-Next | 80B totales; 3B activos | Agentes con memoria de despliegue suficiente | Atención híbrida y MoE; no ocupa como un modelo denso de 3B |
Las fichas Qwen y Devstral citadas identifican Apache-2.0; StarCoder2 utiliza BigCode OpenRAIL-M. Los archivos cuantizados necesitan además publicador identificable, checkpoint base y ruta compatible. Un GGUF no demuestra que la extensión del editor aplique bien su plantilla FIM o de herramientas. El catálogo conecta identidades y archivos.
Elegir el benchmark según el trabajo
LiveCodeBench evalúa problemas de programación con periodos de publicación identificables, incluyendo generación y tareas relacionadas. Informa sobre resolución de problemas, pero no mide directamente el retraso de una sugerencia ni un parche para el repositorio de la organización. Versión y periodo de los problemas forman parte de la puntuación.
SWE-bench estudia resolución de incidencias en repositorios. Verified contiene 500 tareas filtradas por personas; la vista Bash Only mantiene común el entorno mini-SWE-agent. Para atribuir diferencias al modelo se controla framework y entorno. Para elegir un producto final se evalúa la combinación entera.
El diseño de las pruebas también merece revisión. La auditoría de OpenAI sobre SWE-bench Verified describe problemas de pruebas y contaminación en su análisis. En una auditoría posterior, del 8 de julio de 2026, OpenAI también retiró su recomendación anterior de adoptar SWE-bench Pro tras encontrar problemas en sus tareas. Son críticas atribuidas sobre la evidencia, no puntuaciones alternativas del trabajo del equipo. Incidencias representativas y revisión del parche siguen siendo necesarias cuando las pruebas públicas no cubren requisitos locales.
| Función | Evaluación próxima al uso | Datos que registrar | Lo que no demuestra |
|---|---|---|---|
| Autocompletado | Reproducir puntos de inserción y observar el editor real | Latencia útil, aceptación, retención, lenguaje y archivo | Resolver algoritmos no garantiza ayuda rápida al escribir |
| Asistente | Preguntas, fallos y cambios del equipo con pruebas ejecutables | Corrección, comportamiento conservado, revisión y dependencias | Compilar o explicar de forma convincente no acredita comportamiento correcto |
| Agente | Tareas de repositorio con aceptación, junto a benchmarks públicos | Modelo, framework, herramientas, entorno, presupuesto, éxito y coste | Comparar sistemas distintos no aísla la calidad de los pesos |
No basta superar pruebas escritas únicamente por el agente. Deben conservarse pruebas pertinentes previas y requisitos de la tarea. Borrar una prueba fallida o debilitar su condición no resuelve la incidencia. A la vez, una prueba puede ser incompleta o excesivamente restrictiva: criterios de aceptación y revisión del parche acompañan al resultado automático.
Código pertinente antes de ajustar el modelo
Buscar símbolos, definiciones y referencias con el servidor de lenguaje, leer errores del compilador y consultar documentación de la versión correcta puede aportar conocimiento del proyecto durante la petición. La búsqueda semántica ayuda con conceptos, pero nombres de función, rutas y mensajes necesitan herramientas exactas. El artículo sobre RAG separa recuperación y generación; el código añade símbolos y dependencias.
Si falta la definición de una API interna nueva, proporcionarla es más directo que reentrenar. Si el modelo incumple repetidamente una convención fija pese a tener información suficiente, el ajuste aborda otro problema y puede aportar valor. La comparación de RAG y ajuste explica la distinción.
Un servicio compartido necesita planificar por tipo de trabajo
El autocompletado genera muchas peticiones cortas sensibles a la latencia. Un agente puede usar entradas largas, varias rondas y pausas para herramientas. Una cola común sin distinción puede dejar que trabajo largo retrase sugerencias breves. Separar colas o recursos puede importar más que ampliar uniformemente el modelo.
| Trabajo del equipo | Despliegue que estudiar | Restricción principal |
|---|---|---|
| Sugerencias para muchos editores | Modelo FIM pequeño preparado, cola corta y réplicas si hacen falta | Red, cola y ráfagas de generación breve |
| Conversación sobre código y arreglos limitados | Instruct pequeño o mediano, contexto pertinente y escalado | Corrección, longitud de entrada y memoria de contextos activos |
| Agentes con tareas de varios archivos | Modelo apto para herramientas, ejecución aislada y límites | Éxito, reintentos, pruebas y uso de CPU, RAM y GPU |
Ollama, vLLM, SGLang y llama.cpp ofrecen ejecución o servicio de modelos. Extensión y framework construyen autocompletado, conversación y ciclo de herramientas. En la tabla de programas se comparan checkpoint, formato, FIM, herramientas y carga, sin deducir usuarios admitidos del nombre del motor.
Memoria y coste de la tarea terminada
Merece la pena estudiar una tarjeta de 24 GB como RTX 4090 para modelos pequeños de autocompletado y numerosas configuraciones acotadas de asistencia. El ajuste real depende de pesos, motor, contexto y peticiones activas. No implica contexto máximo ni una cantidad fija de usuarios; el artículo de 24 y 48 GB distingue esos presupuestos y combinaciones de tarjetas.
En MoE es fácil confundir parámetros activos. Con los totales redondeados publicados de 30,5B para Qwen3-Coder-30B-A3B y 80B para Qwen3-Coder-Next, un cálculo ideal de pesos a cuatro bits produce 15,25 GB y 40 GB. Son unidades decimales y excluyen escalas, tensores de mayor precisión, KV y espacio de trabajo. No son tamaños reales de archivo ni VRAM mínima. Recuentos activos cercanos no eliminan esa diferencia.
La cuantización se evalúa en su función: sugerencias conservadas, correcciones acertadas o éxito de toda la tarea del agente. El artículo sobre cuatro bits explica por qué archivos menores no garantizan servicio más rápido ni igual precisión.
Para agentes, se divide ejecución total, intentos fallidos y revisión humana entre tareas aceptadas con el mismo criterio de calidad. También se publican límite de tiempo y recursos y tasa de éxito; eliminar tareas difíciles no debe hacer parecer más barata una alternativa. Un modelo más capaz puede ahorrar intentos, mientras otro pequeño puede resolver trabajo limitado con menos recursos.
Una GPU mejor no acelera cada etapa. Instalar dependencias, compilar, probar navegadores y ejecutar suites largas también usa CPU, RAM, disco y recursos externos. Conviene localizar el tiempo consumido antes de atribuirlo a generación.
Preparar una comparación por función
Separemos peticiones reales en los tres grupos y definamos tareas representativas con aceptación concreta. Comparemos un FIM pequeño para autocompletado, un Instruct pequeño o mediano para asistencia y dos combinaciones de modelo y entorno para agentes. El agente debe completar lectura, edición, ejecución y observación; el autocompletado se prueba mientras se escribe realmente. Fallar en una función no descarta el modelo en todas las demás.
El ámbito del repositorio y de las herramientas también pertenece al producto. Entornos aislados y cambios revisables limitan los efectos de errores. El texto del repositorio es información que inspeccionar, no autorización automática para ampliar acceso. El diseño final puede utilizar dos modelos compartidos o tres separados, siempre que cada función cumpla sus objetivos de calidad, tiempo y coste.