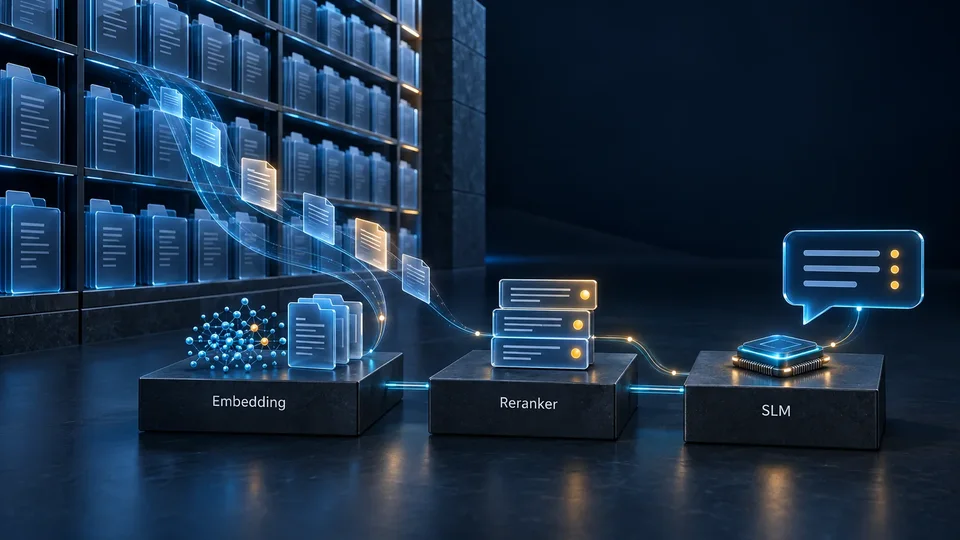
Una persona pregunta quién debe aprobar la renovación de un contrato. Soporte busca un procedimiento de reparación. Alguien recién incorporado necesita los pasos para solicitar un viaje. Las respuestas suelen existir en los documentos de la organización. El asistente debe localizar la fuente vigente, leer las condiciones y responder de forma que se pueda comprobar el respaldo. Ese proceso no exige automáticamente un generador enorme.
Para consultas documentales principalmente directas y acotadas, conviene comparar un modelo de instrucciones de 3–4B con otro de 7–8B antes de comprometer una infraestructura mayor. El objetivo es saber si más capacidad del generador corrige un error real. Embedding, reranking y generación tienen responsabilidades distintas: ampliar uno no arregla los demás. El artículo sobre tamaño de modelo explica la selección; la guía LLM reúne modelos, archivos y evidencia de ejecución.
Los textos, los documentos escaneados y los datos actualizados necesitan rutas distintas
En un PDF con texto, conserve los títulos, las referencias de página y las versiones del documento al extraer e indexar el contenido. Si importan los gráficos, la disposición o las relaciones entre celdas, compare OCR y recuperación visual con muestras propias. El recuperador visual localiza páginas; la respuesta todavía necesita evidencias que se puedan revisar. Los totales y las existencias actuales deben obtenerse mediante consultas autorizadas y cálculos sobre registros fiables, no a partir de unos pocos fragmentos recuperados.
| Datos | Ruta inicial | Evidencia en la respuesta |
|---|---|---|
| PDF con texto, cartas y procedimientos | Extraer títulos, páginas y versiones; búsqueda léxica y vectores cuando aporten valor | La cláusula vigente y su página |
| Documentos escaneados, gráficos y tablas como imagen | OCR que conserve la disposición; comparar recuperación visual con páginas representativas | Texto extraído o una región verificable de la página |
| Registros actualizados del CRM y ERP | Consultas autorizadas mediante un conector con acceso limitado | Registro de origen y hora de consulta |
| Totales, recuentos e informes tabulares | SQL, BI o código sobre todos los registros pertinentes; generación para explicar | Cálculo reproducible y alcance de los datos |
Para una prueba visual, Qwen3-VL-Embedding-2B recupera páginas pertinentes y Qwen3-VL-Reranker-2B vuelve a puntuar candidatos; ninguno genera la respuesta. Las variantes de 8B permiten comparar, sin ser el punto de partida obligatorio. El contexto documentado para la tarea es de 32K tokens. La cuantización de la ficha de embedding se refiere a los vectores de salida, no a pesos Q4. Los resultados agregados de MMEB o ViDoRe no establecen la calidad en español.
Los importes, identificadores y cláusulas exactas necesitan una referencia al texto extraído o a una región verificable de la página. Compare el tiempo de indexación, el tamaño del índice y la latencia de consulta junto con la recuperación correcta. Un modelo visual de 2B no tiene necesariamente el coste de ejecución de un modelo textual de 2B.
Tres componentes y tres responsabilidades
Un RAG habitual prepara y divide documentos, calcula sus representaciones, recupera candidatos para una consulta, opcionalmente los reordena y entrega evidencia al generador. No todas las peticiones necesitan el recorrido completo. Para un número exacto de circular quizá baste buscar el identificador y mostrar el fragmento, sin generar texto nuevo.
| Componente | Responsabilidad | Salida para la siguiente etapa |
|---|---|---|
| Modelo embedding e índice | Representar texto para recuperación, a menudo junto con búsqueda léxica | Pasajes candidatos |
| Reranker | Puntuar con más detalle cada par consulta–pasaje | Candidatos reordenados |
| Generador | Leer evidencia, conservar condiciones y responder con fuentes | Respuesta útil y verificable |
Un encoder habitual representa consulta y documento por separado, permitiendo calcular antes los vectores documentales. Un reranker de tipo cross-encoder procesa el par conjuntamente y repite trabajo para cada candidato. Esto explica la separación entre buscar en un archivo grande y reordenar un conjunto menor, como muestra la guía de recuperación y reranking de Sentence Transformers.
El tamaño del archivo documental no determina el del generador
El generador no tiene que memorizar todos los documentos en sus pesos. La evidencia pertinente llega con cada petición. Un millón de páginas modifica primero la capacidad del índice, la dificultad de búsqueda y la gestión de versiones; no exige necesariamente un generador mayor que diez mil páginas. Lo determinante es interpretar y combinar la evidencia necesaria.
«¿Quién aprueba la renovación según esta política?» puede resolverse con una cláusula explícita. «¿Permiten tres contratos y dos anexos renovar sin otra aprobación?» exige precedencia de versiones, relaciones y excepciones. Ambas preguntas pertenecen a un asistente documental, pero piden razonamiento distinto.
Los autores de Pleias-RAG informan de resultados competitivos de modelos especializados de 350 millones y mil millones de parámetros frente a algunos modelos generales mayores en pruebas concretas, como HotPotQA y 2Wiki. Es un resultado de su entrenamiento y tareas evaluadas, no de cualquier idioma o proceso documental. Justifica considerar la especialización en respuestas fundamentadas junto al número de parámetros.
| Tipo de petición | Elección inicial del generador | Cuándo considerar más capacidad |
|---|---|---|
| Localizar documento, cláusula o identificador exacto | Buscar y mostrar la fuente; quizá sin generación | Ambigüedad o necesidad de explicación |
| Responder desde pasajes explícitos | Modelo de instrucciones de unos 3–8B | Errores persistentes con terminología o condiciones combinadas |
| Extraer campos a un esquema fijo | Reglas o especialista; después un generador de 1–4B para entradas acotadas | Gran variedad de formatos o información que exige inferencia |
| Resumen breve o comparación limitada | Comparar modelos de 4B y 8B | Pérdida de detalles, excepciones o cobertura requerida |
| Conciliar documentos contradictorios | Comparar 8–14B con un candidato más capaz, por ejemplo 32B | Razonamiento incorrecto con evidencia completa |
| Contar, sumar o informar sobre todo el archivo | Consultas estructuradas y procesamiento completo; generación para explicar | Extraer estructura o análisis difícil, no simplemente añadir parámetros |
Son comparaciones iniciales, no umbrales probados ni una afirmación de igualdad entre todos los modelos de un intervalo.
Elegir embeddings según la búsqueda real
La primera pregunta es si el pasaje necesario entra entre los candidatos. Terminología interna, códigos de equipo, nombres de formularios y consultas entre idiomas pueden comportarse de forma distinta a la media de una clasificación pública. Deben aparecer en la evaluación. MIRACL incluye una colección específica en español; sirve como evidencia inicial de recuperación, no como evaluación de la documentación de la organización ni de todas las variedades del idioma.
La similitud semántica ayuda a conectar una formulación informal con el término de una política. Números de contrato, piezas y versiones también requieren coincidencia exacta. Conviene comparar recuperación híbrida, combinando vectores con un método léxico como BM25. La fusión recíproca de rangos, RRF, combina posiciones; sumar puntuaciones BM25 y coseno sin tratar sus escalas es otra operación, sin esa calibración.
El formato de entrada forma parte del modelo. multilingual-e5-small utiliza query: y passage: en recuperación asimétrica y trunca al superar su límite. Qwen3-Embedding tiene su formato de instrucciones para consultas. Pooling, normalización y límites del tokenizador deben corresponder al checkpoint. Igual número de dimensiones no hace compatibles los espacios de dos encoders distintos.
Las dimensiones también afectan al almacenamiento. Un millón de vectores float32 de 384 dimensiones ocupa 1,536 GB, aproximadamente 1,54 GB, antes de texto, metadatos e índice. Con 1.024 dimensiones ocupa 4,096 GB, aproximadamente 4,10 GB. El cálculo es cantidad de vectores × dimensiones × cuatro bytes; no implica almacenarlos en VRAM. Para reducir dimensión debe usarse un método admitido por el modelo, sin suponer que recortar cualquier vector conserva sus propiedades.
Cambiar el modelo embedding normalmente exige recalcular vectores y reconstruir un índice compatible. Cambiar los límites de los fragmentos puede tener el mismo efecto. Reemplazar generador o reranker suele evitar ese trabajo si representación y fragmentación no cambian. La versión del encoder y del preprocesamiento debe formar parte de la configuración del índice.
Relacione la evidencia con el idioma y la tarea
En MIRACL español, E5 publica nDCG@10 de 51,2, 51,5, 52,9 y 53,7 para Small, Base, Large y Large-Instruct. Recall@100 es 87,6, 88,6, 89,1 y 89,3: mide otro aspecto, la presencia de documentos pertinentes entre los candidatos. No mezcle ambas métricas en una misma escala de calidad. En inglés, Large supera a Large-Instruct en nDCG@10, de modo que la etiqueta Instruct tampoco garantiza el primer puesto. Estos resultados no miden las respuestas generadas ni consultas en español sobre documentos en otro idioma.
Recuperación en español
E5-Small es una referencia de menor tamaño; Large-Instruct obtiene más en este informe MIRACL en español. Los resultados de Qwen son agregados multilingües, no puntuaciones específicas de español.
Cuando consultas y documentos están en español; identifique por separado la recuperación entre idiomas.
La diferencia de 51,2 a 53,7 no acredita la calidad de la respuesta final ni la cobertura de todas las variedades del español.
Recuperación en inglés
Trate Large y Large-Instruct como variantes distintas: Large obtiene más en MIRACL inglés en este informe. Para valorar un reranker, use la comparación de Qwen con el mismo conjunto de candidatos.
Cuando importa más la evidencia en el idioma objetivo que una media multilingüe.
La etiqueta Instruct no garantiza una mejora en todas las tareas.
El reranker mejora candidatos; no recupera lo que falta
Varios pasajes pueden tratar renovaciones y referirse a contratos diferentes o versiones obsoletas. El reranker revisa consulta y texto juntos para afinar relevancia. Vigencia, tipo documental y autoridad siguen necesitando metadatos y reglas: relevancia no equivale a validez normativa u organizativa.
El reranker no puede incorporar evidencia ausente de su lista. Además añade cálculo según pares examinados, sus longitudes y el procesamiento por lotes. Treinta a cincuenta candidatos pueden ser un experimento inicial, no una configuración universal. El objetivo útil es conservar evidencia suficiente dentro del presupuesto temporal y de contexto.
Si un identificador exacto ya encuentra el documento correcto, el reranking quizá aporte poco. Cláusulas similares y documentos casi duplicados le dan más trabajo útil. La ficha de BGE reranker describe puntuación de relevancia; incluso convertida al intervalo de cero a uno no es la probabilidad de que la respuesta generada sea correcta.
Reranking con los mismos candidatos
La comparación de Qwen entrega a cada reranker los mismos 100 candidatos recuperados con Qwen3-Embedding-0.6B. MTEB-R pasa de 61,82 a 65,80 con el reranker de 0,6B: son 3,98 puntos, no una mejora del 3,98 % en la calidad de las respuestas. El de 4B obtiene 69,76 frente a 69,02 del de 8B, mientras que 8B aventaja ligeramente en MMTEB-R. La elección depende de la tarea y de los recursos de la segunda etapa; la tabla no mide la latencia.
Añadir una etapa de reranking
Empiece la comparación de tamaños con 0,6B. Considere 4B y 8B si la mejora en la tarea justifica el presupuesto de la segunda etapa; 8B no encabeza todas las métricas.
Cuando los documentos pertinentes están entre los candidatos pero aparecen mal ordenados; la cantidad de candidatos forma parte del diseño.
El reranker no puede recuperar un documento ausente de su conjunto de entrada.
Candidatos concretos para una comparación inicial pequeña
| Modelo | Función | Propiedad concreta | Motivo para incluirlo |
|---|---|---|---|
| multilingual-e5-small | Embedding | Unos 118 millones de parámetros, 384 dimensiones y límite de 512 tokens | Referencia pequeña para fragmentos cortos y posible ejecución CPU |
| BGE-M3 | Embedding y recuperación | Vectores densos de 1.024 dimensiones, hasta 8.192 tokens, rutas dispersa y multivector | Comparar recuperación multilingüe y formas de representación |
| Qwen3-Embedding-0.6B | Embedding | Unos 600 millones de parámetros, hasta 1.024 dimensiones y 32.768 tokens | Candidato con instrucciones y dimensiones configurables |
| bge-reranker-v2-m3 | Reranking | Unos 568 millones de parámetros; puntuación multilingüe de pares | Referencia de menos de mil millones de parámetros |
| Qwen3-Reranker-0.6B | Reranking | Unos 600 millones de parámetros, instrucciones y entrada de 32.768 tokens | Comparar la ruta Qwen antes de sus variantes de 4B y 8B |
Un límite de entrada no es un tamaño recomendado de fragmento. Un pasaje de 32K puede mezclar temas y consumir mucho cálculo. En reranking deben caber conjuntamente consulta, instrucción y candidato. Las representaciones adicionales de BGE-M3 necesitan su ruta correspondiente; una API genérica quizá exponga solo vectores densos. El artículo de BGE-M3 distingue esas capacidades.
Para generar respuestas, Qwen3-4B-Instruct-2507 y Qwen3-8B permiten una comparación concreta. El primero es un checkpoint de instrucciones sin modo thinking; el segundo admite thinking y non-thinking. Una salida de razonamiento larga no debería ser un valor predeterminado sin examinar para responder directamente desde un documento. Ese modo debe constar en las comparaciones de calidad y latencia.
Los tres componentes no tienen que compartir familia. La compatibilidad del espacio vectorial afecta a encoders de consulta y documento; no obliga a elegir reranker y generador del mismo publicador. La vista de modelos especializados y la tabla de programas reúnen evidencia y rutas de ejecución.
La preparación documental decide qué recibe el generador
Si la extracción separa una cabecera de sus filas, deja una excepción en otro fragmento o lee «10» como «1», el generador recibe evidencia dañada. Conviene preservar títulos, números de cláusula, cabeceras de tabla, identificadores y ubicación de la fuente. Herramientas como Docling trabajan sobre estructura y disposición; el OCR del idioma y los tipos de archivo reales siguen necesitando revisión.
Una página escaneada sin texto extraíble necesita OCR o una ruta visual adecuada. Eso no obliga a procesar cada consulta textual con un modelo multimodal grande. En nuestro despliegue de conversación con archivos de Targoman, un generador Aya 8B adaptado utilizaba Qdrant y multilingual-e5-large-instruct, compartiendo GPU con embedding. La ruta descrita no incluía OCR, de modo que los PDF escaneados sin texto extraíble quedaban fuera. El informe original en persa ejemplifica por qué extracción y recursos compartidos pertenecen a la decisión del modelo.
Más texto recuperado no garantiza mejor evidencia. Seis fragmentos de 700 tokens del generador suman unos 4.200 tokens; cincuenta suman 35.000. Instrucciones, historial, pregunta y salida se añaden. Es un ejemplo de presupuesto del generador, no una receta de fragmentación: los modelos E5 limitados a 512 tokens pueden truncar esos pasajes, y cada componente tiene su tokenizador. Hay que controlar límites de embedding y reranker por separado.
Versión, vigencia y permisos deben acompañar al pasaje. Un texto obsoleto no debe desplazar a la política actual por ser más parecido. Pasajes no autorizados deben excluirse antes de llegar al generador o a un reranker fuera del límite permitido de datos. El documento recuperado es evidencia, no una autorización para sustituir las instrucciones del sistema.
Presupuestar toda la cadena de servicio
Tres modelos no implican tres GPU dedicadas. El cálculo inicial de embeddings es distinto de responder en línea; después se procesan documentos nuevos y modificados. Un encoder pequeño puede rendir suficientemente en CPU con poca demanda, mientras los lotes en GPU ayudan en ingestiones mayores. Reranker y generador pueden compartir tarjeta si memoria y latencia lo permiten, o convertirse en servicios separados. Text Embeddings Inference es un ejemplo de motor para servir embeddings; debe comprobarse el modelo y función concretos.
Un generador pequeño sigue teniendo presupuesto de contexto. Según la configuración de Qwen3-4B-Instruct-2507, 36 capas, 8 cabezas KV y dimensión 128 implican aproximadamente 1,125 GiB de KV de dieciséis bits para 8.192 tokens retenidos. Cuatro secuencias independientes necesitan 4,5 GiB, antes de pesos, activaciones y espacio de trabajo. Un modelo residente barato no produce concurrencia ilimitada.
Si alcanza la calidad exigida, réplicas en GPU separadas pueden ampliar capacidad independiente. Dividir un modelo grande es otro despliegue. La comparación de 24 y 48 GB y el artículo de cuantización conectan estas decisiones con memoria sin deducir rendimiento a partir del archivo.
Encontrar el fallo antes de ampliar el generador
Ante una respuesta fallida, entreguemos manualmente los pasajes correctos y suficientes al mismo modelo pequeño. Si ahora acierta, la recuperación o selección del contexto queda señalada en ese ejemplo. Si falla todavía, se revisan instrucciones, idioma, procesamiento de salida y capacidad del generador. No explica todos los errores, pero evita sustituir por defecto el componente equivocado.
| Síntoma | Primer componente que revisar | Intervención anterior a aumentar el generador |
|---|---|---|
| Falta evidencia en los candidatos iniciales | Extracción, fragmentos, embedding y búsqueda | Reparar texto, conservar identificadores, comparar recuperación híbrida y cantidad de candidatos |
| La evidencia se recupera pero no llega al contexto | Reranker y selección de evidencia | Corregir formato de pares, diversificar y revisar presupuesto de tokens |
| La respuesta usa documento obsoleto o ajeno | Metadatos y reglas de validez | Filtros de versión, fecha, tipo y permisos |
| Evidencia completa y respuesta directa incorrecta | Generador, instrucciones y salida | Mejorar el contrato; después comparar otro modelo pequeño o uno más capaz |
| Evidencia correcta pero fallan excepciones o razonamiento | Diseño del proceso y capacidad analítica | Dividir la tarea, usar herramientas o dirigirla a un modelo mayor |
Construyamos preguntas representativas con evidencia y respuestas de referencia, incluyendo casos sin respuesta, ambiguos, obsoletos y fuera de permiso. Reservemos una parte fuera del ajuste de instrucciones y umbrales. En español deben aparecer el vocabulario de los usuarios reales, abreviaturas, formulaciones coloquiales, formatos de número y documentos mezclados con otros idiomas; una colección de un único país puede no cubrir el uso previsto.
En recuperación se mide si la evidencia necesaria está entre los primeros k resultados; un pasaje relevante no basta cuando hacen falta varios. En generación se comprueban exactitud, respaldo de afirmaciones, referencias y conducta sin evidencia. Espera en cola y tiempos de respuesta deben medirse junto con la calidad.
Si la terminología rompe la recuperación, adaptar encoder o reranker con pares pertinentes y no pertinentes puede ser adecuado. Si la recuperación funciona y el generador incumple el formato o comportamiento, el ajuste por instrucciones o adaptadores actúa sobre otro problema. Cambiar una política normalmente exige actualizar fuente e índice, no entrenar todo; la comparación de RAG y ajuste desarrolla esa distinción.
Un encoder pequeño, un reranker pequeño opcional y un generador de 3–8B forman un sistema inicial serio para preguntas documentales directas. Puede añadirse una ruta más potente para casos difíciles identificados mediante reglas evaluadas. Ni la similitud ni el tono seguro del modelo bastan para decidir el escalado. El criterio final es la combinación menos costosa que entrega respuestas correctas y fundamentadas dentro del tiempo requerido.