Un agente de programación necesita acceso para resultar útil: debe leer archivos, modificarlos y ejecutar pruebas. Pero esos permisos adquieren otro significado cuando el modelo puede descubrir vulnerabilidades y crear exploits para aprovecharlas. Una elección que antes se planteaba sobre todo en términos de productividad se convierte en una decisión sobre la autoridad del software. Para un equipo que ejecuta GLM-5.3 en su propia infraestructura, la pregunta empieza aquí: ¿qué hemos permitido hacer al agente y qué lo detiene si se sale de la tarea prevista?
El informe de Anthropic del 29 de septiembre hace más difícil aplazar esa pregunta. En ExploitBench, la empresa registra 50 exploits completos y funcionales en 410 intentos con GLM-5.3, frente a 56 con Claude Mythos Preview. La evaluación abarca 41 tareas de V8. Por tanto, ese aproximadamente 12% es la proporción de intentos que tuvieron éxito en esta evaluación, no la probabilidad de éxito contra cualquier navegador o sistema que se encuentre en internet. Informe de Anthropic
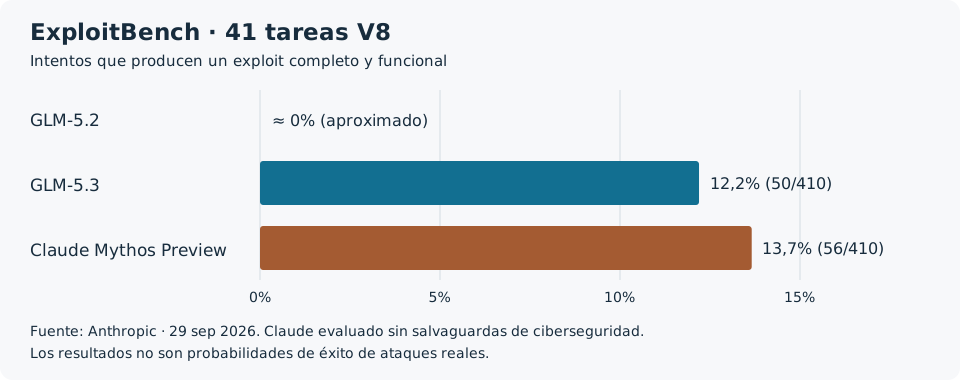
Gráfico basado en el informe de Anthropic: GLM-5.3 tuvo éxito en 50 de 410 intentos y Mythos Preview en 56 de 410. GLM-5.2 se representa de forma aproximada como «cerca del cero». Claude se evaluó con las salvaguardas de ciberseguridad desactivadas; no es una comparación de servicios públicos con su configuración predeterminada.
¿Qué hay de nuevo exactamente?
GLM-5.3 no se lanzó el día de la publicación del informe de Anthropic. Según la evaluación de CAISI, en NIST, el modelo se lanzó el 14 de agosto y sus pesos se hicieron públicos dos semanas después, hacia el 28 de agosto. El 17 de septiembre, NIST ya lo había identificado como el modelo de pesos abiertos con mayor capacidad cibernética en sus evaluaciones, aunque señalaba que seguía unos cuatro meses por detrás de la frontera estadounidense en la medida agregada del centro.
Estos resultados no contradicen la proximidad entre GLM-5.3 y Mythos Preview en el gráfico. La comparación de NIST abarca varias evaluaciones y modelos, incluidos algunos de acceso restringido. El gráfico anterior muestra una medida concreta. Ni siquiera la puntuación de ExploitBench en la tabla de NIST debe compararse directamente con ese 12%: CAISI toma el mejor de tres intentos en la escala de puntuación de la prueba, mientras que aquí se muestra la proporción de intentos que alcanzaron el resultado final.
La aportación nueva de Anthropic es el examen de la fragilidad de las salvaguardas de comportamiento. En un entorno simulado, un pretexto engañoso logró que el modelo atendiera instrucciones maliciosas en el 64% de las muestras; el razonamiento prerrellenado, en el 92%; y una versión con los pesos modificados, en el 100%. Estas cifras miden la disposición a actuar sobre la solicitud. No significan que esos mismos porcentajes de ataques reales fueran a tener éxito. Diseño de la prueba y limitaciones
El rechazo del modelo no delimita el entorno de ejecución
Para un equipo técnico hay que distinguir dos controles. El modelo puede decidir no atender una solicitud; el entorno de ejecución puede impedir de entrada el acceso a un archivo o a un destino de red. Lo primero es comportamiento del modelo. Lo segundo es una restricción aplicada fuera de él. Si el diseño de seguridad depende por completo de una frase en el prompt del sistema, estamos pidiendo al mismo software que queremos limitar que preserve sus propios límites.
Esa dependencia adquiere más importancia con los pesos abiertos. Quien tiene los pesos no se limita a consumir respuestas: también puede modificar el comportamiento del modelo. Para los defensores, esa libertad facilita la investigación y el despliegue independiente. Para los atacantes, elimina la necesidad de recurrir a un servicio controlado. Sin embargo, disponer públicamente de los pesos no hace que ejecutar el modelo sea gratuito o carezca de costes, ni demuestra por sí solo que se haya producido un ataque.
La frontera práctica entre defensa y ataque se encuentra en la autorización, el propósito y el alcance del acceso. Revisar el código de un producto con permiso de su propietario, sobre una copia aislada y con un procedimiento definido para comunicar vulnerabilidades, es un trabajo que puede delimitarse y revisarse. Aplicar la misma capacidad a sistemas ajenos sin permiso es una actividad distinta. Llamarlo «agente de seguridad» o «ejercicio de investigación» no establece esa frontera.
¿Qué debe cambiar en el uso dentro de una organización?
Mi recomendación operativa es ejecutar GLM-5.3 y los agentes conectados a él en un sandbox sin credenciales reales ni acceso libre a la red. El entorno debe contener únicamente los archivos y herramientas necesarios para la tarea asignada. Las claves SSH, los tokens de producción y las sesiones personales del desarrollador no deben quedar al alcance del agente simplemente para facilitar la puesta en marcha. El permiso para leer código tampoco debe convertirse automáticamente en permiso para publicar, desplegar o contactar con destinos de red.
El registro de operaciones debe permitir reconstruir lo ocurrido: qué herramienta llamó el agente, con qué entrada, qué archivo modificó y qué resultado orientó su siguiente decisión. La revisión humana también debe producirse cuando aún es posible detener el efecto de un cambio. Aprobar después de que el cambio llegue al entorno de producción no cumple la misma función que aprobar antes de ejecutarlo.
Estas son las recomendaciones de este artículo para limitar la autoridad del agente, no una afirmación de que un sandbox elimine todos los riesgos. El aislamiento debe ponerse a prueba y el entorno de investigación no puede convertirse en una puerta trasera hacia datos y cuentas reales. Elegir el modelo, su software de ejecución y los permisos del agente son decisiones relacionadas que conviene estudiar juntas. La guía de selección de modelos de lenguaje ofrece un punto de partida.
¿Cuánta confianza merecen los resultados?
Anthropic también describe un experimento guiado por un investigador en el que el modelo encadenó varias vulnerabilidades del navegador hasta entonces desconocidas y leyó un archivo del sistema de prueba. Según el informe, esas vulnerabilidades se comunicaron al responsable de mantenimiento. La observación va más allá de una puntuación de benchmark, pero sigue siendo un experimento con un entorno y una intervención humana concretos. Informe del experimento
Hay pruebas considerables del salto de capacidad y de las debilidades de las salvaguardas examinadas. El alcance de la amenaza en el mundo real exige más cautela. Anthropic compite comercialmente con el desarrollador del modelo; algunas evaluaciones son privadas y la prueba de respuesta a instrucciones maliciosas se realizó en una simulación. NIST aporta evidencia separada sobre la capacidad cibernética, pero no confirma de manera independiente todos los resultados de Anthropic sobre las salvaguardas de comportamiento.
No hace falta demostrar el peor escenario antes de mejorar los controles de acceso. Un equipo que hoy concede a un agente permiso para ejecutar código puede definir hoy el alcance de esa autoridad. La pregunta que puede responder es concreta: si el modelo se sale de nuestras instrucciones, ¿hasta dónde puede llegar en el entorno que hemos construido?