عامل کدنویسی برای مفید بودن به دسترسی نیاز دارد: باید فایل بخواند، تغییری بدهد و آزمونی اجرا کند. اما همین دسترسیها، وقتی مدل بتواند آسیبپذیری پیدا کند و برای آن exploit بسازد، معنای دیگری پیدا میکنند. آنچه تا دیروز صرفاً یک انتخاب برای افزایش بهرهوری بود، حالا به تصمیمی دربارهٔ اختیار نرمافزار تبدیل میشود. مسئله برای تیمی که GLM-5.3 را روی زیرساخت خودش اجرا میکند، از همینجا آغاز میشود: به چه چیزی اجازهٔ عمل دادهایم و اگر از مسیر تعیینشده خارج شد، چه چیزی جلویش را میگیرد؟
گزارش ۲۹ سپتامبر Anthropic این پرسش را جدیتر کرده است. شرکت در ExploitBench، برای GLM-5.3 از ۴۱۰ تلاش، ۵۰ موفقیت در ساخت exploit انتهابهانتها گزارش میکند؛ برای Claude Mythos Preview این تعداد ۵۶ است. آزمون به ۴۱ مسئلهٔ V8 مربوط است. بنابراین حدود ۱۲ درصد، سهم تلاشهای موفق در این ارزیابی است؛ نه احتمال موفقیت علیه هر مرورگر یا سامانهای که در اینترنت پیدا شود. گزارش Anthropic
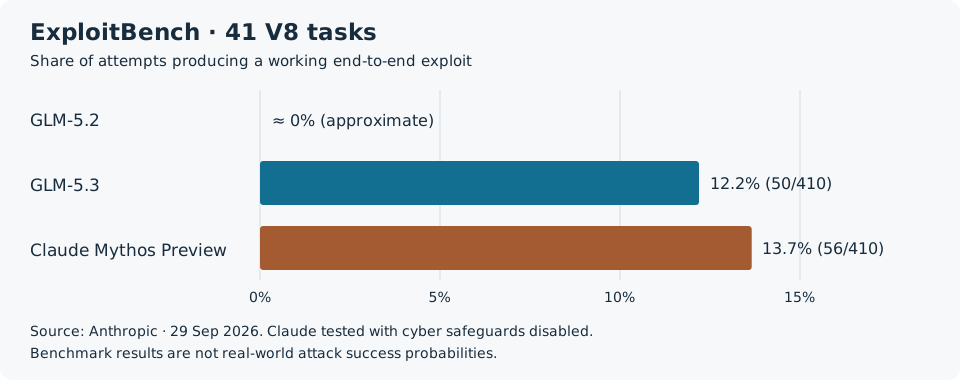
نمودار بر پایهٔ گزارش Anthropic: GLM-5.3 برابر ۵۰ از ۴۱۰ و Mythos Preview برابر ۵۶ از ۴۱۰ تلاش؛ مقدار GLM-5.2 بهصورت تقریبی «نزدیک صفر» گزارش شده است. نسخهٔ Claude در این مقایسه با کنترلهای سایبری غیرفعال آزموده شده؛ نمودار، مقایسهٔ خدمات عمومی با تنظیمات پیشفرض نیست.
خبر تازه دقیقاً چیست؟
GLM-5.3 در روز انتشار گزارش Anthropic عرضه نشده است. بنا بر ارزیابی CAISI در NIST، عرضهٔ مدل در ۱۴ اوت و انتشار عمومی وزنها دو هفته بعد، یعنی حدود ۲۸ اوت، رخ داده است. NIST هم پیشتر، در ۱۷ سپتامبر، آن را توانمندترین مدل وزنباز در ارزیابیهای سایبری خود معرفی کرده بود؛ با این قید که در شاخص تجمیعی آن مرکز، هنوز حدود چهار ماه از مرز توان مدلهای آمریکایی عقبتر بود.
این دو گزاره با نزدیک بودن نتیجهٔ GLM-5.3 و Mythos Preview در نمودار تناقضی ندارند. «مرز توان» در گزارش NIST مجموعهای از آزمونها و مدلها، از جمله مدلهای با دسترسی محدود، را در بر میگیرد. نمودار بالا فقط یک معیار مشخص را نشان میدهد. حتی عدد ExploitBench در جدول NIST را هم نباید مستقیم کنار ۱۲ درصد گذاشت: آن مرکز بهترینِ سه تلاش را روی مقیاس امتیازدهی آزمون محاسبه کرده، در حالی که اینجا سهم تلاشهایی را میبینیم که به نتیجهٔ نهایی رسیدهاند.
سهم تازهٔ گزارش Anthropic، بررسی شکنندگی کنترلهای رفتاری است. در محیط شبیهسازیشده، درخواست با پوشش جعلی در ۶۴ درصد، پیشپرکردن reasoning در ۹۲ درصد و نسخهٔ تغییریافتهٔ وزنها در ۱۰۰ درصد نمونهها باعث همراهی مدل با دستور مخرب شده است. این اعداد، میزان ورود مدل به انجام درخواستاند؛ از آنها نمیتوان نتیجه گرفت که همان درصد از حملههای واقعی موفق خواهند شد. شرح آزمون و محدودیتهای آن
امتناع مدل، دیوار محیط اجرا نیست
برای یک تیم فنی، تفاوت مهم میان این دو کنترل است: مدل ممکن است تصمیم بگیرد درخواستی را نپذیرد؛ محیط اجرا میتواند اساساً امکان دسترسی به یک فایل یا مقصد شبکه را ندهد. اولی رفتار مدل است و دومی محدودیتی است که بیرون از مدل اعمال میشود. اگر طراحی امنیتی فقط به جملهای در دستور سیستم وابسته باشد، عملاً از همان نرمافزاری که باید محدود شود خواستهایم حدود اختیار خودش را نگه دارد.
در مدل وزنباز، این وابستگی مسئلهسازتر میشود. کسی که وزنها را در اختیار دارد، فقط مصرفکنندهٔ پاسخ نیست؛ میتواند رفتار مدل را نیز تغییر دهد. برای مدافع، این آزادی امکان پژوهش و اجرای مستقل ایجاد میکند. برای مهاجم هم مانع مراجعه به یک خدمت کنترلشده را از میان برمیدارد. با این حال، آزاد بودن وزنها به معنی رایگان یا بیهزینه بودن اجرای مدل نیست و بهتنهایی هم وقوع حمله را ثابت نمیکند.
مرز عملی دفاع و حمله را باید در مجوز، هدف و دامنهٔ دسترسی جستوجو کرد. بررسی کد یک محصول با اجازهٔ صاحب آن، روی نسخهای جداشده و با مسیر مشخص گزارش آسیبپذیری، کاری قابل تعریف و بازبینی است. همان توانایی با دسترسی به سامانهٔ دیگران و بدون مجوز، وارد قلمرو دیگری میشود. نام «عامل امنیتی» یا «آزمایش پژوهشی» بهخودیخود این مرز را تعیین نمیکند.
برای استفاده در سازمان چه چیزی باید عوض شود؟
پیشنهاد اجرایی من این است که GLM-5.3 و عاملهای متصل به آن در sandbox بدون credential واقعی و بدون دسترسی آزاد به شبکه اجرا شوند. محیط باید فقط فایلها و ابزارهای لازم برای همان کار را داشته باشد. کلیدهای SSH، توکنهای تولید و نشستهای شخصی توسعهدهنده نباید صرفاً به دلیل راحتتر شدن راهاندازی در دسترس عامل قرار بگیرند. اجازهٔ خواندن کد هم نباید خودبهخود به اجازهٔ انتشار، استقرار یا دسترسی به مقصدهای شبکه تبدیل شود.
ثبت عملیات باید امکان بازسازی آنچه رخ داده را فراهم کند: عامل چه ابزاری را با چه ورودیای فراخوانده، چه فایلی را تغییر داده و کدام خروجی مبنای تصمیم بعدی شده است. بازبینی انسانی نیز باید در نقطهای قرار بگیرد که هنوز میتوان اثر تغییر را متوقف کرد. تأیید پس از اعمال تغییر روی محیط اصلی، کارکرد تأیید پیش از اجرا را ندارد.
اینها توصیههای این یادداشت برای محدود کردن اختیار عاملاند، نه ادعای اینکه یک sandbox هر نوع خطری را حذف میکند. جداسازی باید آزموده شود و محیط پژوهش هم نباید به پشتدری برای دادهها و حسابهای واقعی تبدیل شود. انتخاب مدل، انتخاب نرمافزار اجرا و تعیین دسترسی عامل، سه تصمیم وابستهاند که لازم است کنار هم بررسی شوند؛ راهنمای انتخاب مدل زبانی نقطهٔ شروع این بررسی است.
چقدر باید به این نتیجه اطمینان داشت؟
Anthropic در یک آزمایش هدایتشده نیز از زنجیرهشدن چند آسیبپذیری ناشناختهٔ مرورگر و خواندن فایل از سامانهٔ آزمایشی خبر میدهد؛ طبق گزارش، آسیبپذیریهای مرورگر به نگهدارنده اعلام شدهاند. این مشاهده از یک امتیاز بنچمارک فراتر میرود، اما همچنان آزمونی با محیط و دخالت انسانی مشخص است. گزارش آزمایش
دربارهٔ جهش قابلیت و شکنندگی کنترلهای بررسیشده، شواهد جدیاند؛ دربارهٔ گسترهٔ تهدید در دنیای واقعی باید محتاطتر بود. Anthropic رقیب تجاری سازندهٔ مدل است، بخشی از ارزیابیها خصوصیاند و آزمون همراهی با دستور مخرب در شبیهسازی انجام شده است. ارزیابی NIST پشتوانهٔ جداگانهای برای بحث توان سایبری فراهم میکند، اما تمام نتایج آزمون کنترلهای رفتاری Anthropic را مستقلاً تأیید نمیکند.
برای اصلاح معماری دسترسی لازم نیست منتظر اثبات بدترین سناریو بمانیم. تیمی که امروز به عامل اختیار اجرای کد میدهد، میتواند همین امروز دامنهٔ آن اختیار را روشن کند. پرسش قابل پاسخ این است: اگر مدل از دستور ما عبور کرد، در محیطی که ساختهایم تا کجا میتواند پیش برود؟