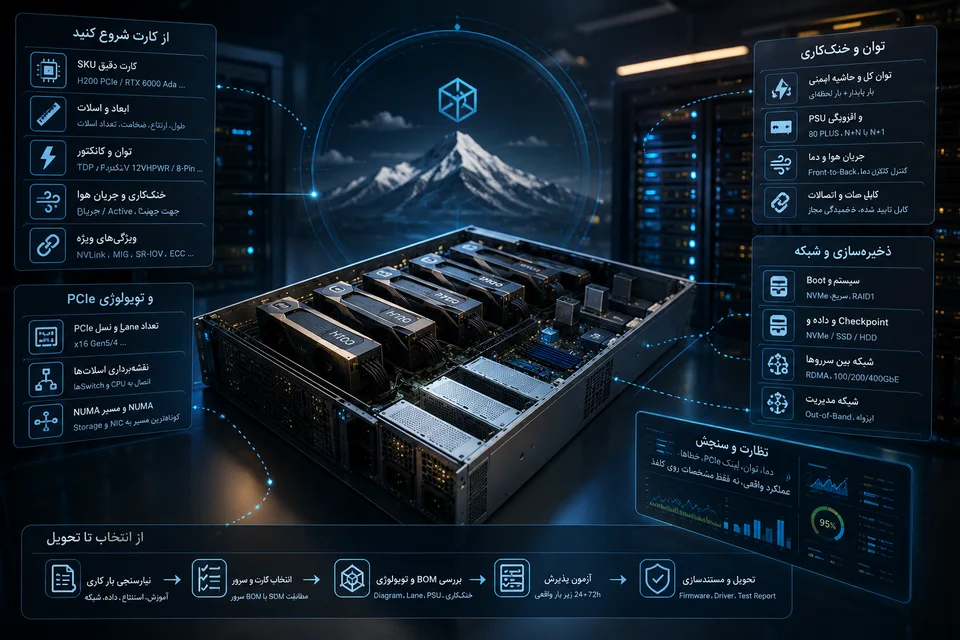
La expresión «servidor para ocho GPU» es un punto de partida para consultar al proveedor, no una declaración de compatibilidad. Esa cifra puede ser válida únicamente para determinadas tarjetas, límites de potencia, tarjetas elevadoras y kits de refrigeración. Una compra adecuada especifica la lista exacta de componentes del servidor y los números de pieza de las GPU que funcionarán juntas.
Identificar la tarjeta antes de elegir el chasis
Los nombres de familia ocultan diferencias importantes. H100 PCIe, H100 NVL y H100 SXM no son intercambiables. Las tarjetas de consumo basadas en una misma GPU también pueden variar en longitud, anchura, disipador y posición de los conectores. Estas diferencias determinan si caben, si dejan utilizables las ranuras adyacentes y si el servidor puede evacuar su calor.
Las tarjetas pasivas dependen del servidor para forzar aire a través de sus disipadores. Muchas tarjetas de consumo usan refrigeración abierta, diseñada para mover aire dentro de una caja de sobremesa. Tener ventilador propio no hace automáticamente adecuada una tarjeta para un chasis de rack muy denso. Hay que comprobar el recorrido del aire, las condiciones de entrada, el espacio alrededor de los conectores y el necesario para colocar los cables de forma segura.
Una tarjeta que ocupa tres o cuatro ranuras puede bloquear tanto otra posición de GPU como una tarjeta de red esencial. La guía de tipos de GPU explica las categorías generales, pero la compatibilidad física siempre depende del número de pieza real.
Leer la topología PCIe
Los dispositivos PCIe suelen poder negociar una generación de enlace compatible con ambos extremos, pero eso no implica que el fabricante haya validado la tarjeta en ese servidor. Una ranura físicamente x16 también puede tener menos líneas eléctricas, o estar disponible únicamente con determinada CPU o tarjeta elevadora instalada.
Hay que preguntar cómo se conecta cada GPU a las CPU y si comparte un enlace ascendente mediante un conmutador PCIe. En un servidor de dos zócalos, debe registrarse a qué CPU pertenece cada GPU y cada tarjeta de red. Esto importa cuando la aplicación transfiere datos entre GPU, descarga trabajo a CPU o utiliza recorridos de almacenamiento y red que dependen del tráfico PCIe.
Los diagramas de bloques del fabricante describen la topología prevista. En un sistema NVIDIA configurado, nvidia-smi topo -m ayuda a inspeccionar las relaciones visibles entre dispositivos. Conviene comparar esa salida con el diseño propuesto y probar las transferencias que realmente hace la aplicación. La comparación PCIe/SXM explica cuándo aporta valor una interconexión de GPU más rápida.
Dimensionar la alimentación para el funcionamiento completo
Sumar las potencias nominales de las GPU no basta para dimensionar un servidor. Las CPU, la memoria, los discos, las tarjetas de red y los ventiladores también consumen energía. Deben incluirse los límites de funcionamiento previstos, la demanda transitoria, la eficiencia de las fuentes y la política de redundancia.
Una configuración anunciada con fuentes redundantes puede no conservar toda la capacidad de cálculo si falla una fuente o una entrada de alimentación. Hay que preguntar si la configuración ofertada mantiene la carga exigida en la condición de fallo especificada o si debe reducir la potencia de las GPU. La instalación eléctrica del rack debe sostener las mismas hipótesis.
Los cables de alimentación y los kits de habilitación de GPU forman parte de la configuración. Sus conectores, capacidades y recorridos deben aparecer en la lista de materiales. Son componentes necesarios del sistema, no accesorios que resolver cuando lleguen las tarjetas.
La refrigeración debe funcionar bajo carga sostenida
Hay que comprobar el kit de refrigeración admitido por el fabricante, los límites de temperatura ambiente y las reglas de ocupación de tarjetas. Una configuración puede admitir una GPU únicamente por debajo de cierta temperatura de entrada, o con una disposición concreta de ventiladores, disipadores y paneles de cierre.
La refrigeración líquida añade trabajo de integración: distribución de refrigerante o radiadores, bombas, mantenimiento y gestión de fallos. Refrigerar el encapsulado de la GPU no elimina la necesidad de refrigerar la memoria, los reguladores de tensión y los demás componentes. La solución elegida debe cubrir el sistema completo.
Las pruebas de aceptación deben demostrar que el servidor mantiene la carga prevista sin reducciones inaceptables de rendimiento por temperatura o potencia. Una demostración breve que carga el modelo y produce una respuesta no acredita un funcionamiento estable en producción.
Proporcionar los recursos anfitriones que utiliza la aplicación
No hay una proporción fija de núcleos de CPU o RAM por GPU adecuada para todas las cargas. La tokenización, la decodificación de imágenes, el aumento de datos, la recuperación, las cachés y la descarga de trabajo a CPU pueden cambiar esos requisitos. Conviene comenzar con una ejecución representativa y medir los recursos utilizados por el número previsto de trabajos concurrentes.
El almacenamiento necesita una distinción similar entre sistema operativo, espacio temporal local y conjuntos de datos o puntos de control persistentes. La red debe soportar después el movimiento real de esos datos. Elegir por costumbre una red de 10, 100 o 400 Gb/s deja sin responder la pregunta principal: qué tráfico debe atravesarla y en qué momento. La ejecución distribuida también puede exigir una configuración RDMA adecuada y una sobresuscripción de red aceptable. La guía de la plataforma de servidor desarrolla estos componentes.
Usar las tablas para seleccionar candidatos
El número máximo de GPU anunciado por un fabricante o una tabla comparativa pueden reducir las alternativas. Ninguno certifica la configuración final. Programas como NVIDIA-Certified Systems son referencias útiles, pero la combinación admitida puede depender de la CPU, el firmware, las tarjetas elevadoras, los puentes de GPU, los adaptadores de almacenamiento, las fuentes y los kits de refrigeración.
| Antes de hacer el pedido | Evidencia que debe solicitarse |
|---|---|
| Configuración exacta del hardware | Referencias del servidor y de las GPU, kits, cables, tarjetas elevadoras y disposición de fuentes |
| Compatibilidad oficial | Configuración admitida por el fabricante o confirmación escrita que cubra la lista propuesta de componentes |
| Topología de dispositivos | Diagrama CPU/GPU/red, número de líneas PCIe y enlaces ascendentes compartidos de los conmutadores |
| Software y firmware | Versiones propuestas de BIOS, BMC, controlador de GPU y motor de ejecución |
| Funcionamiento sostenido | Límites de potencia, condiciones de entrada de aire y carga de aceptación previstos |
| Ampliación futura | Piezas adicionales y reglas de ocupación admitidas para la ampliación prevista |
El mismo criterio debe aplicarse al comparar DGX, HGX y sistemas PCIe convencionales. Una familia de productos no constituye una lista completa de componentes.
Acordar las pruebas de aceptación antes de la entrega
Una prueba práctica de aceptación puede durar entre 24 y 72 horas, según el despliegue y el acuerdo de soporte. Debe utilizar la aplicación real junto con comprobaciones específicas del hardware. Conviene registrar temperatura, comportamiento de las frecuencias, límites de potencia, enlaces PCIe negociados y errores PCIe AER, NVIDIA Xid o ECC pertinentes. Si la carga abarca varias GPU, la prueba debe incluir su patrón de comunicación y sus operaciones colectivas.
Si el sistema está diseñado para mantener el servicio tras el fallo de una fuente o alimentación, debe incluirse una prueba controlada de esa situación conforme al procedimiento operativo acordado. Hay que verificar que el rendimiento útil y el comportamiento eléctrico coinciden con lo prometido en la oferta.
Los criterios de aceptación deben definirse antes de la entrega. El resultado relevante es una configuración estable, con soporte, que cumpla los objetivos de la carga. Ese acuerdo deja explícita la responsabilidad de integración y evita descubrir después de la instalación que un conjunto de piezas nominalmente compatibles todavía necesita mucho trabajo de ingeniería.