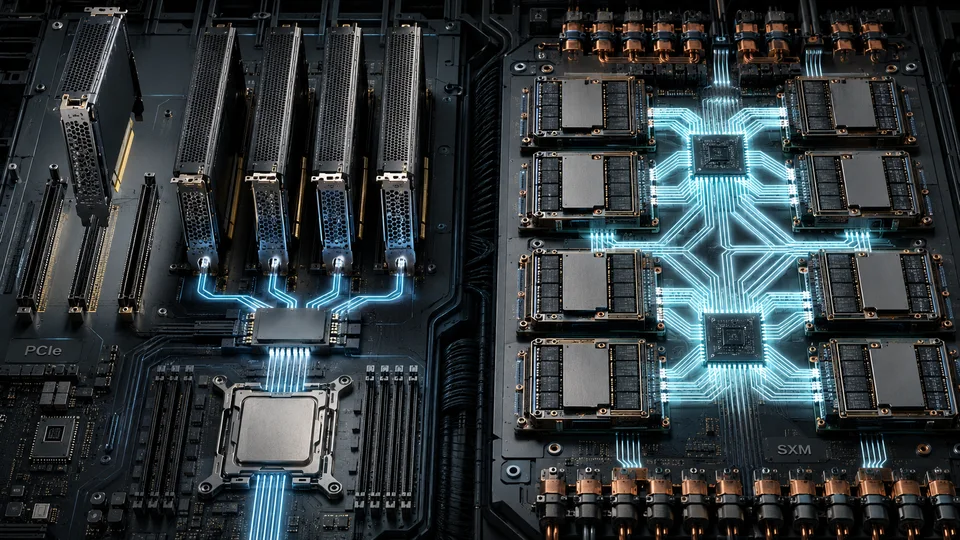
Dos sistemas pueden llevar GPU de la misma familia y comportarse de manera muy distinta. La diferencia puede estar en la variante de GPU, su límite de potencia, su memoria o los enlaces que la conectan con otras GPU. Comparar PCIe y SXM exige, por tanto, comparar configuraciones completas, además de los conectores.
Una tarjeta frente a una plataforma integrada
Una GPU PCIe es una tarjeta de expansión instalada en un servidor o estación de trabajo compatible. SXM es el formato de módulo de NVIDIA para GPU montadas sobre una placa base específica. Un módulo SXM no se puede insertar en una ranura PCIe: necesita una plataforma diseñada para él, incluida su alimentación y refrigeración.
En los sistemas HGX H100 y H200 de ocho GPU, los módulos SXM se comunican mediante NVLink y NVSwitch. Esto proporciona una red de interconexión de gran ancho de banda dentro del servidor. Su valor depende de si la carga de trabajo realmente mueve grandes cantidades de datos entre GPU.
Algunas variantes PCIe también admiten puentes NVLink. El número de GPU y la disposición de los puentes compatibles dependen del producto y de la configuración del servidor. No debe suponerse que toda tarjeta PCIe admite NVLink ni que una pareja conectada por un puente ofrece la misma topología que una placa HGX de ocho GPU. Cuando las GPU se comunican por PCIe, también importan la conexión con las CPU, los conmutadores PCIe y la distribución NUMA.
Cuándo compensa una comunicación rápida entre GPU
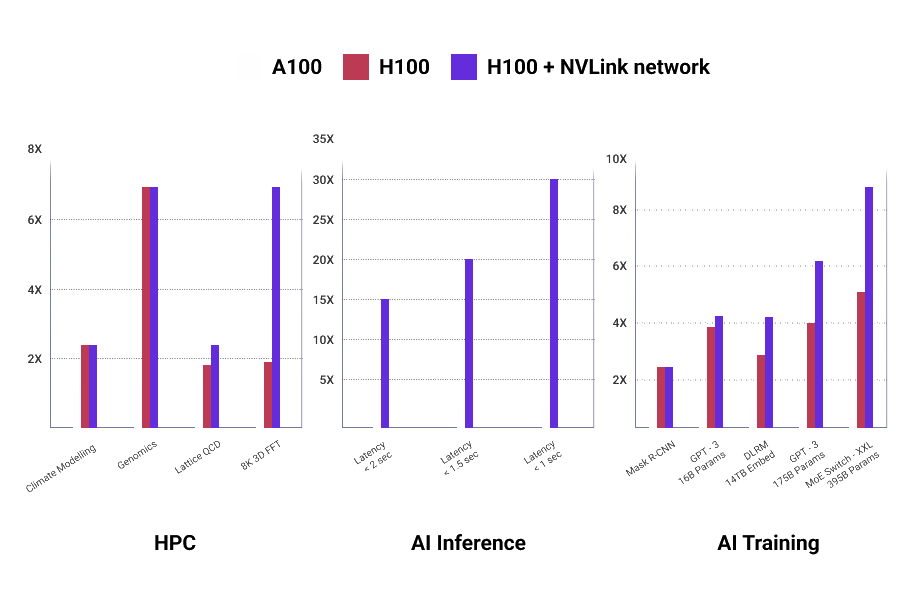
Un modelo grande repartido entre varias GPU puede necesitar comunicación frecuente durante el entrenamiento o la inferencia. En esas condiciones, reducir el tiempo de comunicación puede mejorar considerablemente la utilidad de cada GPU adicional. Conviene evaluar una plataforma SXM integrada cuando las mediciones identifican esa comunicación como un cuello de botella.
Las tareas independientes plantean otra situación. Si ocho usuarios ejecutan cada uno un modelo en una GPU distinta, sus trabajos pueden compartir pocos datos, o ninguno, a través de la interconexión entre GPU. Pueden beneficiarse de un servidor denso sin aprovechar mucho NVSwitch. La comparación de servidores DGX, HGX y PCIe distingue el valor de la interconexión del valor del sistema completo y sus servicios de soporte.
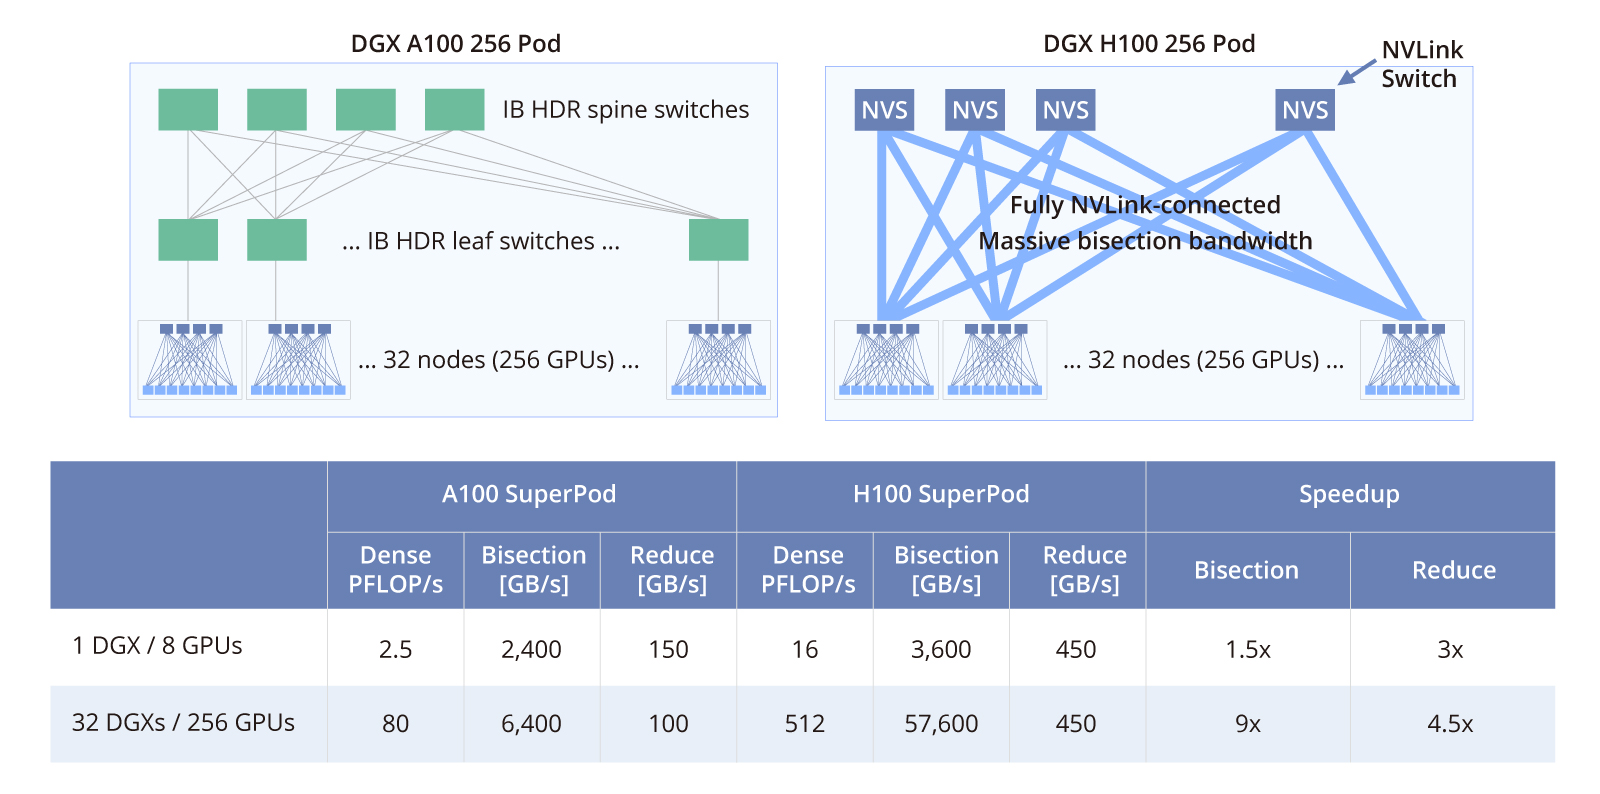
Importa delimitar la interconexión. En los sistemas H100 y H200 tratados aquí, NVSwitch conecta las GPU dentro de un nodo. La comunicación entre servidores también requiere una red de cómputo, tarjetas de red adecuadas y software configurado para utilizarlas. La arquitectura de referencia DGX SuperPOD de NVIDIA describe por separado las redes de cómputo, almacenamiento y gestión. Los sistemas NVLink a escala de rack de otras generaciones deben evaluarse según su propia arquitectura; su topología no se puede deducir de este ejemplo de ocho GPU.
Ampliación y utilización
A menudo se puede adquirir un servidor PCIe compatible con menos GPU y ampliarlo más adelante. Esa flexibilidad resulta útil cuando la demanda crece gradualmente, los usuarios necesitan distintos tipos de tarjeta o aún se está caracterizando la carga de trabajo. La ampliación sigue dependiendo de la configuración aprobada del servidor: puede ser necesario especificar desde el principio las fuentes de alimentación, las tarjetas elevadoras, los kits de refrigeración y las combinaciones de GPU admitidas.
Un sistema SXM integrado concentra una mayor parte de la inversión inicial. La estandarización puede simplificar la operación del conjunto de equipos, pero las GPU inactivas y la capacidad de interconexión sin utilizar siguen siendo costes reales. Antes de elegirlo, hay que medir si la aplicación escala eficazmente de una o dos GPU a cuatro y ocho.
Memoria y potencia: comparar las variantes exactas
La H100 PCIe original de 80 GB utiliza HBM2e, según la ficha de producto H100 PCIe de NVIDIA. La H100 SXM de 80 GB utiliza HBM3. La hoja de datos H100 indica anchos de banda nominales de memoria de aproximadamente 2 TB/s y 3,35 TB/s, respectivamente. H100 NVL es otra configuración; sus especificaciones no deben sustituir a las de la tarjeta PCIe de 80 GB.
El límite de potencia también cambia: la H100 PCIe de 80 GB llega a 350 W, mientras que las configuraciones H100 SXM pueden alcanzar 700 W por GPU. El servidor debe estar diseñado para el punto de funcionamiento elegido. Estas cifras, por sí solas, no determinan la eficiencia energética. Una GPU de mayor potencia puede terminar antes una tarea adecuada; otra poco utilizada puede consumir más energía sin acortar suficientemente la ejecución. Hay que medir la energía y el coste por tarea completada, además del tiempo transcurrido.
La capacidad y el ancho de banda de memoria, así como la capacidad de cálculo, pueden cambiar entre variantes y generaciones. El soporte de formatos numéricos añade otra dimensión: INT8 y FP8 en la práctica explica por qué una especificación de hardware no garantiza una vía de ejecución utilizable.
Ajustar la plataforma al patrón de comunicación
| Característica de la carga | Qué evaluar primero |
|---|---|
| Tareas independientes de inferencia, desarrollo o análisis | Tarjetas PCIe con suficiente memoria y una configuración anfitriona adecuada |
| Un modelo que cabe en una o dos GPU | La configuración compatible más sencilla que cumpla los objetivos de latencia y rendimiento |
| Entrenamiento o inferencia con mucha comunicación entre varias GPU | SXM/HGX junto con alternativas PCIe medidas |
| Computación científica distribuida | El patrón real de comunicación, los requisitos numéricos y la eficiencia de escalado de la aplicación |
| Un trabajo repartido entre varios servidores | La arquitectura completa de red y almacenamiento, además de la interconexión de GPU |
Las etiquetas de aplicación son demasiado amplias para decidir la plataforma. La imagen médica, los modelos de lenguaje y la computación científica pueden incluir tanto tareas independientes como trabajos estrechamente acoplados. Hay que partir del modelo y de su patrón de ejecución, medir el cuello de botella y calcular después el coste del hardware que lo elimina. Para una selección PCIe, continúe con cómo elegir el servidor adecuado para la tarjeta.