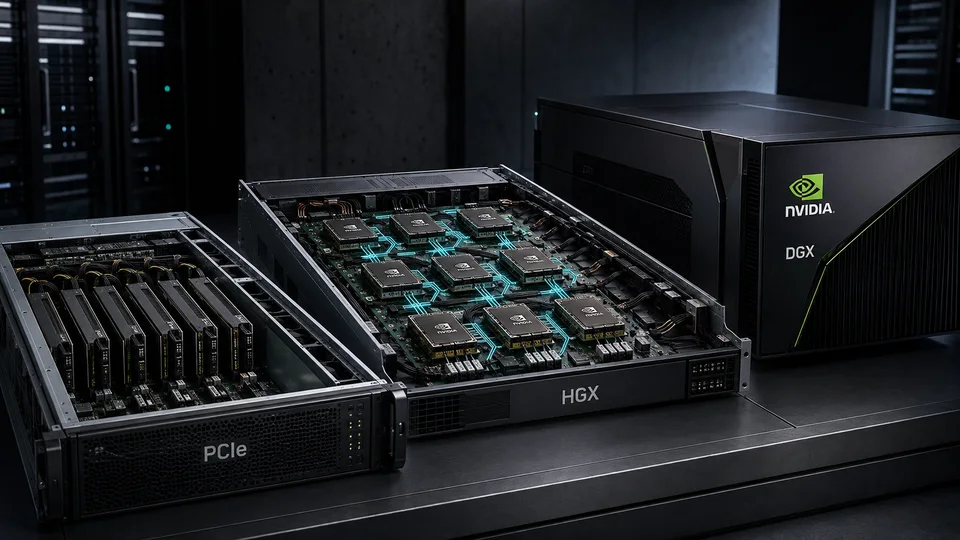
A veces se utiliza DGX como si fuera el nombre técnico de cualquier servidor potente con GPU. Esa confusión puede convertirse en un error de compra costoso. El comprador puede esperar una capacidad de cálculo de otra categoría, cuando buena parte de esa capacidad procede de una plataforma HGX que también está disponible en servidores de otros fabricantes. El valor adicional de DGX está en el producto completo: integración, software, validación y servicios.
La distinción resulta especialmente útil para equipos que sirven modelos de pesos abiertos, construyen sistemas de generación aumentada por recuperación o amplían su capacidad gradualmente. Deben determinar tanto si necesitan una plataforma con varias GPU estrechamente conectadas como si pueden aprovechar los servicios que se venden con ella.
Precisar qué incluye la oferta
| Opción | Qué es | Valor principal |
|---|---|---|
| DGX | Un sistema completo de marca NVIDIA con hardware, DGX OS, firmware, herramientas de gestión y soporte integrado | Una configuración validada y un modelo coordinado de operación y soporte |
| HGX | Una plataforma de cómputo con varias GPU integrada en un servidor de otro fabricante; en los ejemplos H100/H200 de este artículo, GPU SXM, placa base, NVLink y NVSwitch | Comunicación rápida entre GPU para trabajos repartidos entre varios aceleradores |
| Servidor de GPU PCIe | Un chasis de servidor equipado con tarjetas de expansión PCIe | Flexibilidad en el número y tipo de tarjetas, con opciones de crecimiento gradual |
La guía de usuario DGX H100/H200 describe un sistema de ocho GPU con CPU, memoria, almacenamiento, red y cuatro NVSwitch. Un servidor de otro fabricante basado en la plataforma HGX equivalente de ocho GPU puede ofrecer la misma clase de interconexión interna. Hay que comparar configuraciones completas, pero el nombre DGX no permite tratarlo como un HGX más rápido.
Parte de lo que se adquiere con DGX es una lista de componentes probada, firmware, diagnósticos, supervisión y un proceso definido de instalación y soporte. Los recursos de software DGX describen DGX OS como una distribución Ubuntu personalizada y explican que también se pueden instalar componentes del entorno de software sobre sistemas Ubuntu o Red Hat estándar. La justificación económica de DGX depende del valor de esa combinación probada y respaldada.
Un catálogo de modelos no basta para justificar el sistema
A veces se propone el acceso a modelos y herramientas de NVIDIA como motivo para comprar DGX. Ese argumento mezcla productos y derechos de uso distintos. El catálogo público NGC incluye contenedores, modelos, SDK y otros recursos. NVIDIA AI Enterprise añade una oferta comercial de software y soporte cuyas condiciones de licencia deben evaluarse por separado.
La guía de licencias de NVIDIA enumera suscripciones de cinco años a AI Enterprise con las GPU H100 PCIe, H100 NVL y H200 NVL. Siguen siendo relevantes la activación y las condiciones aplicables a la GPU y al sistema certificado. Esto no significa que cualquier producto llamado H100 o H200 dé acceso ilimitado a todos los modelos, ni que DGX sea la única vía para obtener una suscripción incluida. La oferta debe confirmar la referencia exacta, los derechos de uso, la fecha de inicio y la elegibilidad para soporte.
Un equipo que trabaja con modelos de pesos abiertos como Llama, Qwen o Mistral quizá ya pueda obtener el modelo en un repositorio público bajo su propia licencia. Un contenedor optimizado o un motor de ejecución con soporte puede reducir el trabajo de instalación y mantenimiento, pero poseer un DGX no es un requisito general para acceder a esos pesos.
La pregunta útil es concreta: ¿qué componente de la oferta comercial de software y soporte reducirá el coste operativo, el tiempo de despliegue o el riesgo del servicio de este equipo? Una lista extensa de productos no lo demuestra. Si el servicio ya utiliza un motor de código abierto y herramientas internas, la sustitución propuesta necesita un beneficio verificable.
La disponibilidad de los servicios forma parte de la misma evaluación. Los requisitos de registro, la cobertura del soporte, el acceso a actualizaciones y el procedimiento práctico de devolución del hardware pueden variar según el proveedor y el despliegue. Un servicio que no se puede activar o utilizar aporta poco valor operativo. Incluso cuando todos los servicios están disponibles, pagar por uno que el equipo no necesita requiere justificación.
HGX también necesita una carga de trabajo que lo justifique
Elegir un sistema HGX de otro fabricante en lugar de DGX no hace automáticamente adecuada la inversión. Su principal ventaja de hardware es la interconexión de gran ancho de banda dentro del servidor. Resulta útil cuando un modelo o un trabajo de entrenamiento se reparte entre GPU y las operaciones colectivas mueven cantidades importantes de datos.
Ocho tareas independientes, cada una en una GPU, pueden aprovechar poco NVSwitch. De igual modo, servir un modelo que cabe holgadamente en una o dos GPU quizá no se beneficie lo suficiente de una interconexión de ocho aceleradores para justificar su coste adicional. El resultado depende del tamaño del modelo, la concurrencia, la latencia exigida y el motor de ejecución, además del tipo de aplicación.
Entornos como PyTorch y vLLM, y bibliotecas de comunicación como NCCL, ofrecen mecanismos de ejecución con varias GPU. Escalar de forma rentable sigue requiriendo una estrategia de paralelismo adecuada, configuración de lotes, asignación de GPU y mediciones. Que el programa arranque en ocho GPU aporta menos evidencia que una mejora útil del coste por trabajo completado o solicitud atendida.
Cruzar el límite entre servidores añade otra capa. En las configuraciones H100/H200 de este artículo, NVSwitch proporciona la interconexión interna. La ejecución multinodo también necesita tarjetas de red adecuadas, una red de cómputo, almacenamiento y ajuste del software. La arquitectura de referencia DGX SuperPOD trata estos elementos como partes diferenciadas del despliegue. El entrenamiento distribuido a gran escala y algunas cargas de HPC pueden justificar la inversión; instalar los cables y conmutadores necesarios no hará que las tareas independientes escalen entre nodos.
Elegir en dos etapas
Para inferencia, desarrollo, RAG y ajuste fino limitado, un servidor PCIe ampliable suele ser una buena configuración de partida para las pruebas. Conviene evaluar HGX cuando el trabajo real necesita los recursos combinados de varias GPU y la comunicación entre ellas afecta de forma importante al tiempo de ejecución. Hay que medir las configuraciones propuestas, incluida la eficiencia al pasar de dos GPU a cuatro y ocho.
Después se evalúa por separado la oferta del sistema completo. Se compara DGX con alternativas de otros fabricantes que dispongan de soporte, considerando instalación, mantenimiento, derechos de software, cobertura del soporte y diferencia de precio. La guía de la plataforma anfitriona trata los requisitos de CPU, almacenamiento y red que deben figurar en ambas ofertas.
La compra se justifica cuando la carga aprovecha el hardware y el equipo de operación utiliza los servicios. Comprobar ambas partes por separado permite defender mejor la decisión que elegir primero una gama de producto y buscar después una razón para comprarla.