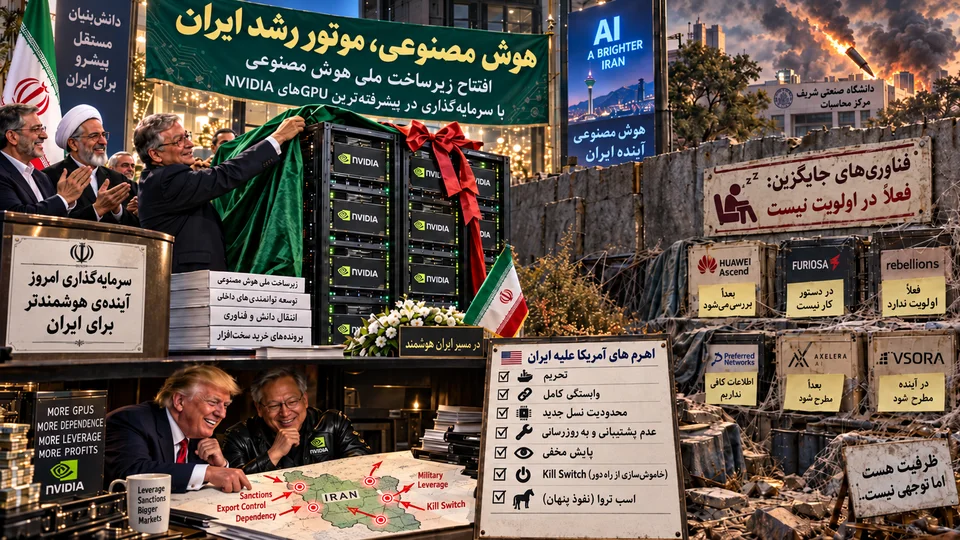
از Ascend چینی تا شتابدهندههای کرهای، ژاپنی و اروپایی؛ آیا منطقی است زیرساخت ملی هوش مصنوعی را به یک شرکت، یک پشته نرمافزاری و کشوری گره بزنیم که هر روز دامنه تحریم را افزایش میدهد؟
در کشوری که تحریم یک اتفاق موقت نیست و سالهاست با آن، دسترسی به فناوریهای پیشرفته همواره میتواند محدودتر شود و تجربه جنگ نیز نشان داده است که زنجیره تأمین را نمیتوان یک متغیر حاشیهای در طراحی زیرساخت ملی فرض کرد، عجیب است اگر راهبرد محاسبات هوش مصنوعی را همچنان با یک پیشفرض ساده آغاز کنیم: GPU یعنی NVIDIA.
هر بار درباره تنوعبخشی زیرساخت محاسباتی صحبت میشود، یک پاسخ آماده وجود دارد: «مگر جایگزینی هم برای NVIDIA هست؟» پاسخ چند سال پیش شاید چندان ساده نبود. امروز سادهتر است: بله، هست.
البته منظور این نیست که Huawei، Furiosa، Rebellions یا هر شتابدهنده دیگری در تمام کاربردها از NVIDIA بهتر باشند؛ چنین ادعایی نه دقیق است و نه لازم. NVIDIA امروز در بخش مهمی از آموزش مدلهای بزرگ، زیستبوم نرمافزاری، ارتباط بین شتابدهندهها و بلوغ ابزارها مزیتی جدی دارد. اما گزاره معکوس از آن نتیجه نمیشود.
مشکل NVIDIA نیست؛ مشکل، NVIDIA-only شدن زیرساخت ملی است.
وقتی کشوری از ابتدا در معرض تحریمهای مختلف از جمله فناوری قرار دارد، منطقی نیست میلیاردها دلار زیرساختی ایجاد کند که توسعه، نگهداری و گسترش آن در آینده به اراده همان حوزه قضایی وابسته باشد که دسترسی او را محدود کرده است. نکته مهم ماجرا این است که NVIDIA محصول و اکوسیستم چنان خوبی ساخته که یک انتخاب فنی بهتدریج میتواند به وابستگی راهبردی تبدیل شود.
جهان پردازندههای هوش مصنوعی فقط NVIDIA نیست
در ادبیات رایج داخل کشور، بازار شتابدهندههای هوش مصنوعی تقریباً به NVIDIA تقلیل یافته است. AMD نیز با خانواده Instinct و ROCm بازیگر جدی این بازار است و حضورش در MLPerf نشان میدهد نمیتوان آن را بازیگری نابالغ تلقی کرد؛ بااینحال از منظر ایران، جایگزینکردن NVIDIA آمریکایی با AMD آمریکایی مسئله اصلی تابآوری در برابر محدودیتهای آمریکا را حل نمیکند.
اما بیرون از این دو اکوسیستم، بازار بهسرعت در حال تغییر است. Huawei در چین خانواده Ascend را توسعه داده و دیگر صحبت از یک تراشه منفرد نیست. CANN، ابزارهای توسعه، کتابخانههای ارتباطی، SuperPoD و interconnect اختصاصی در حال شکلدادن یک پشته کامل سختافزاری و نرمافزاری هستند.
فاصله سختافزاری نیز دیگر آن چیزی نیست که چند سال قبل بود. این به معنی برابری Ascend با جدیدترین محصولات NVIDIA نیست؛ NVIDIA در توان تکشتابدهنده، اکوسیستم و بسیاری از بارهای کاری همچنان جلوتر است. اما:
Ascend و برخی شتابدهندههای غیر NVIDIA به سطحی از بلوغ رسیدهاند که کنارگذاشتن آنها بدون آزمون فنی دیگر قابل دفاع نیست
Huawei در نسلهای جدید Ascend 950 و سیستمهای مبتنی بر آن، علاوه بر افزایش توان محاسباتی، روی پهنایباند اتصال میان NPUها، حافظه و امکان scale-out تمرکز کرده است. در نسل جدید، CANN نیز به سمت توسعه بازتر حرکت کرده است.
اما نکته مهم اینکه چین تنها بازیگر این میدان نیست.
| کشور | نمونه | تمرکز اصلی | نکته مهم |
|---|---|---|---|
| چین | Huawei Ascend 910C / 950 | آموزش و استنتاج | کاملترین اکوسیستم غیرآمریکایی در مقیاس دیتاسنتر |
| کره جنوبی | FuriosaAI RNGD | استنتاج | 48GB HBM3، پهنایباند 1.5TB/s، مصرف حدود 180W |
| کره جنوبی | Rebellions REBEL-Quad | استنتاج LLM | 144GB HBM3E، پهنایباند 4.8TB/s و پشتیبانی اعلامشده از PyTorch، vLLM و Triton |
| ژاپن | Preferred Networks MN-Core | آموزش، HPC و استنتاج | معماری اختصاصی؛ سختافزار، compiler و cloud اختصاصی |
| هلند | Axelera AI Europa | استنتاج | معماری اروپایی برای edge، enterprise و datacenter |
| فرانسه | VSORA Jotunn8 | استنتاج | تمرکز بر LLM inference با توان و هزینه عملیاتی پایین |
Ascend نزدیکترین رقیب غیر آمریکایی
در میان گزینههای غیرآمریکایی، Huawei Ascend را باید جدا از بسیاری از نمونههای نوظهور دید؛ این خانواده دیگر یک پروژه در مرحله اثبات مفهوم نیست و چند نسل سختافزار، زیرساخت خوشهای و اکوسیستم نرمافزاری عملیاتی پشت آن قرار دارد. Ascend 910B مبنای نسل A2 و Ascend 910C مبنای نسل A3 و سامانههایی مانند Atlas 900 A3 و CloudMatrix 384 قرار گرفتهاند. خود Huawei در سال ۲۰۲۵ از استقرار مقیاسپذیر 910C خبر داده بود و در سپتامبر ۲۰۲۶ نیز China Unicom اعلام کرد زیرساخت Ascend و SuperPoDهای ۳۸۴ کارتی را در مقیاس تجاری مستقر کرده است.
نکته مهم این است که مزیت Ascend را نباید الزاماً در مقایسه یک تراشه با یک GPU انویدیا جستوجو کرد. تحلیل SemiAnalysis از CloudMatrix 384 نشان میدهد هر Ascend 910C بهتنهایی از Blackwell ضعیفتر است، اما Huawei با اتصال ۳۸۴ شتابدهنده در یک معماری all-to-all، مسئله را در سطح سیستم حل کرده است. برآورد SemiAnalysis برای این سامانه حدود ۳۰۰ پتافلاپس BF16 متراکم در برابر حدود ۱۸۰ پتافلاپس برای GB200 NVL72، بیش از ۳.۶ برابر ظرفیت کل حافظه و حدود ۲.۱ برابر پهنایباند تجمیعی حافظه است. البته این برتری سیستمی بدون هزینه نیست: همان تحلیل مصرف برق CloudMatrix 384 را حدود ۴.۱ برابر NVL72 و کارایی محاسباتی آن به ازای وات را حدود ۲.۵ برابر ضعیفتر برآورد میکند. بنابراین Ascend نمونه خوبی از همان اصلی است که در این یادداشت بر آن تأکید میشود: مقایسه شتابدهندهها را نمیتوان فقط به FLOPS یک تراشه تقلیل داد؛ معماری سیستم، حافظه، interconnect، توان و هزینه بهرهبرداری همگی در نتیجه نهایی دخیلاند.
نسل جدید Ascend این فاصله را در سطح خود تراشه نیز هدف گرفته است. Huawei برای خانواده Ascend 950 دو گونه متفاوت طراحی کرده: 950PR برای مرحله Prefill و بارهای recommendation و 950DT برای Decode و Training. برای 950DT ظرفیت ۱۴۴ گیگابایت حافظه با پهنایباند ۴ ترابایت بر ثانیه، پهنایباند interconnect برابر ۲ ترابایت بر ثانیه و حدود ۱ پتافلاپس FP8 اعلام شده است. این تفکیک Prefill و Decode نیز قابل توجه است؛ Huawei بهجای طراحی یک تراشه واحد برای همه مراحل استنتاج، سختافزار را بر اساس تفاوت ماهوی بارکاری این دو مرحله تفکیک کرده است.
اکوسیستم نرمافزاری آن نیز نسبت به نسلهای اول Ascend تغییر محسوسی کرده است. vLLM Ascend امروز خانوادههای Atlas A2 و A3 و محصولات مبتنی بر 950DT را پشتیبانی میکند و در ماتریس فعلی آن مدلهایی مانند DeepSeek-V3.1، DeepSeek V4 و GLM-5.1 برای 950DT و مجموعه بزرگی از مدلهای Qwen، Llama، Mistral و دیگر خانوادهها برای A2/A3 قرار گرفتهاند. Huawei نیز در سپتامبر ۲۰۲۶ اعلام کرد Ascend اکنون در بیش از ۹۰ پروژه متنباز مهم حضور دارد و بهعنوان backend شتابدهنده در PyTorch پشتیبانی میشود. بنابراین یکی از مهمترین تفاوتهای Ascend امروز با بسیاری از رقبای نوظهور، وجود یک stack نسبتاً کامل از سختافزار تا CANN، PyTorch و موتورهای استنتاجی مانند vLLM است.
فراتر از چین و آمریکا
RNGD کرهای یک طرح دانشگاهی یا محصول در مرحله نمونهسازی نیست. Furiosa آن را بهطور مشخص برای استنتاج LLM، مدلهای چندوجهی و بارهای Agentic توسعه داده و از ژانویه ۲۰۲۶ وارد تولید انبوه کرده است. نخستین محموله ۴۰۰۰ واحدی آن از زنجیره تولید TSMC و ASUS تحویل شده و محصول اکنون هم بهصورت کارت PCIe و هم سرور آماده عرضه میشود. RNGD علاوه بر استقرار در LG AI Research، از ژوئیه ۲۰۲۶ مبنای سرویس تجاری NPU-as-a-Service سامسونگ SDS نیز قرار گرفته است. این شتابدهنده ۴۸ گیگابایت HBM3 و پهنایباند حافظه ۱.۵ ترابایت بر ثانیه دارد. Furiosa نیز در آزمون Qwen3-32B خود گزارش کرده که در محدوده سرویسدهی ۲۰ تا ۴۰ توکن بر ثانیه به هر کاربر، RNGD به ازای هر کیلووات میتواند حدود ۱.۸ تا ۲ برابر کاربران بیشتری نسبت به RTX Pro 6000 سرویس دهد. بنابراین با محصولی مواجهیم که از مرحله PoC عبور کرده و اکنون در استقرارهای تجاری واقعی قرار دارد.
Rebellions، شرکت دیگر کرهای، برای REBEL-Quad ظرفیت ۱۴۴ گیگابایت HBM3E با پهنایباند ۴.۸ ترابایت بر ثانیه اعلام کرده و در مستندات خود پشتیبانی از PyTorch 2.x، vLLM و Triton را ذکر کرده است. REBEL-Quad نیز صرفاً یک برنامه پژوهشی نیست: تراشه ساخته شده، در ISSCC 2026 بهصورت زنده روی سختافزار واقعی نمایش داده شده و Rebellions اعلام کرده مرحله نهایی اعتبارسنجی پیش از تجاریسازی را پشت سر گذاشته است. این شرکت در سال ۲۰۲۶ تولید انبوه REBEL-Quad را آغاز کرده و عرضه آن به مشتریان جهانی را در برنامه تجاری خود قرار داده است. در عین حال، نسل قبلی این شرکت یعنی ATOM پیش از آن وارد تولید انبوه شده و در کره، ژاپن، عربستان و آمریکا بهکار گرفته شده است؛ بنابراین REBEL-Quad ادامه یک مسیر سختافزاری و تجاری موجود است، نه نخستین تلاش شرکت برای ورود به بازار.
در ژاپن، Preferred Networks از سالها قبل خانواده MN-Core را توسعه داده است. نسل MN-Core 2 از سال ۲۰۲۴ بهصورت سرور و workstation عرضه شده و توان پردازشی آن از طریق سرویس ابری Preferred Computing Platform نیز در دسترس قرار گرفته است. در سپتامبر ۲۰۲۶ نیز Preferred Networks اعلام کرد MN-Core 2 را برای برخی بارهای محاسباتی سرویس Matlantis به کار خواهد گرفت. نسل بعدی، یعنی MN-Core L، مشخصاً برای استنتاج مدلهای مولد و با تمرکز بر پهنایباند بسیار بالای حافظه طراحی شده است. این نسل هنوز در حال توسعه است و عرضه مدلهای اولیه آن برای ۲۰۲۷ برنامهریزی شده، اما توسعه آن تنها درون شرکت انجام نمیشود: Toyota در سال جاری پژوهش مشترکی را با Preferred Networks آغاز کرده تا MN-Core L را برای استنتاج Physical AI و سامانههای رباتیک ارزیابی کند و پس از آغاز عرضه تراشه، آزمونهای واقعی روی رباتها انجام دهد. در نتیجه ژاپن همزمان نمونهای از یک زنجیره بالغ موجود (MN-Core 2) و سرمایهگذاری روی نسل بعدی شتابدهندههای بومی را نشان میدهد.
در اروپا نیز وضعیت دیگر صرفاً در حد طرحهای تحقیقاتی نیست. Axelera AI هلند در سپتامبر ۲۰۲۶ Europa را برای کاربردهای enterprise، datacenter و Physical AI وارد بازار کرده است. Europa اکنون بهصورت تراشه و کارتهای PCIe عرضه میشود و Axelera سیستمهای مبتنی بر آن را با Dell و Supermicro اعتبارسنجی و وارد زنجیره عرضه کرده است. این شرکت علاوه بر Europa، نسل قبلی خود یعنی Metis را نیز پیش از این در صدها استقرار مشتری در حوزههای مختلف بهکار گرفته بود.
VSORA فرانسه نیز روی Jotunn8 بهعنوان شتابدهندهای ویژه استنتاج دیتاسنتری کار میکند. Jotunn8 از مرحله طراحی عبور کرده و tape-out آن در اکتبر ۲۰۲۵ انجام شده است؛ مرحلهای که پایان طراحی و ورود تراشه به فرآیند ساخت را نشان میدهد. VSORA برای این محصول ۲۸۸ گیگابایت HBM3E و ۳۲۰۰ ترافلاپس توان محاسباتی اعلام کرده و اکنون در مسیر صنعتیسازی و افزایش تولید آن قرار دارد. بنابراین Jotunn8 را باید گزینهای در حال ورود به بازار دانست، نه محصولی با همان سابقه استقرار RNGD یا MN-Core 2.
سطح بلوغ این گزینهها یکسان نیست: RNGD وارد تولید انبوه و سرویس تجاری شده؛ REBEL-Quad وارد مرحله تولید و تجاریسازی شده؛ MN-Core 2 محصول عملیاتی است و MN-Core L نسل در حال توسعه آن؛ Europa اکنون در حال عرضه است؛ و Jotunn8 در مرحله گذار از ساخت سیلیکون به صنعتیسازی قرار دارد. همین تفاوتها برای تصمیم خرید مهماند و باید در ارزیابی فنی و تجاری لحاظ شوند.
اما کنار هم گذاشتن این محصولات قرار نیست ثابت کند همه آنها همین امروز همسطح NVIDIA هستند. نکته بسیار محدودتر و در عین حال مهمتر است: «GPU آمریکایی یا هیچ» دیگر توصیف درستی از بازار شتابدهندههای هوش مصنوعی نیست. اکنون میان یک ایده آزمایشگاهی، یک تراشه در حال صنعتیشدن و محصولی که هزاران واحد از آن تولید شده و در سرویس تجاری کار میکند، طیفی واقعی از گزینههای غیرآمریکایی وجود دارد؛ گزینههایی که دستکم ارزش ورود به مرحله ارزیابی و PoC را دارند.
حتی متحدان آمریکا هم همه تخممرغهایشان را در یک سبد نمیگذارند
ممکن است این بحث بهسرعت با برچسب «آمریکاستیزی» کنار گذاشته شود. اما کره جنوبی و ژاپن برای ما مثالهای جالبی هستند؛ دو کشور متحد امنیتی آمریکا که نه با NVIDIA مشکل سیاسی دارند، نه تحریم خرید GPU آمریکایی هستند. بااینحال، هر دو کشور در حال توسعه ظرفیتهای مستقل نیمههادی و شتابدهنده هوش مصنوعی هستند.
کره جنوبی همزمان میزبان Samsung و SK Hynix است و شرکتهایی مانند FuriosaAI و Rebellions را در اکوسیستم AI accelerator خود دارد. دولت این کشور نیز در بودجهٔ ۲۰۲۶، هوش مصنوعی را از محورهای اصلی سرمایهگذاری قرار داده و حمایت از توسعهٔ نیمههادیهای AI را نیز پیشبینی کرده است. ژاپن نیز علاوه بر سرمایهگذاری روی Rapidus برای تولید نیمههادی پیشرفته، در سیاست صنعتی خود «رقابتپذیری صنعتی» و «امنیت اقتصادی» را کنار هم قرار داده است.
پس مسئله ضدیت با آمریکا نیست. کشورهایی که بهترین روابط را با آمریکا دارند نیز فهمیدهاند که زنجیره ارزش نیمههادی و محاسبات AI آنقدر راهبردی است که نمیتوان همه ظرفیت کشور را به یک تولیدکننده یا یک معماری خارجی سپرد.
برای ایران، با سطح بسیار بالاتری از ریسک سیاسی و محدودیت تجاری، این اصل باید جدیتر باشد، نه کمرنگتر.
اما آیا واقعا این محصولات میتوانند با NVIDIA رقابت کنند؟
اینجا باید مراقب یک خطای دیگر باشیم. اعداد TOPS و TFLOPS روی بروشور را نمیتوان کنار هم گذاشت و برنده اعلام کرد. نوع precision، پهنایباند حافظه، interconnect، اندازه batch، معماری مدل، توان مصرفی و حتی کیفیت compiler میتواند نتیجه را عوض کند؛ این موضوع محدود به مقایسه میان Nvidia با سایر تولیدکنندگان نیست و همانطور که در INT8 یا FP8؛ پشتیبانی واقعی GPU در اجرای مدلهای زبانی توضیح دادهام حتی درون خانواده Nvidia هم برقرار است.
برای یک مدل زبانی بزرگ نیز «سرعت» یک عدد واحد نیست. حداقل باید TTFT، TPOT، throughput، تعداد کاربران همزمان، context length، مصرف انرژی و هزینه هر خروجی سنجیده شود؛ چرایی این تفکیک را در «چرا سریعترین GPU لزوماً سریعترین پاسخ را نمیدهد؟» با جزئیات بررسی کردهام.
یکی از معتبرترین تلاشهای جهانی برای مقایسه سختافزار، MLPerf است. نسخه Inference v6.1 در سپتامبر ۲۰۲۶ با ۳۰ submitter و ۱۲۰ سیستم منتشر شد و تلاش میکند سختافزارها را روی بارهای کاری استاندارد مقایسه کند. اما همین دادهها یک محدودیت مهم دارند: Huawei، Furiosa و Rebellions در میان گزارشهای این دوره نیستند. در MLPerf Training v6.0 نیز Huawei در فهرست شرکتکنندگان نیست. بنابراین امروز نمیتوان با صداقت جدولی ساخت، چند عدد از بروشور NVIDIA، Huawei و Furiosa را کنار هم گذاشت و نوشت «بر اساس benchmark جهانی، این یکی ۳۰ درصد بهتر است». راه درست این است که سه سطح مدرک را از هم جدا کنیم:
- Benchmark مستقل استاندارد؛
- آزمون قابل بازتولید ولی انجامشده توسط سازنده؛
- مشخصات اسمی سختافزار.
آموزش با استنتاج یکی نیست
یکی از خطاهای سیاستگذاری این است که نیاز محاسباتی کشور را با سختترین مسئله ممکن تعریف کنیم. اگر سؤال این باشد که «برای آموزش یک مدل مدل زبانی خیلی بزرگ چندصد میلیارد یا چندتریلیون پارامتری در یک کلاستر بزرگ چه چیزی بخریم؟»، پاسخ به احتمال قریب به یقین همچنان بهشدت به نفع NVIDIA است.
NVLink، NVSwitch، CUDA، NCCL، کتابخانههای بهینه، profiling، debugging و حجم تجربه عملیاتی موجود در جهان مزیتهایی نیستند که بتوان با خواندن جدول FLOPS نادیده گرفت.
اما چند درصد از بارکاری واقعی هوش مصنوعی کشور frontier pretraining خواهد بود؟بخش بزرگی از مصرف محاسباتی آینده، استنتاج است:
- اجرای مدلهای زبانی و چندوجهی
- RAG و جستوجوی سازمانی
- ترجمه و خلاصهسازی
- پردازش صوت و تصویر
- agentها
- مدلهای تخصصی سازمانی
- reranking و embedding
- و سرویسدهی مدلهایچند میلیارد پارامتری
در بسیاری از این بارهای کاری مهمترین سؤال دیگر این نیست که کدام تراشه بالاترین توان نظری FP8 را دارد. تفاوت نیازهای آموزش و استنتاج و اثر آن بر انتخاب سختافزار را در «نحوه انتخاب پردازنده گرافیکی برای هوش مصنوعی» نیز توضیح دادهام.
پس در واقع سوال اساسی این است: برای SLA مشخص، چند کاربر را با چه هزینه، چه برق، چه حافظه و چه میزان وابستگی میتوان سرویس داد؟
اگر یک شتابدهنده کرهای، چینی یا اروپایی بتواند یک بار کاری استنتاجی را با کیفیت قابل قبول و TCO بهتر اجرا کند، ردکردن آن صرفاً به این دلیل که «CUDA ندارد» تصمیم مهندسی نیست؛ عادت است.
پاشنه آشیل فقط سختافزار نیست؛ CUDA هم هست
حتی اگر فردا انباری از H100، H200، B200 یا نسلهای بعد در اختیار داشته باشیم، بخش دیگری از وابستگی باقی میماند. CUDA فقط API اجرای kernel نیست. سالها توسعه PyTorch و کتابخانههای جانبی، NCCL، TensorRT، TensorRT-LLM، FlashAttention، extensionهای سفارشی، profilerها، containerها، ابزارهای توسعه و تجربه هزاران برنامهنویس، یک اکوسیستم ساخته است. همین اکوسیستم یکی از بزرگترین دستاوردهای NVIDIA است. و دقیقاً به همین دلیل یکی از بزرگترین ریسکهای تکوابستگی نیز هست.
وقتی یک سازمان مدل، pipeline، کتابخانههای سفارشی، مانیتورینگ، deployment و نیروی انسانی خود را کاملاً حول CUDA میسازد، هزینه مهاجرت دیگر فقط قیمت خرید یک کارت جدید نیست. برای همین چین تنها Ascend نمیسازد؛ CANN، compiler، ابزار برنامهنویسی و کتابخانه ارتباطی هم میسازد. همکاری DeepSeek و Huawei روی ابزارهای متنباز برنامهنویسی Ascend دقیقاً به همین گلوگاه پاسخ میدهد.
کره و ژاپن نیز همین درس را گرفتهاند: شتابدهنده بدون compiler و runtime و integration با frameworkها، محصول کامل نیست. پس اگر قرار است تابآوری ایجاد کنیم، داشتن چند برند کارت در یک دیتاسنتر کافی نیست. باید قابلیت جابهجایی بارهای کاری داشته باشیم.
بومیسازی تراشه؛ راهحل واقعی یا فرار از مسئله؟
در این نقطه معمولاً پاسخ دیگری هم مطرح میشود: «پس خودمان GPU بسازیم.» از نظر آرمانی پاسخ جذابی است. توسعه صنعت میکروالکترونیک برای ایران یک انتخاب تجملی نیست و باید در آن سرمایهگذاری کرد. اما سیاست صنعتی را نباید با آرزو اشتباه گرفت.
ایران در بخشهایی از طراحی دیجیتال، FPGA، سیستمهای تعبیهشده و طراحی تراشه تجربه و نیروی انسانی دارد، در همین جنگهای ۱۲ روزه و رمضان هم شاهد فناوریهایی بودیم که توسط نیروهای مسلح ما مورد استفاده قرار گرفت و همگان را به تعجب وا داشت؛ اما فاصله تا ساخت یک شتابدهنده دیتاسنتری هوش مصنوعی در کلاس محصولات روز نیازمند تجهیزاتی است که حتی در زنجیره تامین جهانی هیچ کشوری به تنهایی به آن دسترسی ندارد.
یک شتابدهنده هوش مصنوعی پیشرفته حاصل یک زنجیره عظیم است: طراحی معماری، EDA، IP، fabrication، لیتوگرافی، مواد فوقخالص، ویفر پیشرفته، HBM، interposer، substrate، تست، yield engineering، سیستم خنککاری، شبکه پرسرعت، firmware، compiler و در نهایت زیستبوم نرمافزاری.
کشورهایی که امروز در خط مقدم این صنعت هستند نیز همه این زنجیره را بهتنهایی در اختیار ندارند. TSMC، Samsung، SK Hynix، ASML و مجموعهای از شرکتهای آمریکایی، اروپایی و آسیایی اجزای مختلف یک زنجیره جهانیاند. حتی چین با آن حجم سرمایهگذاری، بازار داخلی و نیروی انسانی هنوز در برخی فناوریهای ساخت پیشرفته با محدودیت روبهروست؛ Huawei برای جبران فاصله تولید به سمت نوآوریهای معماری و system-level رفته است.
نمونه هند هم آموزنده است. این کشور با بازار بسیار بزرگ و دسترسی بینالمللی، نخستین fab تجاری ۳۰۰ میلیمتری خود را در پروژهای با سرمایهگذاری برنامهریزیشدهٔ حدود ۱۱ میلیارد دلار و مشارکت ASML پیش میبرد. جالبتر آنکه سند راهبرد ملی پیشرفت صنعتی خود ایران نیز در بخش میکروالکترونیک، تمرکز را بر «طراحی تراشه»، توسعه زنجیره طراحی و «ایجاد دسترسی پایدار به Fab خارجی» قرار داده است. یعنی در سطح اسناد رسمی نیز مسئله صرفاً ساخت فوری یک fab پیشرفته در داخل تعریف نشده است. این واقعبینی ارزشمند است. بومیسازی خوب است؛ اما سؤال درست این نیست که: «آیا میتوانیم روزی GPU ایرانی بسازیم؟» سؤال سیاستی این است: «در چه لایههایی میتوانیم در بازه زمانی معقول مزیت و استقلال واقعی ایجاد کنیم؟»
ممکن است ساخت یک شتابدهنده ۳ نانومتری رقیب B200 در داخل، برنامه کوتاهمدت واقعبینانهای نباشد؛ اما ساخت دانش و محصول در لایههای بالاتر و پایینتر زنجیره کاملاً متفاوت است.
استقلال فناورانه با آرزوکردن برای ساخت یک H100 ایرانی به دست نمیآید؛ گاهی استقلال یعنی معماریای بسازیم که نبود هیچ H100، Ascend یا شتابدهنده دیگری نتواند آن را متوقف کند.
هدف نباید جایگزینکردن NVIDIA با Huawei باشد
اگر تمام این یادداشت را بخوانیم و در پایان نتیجه بگیریم که «پس از فردا فقط Ascend بخریم»، دقیقاً همان اشتباه قبلی را با لوگوی دیگری تکرار کردهایم. Huawei نیز یک فروشنده خارجی است. چین نیز منافع سیاسی، اقتصادی و صنعتی خودش را دارد. Furiosa، Rebellions، Preferred Networks یا هر شرکت دیگری نیز ممکن است فردا دچار محدودیت تولید، تغییر راهبرد یا مشکل تأمین شود.
حتی عبارت «تراشه غیرآمریکایی» را نیز باید با احتیاط استفاده کرد. برای مثال RNGD کرهای در TSMC و روی فرایند 5 نانومتری ساخته میشود. یک محصول ممکن است متعلق به شرکت آمریکایی نباشد، اما بخشی از زنجیره طراحی یا ساخت آن همچنان به فناوری آمریکایی، تایوانی، ژاپنی یا اروپایی وابسته باشد. بنابراین هدف واقعبینانه حذف آمریکا از آخرین پیچ زنجیره تأمین نیست. هدف این است که یک تصمیم سیاسی، یک شرکت یا یک پشته نرمافزاری نتواند به single point of failure زیرساخت ملی تبدیل شود.
راهحل، معماری چندفروشندهای است
اگر قرار باشد از این بحث یک توصیه سیاستی بیرون بیاید، آن توصیه «NVIDIA نخرید» نیست. اتفاقاً در بعضی بارهای کاری ممکن است بهترین خرید همچنان NVIDIA باشد. اما برای هر پروژه بزرگ ملی باید بتوان پرسید:
چرا NVIDIA؟ و پاسخ نباید این باشد: چون همیشه NVIDIA خریدهایم.
برای آموزش یک مدل بسیار بزرگ ممکن است benchmark نشان دهد NVIDIA بهترین انتخاب است. برای fine-tuning شاید AMD، Ascend یا محصول دیگری اقتصادیتر باشد. برای استنتاج یک مدل ۳۰ میلیارد پارامتری شاید Furiosa یا Rebellions ارزش آزمایش داشته باشد. برای یک بار کاری مشخص صنعتی ممکن است NPU دیگری با مصرف برق بسیار کمتر کافی باشد. همانطور که در یادداشت قبلی درباره سرمایهگذاری GPU نوشتم، انتخاب سختافزار باید پس از شناخت مسئله انجام شود؛ نه قبل از آن. اما این بار باید یک شرط دیگر نیز اضافه کنیم:
در پروژههای حیاتی، portability باید جزو الزامات باشد.
سامانهای که تنها روی یک شتابدهنده و یک محیط وابسته به یک تامینکننده خاص قابل اجراست، هرچقدر امروز سریع باشد، از منظر تابآوری ناقص است. اتفاقاً نبود benchmark مستقل جامع، میتواند نقطه شروع یک سیاست بهتر باشد.بهجای آنکه مشخصات مناقصه از ابتدا نام یک محصول را توصیف کند، بارکاری واقعی تعریف کنیم:
- یک مدل 8B برای بار تعاملی
- یک مدل 30B یا 70B برای RAG
- embedding و reranking فارسی
- ASR و TTS
- VLM
- fine-tuning
- و در سطحی دیگر distributed training
بعد اندازه بگیریم: TTFT، TPOT، throughput، concurrency، memory، power، token/Joule، پایداری ۷۲ ساعته، هزینه هر میلیون توکن و TCO. و در نهایت NVIDIA، AMD، Ascend و هر گزینهای که واقعاً قابل تأمین است وارد آزمون شوند.
MLPerf نشان داده که benchmark معماریخنثی و قابل تکرار شدنی است؛ اتفاقاً در نسخه 6.1 حتی بارهای کاری جدید RAG و agentic نیز به این مجموعه اضافه شدهاند. ما هم باید benchmark خودمان را بر اساس بار واقعی کشور داشته باشیم.
حرف آخر
ایران در میکروالکترونیک عقبماندگی قابل توجهی دارد و جهان منتظر نمیماند تا این فاصله را جبران کنیم. باید روی طراحی تراشه، میکروالکترونیک، packaging، سیستم، کامپایلر و هر حلقهای که امکان ایجاد توان داخلی در آن داریم سرمایهگذاری کنیم. شاید در آینده بتوانیم بخش بزرگتری از زنجیره را نیز در داخل شکل دهیم.
اما نمیتوان سیاست محاسبات هوش مصنوعی امروز را به امید fab پیشرفته ایرانی فردا متوقف کرد. در طرف دیگر نیز منطقی نیست میلیاردها دلار صرف ایجاد زیرساختی کنیم که تقریباً همه مسیرهایش به یک شرکت آمریکایی ختم شود. برای نقد این وضعیت حتی نیازی نیست از «Kill Switch»، در پشتی یا «اسب تروا» صحبت کنیم. هیچکدام برای اثبات مسئله لازم نیست. همین که دسترسی به نسل بعد، توسعه ظرفیت، خرید قطعات، پشتیبانی یا برخی فناوریهای وابسته بتواند با یک تصمیم سیاسی محدود شود، برای تعریف یک ریسک راهبردی کافی است.
ممکن است امروز برای آموزش بزرگترین مدلها، NVIDIA همچنان بهترین یا حتی در بعضی مقیاسها تنها گزینه عملی باشد. اما از این گزاره نمیتوان نتیجه گرفت که استنتاج RAG، agent، ترجمه، بینایی ماشین، پردازش صوت و تمام خدمات عمومی هوش مصنوعی کشور نیز باید روی همان پشته قفل شوند.
Ascend آنقدر خوب شده که دیگر نمیتوان «نبود جایگزین» را دلیل موجهی برای NVIDIA-only کردن تمام زیرساخت کشور دانست.
Furiosa، Rebellions، Preferred Networks و تلاشهای اروپایی نیز نشان میدهند که این فقط واکنش چین به تحریم آمریکا نیست. حتی متحدان آمریکا نیز همه تخممرغهای محاسباتی خود را در یک سبد نمیگذارند. پس شاید سؤال درست برای زیرساخت هوش مصنوعی ایران دیگر این نباشد که:
«چند H100، H200 یا B200 میتوانیم بخریم؟»
سؤال مهمتر این است:
«اگر فردا نتوانستیم نسل بعد آن را بخریم، اگر همینهایی که با زحمت خریدیم فردا از کار افتاد، چه مقدار از زیرساخت هوش مصنوعی کشور همچنان کار خواهد کرد؟»
پاسخ به این سؤال، معیار واقعی تابآوری است.