در انتخاب پردازندهٔ گرافیکی برای هوش مصنوعی، معمولاً ابتدا ظرفیت حافظه و سپس توان پردازشی بررسی میشود. اگر وزنهای مدل در حافظه جا شوند و نام قالب عددی آن هم در مشخصات کارت آمده باشد، ممکن است سازگاری تأییدشده تلقی شود. اما هنگام انتقال یک مدل INT8 به نسل جدید GPU، همین فرض میتواند به توقف اجرا یا عملکردی بسیار متفاوت با انتظار منجر شود.
در مقالهٔ نحوهٔ انتخاب پردازندهٔ گرافیکی برای هوش مصنوعی معیار اصلی، تناسب کارت با بار کاری و هزینهٔ اجرای آن بود. اینجا یکی از جزئیات مؤثر بر همان تصمیم را بررسی میکنیم: آیا نرمافزار واقعاً از قابلیتی که برای آن هزینه میکنیم استفاده میکند؟ محور بحث، استنتاج مدلهای زبانی است؛ آموزش مدل و دیگر کاربردهای محاسبات صحیح، ارزیابی جداگانهای میخواهند.
تفاوت INT8 و FP8
INT8 و FP8 هر دو برای مقدار پایهٔ هر عنصر هشت بیت مصرف میکنند، اما نمایش عدد در آنها یکسان نیست. در کوانتیزهسازی متداول INT8، عدد حقیقی با یک عدد صحیح و ضریب مقیاس تقریب زده میشود. فاصلهٔ مقادیر بازسازیشده در یک گروه با مقیاس مشترک یکنواخت است. در FP8، بخشی از بیتها به نما اختصاص دارد و فاصلهٔ اعداد با بزرگی آنها تغییر میکند. همانطور که در شرح قالبهای کوانتیزهسازی TensorRT دیده میشود، FP8 نیز معمولاً به مقیاسگذاری نیاز دارد.
FP8 خود چند نمایش دارد. E4M3 چهار بیت نما و سه بیت مانتیسا دارد؛ E5M2 با پنج بیت نما و دو بیت مانتیسا، دامنهٔ بزرگتری را با تفکیک کمتر پوشش میدهد. راهنمای Transformer Engine این تفاوت را توضیح میدهد. بنابراین ممیزشناور بودن بهتنهایی تضمین نمیکند که خطای یک مدل کمتر شود.
در نام مدلهای کوانتیزهشده، W به وزنها و A به فعالسازیها، یعنی دادههای میانی عبوری از لایهها، اشاره دارد. عبارت W8A8 فقط تعداد بیت این دو گروه را مشخص میکند؛ از روی آن نمیتوان صحیح یا ممیزشناور بودن محاسبات را تعیین کرد.
| توصیف مدل | معنی | جزئیاتی که باید بررسی شوند |
|---|---|---|
| INT8 W8A8 | وزن و فعالسازیِ عملیات مشمول کوانتیزهسازی، هشتبیتی صحیحاند | مقیاسگذاری، کرنل و لایههای مستثنا |
| FP8 W8A8 | وزن و فعالسازیِ عملیات مشمول کوانتیزهسازی، هشتبیتی ممیزشناورند | نوع FP8، قالب مقیاس و پوشش عملیات |
| W8A16 با وزن INT8 | وزن فشرده و فعالسازی شانزدهبیتی است | روش بازسازی وزن و دقت واقعی ضرب ماتریسی |
| FP8 برای KV cache | حافظهٔ کلید و مقدار Attention کوانتیزه شده است | قالب وزنها و محاسبات لایهها جدا تعیین میشود |
این تفکیک در مستندات کوانتیزهسازی vLLM نیز دیده میشود. حتی نوع انباشت حاصلضربها مستقل است؛ ورودی INT8 میتواند با انباشت INT32 همراه باشد. ازاینرو «مدل هشتبیتی» توصیف تمام عملیات مدل نیست.
حافظهٔ وزنها، تمام حافظهٔ مورد نیاز نیست
اگر دقیقاً ۷۰ میلیارد پارامتر را هر کدام در یک بایت ذخیره کنیم، اندازهٔ خام وزنها ۷۰ گیگابایت دهدهی، معادل حدود ۶۵٫۲ گیبیبایت خواهد بود. این مقدار برای INT8 و FP8 یکسان است، اما مقیاسها، لایههای با دقت بالاتر، بافرهای موقت و حافظهٔ موتور اجرا را شامل نمیشود.
KV cache نیز با طول زمینه و تعداد درخواستهای فعال تغییر میکند. مطابق راهنمای KV cache در vLLM، قالب آن جداگانه تنظیم میشود؛ هشتبیتیکردن وزنها خودبهخود آن را هشتبیتی نمیکند. در نتیجه باید ظرفیت حافظه را با طول ورودی، طول خروجی و تعداد درخواست همزمان مورد نیاز سنجید. بارگذاری موفق مدل هنوز نشان نمیدهد که کارت ظرفیت سرویسدهی به کاربران را دارد.
این نکته مکمل بحث انواع پردازندههای گرافیکی برای هوش مصنوعی است: حافظهٔ بیشتر ممکن است امکان استقرار را فراهم کند، ولی برای برآورد ظرفیت باید مصرف کل سرویس را اندازه گرفت.
تغییر موازنهٔ INT8 و FP8 در B300
یکی از نمونههای قابل توجه، تفاوت B200 و B300 است. جدول زیر نرخهای اسمی متراکم یا Dense را برای هر GPU نشان میدهد. مبنای B200 و B300، جدول ۳ سند فنی معماری Blackwell، صفحهٔ ۲۵ است. اعداد H200 SXM نیز با حذف ضریب تنکی مشخصات سازنده محاسبه شدهاند.
| GPU و پیکربندی مرجع | FP8 متراکم؛ TFLOPS | INT8 متراکم؛ TOPS | نسبت نرخ اسمی FP8 به INT8 |
|---|---|---|---|
| H200 SXM | ۱٬۹۷۹ | ۱٬۹۷۹ | ۱ به ۱ |
| B200 در HGX | ۴٬۵۰۰ | ۴٬۵۰۰ | ۱ به ۱ |
| B300 در HGX | ۴٬۵۰۰ | ۱۵۰ | حدود ۳۰ به ۱ |
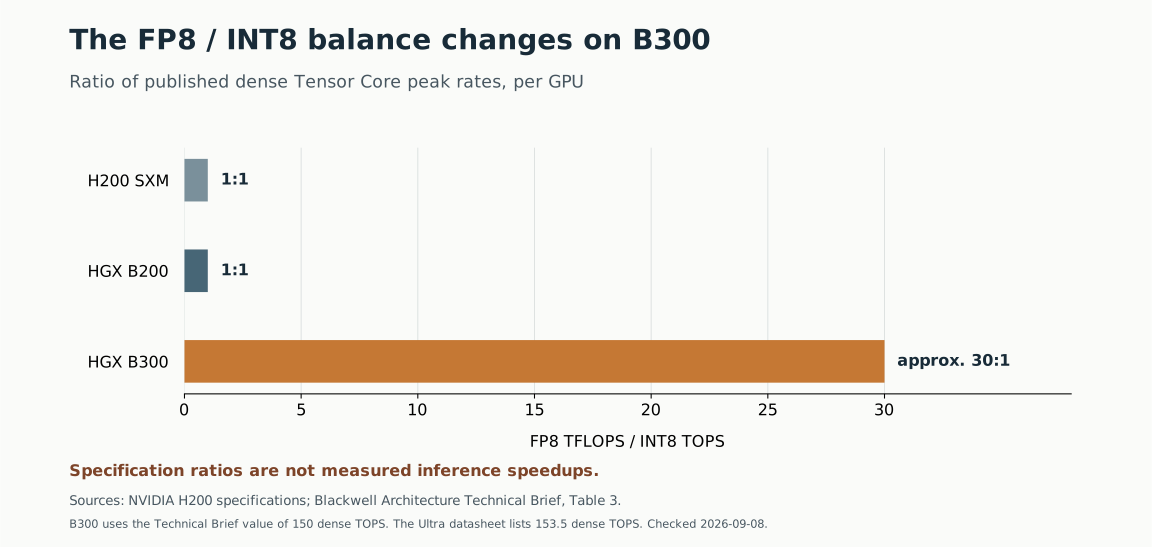
بلندتر بودن ستون B300 ممکن است در نگاه اول نشانهٔ برتری سرعت آن بر B200 به نظر برسد؛ اما این نمودار اصلاً سرعت دو کارت را با یکدیگر مقایسه نمیکند. هر ستون، نسبت توان اسمی FP8 به INT8 را درون همان کارت نشان میدهد.
در پیکربندیهای این جدول، توان اسمی متراکم FP8 در B200 و B300 برابر ۴۵۰۰ ترافلاپس است. آنچه تغییر کرده، توان اسمی متراکم INT8 است که از ۴۵۰۰ به ۱۵۰ تراعملیاتبرثانیه کاهش یافته است. بنابراین نسبت از یک به حدود سی رسیده، چون مخرج کوچکتر شده است، نه اینکه توان FP8 افزایش یافته باشد. بزرگتر بودن این نسبت بهخودیخود مزیت محسوب نمیشود.
این تفاوت میتواند در کاربرد واقعی مهم باشد: اگر عملیات غالب مدل با INT8 اجرا شود و گلوگاه محاسباتی داشته باشد، کاهش توان این مسیر میتواند عملکرد را محدود کند. اما از نسبت سی نمیتوان نتیجه گرفت که مدل روی B300 سی برابر کندتر اجرا میشود یا با تبدیل به FP8 سی برابر سریعتر خواهد شد. نوع کرنل، انتقال داده، مصرف حافظه و دیگر عملیات مدل در نتیجه دخالت دارند؛ حتی ذخیرهشدن وزنها بهصورت INT8 الزاماً به معنی انجام ضرب ماتریسی با INT8 نیست.
پس این نمودار بهتنهایی دلیلی برای خرید B300 یا کنارگذاشتن GPU موجود نیست. مزایای احتمالی کارت جدید باید در اجرای مدل و بار کاری موردنظر سنجیده شوند. پیام نمودار، اهمیت بررسی مسیر محاسباتی است؛ نه برتری عمومی یک کارت بر دیگری.
در دیتاشیت Blackwell Ultra، صفحهٔ ۵، نرخ INT8 برای HGX B300 برابر ۳۰۷ TOPS تنک است که به ۱۵۳٫۵ TOPS متراکم تبدیل میشود؛ سند فنی عدد گردشدهٔ ۱۵۰ را دارد. نمودار از مبنای سند فنی استفاده میکند. این اعداد را نباید با ستون GB300 NVL72 یا پیکربندیهای دیگر ترکیب کرد. تفاوت این سکوها در مقالهٔ DGX، HGX یا سرور معمولی GPU توضیح داده شده است.
افت نرخ اسمی INT8 در این مقایسه مربوط به گذار B200 به B300 است و به همهٔ محصولات Blackwell تعمیم ندارد. همچنین TFLOPS و TOPS در اینجا نرخ دو نوع عملیات متفاوتاند؛ نسبت آنها به معنی سی برابر کندتر بودن مدل INT8 نیست.
از مشخصات کارت تا کرنل قابل اجرا
کرنل در این بحث، تابع محاسباتی اجراشونده روی GPU است؛ برای مثال تابع ضرب ماتریسی یک لایه، نه کرنل سیستمعامل. وجود یک قالب در جدول سختافزار کافی نیست: دستور باید برای معماری مقصد مجاز باشد، کتابخانه کرنل مناسب داشته باشد و موتور اجرا نیز آن را برای مدل انتخاب کند.
پیشچاپ Spec Sheets Are Not Kernels، نسخهٔ دوم، اوت ۲۰۲۶ همین زنجیره را در Blackwell Ultra ممیزی کرده است. مطالعه، بررسی مستندات و کد در نسخههای مشخص است و بنچمارک سرعت یا کیفیت ارائه نمیکند. جزئیات یافتههای آن را باید با همان نسخهها خواند:
| لایه | یافتهٔ مطالعهٔ موردی | دامنهٔ نتیجه |
|---|---|---|
| دستور GPU | در PTX ۹٫۳، دستور tcgen05.mma با .kind::i8 برای sm_100a آمده، اما sm_103a در فهرست نیست | نبود این مسیر نسل پنجم، معادل حذف تمام قابلیت INT8 نیست |
| CUTLASS | مولد کرنل در commit dcf215a تولید INT8 UMMA را برای هدف 103a کنار میگذارد | قابلیت SM100 را نمیتوان به SM103 تعمیم داد |
| vLLM | مسیر W8A8 مربوط به SM100 در commit 6c95a641 تابع INT8 ندارد | قابلیت سختافزاری B200 نیز الزاماً از این مسیر استفاده نمیشود |
| SGLang | کرنل INT8 بررسیشده در commit b20c375 مسیرهای معماری را تا Hopper پوشش میدهد | نتیجه دربارهٔ همان کرنل است، نه تمام روشهای INT8 در SGLang |
برای پیگیری مستقیم، محدودیت دستور در مرجع PTX، شرط تولید در مولد CUTLASS و انتخاب عملیات در کد vLLM و کرنل SGLang قابل مراجعهاند. این ارجاعها عمداً به commit مشخص متصلاند؛ وضعیت نسخهٔ نصبشده باید جدا بررسی شود.
در نمونهٔ vLLM، کنترل اولیهٔ سازگاری عبور میکند، اما نبود مسیر محاسباتی هنگام نخستین اجرای مدل آشکار میشود. بنابراین آزمون سازگاری باید دستکم تا تولید خروجی ادامه پیدا کند. استفاده از مدل کوچکتر با همان روش کوانتیزهسازی میتواند این خطا را زودتر نشان دهد؛ تأیید نهایی همچنان به مدل اصلی نیاز دارد، چون ابعاد ماتریسها و معماری مدل میتوانند انتخاب کرنل را تغییر دهند.
مطالعه همچنین امکان کنارگذاشتن کرنل CUTLASS با VLLM_DISABLED_KERNELS و بررسی مسیر جایگزین Triton را توضیح میدهد. این سازوکار روی Ada آزمایش شده و عملکرد آن روی B300 اندازهگیری نشده است. پس وجود مسیر جایگزین، بهتنهایی مبنای توصیهٔ آن برای استقرار B300 نیست.
ثبت نسخهٔ درایور، کتابخانه و موتور اجرا در این ارزیابی ضروری است. همین وابستگی از منظر نگهداری و امنیت در نوشتهٔ امنیت زیرساخت هوش مصنوعی از کرنل و GPU آغاز میشود بررسی شده است.
چرا نرخ اسمی، سرعت پاسخ را تعیین نمیکند؟
زمان اجرای مدل به خواندن داده از حافظه، ابعاد ماتریسها، میزان موازیسازی و کیفیت پیادهسازی وابسته است. در راهنمای کارایی ضرب ماتریسی NVIDIA، نسبت عملیات به دادهٔ جابهجاشده از عوامل تعیینکنندهٔ محدودیت محاسبه یا حافظه است.
در استنتاج مدل زبانی، پردازش ورودی یا Prefill و تولید توکن یا Decode الگوی یکسانی ندارند. افزایش تعداد درخواستهای همزمان میتواند استفاده از توان محاسباتی را بهتر کند، ولی مصرف حافظه و تأخیر صف را نیز تغییر میدهد. اگر FP8 و INT8 با پیادهسازیهای متفاوت اجرا شوند، نتیجهٔ مقایسه به کل پیکربندی مربوط است و نمیتوان همهٔ اختلاف را به قالب عددی نسبت داد.
در اجرای چندGPU، تبادل داده هم به این هزینه اضافه میشود. به همین دلیل بررسی رابطهای PCIe و SXM باید در کنار انتخاب دقت محاسبات انجام شود؛ نرخ بالاتر یک عملیات نمیتواند گلوگاه ارتباطی را جبران کند.
تغییر قالب و ارزیابی کیفیت
اگر مسیر FP8 روی سختافزار مقصد مناسبتر باشد، بررسی مهاجرت به آن منطقی است. بااینحال بازتفسیر بایتهای INT8 بهعنوان FP8 تبدیل معتبر مدل نیست. نگاشت عددی و مقیاسها متفاوتاند و بهتر است، در صورت دسترسی، کوانتیزهسازی مقصد از وزنهای با دقت بالاتر انجام شود تا خطای تبدیل قبلی نیز به آن تحمیل نشود.
کیفیت به روش آمادهسازی مدل وابسته است. برای نمونه، پژوهش SmoothQuant با مدیریت مقادیر پرت فعالسازی، اجرای W8A8 را با افت ناچیز در آزمونهای خود نشان میدهد. مطالعهٔ مصالحهٔ کیفیت و کارایی کوانتیزهسازی در ACL ۲۰۲۵ نیز قالبهای مختلف را در خانوادهٔ Llama-3.1 و شرایط استقرار متفاوت بررسی میکند. نتایج هیچیک، تضمین کیفیت یک مدل فارسی در کاربرد سازمانی نیست.
برای چنین کاربردی، دادهٔ آزمون باید از جنس کار واقعی باشد: استخراج مبلغ و نام از اسناد، حفظ نفی و شرط، پاسخ مستند و تولید خروجی ساختیافته. تغییر جزئی جملهبندی با حذف یک شرط قرارداد یا جابهجایی یک مبلغ همارز نیست. مقایسهٔ نسخهٔ کوانتیزهشده با مدل مبنا باید این تفاوت خطاها را نشان دهد.
معیار عملی برای انتخاب زیرساخت
در استعلام خرید بهتر است اجرای یک پیکربندی مشخص مطالبه شود: نسخهٔ مدل، روش کوانتیزهسازی، موتور اجرا، GPU و بار آزمون. جدول زیر حداقل اطلاعات لازم برای مقایسهٔ پیشنهادها را جمع میکند.
| موضوع | آنچه در گزارش آزمون ثبت میشود |
|---|---|
| مدل و محیط | نسخه یا هش وزنها، روش کوانتیزهسازی، مدل GPU، درایور و نسخهٔ موتور اجرا |
| اجرای واقعی | تولید خروجی با مدل اصلی و ثبت کرنل منتخب برای عملیات غالب |
| ظرفیت | مصرف حافظه با طول ورودی، خروجی و تعداد درخواست همزمان هدف |
| کیفیت | خطاهای کاربردی در مقایسه با مدل مبنا روی دادهٔ نماینده |
| پاسخگویی | زمان نخستین توکن، زمان تولید توکنهای بعدی و صدکهای تأخیر |
| هزینه | هزینهٔ ظرفیت قابل استفاده، تبدیل مدل و نگهداری پیکربندی |
شرح معیارهای سرویسدهی vLLM میان نرخ خام خروجی و ظرفیت منطبق با اهداف سطح خدمت، یا Goodput، تفاوت میگذارد. برای یک سرویس تعاملی، تعداد درخواستهایی که با کیفیت و تأخیر قابل قبول پاسخ میگیرند از بیشترین نرخ توکن در یک آزمون منفرد مفیدتر است. زمان بارگذاری و گرمشدن نیز باید از اندازهگیری اجرای پایدار جدا باشد.
اگر مدل INT8 موجود نیاز سازمان را تأمین میکند، معرفی نسل جدید بهتنهایی دلیل مهاجرت نیست. برای استقرار تازه نیز باید هزینهٔ خرید را همراه با آمادهسازی مدل، آزمون کیفیت و نگهداری نرمافزار سنجید. ممکن است GPU گرانتر با مسیر آمادهٔ FP8 اقتصادیتر باشد، یا حفظ زیرساخت فعلی نتیجهٔ بهتری بدهد؛ پاسخ را آزمون همان مدل و همان سرویس مشخص میکند.
منابع و مبنای اعداد
پیوند هر منبع کنار بحث مربوط آمده است. اعداد نمودار از مشخصات H200 و جدول ۳ سند فنی Blackwell گرفته شدهاند و دادهٔ قابل دریافت نمودار مبنای هر ردیف را ثبت میکند. تاریخ بازبینی این نسخه ۱۷ شهریور ۱۴۰۵ است.
یافتههای نرمافزاری به نسخههای درجشده در مطالعهٔ اوت ۲۰۲۶ مربوطاند. این نوشته آزمون اختصاصی روی B300 گزارش نمیکند؛ مطالعهٔ مبنا نیز TensorRT-LLM را ممیزی نکرده است. ارجاع به TensorRT در بخش نخست صرفاً برای توضیح قالبهای عددی است.