Cuando se elaboró la primera versión de esta guía, las RTX 6000 Ada, A100 y H100 eran opciones destacadas para infraestructuras de aprendizaje profundo. H200 y Blackwell han ampliado desde entonces las alternativas. El criterio de decisión sigue siendo el mismo: una GPU más reciente o potente compensa únicamente si la carga de trabajo prevista puede aprovechar lo que ofrece.
Comprar un acelerador de gama alta sin evaluar la aplicación suele provocar tres problemas:
- La GPU y la plataforma de servidor que necesita pueden costar mucho más de lo que justifica su rendimiento útil.
- Las tareas pequeñas o poco paralelizadas pueden dejar inactiva gran parte de la capacidad de cálculo.
- El software diseñado para una sola GPU puede necesitar cambios importantes antes de beneficiarse de un sistema con varias GPU.
Por eso, para un equipo de desarrollo con presupuesto limitado, un servicio de inferencia o una instalación de investigación compartida, las tarjetas de consumo y de estación de trabajo deben figurar entre las candidatas junto con los aceleradores de centro de datos. La cuestión es cuánta capacidad utilizable proporciona la inversión completa.
Qué enseñan las pruebas históricas
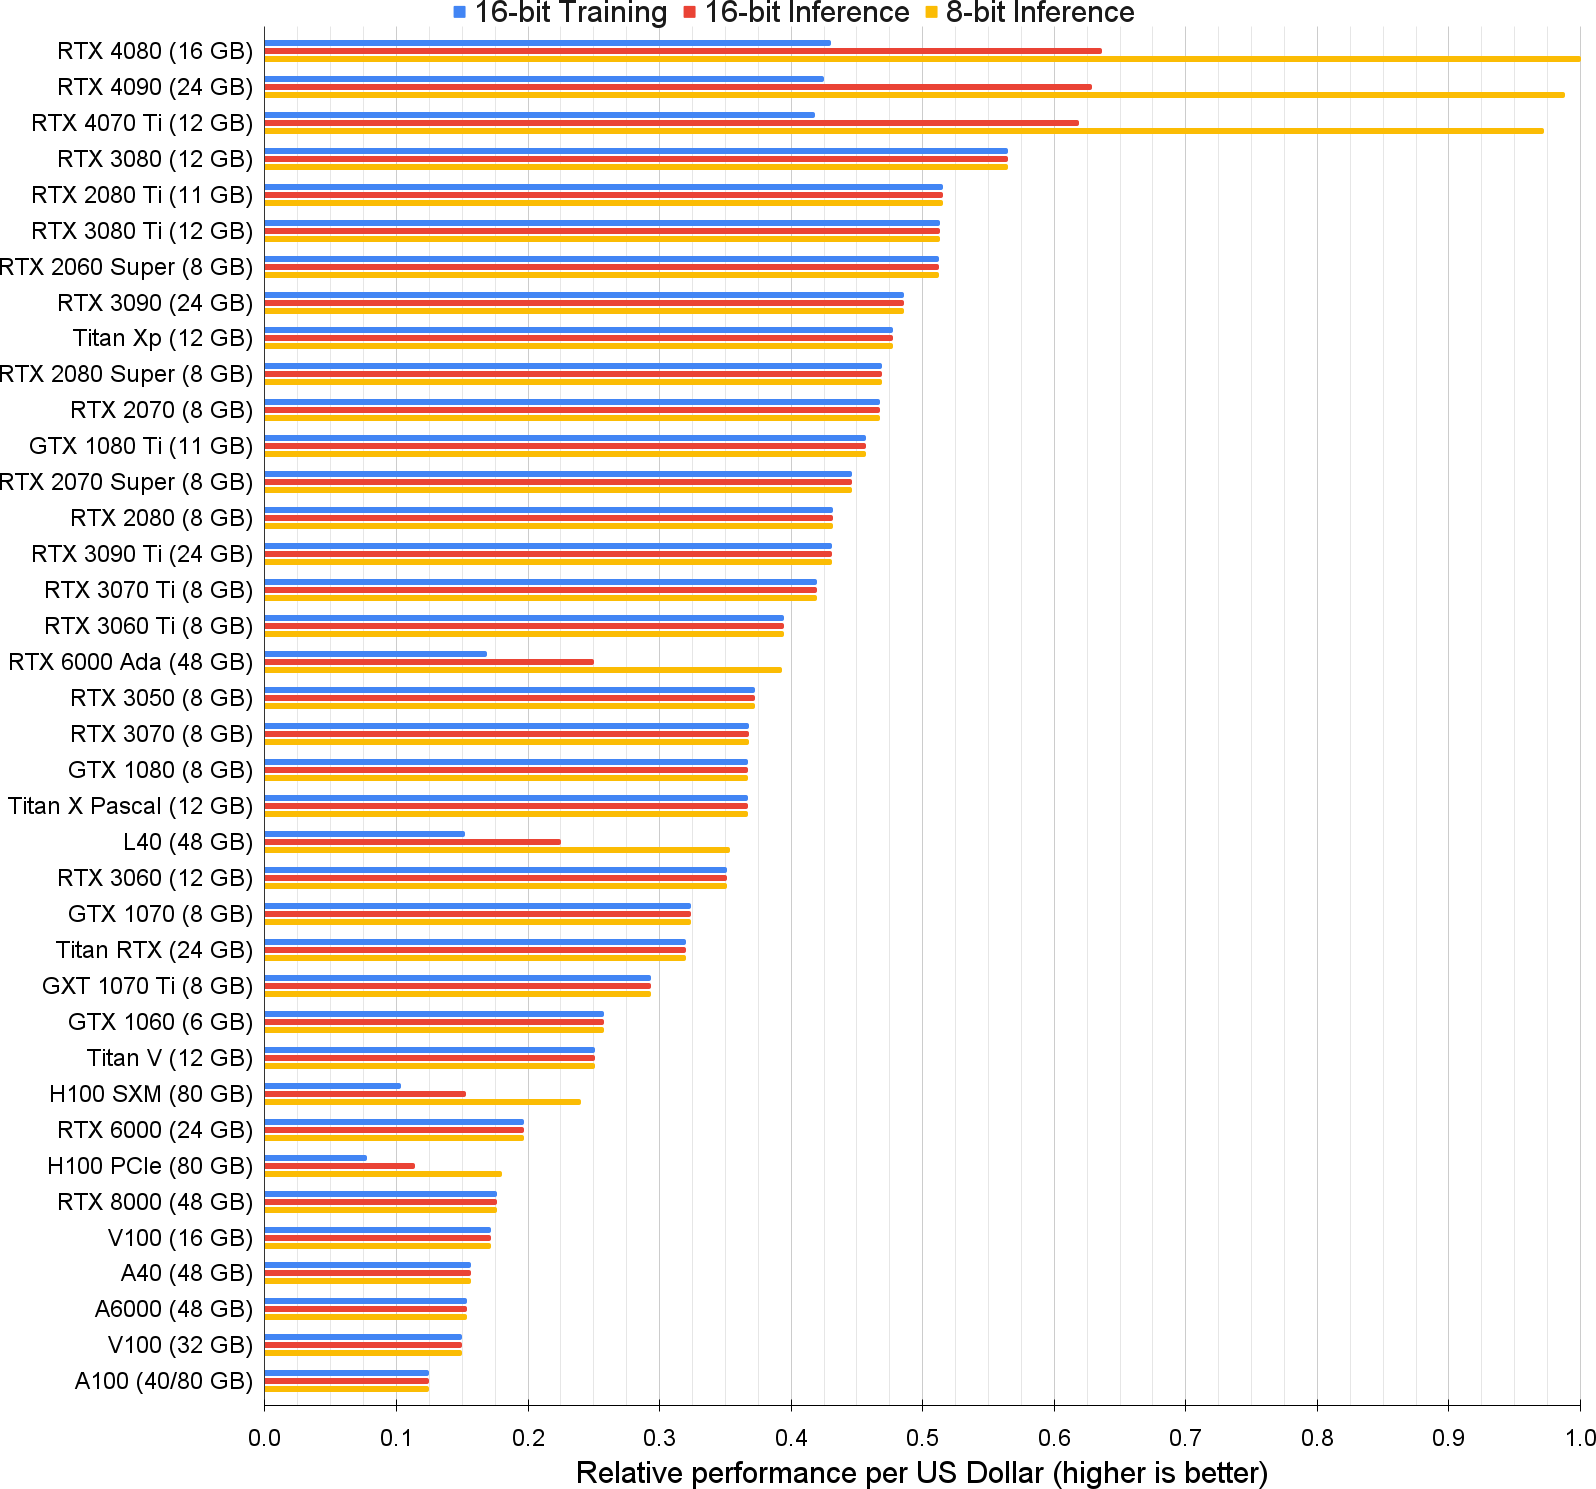
El siguiente gráfico procede del análisis de GPU para aprendizaje profundo publicado por Tim Dettmers en 2023. Con las cargas y los precios considerados, tarjetas como la RTX 4090 ofrecían una relación atractiva entre rendimiento y coste frente a la A100. Los resultados ilustran un método de comparación; no son precios actuales ni una clasificación válida para todos los modelos.
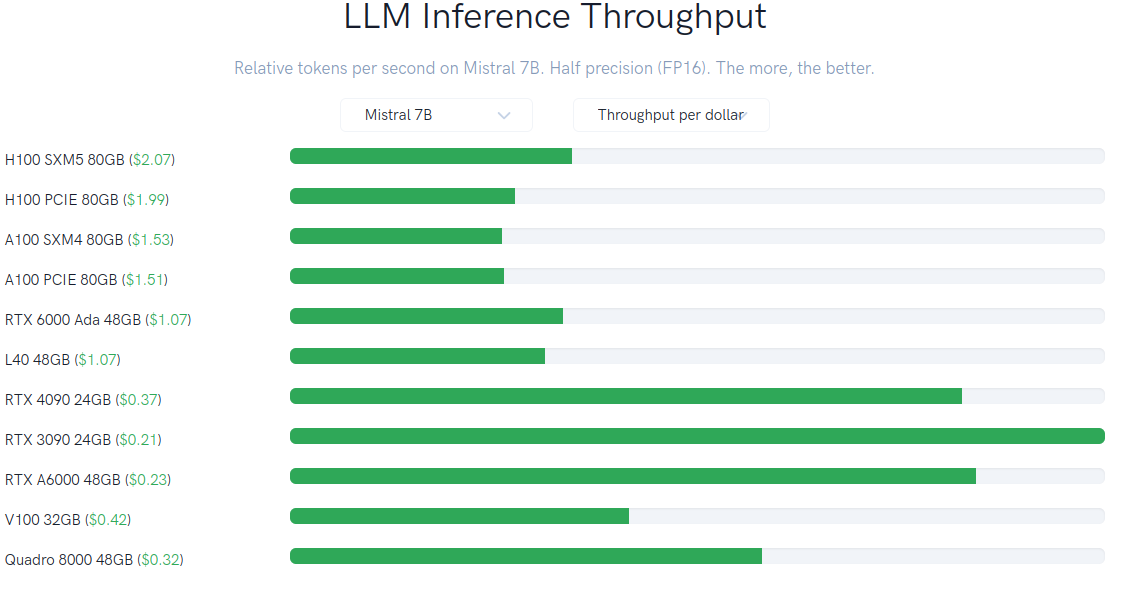
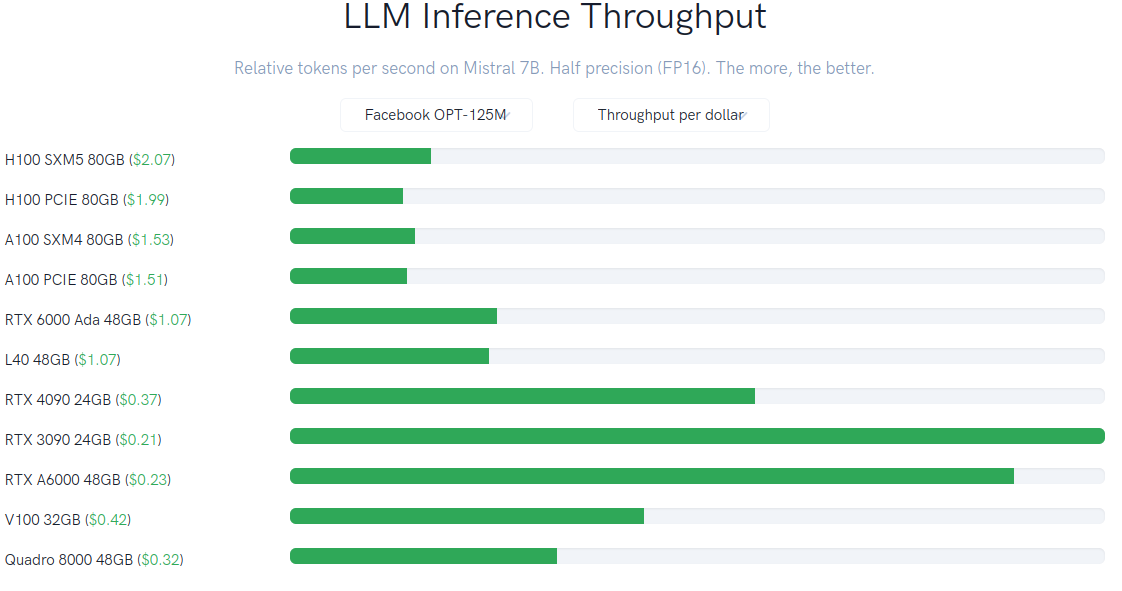
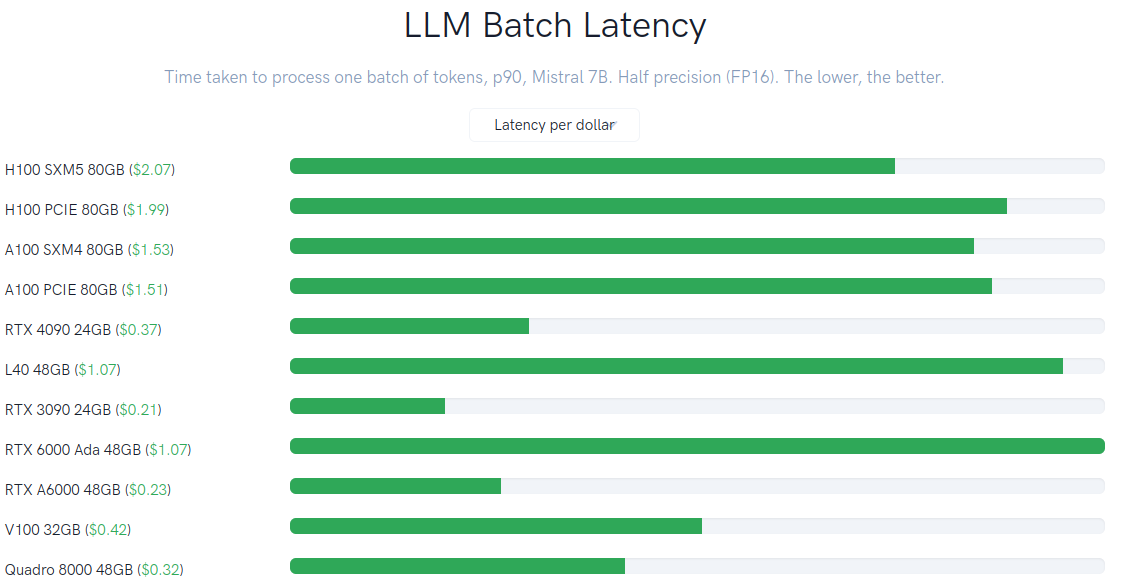
Las siguientes capturas de las pruebas de TensorDock muestran la misma idea para cargas concretas de modelos de lenguaje. Una tarjeta económica puede obtener buenos resultados en una prueba, mientras que otra carga cambia el orden. Son capturas conservadas del artículo original: los precios de alquiler, los controladores y los motores de ejecución han cambiado desde que se obtuvieron.
El entrenamiento y la inferencia exigen cosas distintas al hardware. En inferencia suele importar si caben los pesos y la caché KV, cuántas solicitudes se pueden atender a la vez y cuánto tarda cada usuario en recibir una respuesta. El entrenamiento necesita además gradientes, activaciones y estados del optimizador. El entrenamiento distribuido añade comunicación recurrente entre GPU.
Por tanto, un resultado de inferencia no se puede trasladar al entrenamiento. Incluso dentro de cada categoría, el tamaño del modelo, el tamaño de lote, la precisión numérica y la memoria disponible pueden cambiar el resultado. La diferencia entre un formato que figura en una ficha técnica y el que realmente utiliza el motor de ejecución se explica en INT8 o FP8: soporte real de la GPU.
Comparar el despliegue completo
NVIDIA ofrece algunas tarjetas de consumo como diseños de referencia, mientras que fabricantes asociados como ASUS, MSI y Gigabyte comercializan sus propias versiones. El precio refleja algo más que el procesador: pueden variar el disipador, las dimensiones, la alimentación, el ruido y otras características. Una función útil en un ordenador para videojuegos puede aportar poco a una máquina dedicada a IA.
La calidad de construcción, el precio y los requisitos de integración merecen más atención que los elementos decorativos. Muchas variantes de RTX 4090 son demasiado grandes o tienen un flujo de aire inadecuado para un despliegue denso en servidores. Incluso una tarjeta compacta o con ventilador de turbina debe comprobarse por su número de pieza exacto. La denominación comercial de un distribuidor no sustituye a una especificación oficial ni a una configuración admitida por el fabricante del servidor. La selección de servidores para GPU PCIe detalla las comprobaciones mecánicas, térmicas y eléctricas.
El coste debe incluir el servidor anfitrión, la refrigeración, la alimentación, la preparación del software y la utilización prevista. Una GPU barata que exige mucho trabajo de integración puede salir cara al operarla. A la inversa, un sistema integrado costoso puede aportar poco si cada trabajo se ejecuta de forma independiente en una tarjeta.
Un conjunto reducido y deliberado de configuraciones
Un servicio de cómputo compartido no necesita necesariamente un único modelo de GPU para todos sus clientes. Un conjunto limitado de configuraciones puede atender distintas necesidades de memoria y rendimiento sin complicar demasiado la operación. Conviene estandarizar donde se reduzca el trabajo de soporte e introducir otro tipo de tarjeta cuando una carga diferenciada lo justifique.
Las comparaciones de rendimiento por coste tienen una larga historia. Por ejemplo, la comparación de Lambda entre RTX 2080 Ti, V100 y otras GPU de la época dividía el rendimiento por el coste total del sistema. Las cifras son históricas, pero el método sigue siendo útil.
Para una compra actual, hay que ejecutar el modelo previsto con sus longitudes de entrada, tamaños de lote y objetivos de servicio reales. Después se compara el coste de la capacidad que supera esas pruebas. La tarjeta más potente sobre el papel puede ser la elección correcta, pero debe demostrarlo con la carga de trabajo.