انواع رابطهای اتصال
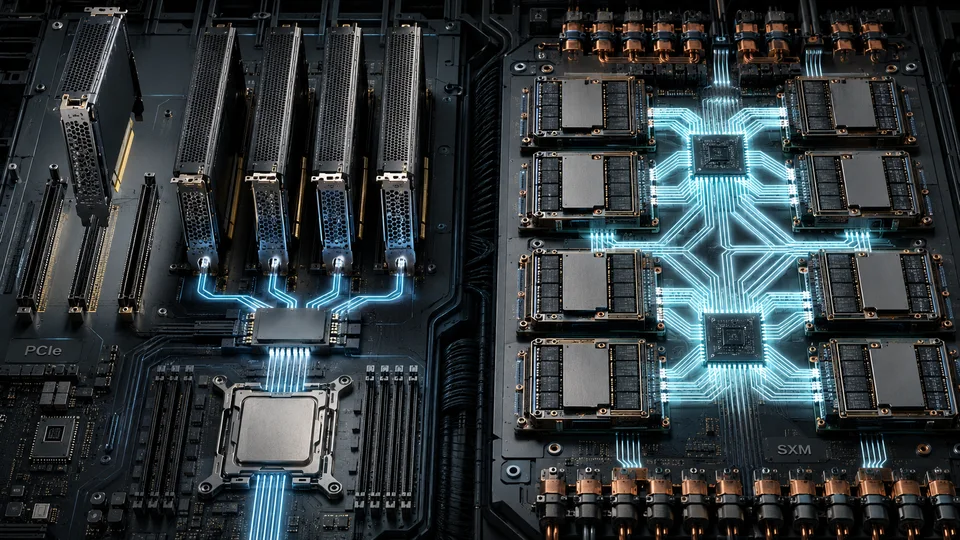
در گذشته عمدتاً رابط PCIe برای پردازندههای گرافیکی مورد استفاده بود، اما با رشد هوش مصنوعی و نیاز به دستیابی به سرعتهای بالاتر برای انتقال اطلاعات میان پردازندهها، فرمفکتور SXM در سکوهای DGX و HGX انویدیا توسعه یافت. در نسخهٔ اولیهٔ این مقاله SXM بهاشتباه مخفف «Server PCI Express Module» معرفی شده بود؛ NVIDIA آن را بهعنوان نام فرمفکتور ماژول و سکوی اختصاصی خود به کار میبرد و نباید آن را نوعی PCIe دانست.
معماری SXM راهکاری با پهنایباند بالا برای اتصال شتابدهندههای Tensor Core انویدیا به سیستمهای اختصاصی DGX و HGX است. بردهای تخصصی HGX در نسل H100 و H200 مجموعهای از هشت پردازندهٔ گرافیکی را از طریق NVLink و NVSwitch به هم متصل میکنند و پهنایباند بالای GPU به GPU را فراهم میسازند. این اتصال اجازه میدهد دادهها بدون عبور از مسیر معمول PCIe و CPU میان GPUها مبادله شوند.
در مرکز داده و صنعت هوش مصنوعی، NVIDIA DGX گاه به معنای واقعی کلمه طلا تلقی میشود: محصولی متراکم، گران و در بالاترین ردهٔ بازار. شرکتهای بزرگ به سراغ DGX نمیروند فقط به این دلیل که هر GPU آن قوی است؛ توانایی مقیاسپذیری و اجرای یک کار واحد روی چند GPU بخش اصلی مزیت است. در DGX و HGX نحوهٔ اتصال هشت GPU از کارتهای مستقل PCIe متفاوت است. هر GPU به NVSwitch متصل است و این توپولوژی امکان عملکرد هماهنگ همهٔ GPUها را فراهم میکند.
در رابط PCIe نیز میتوان ارتباط مستقیم بین برخی کارتها برقرار کرد، اما این ارتباط بسته به SKU معمولاً از طریق NVLink Bridge تنها بین یک جفت GPU ممکن است. GPUهایی که چنین ارتباط مستقیمی ندارند داده را از مسیر PCIe مبادله میکنند و توپولوژی CPU و PCIe switch در کارایی آنها اثر میگذارد. دورزدن این مسیر هنگام تبادل داده میان پردازندههای گرافیکی به SXM اجازه میدهد در آموزش مدلهای بسیار بزرگ و سایر بارهای پرارتباط، توان عملیاتی بیشتری نسبت به مجموعهای از کارتهای مستقل به دست آورد.
NVIDIA DGX بهویژه از منظر استانداردسازی و مقیاسپذیری عملکردی ارائه میدهد که در فرمفکتور خود کمرقیب است. اتصال چند DGX به شبکهٔ محاسباتی و ذخیرهسازی مناسب میتواند SuperPOD لازم برای آموزش مدلهای بسیار بزرگ را بسازد. بااینحال مهمترین نقطهضعف معماری SXM انعطافپذیری محدود آن در پیکربندی است؛ این معماری برای سیستمهای خاص طراحی شده و برای کاربردهای متنوعتر، افزایش مرحلهای ظرفیت یا تعویض مستقل کارتها انعطاف PCIe را ندارد.
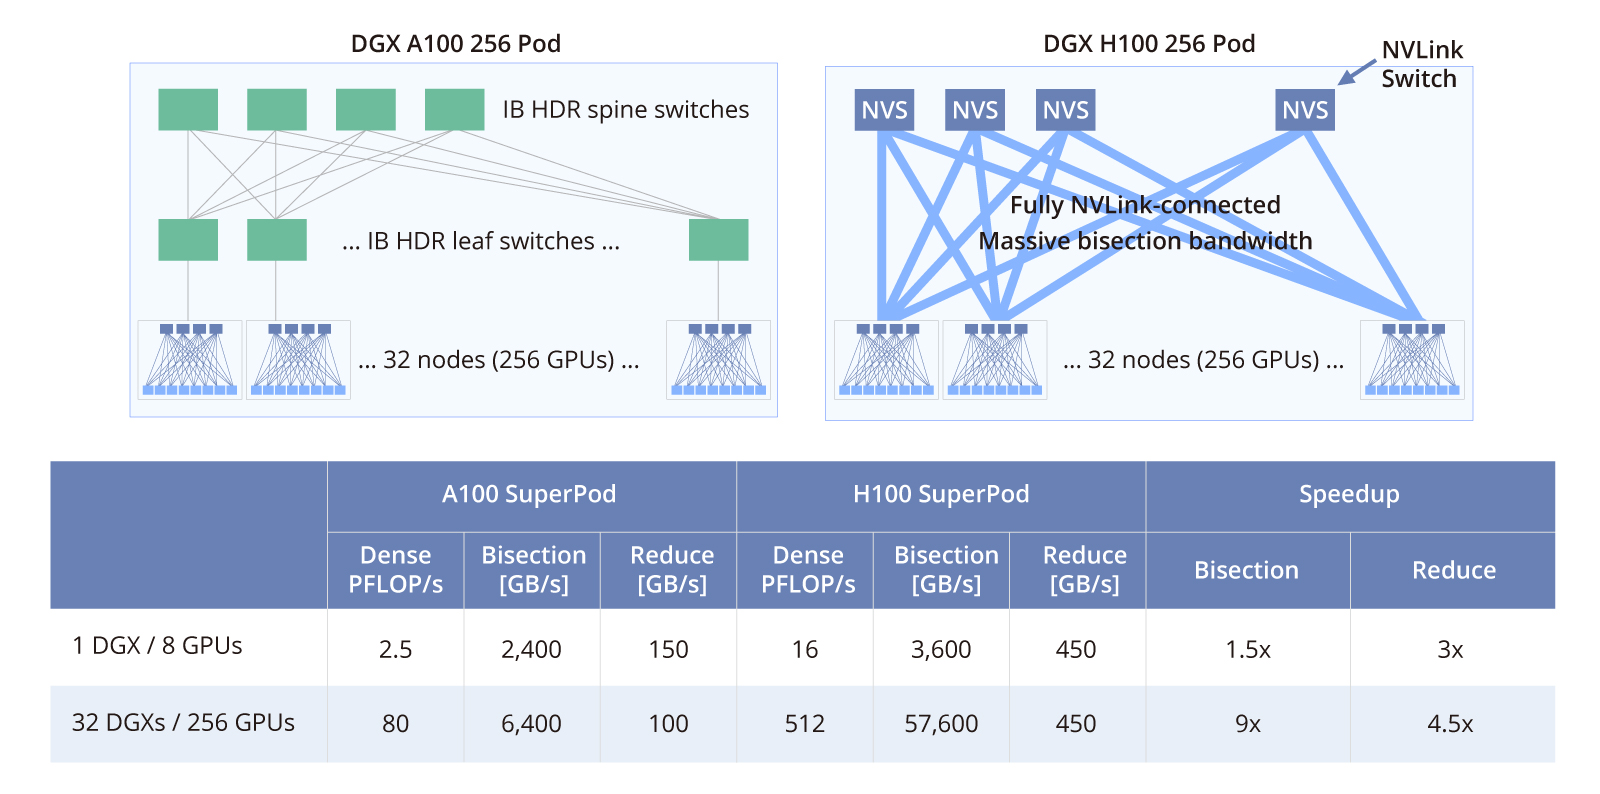
در تفسیر تصویر بالا باید یک خطای رایج را کنار گذاشت. در DGX H100/H200، NVSwitch ارتباط هشت GPU داخل هر سرور را فراهم میکند؛ معماری SuperPOD برای ارتباط میان سرورها از InfiniBand و Ethernet، در کنار شبکهٔ مدیریت و ذخیرهسازی مستقل، استفاده میکند. بنابراین NVSwitch داخلی را نباید شبکهٔ بین دو سرور دانست. نسلهای rack-scale جدید که multi-node NVLink دارند نیز معماری دیگری دارند و حکم آنها را نمیتوان به DGX/HGX H100 و H200 تعمیم داد.
نوع PCIe برای کسانی مناسب است که با حجم کاری کوچکتر کار میکنند یا خواهان انعطاف در تعیین تعداد پردازندههای گرافیکی سیستم هستند. کارتهای PCIe میتوانند از سرورهای کوچک تا شاسیهای چندGPU به کار روند و افزودن یا تعویض مستقل آنها سادهتر است. در مقابل، سامانههای DGX/HGX معمولاً بهصورت یک سکوی متراکم چهار یا هشتGPU خریداری میشوند و حتی اگر بهرهبردار از یک یا دو GPU استفاده کند، هزینهٔ برد پایه، ارتباط داخلی، توان و خنککاری کل سامانه را پرداخته است.
از طرف دیگر، استفاده از توان پردازشی چنین سامانهای در همهٔ الگوریتمها ممکن نیست. برخی برنامهها تنها یک GPU را به کار میگیرند، برخی چند کار مستقل اجرا میکنند و برخی نیز به دلیل محدودیت نرمافزار یا طراحی نامناسب، بخش قابلتوجهی از تبادل را از مسیر CPU و PCIe انجام میدهند. در نتیجه در شرایط زیر انتخاب SXM معمولاً کارایی به قیمت مناسبی ایجاد نمیکند:
- کارتهای گرافیکی عمدتاً مستقل از هم استفاده شوند؛
- مدل یا job روی یک یا دو GPU جا شود و به fabric هشتGPU نیاز نداشته باشد؛
- تیم بهرهبردار توان بهینهسازی نرمافزار برای استفادهٔ یکپارچه از خوشهٔ پردازندههای گرافیکی را نداشته باشد.
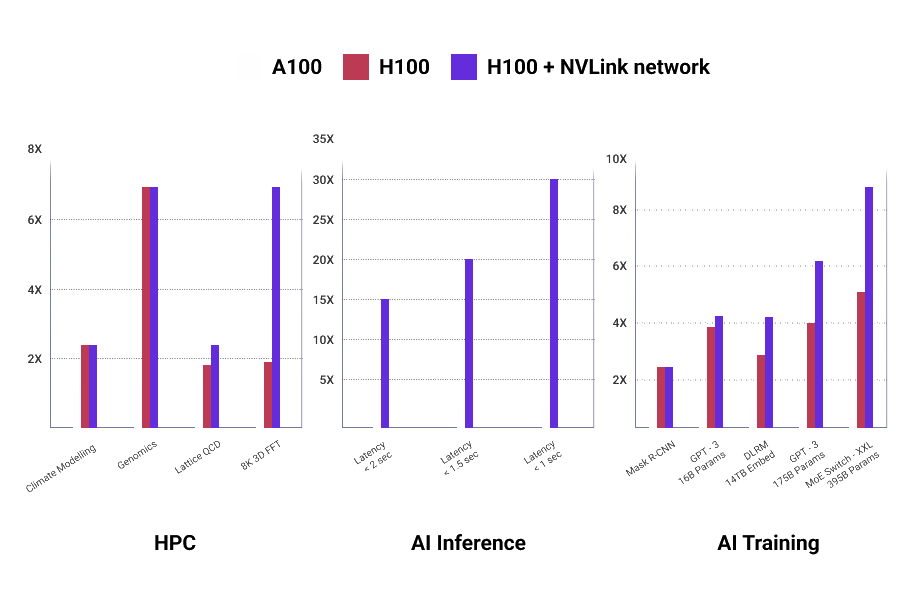
مقایسهٔ نسخههای H100 PCIe و H100 SXM نشان میدهد که تعداد هستهها بهتنهایی تمام تفاوت را توضیح نمیدهد و پهنایباند حافظه، توان و اتصال NVLink مهماند. تصویر زیر یک نمودار نسبی از بارهای منتخب HPC، استنتاج و آموزش است. این نمودار ماهیت تبلیغاتی و وابسته به workload دارد و نباید ضریب افزایش سرعت آن برای همهٔ برنامهها فرض شود، اما نشان میدهد بخش بزرگی از مزیت H100 همراه با شبکهٔ NVLink در بارهای مقیاسپذیر ظاهر میشود.
پهنایباند و سرعت انتقال داده
نسخههای اولیهٔ H100 PCIe و SXM هر دو ۸۰ گیگابایت حافظه داشتند؛ نوع حافظه در H100 PCIe طبق سند رسمی سازنده، HBM2e بود و در SXM از HBM3 استفاده میشد. طبق برگهٔ رسمی H100، نسخهٔ SXM تا ۳٫۳۵ ترابایت بر ثانیه و نسخهٔ PCIe حدود ۲ ترابایت بر ثانیه پهنایباند حافظه ارائه میکردند. ظرفیت ۱۴۱ گیگابایت که در نسخهٔ قبلی مقاله به H100 SXM نسبت داده شده بود متعلق به H200 است، نه H100.
بهرهوری انرژی و مصرف برق
توان طراحی H100 PCIe در نسل اولیه حدود ۳۵۰ وات و H100 SXM تا ۷۰۰ وات بود. SXM میتواند به سبب کارایی و ارتباط بیشتر، یک کار بزرگ را زودتر تمام کند و الزاماً از نظر انرژی هر نتیجه بدتر نباشد؛ بااینحال دو برابرشدن سقف توان، بار خنککاری و برق رک را افزایش میدهد. بنابراین مقایسه باید بر اساس انرژی یا هزینهٔ تکمیل workload انجام شود، نه فقط TDP یا سرعت خام.
کارایی و کاربرد
جدول نسخهٔ اولیه برای مقایسهٔ کاربردی دو رابط مهم بود و در این بازبینی حفظ شده است، اما عبارتهای قطعی آن اصلاح شدهاند. حوزهٔ کاربرد بهتنهایی نوع رابط را تعیین نمیکند؛ اندازهٔ مسئله و الگوی تبادل داده تعیینکننده است.
| NVIDIA H100 PCIe معمولاً مناسبتر است برای | NVIDIA H100 SXM معمولاً مناسبتر است برای |
|---|---|
| تجزیهوتحلیل داده و استنتاج مستقل: هنگامی که هر GPU یک جریان یا مدل مستقل را اجرا میکند و توسعهٔ مرحلهای مهم است. | شبیهسازی HPC در مقیاس بزرگ: هنگامی که کد برای collective communication و توپولوژی چندGPU بهینه شده است. |
| تصویربرداری و تشخیص: وقتی مدل روی یک کارت جا میشود یا چند کار مستقل باید همزمان اجرا شوند. | آموزش مدلهای بسیار بزرگ: هنگامی که مدل یا batch میان چند GPU تقسیم میشود و تبادل مداوم tensor و gradient وجود دارد. |
| طراحی تعاملی و مصورسازی: وقتی انعطاف پیکربندی، تعداد کمتر GPU و هزینهٔ ورودی اهمیت بیشتری دارد. | کشف دارو و علم مواد: تنها در ابعادی که محاسبه و تبادل داده واقعاً از NVLink و NVSwitch سود میبرد. |
این جدول به معنی ناتوانی PCIe در آموزش یا ناتوانی SXM در استنتاج نیست. استنتاج یک مدل بسیار بزرگ که در حافظهٔ یک GPU جا نمیشود میتواند از SXM سود ببرد و آموزش چند مدل کوچک مستقل ممکن است روی PCIe اقتصادیتر باشد. در اغلب کاربردهای عمومی، PCIe باید انتخاب پیشفرض باشد و SXM انتخابی که ضرورت آن با benchmark یک، دو، چهار و هشت GPU اثبات میشود. اگر کاربرد به fabric نیاز ندارد، هزینهٔ fabric کارایی ایجاد نمیکند.