La selección de GPU suele comenzar por la capacidad de memoria y el rendimiento máximo de cálculo. Si los pesos del modelo caben y su formato numérico aparece en la ficha técnica, la compatibilidad puede parecer resuelta. Trasladar un modelo INT8 a una GPU más reciente puede revelar el fallo de esa suposición: el modelo puede fallar al ejecutarse o rendir de forma muy distinta a la esperada.
La guía de selección de GPU utiliza la adecuación a la carga y el coste operativo como criterios principales. Este artículo examina un detalle de esa decisión: si el software utiliza realmente la capacidad que se está comprando. Se centra en la inferencia de modelos de lenguaje. El entrenamiento y otras cargas de cálculo entero requieren una evaluación propia.
INT8 y FP8 representan números distintos
INT8 y FP8 utilizan ocho bits para la representación básica de cada valor, pero no lo codifican igual. En los esquemas habituales de cuantización INT8, un entero y una escala aproximan un número real. Los valores reconstruidos dentro de un grupo que comparte escala están espaciados uniformemente. FP8 dedica algunos bits a un exponente, por lo que el espaciado cambia con la magnitud. FP8 también suele necesitar escalado, como explica la documentación de cuantización de TensorRT.
FP8 tiene varias representaciones. E4M3 utiliza cuatro bits de exponente y tres de mantisa; E5M2 utiliza cinco y dos, sacrificando precisión a cambio de un rango mayor. La introducción a Transformer Engine de NVIDIA explica la diferencia. La representación en coma flotante no garantiza por sí sola un error menor en un modelo concreto.
En las denominaciones de modelos cuantizados, W se refiere a los pesos y A a las activaciones: los valores intermedios que pasan por las capas. W8A8 especifica el número de bits de ambos grupos. Por sí solo, no identifica si el cálculo utiliza enteros o coma flotante.
| Descripción del modelo | Significado | Qué falta comprobar |
|---|---|---|
| INT8 W8A8 | Los pesos y las activaciones de las operaciones cuantizadas utilizan enteros de ocho bits | Escalado, soporte de kernels y capas excluidas |
| FP8 W8A8 | Los pesos y las activaciones de las operaciones cuantizadas utilizan coma flotante de ocho bits | Variante FP8, formato de escala y operaciones cubiertas |
| W8A16 con pesos INT8 | Los pesos están comprimidos; las activaciones utilizan dieciséis bits | Reconstrucción de los pesos y precisión real de la multiplicación de matrices |
| Caché KV en FP8 | Se cuantizan las claves y los valores de atención | Los formatos de pesos y el cálculo de las capas se configuran por separado |
Estas diferencias también aparecen en la documentación de cuantización de vLLM. La precisión de acumulación es otra elección independiente: por ejemplo, entradas INT8 pueden utilizar acumulación INT32. Un modelo de ocho bits no ejecuta necesariamente todas sus operaciones con esa precisión.
La memoria de los pesos es solo una parte
Exactamente 70.000 millones de parámetros almacenados a un byte cada uno ocupan 70 GB decimales, unos 65,2 GiB. La cifra bruta es igual para INT8 y FP8. No incluye escalas, capas de mayor precisión, búferes temporales ni memoria del motor de ejecución.
La caché KV también crece con la longitud del contexto y las solicitudes activas. Como explica la guía de caché KV de vLLM, su formato se configura por separado. Cuantizar los pesos a ocho bits no cuantiza automáticamente la caché.
Hay que medir la memoria con la longitud de entrada, la longitud de salida y la concurrencia requeridas. Cargar correctamente un modelo no demuestra la capacidad de servirlo. Esto amplía la comparación de familias de GPU: más memoria puede hacer posible el despliegue, pero la capacidad de servicio depende del conjunto completo de datos de trabajo.
La relación entre INT8 y FP8 cambia en B300
La diferencia entre B200 y B300 ofrece un ejemplo útil. Las cifras siguientes son tasas nominales densas por GPU. Para B200 y B300 proceden de la tabla 3, página 25, del informe técnico de arquitectura Blackwell de NVIDIA. Las cifras de H200 SXM se obtienen eliminando el multiplicador por dispersión de los valores publicados por el fabricante.
| GPU y configuración de referencia | FP8 denso, TFLOPS | INT8 denso, TOPS | Relación nominal FP8/INT8 |
|---|---|---|---|
| H200 SXM | 1979 | 1979 | 1:1 |
| B200 en HGX | 4500 | 4500 | 1:1 |
| B300 en HGX | 4500 | 150 | Aproximadamente 30:1 |
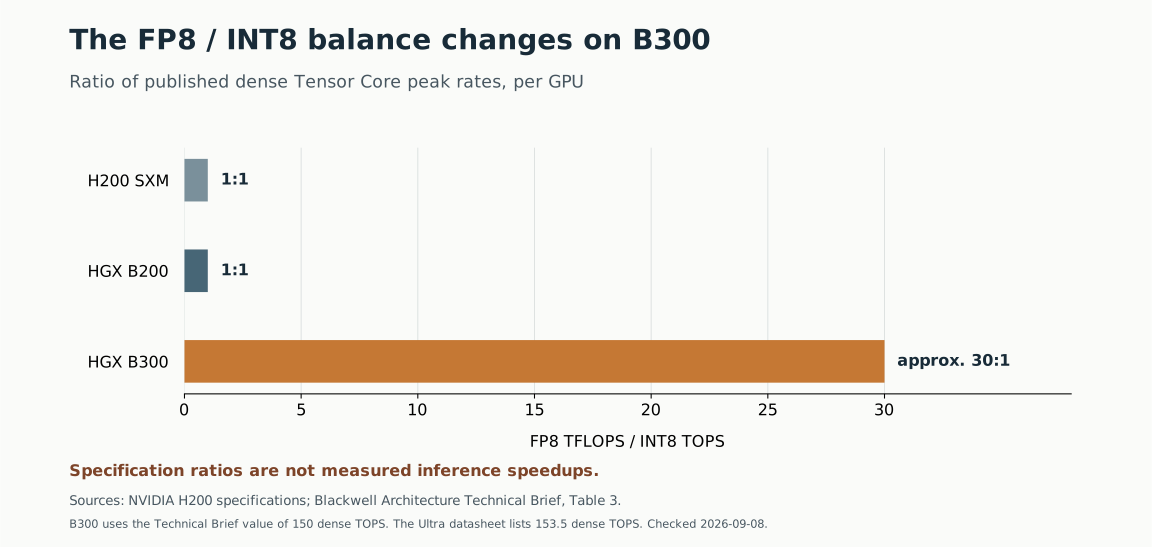
La hoja de datos Blackwell Ultra, página 5, indica 307 TOPS INT8 con dispersión para HGX B300, equivalentes a 153,5 TOPS densos. El informe técnico utiliza el valor redondeado de 150, base de este gráfico. No deben mezclarse estas cifras con la columna GB300 NVL72 ni con otras configuraciones. La comparación de DGX y HGX explica por qué importa distinguir las plataformas.
También hay una diferencia entre esos documentos y la tabla de producto HGX en línea, consultada el 9 de septiembre de 2026. Esta última indica 3 POPS INT8 con dispersión para un HGX B300 de ocho GPU, equivalentes a 187,5 TOPS densos por GPU. Esa es la base de la comparación interactiva de esta colección; frente a 4500 TFLOPS FP8 densos, la relación es 24:1. El gráfico anterior conserva deliberadamente la base de 150 TOPS del informe técnico. Las cifras publicadas no son idénticas: cada comparación debe conservar su fuente y configuración, y una compra requiere confirmar la especificación aplicable.
La reducción de la tasa nominal INT8 en este ejemplo se produce entre B200 y B300; no afecta a todos los productos Blackwell. Además, TFLOPS y TOPS describen aquí operaciones de tipos distintos. Su relación no significa que un modelo INT8 vaya a ejecutarse treinta veces más despacio.
De la ficha técnica a un kernel ejecutable
Aquí, un kernel es una función de cálculo ejecutada en la GPU, como la multiplicación de matrices de una capa; no se refiere al núcleo del sistema operativo. Deben coincidir tres cosas: la instrucción ha de ser válida para la arquitectura de destino, la biblioteca debe proporcionar una implementación adecuada y el motor de ejecución debe seleccionarla para el modelo.
La versión 2 de la prepublicación de agosto de 2026 Spec Sheets Are Not Kernels examina esa cadena en Blackwell Ultra. Revisa documentación y código de versiones concretas; no presenta pruebas de velocidad ni de calidad de modelos. Sus resultados deben interpretarse dentro de ese alcance.
| Capa | Resultado del estudio de caso | Límite de la conclusión |
|---|---|---|
| Instrucción de GPU | PTX 9.3 enumera tcgen05.mma con .kind::i8 para sm_100a, pero no para sm_103a | La ausencia de esta vía de quinta generación no elimina toda capacidad INT8 |
| CUTLASS | En el commit dcf215a, el generador excluye la generación de INT8 UMMA para el destino 103a | No puede suponerse que SM103 se comporte como SM100 |
| vLLM | La vía SM100 W8A8 del commit 6c95a641 no tiene implementación INT8 | Incluso la capacidad de hardware de B200 puede quedar sin utilizar en esta vía |
| SGLang | El kernel INT8 examinado en el commit b20c375 cubre arquitecturas hasta Hopper | El resultado se refiere a ese kernel, no a todos los métodos INT8 de SGLang |
Las referencias directas son el manual de instrucciones PTX, el generador de CUTLASS, el código de selección de operaciones de vLLM y el kernel de SGLang. Los enlaces de código fijan deliberadamente commits concretos. Hay que revisar por separado la versión instalada.
En el caso de vLLM, la comprobación inicial de compatibilidad puede superarse antes de que la primera ejecución revele la ausencia de una vía de cálculo. Por eso, una prueba de compatibilidad debe llegar al menos a producir una salida. Un modelo más pequeño con el mismo método de cuantización puede revelar el problema antes, pero la aceptación final exige el modelo previsto: las dimensiones de las matrices y su arquitectura pueden cambiar la selección de kernels.
El estudio también trata la desactivación de un kernel CUTLASS mediante VLLM_DISABLED_KERNELS y el examen de una alternativa Triton. Ese mecanismo se probó en Ada, sin una medición de rendimiento en B300. La existencia de una alternativa no basta para recomendarla en un despliegue B300.
Las versiones del controlador, las bibliotecas y el motor de ejecución deben acompañar a los resultados. Las implicaciones de mantenimiento y seguridad de esta cadena se explican en La seguridad de la infraestructura de IA empieza por el núcleo y la GPU.
Las tasas máximas no determinan el tiempo de respuesta
El tiempo de ejecución depende del tráfico de memoria, las dimensiones de las matrices, el paralelismo y la calidad de la implementación. La guía de rendimiento de multiplicación de matrices de NVIDIA explica cómo la relación entre operaciones y datos transferidos ayuda a determinar si una operación está limitada por cálculo o por memoria.
El procesamiento inicial del contexto —prefill— y la generación token a token —decode— tienen patrones distintos. Aumentar la concurrencia puede mejorar la utilización del cálculo, pero también cambia el consumo de memoria y la espera en cola. Cuando FP8 e INT8 utilizan implementaciones distintas, la prueba compara configuraciones completas; no se puede atribuir toda la diferencia al formato numérico.
La ejecución con varias GPU añade costes de comunicación. Hay que evaluar la conectividad PCIe y SXM junto con la precisión. Un máximo aritmético mayor no compensa un cuello de botella en otra parte de la ejecución.
Cambiar de formato exige evaluar la calidad
Si FP8 dispone de una vía mejor soportada en el hardware de destino, merece la pena probar la migración. Reinterpretar bytes INT8 como FP8 no convierte válidamente un modelo: el mapeo numérico y las escalas son distintos. Cuando existen pesos de mayor precisión, preparar la cuantización de destino a partir de ellos evita añadir otra conversión sobre una representación ya cuantizada.
La calidad depende del método de preparación. Por ejemplo, SmoothQuant trata valores atípicos de las activaciones para permitir W8A8 con poca degradación en sus evaluaciones publicadas. Un estudio de ACL de 2025 sobre calidad y eficiencia de la cuantización examina varios formatos de la familia Llama-3.1 bajo distintas condiciones de despliegue. Ninguno garantiza la calidad para los documentos, la combinación de idiomas o la terminología especializada de una organización concreta.
Los datos de prueba deben reflejar el trabajo: extraer importes y nombres, conservar negaciones y condiciones, responder con evidencia y devolver resultados estructurados. Un cambio inocuo de redacción no equivale a omitir una condición contractual o modificar un importe. La comparación con el modelo de referencia debe distinguir esos errores. En servicios multilingües o especializados, hay que incluir los sistemas de escritura, los términos y las estructuras documentales que realmente presentan los usuarios.
Solicitar una prueba de servicio reproducible
Una solicitud de compra debe identificar una configuración ejecutable: versión del modelo, método de cuantización, motor, GPU y carga de trabajo. La información siguiente permite comparar propuestas con sentido.
| Área | Qué debe registrar el informe |
|---|---|
| Modelo y entorno | Versión o hash de los pesos, método de cuantización, modelo de GPU, versiones del controlador y del motor |
| Ejecución real | Salida del modelo previsto y kernels seleccionados para las operaciones dominantes |
| Capacidad | Uso de memoria con las longitudes de entrada y salida y la concurrencia previstas |
| Calidad | Errores relevantes para la aplicación frente al modelo de referencia con datos representativos |
| Respuesta | Tiempo hasta el primer token, tiempos de los tokens posteriores y percentiles de latencia |
| Coste | Capacidad útil de servicio, conversión del modelo y mantenimiento de la configuración |
La explicación de las métricas de servicio de vLLM distingue la tasa bruta de salida de goodput: la capacidad que cumple los objetivos del servicio. En una aplicación interactiva, el número de solicitudes atendidas dentro de límites aceptables de calidad y latencia es más útil que la tasa máxima de tokens de una ejecución aislada. Los tiempos de carga y calentamiento deben informarse por separado de las mediciones en régimen estable.
Si un despliegue INT8 existente satisface las necesidades del servicio, la aparición de otra generación de GPU no justifica por sí sola una migración. Para un despliegue nuevo, la comparación debe incluir la preparación del modelo, las pruebas de calidad y el mantenimiento del software. Una GPU más cara con una vía FP8 madura puede costar menos al operarla; también puede ser preferible conservar la infraestructura actual. La misma prueba de modelo y servicio debe decidir entre ambas opciones.
Fuentes y base numérica
Las fuentes se enlazan junto a las afirmaciones que sustentan. El gráfico utiliza las especificaciones H200 y la tabla 3 del informe técnico Blackwell; sus datos descargables registran la base de cada fila. La revisión numérica del artículo de origen es del 8 de septiembre de 2026.
Los resultados de software se refieren a las versiones examinadas en el estudio de agosto de 2026. Este artículo no presenta una prueba independiente de B300, y el estudio de base no auditó TensorRT-LLM. La referencia inicial a TensorRT se utiliza únicamente para explicar los formatos numéricos.