Imagine una organización que conserva sus datos sensibles de entrenamiento en un entorno separado. El equipo de desarrollo no tiene cuentas de acceso a la base de datos, los archivos reales no se copian a los ordenadores del personal y el entrenamiento se ejecuta mediante una canalización automatizada. A primera vista, el problema parece resuelto: las personas no ven los datos y las máquinas realizan el trabajo necesario.
Pero ¿qué ocurre si un desarrollador puede modificar el programa de entrenamiento e incluir algunos registros en un informe de error? ¿Y si el equipo puede descargar el modelo y este revela información de sus datos de entrenamiento? Si un administrador de infraestructura puede leer la memoria del entorno de ejecución u obtener su clave de descifrado, ¿qué ha garantizado realmente la eliminación de una cuenta de base de datos?
Una nota anterior sobre confidencialidad de datos y procesamiento autorizado (en persa) distinguía el derecho a procesar información del derecho a recibir los datos en bruto. Hacer efectiva esa distinción es un problema arquitectónico: debe ser posible realizar un cálculo concreto sin entregar a quien lo ejecuta información que exceda el permiso concedido. Este artículo examina las condiciones necesarias para conseguirlo.
Retirar a las personas del recorrido de los datos es un objetivo arquitectónico
En la formulación de IA de confianza cero de esta colección, un objetivo importante consiste en diseñar y automatizar los flujos de datos de modo que su ejecución rutinaria no exija inspeccionar, mover o manipular datos sensibles en bruto. Las personas definen el problema y sus usos permitidos, construyen el proceso y examinan evidencia de su funcionamiento. Los datos sensibles permanecen en un recorrido controlado.
El nivel 4 del modelo de madurez de ZTAI introduce este objetivo mediante la separación entre desarrollo y producción. La siguiente pregunta es qué facultades permanecen después de esa separación y si su combinación reconstruye el acceso a los datos.
Este es el enfoque arquitectónico discutido en la colección, no la definición de una norma ZTAI independiente y aprobada. La arquitectura de confianza cero de NIST ya abarca recursos, servicios y flujos de trabajo. Aquí se pone el énfasis en rediseñar el proceso para eliminar la intervención humana directa innecesaria sobre datos sensibles.
La afirmación también necesita un modelo de amenazas declarado. ¿Restringe a desarrolladores, operadores de infraestructura, proveedores de nube o a una combinación de ellos? ¿Contempla la colusión entre roles? ¿En qué componentes de hardware y software sigue confiando? Sin estos supuestos, «sin acceso humano» es una afirmación demasiado amplia para evaluarla.
La capacidad de cambiar código puede reconstruir la capacidad de leer
Un programa autorizado a procesar datos en bruto recibe necesariamente cierto acceso a ellos. Si un desarrollador puede cambiar ese programa y recibir resultados sin restricciones, puede indicarle que coloque los datos en un archivo de salida. No existe la cuenta de base de datos, pero sí un mecanismo de lectura indirecta.
El mismo problema puede aparecer sin intención maliciosa. La depuración puede registrar entradas reales, los manejadores de errores pueden incluir el registro que falló y la telemetría puede enviar muestras a un sistema que el equipo de desarrollo puede inspeccionar.
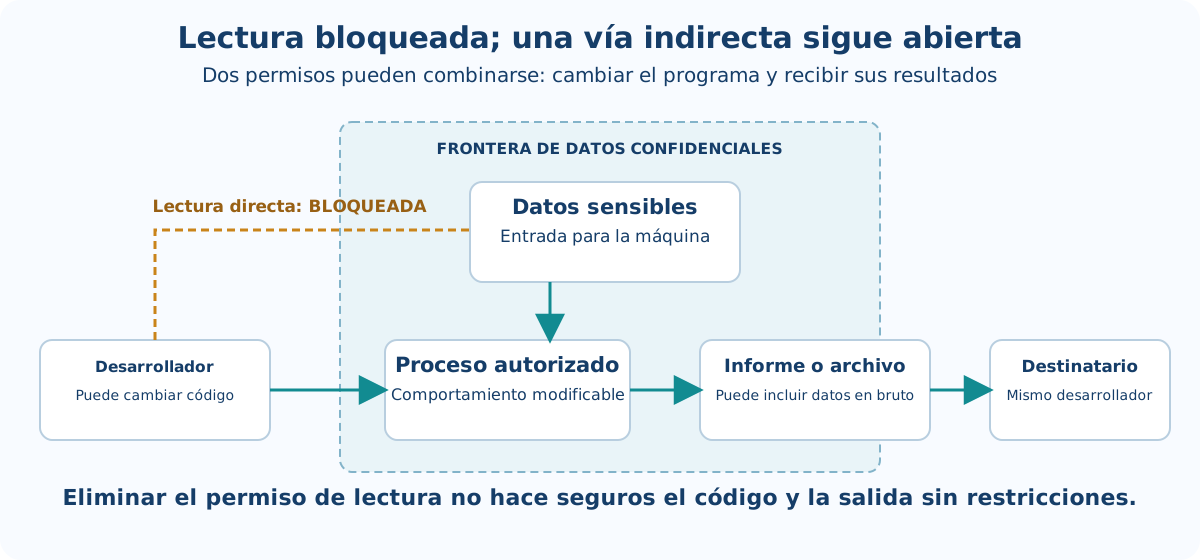
Una solicitud de procesamiento necesita, por tanto, algo más que el nombre del programa o la identidad del solicitante. Debe especificar la versión del código, los datos autorizados, la operación, el destino de salida, la vigencia y los límites de recursos. El permiso para entrenar sobre un conjunto de datos no debe convertirse en permiso para ejecutar cualquier programa y producir cualquier salida sobre él.
Las firmas y los registros de procedencia son evidencia necesaria, pero no responden a todas las preguntas. Una firma establece la identidad y la integridad del paquete admitido; no demuestra su buen comportamiento. Los análisis de seguridad y las revisiones contribuyen a la evidencia de admisión. Para código arbitrario de propósito general, unas pocas comprobaciones preliminares no establecen que todas las vías de divulgación estén cerradas. Las restricciones durante la ejecución y los controles de salida deben mantenerse después de la admisión.
Separar tres tipos de autoridad
La separación de funciones significa algo más que escribir tres nombres en una tabla. Hay que hacer efectivas tres facultades independientes: definir el procesamiento, admitirlo para su ejecución y autorizar la publicación de sus resultados.
El equipo de desarrollo puede construir el cálculo propuesto. Una autoridad de admisión comprueba si esa versión concreta se ajusta a la tarea, el entorno y las restricciones. Una autoridad de publicación decide qué resultado puede llegar a qué destinatario y con qué detalle. Las decisiones rutinarias pueden automatizarse; la independencia no exige tres aprobaciones manuales para cada trabajo.
La carga de procesamiento no debe poder cambiar la política que la gobierna, añadir otro destino de salida o detener el registro de evidencia. Del mismo modo, la autoridad para modificar el código no debe permitir al desarrollador eludir los controles de salida. Si un administrador conserva la capacidad de cambiar todas esas restricciones, la confianza en él sigue formando parte de la arquitectura y debe declararse explícitamente.
El motor de políticas forma parte del problema. Desplegarlo como servicio separado no establece su independencia. Importan la autoridad para cambiar sus reglas, la clave de firma, la vía de despliegue y las cuentas administrativas. Un control solo es independiente en la medida en que el componente controlado no pueda redefinirlo.
El control de versiones y la reproducibilidad de MLOps aportan la base. Sin saber qué versión del código se ejecutó, con qué política y sobre qué datos, no puede examinarse de manera útil esa separación de facultades.
La frontera de salida atraviesa todas las canalizaciones
El modelo de madurez describe fronteras alrededor de la preparación de datos, el entrenamiento, la evaluación y el despliegue. El control de salida debe atravesar las cuatro. Un informe de limpieza de datos, una métrica de evaluación y un archivo de modelo pueden salir del entorno confidencial; cada uno necesita una regla de publicación adecuada.
Bloquear la conexión a internet no basta. Si los informes llegan a un panel interno de experimentos visible para el equipo de desarrollo, la información puede cruzar allí la frontera prevista. La confidencialidad depende de lo que el destinatario esté autorizado a recibir, no simplemente de que el destino sea interno.
| Vía de salida | Qué podría revelar | Controles adecuados |
|---|---|---|
| Informes de error y registros | Entradas reales, identificadores o contenido de registros | Esquemas restringidos, eliminación de contenido sensible antes de registrarlo y límites de acceso |
| Archivos temporales y artefactos de depuración | Fragmentos de datos o memoria del proceso | Conservación dentro de la frontera protegida e impedimento de descarga automática |
| Métricas e informes estadísticos | Características de una persona, datos de un grupo pequeño o condiciones sensibles de la organización | Límites de detalle, evaluación conjunta de resultados y controles de solicitudes repetidas |
| Pesos, adaptadores y puntos de control | Información extraíble del modelo o datos insertados deliberadamente en un archivo | Comprobaciones estructurales, evaluación de divulgación y autorización separada para publicar el modelo |
| Representaciones vectoriales e índices de recuperación | Información derivada de documentos sensibles | Conservación de clasificación y permisos, separación de usuarios y controles de descarga |
| Datos sintéticos | Reproducción o inferencia de información del conjunto original | Evaluación del método de generación y del riesgo antes de su publicación |
| Copias de seguridad e instantáneas | Copias de datos, secretos o memoria capturada | Cifrado, separación de claves y aplicación de políticas durante la restauración |
Estas vías no tienen todas el mismo riesgo, y su existencia no significa que se haya producido una divulgación. La tabla ayuda a completar el modelo de amenazas. Eliminar nombres o cambiar el formato de un archivo no concede, por sí solo, permiso para cruzar una frontera.
En un diseño conservador, una carga de trabajo no puede enviar un archivo arbitrario al destinatario. Entrega un resultado definido a un componente independiente con autoridad de publicación. Ese componente puede comprobar tipo y tamaño, rangos de valores, detalle permitido e historial de solicitudes. Cuanto mayor sea la libertad de procesamiento y la diversidad de salidas, más difícil será demostrar que el control es adecuado.
El componente de publicación maneja información cuya divulgación todavía no ha sido aprobada. Su propio entorno y su conexión con el procesamiento deben recibir protección acorde con esa sensibilidad. Enviar información descifrada desde un entorno confidencial a un filtro externo visible para el administrador del anfitrión contradice el objetivo original de protección.
Los filtros de palabras, las expresiones regulares y los clasificadores de datos sensibles solo proporcionan una parte de la defensa. El código puede codificar información como números, repartirla entre resultados pequeños o presentarla como contenido aparentemente inocuo. Las cargas muy sensibles pueden necesitar límites sobre qué puede calcularse y devolverse. En algunos casos, un conjunto de operaciones aprobadas es más adecuado que admitir código arbitrario.
Publicar un modelo es una decisión distinta de entrenarlo
El permiso para entrenar sobre datos confidenciales no decide si alguien puede descargar los pesos. Una organización puede permitir que el modelo funcione como servicio dentro del entorno y prohibir la exportación de su artefacto. Las respuestas del servicio siguen necesitando control: mantener los pesos dentro no impide automáticamente la divulgación mediante inferencia.
Conviene distinguir dos riesgos. Un programa no fiable puede insertar deliberadamente información en un archivo de salida. Por separado, un entrenamiento legítimo puede producir un modelo que conserve información de sus ejemplos y la revele en determinadas condiciones. Las comprobaciones de formato solo limitan parcialmente el primer riesgo. La evaluación de divulgación mediante el comportamiento aborda el segundo.
SACRO-ML ofrece herramientas para evaluar el riesgo de divulgación de modelos antes y después del entrenamiento en entornos de investigación protegidos. Este enfoque añade evidencia a la decisión de publicación. Que fallen los ataques ensayados no constituye una garantía matemática de ausencia de divulgación, y la cobertura de una herramienta no debe generalizarse a todas las arquitecturas de modelo.
Los datos sintéticos requieren el mismo cuidado. La información generada a partir de un conjunto sensible puede revelar información de ese conjunto. NIST SP 800-226, directrices para evaluar garantías de privacidad diferencial, publicado en marzo de 2025, examina los límites de estas garantías. En aplicaciones adecuadas, la privacidad diferencial puede limitar la influencia de una persona u otra unidad protegida definida en los resultados publicados. La garantía depende de esa unidad, de los parámetros y de la implementación; no abarca todos los secretos operativos de una organización.
Los resultados pequeños pueden revelar mucho al combinarse
El control de salida no puede evaluar cada solicitud como si fuera la primera. Supongamos que dos informes precisos y permitidos devuelven sumas para grupos que difieren en un solo miembro. Restar los resultados puede revelar el valor de ese miembro, aunque ninguno de los informes contenga un nombre o un registro en bruto.
La autorización debe considerar, por tanto, el historial de solicitudes, el solapamiento entre grupos, la repetición y las combinaciones de información publicada. Los tamaños mínimos de grupo y los límites de solicitudes pueden contribuir a la protección, pero no ofrecen una garantía universal. Los sistemas de privacidad diferencial también necesitan contabilizar el presupuesto de privacidad acumulado entre publicaciones, en lugar de reiniciarlo con cada solicitud; véase NIST SP 800-226.
Esto tiene una consecuencia arquitectónica. La autoridad de publicación necesita el estado requerido para evaluar solicitudes relacionadas. Si cada trabajo breve aplica la política sin conocimiento de los anteriores, una restricción eficaz dentro de una ejecución puede fallar en la secuencia completa.
Cuando también debe excluirse al administrador de infraestructura
Eliminar el acceso del equipo de desarrollo deja sin resolver la cuestión del administrador del anfitrión. En muchos sistemas convencionales, un control suficiente sobre el sistema operativo o la capa de virtualización permite interferir con procesos y memoria. El cifrado de disco por sí solo no resuelve el problema: el procesamiento ordinario requiere descifrar en algún punto.
Como se explica en Los contenedores no son fronteras de seguridad independientes (en persa), aislar una aplicación de su entorno de desarrollo es distinto de protegerla frente al administrador del anfitrión. Si ese administrador forma parte del modelo de amenazas, el entorno de ejecución debe sostener ese supuesto.
La computación confidencial puede proporcionar parte de esta protección mediante entornos de ejecución de confianza, o TEE, respaldados por hardware. El patrón general mantiene cifrados los datos y modelos hasta que se acepta la evidencia del entorno; después entrega una clave al entorno que cumple la política de admisión. La guía de computación confidencial de NVIDIA describe la combinación de entornos confidenciales de CPU y GPU, atestación y entrega condicional de claves.
Esto cambia la frontera de confianza; no elimina todos los componentes en los que se confía. La protección frente al administrador del anfitrión no restringe necesariamente al administrador dentro del sistema invitado ni a un programa malicioso autorizado que se ejecute en el entorno protegido. Las vulnerabilidades de hardware y software, los canales laterales y la denegación de servicio deben considerarse según la tecnología elegida. Añadir «TEE» a un diagrama no resuelve estas cuestiones.
En una carga de IA, la protección puede necesitar abarcar la memoria de CPU, la memoria de GPU y el recorrido de transferencia entre ambas. No basta con el soporte del chip: servidor, firmware, controladores y modo de despliegue deben funcionar juntos. Esta relación se desarrolla en Seguridad de la infraestructura de IA desde el núcleo hasta la GPU. La descripción de los componentes de un servidor GPU en español ofrece el contexto general de hardware.
La atestación debe determinar una decisión efectiva
La atestación ayuda a restringir el acceso cuando su resultado modifica una decisión real: por ejemplo, si una ejecución concreta recibe una clave de descifrado. Un informe que solo se archiva no impide que un entorno inaceptable procese datos.
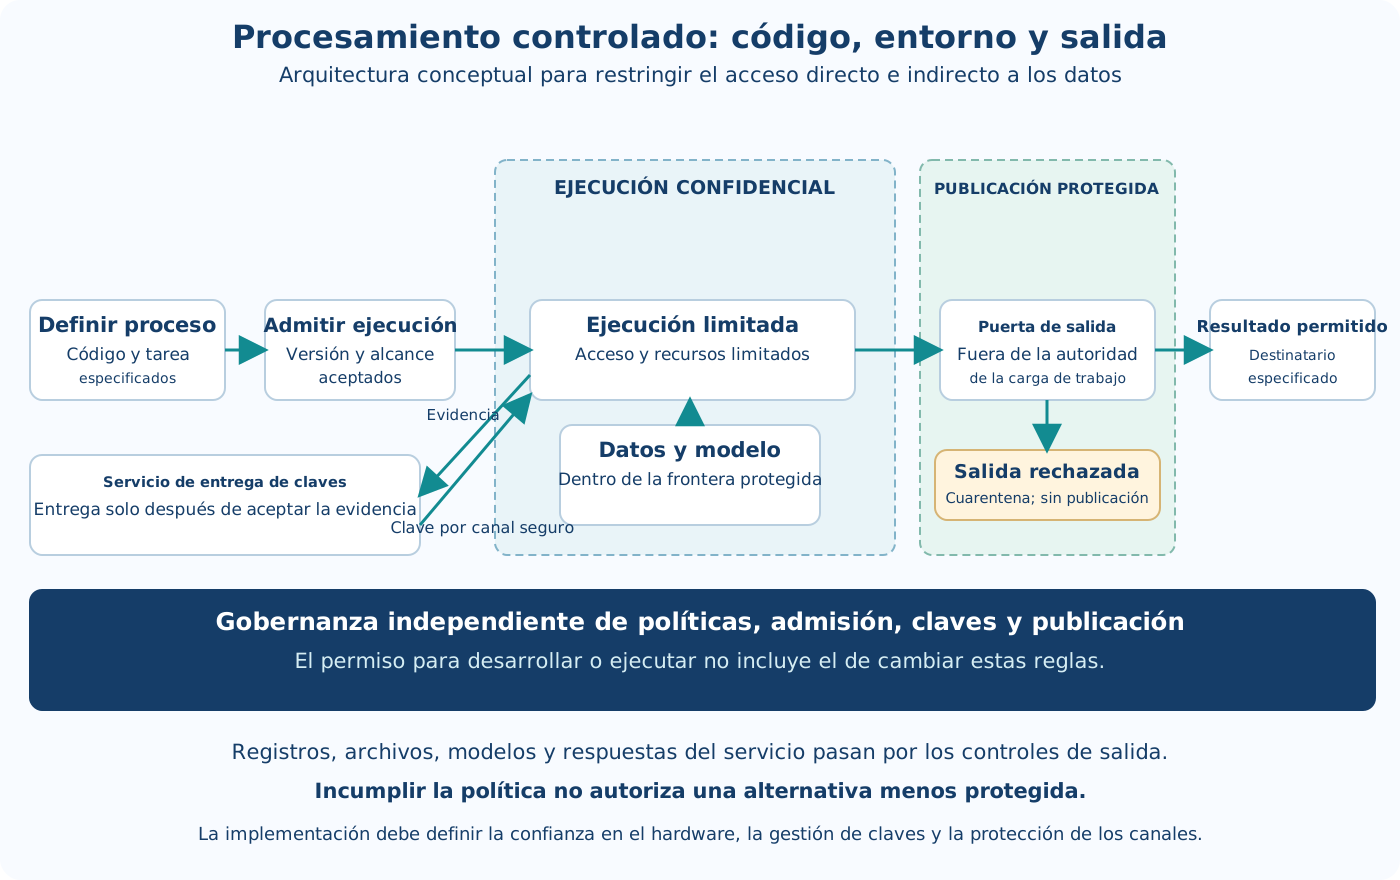
En el diseño propuesto, la evidencia debe corresponder al entorno y a la ejecución previstos, y debe comprobarse su vigencia. La política define las mediciones aceptables y la identidad y el canal protegido al que se entrega la clave. También deben controlarse los cambios de la política de referencia. De lo contrario, quien modifica el entorno puede limitarse a declarar aceptable su nuevo estado.
La protección debe continuar después de entregar la clave. Si el proceso puede cargar código nuevo, alterar archivos admitidos o transmitir su clave, aceptar el estado inicial resulta insuficiente. A la inversa, rechazar futuras solicitudes no borra necesariamente una clave ya entregada ni los datos ya descifrados. La política de terminación, la vigencia de las credenciales y la limpieza deben tener en cuenta esa realidad.
La atestación tiene un alcance limitado: medir un componente no demuestra la corrección semántica de todos los cálculos. La nota sobre desviación de configuración, atestación y reversión (en persa) desarrolla esta distinción. La evidencia válida necesita un estado de referencia, una decisión de aplicación de políticas y una respuesta práctica cuando cambian las condiciones.
El mantenimiento no debe crear una vía de acceso permanente
Las excepciones de mantenimiento pueden ser más poderosas que las operaciones ordinarias. Se abre acceso temporal para depurar, se mueve una instantánea a otro entorno para investigarla o se envía un volcado de memoria a un contratista. Parte de ese acceso puede mantenerse tras resolver el incidente.
Una arquitectura que pretende reducir el acceso humano debe diseñar los diagnósticos desde el principio: registros estructurados y restringidos, reproducción de fallos con datos de prueba, ejecución de diagnósticos dentro de la frontera y recuperación desde una versión aceptada. Una solicitud de reparación no debe convertirse automáticamente en permiso para recibir datos en bruto.
Cuando la inspección humana sea inevitable, trátese como una excepción acotada. Registre el problema, la persona autorizada, el alcance de los datos y el vencimiento. Después, restablezca las restricciones y revise los efectos del acceso. Esto es más preciso que afirmar su eliminación completa y aporta evidencia para reducir excepciones futuras.
La automatización también debe detenerse cuando las condiciones exigidas no sean válidas. Un sistema que desactiva sus controles de salida o recurre a una vía menos protegida para seguir funcionando abandona sus restricciones en un momento crítico. Las cargas que necesitan continuidad requieren una alternativa diseñada y probada de antemano, con límites de protección explícitos.
Qué evidencia demuestra que el acceso se ha restringido realmente
Una afirmación arquitectónica debe conducir a preguntas comprobables. La ausencia de una cuenta humana en la base de datos no contempla todas las vías hacia la información. La auditoría debe examinar las facultades que pueden combinarse y los resultados que pueden recibirse.
| Pregunta de auditoría | Evidencia que debe buscarse | Qué no basta por sí solo |
|---|---|---|
| ¿Puede un desarrollador ejecutar código arbitrario sobre los datos? | Admisión de una versión concreta, restricciones durante la ejecución y pruebas de intento de evasión | Un repositorio Git o una firma del paquete |
| ¿Pueden salir resultados por otra vía? | Inventario de salidas y pruebas de registros, archivos y comunicaciones | Ausencia de conexión a internet |
| ¿Puede la carga cambiar sus propias restricciones? | Separación de la autoridad de políticas, claves y publicación respecto al procesamiento | Un motor de políticas en otro servicio |
| ¿Puede el administrador del anfitrión observar los datos? | Modelo de amenazas explícito y evidencia de que la configuración de protección lo respalda | Cifrado de disco o despliegue en contenedores |
| ¿Pueden los resultados repetidos eludir el límite? | Evaluación de solicitudes relacionadas y contabilidad acumulada adecuada | Aprobación independiente de cada resultado |
| ¿Ha creado la depuración una vía duradera de acceso? | Historial de excepciones, vencimiento y restauración verificada de controles | Una solicitud de soporte |
Las pruebas tienen límites. Superar un conjunto de escenarios aporta evidencia sobre esos escenarios, no demuestra que todos los ataques posibles estén cerrados. El tiempo de ejecución, el tamaño de salida y los patrones de error pueden ser canales de comunicación en modelos de amenazas más estrictos. La fuerza de la afirmación debe corresponder a lo que se diseñó y probó.
Siga dos medidas por separado: cuánto se ha automatizado el flujo y cuánto se ha reducido el acceso humano. Una canalización totalmente automatizada puede seguir permitiendo que muchas personas obtengan sus datos, su memoria o sus salidas sin restricciones. Cuente las vías directas e indirectas, las facultades privilegiadas que eluden los controles y el uso de excepciones junto con las métricas de automatización.
Mantener posible el uso autorizado de los datos
El propósito es hacer viable el procesamiento autorizado. Detener todo cálculo puede impedir la divulgación, pero no satisface la necesidad de desarrollo. Conceder más acceso cada vez que desarrollar resulta difícil también vuelve insostenible la frontera. Las buenas herramientas de desarrollo y diagnóstico forman parte de la viabilidad de la arquitectura.
OpenSAFELY ofrece un ejemplo práctico en esta dirección: el código de investigación se lleva a los datos, el desarrollo puede utilizar datos ficticios y los investigadores reciben resultados agregados. El ejemplo tiene un alcance definido. El proyecto excluye a los propietarios de los centros de datos de su afirmación de ausencia de acceso. Demuestra que es posible desarrollar sin acceso irrestricto del investigador, no que se cumplan todos los supuestos de la arquitectura más exigente discutida aquí.
En ZTAI, eliminar el acceso humano adquiere sentido cuando se consideran conjuntamente la observación directa, los cambios de procesamiento, la publicación de información y la administración de infraestructura. Las personas siguen siendo responsables de la finalidad, la autoridad permitida y el riesgo aceptado. La ejecución rutinaria debería continuar dentro de esos límites sin volver repetidamente a los datos en bruto.
La prueba final no es solo quién puede ver los datos hoy. Es quién puede obtener información después de cambiar el código, durante un fallo y al recibir un resultado, y qué control conserva el límite previsto en cada caso.
Vuelva a la colección técnica de ZTAI o revise los principios y controles que sostienen estas fronteras.