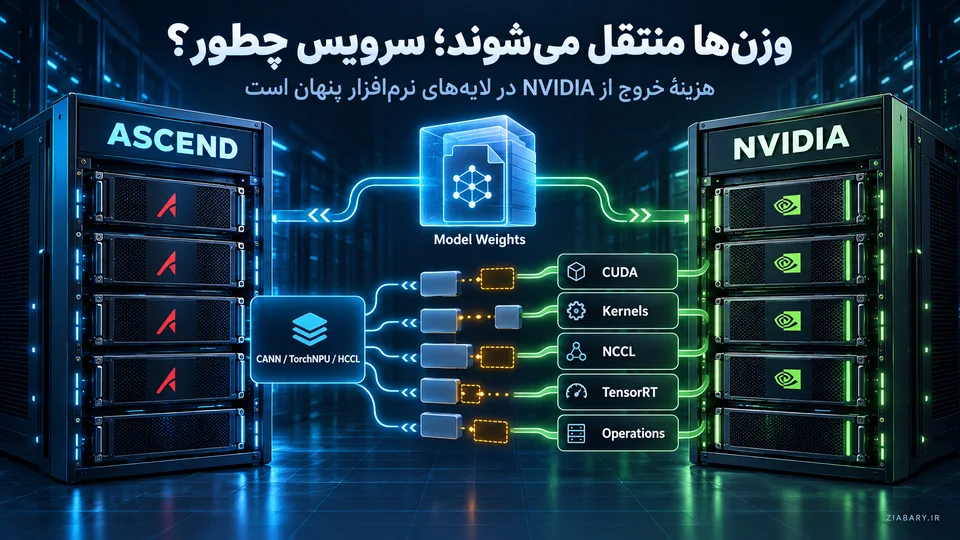
CUDA فقط یک کتابخانه نیست؛ هزینهٔ خروج از NVIDIA کجا پنهان میشود؟
در یادداشت اول این مجموعه بحثم این بود که مسئله، خوب یا بد بودن NVIDIA نیست؛ مسئله این است که وقتی تمام زیرساخت هوش مصنوعی را بر پایهٔ محصولات یک سازنده بنا میکنیم، بهتدریج امکان انتخابهای بعدی خود را محدود میکنیم. در یادداشت دوم از بحث سیاستگذاری فاصله گرفتم و سعی کردم Ascend و NVIDIA را از نظر مشخصات سختافزاری، حافظه، ارتباطات، کرنلها و اجرای واقعی مدل مقایسه کنم. اما بازخوردهای این دو یادداشت سؤال دیگری را پیش کشید که شاید از مقایسهٔ خود تراشهها هم به تصمیم امروز ما نزدیکتر باشد: اگر فردا یک سرور Ascend با توان کافی کنار سرور NVIDIA قرار بدهیم، آیا میتوانیم مدل و سرویسی را که ساختهایم به آن منتقل کنیم؟
پاسخ اولیه معمولاً این است که مشکل CUDA است؛ ولی اگر CUDA را فقط یک کتابخانه یا حتی یک رابط برنامهنویسی بدانیم، بخش بزرگی از مسئله را ندیدهایم. همانطور که معرفی سکوی CUDA در مستندات NVIDIA توضیح میدهد، این سکو از مدل برنامهنویسی و محیط اجرا تا رابط راهانداز، مترجم، مجموعهدستورهای مجازی PTX، کتابخانههای محاسباتی و ابزارهای توسعه را در بر میگیرد. در سامانهای که بر پایهٔ این سکو ساختهایم، کتابخانههای ارتباط میان پردازندهها، موتور استنتاج، ابزارهای تحلیل کارایی و شیوهٔ استقرار نیز ممکن است به همان سختافزار وابسته شده باشند. بنابراین برای فهم هزینهٔ مهاجرت، شمارش چند فراخوانی CUDA کافی نیست؛ باید ببینیم چند لایه از سامانه با این فرض ساخته شدهاند که سختافزار مقصد حتماً NVIDIA است.
وابستگی همیشه نتیجهٔ تصمیم اشتباه نیست
پیش از ادامه لازم است روشن کنم که منظورم از وابستگی به فروشنده، الزاماً طراحی عمدی یک تله از سوی سازنده نیست. بخش مهمی از وابستگی به NVIDIA نتیجهٔ طبیعی تلاش برای بهینهسازی است. فرض کنید کرنل عمومی PyTorch روی H100 برای بار کاری ما بهاندازهٔ کافی سریع نیست و تیم آن را با CUDA بازنویسی میکند. در مرحلهٔ بعد، برای کاهش تأخیر از CUDA Graph استفاده میشود، ارتباط هشت پردازندهٔ گرافیکی به NCCL سپرده میشود و موتور استنتاج نیز TensorRT یا TensorRT-LLM است. اگر بستههای اجرایی هم بر پایهٔ تصاویر کانتینری CUDA ساخته شوند و تحلیل کارایی با ابزارهای NVIDIA انجام شود، هر مرحله از این مسیر میتواند بهتنهایی تصمیمی منطقی و حتی ضروری باشد.
مسئله زمانی آشکار میشود که پس از چند سال بخواهیم حاصل این تصمیمها را به سختافزار دیگری منتقل کنیم. ممکن است وزنهای مدل بهسادگی جابهجا شوند، اما کرنل بهینهشده، موتور استنتاج، تنظیمات ارتباطی و ابزارهای عملیاتی همراه آنها منتقل نشوند. انتقالپذیری مدل با انتقالپذیری سرویس یکی نیست و اگر این دو را یکسان فرض کنیم، برآورد ما از هزینهٔ تغییر زیرساخت از همان ابتدا ناقص خواهد بود.
وقتی میگوییم مدل قابل انتقال است، منظورمان چیست؟
در بسیاری از بحثها، موفقیت مهاجرت با این سؤال سنجیده میشود که «مدل روی سختافزار جدید اجرا شد یا نه؟» اجرای مدل شرط لازم است، اما برای تصمیم زیرساختی کافی نیست؛ چون ممکن است خروجی تولید شود ولی کیفیت آن تغییر کرده باشد، تأخیر از حد قابل قبول بالاتر برود یا نگهداری سرویس برای تیم عملیات دشوار شود. به همین دلیل باید دستکم چهار وجه متفاوت انتقالپذیری را از یکدیگر جدا کنیم:
| وجه انتقالپذیری | سؤال اصلی |
|---|---|
| عملکردی | آیا مدل روی سختافزار دیگر اجرا میشود و عملیات موردنیاز آن پشتیبانی میشوند؟ |
| عددی | آیا خروجی و کیفیت مدل در محدودهٔ قابل قبول باقی میماند؟ |
| کارایی | آیا زمان تا نخستین توکن (TTFT)، زمان تولید هر توکن خروجی (TPOT)، توان عملیاتی و مصرف حافظه همچنان مناسباند؟ |
| عملیاتی | آیا استقرار، پایش، افزایش ظرفیت، بازیابی سرویس پس از خرابی و نگهداری آن شدنی است؟ |
ممکن است رسیدن به سطح اول یک روز زمان ببرد، اما بازگرداندن کارایی قبلی چند هفته یا چند ماه طول بکشد. در چنین وضعیتی، جملهٔ «مدل روی Ascend اجرا شد» فقط بخشی از مسیر را توصیف میکند و هنوز چیزی دربارهٔ مناسببودن آن برای سرویسدهی با تعهدات سطح خدمت موردنظر ما نمیگوید. هزینهٔ واقعی مهاجرت را باید در مجموع این چهار وجه سنجید.
وزنهای مدل معمولاً آغاز مسئله نیستند
در بسیاری از سامانهها، وزنهای مدل از کموابستهترین اجزا هستند. یک نسخهٔ ذخیرهشدهٔ استاندارد PyTorch یا فایلی با قالب Safetensors ذاتاً متعلق به NVIDIA نیست و وزنهای Llama یا Qwen نیز به CUDA تعلق ندارند. اگر محیط اجرای مقصد از معماری مدل، نوع داده و عملگرهای لازم پشتیبانی کند، میتوان این وزنها را بارگذاری کرد. البته همین شرط پشتیبانی مهم است؛ یکسانبودن فایل مدل به معنی آمادهبودن همهٔ لایههای اجرای آن نیست.
با ورود به کوانتیزهسازی، یعنی کاهش دقت عددی برای کمکردن حجم و هزینهٔ محاسبه، وابستگی بیشتر میشود. همانطور که در یادداشت INT8 و FP8 توضیح داده بودم، عنوان «FP8» بهتنهایی مشخص نمیکند مدل از چه مسیر محاسباتی اجرا خواهد شد. در مستندات کوانتیزهسازی TensorRT-LLM نیز پشتیبانی از قالبها و روشهایی مانند FP8، MXFP8، NVFP4، AWQ و GPTQ به نسل سختافزار و مسیر اجرا وابسته است. بنابراین ممکن است وزنهای اصلی قابل انتقال باشند، اما نسخهای که برای سختافزار مشخصی کمدقت و بهینه کردهایم، روی مقصد جدید به همان شکل قابل استفاده نباشد.
برنامهٔ PyTorch الزاماً برنامهٔ CUDA نیست
یکی از تمایزهای مهم این بحث آن است که استفاده از PyTorch را نباید با وابستگی قطعی به CUDA یکسان گرفت. PyTorch سازوکارهایی برای پشتیبانی از شتابدهندههای دیگر دارد و در راهنمای یکپارچهسازی شتابدهندهها، امکاناتی مانند PrivateUse1 و torch.accelerator را در همین مسیر توضیح میدهد. این سازوکارها به توسعهدهندگان اجازه میدهند پشتیبانی از سختافزار جدید را به چارچوب اضافه کنند؛ هرچند وجود مسیر توسعه، بهخودیخود به معنی پشتیبانی کامل از همهٔ مدلها و قابلیتها نیست.
اثر این انتخاب را میتوان در کد خود برنامه هم دید. در نمونهٔ زیر، انتخاب دستگاه از جابهجایی مدل و داده جدا شده است و تا زمانی که عملگرهای موردنیاز پشتیبانی شوند، کد اصلی مجبور نیست نام سازندهٔ سختافزار را بداند:
device = get_device()
model = model.to(device)
x = x.to(device)
در مقابل، نمونهٔ زیر انتخاب CUDA را مستقیماً وارد منطق برنامه میکند و هنگام مهاجرت، همین فرض باید در محلهای مختلف شناسایی و اصلاح شود:
torch.cuda.set_device(0)
model.cuda()
x = x.cuda()
این تفاوت در ظاهر کوچک است، اما وقتی در یک پروژه تکرار شود، مرز میان کد مدل و کد وابسته به سختافزار را تعیین میکند. توصیهٔ مستندات ثبت پشتیبانی از سختافزار جدید در PyTorch نیز استفاده از رابطهای عمومی مانند to(device=...) تا جای ممکن است. اگر برنامه از عملگرهای استاندارد استفاده کند و انتخاب دستگاه را از منطق اصلی جدا نگه دارد، بخشی از هزینهٔ مهاجرت کاهش مییابد؛ ولی هرچه برای افزایش کارایی از این لایهٔ عمومی پایینتر برویم، مسئولیت انتقالپذیری بیشتری بر عهدهٔ خودمان قرار میگیرد.
کرنل اختصاصی و CUDA Graph؛ هزینهٔ بهینهسازی در لایههای پایینتر
وقتی کارایی کرنل عمومی کافی نیست، ممکن است یک عملگر را با CUDA C++ بازنویسی کنیم، فایل .cu داشته باشیم و آن را با NVCC ترجمه کنیم. در این مرحله دیگر فقط از قابلیت عمومی PyTorch استفاده نمیکنیم؛ بخشی از برنامه را مشخصاً برای سکوی NVIDIA نوشتهایم. اگر کارایی سرویس به همین بخش وابسته باشد، انتقال مدل به Ascend مستلزم آن است که برای این کرنل، پیادهسازی معادل پیدا کنیم یا آن را برای سختافزار مقصد بازنویسی کنیم.
وجود PTX هم این مسئله را حل نمیکند. مطابق توضیح مستندات سکوی CUDA دربارهٔ سازگاری کد، PTX مجموعهدستورهای مجازی NVIDIA است که راهانداز آن را برای پردازندهٔ مقصد به کد اجرایی تبدیل میکند. این سازوکار به سازگاری با نسلهای بعدی در خانوادهٔ CUDA کمک میکند؛ قرار نیست یک نمایش میانی مستقل از سازنده باشد که همان کد را روی Ascend نیز اجرا کند. حتی سازگاری کد دودویی cubin میان نسلهای اصلی قابلیت محاسباتی NVIDIA را نیز نباید بدیهی فرض کرد.
PyTorch برای عملگرهای اختصاصی امکان ثبت پیادهسازیهای متفاوت و انتخاب آنها بر اساس دستگاه را فراهم کرده است، اما این امکان را باید از وجود پیادهسازی آماده جدا کرد. در راهنمای پشتیبانی از عملگرهای PyTorch همین مسئولیت برای شتابدهندهٔ جدید توضیح داده میشود: مجموعهٔ عملگرها و گونههای موردنیاز باید پوشش داده شوند. اگر عملگر خاص پروژهٔ ما در این مجموعه نباشد، عمومیبودن چارچوب، کار بازنویسی آن را از دوش تیم برنمیدارد.
وابستگی البته به نوشتن کرنل محدود نمیشود. در استنتاج با دستههای کوچک داده و کرنلهای سریع، هزینهٔ آمادهسازی و آغاز اجرای عملیات از سمت پردازندهٔ اصلی میتواند قابل توجه باشد. سازوکاری که در راهنمای CUDA Graph شرح داده شده، اجازه میدهد عملیات و وابستگیهایشان یکبار تعریف و آماده شوند و سپس با سربار کمتر تکرار شوند. اگر تأخیر قابل قبول سرویس ما حاصل استفاده از این قابلیت باشد، محیط اجرای مقصد علاوه بر پشتیبانی از عملگرهای مدل، باید سازوکاری با کارایی مناسب برای اجرای گراف نیز داشته باشد. این همان جایی است که تفاوت «مدل اجرا میشود» و «مدل با کارایی موردنیاز اجرا میشود» خود را نشان میدهد.
ارتباط میان پردازندهها؛ تغییر نام NCCL به HCCL کافی نیست
روی یک پردازندهٔ گرافیکی، بخش بزرگی از پیچیدگی ارتباطات توزیعشده دیده نمیشود؛ اما وقتی مدل یا داده را میان چند پردازنده تقسیم میکنیم، کتابخانهٔ ارتباطی وارد مسیر اصلی اجرا میشود. مطابق معرفی NCCL در مستندات NVIDIA، این کتابخانه برای عملیات ارتباطی جمعی مانند AllReduce، AllGather، ReduceScatter و AllToAll و نیز ارسال و دریافت داده طراحی شده و ساختار اتصال پردازندهها را در اجرای بهینهٔ این عملیات در نظر میگیرد. در آموزش توزیعشده و مدلهای ترکیب کارشناسان (MoE)، زمان صرفشده در همین لایه میتواند بخش مهمی از نتیجهٔ نهایی را تعیین کند.
فرض کنید در برنامه، گروه پردازشی را به این شکل ساختهایم:
dist.init_process_group(backend="nccl")از نظر تغییر متن برنامه، جایگزینکردن nccl با hccl کار بزرگی به نظر نمیرسد و راهنمای مهاجرت چنددستگاهی Ascend نیز جایگزینی NCCL با HCCL را از تغییرهای لازم معرفی میکند. بااینحال، کارایی اجرای توزیعشده فقط به نام کتابخانه وابسته نیست؛ ساختار اتصالها، تعداد فرایندها، اندازهٔ دادههای مبادلهشده، همپوشانی ارتباط و محاسبه، شیوهٔ تقسیم کارشناسان و الگوریتم عملیات جمعی همگی بر زمان اجرا اثر میگذارند. بنابراین ممکن است تغییر اصلی در یک خط کد انجام شود، ولی رسیدن به کارایی قبلی مستلزم بازبینی و تنظیم دوبارهٔ کل الگوی ارتباطی باشد.
موتور استنتاج و کانتینر هم بخشی از وابستگیاند
در استنتاج، یکی از سطوح مهم وابستگی زمانی شکل میگیرد که مدل را به یک موتور اجرایی بهینهشده تبدیل میکنیم. TensorRT شبکه را بهینه میکند، روش اجرای عملیات را انتخاب میکند و در نهایت میتواند موتور ساختهشده را در فایل ذخیره کند. این فایل با نسخهٔ ذخیرهشدهٔ وزنهای مدل یکسان نیست. در جدول پشتیبانی TensorRT، محدودیتهای سازگاری موتور با سکو، نسخه و سختافزار توضیح داده شدهاند و راهنمای سازگاری موتور نیز روشن میکند که فایل موتور، روشهای اجرایی ترجمهشدهٔ CUDA را در خود دارد. قابلیتهای سازگاری سختافزاری و نسخهای میتوانند بخشی از محدودیتها را کاهش دهند، ولی دامنهٔ پشتیبانی و اثر احتمالی آنها بر کارایی باید جداگانه بررسی شود.
در نتیجه، قابل انتقال بودن وزنهای Llama به معنی قابل انتقال بودن موتور TensorRT ساختهشده از آن نیست. هرچه خروجی فرایند آمادهسازی مدل به سختافزار نزدیکتر شود، سهم بیشتری از بهینهسازیهای آن به همان سختافزار گره میخورد. به همین دلیل نگهداری مدل اصلی در کنار موتور بهینهشده، برای حفظ امکان مهاجرت اهمیت دارد.
بستهبندی سرویس در کانتینر نیز این وابستگی را از بین نمیبرد. کانتینر مرز مناسبی برای بستهبندی برنامه و وابستگیهای آن فراهم میکند، اما کانتینر CUDA همچنان به راهانداز میزبان وابسته است. در یادداشتهای انتشار NVIDIA Container Toolkit، موضوع سازگاری راهانداز و کتابخانههای مربوط بخشی از ملاحظات اجراست؛ قیدهایی مانند NVIDIA_REQUIRE_CUDA نیز میتوانند اجرای کانتینر را در صورت کافینبودن نسخهٔ راهانداز محدود کنند. بنابراین اینکه «همهچیز را در Docker گذاشتهایم» بهتنهایی نشانهٔ استقلال از سختافزار نیست؛ این کار وابستگیها را مدیریتپذیرتر و نسخههایشان را مشخص میکند، اما برای انتقال میان سازندگان، همچنان باید محیط اجرای مقصد آماده شود.
هزینهٔ خروج را در کدام لایه باید جستوجو کنیم؟
اگر لایههای مختلف را کنار هم بگذاریم، روشن میشود که دو پروژه با توصیف ظاهراً یکسانِ «روی NVIDIA اجرا میشوند»، ممکن است هزینهٔ مهاجرت کاملاً متفاوتی داشته باشند. جدول زیر نتیجهٔ آزمون کارایی نیست و قرار نیست برای زمان یا هزینهٔ مهاجرت عدد بدهد؛ فقط نشان میدهد با عمیقترشدن وابستگی، چه بخشهایی باید دوباره بررسی شوند.
| وضعیت برنامه | وابستگی به NVIDIA | هزینهٔ احتمالی مهاجرت |
|---|---|---|
وزنهای استاندارد، عملگرهای عمومی PyTorch و to(device) | کم | پایین، مشروط به پشتیبانی مقصد از عملگرها |
PyTorch همراه torch.compile و بهینهسازیهای عمومی | کم تا متوسط | پایین تا متوسط، بسته به پشتیبانی مسیر ترجمهٔ مقصد |
| محیط اجرای ویژهٔ سرویسدهی، بدون کرنل اختصاصی | متوسط | متوسط |
| افزونه و کرنل اختصاصی CUDA | زیاد | زیاد |
| CUDA Graph و بهینهسازی ویژهٔ پردازندهٔ گرافیکی | زیاد | زیاد |
| اجرای چندپردازندهای با تنظیم عمیق NCCL و NVLink | زیاد | زیاد |
| موتور TensorRT یا TensorRT-LLM همراه کرنل و تنظیمات ارتباطی اختصاصی | بسیار زیاد | بسیار زیاد |
| موارد بالا همراه زنجیرهٔ یکپارچهسازی و استقرار، تحلیل کارایی و پایش وابسته به NVIDIA | ساختاری | نیازمند تغییر در نرمافزار و شیوهٔ بهرهبرداری |
برای بیان همین موضوع میتوان هزینهٔ خروج را بهصورت مجموع چند جزء نوشت؛ هزینهٔ تغییر کد، بازنویسی کرنل، بازطراحی ارتباطات، جایگزینی موتور اجرا، آمادهسازی عملیات، آموزش تیم و بازیابی کارایی:
این رابطه یک مدل عددی برای محاسبهٔ هزینه نیست؛ یادآوری میکند که تعداد خطهای تغییرکرده در برنامه، معیار کافی برای برآورد مهاجرت نیست. ممکن است تغییر کد بسیار کم باشد و مدل در ساعت اول اجرا شود، اما بازگرداندن تأخیر قبلی به هفتهها تنظیم کرنل و ارتباطات نیاز داشته باشد. حالت معکوس هم ممکن است: حجم تغییرات کد زیاد باشد ولی پس از آن، کارایی بهسرعت به سطح قابل قبول برسد. آنچه باید در تصمیم خرید و معماری دیده شود، مجموع این هزینههاست.
آیا این وابستگی فقط مختص NVIDIA است؟
یکی از نقدهای مطرحشده پس از یادداشت اول این بود که وابستگی به فروشنده در فناوری پدیدهٔ تازهای نیست. این نقد درست است؛ Cisco، Oracle، VMware، HPE، AWS و Microsoft نیز هرکدام زیستبومی دارند که خروج از آن میتواند هزینهبر باشد. بااینحال، عمق این وابستگی در همهٔ حوزهها یکسان نیست. اگر یک سرور x86 از HPE را با سرور x86 سازندهٔ دیگری جایگزین کنیم، معمولاً قرار نیست فایل اجرایی برنامه، مترجم، کتابخانهٔ عددی و شیوهٔ برنامهنویسی ریسهها را از نو طراحی کنیم؛ هرچند وابستگیهای مدیریتی و عملیاتی دیگری ممکن است باقی بمانند.
در محاسبات شتابیافته، سازنده میتواند در لایههای پایینتری از اجرای برنامه حضور داشته باشد: مجموعهدستورها، مترجم، محیط اجرا، کرنل، کتابخانهٔ ارتباطی و موتور استنتاج ممکن است همگی ویژگیهای سختافزار او را فرض گرفته باشند. بنابراین بحثم این نیست که NVIDIA پدیدهای منحصربهفرد یا الزاماً محصول رفتاری ضدرقابتی ساخته است؛ بحث این است که هزینهٔ تغییر چنین پشتهای را نمیتوان با هزینهٔ تعویض سازندهٔ یک سرور معمولی یکسان گرفت.
PyTorch، Ascend و vLLM چه بخشی از مسئله را حل میکنند؟
مسیر توسعهٔ چارچوبهای عمومی میتواند بخشی از این وابستگی را کاهش دهد. برای مثال، راهنمای تعریف بخش اجرایی اختصاصی برای torch.compile امکان ثبت مسیرهای ترجمه و اجرای متفاوت، از جمله پیادهسازیهای خارج از هستهٔ PyTorch را توضیح میدهد. هرچه برنامه بیشتر از رابطهای عمومی چارچوب استفاده کند، امکان بیشتری وجود دارد که پشتیبانی از سختافزار جدید در لایهٔ زیرین انجام شود و کد اصلی مدل تغییر کمتری بخواهد. البته وقتی برای دستیابی به کارایی بالاتر به سراغ کرنل یا محیط اجرای اختصاصی میرویم، بخشی از مسئولیت انتقالپذیری دوباره به خود پروژه برمیگردد؛ این انتخاب میتواند کاملاً موجه باشد، به شرط آنکه هزینهاش را بشناسیم.
در سمت Ascend نیز TorchNPU میان PyTorch و CANN قرار میگیرد و عملگرهای چارچوب را به کرنلهای پردازندهٔ عصبی متصل میکند. در معرفی TorchNPU از سوی هواوی، حفظ بسیاری از الگوهای برنامهنویسی PyTorch و تغییر روش انتقال دستگاه، مانند جایگزینی .cuda() با .npu()، از مسیرهای سادهٔ مهاجرت است. بااینحال، خود راهنمای ابزار مهاجرت خودکار محدودیتها را نیز بیان میکند: همهٔ رابطهای CUDA پشتیبانی نمیشوند، NCCL باید با HCCL جایگزین شود و برای عملگر ناسازگار ممکن است سازگارکردن یا پیادهسازی لازم باشد. پس نه میتوان مهاجرت را همیشه به تغییر چند نام تقلیل داد و نه میتوان نتیجه گرفت که هر پروژه باید از ابتدا نوشته شود؛ پاسخ به لایههایی بستگی دارد که برنامه در آنها به CUDA وابسته شده است.
نمونهٔ دیگر، معماری vLLM Ascend است. مطابق معرفی این پروژه، پشتیبانی از Ascend در قالب افزونهٔ سختافزاری دنبال میشود تا از هستهٔ vLLM جدا بماند. در چنین ساختاری، برنامه میتواند با رابط مشترک سرویسدهی کار کند و بخش وابسته به سختافزار در افزونه پیادهسازی شود. این جداسازی بخشی از هزینهٔ مهاجرت را از منطق برنامه به لایهٔ سازگارکننده منتقل میکند، اما به معنی برابری کارایی یا پوشش همهٔ قابلیتها نیست. همانطور که یادداشتهای انتشار vLLM Ascend نشان میدهند، پشتیبانی مدلها، حافظهٔ نهان کلید–مقدار، تقسیم پردازش زمینه و دیگر قابلیتها همچنان باید برای نسخه و سختافزار موردنظر بررسی شوند.
استفاده از CUDA و حفظ امکان انتخاب بعدی
از این بحث نباید نتیجه گرفت که برای حفظ انتقالپذیری، استفاده از CUDA را کنار بگذاریم. اگر این سکو برای مسئلهٔ امروز ما سریعترین و بالغترین مسیر است، صرفنظرکردن از مزیت آن ممکن است تصمیم فنی مناسبی نباشد. مسئله این است که مرز بخشهای عمومی و بخشهای وابسته به سازنده را آگاهانه نگه داریم تا هر بهینهسازی محلی، بیآنکه متوجه باشیم، تمام برنامه را به همان سختافزار گره نزند.
| اصل طراحی | اثر بر مهاجرت |
|---|---|
| کد مدل تا جای ممکن مستقل از نوع دستگاه نوشته شود | تغییر محیط اجرای مقصد به اصلاح کمتری در منطق مدل نیاز دارد |
| کرنل اختصاصی پشت رابط مشخص قرار گیرد | پیادهسازی وابسته به سختافزار را میتوان جداگانه جایگزین کرد |
| برای عملگر اختصاصی، پیادهسازی مرجع داشته باشیم | درستی نتیجهٔ پیادهسازی جدید قابل مقایسه میشود |
| مدل اصلی جدا از موتور بهینهشده نگهداری شود | خروجی ویژهٔ سختافزار جای تنها نسخهٔ مدل را نمیگیرد |
| کتابخانهٔ ارتباطی مستقیماً وارد منطق اصلی برنامه نشود | جایگزینی NCCL و HCCL محدودتر و روشنتر میشود |
| آزمون کارایی بر اساس تعهدات سطح خدمت تعریف شود | اجرای موفق با مناسببودن برای سرویسدهی اشتباه نمیشود |
| در فرایند یکپارچهسازی، اجرای دورهای روی یک سختافزار دوم داشته باشیم | انتقالپذیری در عمل سنجیده میشود و صرفاً ادعای معماری باقی نمیماند |
بخش دیگری از هزینه در مهارت تیم پنهان است. حتی اگر کد کاملاً قابل انتقال باشد، تیمی که سالها با راهانداز NVIDIA، ابزار nvidia-smi، خطاهای کمبود حافظهٔ CUDA، اشکالزدایی NCCL، ابزار Nsight، موتور TensorRT و افزونههای NVIDIA در Kubernetes کار کرده، برای بهرهبرداری از محیط جدید به زمان نیاز دارد. ابزار عیبیابی، تحلیلگر کارایی، مدیریت حافظه و حتی شیوهٔ فهم خطاها تغییر میکند و این هزینه در مقایسهٔ نسخههای کد دیده نمیشود. در مقابل، تیمی که از ابتدا آزمونهای تکرارپذیر، تحلیل منظم کارایی و مرز روشن میان برنامه و سختافزار داشته باشد، برای یادگیری محیط جدید نقطهٔ شروع بهتری دارد. دانش سازمانی هم بخشی از زیرساخت است و باید در برآورد مهاجرت دیده شود.
برای کارایی امروز، چه مقدار از امکان انتخاب فردا هزینه کردهایم؟
مزیت CUDA فقط در یک رابط برنامهنویسی خلاصه نمیشود؛ NVIDIA طی سالها مترجم، محیط اجرا، کتابخانههای محاسباتی، ارتباطات، ابزارهای توسعه و موتورهای استنتاج را در یک مجموعه کنار هم قرار داده است. همین یکپارچگی یکی از دلایل موفقیت آن است و در عین حال میتواند هزینهٔ خروج را بالا ببرد. اما شدت این وابستگی برای همهٔ پروژهها یکسان نیست: انتقال مدلی که از عملگرهای عمومی PyTorch استفاده میکند با انتقال سامانهای متکی به کرنل اختصاصی CUDA، اجرای گراف، تنظیم عمیق NCCL و موتور TensorRT، دو مسئلهٔ متفاوت است.
بهنظرم پرسشی که باید پیش از خرید و بهینهسازی پاسخ دهیم این است که برای کارایی بهدستآمده، چه مقدار از امکان انتخاب بعدی خود را هزینه میکنیم و آیا منفعت امروز، آن هزینه را توجیه میکند؟ بسیاری از بهینهسازیهای وابسته به سختافزار ارزش این مبادله را دارند، ولی تصمیم آگاهانه زمانی ممکن است که بدانیم در صورت تغییر شرایط، کدام بخشها فقط تنظیم مجدد میخواهند و کدام بخشها به بازنویسی، آموزش تیم و بازیابی طولانی کارایی نیاز خواهند داشت.
در یادداشت بعدی میخواهم همین بحث را در یک پروژهٔ واقعی PyTorch دنبال کنم: هنگام انتقال از CUDA به CANN، کدام قسمتها با تغییر رابط برنامهنویسی سازگار میشوند، کجا با نبود عملگر روبهرو میشویم، ارتباطات NCCL چگونه به HCCL منتقل میشود و برای کرنل اختصاصی چه راهی داریم. معیار نهایی هم صرفاً اجرای مدل نخواهد بود؛ باید ببینیم پس از مهاجرت، کیفیت، تأخیر، ظرفیت سرویسدهی و امکان نگهداری آن را چگونه به سطح موردنیاز برمیگردانیم.