CUDA es más que una biblioteca: ¿dónde se esconde el coste de dejar NVIDIA?
En el primer artículo de esta serie, publicado en persa, mi argumento era que el problema no consiste en decidir si NVIDIA es bueno o malo, sino en reconocer que construir toda la infraestructura de IA alrededor de un único proveedor limita progresivamente nuestras opciones futuras. En el segundo artículo, dejé a un lado la política tecnológica para comparar Ascend y NVIDIA desde sus especificaciones de hardware, memoria, interconexiones, kernels y ejecución real de modelos. Las respuestas plantearon otra pregunta, quizá todavía más próxima a las decisiones de infraestructura que tomamos hoy: si mañana tuviéramos un servidor Ascend con capacidad suficiente junto al servidor NVIDIA, ¿podríamos trasladar a él tanto el modelo como el servicio que hemos construido?
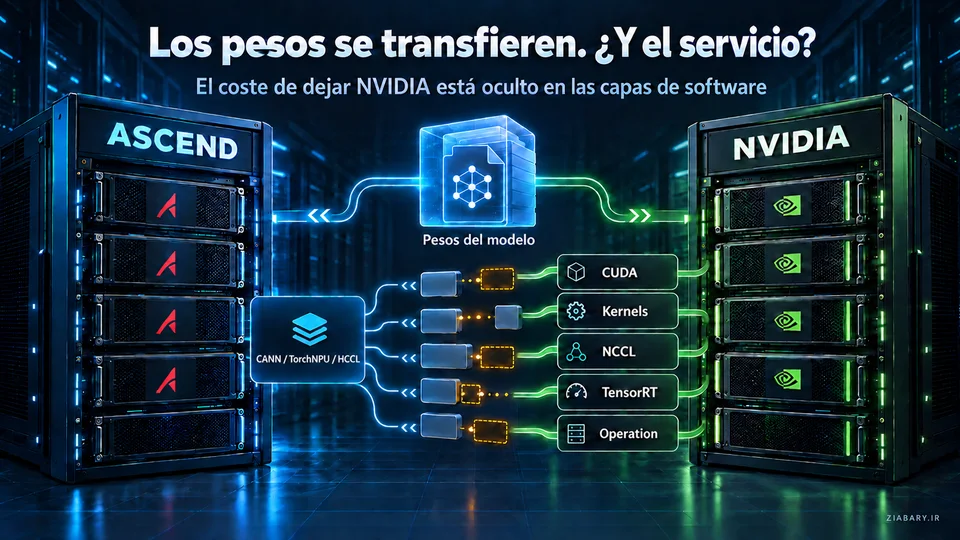
La primera respuesta suele ser que el problema es CUDA, pero considerarlo una biblioteca, o incluso una simple interfaz de programación, deja fuera buena parte de la cuestión. Como explica la introducción a la plataforma CUDA de NVIDIA, esta abarca el modelo de programación, el entorno de ejecución, la interfaz del controlador, el compilador, el conjunto de instrucciones virtuales PTX, las bibliotecas de cálculo y las herramientas de desarrollo. En un sistema construido sobre esa plataforma, la comunicación entre GPU, el motor de inferencia, las herramientas de análisis de rendimiento y el despliegue también pueden depender del mismo hardware. Para entender el coste de migrar, no basta con contar llamadas a CUDA; tenemos que identificar cuántas capas presuponen que el hardware de destino será NVIDIA.
La dependencia no siempre nace de una mala decisión
Antes de continuar, conviene aclarar que depender de un proveedor no implica necesariamente que este haya diseñado una trampa deliberada. Una parte importante de la dependencia de NVIDIA es el resultado natural de optimizar. Supongamos que un kernel general de PyTorch en H100 no es suficientemente rápido para nuestra carga y el equipo lo reescribe en CUDA. Después incorpora CUDA Graph para reducir la latencia, utiliza NCCL para comunicar ocho GPU y elige TensorRT o TensorRT-LLM para la inferencia. Si además los paquetes de despliegue se construyen a partir de imágenes de contenedor CUDA y el análisis de rendimiento utiliza herramientas NVIDIA, cada paso puede ser razonable e incluso necesario por separado.
Las consecuencias se hacen visibles cuando, años después, intentamos trasladar el resultado a otro acelerador. Los pesos del modelo pueden transferirse con facilidad, mientras que el kernel optimizado, el motor de inferencia, los ajustes de comunicación y las herramientas operativas no se trasladan con ellos. La portabilidad del modelo y la del servicio son propiedades distintas. Si las tratamos como equivalentes, nuestra estimación del coste de cambiar la infraestructura será incompleta desde el principio.
¿Qué significa que un modelo sea portable?
Muchas conversaciones sobre migración se resuelven con la pregunta «¿el modelo se ejecutó en el nuevo hardware?». La ejecución es una condición necesaria, pero no basta para decidir una inversión en infraestructura. Un modelo puede producir respuestas mientras cambia su calidad, aumenta la latencia por encima del límite permitido o se complica el mantenimiento para el equipo de operaciones. Por eso conviene distinguir al menos cuatro dimensiones de la portabilidad:
| Dimensión de la portabilidad | Pregunta principal |
|---|---|
| Funcional | ¿El modelo se ejecuta en el otro hardware y están disponibles las operaciones necesarias? |
| Numérica | ¿Las salidas y la calidad del modelo se mantienen dentro de límites aceptables? |
| De rendimiento | ¿Siguen siendo adecuados el tiempo hasta el primer token (TTFT), el tiempo por token de salida (TPOT), la capacidad de procesamiento y el consumo de memoria? |
| Operativa | ¿Podemos desplegar, supervisar, ampliar, recuperar y mantener el servicio? |
Llegar al primer nivel puede llevar un día, mientras que recuperar el rendimiento anterior puede requerir semanas o meses. En ese caso, afirmar que «el modelo se ejecutó en Ascend» describe solo una parte del recorrido y todavía no demuestra que el sistema pueda atender a los usuarios dentro del acuerdo de nivel de servicio exigido. El coste real de la migración incluye las cuatro dimensiones.
Los pesos del modelo no suelen ser el comienzo del problema
En muchos sistemas, los pesos están entre los componentes menos dependientes del hardware. Un archivo estándar de estado del modelo de PyTorch o un archivo Safetensors no pertenece de forma inherente a NVIDIA, y los pesos de Llama o Qwen tampoco pertenecen a CUDA. Pueden cargarse si el entorno de destino admite la arquitectura del modelo, los tipos de datos y los operadores necesarios. Esta condición importa: compartir un formato de archivo no significa que estén preparadas todas las capas necesarias para ejecutarlo.
La cuantización introduce nuevas dependencias. Como expliqué en el artículo sobre INT8 y FP8, la etiqueta «FP8» no define por sí sola la ruta de cálculo con la que se ejecutará un modelo. La documentación de cuantización de TensorRT-LLM también muestra que el soporte de formatos y métodos como FP8, MXFP8, NVFP4, AWQ y GPTQ depende de la generación del hardware y de la ruta de ejecución. Los pesos originales pueden ser portables aunque la versión cuantizada y optimizada para un acelerador concreto no pueda utilizarse de la misma manera en el destino.
Un programa de PyTorch no es necesariamente un programa CUDA
Una distinción importante es que utilizar PyTorch no implica depender inevitablemente de CUDA. PyTorch dispone de mecanismos para incorporar otros aceleradores, y su guía de integración de aceleradores presenta recursos como PrivateUse1 y torch.accelerator en ese contexto. Estos permiten añadir soporte para nuevo hardware, aunque disponer de una vía de integración no equivale a contar con soporte completo para todos los modelos y funciones.
El efecto de esta elección se ve en el propio código. En el siguiente ejemplo, la selección del dispositivo está separada del traslado del modelo y los datos. Siempre que estén disponibles los operadores necesarios, la lógica principal no necesita conocer al fabricante del hardware:
device = get_device()
model = model.to(device)
x = x.to(device)
En cambio, la siguiente versión introduce la elección de CUDA directamente en el programa. Durante la migración habrá que localizar y corregir esa suposición en todos los lugares donde aparezca:
torch.cuda.set_device(0)
model.cuda()
x = x.cuda()
La diferencia parece pequeña, pero al repetirse por todo un proyecto determina la separación entre el código del modelo y el código dependiente del hardware. La documentación de registro de nuevos entornos de ejecución en PyTorch también recomienda utilizar interfaces generales como to(device=...) siempre que sea posible. Usar operadores estándar y separar la selección del dispositivo de la lógica principal puede reducir el trabajo de migración. Sin embargo, cuanto más descendemos por debajo de esa interfaz para obtener rendimiento, más responsabilidad asumimos sobre la portabilidad.
Kernels propios y CUDA Graph: optimizar en las capas inferiores
Cuando un kernel general no es suficientemente rápido, podemos reescribir un operador en CUDA C++, introducir un archivo .cu y compilarlo con NVCC. En ese momento ya no estamos utilizando únicamente una capacidad general de PyTorch: una parte del programa está escrita específicamente para la plataforma de NVIDIA. Si el rendimiento del servicio depende de ese kernel, trasladar el modelo a Ascend exige encontrar una implementación equivalente o reescribirla para el hardware de destino.
PTX tampoco elimina esta necesidad. Como explica la documentación de CUDA sobre compatibilidad del código, PTX es el conjunto de instrucciones virtuales de NVIDIA que el controlador traduce a código ejecutable para la GPU de destino. Facilita la compatibilidad con generaciones posteriores dentro de la familia CUDA; no es una representación intermedia independiente del fabricante que permita ejecutar el mismo código en Ascend. Ni siquiera debe darse por supuesta la compatibilidad de un binario cubin entre generaciones principales de capacidad de cómputo de NVIDIA.
PyTorch permite registrar distintas implementaciones de un operador propio y seleccionarlas según el dispositivo, pero ese mecanismo debe distinguirse de la existencia de una implementación lista para usar. La guía de integración de operadores de PyTorch explica la responsabilidad del nuevo acelerador de cubrir los operadores y variantes necesarios. Si falta un operador específico de nuestro proyecto, el carácter general del marco no evita que el equipo tenga que implementarlo.
La dependencia tampoco se limita a escribir kernels. En inferencia con lotes pequeños y kernels rápidos, la preparación y el lanzamiento de operaciones desde la CPU pueden introducir una sobrecarga importante. El mecanismo descrito en la guía de CUDA Graph permite definir y preparar una vez las operaciones y sus dependencias para repetir su ejecución con menos sobrecarga. Si nuestro servicio cumple su objetivo de latencia gracias a esa capacidad, el destino necesita algo más que los operadores del modelo: también debe ofrecer un mecanismo de ejecución de grafos con rendimiento adecuado. Aquí se hace concreta la diferencia entre ejecutar un modelo y ejecutarlo con el rendimiento requerido.
Comunicación entre aceleradores: cambiar NCCL por HCCL no basta
En una sola GPU permanece oculta buena parte de la complejidad de la comunicación distribuida. Cuando repartimos el modelo o los datos entre varios procesadores, la biblioteca de comunicación pasa a formar parte de la ruta crítica de ejecución. Según la presentación de NCCL en la documentación de NVIDIA, esta biblioteca ofrece operaciones colectivas como AllReduce, AllGather, ReduceScatter y AllToAll, además de envío y recepción, con optimizaciones que tienen en cuenta la topología de las conexiones. En entrenamiento distribuido y en modelos de mezcla de expertos (MoE), el tiempo dedicado a esta capa puede influir de forma considerable en el resultado final.
Supongamos que el programa inicializa el grupo de procesos así:
dist.init_process_group(backend="nccl")Sustituir nccl por hccl no parece un cambio grande en el código, y la guía de migración multidispositivo de Ascend identifica la sustitución de NCCL por HCCL como uno de los ajustes necesarios. Sin embargo, el rendimiento distribuido depende de mucho más que el nombre de la biblioteca. La topología, el número de procesos, el tamaño de los tensores, el solapamiento entre comunicación y cálculo, la distribución de expertos y los algoritmos colectivos afectan al tiempo de ejecución. El cambio principal puede caber en una línea, mientras que recuperar el rendimiento anterior exige revisar y ajustar todo el patrón de comunicación.
Los motores de inferencia y los contenedores también crean dependencias
Una capa importante de dependencia aparece cuando convertimos el modelo en un motor de ejecución optimizado. TensorRT optimiza la red, selecciona las tácticas de ejecución y puede guardar el motor resultante en un archivo. Ese archivo no es equivalente al estado guardado de los pesos del modelo. La matriz de soporte de TensorRT explica las restricciones de compatibilidad de plataforma, versión y hardware, mientras que la guía de compatibilidad de motores aclara que el archivo incluye tácticas CUDA compiladas. Las funciones de compatibilidad entre versiones y hardware pueden reducir algunas restricciones, pero hay que evaluar su alcance y sus posibles efectos sobre el rendimiento.
Por tanto, que los pesos de Llama sean portables no implica que lo sea el motor TensorRT construido a partir de ellos. Cuanto más se aproxima al hardware el resultado de preparar un modelo para producción, más parte de su optimización puede quedar ligada a ese hardware. Mantener el modelo original junto al motor optimizado es importante para conservar la posibilidad de migrar.
Empaquetar el servicio en un contenedor tampoco elimina esa dependencia. El contenedor ofrece un límite útil para distribuir la aplicación y sus dependencias, pero un contenedor CUDA sigue necesitando el controlador del anfitrión. Las notas de publicación de NVIDIA Container Toolkit tratan la compatibilidad de controladores y bibliotecas, y restricciones como NVIDIA_REQUIRE_CUDA pueden impedir el arranque si la versión del controlador no cumple los requisitos. Decir que «todo está en Docker» no demuestra independencia del hardware. Facilita la gestión y el control de versiones de las dependencias, pero todavía hay que preparar el entorno de ejecución para otro fabricante.
¿En qué capas se determina el coste de salida?
Al considerar las capas en conjunto, se entiende que dos proyectos descritos de la misma forma, «se ejecutan en NVIDIA», pueden tener costes de migración muy distintos. La siguiente tabla no es una prueba de rendimiento ni estima horas de ingeniería o dinero. Solo señala qué partes deben reconsiderarse a medida que la dependencia se hace más profunda.
| Diseño de la aplicación | Dependencia de NVIDIA | Coste probable de migración |
|---|---|---|
Pesos estándar, operadores generales de PyTorch y to(device) | Baja | Bajo, siempre que el destino admita los operadores |
PyTorch con torch.compile y optimizaciones generales | Baja a media | Bajo a medio, según el soporte de compilación del destino |
| Entorno específico de servicio sin kernels propios | Media | Medio |
| Extensiones y kernels propios de CUDA | Alta | Alto |
| CUDA Graph y optimización específica de GPU | Alta | Alto |
| Ejecución en varias GPU con ajustes profundos de NCCL y NVLink | Alta | Alto |
| Motor TensorRT o TensorRT-LLM con kernels y ajustes de comunicación propios | Muy alta | Muy alto |
| Todo lo anterior, más integración, despliegue, análisis de rendimiento y supervisión ligados a NVIDIA | Estructural | Cambios en el software y en la forma de operar |
Podemos expresar la misma idea como una suma de costes: modificar el código, reescribir kernels, rediseñar las comunicaciones, sustituir el motor, preparar la operación, formar al equipo y recuperar el rendimiento.
Esta relación no es un modelo numérico para calcular un presupuesto de migración. Recuerda que contar las líneas modificadas no basta. El modelo puede ejecutarse durante la primera hora con muy pocos cambios, pero recuperar la latencia anterior puede requerir semanas de ajuste de kernels y comunicaciones. También puede ocurrir lo contrario: una modificación considerable del código seguida de una recuperación rápida del rendimiento aceptable. Las decisiones de compra y arquitectura deben tener en cuenta el coste conjunto.
¿Es una dependencia exclusiva de NVIDIA?
Una de las críticas al primer artículo fue que depender de un proveedor no es una novedad en tecnología. La crítica es correcta: Cisco, Oracle, VMware, HPE, AWS y Microsoft tienen ecosistemas de los que puede resultar costoso salir. Sin embargo, la profundidad de esa dependencia cambia entre ámbitos. Sustituir un servidor HPE x86 por un servidor x86 de otro fabricante no suele exigir rediseñar el binario de la aplicación, el compilador, las bibliotecas numéricas y el modelo de programación de hilos, aunque puedan mantenerse otras dependencias de gestión y operación.
En computación acelerada, el fabricante puede estar presente en niveles mucho más bajos de la ejecución. El conjunto de instrucciones, el compilador, el entorno de ejecución, los kernels, la biblioteca de comunicación y el motor de inferencia pueden presuponer características de su hardware. Mi argumento no es que NVIDIA haya creado un fenómeno único ni que esa dependencia sea necesariamente resultado de una conducta anticompetitiva. Es que cambiar esa pila de ejecución no puede presupuestarse como si fuera una sustitución habitual del proveedor de servidores.
¿Qué parte del problema resuelven PyTorch, Ascend y vLLM?
Los marcos de propósito general pueden reducir parte de la dependencia. Por ejemplo, la guía de entornos de compilación propios para torch.compile explica cómo registrar rutas de compilación y ejecución alternativas, incluidas implementaciones externas al núcleo de PyTorch. Cuanto más utiliza la aplicación las interfaces generales del marco, más adaptación al hardware puede realizarse en las capas inferiores sin cambiar el código principal del modelo. Elegir un kernel o un entorno de ejecución específico para obtener más rendimiento devuelve al proyecto parte de la responsabilidad sobre la portabilidad. La decisión puede estar plenamente justificada, siempre que conozcamos su coste.
En Ascend, TorchNPU se sitúa entre PyTorch y CANN y conecta los operadores del marco con los kernels de la NPU. La presentación de TorchNPU de Huawei describe la conservación de muchos patrones de programación de PyTorch y el cambio de llamadas de transferencia, como sustituir .cuda() por .npu(), como una vía sencilla en los casos menos complejos. La guía de la herramienta de migración automática también recoge sus límites: no están disponibles todas las interfaces CUDA, hay que sustituir NCCL por HCCL y un operador incompatible puede necesitar adaptación o implementación. Por tanto, no siempre basta con renombrar unas llamadas, pero tampoco es necesario reescribir todos los proyectos desde cero. La respuesta depende de las capas en las que la aplicación se haya ligado a CUDA.
La arquitectura de vLLM Ascend ofrece otro ejemplo. La introducción del proyecto presenta un complemento de hardware para Ascend que mantiene la integración separada del núcleo de vLLM. La aplicación puede utilizar una interfaz común de servicio y dejar el comportamiento específico del acelerador en el complemento. Esta separación desplaza parte del trabajo de migración desde la lógica de la aplicación hacia una capa de adaptación, pero no garantiza igualdad de rendimiento ni cobertura completa de funciones. Como muestran las notas de publicación de vLLM Ascend, hay que comprobar el soporte de modelos, el comportamiento de la caché KV, el paralelismo de contexto y las demás capacidades para la versión y el hardware elegidos.
Utilizar CUDA sin renunciar a la siguiente elección
La conclusión no debería ser que debemos abandonar CUDA para conservar la portabilidad. Si es la vía más rápida y madura para el problema actual, renunciar a esa ventaja puede ser una mala decisión técnica. Se trata de mantener una separación deliberada entre el código general de la aplicación y las implementaciones específicas del proveedor, para que cada optimización local no termine vinculando silenciosamente todo el servicio al mismo hardware.
| Principio de diseño | Efecto sobre la migración |
|---|---|
| Mantener el código del modelo tan independiente del dispositivo como sea razonable | Cambiar el destino de ejecución exige menos modificaciones de la lógica del modelo |
| Situar los kernels propios detrás de una interfaz definida | La implementación dependiente del hardware puede sustituirse por separado |
| Conservar una implementación de referencia de los operadores propios | Permite comprobar la corrección de la nueva implementación |
| Guardar el modelo original por separado del motor optimizado | El resultado específico del hardware no se convierte en la única copia del modelo |
| Evitar que la biblioteca de comunicación entre directamente en la lógica principal | La sustitución de NCCL o HCCL queda más delimitada y resulta más explícita |
| Definir pruebas de rendimiento a partir de los requisitos del servicio | La ejecución correcta no se confunde con la capacidad de atender a los usuarios |
| Ejecutar periódicamente en un segundo tipo de hardware dentro del proceso de integración | La portabilidad se comprueba en la práctica y no queda como una declaración de arquitectura |
Otra parte del coste está en la experiencia del equipo. Aunque el código sea portable, un equipo que lleva años trabajando con los controladores NVIDIA, nvidia-smi, los errores de memoria de CUDA, la depuración de NCCL, Nsight, TensorRT y los complementos NVIDIA de Kubernetes necesitará tiempo para aprender el nuevo entorno. Cambiarán las herramientas de diagnóstico, los analizadores de rendimiento, la gestión de memoria y hasta la interpretación de los errores. Este trabajo no aparece al comparar versiones del código. Un equipo con pruebas repetibles, análisis periódico del rendimiento y una separación clara entre la aplicación y el hardware parte de una posición mejor. El conocimiento de la organización también forma parte de la infraestructura y debe incluirse en la estimación de la migración.
¿Qué limitaciones futuras aceptamos a cambio del rendimiento actual?
La ventaja de CUDA va mucho más allá de una interfaz de programación. Durante años, NVIDIA ha reunido compiladores, entornos de ejecución, bibliotecas de cálculo, comunicaciones, herramientas de desarrollo y motores de inferencia en una plataforma integrada. Esa integración explica parte de su éxito y también puede elevar el coste de abandonarla. Sin embargo, la dependencia no es uniforme: trasladar un modelo construido con operadores generales de PyTorch y trasladar un servicio basado en kernels CUDA propios, ejecución de grafos, ajustes profundos de NCCL y un motor TensorRT son problemas de ingeniería distintos.
La pregunta que, a mi juicio, deberíamos responder antes de comprar y optimizar es qué limitaciones futuras aceptamos a cambio del rendimiento de hoy y si el beneficio inmediato las justifica. Muchas optimizaciones específicas del hardware merecen ese intercambio. Pero una decisión informada exige saber qué partes solo necesitarían nuevos ajustes si cambiaran las condiciones y cuáles requerirían reescritura, formación del equipo y una recuperación prolongada del rendimiento.
En el próximo artículo quiero seguir esta discusión dentro de un proyecto real de PyTorch: qué partes de la migración de CUDA a CANN son cambios de interfaz, dónde aparecen operadores ausentes, cómo se traslada la comunicación de NCCL a HCCL y qué opciones existen para los kernels propios. El criterio final irá más allá de comprobar que el modelo se ejecuta. Tendremos que determinar cómo devolver la calidad, la latencia, la capacidad del servicio y su mantenimiento al nivel necesario después de migrar.