در یادداشت قبلی با عنوان «توسعه در سایه تحریم و جنگ! آیا همه راهها به NVIDIA ختم میشود؟» بحثم این بود که مسئله، خوب یا بد بودن NVIDIA نیست؛ مسئله این است که تبدیلشدن یک معماری به تنها انتخاب زیرساختی، ریسک ایجاد میکند. در آن یادداشت عمداً وارد مقایسه فنی عمیق نشدم و نتیجه هم این نبود که NVIDIA را کنار بگذاریم و Ascend بخریم. نتیجه محدودتر بود: گزینههای دیگر آنقدر جدی شدهاند که کنارگذاشتنشان بدون آزمون فنی دیگر قابل دفاع نیست.
بازخوردهایی که بعد از انتشار گرفتم اتفاقاً سؤال بعدی را روشنتر کرد. چند نفر تقریباً با بیانهای مختلف گفتند اگر NVIDIA از نظر نرمافزار، مصرف انرژی، چگالی پردازشی و پشتیبانی کتابخانهها بهتر است، طبیعی است که انتخاب شود. نقد دیگری این بود که وابستگی به فروشنده فقط مختص NVIDIA نیست؛ همین اتفاق سالها در شبکه با Cisco یا در سرور با HPE افتاده است. سؤال مهم دیگری هم مطرح شد: یک جایگزین زمانی واقعاً جایگزین است که مدل و کتابخانه موردنیاز روی آن اجرا شود، کارایی قابلقبولی بدهد و هزینه مهاجرتش از منفعتش بیشتر نباشد.
همه این نقدها از نظر فنی درستاند.
حتی سؤالهایی درباره مسیر تأمین از چین، خدمات پس از فروش، آموزش و پشتیبانی هم مطرح شد که مهماند، ولی موضوع این یادداشت نیستند. اینجا فرض میکنیم یک سیستم NVIDIA و یک سیستم Ascend هر دو در آزمایشگاه در اختیار ما هستند و فقط میخواهیم بدانیم:
Ascend و NVIDIA از نظر فنی واقعاً چقدر با هم فاصله دارند؟
از اینجا به بعد، تحریم، ملیت سازنده یا ملاحظات سیاسی هیچ امتیاز فنی به Ascend نمیدهد. اگر NVIDIA سریعتر است، سریعتر است؛ اگر به ازای هر توکن برق کمتری مصرف میکند، باید همان عدد ثبت شود. در مقابل اگر Ascend یک بار کاری را با تعهدات سطح خدمت (SLA) موردنظر اجرا میکند، نمیتوان صرفاً به دلیل نداشتن CUDA آن را «غیرقابل استفاده» فرض کرد.
پیش از ورود به مقایسه، لازم است نکتهای را که در «کاربست هوش مصنوعی، جراحی زیبایی یا شیمیدرمانی؟» و «نحوه انتخاب پردازنده گرافیکی برای هوش مصنوعی» گفتهام دوباره تأکید کنم: مدلهای زبانی بزرگ (LLM) فقط یکی از کاربستهای هوش مصنوعیاند. پیشبینی خرابی تجهیزات، تشخیص ناهنجاری در دادههای حسگری، پیشبینی تقاضا، کنترل کیفیت و بهینهسازی مصرف انرژی نیز کاربستهای مهم هوش مصنوعیاند. برای اغلب این کاربستها در مقیاس معمول یک سازمان، مدل تخصصی در زمان استنتاج به تعداد زیادی پردازندهٔ گرافیکی (GPU) نیاز ندارد؛ گاهی پردازندهٔ اصلی (CPU) کافی است و گاهی یک شتابدهنده کوچک یا تعداد محدودی GPU کار را انجام میدهد. نیاز محاسباتی آموزش را نیز باید جدا از استنتاج سنجید. البته اندازه مدل، نرخ درخواست و تأخیر مجاز همچنان تعیین میکنند چه ظرفیتی لازم است.
تمرکز این یادداشت بر مدلهای زبانی از همین تفاوت میآید. در سرویسدهی مدلهای زبانی بزرگ، نگهداری وزنها، رشد حافظهٔ نهان کلید–مقدار (KV cache) با طول زمینه و درخواستهای همزمان، تولید توکنبهتوکن و ارتباط میان شتابدهندهها میتوانند حافظه و تعداد GPU موردنیاز را بهطور جدی بالا ببرند. در این مقیاس، تفاوت Ascend و NVIDIA در پهنایباند، ارتباط میان شتابدهندهها، کرنلها و موتور اجرا مستقیماً بر ظرفیت سرویس و هزینه اثر میگذارد؛ به همین دلیل مقایسههای این یادداشت را عمدتاً حول آموزش و استنتاج مدلهای زبانی، بهویژه سرویسدهی مدلهای بزرگ، متمرکز کردهام. این انتخاب به معنی نیاز همه مدلهای زبانی به خوشه بزرگ هم نیست؛ برای مدلهای کوچکتر، همان انتخاب اندازه متناسب با وظیفه اصل تصمیم است. نتیجه این مقایسه را نیز باید در همین دامنه خواند و برای هر کاربست دیگر، مدل و بار کاری خودش را آزمود.
اول مشخص کنیم چه چیزی را با چه چیزی مقایسه میکنیم
خود عبارت «Ascend در برابر NVIDIA» بیش از حد کلی است.
Ascend 910C، محصولی که CloudMatrix384 و نسل A3 بر پایه آن ساخته شده، با Ascend 950PR و 950DT یکسان نیست. 950PR و 950DT حتی با آنکه از یک نسلاند، برای یک بار کاری طراحی نشدهاند. هواوی، 950PR را برای پردازش اولیهٔ ورودی (Prefill) و سامانههای پیشنهاددهنده و 950DT را برای تولید توکن (Decode) و آموزش طراحی کرده است؛ دلیل این جداسازی نیز تفاوت نیاز این مراحل به توان محاسباتی و پهنایباند حافظه است. هواوی
سمت NVIDIA هم H200 با B300 از یک نسل نیستند. H200 یک مرجع مناسب برای زیرساخت مراکز دادهٔ موجود است، در حالی که B300 نماینده Blackwell Ultra است و توان محاسباتی، ظرفیت حافظه و ارتباطات بسیار قویتری دارد. NVIDIA برای H200، حافظهٔ 141GB از نوع HBM3e با پهنایباند 4.8TB/s و اتصال NVLink با 900GB/s اعلام میکند؛ اسناد رسمی برای B300 در HGX بسته به سند/پیکربندی 270–288GB حافظه و 7.7–8TB/s پهنایباند حافظه گزارش میکنند؛ اتصال NVLink نسل پنجم آن نیز 1.8TB/s پهنایباند دارد. NVIDIA
بنابراین در این یادداشت چهار مرجع را نگه میداریم: Atlas 350 مبتنی بر 950PR برای پردازش ورودی، Atlas 650E مبتنی بر 950DT، شتابدهندهٔ H200 بهعنوان نمایندهٔ جاافتادهٔ نسل Hopper و B300 بهعنوان مرجع جدیدتر NVIDIA.
مشخصات خود تراشه با مشخصات محصول نهایی یکی نیست
همین ابتدا به یک نمونه جالب میرسیم که نشان میدهد چرا مقایسه برگههای مشخصات فنی به آن سادگی که به نظر میرسد نیست.
هواوی برای خود پردازنده 950PR حداکثر 128GB حافظه با پهنایباند 1.6TB/s و حداکثر 1784TFLOPS اعلام میکند. اما Atlas 350، یعنی کارت واقعی مبتنی بر همین پردازنده، 112GB حافظه با 1.4TB/s، توان BF16/FP16 برابر 425TFLOPS و mxFP8 برابر 804TFLOPS دارد. حداکثر مصرف کارت نیز 600 وات است. جامعهٔ توسعهدهندگان Ascend
برای 950DT موضوع حتی جالبتر است. هواوی هنگام اعلام برنامهٔ توسعه در سال ۲۰۲۵ از 144GB حافظه HiZQ 2.0 با 4TB/s پهنایباند سخن گفته بود. اما صفحه محصول فعلی Atlas 650E، که هشت 950DT دارد، 8×96GB حافظه را اعلام میکند؛ همان 4TB/s پهنایباند اما ظرفیت کمتر. در این یادداشت عدد محصول فعلی را مبنا میگیرم، نه عدد اعلامشده در برنامهٔ توسعه، چون هنوز توضیح عمومی روشنی برای این تفاوت پیدا نکردم. هواوی
این همان قاعدهای است که در مقایسه GPUهای NVIDIA هم باید رعایت شود: مشخصات معماری، حداکثر مشخصات تراشه و مشخصات نسخهٔ محصولی که واقعاً داخل سرور نصب شده است سه چیز متفاوتاند.
مقایسه خام؛ فاصله یک عدد نیست
جدول زیر مشخصات محصولاتی را مقایسه میکند که تا حد ممکن قابل تطبیقاند. در اعداد NVIDIA، جایی که سازنده توان Tensor Core را با فرض تنکی دادهها اعلام کرده، مقدار محاسبات متراکم را مبنا گرفتهام؛ همان روشی که در مقایسههای قبلی GPU استفاده کردهام.
| شاخص | Ascend 950PR در Atlas 350 | Ascend 950DT در Atlas 650E؛ بهازای هر NPU | H200 SXM | B300 در HGX؛ بهازای هر GPU |
|---|---|---|---|---|
| کاربرد هدف | پردازش ورودی / پیشنهاددهی | تولید توکن / آموزش | آموزش و استنتاج عمومی | آموزش و استنتاج عمومی |
| BF16/FP16 نظری | 425 TFLOPS | 425 TFLOPS | ≈990 TFLOPS متراکم | ≈2.25 PFLOPS متراکم |
| FP8 یا خانواده همرده | 804 TFLOPS | ≈804 TFLOPS | ≈1.98 PFLOPS متراکم | ≈4.5 PFLOPS متراکم |
| حافظه روی شتابدهنده | 112GB | 96GB در Atlas 650E فعلی | 141GB | 270–288GB |
| پهنایباند حافظه | 1.4TB/s | 4.0TB/s | 4.8TB/s | 7.7–8TB/s |
| اتصال درون سامانه | 318GB/s بهازای هر کارت در اتصال کامل چهارتایی | 784GB/s/NPU دوطرفه در سرور هشتشتابدهندهای | 900GB/s NVLink | 1.8TB/s NVLink |
| بودجه توان | ≤600W کارت | 14.5kW کل سرور هشتشتابدهندهای | ≤700W GPU؛ DGX H200 کل 10.2kW | تا ≈1.1kW در HGX؛ DGX B300: توان اعلامی 14.5kW؛ سقف ورودی 15kW |
یادداشت دربارهٔ B300: اسناد رسمی NVIDIA بسته به سند/پیکربندی این دو مقدار را گزارش کردهاند: در معماری مرجع HGX B300، حافظهٔ 288GB و پهنایباند 8TB/s؛ در برگهٔ مشخصات Blackwell Ultra، حافظهٔ 270GB و پهنایباند 7.7TB/s. معماری مرجع NVIDIA · برگهٔ مشخصات Blackwell Ultra
مشخصات Ascend از صفحات فعلی Atlas 350 و Atlas 650E و مشخصات NVIDIA از صفحات رسمی H200، HGX و DGX گرفته شدهاند. اعداد توان در این جدول همسطح نیستند: برای 950DT توان طراحی حرارتی (TDP) مستقل و عمومی نداریم و هواوی توان کل سرور را داده است؛ بنابراین نباید از این جدول مستقیماً کارایی بهازای هر تراشه را استخراج کرد. جامعهٔ توسعهدهندگان Ascend و NVIDIA
جدول یک نکته مهمتر از «چه کسی برنده است» نشان میدهد.
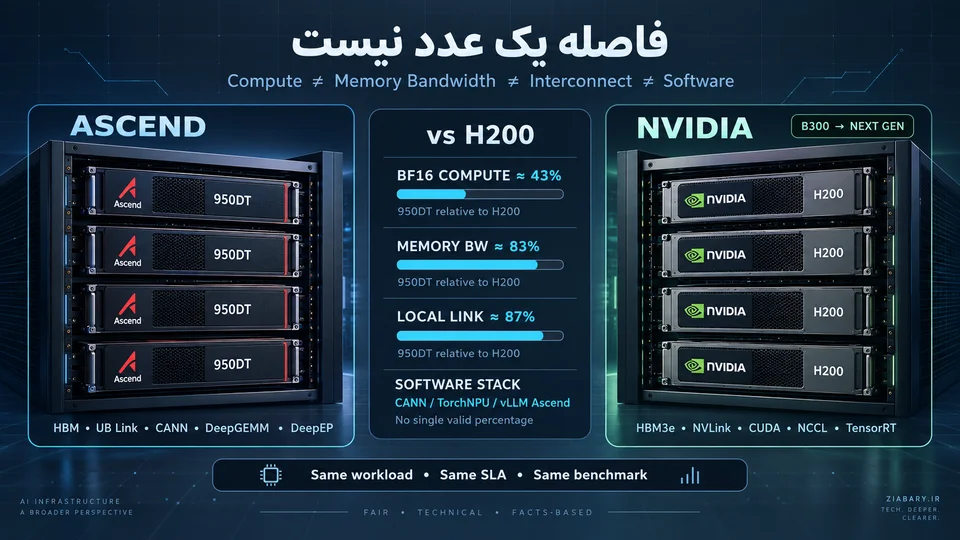
اگر 950DT فعلی را با H200 مقایسه کنیم، توان نظری BF16 آن حدود 43 درصد H200 و FP8 آن حدود 41 درصد است. اما پهنایباند حافظهاش حدود 83 درصد و پهنایباند اتصال محلی اعلامشدهاش حدود 87 درصد H200 است. در برابر B300 فاصله بسیار بزرگتر میشود: محاسبات خام 950DT کمتر از یکپنجم، پهنایباند حافظه حدود نصف و ظرفیت حافظه در محصول فعلی Atlas 650E حدود یکسوم است. پس پرسش «Ascend چند درصد NVIDIA است؟» از اساس سؤال دقیقی نیست.
Ascend در قیاس با NVIDIA در محاسبات ممکن است 40 درصد باشد و در پهنایباند حافظه بیش از 80 درصد. اینکه کدام عدد مهمتر است، به بار کاری بستگی دارد.
چرا 4TB/s در 950DT از چیزی که در نگاه اول دیده میشود مهمتر است؟
در یادداشت مربوط به تأخیر و توان عملیاتی از یک تقریب ساده استفاده کرده بودم:
که در آن حجم محاسبه، توان محاسباتی، دادهای است که باید منتقل شود و پهنایباند حافظه است. اگر جمله دوم بزرگتر باشد، اضافهکردن FLOPS لزوماً عملیات را سریعتر نمیکند.
میتوان از همین رابطه یک شاخص ساده دیگر استخراج کرد:
اگر شدت محاسباتی یک کرنل از این مقدار کمتر باشد، انتظار داریم عملکرد آن بیشتر به پهنایباند حافظه محدود شود؛ اگر بیشتر باشد، توان محاسباتی نقش تعیینکنندهتری پیدا میکند.
با BF16 نظری، تقریب اولیه چنین میشود:
| شتابدهنده | BF16 | پهنایباند حافظه | تقریبی |
|---|---|---|---|
| Ascend 950PR / Atlas 350 | 425TFLOPS | 1.4TB/s | ≈304 FLOP/Byte |
| Ascend 950DT / Atlas 650E | 425TFLOPS | 4.0TB/s | ≈106 FLOP/Byte |
| H200 SXM | ≈990TFLOPS | 4.8TB/s | ≈206 FLOP/Byte |
| B300 HGX | ≈2.25PFLOPS | 7.7–8TB/s | ≈281–292 FLOP/Byte |
این اعداد بنچمارک نیستند؛ فقط نسبت دو مشخصه نظری را نشان میدهند. بااینحال، تفاوت در طراحی 950PR و 950DT را بهخوبی توضیح میدهند.
در مرحله پردازش اولیهٔ ورودی، بهویژه وقتی تعداد ورودیهای هر دستهٔ پردازش بزرگ است، عملیات ماتریسی شدت محاسباتی بیشتری دارد و در نتیجه میتوان از توان محاسباتی بیشتری استفاده کرد. 950PR هم دقیقاً برای همین مرحله طراحی شده و هواوی در مقابل، پهنایباند حافظه را روی ۱.۴ ترابایت بر ثانیه نگه داشته است.
در مرحله تولید توکن، بهخصوص در اندازه دستههای کوچکتر، پردازنده بارها ناچار است وزنهای مدل و حافظهٔ نهان کلید–مقدار را از حافظه بخواند؛ بنابراین پهنایباند حافظه اهمیت بیشتری پیدا میکند. در 950DT، بدون افزایش توان محاسباتی BF16 در محصول Atlas 650E، پهنایباند حافظه از ۱.۴ به ۴ ترابایت بر ثانیه افزایش یافته است.
این تغییر تصادفی نیست.
هواوی برای تولید توکن تلاش نکرده مشکل را فقط با FLOPS بیشتر حل کند؛ تناسب توان محاسباتی با پهنایباند حافظه را تغییر داده است.
همیشه نمیتوان FP4 را با FP4 و FP8 را با FP8 مستقیم مقایسه کرد
مشکل مقایسه دقتهای عددی پایین فقط تفاوت محاسبات تنک و متراکم نیست.
هواوی از mxFP4، mxFP8 و HiF8 پشتیبانی میکند؛ NVIDIA در Blackwell از NVFP4 و قالبهای FP8 خود استفاده میکند. یکسانبودن تعداد بیت به معنی یکسانبودن شیوهٔ نمایش اعداد، ضرایب مقیاس، گروهبندی دادهها برای اعمال این ضرایب، کرنل و دقت خروجی نیست.
به همین دلیل ادعایی مانند «Atlas 350 در FP4 فلان برابر H20 است» بدون توضیح مسیر عددی ارزش محدودی دارد. H20 اصلاً برای همان مسیر FP4 طراحی نشده است و چنین نسبتی درباره سرعت یک مدل واقعی اطلاعات کافی نمیدهد؛ این ایراد به مقایسه اولیه خود هواوی با H20 نیز وارد شده است. Tom’s Hardware
در عمل باید وزن، مقادیر فعالسازی، قالب ضرایب مقیاس و کرنل را با هم ثبت کنیم. همانطور که در یادداشت «INT8 یا FP8» توضیح داده بودم، حتی اینکه وزن مدل «FP8» یا «INT8» نامیده شود هنوز تضمین نمیکند ضرب ماتریسی روی همان مسیر عددی انجام شود. به همین علت در جدول قبلی BF16 را یکی از مبناهای اصلی قرار دادم؛ نه چون قرار است همه مدلها را BF16 اجرا کنیم، بلکه چون مقایسه معماری با دقت عددی نسبتاً همسنخ را سادهتر میکند.
از برگهٔ مشخصات عبور کنیم؛ آیا واقعاً کار میکند؟
اینجا همان نقطهای است که در بازخورد یادداشت قبلی بهدرستی روی آن تأکید شد. وجود پهنایباند 4TB/s و 804TFLOPS روی یک صفحه محصول هنوز ثابت نمیکند یک مدل واقعی روی آن خوب اجرا میشود. شواهد عمومی امروز از نظر دامنه و اعتبار یکسان نیستند. در جدول زیر، TPOT زمان تولید هر توکن خروجی را نشان میدهد:
| شاهد | سختافزار | چه چیزی را اندازه گرفته؟ | نتیجه | کیفیت مدرک |
|---|---|---|---|---|
| MLPerf Inference 6.1 | NVIDIA و چندین سازندهٔ دیگر | مدل و بار کاری استاندارد | داده گسترده و قابل مقایسه | استاندارد با قواعد بررسی نتایج ارسالی؛ هواوی غایب است |
| CloudMatrix-Infer | 910C | سرویسدهی کامل DeepSeek-R1 | 1,943 توکن/ثانیه/NPU در TPOT≈49.4ms | مقاله فنی هواوی و SiliconFlow؛ نه آزمون مستقل |
| DeepGEMM-Ascend | 950DT | کرنل ضرب ماتریسی (GEMM) | تا 99.8٪ سقف اعلامی کرنل | آزمون متنباز و قابل بازتولید؛ کل مسیر اجرای مدل را نمیسنجد |
| DeepEP-Ascend | 950DT | تبادل داده در مدلهای MoE | حدود 90–95٪ سقف انتقال دادهٔ مفید تا EP32 | متنباز؛ روی کیت سختافزاری آزمایشی (PoC HDK)، هنوز محدودیت دارد |
MLPerf Inference v6.1 در سپتامبر ۲۰۲۶ با ۳۰ ارائهدهندهٔ نتایج و ۱۲۰ سیستم منتشر شده و بخش بستهٔ آن (Closed Division) مشخصاً برای مقایسه با شرایط مشترک طراحی شده است. NVIDIA حضور گستردهای دارد، اما هواوی در فهرست ارائهدهندگان نیست. در نتیجه فعلاً چیزی به نام MLPerf رسمی H200 در برابر 950DT نداریم. این مهمترین خلأ داده عمومی Ascend است. MLCommons
این نبود آزمون استاندارد را نباید با «کار نمیکند» اشتباه گرفت؛ اما نباید آن را هم با آزمونهای سازنده پر کنیم و اسمش را مقایسه مستقل بگذاریم.
910C؛ فعلاً بهترین شاهد عمومی از اجرای کامل مدل روی Ascend
برای نسل 950 هنوز آزمونی مستقل و جامع، مشابه MLPerf، برای کل مسیر اجرای مدل در اختیار نداریم. بنابراین برای فهم اینکه پشتهٔ نرمافزاری Ascend در اجرای یک مدل زبانی بزرگ اصولاً چقدر بالغ شده، جالبترین داده عمومی همچنان CloudMatrix384 مبتنی بر 910C است.
مقاله Serving Large Language Models on Huawei CloudMatrix384، اجرای DeepSeek-R1 را روی سیستمی شامل 384 NPU و 192 CPU بررسی میکند. برای پردازش ورودی 4K، نتیجهٔ پیشفرض 5,655 توکن بر ثانیه به ازای هر NPU است؛ عدد 6,688 به حالت ایدهآل «Perfect EPLB» مربوط میشود، نه اجرای پیشفرض. در مرحلهٔ تولید توکن نیز با اندازهٔ دستهٔ 96، طول حافظهٔ نهان کلید–مقدار برابر 4096 و TPOT=49.4ms، حدود 1,943 توکن بر ثانیه بهازای هر NPU گزارش شده است. خود مقاله چند نتیجهٔ مرجع از H800 و H100 هم آورده است. SGLang روی H100 با اندازهٔ دستهٔ 128 حدود 2,172 توکن بر ثانیه و TPOT حدود 55.6ms گزارش شده، درحالیکه CloudMatrix با اندازهٔ دستهٔ 96 همان 1,943 توکن بر ثانیه و 49.4ms را داشته است. جدول ۴ مقالهٔ اصلی
ولی این جدول را نباید تبدیل کرد به جمله «Ascend فقط 10 درصد از H100 کندتر است». اندازهٔ دسته یکی نیست، دقت عددی یکی نیست، نرمافزار سرویسدهی یکی نیست و حتی مسیر تولید حدسی توکن و پیشبینی چندتوکنی (MTP) باید دقیقاً کنترل شود. در جدول تولید توکن این مقاله، هر دو مسیر SGLang و CloudMatrix-Infer از MTP با نرخ پذیرش مؤثر فرضشدهٔ ۷۰ درصد برای یک توکن پیشنهادی استفاده میکنند؛ این شرط باید همراه نتیجه ثبت شود. این داده بیشتر از آنکه آزمون کارتبهکارت باشد، یک چیز را ثابت میکند:
910C و پشته نرمافزاری اطراف آن قادرند DeepSeek-R1 را در مقیاس واقعی و با زمان تولید توکن قابل قبول سرویس دهند.
همین حد از استنتاج برای بحث فنی ما مهم است؛ بیشتر از آن، بدون آزمایش مشترک، زیادهگویی است.
950DT؛ کرنل دیگر مشکل اصلی نیست
نسل 950 تازهتر است و دادهٔ اجرای کامل مدل روی آن هنوز به اندازه 910C انباشته نشده، ولی یک آزمون عملکرد جدید از DeepSeek تصویر جالبی از مسیر محاسباتی آن میدهد. DeepGEMM-Ascend در 30 سپتامبر ۲۰۲۶ منتشر شده و آزمونهایش روی Ascend 950DT و CANN 9.20، طبق نسخهٔ README بررسیشده، قابل بازتولیدند. برای ابعاد بزرگ ماتریس در آزمون گزارششده، BF16 GEMM به 431TFLOPS از سقف 432TFLOPS، یعنی 99.8٪ رسیده است. FP8×FP8 نیز 861 از 865TFLOPS و FP4×FP4 حدود 1701 از 1730TFLOPS ثبت کرده است. GitHub
این اعداد خیلی مهماند، ولی نه به دلیلی که ممکن است ابتدا به نظر برسد. در واقع نشان نمیدهند 950DT از H200 یا B300 سریعتر است. اصلاً NVIDIA در این آزمون حضور ندارد. صرفا نشان میدهند برای ابعاد مناسب ماتریس، کرنل موجود میتواند تقریباً تمام توان واحد محاسبات ماتریسی این NPU را به کار بگیرد. بنابراین در چنین مسیرهایی دیگر نمیشود افت شدید عملکرد را صرفاً به «کامپایلر ضعیف Ascend» نسبت داد.
البته اجرای مدل زبانی به چند ضرب ماتریسی بزرگ خلاصه نمیشود. محاسبات توجه، نرمالسازی، نمونهگیری توکن، مدیریت حافظهٔ نهان، تبادل داده، زمانبندی و عملیات کوچکتر هنوز میتوانند گلوگاه شوند.
MoE بدون ارتباط سریع، FLOPS زیادی به درد نمیخورد
برای مدلهای ترکیب کارشناسان (MoE)، ارتباط میان شتابدهندهها حتی از توان محاسباتی هم میتواند مهمتر شود. هر توکن باید به کارشناسان مختلف فرستاده شود و سپس نتایج آنها تجمیع شود؛ با تقسیم کارشناسان میان شتابدهندهها، هزینهٔ تبادل دادهٔ همهبههمه میتواند سهم قابل توجهی از زمان تولید هر توکن را بگیرد.
DeepEP-Ascend روی 950DT در EP=8 حدود 373 تا 375GB/s برای توزیع توکنها گزارش کرده و در EP=32 هنوز 335 تا 340GB/s را حفظ میکند. خود پروژه میگوید تا EP32 تقریباً 90 تا 95 درصد سقف پهنایباند فیزیکی انتقال دادهٔ مفید حاصل شده است. اما در EP64 و EP128 افت ادامه پیدا میکند و تجمیع نتایج نیز ضعیفتر میشود؛ توسعهدهندگان صریحاً نوشتهاند که این قسمتها هنوز در حال بهینهسازی هستند. EP در این اعداد، اندازهٔ گروه موازیسازی کارشناسان است. GitHub
یک شرط دیگر هم مهم است: این اندازهگیری روی کیت سختافزاری آزمایشی و نسخهٔ مشخص میانافزار انجام شده است. پس نباید فرض کنیم هر Atlas 650E که امروز تهیه شود الزاماً همین اعداد را بدون تغییر به دست میدهد. این دقیقاً نوع دادهای است که در ارزیابی Ascend باید حفظ شود: نتیجهٔ آزمون امیدوارکننده است، روش اندازهگیری منتشر شده، ولی وضعیت محصول و نسخهٔ نرمافزار باید همراه عدد ثبت شود.
نرمافزار؛ فاصله واقعی شاید اینجا بیشتر از سختافزار باشد
در بازخورد یادداشت قبلی گفته شد که «اکثر کتابخانهها با این پردازندهها سازگار هستند؟» این سؤال شاید از مقایسه FLOPS مهمتر باشد. پاسخ کوتاه این است:
اجرای PyTorch روی Ascend واقعی و عملی است؛ اما سازگاری با CUDA کامل نیست.
TorchNPU 26.1 اکنون 950DT را رسماً پشتیبانی میکند و برای کار با PyTorch ارائه میشود. هواوی تلاش کرده رابطهای برنامهنویسی و روش توسعه در PyTorch را تا حد ممکن حفظ کند؛ بخشی از این رابطها با تغییر رفتار توابع هنگام اجرا به NPU متصل میشوند. جامعهٔ توسعهدهندگان Ascend
برای کدی که از عملگرهای استاندارد PyTorch استفاده میکند، مهاجرت میتواند نسبتاً ساده باشد. اما اگر برنامه از افزونهٔ CUDA، کرنل اختصاصی، کتابخانهٔ مخصوص CUDA، رفتار خاص NCCL یا عملگری استفاده کند که در CANN/TorchNPU پیاده نشده، داستان عوض میشود. خود مستندات هواوی یک مسیر مستقل برای سازگارکردن عملگرها دارد؛ یعنی حتی سازنده هم فرض نمیکند تمام عملگرها بدون کار اضافه منتقل شوند. جامعهٔ توسعهدهندگان Ascend
بنابراین جمله «فقط .cuda() را به .npu() تبدیل میکنیم» برای یک نمونهٔ نمایشی ساده ممکن است درست باشد، ولی معیار خوبی برای تخمین پروژه واقعی نیست.
و همین موضوع دلیل یادداشت بعدی این مجموعه خواهد بود: «مهاجرت یک برنامهٔ واقعی از CUDA به CANN دقیقاً کجا هزینه ایجاد میکند».
vLLM؛ وضعیت خیلی بهتر از چیزی است که دو سال پیش بود
برای کاربردی که بیشتر موردنظر من است، یعنی سرویسدهی مدلهای زبانی، وضعیت جالبتر است.
vLLM Ascend دیگر یک پروژهٔ آزمایشی حاشیهای نیست. جدول پشتیبانی فعلی برای 950DT، مدلهایی مانند DeepSeek V4، DeepSeek-V3.1 و GLM-5.1 را با قابلیتهایی مانند W8A8، پردازش بخشبخش ورودی، استفادهٔ مجدد از محاسبات بخش مشترک ابتدای ورودیها، تولید توکن با پیشنهاد و تأیید، توزیع کارشناسان، موازیسازی داده و جداسازی پردازش ورودی از تولید توکن ثبت کرده است. vLLM
حتی بستهٔ رسمی کانتینر vllm-ascend:v0.23.0-a5 برای 950DT مستند شده و راهنمای استقرار روی چند گره برای مدلهایی مانند GLM-5/5.1 وجود دارد.
اما یک نکته ظریف را نباید از جدول پشتیبانی حذف کنیم: همه خانهها سبز نیستند.
پشتیبانی بعضی مدلها آزمایشی است، بعضی قابلیتها هنوز آزموده نشدهاند و در برخی مدلها LoRA یا تقسیم مراحل مدل میان شتابدهندهها محدود است. پس عبارت «vLLM پشتیبانی میشود» کافی نیست؛ همانند CUDA باید بپرسیم:
کدام مدل، با کدام کوانتیزهسازی، کدام قابلیت و روی کدام نسل Ascend؟
این دقیقاً شبیه همان اشتباهی است که در GPUها با عبارت کلی «FP8 پشتیبانی میشود» رخ میدهد.
آموزش؛ هنوز نمیتوان گفت فاصله از بین رفته است
950DT رسماً برای تولید توکن و آموزش طراحی شده است و از نظر سختافزاری پهنایباند حافظه و ارتباط میان شتابدهندهها را نسبت به نسل قبل بهطور جدی بالا برده است. TorchNPU نیز مسیر آموزش با PyTorch را ارائه میکند. بنابراین جمله «روی Ascend نمیتوان مدل آموزش داد» نادرست است. Huawei
اما سؤال درست این نیست که میشود یا نمیشود. سؤال این است که در یک کار آموزش بزرگ، نسبت محاسبات واقعی مدل به سقف توان محاسباتی در دسترس چقدر است:
در مقیاس 64، 256 یا چند هزار شتابدهنده، چه مقدار از این نسبت باقی میماند؟ هزینهٔ عملیات ارتباطی جمعی چقدر میشود؟ بازیابی پس از خرابی چه اثری دارد؟ ذخیرهٔ وضعیت آموزش و توزیع وضعیت بهینهساز چگونه انجام میشود؟ تقسیم کارشناسان میان شتابدهندهها چقدر تبادل داده میطلبد؟ و کامپایلر هنگام اجرای محاسبات واقعی مدل چه میزان از توان نظری را حفظ میکند؟
برای NVIDIA در این حوزه حجم زیادی از نتایج MLPerf Training، تجربهٔ عمومی خوشههای پردازشی و ابزارهای توسعه و پایش در دسترس است. MLPerf در نسلهای جدید حتی بارهای کاری مدلهای MoE و DeepSeek-V3 را وارد آزمون آموزش کرده است. MLCommons
برای Ascend هنوز نتیجهٔ استاندارد و مستقیمی که بتواند 950DT را در همین شرایط کنار B300 یا حتی H200 بگذارد نداریم.
DeepGEMM نشان میدهد واحد محاسبات ماتریسی خوب استفاده میشود. DeepEP نشان میدهد نرمافزار تبادل داده جدی است. ولی جمع این دو هنوز معادل آزمون کامل فرایند آموزش نیست. بنابراین اگر سؤال من امروز «بهترین انتخاب فنی برای پیشآموزش مدلهای بسیار بزرگ چیست؟» باشد، داده عمومی همچنان بهمراتب کاملتر به نفع NVIDIA است. این نتیجه سیاسی نیست؛ نتیجه وضعیت فعلی دادههاست.
استنتاج؛ جایی که مقایسه بسیار نزدیکتر میشود
در استنتاج، خصوصاً مرحلهٔ تولید توکن، داستان متفاوت است.
950DT در محصول فعلی فقط حدود 43 درصد BF16 یک H200 را دارد، اما 83 درصد پهنایباند حافظهٔ آن را. اگر کارایی در مرحلهٔ تولید توکن بیشتر به پهنایباند حافظه محدود باشد، انتظار نداریم نسبت عملکرد واقعی الزاماً همان 43 درصد باشد.
نتایج CloudMatrix روی نسل قبلی 910C هم دقیقاً همین نکته را تقویت میکنند: NPUای که روی کاغذ از H100 ضعیفتر است، با کرنل، زیرسامانهٔ حافظه، ارتباطات و نرمافزار سرویسدهی مناسب میتواند در بار کاری مشخص به توان عملیاتی و زمان تولید توکن قابل رقابت برسد.
و طراحی خود نسل 950 نیز این جهت را تأیید میکند: هواوی عملاً پردازش ورودی و تولید توکن را دو مسئلهٔ سختافزاری متفاوت دیده است. 950PR با 1.4TB/s برای بخشی ساخته شده که بیشتر به توان محاسباتی متکی است و 950DT با 4TB/s برای بخشی که بیشتر به حافظه و تبادل داده وابسته است. Huawei
برای سرویسدهی مدلهای زبانی این تفکیک از افزایش ساده FLOPS جالبتر است. حتی vLLM Ascend امروز جداسازی پردازش ورودی از تولید توکن را در 950DT پشتیبانی میکند؛ یعنی پشتهٔ نرمافزاری نیز در همین جهت حرکت کرده است. vLLM
ارتباط میان شتابدهندهها؛ NVLink هنوز مزیت مهم NVIDIA است، اما مقایسه ساده نیست
H200 روی NVLink نسل چهارم تا 900GB/s و B300 روی NVLink نسل پنجم تا 1.8TB/s به ازای GPU ارائه میدهد. در HGX B300 هشت GPU از طریق NVSwitch در یک شبکهٔ ارتباطی با مجموع 14.4TB/s قرار میگیرند. NVIDIA
در Atlas 650E نیز هر NPU در سرور هشتتایی پهنایباند دوطرفهٔ UB برابر 784GB/s دارد و دو سرور میتوانند یک شبکهٔ شانزدهتایی تشکیل دهند که در آن هر شتابدهنده مستقیماً به بقیه متصل است و پهنایباند بهازای هر NPU به 1.68TB/s میرسد. علاوه بر آن، UBoE و RoCE هرکدام 400Gbps به ازای NPU برای گسترش ارتباط میان سامانهها ارائه شدهاند. جامعهٔ توسعهدهندگان Ascend
در نگاه اول میشود 784 را کنار 900 گذاشت و گفت فاصله کوچک است. اما این مقایسه ناقص است. ساختار اتصالها، تأخیر، نحوهٔ اجرای عملیات ارتباطی جمعی، تعداد نقاط اتصال و اینکه پهنایباند اعلامشده در چه الگوی ارتباطی قابل استفاده است، مهمتر از یک عدد تجمیعی هستند. مخصوصاً برای مدلهای MoE، چیزی که اهمیت دارد زمان واقعی توزیع توکنها و تجمیع نتایج هنگام تقسیم کارشناسان میان شتابدهندههاست، نه فقط ظرفیت اتصال. به همین دلیل داده DeepEP از خود عدد 784GB/s مفیدتر است.
هواوی یک راه دیگر هم برای جبران ضعف تکتراشه دارد: مقیاس
CloudMatrix384 مثال واضح این راهبرد است. هر 910C از Blackwell ضعیفتر است، اما هواوی 384 NPU را در یک حوزهٔ ارتباطی بزرگ به هم متصل کرده است. تحلیل SemiAnalysis برای CloudMatrix384 حدود 300PFLOPS BF16 متراکم، 49TB حافظه و بیش از 1.2PB/s پهنایباند تجمیعی حافظه برآورد کرده بود؛ اعدادی که در سطح سیستم از GB200 NVL72 بالاترند. ولی همان تحلیل هزینه آن را نیز نشان میداد: تعداد شتابدهندهٔ بسیار بیشتر و مصرف توان چندبرابری. در یادداشت قبلی دربارهٔ گزینههای جایگزین NVIDIA هم به همین تفاوت در سطح سامانه اشاره کرده بودم.
از نظر معماری این نکته مهم است:
هواوی فعلاً بخشی از فاصله در توان تراشه را با مهندسی اتصال تعداد بیشتری شتابدهنده در یک سامانه جبران میکند.
این راهحل کاملاً معتبر است، اما رایگان نیست. رک بیشتر، تجهیزات ارتباط نوری بیشتر، شبکه پیچیدهتر، دامنهٔ اثر خرابی بزرگتر و برق بیشتر، همگی وارد هزینهٔ کل مالکیت (TCO) میشوند.
هزینهٔ کل مالکیت؛ قیمت شتابدهنده فقط بخشی از صورتحساب است
در بازخوردها سؤال قیمت و صرفه اقتصادی زیاد مطرح شد. در این یادداشت عمداً عدد خرید ایران برای Ascend یا H200 نمیگذارم، چون برای هر دو بازار غیرشفاف است و قیمت واسطه را نمیشود معادل قیمت محصول دانست. اما میتوان هزینهٔ کل مالکیت را روشن کرد. هزینهٔ شتابدهنده، سرور، شبکه، برق، سرمایش، نرمافزار، مهاجرت، پشتیبانی و قطعات یدکی همگی در آن سهم دارند:
و برای سرویسدهی، هزینهٔ هر توکنِ تولیدشده در محدودهٔ تعهدات خدمت، از هزینهٔ کل بهتنهایی مفیدتر است:
اگر یک سیستم دو برابر توکن تولید کند ولی زمان تولید هر توکن از محدودهٔ توافقشده خارج شود، آن افزایش توان عملیاتی برای مسئله ما الزاماً ارزش ندارد.
از نظر ظرفیت برق و سرمایش مرکز داده نیز Ascend الزاماً گزینه کممصرفی نیست. Atlas 650E با هشت 950DT حدود 14.5kW مصرف سیستم اعلام میکند. DGX H200 هشتGPUای حداکثر 10.2kW و DGX B300 هشتGPUای نیز 14.5kW مصرف اعلامی دارد؛ راهنمای B300 سقف توان ورودی سیستم را 15kW ثبت میکند. این دو عدد مصرف اعلامی و سقف ورودی را نباید یکسان دانست. این اعداد بهدلیل تفاوت CPU، شبکه و طراحی سیستم معیار کارایی بهازای وات نیستند، اما حداقل نشان میدهند «چینی بودن» را نباید مترادف با توان پایینتر گرفت. جامعهٔ توسعهدهندگان Ascend · راهنمای DGX B300
برای محاسبهٔ هزینهٔ واقعی باید با مدل یکسان، توزیع یکسان طول زمینه، همزمانی یکسان و تعهدات خدمت یکسان، این شاخصها را اندازه بگیریم:
تعداد توکن بهازای هر ژول، تعداد توکن در ثانیه بهازای هر رک و تعداد توکن در ثانیه بهازای هر دلار هزینه.
بدون آن، مقایسه قیمت کارت تقریباً ناقص است.
پس فاصله واقعی چقدر است؟
بعد از کنارگذاشتن تبلیغات هر دو طرف، تصویر فعلی برای من اینطور است:
| لایه | وضعیت فنی امروز |
|---|---|
| توان محاسباتی خام هر شتابدهنده | برتری روشن NVIDIA؛ 950DT در BF16/FP8 حدود 40٪ H200 و کمتر از 20٪ B300 در نسخهٔ محصول فعلی |
| پهنایباند حافظه | فاصله با H200 بسیار کمتر؛ 4 در برابر 4.8TB/s |
| ظرفیت حافظه | 950DT فعلی Atlas 650E از H200 و B300 عقبتر؛ 950PR به H200 نزدیکتر است |
| تولید توکن در مدل زبانی | فاصله میتواند بهمراتب کمتر از اختلاف FLOPS باشد |
| پردازش ورودی | فاصلهٔ توان محاسباتی بیشتر اهمیت پیدا میکند؛ 950PR دقیقاً برای این بخش طراحی شده |
| ارتباطات مدلهای MoE | نرمافزار عملی وجود دارد و نتایج امیدوارکننده است، ولی موازیسازی کارشناسان در گروههای بزرگ هنوز جای کار دارد |
| PyTorch | پشتیبانی رسمی دارد؛ سازگاری کامل برای اجرای بیتغییر کد CUDA ندارد |
| vLLM | پشتیبانی جدی و فعال؛ مدلها و قابلیتهای پشتیبانیشده هنوز کاملاً یکسان نیستند |
| آموزش در مقیاس بزرگ | شدنی است، ولی شواهد عمومی مستقل برای اثبات برابری با NVIDIA هنوز کافی نیست |
| آزمون عملکرد استاندارد | بزرگترین ضعف داده Ascend؛ هواوی در MLPerf فعلی حضور ندارد |
| استنتاج در کل مسیر اجرا | شواهد واقعی وجود دارد، ولی عمدتاً مقالههای فنی سازنده یا شریک تجاری اوست |
| هزینهٔ کل مالکیت | بدون آزمون بار کاری و قیمت واقعی تأمین قابل نتیجهگیری نیست |
بنابراین جواب فنی به سؤال عنوان این نیست که «Ascend به NVIDIA رسیده است». چرا که واقعاً نرسیده است. اما جواب این هم نیست که «Ascend یک محصول عقبافتاده است که صرفاً به دلیل تحریم استفاده میشود». این توصیف هم دیگر با دادههای موجود سازگار نیست.
950DT فعلی در توان محاسباتی خام فاصله قابل توجهی با H200 و مخصوصاً B300 دارد، اما در پهنایباند حافظه و ارتباط میان شتابدهندهها فاصله بسیار کوچکتر است. برای همین در تولید توکن و بعضی بارهای کاری با تبادل دادهٔ سنگین، ممکن است فاصلهٔ عملکرد در کل مسیر اجرا بسیار کمتر از اختلاف TFLOPS شود.
در مقابل، برای آموزش در مقیاس عظیم یا بارهای کاری متکی به افزونههای اختصاصی CUDA، کرنلهای بسیار بهینه و ابزارهای توسعهٔ بالغ، فاصله نرمافزاری میتواند حتی مهمتر از تفاوت توان تراشهها باشد. و این دقیقاً جایی است که به نظرم مقایسه نظری باید متوقف شود.
آزمایشی که دوست دارم انجام دهیم
اگر یک Atlas 650E یا حتی یک سیستم A3 در دسترس باشد، بهجای ادامهدادن مقایسه بروشورها، یک بار کاری واقعی را که امروز روی NVIDIA داریم بدون سادهسازی روی Ascend منتقل میکنم. مدل یکسان، توکنساز یکسان، توزیع یکسان طول زمینه، آزمایش در سطوح یکسان همزمانی و تعهدات خدمت یکسان.
زمان آغاز پاسخ (TTFT)، زمان تولید هر توکن (TPOT)، نرخ تولید توکن خروجی، تعداد درخواستهای در حال پردازش، میزان استفاده از حافظهٔ HBM، ظرفیت حافظهٔ نهان کلید–مقدار، توان مصرفی سیستم و خطاهای 24 یا 72 ساعت را ثبت میکنیم.
مهمتر از همه، زمان مهندسی مهاجرت را هم اندازه میگیریم: چند خط کد تغییر کرد؟ کدام عملگر اجرا نشد؟ کدام کرنل را مجبور شدیم عوض کنیم؟ کدام کوانتیزهسازی قابل استفاده نبود؟ و بعد از اینکه مدل بالا آمد، برای رسیدن به کارایی قابل قبول چند روز تنظیم و بهینهسازی لازم بود؟
چون برای تصمیم واقعی، این عدد هم بخشی از آزمون عملکرد است. فاصله Ascend و NVIDIA یک درصد واحد نیست. در BF16 یک فاصله داریم، در پهنایباند فاصله دیگری، در تولید توکن فاصلهای دیگر و در زیستبوم نرمافزاری احتمالاً بزرگترین فاصله را. پس سؤال فنی درست این نیست که: «Ascend چند درصد NVIDIA است؟» بلکه این است:
«برای این مدل، این موتور اجرا، این تعهدات خدمت و این مقیاس، Ascend چه چیزی از دست میدهد و در مقابل چه مقدار از نیاز ما را واقعاً پوشش میدهد؟» تا وقتی این سؤال را روی سختافزار واقعی اندازه نگیریم، هم ادعای «Ascend جایگزین NVIDIA است» زودهنگام است و هم ادعای «به درد نمیخورد».
این یکی دیگر با سیاستگذاری جواب داده نمیشود؛ باید با آزمون عملکرد سنجیده شود.