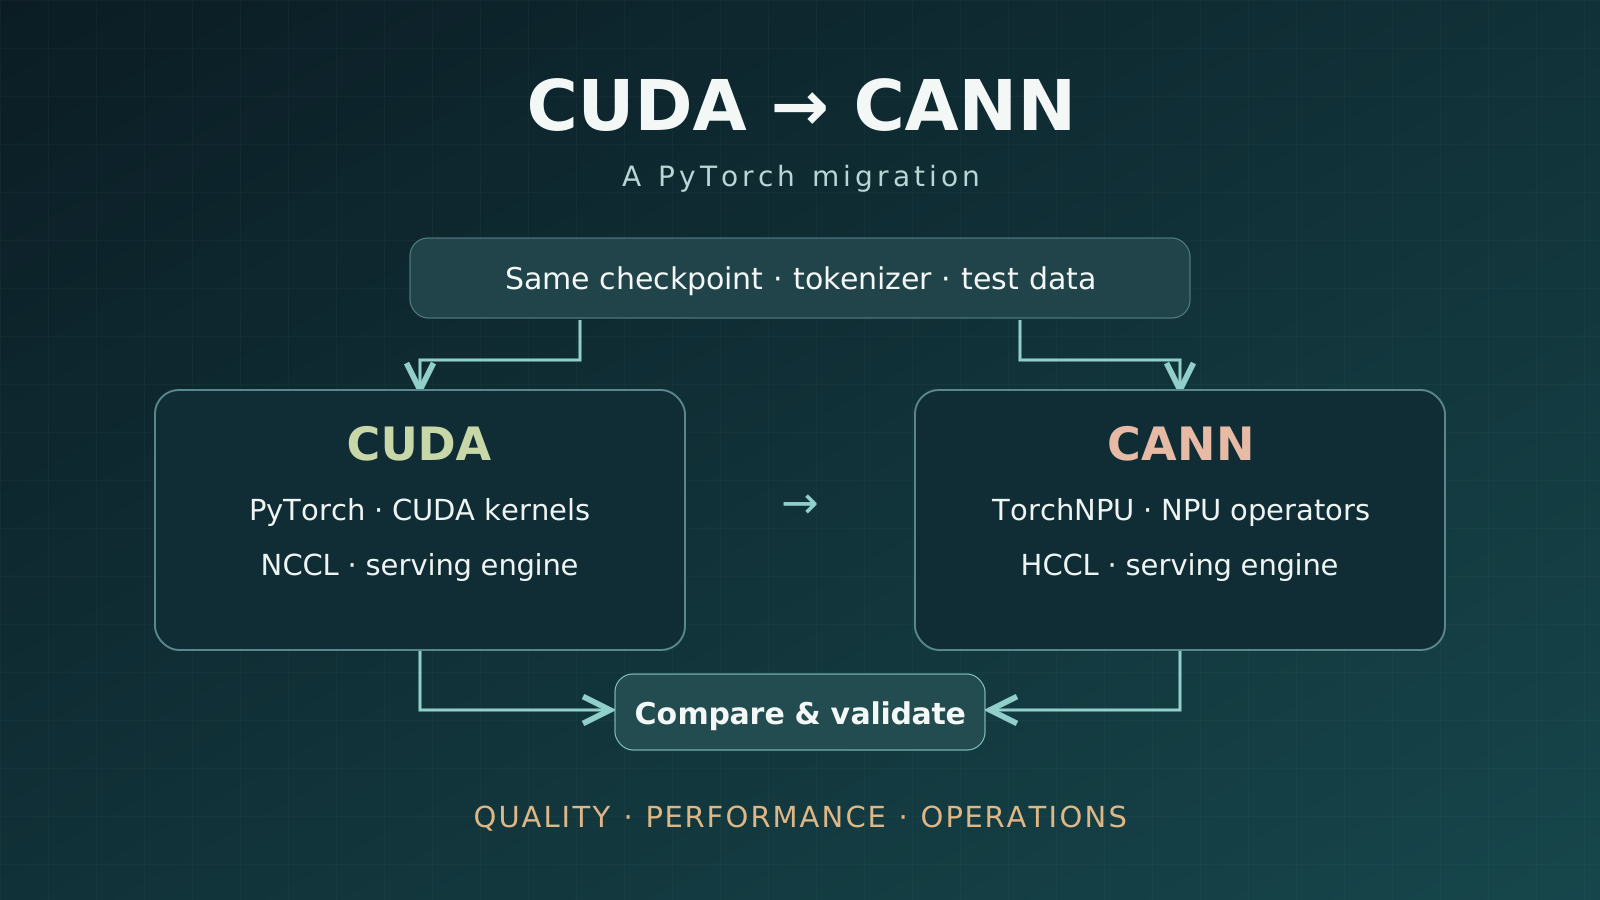
تغییر دستگاه، سازگارسازی عملگر، انتقال ارتباطات و بازیابی کارایی در مسیر آموزش و سرویسدهی یک مدل زبانی
در یادداشت قبلی پرسیدم اگر فردا NVIDIA را از زیرساخت خود برداریم، کدام بخشهای سامانه از کار میافتند. بحث به اینجا رسید که وزنهای مدل، کرنلها، ارتباط میان شتابدهندهها و موتور سرویسدهی، هزینهٔ انتقال یکسانی ندارند. اکنون میخواهم همین مسئله را در یک پروژهٔ مشخص دنبال کنم: مدلی که با PyTorch آموزش میدهیم، روی CUDA اجرا میکنیم و از آن سرویس میگیریم، برای انتقال به Ascend به چه تغییرهایی نیاز دارد؟
دشواری اصلی معمولاً پس از نخستین اجرای موفق آشکار میشود. مدل ممکن است بارگذاری شود و خروجی هم بدهد، اما اجرای ورودی بلند خطا کند، آموزش چنددستگاهی متوقف بماند یا ظرفیت سرویس با افزایش درخواستها افت کند. برای برآورد هزینهٔ مهاجرت باید از ابتدا میان سه کار فرق بگذاریم: سازگارکردن رابط برنامهنویسی، فراهمکردن مسیر محاسبهٔ درست و رساندن سرویس به کیفیت و کارایی موردنیاز.
پروژهٔ مرجع را مشخص کنیم
مبنای بحث، پروژهٔ متنباز Transformers و اسکریپت آموزش علّی زبان آن، examples/pytorch/language-modeling/run_clm.py، است. مدل نمونه را Qwen2.5-1.5B در نظر میگیرم: یک مدل واقعی با وزنهای منتشرشده و پیادهسازی در Transformers که اندازهاش برای بررسی مسیر مهاجرت مناسب است. انتخاب این مدل برای مطالعهٔ مهندسی است؛ دربارهٔ مناسببودن آن برای یک کاربرد فارسی باید جداگانه ارزیابی کرد. huggingface.co
سناریوی ما ادامهٔ آموزش مدل روی یک پیکرهٔ متنی و سپس عرضهٔ همان مدل برای تولید متن است. این مسیر، آموزش روی متن را بررسی میکند؛ برای ساخت دستیار گفتوگویی باید داده، قالب مکالمه و شیوهٔ آموزش متناسب با آن نیز طراحی شود. در سمت مبدأ، آموزش میتواند با چند GPU و DDP انجام شود و سرویس نیز نسخهای بهینهشده از اجرای مدل داشته باشد.
آنچه در ادامه میآید، تحلیل مسیر مهاجرت این پروژه بر پایهٔ کد و مستندات رسمی است. اندازهگیری روی سختافزار Ascend در این یادداشت انجام نشده و هیچ عدد کارایی بهعنوان نتیجهٔ آزمایش گزارش نمیشود. همچنین وجود کرنل CUDA اختصاصی را به اسکریپت اصلی نسبت نمیدهم؛ این وابستگی را در نسخههای بهینهشدهٔ پروژه جداگانه بررسی میکنم.
پیش از تغییر کد، نسخهٔ قابل مقایسه بسازیم
اگر در جریان مهاجرت همزمان نسخهٔ مدل، روش کوانتش، طول زمینه و موتور اجرا را عوض کنیم، پیدا کردن علت اختلاف نتیجه دشوار میشود. برای شروع، باید یک checkpoint مشخص، tokenizer یکسان، پیشپردازش ثابت و مجموعهٔ آزمون مشترک داشته باشیم. نخست همان checkpoint را روی دو سکو مقایسه میکنیم؛ پس از آن به سراغ ادامهٔ آموزش روی مقصد میرویم.
این تفکیک اهمیت دارد. تفاوت خروجی یک وزن ثابت، مسئلهٔ مسیر استنتاج است؛ تفاوت دو مدلی که جداگانه آموزش دیدهاند، میتواند از ترتیب داده، محاسبات عددی، ارتباطات توزیعشده و مسیر بهینهسازی هم ناشی شده باشد. مخلوطکردن این دو آزمون، عیبیابی را بیجهت پیچیده میکند.
محیط مقصد نیز باید قابل بازسازی باشد. در Ascend، نسخههای PyTorch، بستهٔ torch_npu، CANN، Python، راهانداز و firmware را باید مطابق جدول سازگاری انتخاب کرد. کنار هم قراردادن آخرین نسخهٔ هر جزء، تضمینی برای ساخت یک محیط سازگار نیست. نسخهٔ Transformers و Accelerate و هر افزونهٔ عملگری هم باید در همین محیط ثبت و آزموده شود. github.com
برای پروژهٔ مرجع، صورتمسئلهٔ وابستگیها تقریباً چنین است:
| بخش پروژه | در مبدأ چه چیزی داریم؟ | در مقصد چه چیزی باید بررسی شود؟ |
|---|---|---|
| وزن و tokenizer | فایلهای استاندارد مدل | بارگذاری همان نسخه و حفظ پیشپردازش |
| انتخاب دستگاه | cuda و فراخوانیهای torch.cuda | دستگاه npu و رابطهای متناظر |
| محاسبات مدل | عملگرهای PyTorch و مسیر انتخابشدهٔ attention | پشتیبانی شکل، نوع داده، ماسک و مسیر محاسبه |
| آموزش توزیعشده | DDP با backend ارتباطی NCCL | DDP با backend ارتباطی HCCL |
| بهینهسازیهای افزوده | کرنل اختصاصی، افزونه یا اجرای گرافی | معادل موجود، بازنویسی یا تنظیم مجدد |
| سرویسدهی | batching، cache، صف و موتور اجرا | پشتیبانی و تنظیم همین قابلیتها در مقصد |
| عملیات | تصویر اجرایی، پایش و بازیابی خرابی | محیط قابل بازسازی و روش نگهداری آزمودهشده |
این جدول باید با وابستگیهای واقعی مخزن تکمیل شود. صرف دیدن نام PyTorch در فهرست فناوریها، اطلاعات کافی برای برآورد مهاجرت نمیدهد.
بخشی که واقعاً با تغییر رابط حل میشود
در یک اجرای تکدستگاهی، تغییر اولیه میتواند کوچک باشد. برای نمونه، بخش وابسته به دستگاه در یک اسکریپت سادهٔ CUDA ممکن است چنین نوشته شده باشد:
torch.cuda.set_device(0)
device = torch.device("cuda:0")
model = model.to(device)
batch = {name: value.to(device) for name, value in batch.items()}
در مسیر صریح TorchNPU، همین قسمت به این شکل تغییر میکند:
import torch_npu

torch.npu.set_device(0)
device = torch.device("npu:0")
model = model.to(device)
batch = {name: value.to(device) for name, value in batch.items()}
در این مثال، مدل و batch از قبل ساخته شدهاند و مقدارهای batch تنسور هستند. این قطعه فقط انتخاب دستگاه و انتقال داده را نشان میدهد. TorchNPU افزونهای است که اجرای PyTorch روی NPUهای Ascend را فراهم میکند؛ بنابراین در صورت پشتیبانی عملگرها، بخش قابلتوجهی از منطق مدل میتواند حفظ شود. github.com
در پروژهای که از Trainer و Accelerate استفاده میکند، بخشی از همین انتخاب دستگاه و راهاندازی توزیعشده را چارچوب انجام میدهد. مستندات Transformers نیز Ascend را با دستگاه npu و بستهٔ torch-npu معرفی میکند. به همین دلیل، پیش از بازنویسی حلقهٔ آموزش باید دید نسخهٔ انتخابشدهٔ این ابزارها چه چیزی را از قبل پشتیبانی میکند. huggingface.co
البته وابستگی به CUDA فقط در .cuda() پنهان نیست. اندازهگیری زمان با CUDA Event، streamها، همگامسازی، mixed precision، مدیریت حافظه و شرطهایی مانند torch.cuda.is_available() نیز باید بررسی شوند. برای مثال، اگر برنامه در صورت نبود CUDA بیسروصدا به CPU برگردد، ممکن است اجرای موفق ظاهری داشته باشیم، اما اصلاً روی NPU محاسبه نکرده باشیم. ثبت دستگاه مدل و داده در شروع اجرا، یک کنترل ساده و ضروری است.
ابزار مهاجرت خودکار TorchNPU نیز مسیری با افزودن from torch_npu.contrib import transfer_to_npu فراهم میکند. این ابزار میتواند بخشی از فراخوانیها را نگاشت کند، اما محدودیتهای مستند دارد؛ برای مثال در راهنمای مربوط به آن، ناسازگاری با بعضی کاربردهای torch.jit.script توضیح داده شده است. چنین ابزاری برای کوتاهکردن مسیر سازگارسازی مفید است، ولی وجود آن جای آزمون رفتار برنامه را نمیگیرد. www.hiascend.com
برای اینکه این تغییر به یک آزمون مشخص در همان مدل وصل شود، میتوان نخستین مقایسه را روی یک forward ساده انجام داد. در نمونهٔ زیر، device در مرحلهٔ قبل انتخاب شده و پوشهٔ محلی، نسخهٔ ثابت Qwen یا checkpoint حاصل از آموزش آن را نگه میدارد:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

checkpoint = "/models/qwen-reference"
tokenizer = AutoTokenizer.from_pretrained(checkpoint, local_files_only=True)
model = AutoModelForCausalLM.from_pretrained(
    checkpoint,
    local_files_only=True,
    torch_dtype=torch.bfloat16,
    attn_implementation="eager",
).to(device).eval()

batch = tokenizer("زیرساخت هوش مصنوعی به", return_tensors="pt")
batch = {name: value.to(device) for name, value in batch.items()}

with torch.inference_mode():
    logits = model(**batch, use_cache=False).logits

torch.save(logits.float().cpu(), f"logits-{device.type}.pt")
این آزمون در یک محیط با نسخههای سازگار و پشتیبانی BF16 اجرا میشود. خروجی ذخیرهشده برای مقایسهٔ عددی است؛ انتقال آن به CPU جزئی از آزمون صحت است و نباید وارد اندازهگیری سرعت مدل شود. سپس باید همین مقایسه را به چند ورودی، طولهای متفاوت و مسیر تولید با KV cache گسترش داد. برای بررسی کامل مهاجرت آموزش نیز یک batch ثابت را با labelهای یکسان، در حالت آموزش و با کنترل dropout، تا محاسبهٔ loss و backward جلو میبریم.
نبود عملگر دقیقاً در کدام لایه است؟
فرض کنیم وزنهای Qwen بارگذاری شدهاند، اما نخستین اجرای مدل متوقف میشود. عبارت «این عملگر پشتیبانی نمیشود» هنوز تشخیص کافی نیست. ممکن است خود عملگر در دسترس نباشد؛ ممکن است فقط ترکیب خاصی از نوع داده، ابعاد یا چیدمان حافظه پشتیبانی نشود؛ یا ممکن است اجرای عادی کار کند و مسیر کامپایلشده فاقد تبدیل لازم باشد.
حالت دیگری نیز وجود دارد: عملگر عمومی موجود است، اما برنامه مستقیماً یک افزونهٔ مخصوص CUDA را فراخوانی میکند. در این وضعیت، ابتدا باید وابستگی افزونه را از محاسبهٔ موردنیاز جدا کرد. نبود بستهٔ اجرایی مناسب برای آن افزونه، الزاماً به معنی نبود امکان انجام محاسبه در CANN نیست. پروژهٔ OpPlugin دقیقاً بخشی از اتصال عملگرهای PyTorch و عملگرهای اختصاصی TorchNPU به رابطهای محاسباتی CANN را بر عهده دارد. github.com
برای مدل مرجع، attention محل مناسبی برای دیدن این تفاوتهاست. مسیر محاسبه به طول توالی، ماسک علّی، padding، نوع داده و استفاده از KV cache وابسته است. اجرای یک ورودی کوتاه و بدون padding، همهٔ این حالتها را نمیآزماید. بهویژه باید پردازش اولیهٔ ورودی و تولید توکن با cache را جداگانه بررسی کرد؛ شکل محاسبات آنها یکسان نیست.
در نخستین مرحله، هرجا مدل اجازه میدهد، مسیر عمومیتر مانند eager را مبنای صحت قرار میدهم. سپس مسیر بهینهشدهٔ مقصد را فعال و نتیجه را دوباره مقایسه میکنم. این ترتیب یک انتخاب مهندسی برای عیبیابی است: وقتی مسیر ساده درست کار کند، اختلاف نسخهٔ بهینهشده را میتوان در محدودهٔ کوچکتری جستوجو کرد.
| وضعیت مشاهدهشده | اقدام مناسب |
|---|---|
| افزونهٔ CUDA در مقصد بارگذاری نمیشود | بررسی مسیر عمومی مدل یا پیادهسازی سازگار افزونه |
| عملگر فقط با یک نوع داده خطا دارد | بررسی دامنهٔ پشتیبانی و آزمون تبدیل محدود با کنترل خطای عددی |
| فقط بعضی طولها یا layoutها خطا دارند | ساخت نمونهٔ کوچک بازتولیدپذیر و بررسی محدودیت همان ترکیب |
| اجرای عادی درست است، اجرای گرافی خطا دارد | بررسی backend و تبدیل عملگر در مسیر گراف |
| اجرا موفق است، اما کند شده | ثبت profile و بررسی کرنل، انتقال داده و همگامسازی |
بردن یک محاسبه به CPU نیز میتواند برای تشخیص یا یک بخش کمتکرار مفید باشد. اما اگر همان محاسبه در هر لایه و برای هر توکن تکرار شود، هزینهٔ انتقال و انتظار میتواند بر کل سرویس مسلط شود. محل و تعداد وقوع fallback باید معلوم باشد؛ موفقیت اجرای برنامه بهتنهایی آن را توجیه نمیکند.
کرنل اختصاصی را چگونه جایگزین کنیم؟
اکنون نسخهای از پروژه را در نظر بگیریم که تیم برای افزایش سرعت، RMSNorm یا بخشی از attention را با یک کرنل اختصاصی CUDA جایگزین کرده است. در این نقطه، تغییر نام دستگاه کافی نیست؛ باید برای محاسبهٔ موردنیاز، پیادهسازی مناسب مقصد پیدا یا تولید شود.
نخستین انتخاب من بررسی عملگر موجود در پشتهٔ مقصد است. اگر پیادهسازی آماده، قرارداد محاسباتی و کارایی لازم را دارد، نگهداری کرنل تازه هزینهٔ اضافه ایجاد میکند. انتخاب بعدی، بازگرداندن محاسبه به ترکیبی از عملگرهای استاندارد PyTorch است تا یک مرجع قابل مقایسه داشته باشیم. برای نمونه، در RMSNorm باید محل افزودن epsilon، نوع دادهٔ انباشت و زمان تبدیل خروجی دقیقاً حفظ شود؛ شباهت نام دو تابع، برابری رفتار آنها را ثابت نمیکند.
اگر profile نشان داد همین بخش مانع رسیدن به هدف است، توسعهٔ کرنل اختصاصی مقصد معنا پیدا میکند. Ascend C یکی از مسیرهای رسمی این کار است و OpPlugin راهنمای اتصال چنین عملگرهایی به PyTorch را ارائه میکند. در این مسیر باید تقسیم محاسبه، جابهجایی داده، حافظهٔ محلی و همپوشانی مراحل را با معماری مقصد تنظیم کرد. انتقال الگوریتم، به معنی حفظ همان طرح اجرایی CUDA نیست. github.com
Triton-Ascend نیز مسیر دیگری است، بهویژه برای پروژهای که بخشی از کرنلهایش از قبل با Triton نوشته شدهاند. این پروژه backend و سازگارسازی Triton برای Ascend را فراهم میکند؛ بااینحال، دامنهٔ APIهای پشتیبانیشده، نوع داده و انتخاب پارامترهای اجرا همچنان باید بررسی شود. یک کرنل ممکن است با تغییر کمی قابل اجرا شود، اما برای رسیدن به کارایی مناسب به تنظیم دوباره نیاز داشته باشد. github.com
برای کرنلی که در آموزش هم استفاده میشود، صحت forward پایان کار نیست. backward، گرادیانها و رفتار روی ورودیهای مرزی نیز باید آزموده شوند. اگر قرار است عملگر در اجرای گرافی حضور داشته باشد، ثبت عملگر و اطلاعات شکل و نوع خروجی آن هم بخشی از کار است. برآوردی که فقط زمان نوشتن کرنل را حساب کند، این هزینههای اتصال و نگهداری را نادیده میگیرد.
NCCL چگونه به HCCL منتقل میشود؟
در آموزش با DDP، هر فرایند نسخهای از مدل را دارد و گرادیانها میان فرایندها همگام میشوند. وقتی برنامه از رابط عمومی torch.distributed استفاده کرده باشد، تغییر backend از NCCL به HCCL میتواند بخش کوچکی از کد راهاندازی باشد. برای یک اسکریپت مستقل که با torchrun اجرا میشود، شکل سادهٔ این راهاندازی چنین است:
import os
import torch
import torch_npu
import torch.distributed as dist

local_rank = int(os.environ["LOCAL_RANK"])
torch.npu.set_device(local_rank)
device = torch.device("npu", local_rank)
dist.init_process_group(backend="hccl")
این قطعه فقط راهاندازی ارتباطات را نشان میدهد. در اسکریپت مبتنی بر Trainer، باید از مسیر تنظیمات خود چارچوب استفاده کرد؛ ddp_backend="hccl" یکی از گزینههای تعریفشده است و Accelerate نیز مسیر انتخاب HCCL برای NPU دارد. راهاندازی دستی دوباره در کنار مدیریت چارچوب، مسئلهٔ دیگری ایجاد میکند. github.com
اما حفظ نامهایی مانند all_reduce و all_gather فقط بخشی از مهاجرت است. برای نسخهٔ واقعی پروژه باید صحت collectiveهای مورد استفاده، نوع داده، ترتیب فراخوانی در همهٔ فرایندها، انتخاب دستگاه هر فرایند و رفتار ارتباطات غیرهمگام آزموده شود. تنظیمات محیطی و انتخاب الگوریتمهای NCCL نیز نسخهٔ قابل انتقال تنظیمات HCCL محسوب نمیشوند؛ شبکه و توپولوژی مقصد باید جداگانه تنظیم شوند.
در آزمون آموزش، global batch، ترتیب داده، gradient accumulation و برنامهٔ نرخ یادگیری را ثابت نگه میداریم. سپس زمان هر گام و سهم ارتباطات را اندازه میگیریم. اگر اجرای تکدستگاهی مناسب باشد و با افزودن دستگاه، بهرهوری افت کند، باید مسیر ارتباط و همپوشانی محاسبه با ارتباط را بررسی کرد؛ ضعیفبودن مقیاسپذیری را نمیتوان فوراً به توان محاسباتی تراشه نسبت داد.
یک تمایز دیگر هم ضروری است: DDP آموزش، مدل را برای سرویسدهی میان چند دستگاه تقسیم نمیکند. اگر هر درخواست روی یک نسخهٔ کامل مدل پاسخ داده شود، میتوان چند replica مستقل داشت. اگر مدل میان دستگاهها تقسیم شود، به مسیر پشتیبانیشدهٔ tensor parallelism یا روش مناسب دیگر در موتور استنتاج نیاز داریم. تغییر backend آموزش، این طراحی و آزمون جداگانه را انجام نمیدهد.
کیفیت را با شباهت دو پاسخ نسنجیم
برای مقایسهٔ اولیه، یک checkpoint ثابت را با ورودیهای ثابت روی هر دو سکو اجرا میکنیم. tokenizer، token IDها، ماسک، position IDها و تنظیمات تولید باید یکسان باشند. غیرفعالکردن sampling در نخستین آزمون، یکی از منابع تغییرپذیری را حذف میکند، هرچند برابری بیتبهبیت را میان دو پشته تضمین نمیکند.
در سطح عددی، loss و logits و در صورت نیاز خروجی لایههای منتخب را مقایسه میکنیم. وقتی اختلاف آشکار شد، باید نخستین نقطهٔ واگرایی را پیدا کنیم. ابزارهایی مانند msProbe برای جمعآوری داده و مقایسهٔ دقت محاسبات GPU و NPU مسیر مستند دارند. github.com
در سطح کاربرد، معیار باید به کار واقعی مربوط باشد. برای سرویس فارسی، آزمون صرفاً انگلیسی کافی نیست؛ ورودی فارسی، عدد و تاریخ، متن دوزبانه، ورودی بلند و قالب خروجی موردنیاز هم باید حضور داشته باشند. آستانهٔ قابل قبول را پیش از دیدن نتیجه تعیین میکنیم تا هر اختلافی بعداً با عنوان «طبیعی است» پذیرفته نشود.
اگر روی مقصد دوباره آموزش میدهیم، علاوه بر این آزمونها، روند loss، وضعیت گرادیان و نتیجهٔ نهایی را در اجرای تکرارشونده بررسی میکنیم. هدف، حفظ کیفیت موردنیاز و پایداری آموزش است؛ یکسانشدن دقیق همهٔ وزنهای حاصل از دو اجرای متفاوت، معیار مناسبی برای همهٔ پروژهها نیست.
کارایی را در سه نسخه مقایسه کنیم
برای جلوگیری از قضاوت عجولانه، سه نسخه را کنار هم نگه میدارم: نسخهٔ عملیاتی CUDA، نسخهٔ سازگارشدهٔ اولیه روی NPU و نسخهٔ تنظیمشدهٔ مقصد. فاصلهٔ نسخهٔ اول و دوم هزینهٔ عبور اولیه را نشان میدهد؛ فاصلهٔ دوم و سوم روشن میکند چه مقدار از افت، با مهندسی و تنظیم قابل بازیابی بوده است.
این مقایسه به profile نیاز دارد. باید معلوم شود زمان کجا مصرف میشود: tokenization و آمادهسازی داده، انتقال، کرنلهای محاسباتی، تخصیص حافظه، همگامسازی یا ارتباط میان دستگاهها. کندی یک اجرای کوتاه ممکن است تحتتأثیر راهاندازی و کامپایل اولیه باشد؛ بنابراین زمان شروع و کارایی پایدار را جدا ثبت میکنیم.
اجرای گرافی هم مرحلهای مستقل است. TorchAir برای تبدیل گراف PyTorch و اجرای آن در مسیر گرافی Ascend امکاناتی فراهم میکند، اما کارکردن مدل در حالت عادی، پشتیبانی تمام مسیرهای گرافی را ثابت نمیکند. شکلهای پویا، graph break و کامپایل مجدد باید با توزیع طول ورودی واقعی بررسی شوند. github.com
در مرحلهٔ تنظیم نیز هر تغییر باید اثر قابل مشاهده داشته باشد: تنظیم batch، گروهبندی طولها، کاهش انتقالهای غیرضروری، انتخاب کرنل مناسب یا تغییر شیوهٔ تقسیم مدل. اگر برای بهترشدن عدد آزمون، طول ورودی یا خروجی را کاهش دادهایم، باید این تغییر در کنار نتیجه گزارش شود؛ زیرا بار کاری دیگری ساختهایم.
ظرفیت سرویس با سرعت یک اجرای مدل فرق دارد
فراخوانی مستقیم generate() برای آزمون صحت مفید است، اما نمایندهٔ کامل یک سرویس پرترافیک نیست. در سرویس، صف درخواست، زمانبندی، batching، KV cache، محدودیت حافظه و لغو درخواستها نیز در نتیجه دخالت دارند. اگر مبدأ از موتور تخصصی استفاده میکند، مقصد را هم باید در مسیر عملیاتی مناسب خودش ارزیابی کرد.
برای نمونه، vLLM Ascend یکی از مسیرهای سرویسدهی است. بااینحال، باید مدل، نسل سختافزار و قابلیتهای موردنیاز را در ماتریس همان نسخه بررسی کرد. وجود نام یک خانوادهٔ مدل در جدول، بهتنهایی پشتیبانی همهٔ روشهای کوانتش، طولهای زمینه و حالتهای موازیسازی آن را ثابت نمیکند. docs.vllm.ai
برای پروژهٔ مرجع، گزارش پذیرش سرویس باید دستکم این موارد را کنار هم داشته باشد:
| محور | آنچه اندازه میگیریم |
|---|---|
| کیفیت | نتیجهٔ مجموعهٔ آزمون ثابت و موارد حساس کاربرد |
| تأخیر شروع پاسخ | TTFT از دید کاربر، با احتساب زمان صف |
| ادامهٔ تولید | فاصلهٔ میان توکنها و زمان تکمیل پاسخ |
| ظرفیت | درخواست موفق در واحد زمان با رعایت حدود تأخیر |
| منابع | مصرف و اوج حافظه در ترکیب واقعی طول ورودی و خروجی |
| پایداری | خطا، OOM، timeout، لغو درخواست و رفتار زیر بار طولانی |
| بازیابی | زمان راهاندازی مجدد و بازگشت سرویس به وضعیت آماده |
میانگین تأخیر بهتنهایی کافی نیست؛ صدکهایی مانند P95 و P99 نشان میدهند کاربران کندتر چه تجربهای دارند. ظرفیت نیز باید با نرخ ورود درخواست و توزیع واقعی طول ورودی و خروجی سنجیده شود. «صد کاربر همزمان» بدون این مشخصات، هنوز یک بار کاری تعریفشده نیست.
از نظر من، معیار مفید ظرفیت، تعداد درخواستهایی است که با کیفیت و در محدودهٔ زمانی پذیرفتهشده کامل میشوند. افزایش throughput با صف طولانیتر، وقتی کاربر از حد انتظارش عبور کرده است، لزوماً به معنی بازیابی ظرفیت سرویس نیست.
مهاجرت چه زمانی تمام شده است؟
وقتی مدل اجرا شد، هنوز باید بتوان محیط را دوباره ساخت، خطا را پیدا کرد و نسخهٔ بعدی را با اطمینان مستقر کرد. تصویر اجرایی و وابستگیهای ثبتشده، آزمونهای صحت و بار، روش پایش حافظه و ارتباطات، و دستورالعمل بازیابی خرابی بخشی از خروجی مهاجرت هستند. نصب و استقرار در محیطی با دسترسی محدود به اینترنت نیز، اگر از نیازهای بهرهبرداری است، باید عملاً آزموده شود.
برای کرنل اختصاصی یا patch محلی، مسئول نگهداری و مسیر ارتقا باید معلوم باشد. اگر هر بهروزرسانی Transformers یا TorchNPU نیازمند اصلاح دستی چند مخزن باشد، این هزینه باید وارد تصمیم زیرساخت شود. حتی یک مهاجرت موفق از نظر سرعت میتواند از نظر نگهداری بیش از توان تیم هزینه ایجاد کند.
مهاجرت این پروژه از CUDA به CANN چند کار مشخص دارد: تغییر فراخوانیهای وابسته به دستگاه، جایگزینی عملگرها و کرنلهای ناسازگار، انتقال ارتباطات از NCCL به HCCL و تنظیم دوبارهٔ اجرای مدل. بخشی از کد حفظ میشود و بخشی به بازنویسی نیاز دارد. هزینهٔ مهاجرت نیز از همین کارها به دست میآید: زمان توسعه و آزمون، منابع لازم برای پاسخگویی به بار واقعی و کار مستمری که نگهداری نسخهٔ جدید میطلبد.
کار زمانی تمام میشود که مدل کیفیت موردنیاز را حفظ کند، درخواستها در زمان تعیینشده پاسخ بگیرند و تیم فنی بتواند سرویس را مستقر، پایش و بهروزرسانی کند. رسیدن به این نقطه، امکان انتخاب زیرساخت را به یک توانایی عملی تبدیل میکند. آنوقت سازمان میتواند بخشی از بار کاری خود را روی Ascend اجرا کند و برای توسعه یا جایگزینی زیرساخت، مسیر دومی در اختیار داشته باشد؛ مسیری که هزینه و ظرفیت آن را با پروژهٔ خودش سنجیده است.