Cambiar de dispositivo, adaptar operadores, trasladar las comunicaciones y recuperar rendimiento al entrenar y servir un modelo de lenguaje
En el artículo anterior preguntaba qué partes del sistema dejarían de funcionar si mañana retirásemos NVIDIA. La discusión mostró que los pesos, los kernels, la comunicación entre aceleradores y el motor de servicio tienen costes de traslado distintos. Ahora quiero seguir la misma cuestión en un proyecto concreto: ¿qué necesita cambiar para trasladar a Ascend un modelo que entrenamos con PyTorch, ejecutamos sobre CUDA y ofrecemos como servicio?
Las dificultades principales suelen aparecer después de la primera ejecución correcta. El modelo puede cargar y producir resultados, pero fallar con entradas largas, bloquearse durante el entrenamiento multidispositivo o perder capacidad de servicio cuando aumentan las peticiones. Para estimar el coste de migrar hay que distinguir desde el principio tres tareas: adaptar la interfaz, disponer de una ruta de cálculo correcta y alcanzar la calidad y el rendimiento que necesita el servicio.
Definir el proyecto de referencia
La referencia es el proyecto de código abierto Transformers y su script de entrenamiento de modelos de lenguaje causal, examples/pytorch/language-modeling/run_clm.py. El modelo de ejemplo es Qwen2.5-1.5B: un modelo real, con pesos publicados e implementación en Transformers, cuyo tamaño permite estudiar la migración. La elección responde a un estudio de ingeniería; su idoneidad para una aplicación en persa necesita una evaluación aparte. Página del modelo
El escenario consiste en continuar su entrenamiento sobre un corpus de texto y después ofrecer ese mismo modelo para generar texto. Esta ruta estudia el entrenamiento sobre texto; construir un asistente conversacional requiere además diseñar datos, formato de conversación y entrenamiento apropiados. En el origen, el entrenamiento puede utilizar varias GPU con DDP y el servicio puede disponer de una implementación optimizada.
Lo que sigue es un análisis de la migración basado en código y documentación oficial. Este artículo no incluye mediciones sobre hardware Ascend ni presenta cifras de rendimiento como resultados experimentales. Tampoco atribuyo un kernel CUDA propio al script original: examino esa dependencia por separado en versiones optimizadas del proyecto.
Crear una versión comparable antes de cambiar el código
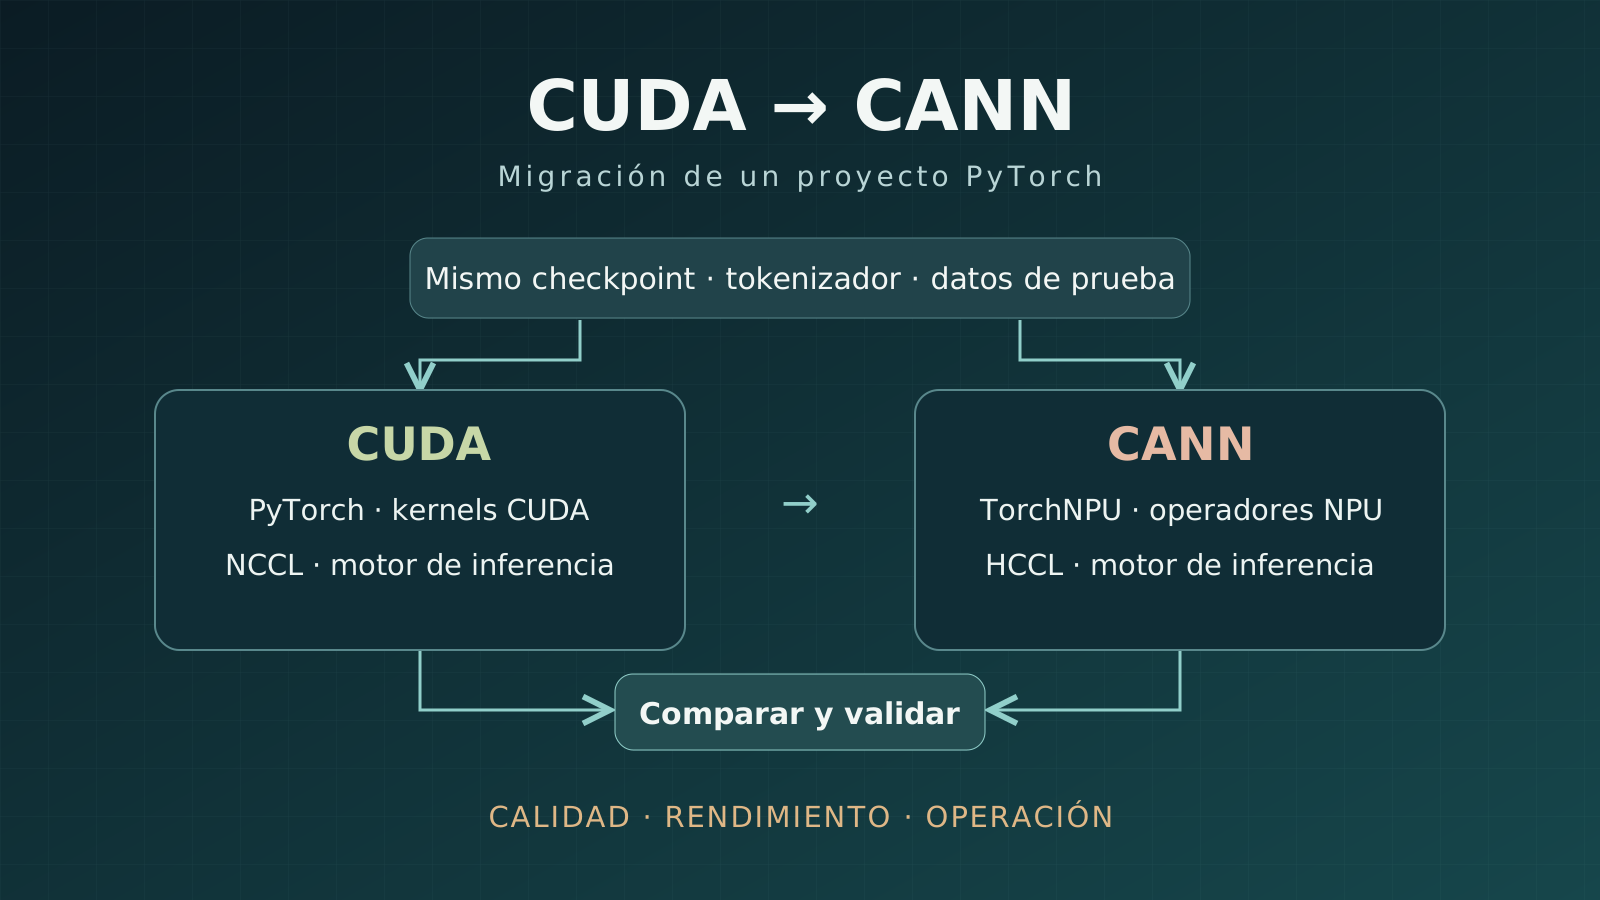
Cambiar a la vez la versión del modelo, la cuantización, la longitud de contexto y el motor dificulta localizar la causa de una diferencia. Hay que empezar por un checkpoint fijo, el mismo tokenizador, un preprocesamiento idéntico y un conjunto común de pruebas. Primero comparamos ese checkpoint en ambas plataformas; después continuamos el entrenamiento en el destino.
La distinción importa. Una diferencia en la salida de unos pesos fijos pertenece a la ruta de inferencia. La diferencia entre dos modelos entrenados por separado también puede proceder del orden de los datos, el cálculo numérico, las comunicaciones distribuidas y la optimización. Mezclar las dos pruebas complica innecesariamente el diagnóstico.
El entorno de destino también debe poder reconstruirse. En Ascend hay que seleccionar PyTorch, torch_npu, CANN, Python, el controlador y el firmware según la matriz de compatibilidad. Instalar la última versión de cada componente no garantiza que funcionen juntos. También deben registrarse y probarse las versiones de Transformers, Accelerate y las extensiones de operadores. Matriz de compatibilidad
El mapa aproximado de dependencias del proyecto es este:
| Componente | ¿Qué hay en el origen? | ¿Qué revisar en el destino? |
|---|---|---|
| Pesos y tokenizador | Archivos estándar del modelo | Cargar la misma revisión y conservar el preprocesamiento |
| Selección de dispositivo | cuda y llamadas a torch.cuda | Dispositivo npu e interfaces equivalentes |
| Cálculo del modelo | Operadores PyTorch y ruta de atención elegida | Formas, tipos, máscaras y rutas de cálculo admitidos |
| Entrenamiento distribuido | DDP con backend NCCL | DDP con backend HCCL |
| Optimizaciones añadidas | Kernels propios, extensiones o ejecución de grafos | Equivalentes, reescritura o reajuste |
| Servicio | Agrupación de peticiones, caché, cola y motor | Soporte y ajuste de esas mismas capacidades |
| Operación | Imagen de despliegue, supervisión y recuperación | Entorno reproducible y mantenimiento probado |
La tabla debe completarse con las dependencias reales del repositorio. Que PyTorch figure entre las tecnologías no basta para estimar la migración.
Lo que realmente se resuelve cambiando la interfaz
En una ejecución con un solo dispositivo, el cambio inicial puede ser pequeño. La parte dependiente del dispositivo en un script CUDA sencillo podría ser:
torch.cuda.set_device(0)
device = torch.device("cuda:0")
model = model.to(device)
batch = {name: value.to(device) for name, value in batch.items()}
Al utilizar TorchNPU explícitamente, pasa a ser:
import torch_npu

torch.npu.set_device(0)
device = torch.device("npu:0")
model = model.to(device)
batch = {name: value.to(device) for name, value in batch.items()}
Aquí model y batch ya existen y los valores del lote son tensores. El fragmento muestra únicamente la selección del dispositivo y el traslado de datos. TorchNPU permite ejecutar PyTorch sobre NPU Ascend; si los operadores están admitidos, buena parte de la lógica del modelo puede conservarse. Repositorio TorchNPU
En un proyecto con Trainer y Accelerate, el framework gestiona parte de la selección del dispositivo y la inicialización distribuida. La documentación de Transformers identifica Ascend con el dispositivo npu y el paquete torch-npu. Antes de reescribir el bucle de entrenamiento hay que comprobar qué ofrecen ya las versiones elegidas. Documentación de hardware
La dependencia de CUDA no se limita a .cuda(). Hay que revisar CUDA Event para medir tiempos, streams, sincronización, precisión mixta, gestión de memoria y condiciones como torch.cuda.is_available(). Si el programa vuelve silenciosamente a CPU cuando no encuentra CUDA, podría parecer correcto sin haber calculado nada en la NPU. Registrar al inicio el dispositivo del modelo y los datos es una comprobación sencilla y necesaria.
TorchNPU también ofrece migración automática mediante from torch_npu.contrib import transfer_to_npu. Puede redirigir algunas llamadas, pero tiene limitaciones documentadas, como incompatibilidades con ciertos usos de torch.jit.script. Ayuda a acortar la adaptación, sin sustituir las pruebas del comportamiento del programa. Guía de migración
Para conectar el cambio con una prueba concreta del mismo modelo, podemos empezar por una pasada hacia delante sencilla. Aquí device se ha seleccionado antes y la carpeta local contiene la revisión fija de Qwen o el checkpoint resultante de entrenarlo:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

checkpoint = "/models/qwen-reference"
tokenizer = AutoTokenizer.from_pretrained(checkpoint, local_files_only=True)
model = AutoModelForCausalLM.from_pretrained(
    checkpoint,
    local_files_only=True,
    torch_dtype=torch.bfloat16,
    attn_implementation="eager",
).to(device).eval()

batch = tokenizer("زیرساخت هوش مصنوعی به", return_tensors="pt")
batch = {name: value.to(device) for name, value in batch.items()}

with torch.inference_mode():
    logits = model(**batch, use_cache=False).logits

torch.save(logits.float().cpu(), f"logits-{device.type}.pt")
La prueba presupone versiones compatibles y soporte BF16. La salida guardada sirve para comparar numéricamente; trasladarla a CPU forma parte de comprobar la corrección y no debe incluirse al medir la velocidad. Después hay que extender la comparación a varias entradas, diferentes longitudes y generación con caché KV. Para evaluar la migración del entrenamiento también llevamos un lote fijo, con etiquetas idénticas y control del dropout, hasta calcular la pérdida y ejecutar la retropropagación en modo de entrenamiento.
¿En qué capa falta el operador?
Supongamos que los pesos de Qwen cargan, pero la primera ejecución se detiene. «Este operador no está soportado» todavía no es un diagnóstico suficiente. Puede faltar el operador; puede no admitirse una combinación de tipo, forma o disposición de memoria; o puede funcionar en ejecución directa y faltar la conversión en la ruta compilada.
También puede existir un operador general mientras la aplicación llama directamente a una extensión específica de CUDA. Primero hay que separar la dependencia de la extensión del cálculo requerido. Que no exista un paquete ejecutable de esa extensión no significa necesariamente que CANN no pueda realizar el cálculo. OpPlugin conecta parte de los operadores PyTorch y específicos de TorchNPU con las interfaces de cálculo CANN. Repositorio OpPlugin
En el modelo de referencia, la atención permite observar estas diferencias. Su ruta depende de la longitud de secuencia, la máscara causal, el padding, el tipo de datos y la caché KV. Una entrada corta y sin padding no comprueba todas las combinaciones. Hay que examinar por separado el procesamiento inicial y la generación con caché: sus formas de cálculo son distintas.
Cuando el modelo lo permite, primero tomo una ruta más general, como eager, como referencia de corrección. Después activo la ruta optimizada del destino y vuelvo a comparar. Es una elección de ingeniería para diagnosticar: si funciona la ruta sencilla, la diferencia de la optimizada puede buscarse en un ámbito más reducido.
| Situación observada | Acción apropiada |
|---|---|
| No carga una extensión CUDA | Examinar la ruta general del modelo o una implementación compatible |
| Un operador falla con un único tipo | Comprobar los límites de soporte y probar una conversión acotada, controlando el error numérico |
| Solo fallan ciertas longitudes o disposiciones | Crear un caso pequeño reproducible y revisar esa combinación |
| Funciona la ejecución directa, pero falla el grafo | Examinar el backend y la conversión del operador en el grafo |
| Se ejecuta correctamente, pero más despacio | Perfilar kernels, transferencias y sincronización |
Trasladar un cálculo a CPU puede ayudar al diagnóstico o servir para una parte poco frecuente. Pero si se repite en cada capa y para cada token, las transferencias y esperas pueden dominar el servicio. Debemos localizar cada fallback y su frecuencia; que el programa se ejecute no basta para justificarlo.
¿Cómo sustituir un kernel propio?
Consideremos ahora una versión en la que el equipo ha sustituido RMSNorm o parte de la atención por un kernel CUDA propio para aumentar la velocidad. Cambiar el nombre del dispositivo no basta: hay que encontrar o desarrollar una implementación adecuada del cálculo en el destino.
Mi primera opción es revisar los operadores de la pila de destino. Si uno existente cumple el contrato de cálculo y el rendimiento necesario, mantener otro kernel añade coste. La siguiente opción es expresar el cálculo con operadores PyTorch estándar para tener una referencia comparable. En RMSNorm, por ejemplo, hay que conservar exactamente dónde se añade epsilon, el tipo de acumulación y cuándo se convierte la salida. Que dos funciones tengan nombres similares no demuestra que se comporten igual.
Si el perfil muestra que esa parte impide alcanzar el objetivo, tiene sentido desarrollar un kernel propio para el destino. Ascend C es una de las vías oficiales, y OpPlugin documenta cómo conectarlo con PyTorch. La partición del cálculo, las transferencias, la memoria local y el solapamiento deben ajustarse a la arquitectura de destino. Trasladar el algoritmo no implica conservar el diseño de ejecución CUDA. Documentación de OpPlugin
Triton-Ascend ofrece otra vía, especialmente si el proyecto ya tiene kernels escritos en Triton. Proporciona un backend y adaptación de Triton para Ascend, pero hay que revisar las API, los tipos y los parámetros de ejecución admitidos. Un kernel puede ejecutarse con pocos cambios y aun necesitar reajuste para rendir adecuadamente. Repositorio Triton-Ascend
Para un kernel utilizado en entrenamiento, una pasada hacia delante correcta no termina el trabajo. También se prueban la retropropagación, los gradientes y las entradas límite. La ejecución de grafos exige además registrar el operador y describir las formas y tipos de salida. Contar solo el tiempo de escribir el kernel omite los costes de integración y mantenimiento.
¿Cómo se pasa de NCCL a HCCL?
En DDP, cada proceso tiene una copia del modelo y los gradientes se sincronizan entre procesos. Si la aplicación utiliza la interfaz general torch.distributed, cambiar de NCCL a HCCL puede afectar solo a una pequeña parte de la inicialización. Un script independiente ejecutado mediante torchrun puede empezar así:
import os
import torch
import torch_npu
import torch.distributed as dist

local_rank = int(os.environ["LOCAL_RANK"])
torch.npu.set_device(local_rank)
device = torch.device("npu", local_rank)
dist.init_process_group(backend="hccl")
El fragmento solo inicializa comunicaciones. Con Trainer hay que utilizar la configuración del framework: ddp_backend="hccl" es una opción definida y Accelerate también contempla HCCL para NPU. Añadir una segunda inicialización manual a la gestión del framework crea otro problema. Argumentos de entrenamiento de Transformers
Conservar nombres como all_reduce y all_gather cubre solo parte de la migración. Hay que probar las operaciones colectivas utilizadas, los tipos, el orden de llamadas en todos los procesos, la asignación de dispositivos y el comportamiento asíncrono. Las variables de entorno y elecciones de algoritmos NCCL no se trasladan como ajustes HCCL; la red y la topología de destino necesitan ajuste propio.
En las pruebas de entrenamiento mantenemos el lote global, el orden de datos, la acumulación de gradientes y el programa de tasa de aprendizaje. Después medimos el tiempo por paso y la proporción de comunicación. Si un dispositivo funciona adecuadamente pero la eficiencia cae al añadir otros, hay que examinar las comunicaciones y su solapamiento con el cálculo. Una mala escalabilidad no puede atribuirse inmediatamente a la capacidad de cómputo del chip.
Hay otra distinción esencial: DDP de entrenamiento no divide el modelo entre dispositivos para servirlo. Si cada petición utiliza una copia completa, podemos tener réplicas independientes. Si dividimos el modelo, el motor de inferencia necesita una ruta admitida de paralelismo tensorial u otro método adecuado. Cambiar el backend de entrenamiento no realiza ese trabajo independiente de diseño y pruebas.
No medir la calidad por dos respuestas parecidas
Para la primera comparación ejecutamos un checkpoint fijo y entradas fijas en ambas plataformas. Tokenizador, identificadores de tokens, máscaras, identificadores de posición y ajustes de generación deben coincidir. Desactivar el muestreo elimina una fuente de variabilidad, aunque no garantiza igualdad bit a bit entre pilas.
Numéricamente comparamos pérdida, logits y, cuando haga falta, salidas de ciertas capas. Ante una diferencia hay que encontrar el primer punto de divergencia. Herramientas como msProbe documentan la recogida de datos y la comparación de precisión entre GPU y NPU. Documentación de msProbe
En la aplicación, los criterios deben corresponder al trabajo real. Para un servicio en persa no basta probar en inglés: hacen falta entradas persas, números y fechas, texto bilingüe, entradas largas y el formato de salida requerido. Fijamos los umbrales antes de ver los resultados para no aceptar después cualquier diferencia como «normal».
Si volvemos a entrenar en destino, también examinamos la evolución de la pérdida, los gradientes y el resultado final en ejecuciones repetidas. El objetivo es conservar la calidad y estabilidad necesarias; obtener exactamente los mismos pesos en dos ejecuciones distintas no es un criterio adecuado para todos los proyectos.
Comparar el rendimiento en tres versiones
Para evitar conclusiones prematuras mantengo tres versiones: CUDA en producción, la primera adaptación compatible con NPU y la versión ajustada del destino. La distancia entre primera y segunda muestra el coste inicial; entre segunda y tercera, cuánto deterioro puede recuperarse mediante ingeniería y ajuste.
La comparación exige perfiles. Hay que localizar el tiempo en tokenización y preparación de datos, transferencias, kernels, asignación de memoria, sincronización o comunicación. El arranque y la compilación inicial pueden distorsionar una ejecución corta; por eso registramos por separado el tiempo de inicio y el rendimiento estable.
La ejecución de grafos es otra etapa independiente. TorchAir ofrece conversión de grafos PyTorch y ejecución por la ruta de grafos Ascend, pero que el modelo funcione directamente no demuestra soporte en todas las rutas de grafo. Hay que revisar formas dinámicas, interrupciones del grafo y recompilaciones con la distribución real de longitudes. Repositorio TorchAir
Cada ajuste debe tener un efecto observable: modificar lotes, agrupar longitudes, reducir transferencias, elegir kernels o cambiar la partición del modelo. Si reducimos las longitudes de entrada o salida para mejorar el resultado, debe indicarse junto a la cifra: se ha construido otra carga.
La capacidad del servicio no es la velocidad de una ejecución
Llamar directamente a generate() ayuda a probar la corrección, pero no representa por completo un servicio con mucho tráfico. La cola, la planificación, la agrupación de peticiones, la caché KV, los límites de memoria y la cancelación también influyen. Si el origen utiliza un motor especializado, el destino debe evaluarse en su ruta de producción apropiada.
vLLM Ascend es una opción. Hay que comprobar el modelo, la generación de hardware y las funciones en la matriz de la versión concreta. Que aparezca una familia no demuestra soporte para todas sus cuantizaciones, longitudes de contexto y modos de paralelismo. Modelos admitidos
El informe de aceptación del proyecto de referencia debe incluir al menos:
| Dimensión | Qué medimos |
|---|---|
| Calidad | Resultado del conjunto fijo y casos sensibles de la aplicación |
| Inicio de respuesta | TTFT percibido por el usuario, incluida la cola |
| Continuación de generación | Intervalo entre tokens y tiempo de finalización |
| Capacidad | Peticiones correctas por unidad de tiempo dentro de los límites de latencia |
| Recursos | Consumo y máximo de memoria con combinaciones reales de entrada y salida |
| Estabilidad | Errores, OOM, timeouts, cancelaciones y comportamiento con carga prolongada |
| Recuperación | Tiempo de reinicio y vuelta al estado disponible |
La latencia media no basta: P95 y P99 muestran la experiencia de las peticiones más lentas. La capacidad debe medirse con la tasa de llegada y las distribuciones reales de longitud. «Cien usuarios simultáneos» sin esas especificaciones aún no define una carga.
Para mí, una medida útil es el número de peticiones completadas con la calidad necesaria y dentro del plazo aceptado. Aumentar el procesamiento prolongando las colas más allá de lo que el usuario admite no equivale necesariamente a recuperar capacidad de servicio.
¿Cuándo termina la migración?
Después de ejecutar el modelo todavía hay que poder reconstruir el entorno, diagnosticar errores y desplegar la siguiente versión con confianza. La imagen de despliegue, las dependencias registradas, las pruebas de corrección y carga, la supervisión de memoria y comunicaciones y la recuperación forman parte de los entregables. Si la operación necesita instalación con acceso limitado a internet, también debe probarse realmente.
Para kernels propios o parches locales hay que definir responsables y ruta de actualización. Si cada actualización de Transformers o TorchNPU requiere cambios manuales en varios repositorios, ese coste debe incorporarse a la decisión. Incluso una migración rápida puede imponer un mantenimiento superior a la capacidad del equipo.
Migrar este proyecto de CUDA a CANN comprende tareas concretas: cambiar llamadas dependientes del dispositivo, sustituir operadores y kernels incompatibles, pasar de NCCL a HCCL y reajustar la ejecución. Parte del código se conserva y parte se reescribe. De ahí sale el coste: desarrollo y pruebas, recursos para responder a la demanda real y mantenimiento continuado de la nueva versión.
El trabajo termina cuando el modelo conserva la calidad requerida, las peticiones cumplen sus plazos y el equipo puede desplegar, supervisar y actualizar el servicio. Llegar a ese punto convierte la elección de infraestructura en una capacidad práctica. La organización puede ejecutar parte de sus cargas en Ascend y dispone de una segunda ruta para ampliar o sustituir su infraestructura, con costes y capacidad medidos en su propio proyecto.