پیادهسازی هوش مصنوعی بدون اعتماد یک فرآیند تدریجی است. نقطهٔ آغاز بسیاری از سازمانها چند اسکریپت، چند فایل مدل و تیمهایی است که جدا از یکدیگر کار میکنند؛ نقطهٔ پایان، معماریای است که در آن داده، آموزش، ارزیابی و استقرار در مرزهای مشخص و قابل کنترل انجام میشوند و انسان میتواند از دسترسی مستقیم به دادههای حساس حذف شود.
این سطحبندی، برداشتی نوین بر پایهٔ مدلهای بلوغ معماری بدون اعتماد CISA و تصاویر معماری MLOps مایکروسافت است؛ تصاویر این بخش بر مبنای پیاده سازی مایکروسافت، در اینجا برای صورتبندی مسیری به کار رفتهاند که از بلوغ مهندسی هوش مصنوعی آغاز میشود و به هوش مصنوعی بدون اعتماد میرسد، بهویژه در سطح چهار که تفسیر ارائهشده فراتر از بیان متعارف MLOps است.
پیشنیاز فهم این مدل، شناخت MLOps بهعنوان بستر عملی ZTAI است. سطوح صفر تا سه بیش از هر چیز بلوغ مهندسی و عملیاتی را میسازند؛ سطح چهار جایی است که این بلوغ میتواند برای اجرای واقعی اصول بدون اعتماد به کار گرفته شود.
سطح صفر: دستی و هرجومرج
در سطح صفر، فرآیندهای امنیتی و مهندسی هوش مصنوعی عمدتاً دستی و پراکندهاند. دانشمندان داده معمولاً جدا از بقیهٔ تیم کار میکنند و حتی اگر مهندسان داده حضور داشته باشند، تعامل آنها با سایر اعضا محدود است. مهندس نرمافزار مدل را بهصورت دستی و با روشهای سنتی از تیم داده میگیرد و برنامه را پیرامون آن مینویسد.
گردآوری داده تدریجی و دستی است، محاسبات تقریباً مدیریت نمیشوند و آزمایشها بهدرستی دنبال و مستند نمیشوند. مدل نهایی ممکن است فقط یک فایل یا برنامه با ورودی و خروجی مشخص باشد. استقرار نیز کاملاً دستی است. اسکریپتهای ارزیابی معمولاً پس از تولید مدل نوشته میشوند و نسخهگذاری ندارند. فرآیند تأیید استاندارد نیست و نسخهٔ نهایی ممکن است توسط برنامهنویس، مهندس داده یا حتی دانشمند داده مستقر شود.
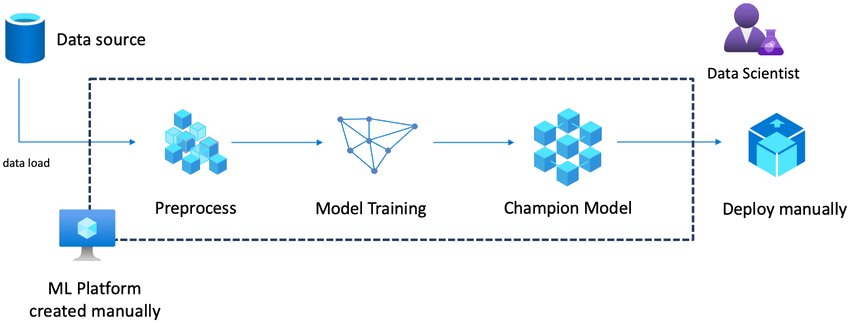
در این سطح، بازتولید مدل بسیار دشوار است؛ افراد از ابزارها، کدها و اسکریپتهای متنوعی استفاده میکنند که ممکن است تغییر کرده یا به اشتراک گذاشته نشده باشند. آزمایشها از پیش تعیین نشدهاند و در سطح سازمان به اشتراک گذاشته نمیشوند. امکان نشت داده و مدل به دلیل اتکا به افراد بالاست و عملاً حکمرانی داده وجود ندارد.
فرآیندها مقیاسپذیر نیستند و منابع پردازش سریع مانند GPU بهدرستی میان افراد سازمان به اشتراک گذاشته نمیشوند. منابع داده نیز برای فعالیت یادگیری ماشین آماده نیستند و هر استفاده به اسکریپت و کار دستی تازه نیاز دارد.
سطح یک: پایهای و مدیریتشده
در سطح یک، نقش افراد هنوز تفاوت بنیادینی با سطح صفر ندارد. دانشمندان داده همچنان ایزولهاند، مهندسان داده تعامل محدودی دارند و مهندسان نرمافزار فقط با ابزارهای مدیریت کد تا اندازهای وضعیت بهتری پیدا کردهاند.
فرآیند گردآوری داده خودکار میشود، اما پردازش داده میتواند مدیریتشده یا مدیریتنشده باشد. آزمایشها همچنان بهدرستی مدیریت نمیشوند و مدلهای خروجی مانند سطح صفر، هرکدام فایلی با ورودی و خروجی مشخصاند. انتشار مدل دستی است. اسکریپتهای ارزیابی نسخهگذاری میشوند، اما همچنان دستی تولید میشوند و مدل در روالی مشخص به برنامهنویس تحویل داده میشود تا استقرار را انجام دهد.
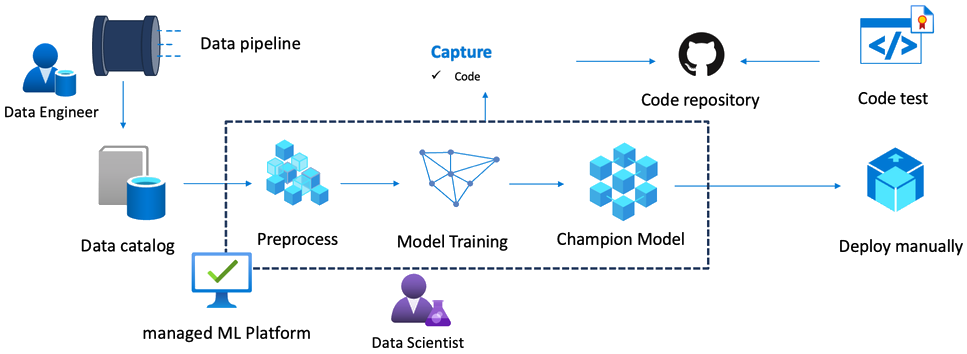
آزمایش کیفی معمولاً پیش از استقرار انجام میشود و تولید نسخهٔ انتشار میتواند خودکار باشد. بااینحال، کیفیت هنوز به مهارت افراد وابسته است. تنوع ابزارها مدیریت یکپارچهٔ تیم را دشوار میکند، تضمین کیفیت عمدتاً به بخش نرمافزار محدود میماند و مدل کنترل کیفی درست ندارد. احتمال نشت داده و مدل همچنان بالاست و حکمرانی داده شکل نگرفته است. مشکل اشتراک منابع GPU نیز حل نشده است.
سطح دو: خودکارسازی اولیه همراه با ردیابی
در سطح دو، دانشمند داده با مهندس داده برای تولید کد و فرآیندهای خودکار همکاری میکند. مهندس داده در تعامل مستقیم با دانشمند داده است. مهندس نرمافزار هنوز تعامل نزدیکی با این دو گروه ندارد، اما مدل را بهصورت خودکار دریافت میکند.
گردآوری داده خودکار و پردازش آن کاملاً مدیریتشده است. آزمایشها دنبال و نسخهگذاری میشوند. کد، اسکریپت، داده، مدل و برنامهٔ نهایی همگی نسخه دارند. با وجود این، انتشار مدل هنوز دستی است. اسکریپتهای ارزیابی همراه با نتیجهٔ ارزیابی ذخیره میشوند و نسخهٔ انتشار را برنامهنویس مدیریت میکند.
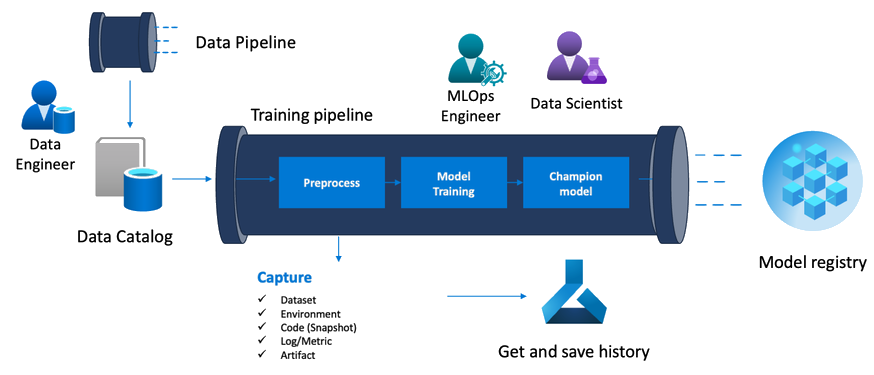
در این سطح میتوان کیفیت بخشهای مختلف را دنبال کرد و سامانه شفافتر میشود، اما اثر این کنترلها در نسخهٔ مستقر هنوز کامل نیست. هنوز روشن نیست کیفیت مدل چگونه به کیفیت محصول نهایی تبدیل میشود. نشت داده و مدل به دلیل اتکا به افراد ممکن است و حکمرانی داده کامل نیست. مقیاسپذیری منابع توسعه و استقرار در چند نقطه نیز هنوز مسئله است.
سطح سه: استقرار خودکار و CI/CD
در سطح سه، دانشمند داده، مهندس داده و مهندس نرمافزار در تعامل مستقیماند. مهندس داده ورود و خروجیها را با همکاری هر دو گروه مدیریت میکند و فرآیندهای گردآوری و پردازش داده خودکار و مدیریتشدهاند. آزمایشها همراه با نتایج نسخهگذاری میشوند و همهٔ اجزا، از کد و اسکریپت تا داده، مدل و برنامهٔ نهایی، قابل ردیابیاند.
مدل بهصورت دقیق و نیمهخودکار ارزیابی کیفی میشود. انتشار خودکار است، اسکریپت و نتیجهٔ ارزیابی ذخیره میشوند و فرآیند توسعه و استقرار توأم یا CI/CD امکان بهرهبرداری واقعی پیدا میکند. آزمایشهای قطعهای و کنترل کیفی برای هر مدل انجام میشوند و کیفیت، به دلیل خودکارشدن ارزیابی، کمتر به یک فرد خاص وابسته است. مهندس کنترل کیفیت و DevOps بر فرآیند نظارت میکنند.
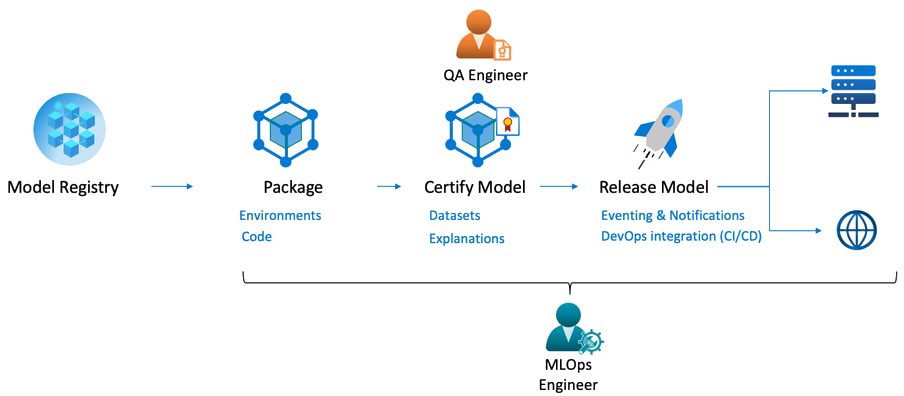
سطح سه پایان مسیر نیست. تنوع ابزارها کمتر شده، اما از بین نرفته است. کیفیت مدل و محصول قابل کنترل شده، بااینحال ممکن است مدل در آزمایش بهتر شود اما تجربهٔ کاربر در محیط عملیاتی بهبود پیدا نکند. امکان نشت داده و مدل هنوز وجود دارد و حکمرانی داده کامل نیست، هرچند با اعمال محدودیت میتوان ریسک را کاهش داد.
استقرار روی چند گره و مدیریت منابع بهرهبرداری بهبود یافته، اما منابع آموزش همچنان میتوانند چالشبرانگیز باشند. مهمتر آنکه فرآیند عمدتاً یکطرفه است و بازخورد مدل مستقر بر چرخهٔ تولید اثر نمیگذارد. استقرار نسخهٔ تازه بدون توقف خدمت نیز لزوماً حل نشده است.
سطح چهار: خودکارسازی کامل و امکان حذف عامل انسانی
در سطح چهار، هر سه گروهِ دانشمندان داده، مهندسان داده و مهندسان نرمافزار یا MLOps بر خودکارسازی همهٔ فرآیندها، از مهندسی داده تا استقرار و کنترل کیفیت، نظارت میکنند. انسان میتواند از ورود مستقیم به بخشهای دادهمحور حذف شود و نقش او به ناظر یا تعریفکنندهٔ فرآیند تقلیل یابد؛ بنابراین میتوان حق دسترسی مستقیم به داده را از او سلب کرد.
گردآوری داده خودکار است و بازآموزی مدل میتواند خودکار فعال شود. آزمایشها همراه با نتایج نسخهگذاری میشوند و تمام اجزای تولید و خود فرآیندها قابل ردیابیاند. مدل بهصورت دقیق و خودکار ارزیابی میشود و بازخورد کاربر در تولید نسخهٔ بعدی اثر میگذارد.
انتشار خودکار است و CI/CD با آموزش مستمر یا CT تکمیل میشود. آزمایشهای قطعهای، کنترل کیفیت و آزمایشهای جعبهسیاه برای هر نسخهٔ مدل خودکار اجرا میشوند و متخصصان کنترل کیفیت و عملیات بر فرآیند نظارت دارند.
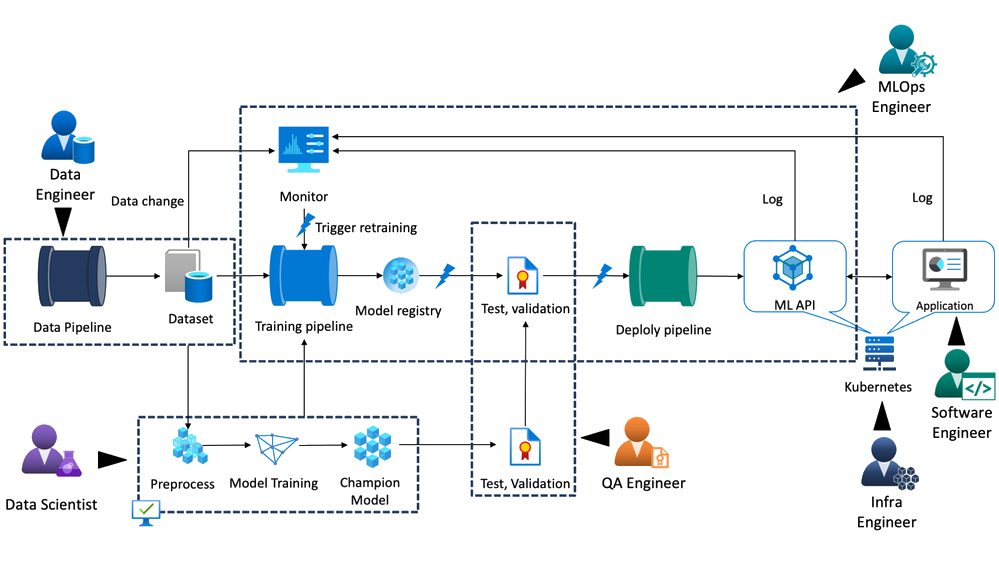
این سطح در سازمانی که در یک شبکهٔ پیوسته فعالیت میکند بالاترین کارکرد و امنیت را ارائه میدهد، اما همانگونه که در تصویر دیده میشود، نیروی انسانی هنوز در بخشهای مختلف بهعنوان ناظر و مداخلهکننده حضور دارد. برای دادههای سری و فوقمحرمانه همین حضور نیازمند بازنگری است.
تفکیک محیط توسعه و تولید
در برداشت دوم از سطح چهار، مرز مشخصی میان توسعه و تولید ایجاد میشود. با خودکارسازی کامل فرآیندهای تولید، نقش انسان به ناظر کاهش مییابد. دادهٔ محرمانه از دادهٔ عمومی جداست و خط لولهٔ آموزش اصلی در محیط تولید و امن قرار میگیرد. تیم توسعه با دادهٔ عمومی، مصنوعی یا بینامشده کار میکند و اجازهٔ دسترسی مستقیم به دادهٔ محرمانه ندارد.
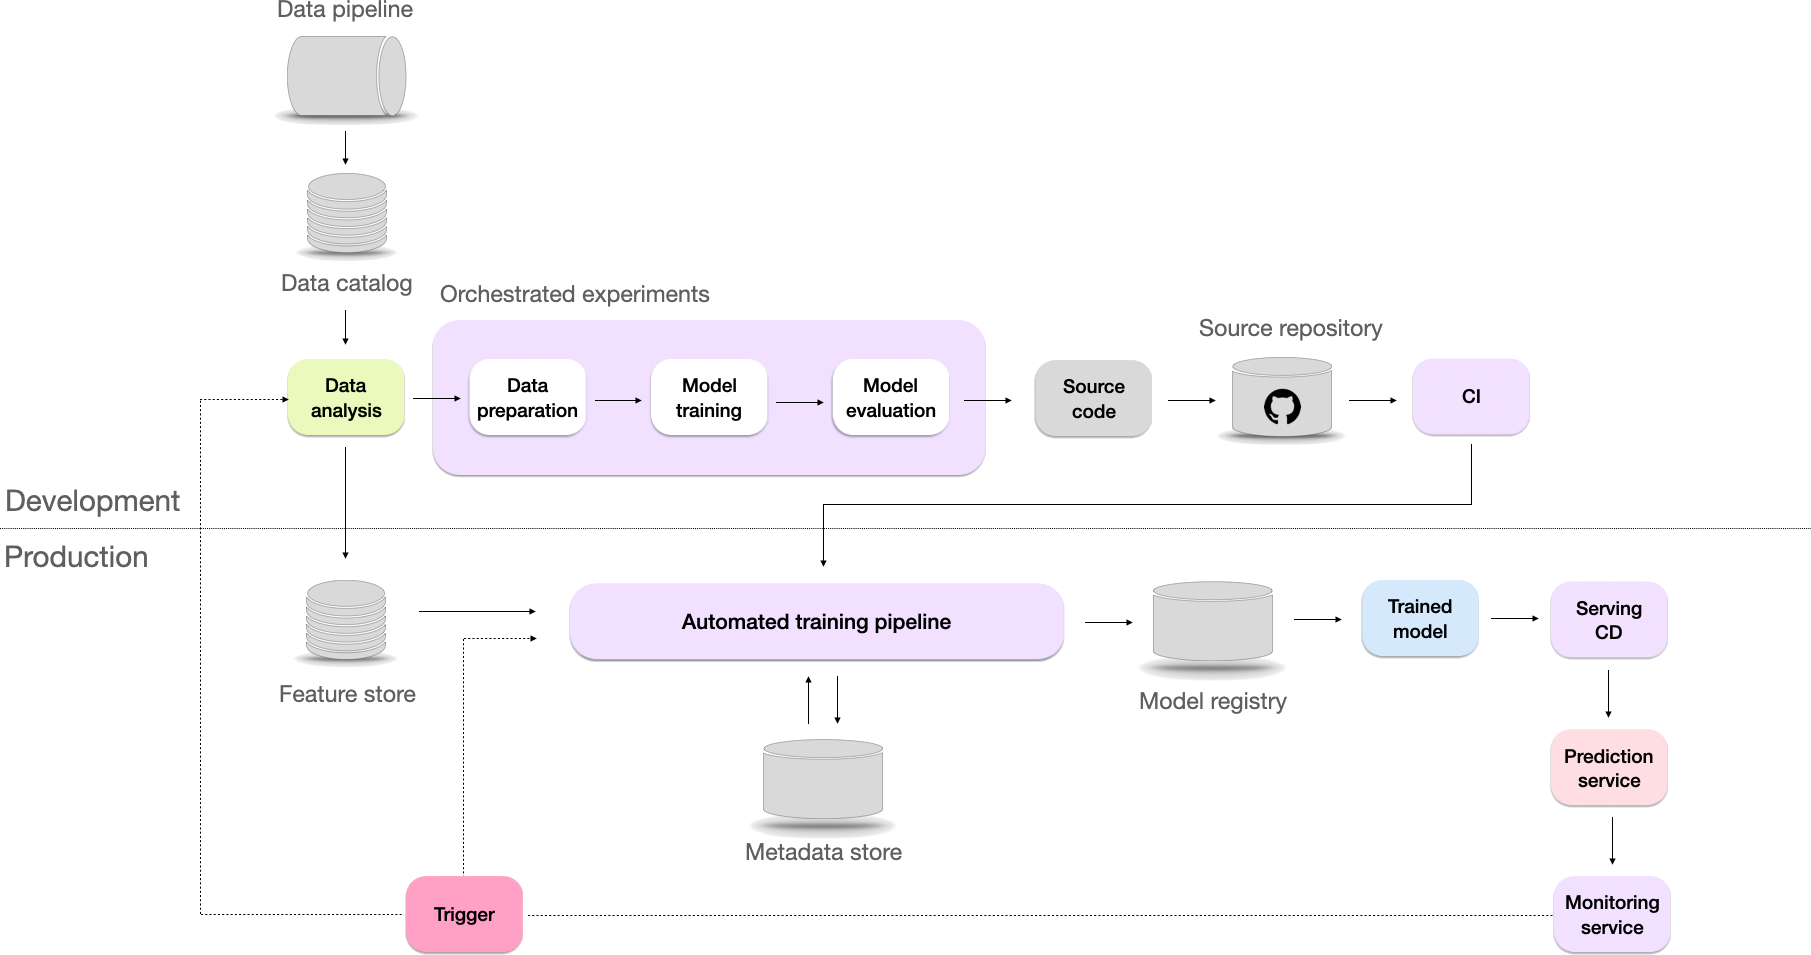
در این معماری چهار مرز حیاتی برای وظایف هوش مصنوعی شکل میگیرد:
- خط لولهٔ داده: مهندس داده ورود داده و تعریف فرآیند تحلیل و آمادهسازی را مدیریت میکند، اما اجرای فرآیند در مرز کنترلشده انجام میشود.
- خط لولهٔ آموزش: دانشمند داده فرآیند و پارامترهای آموزش را تعریف میکند، اما آموزش خودکار است و خروجی به رجیستری مدل وارد میشود. سامانهٔ مانیتورینگ عملکرد را پیوسته رصد میکند و در صورت تغییر داده میتواند بازآموزی را فعال کند.
- ارزیابی و اعتبارسنجی: مدل آموزشدیده بهصورت خودکار یا نیمهخودکار ارزیابی میشود. آزمونهای قطعهای و جعبهسیاه بخشی از همین مسیرند.
- خط لولهٔ استقرار: پس از تأیید مدل، استقرار بهصورت خودکار انجام میشود و مدل میتواند بهعنوان API روی زیرساخت عملیاتی منتشر شود. مهندس نرمافزار و زیرساخت برنامهٔ مصرفکنندهٔ این API را توسعه میدهند، نه اینکه مستقیماً در داده و آموزش دخالت کنند.
این چهار مرز نشاندهندهٔ یکپارچگی عمیق MLOps و اعتماد صفرند. تنها خروجی تأییدشده و منطبق با سیاست به محیط عملیاتی میرسد. انسان مدیر سیاست و ناظر فرآیند است و دخالت مستقیم او در دادهٔ حساس یا آموزش مدل میتواند حذف شود.
صورتبندی برای محیطهای با ماموریتهای حساس
در سازمانهای با ماموریت ویژه که دادهٔ سری و فوقمحرمانه دارند، اجرای کامل CI/CD/CT ممکن است به دلیل محدودیت شبکه یا هزینه دشوار باشد. در این حالت میتوان نسخهای سفارشیشده و تقلیلیافته از سطح چهار ساخت: تیم توسعه به دادهٔ محرمانه دسترسی ندارد و توسعه را با دادهٔ عمومی یا بینامشده انجام میدهد؛ آموزش نهایی روی دادهٔ محرمانه در محیط امن و ایزوله بهصورت خودکار اجرا میشود و حتی مدیر سامانه نیز دسترسی مستقیم به داده ندارد.
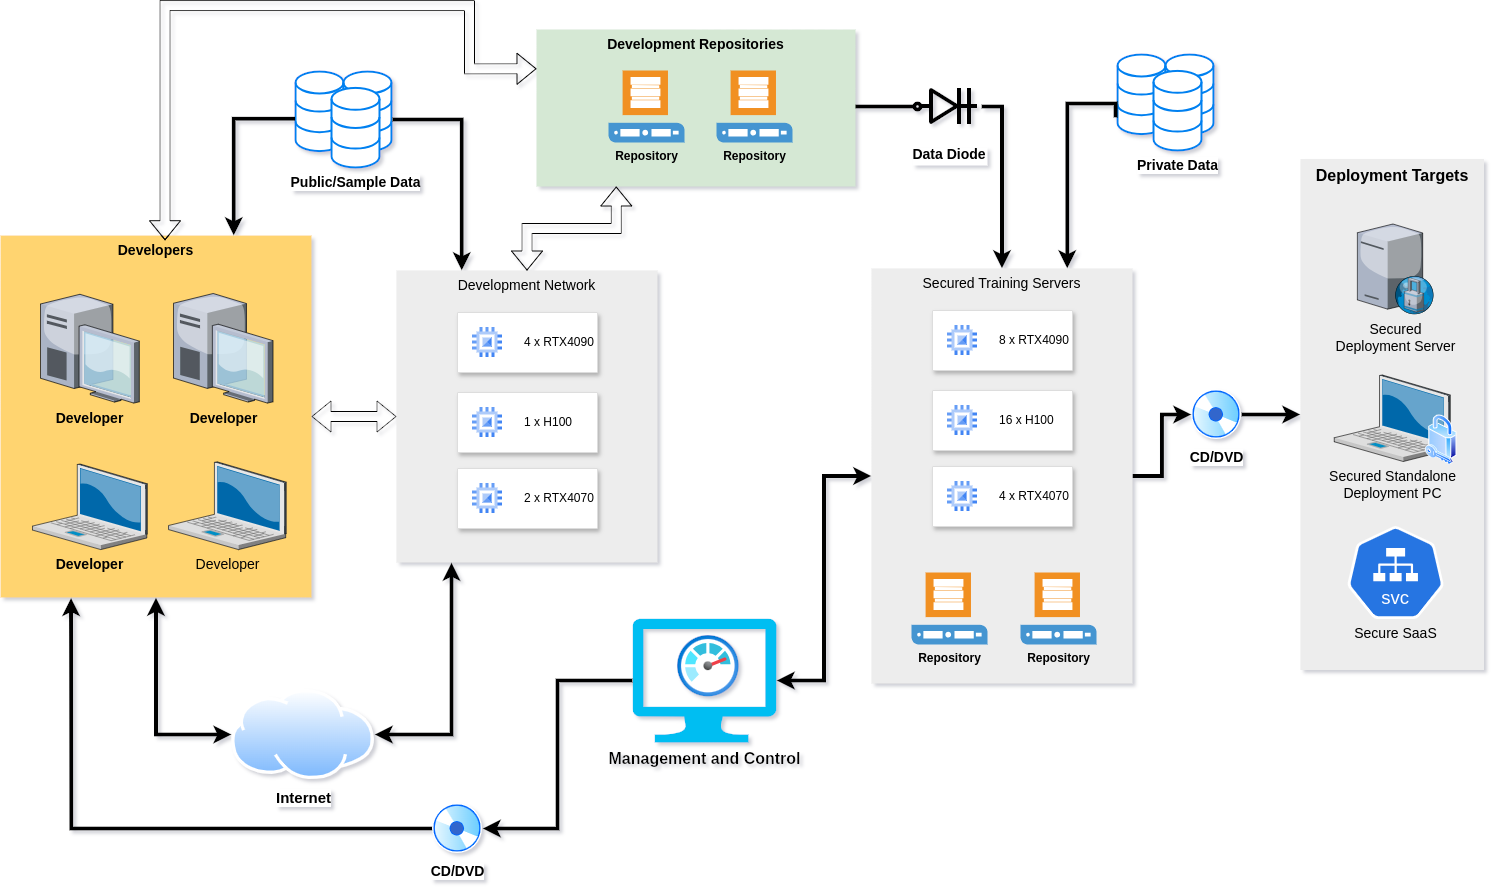
در این سطح، حذف انسان به معنی حذف مسئولیت انسانی نیست. انسان هنوز سیاست را تعریف میکند، فرآیند را میسازد، بر شواهد نظارت دارد و در استثناها مداخله میکند؛ آنچه حذف میشود دسترسی مستقیم و غیرضروری به دادهٔ خام و امکان دورزدن مسیر کنترلشده است.
مقایسهٔ سطوح بلوغ
| سطح | ویژگیهای کلیدی | فعالیتهای اصلی | چالش امنیتی و عملیاتی |
|---|---|---|---|
| صفر؛ دستی و پراکنده | تیمهای ایزوله و استقرار کاملاً دستی | گردآوری دستی داده، محاسبهٔ مدیریتنشده و مدل بهشکل فایل | بازتولید دشوار، نشت بالا، نبود حکمرانی داده و مقیاسپذیری |
| یک؛ پایهای | گردآوری خودکار داده و نسخهگذاری اولیه | انتشار دستی و آزمایش کیفی پیش از استقرار | تضمین کیفیت عمدتاً برای نرمافزار، نشت بالا و مشکل اشتراک GPU |
| دو؛ مدیریت و ردیابی | پردازش مدیریتشده و نسخهگذاری همهٔ اجزا | ذخیرهٔ نتیجهٔ ارزیابی و تحویل خودکار مدل | انتشار همچنان دستی، حکمرانی ناکامل و استقرار محدود |
| سه؛ CI/CD | همکاری مستقیم سه تیم و ارزیابی نیمهخودکار | انتشار خودکار و آزمون برای هر مدل | فرآیند یکطرفه، بازخورد ناکامل و باقیماندن امکان نشت |
| چهار؛ خودکارسازی کامل | نقش انسان به ناظر و مدیر فرآیند تقلیل مییابد | CI/CD/CT، بازآموزی و ارزیابی خودکار | نیاز به تفکیک بیشتر برای دادهٔ فوقمحرمانه و هزینهٔ اجرای کامل |
مدل بلوغ قرار نیست به سازمان یک برچسب تزئینی بدهد. کارکرد آن این است که نشان دهد کدام کنترل در وضعیت فعلی واقعاً قابل اجراست و گام بعدی چیست. اصولی مانند کمترین دسترسی یا راستیآزمایی مستمر، بدون نسخهگذاری و مسیر خودکار در سطح شعار میمانند. اصول و کنترلهای عملی ZTAI توضیح میدهد این بلوغ باید در امنیت داده، مدل، زیرساخت و خروجی چگونه مصرف شود.