Una organización no puede pasar de cuadernos dispersos y conjuntos de datos copiados manualmente a un ciclo de vida de IA controlado en un solo paso. Primero necesita saber cómo se construyen y publican sus modelos; después, hacer repetible ese proceso; y finalmente, aplicar restricciones sobre quién puede utilizar información sensible en cada etapa.
El modelo siguiente describe esta progresión mediante cinco niveles, del 0 al 4. Su base operativa es MLOps. El objetivo adicional de ZTAI es rediseñar el procesamiento rutinario para que las personas puedan definir una tarea y evaluar sus resultados sin tener que ver, mover o manipular repetidamente datos sensibles en bruto.
Esta es la interpretación arquitectónica utilizada en la colección. Se apoya en la progresión por etapas del modelo de madurez de confianza cero de CISA y en el modelo de madurez MLOps de Microsoft. Los cinco niveles de ZTAI que se presentan aquí no constituyen una escala oficial de CISA ni un esquema de certificación. En particular, las restricciones de acceso a datos propuestas en el nivel 4 son un objetivo adicional de diseño de seguridad, no una garantía derivada de una calificación de madurez MLOps.
Los niveles 0 a 3 establecen un control operativo progresivamente mejor. Son bases útiles para la confianza cero, pero ninguno demuestra que el sistema ya la aplique. Una organización también puede reunir capacidades de varios niveles a la vez: entrenamiento automatizado en un equipo, despliegue manual en otro y una vía de mantenimiento sin control que atraviesa ambos.
Nivel 0: trabajo manual y aislado
En el nivel 0, científicos de datos, ingenieros de datos e ingenieros de software trabajan en gran medida por separado. La colaboración consiste en intercambiar archivos e instrucciones. No existe un proceso compartido y fiable que conecte la preparación de datos con la aplicación en producción.
Los datos se recopilan manualmente y el entorno de cómputo puede ser una estación de trabajo o un servidor sin gestión centralizada. Los experimentos no se registran de forma sistemática. Un experimento satisfactorio produce un archivo de modelo, a menudo sin un registro completo de sus datos, parámetros, dependencias y entorno.
La publicación también es manual. El script de inferencia puede escribirse después de experimentar y quedar fuera del control de versiones. Una sola persona puede acabar decidiendo si el modelo está listo, entregándolo y explicando cómo ejecutarlo. El equipo de la aplicación depende mucho de sus conocimientos.
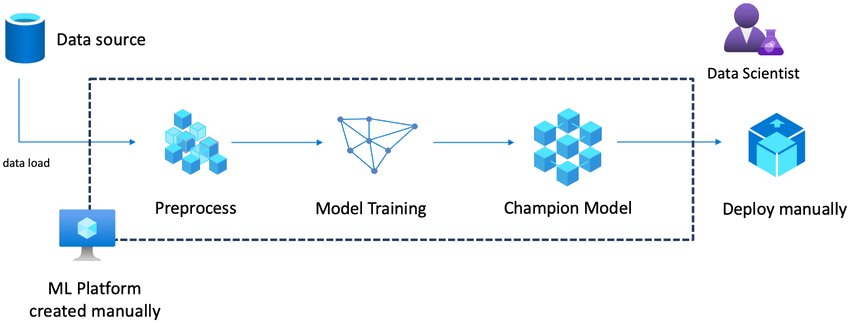
Reproducir resultados resulta difícil. La diversidad de herramientas y los ajustes sin documentar impiden comparaciones fiables, y los cambios de datos pueden confundirse con cambios de código. La información sensible puede dispersarse por entornos personales sin un registro claro. También es difícil coordinar las GPU compartidas y otros recursos escasos.
La mejora inmediata consiste en hacer visible el trabajo: versionar el código, registrar las entradas y los experimentos, definir una entrega repetible y establecer quién responde de la publicación. Añadir un producto de seguridad alrededor de un flujo sin documentar no aporta la evidencia que falta.
Nivel 1: mejora la entrega de software, pero el trabajo del modelo sigue separado
En el nivel 1 se automatizan partes de los procesos de datos y software. La recopilación puede seguir una canalización y el código se guarda en un repositorio. Los ingenieros de software reciben una entrega más clara del equipo de datos y pueden automatizar las compilaciones, las pruebas y el empaquetado de la aplicación.
El desarrollo del modelo sigue dependiendo de experimentos manuales y entornos parcialmente gestionados. La preparación de datos y el entrenamiento pueden no ser reproducibles a partir de una única especificación registrada. El equipo crea manualmente scripts de evaluación o inferencia, aunque ahora los versiona. Publicar un modelo nuevo todavía exige la intervención directa del equipo de datos.
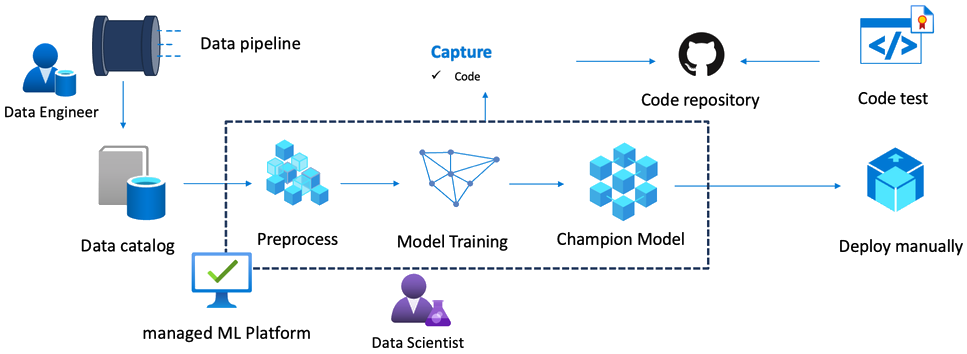
Esto reduce algunas dificultades de publicación, pero las pruebas de la aplicación no establecen la calidad del modelo. El software puede iniciarse correctamente y aceptar solicitudes mientras el modelo funciona mal con entradas reales. La retroalimentación de producción sigue siendo limitada, y el historial experimental puede no explicar por qué un modelo sustituyó a otro.
La seguridad continúa dependiendo de que las personas manejen los datos con cuidado. Las copias sin control, los permisos amplios y la asignación informal de GPU pueden persistir aunque las compilaciones estén automatizadas. El siguiente paso es incorporar el entrenamiento y su evidencia a un proceso gestionado.
Nivel 2: entrenamiento automatizado y trazable
En el nivel 2, los ingenieros y científicos de datos colaboran mediante una canalización de entrenamiento automatizada. La ingesta y el procesamiento se ejecutan en un entorno gestionado. Se registran parámetros, resultados y artefactos de los experimentos, y el registro de modelos proporciona una entrega estable al equipo de la aplicación.
El código, las referencias a los datos y las versiones del modelo y de la aplicación pueden relacionarse entre sí. Los resultados de evaluación se almacenan con el modelo, en vez de quedar en un documento aparte o en el cuaderno de una persona. Se puede reproducir un modelo con mucha mayor fiabilidad y seguir un cambio hasta sus entradas.
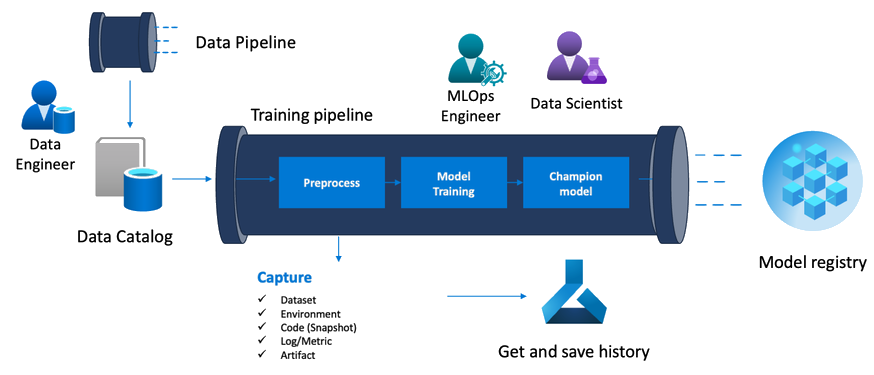
La publicación todavía puede ser manual. Los ingenieros de software pueden recibir el modelo a través de una interfaz fiable sin participar de cerca en su entrenamiento. Es una mejora respecto al intercambio de archivos, pero la conexión entre la evaluación del modelo y la calidad del producto completo puede seguir siendo débil.
Un entorno de entrenamiento bien gestionado tampoco resuelve todas las cuestiones de gobernanza. ¿Quién puede cambiar el código? ¿Quién puede inspeccionar los datos, descargar un punto de control o aprobar el despliegue? La planificación de recursos y el despliegue en varias máquinas pueden seguir requiriendo trabajo específico. La trazabilidad facilita responder a estas preguntas; no las responde automáticamente.
Nivel 3: despliegue automatizado del modelo
En el nivel 3, la ciencia de datos, la ingeniería de datos y la ingeniería de software forman parte de un proceso de entrega conectado. El entrenamiento utiliza datos y recursos gestionados, los experimentos y evaluaciones están versionados, y las publicaciones siguen una canalización de despliegue automatizada.
El modelo se empaqueta junto con su entorno y la evidencia necesaria para publicarlo. Las pruebas cubren el código y la integración del modelo, mientras que el aseguramiento de la calidad tiene un papel definido en la decisión de qué llega a producción. La evaluación puede combinar comprobaciones automáticas con revisión humana de los criterios que todavía no pueden evaluarse por máquina con fiabilidad.
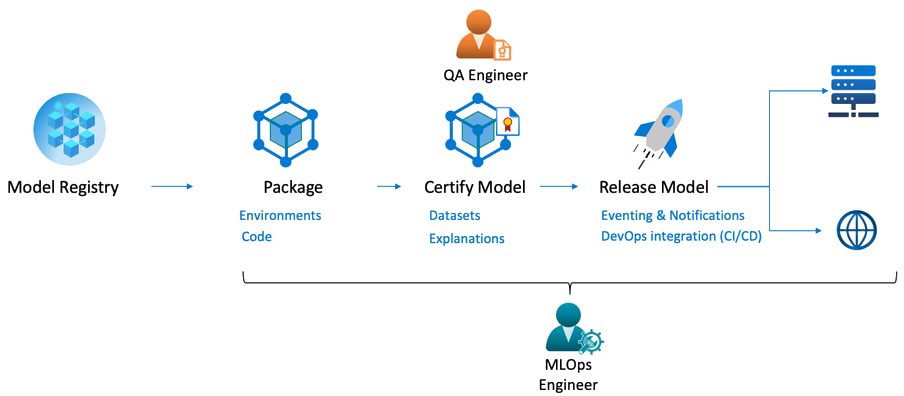
La organización puede seguir el modelo desplegado hasta el proceso que lo creó. También puede hacer explícitos los criterios de publicación y aplicarlos de forma coherente. Esto mejora la capacidad de investigar un fallo y volver a una versión anterior.
La carencia que suele quedar es el ciclo de retroalimentación. Un despliegue puede superar las pruebas sin ofrecer la experiencia de uso deseada, y la canalización puede no convertir todavía la evidencia de producción en un reemplazo validado. La entrega automatizada no garantiza continuidad del servicio, reparto eficiente de GPU ni confidencialidad. El acceso amplio de los administradores y los canales de salida permisivos pueden seguir intactos bajo un proceso de publicación eficiente.
Nivel 4: un ciclo conectado con límites efectivos
En el nivel 4, los datos, el entrenamiento, la evaluación, el despliegue y la supervisión forman un ciclo operativo conectado. Los cambios pertinentes pueden activar un nuevo entrenamiento. El modelo resultante pasa por validación y por la política de publicación antes de sustituir una versión de producción. La retroalimentación se registra y se utiliza para mejorar decisiones posteriores.
La integración, entrega y entrenamiento continuos —CI/CD/CT— sostienen este ciclo. Las pruebas unitarias, de integración y del comportamiento observable desde el exterior aportan evidencias distintas. La supervisión humana sigue siendo responsable de la finalidad del sistema, los criterios que debe cumplir y las excepciones que puede aceptar.
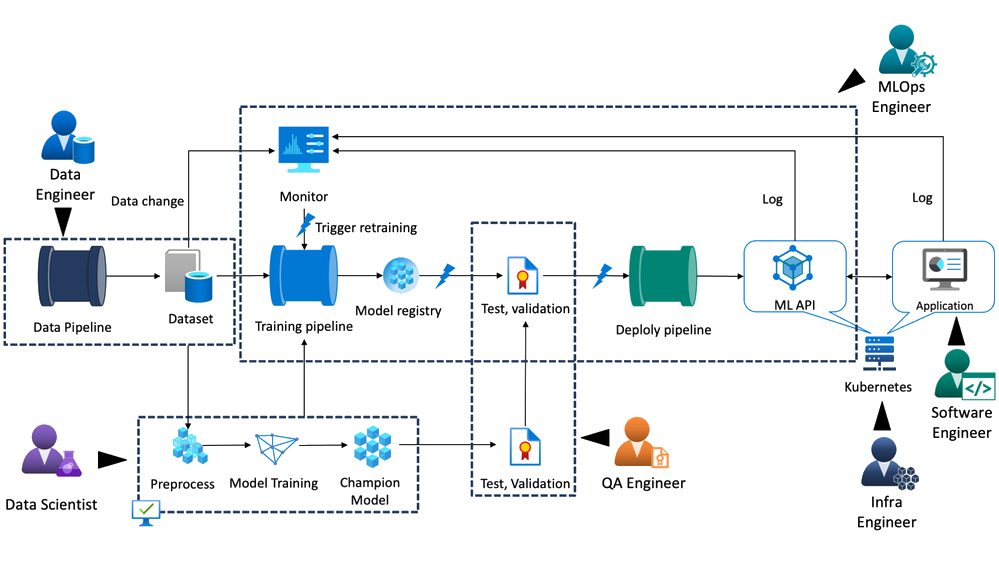
Para ZTAI, el paso adicional importante es eliminar el manejo humano innecesario de datos sensibles. Los desarrolladores definen y prueban un proceso; una ejecución aprobada utiliza los datos reales en un entorno controlado. La organización debe imponer esa separación, no limitarse a pedir que los desarrolladores eviten mirar los registros.
Se trata de un objetivo de diseño, no de una afirmación de seguridad máxima. Un trabajo automatizado puede filtrar información mediante registros, archivos del modelo o respuestas de API. Un administrador de infraestructura puede conservar la capacidad de inspeccionar memoria. Los controles necesarios para abordar estas vías se desarrollan en Si las personas no pueden ver los datos, ¿se ha eliminado realmente su acceso?.
Separar el desarrollo del procesamiento sensible en producción
Una disposición útil del nivel 4 proporciona a los desarrolladores datos públicos, sintéticos o debidamente desidentificados para el trabajo habitual. La canalización de producción utiliza datos sensibles en un entorno con gobernanza separada. Los conjuntos sintéticos y desidentificados también necesitan una evaluación del riesgo de divulgación; esas etiquetas no bastan para autorizar su entrega.
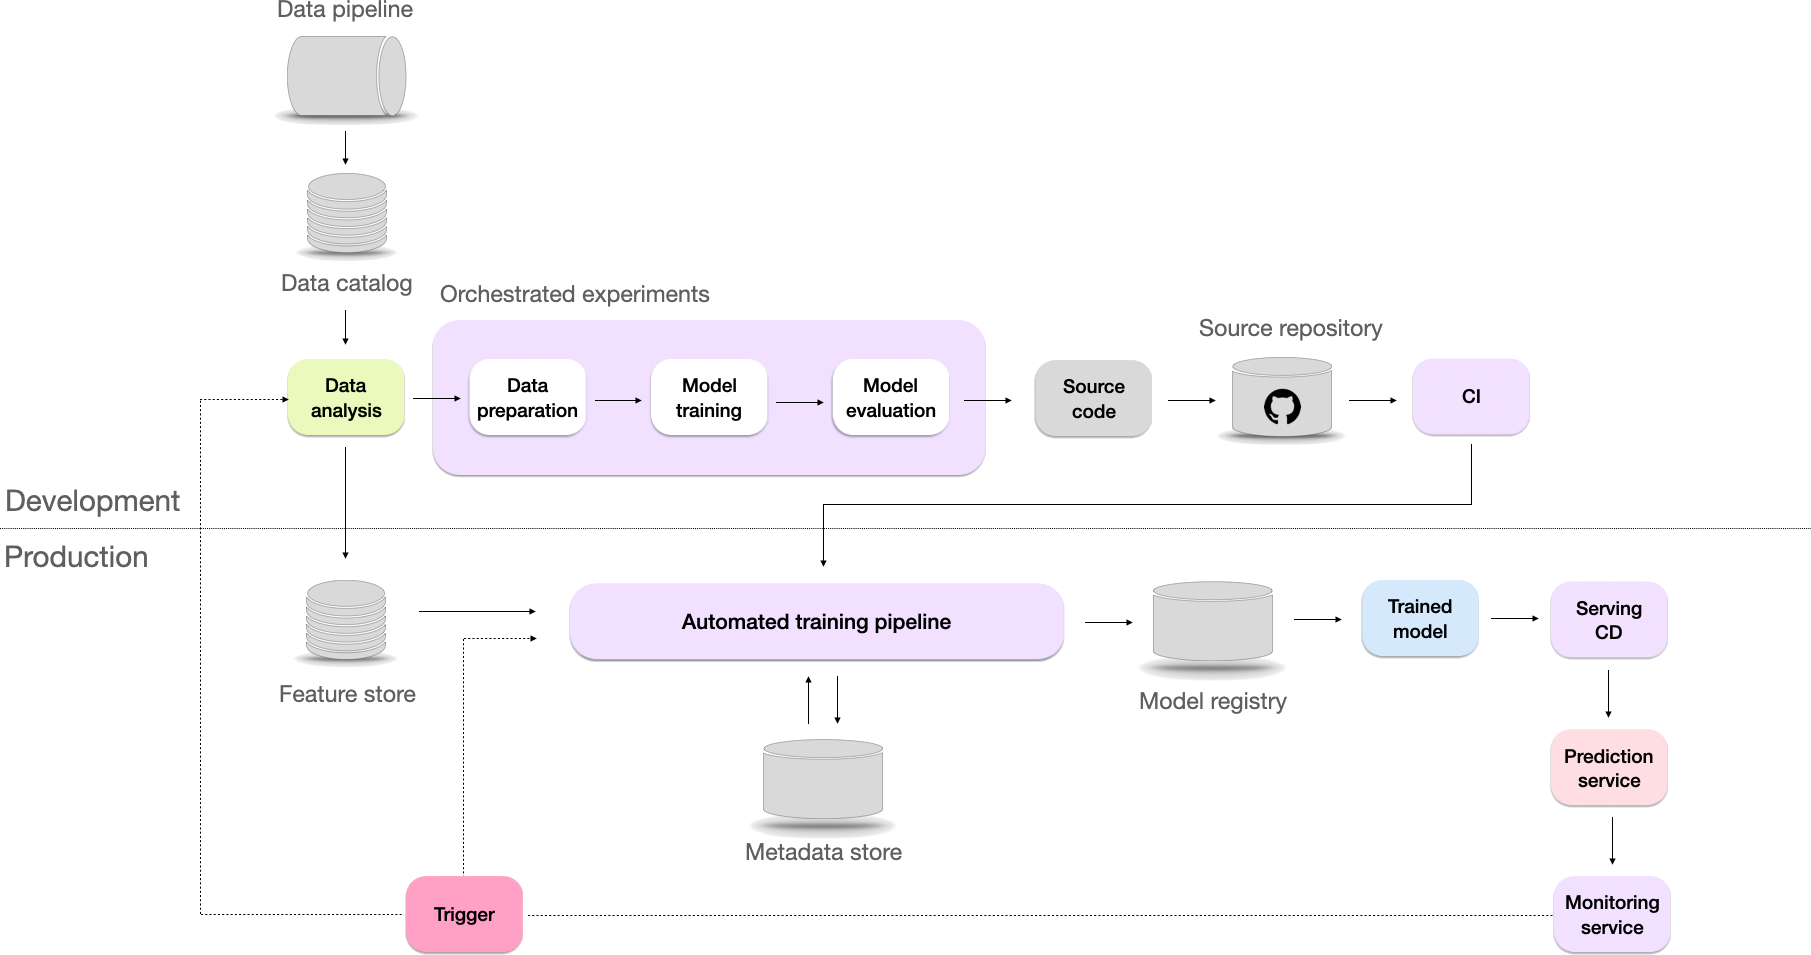
La separación puede organizarse en cuatro fronteras:
- Preparación de datos. Los desarrolladores definen las transformaciones. La ejecución aprobada recopila y prepara los datos reales bajo controles de acceso y procedencia.
- Entrenamiento. Una versión especificada del código y sus parámetros se ejecuta en un entorno autorizado. Los artefactos entran en un registro controlado y la supervisión documenta las condiciones que pueden justificar un reentrenamiento.
- Evaluación. Las comprobaciones automáticas y, cuando sea necesario, la revisión humana evalúan los resultados mediante interfaces aprobadas. La evaluación no se convierte en una vía irrestricta hacia muestras reales.
- Despliegue. Un modelo aceptado se expone mediante el servicio previsto. El equipo de la aplicación consume ese servicio sin recibir automáticamente los datos de entrenamiento o los archivos de pesos.
Estas fronteras están relacionadas. Una política que gobierna la entrada al entrenamiento, pero ignora el informe de evaluación o la descarga del modelo, deja abierta una vía de acceso indirecto. Los permisos de publicación deben aplicarse a todo resultado que alguien pueda recibir.
Una variante limitada para entornos aislados
Algunas cargas sensibles o de misión crítica no admiten una plataforma permanentemente conectada ni una pila completa de CI/CD/CT. Las restricciones de red, las condiciones operativas y el coste pueden exigir una solución más reducida: desarrollar con datos no sensibles, transferir una especificación de procesamiento aceptada a través de una frontera controlada y realizar el entrenamiento final dentro de un entorno aislado.
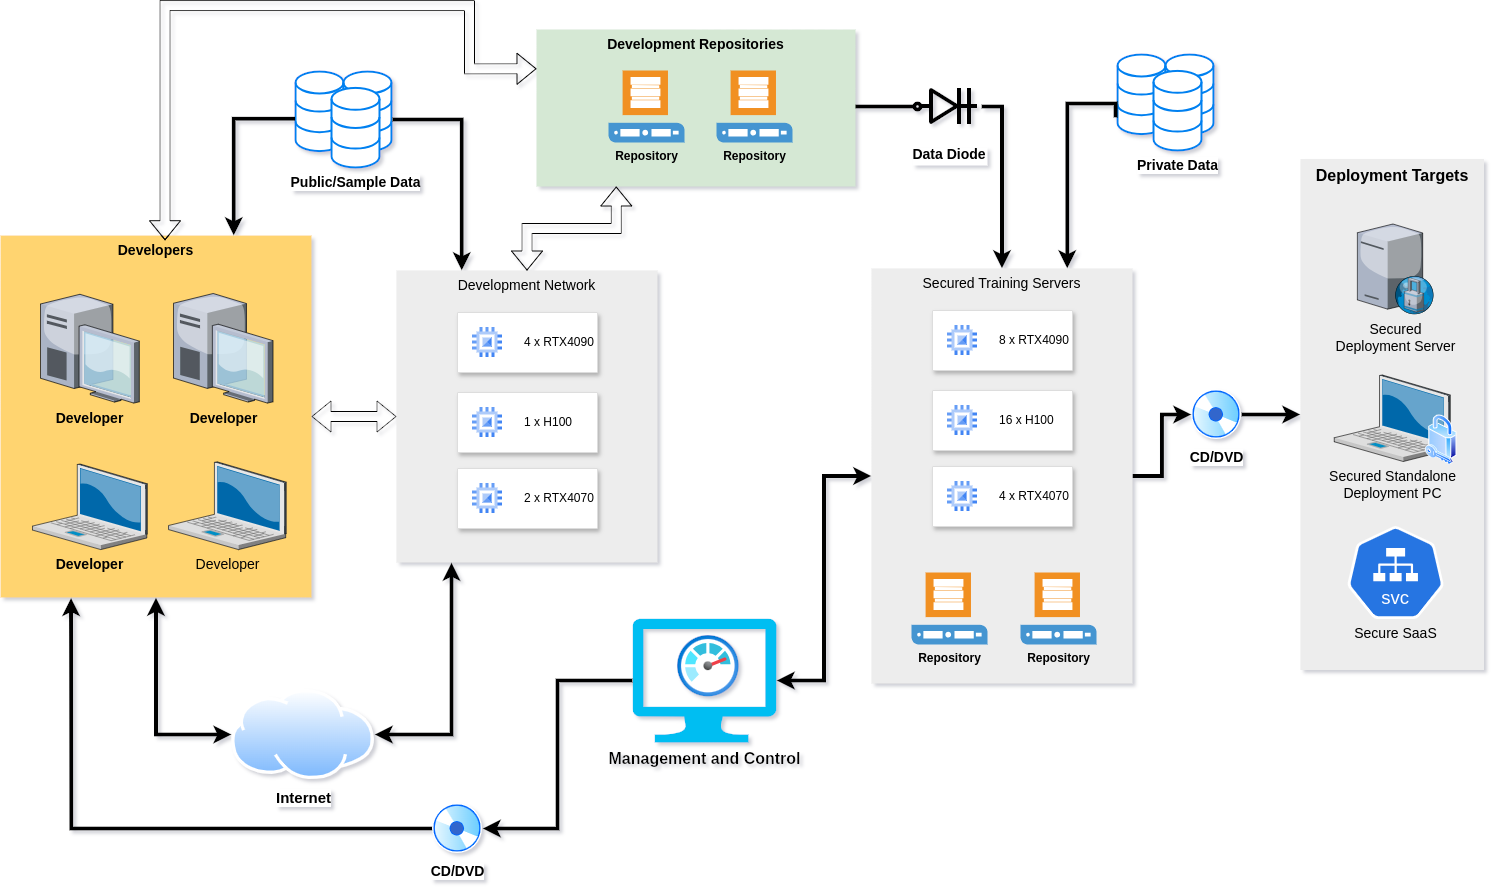
El objetivo arquitectónico puede mantenerse con menos automatización. El desarrollo rutinario no debería exigir que el conjunto sensible abandone su entorno protegido. Sin embargo, el aislamiento, un mecanismo de transferencia unidireccional o un trabajo automatizado no protegen por sí solos los datos en claro frente a cualquier administrador privilegiado. El diseño debe declarar en qué administradores confía, qué permiten sus privilegios y qué evidencia respalda una afirmación más fuerte.
La misma disciplina se aplica al mantenimiento. Si cada fallo difícil exige exportar un volcado de memoria o conceder acceso sin restricciones, la separación desaparecerá en la práctica. Las herramientas de desarrollo, diagnóstico y recuperación forman parte de la arquitectura de seguridad.
Comparación de los niveles
| Nivel | Capacidad principal | Actividades habituales | Cuestiones pendientes |
|---|---|---|---|
| 0 | Trabajo manual y aislado | Experimentos individuales y entregas mediante archivos | Poca reproducibilidad, responsabilidades imprecisas, copias y recursos sin control |
| 1 | Prácticas de entrega de software | Código versionado, pruebas de aplicación y publicaciones más organizadas | Desarrollo y retroalimentación del modelo dependientes de personas |
| 2 | Entrenamiento automatizado | Entornos gestionados, seguimiento de experimentos y registro de modelos | Publicación manual, retroalimentación incompleta del producto y políticas de acceso sin resolver |
| 3 | Despliegue automatizado | Equipos conectados, pruebas de publicación y promoción trazable | Retroalimentación, continuidad y confidencialidad necesitan diseño explícito |
| 4 | Ciclo conectado con un objetivo de separación ZTAI | CI/CD/CT controlado, retroalimentación supervisada y separación entre desarrollo y procesamiento sensible | Hay que aplicar y auditar controles sobre acceso indirecto, privilegios administrativos, publicación de resultados y excepciones |
La responsabilidad humana no desaparece al aumentar el nivel. Las personas siguen decidiendo para qué sirve el sistema, qué riesgos son aceptables y cuándo debe detenerse. El objetivo es reducir el contacto innecesario con datos en bruto y hacer más claras las decisiones y sus responsables.
Utilice el modelo para identificar la siguiente capacidad que falta en un flujo de trabajo real. Una etiqueta de nivel superior aporta menos que la evidencia de que una vía antes descontrolada ahora está gobernada. El siguiente artículo relaciona ese trabajo con los principios y controles prácticos de ZTAI; la página de la colección reúne toda la secuencia.