هوش مصنوعی بدون اعتماد فقط مجموعهای از ابزارهای امنیتی در اطراف مدل نیست. اگر داده، کد، آزمایش، مدل و استقرار در یک فرآیند قابل ردیابی و کنترل قرار نگیرند، راستیآزمایی مستمر نیز در حد یک اصل نظری باقی میماند. MLOps بستری است که این اصول را در چرخهٔ حیات واقعی هوش مصنوعی قابل اجرا میکند.
MLOps یا عملیات یادگیری ماشین، رویکردی مهندسی و مجموعهای از شیوهها برای پیادهسازی و نگهداری قابل اعتماد و کارآمد مدلهای یادگیری ماشین در محیط عملیاتی است. این رویکرد میان علم داده، عملیات توسعه و مهندسی نرمافزار پل میزند تا چرخهٔ حیات مدل از آغاز تا پایان مدیریت شود.
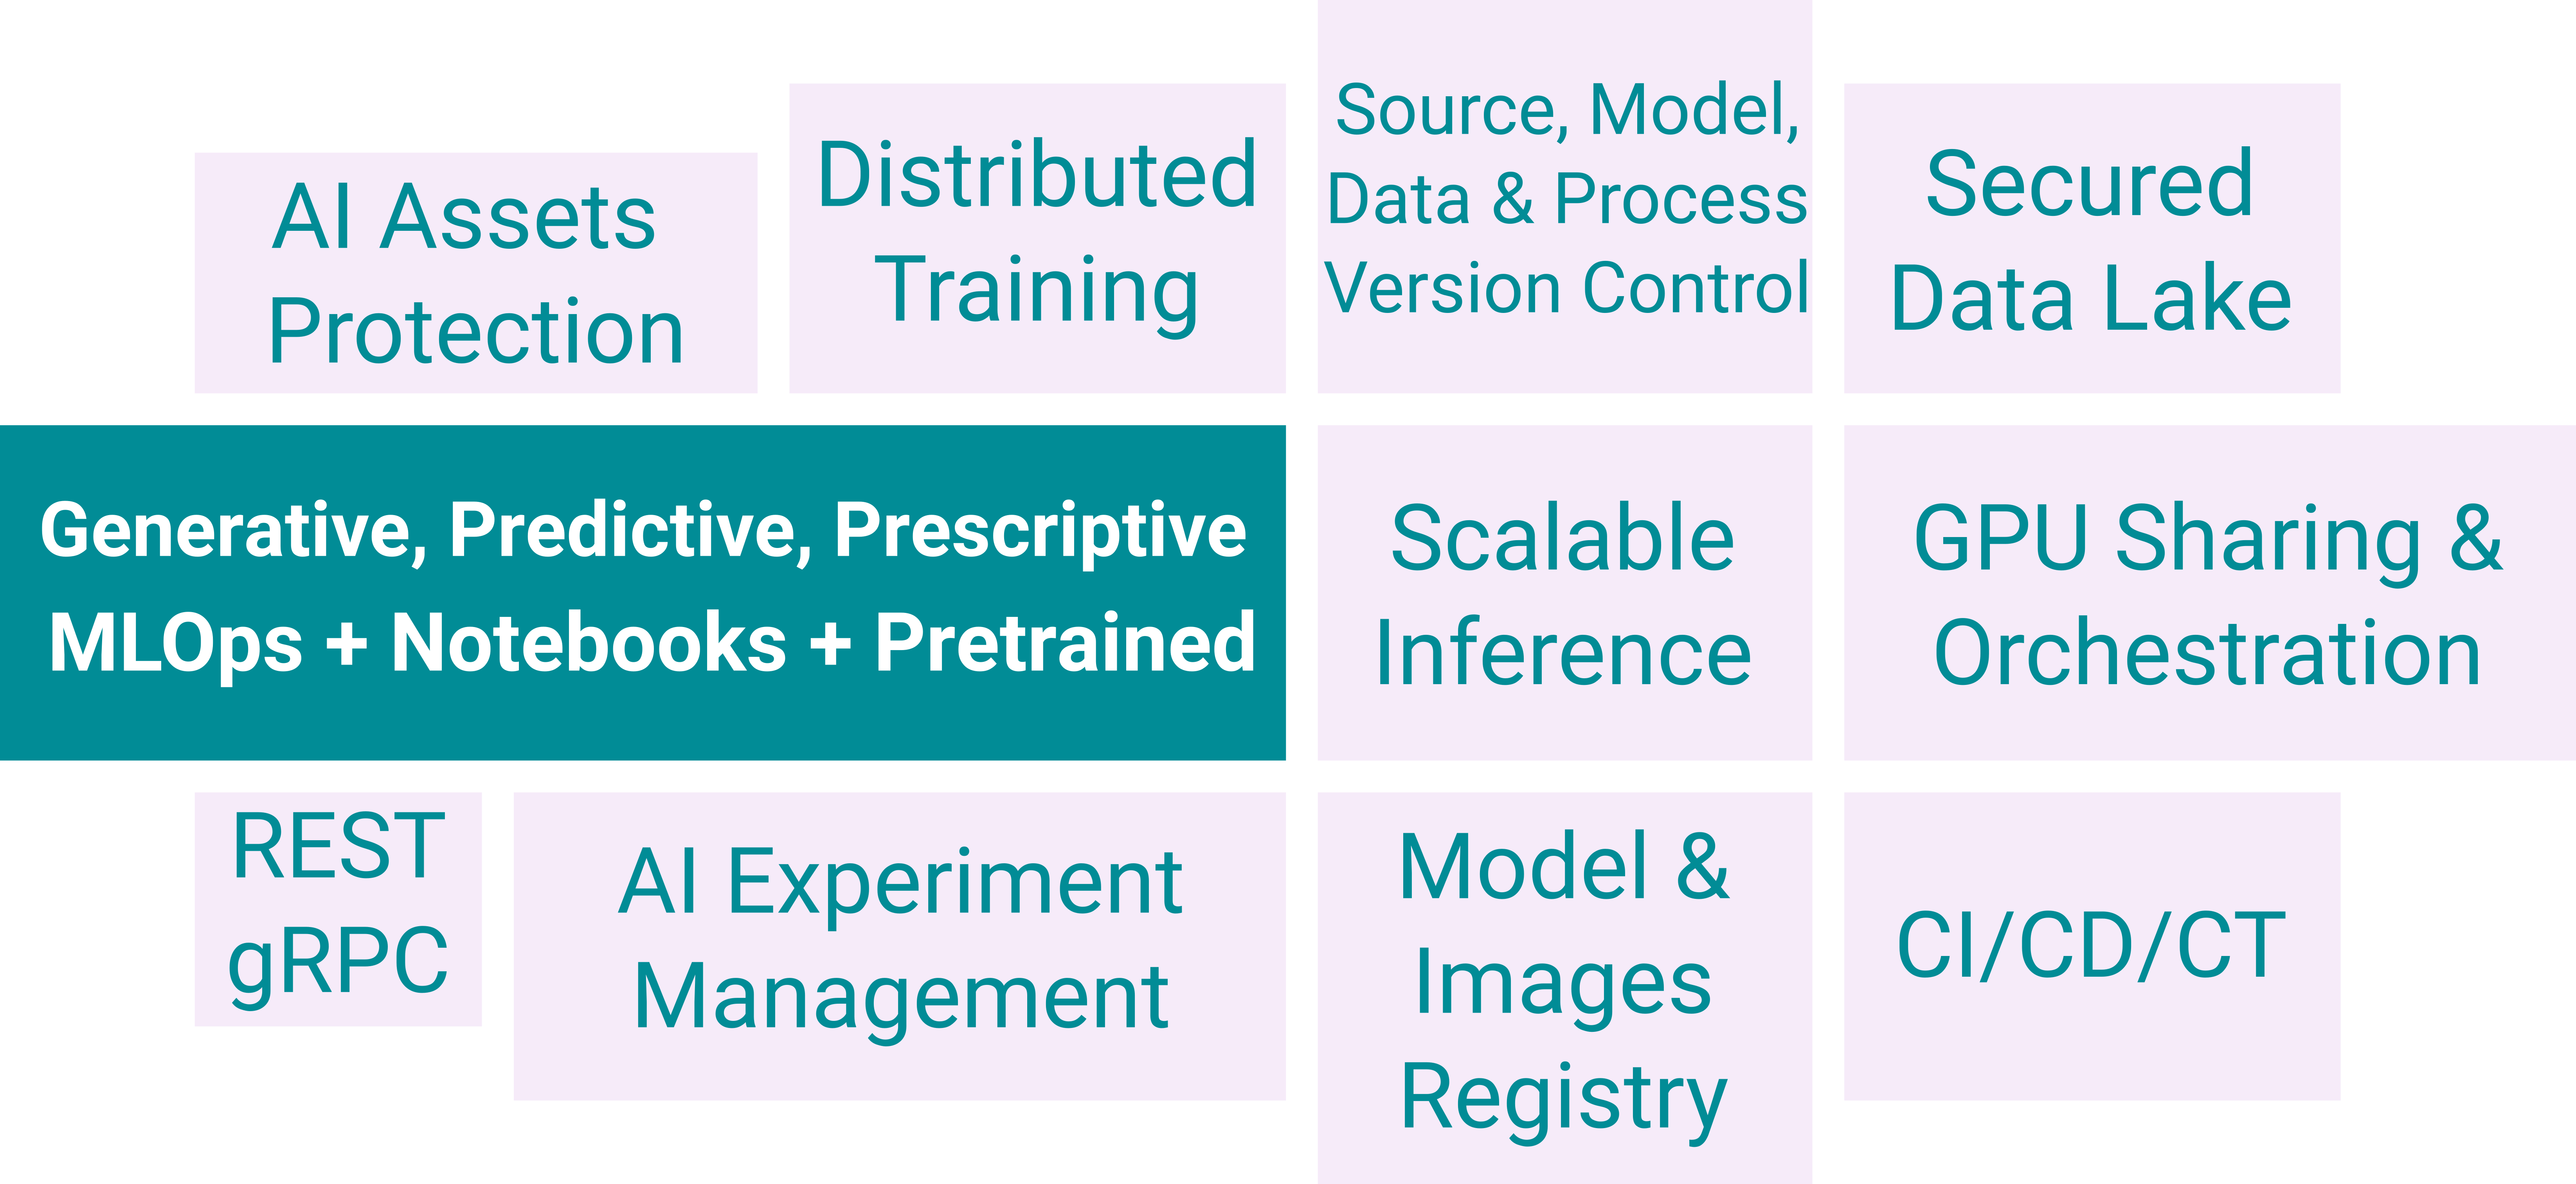
رابطهٔ MLOps و DevOps
DevOps بر خودکارسازی، نظارت و مدیریت چرخهٔ حیات توسعهٔ نرمافزار، از کدنویسی و ساخت تا آزمایش، انتشار، استقرار و نظارت تمرکز دارد. MLOps این اصول را به مراحل خاص توسعه و استقرار مدل هوش مصنوعی گسترش میدهد: جمعآوری و کاوش داده، آمادهسازی، آموزش، ارزیابی، استقرار، عملیات و نظارت.
هدف مشترک در هر دو، تسریع تحویل، افزایش کیفیت و تضمین پایداری محیط عملیاتی است. تفاوت در آن است که MLOps چالشهایی را نیز در نظر میگیرد که در نرمافزار متعارف یا وجود ندارند یا به این شدت نیستند؛ از جمله وابستگی رفتار مدل به داده، نیاز به بازآموزی و مدیریت مصنوعات مدل.
چرا MLOps حیاتی است؟
نخستین اثر MLOps، کاهش فاصلهٔ تحقیق تا تولید است. خودکارسازی فرآیندها زمان انتقال مدل از آزمایش به محیط عملیاتی را کم میکند و سازمان میتواند سریعتر به تغییر نیاز یا شرایط پاسخ دهد. این سرعت فقط وقتی ارزش دارد که با قابلیت اطمینان همراه باشد. استانداردسازی مراحل، خطای انسانی را کاهش میدهد و نظارت مداوم به تشخیص زودهنگام مشکل کمک میکند.
اثر دوم، مقیاسپذیری است. سازمان بدون فرآیند مشترک نمیتواند تعداد زیادی مدل را همزمان توسعه، مستقر و نگهداری کند. هر مدل به یک پروژهٔ دستی و وابسته به افراد تبدیل میشود. MLOps زیرساخت و فرآیندی میسازد که این چرخه را تکرارپذیر میکند.
اثر سوم، حکمرانی و انطباقپذیری است. تغییر داده، کد و مدل باید قابل ردیابی باشد. این ردیابی هم برای مقررات امنیت و حریم خصوصی و هم برای بررسی داخلی و خارجی حیاتی است. مدیریت چرخهٔ حیات نیز فقط تا لحظهٔ استقرار ادامه ندارد؛ جمعآوری و آمادهسازی داده، آموزش، اعتبارسنجی، استقرار و پایش عملکرد در محیط واقعی یک چرخهٔ مداوماند.
اجزای چرخهٔ MLOps
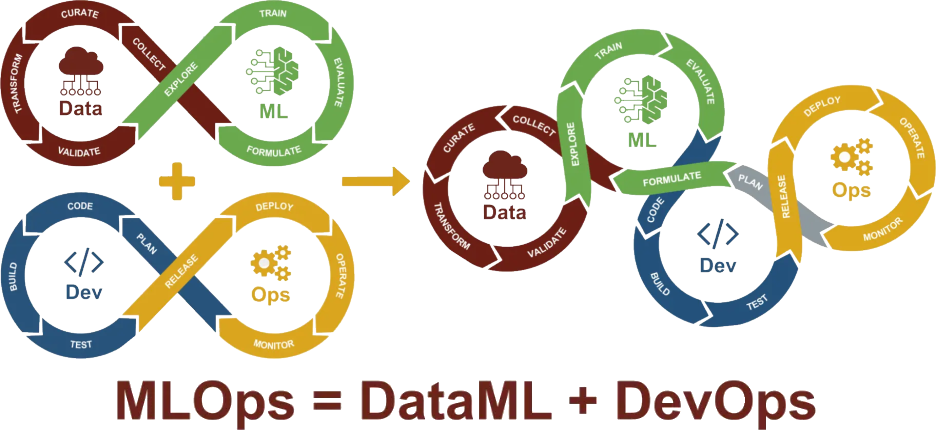
مدیریت داده، جمعآوری، پاکسازی، مهندسی ویژگی، نسخهسازی و کاتالوگ داده را در بر میگیرد. مدیریت کد و نسخه، تغییرات کد مدل، اسکریپتهای آموزش و پیکربندیها را دنبال میکند. آموزش و اعتبارسنجی نیز فرآیند آموزش، ارزیابی، تنظیم فراپارامتر و تأیید مدل را تا حد ممکن خودکار میکند.
مدل آموزشدیده بهتنهایی کافی نیست. مصنوعات مدل باید ذخیره، نسخهگذاری و سازماندهی شوند. استقرار مدل نیز باید انتشار آن را در محیطهای مختلف، از سرور و سرویس API تا محیط لبه، قابل کنترل کند. پس از استقرار، عملکرد مدل پیوسته پایش میشود تا انحراف داده، انحراف مدل و نیاز به بازآموزی تشخیص داده شود.
حلقهٔ بازخورد، دادهٔ تازهٔ محیط عملیاتی را به چرخه بازمیگرداند تا مدل دقت و کارایی خود را حفظ کند. امنیت و حکمرانی نیز یک مرحلهٔ جدا در انتهای خط نیست؛ سیاست دسترسی و الزامات انطباق باید در همهٔ مراحل اعمال شوند.
MLOps چگونه به ZTAI تبدیل میشود؟
MLOps بهخودیخود معادل هوش مصنوعی بدون اعتماد نیست. نقش آن فراهمکردن یک چرخهٔ ساختاریافته، خودکار و قابل مشاهده است که بتوان کنترلهای بدون اعتماد را در هر مرحلهٔ آن قرار داد. وقتی داده، کد، آزمایش، مدل و نتیجهٔ ارزیابی نسخهگذاری میشوند، میتوان دربارهٔ اصالت و یکپارچگی آنها تصمیم گرفت. وقتی انتشار مدل از مسیر مشخص انجام میشود، میتوان یک نقطهٔ اعمال سیاست داشت. وقتی عملکرد مدل و تغییر داده پایش میشود، راستیآزمایی از لحظهٔ ورود کاربر فراتر میرود و به تمام عمر سامانه گسترش مییابد.
این مسیر یکباره طی نمیشود. سازمان ممکن است از فرآیندهای دستی و پراکنده شروع کند و مرحلهبهمرحله به خودکارسازی، CI/CD و آموزش مستمر برسد. مدل بلوغ ZTAI از سطح صفر تا چهار این گذار را بهتفصیل توضیح میدهد و نشان میدهد چرا سطح چهار فقط «MLOps بهتر» نیست، بلکه به حذف دسترسی مستقیم انسان به دادههای حساس نزدیک میشود.