Del tiempo hasta el primer token a la velocidad de generación: cómo la memoria, la concurrencia y la comunicación determinan el rendimiento real de la inferencia
Un sistema de inferencia puede producir más tokens por segundo y, aun así, hacer que el usuario espere más para recibir una respuesta. Incluso puede empezar a escribir antes y terminar después. Estas diferencias no son contradicciones: surgen al medir cosas distintas bajo una misma etiqueta, «velocidad».
El artículo anterior, «INT8 o FP8: qué puede ejecutar realmente una GPU», examinaba por qué el rendimiento anunciado en las especificaciones del hardware no siempre está disponible en la vía real de ejecución del modelo. Aquí avanzamos un paso más: aunque el modelo utilice el kernel adecuado y la aceleración del hardware, la capacidad de cálculo de la tarjeta sigue sin permitir predecir el tiempo de respuesta del servicio.
Para elegir infraestructura hay que saber qué tiempo se pretende reducir, cuántas solicitudes simultáneas deben cumplir ese objetivo y cuánto costará conseguirlo. Este artículo, el segundo de esta secuencia dentro de la colección de selección de GPU e infraestructura de IA, estudia esa relación.
Cuando decimos «rápido», ¿qué estamos midiendo?
El usuario envía una solicitud, espera, ve la primera parte de la respuesta y después recibe el resto. Esa experiencia comprende al menos dos medidas temporales distintas: la espera hasta el inicio de la respuesta y los intervalos de producción de sus partes posteriores.
| Métrica | Definición operativa | Utilidad |
|---|---|---|
| TTFT: tiempo hasta el primer token | Intervalo entre el envío de la solicitud y la recepción del primer token de contenido | Medir la espera inicial |
| TPOT: tiempo por token de salida | Tiempo medio de producción de los tokens posteriores al primero | Medir el ritmo de continuación de la respuesta |
| ITL: latencia entre tokens | Intervalos de recepción durante el flujo de salida, teniendo en cuenta los tokens de cada fragmento | Detectar pausas y variaciones |
| Tasa de tokens por usuario | Número de tokens posteriores al primero, dividido entre el tiempo empleado en recibirlos | Medir la velocidad de generación de una solicitud |
| Rendimiento total de salida | Total de tokens de salida en el intervalo de medición, dividido entre su duración | Medir la capacidad total del servicio |
| Latencia de extremo a extremo | Intervalo entre el envío de la solicitud y la recepción del último token | Medir el tiempo hasta completar la respuesta |
Esta distinción es coherente con las herramientas de evaluación de inferencia, pero los resultados deben ir acompañados de las definiciones precisas de cada herramienta. Algunas miden el intervalo entre fragmentos de respuesta, y cada fragmento puede contener varios tokens. Documentación de métricas de GenAI-Perf
En este artículo, sean el instante de envío de la solicitud, la llegada del primer token, la llegada del último y el número de tokens de salida:
Para esta solicitud y esta convención de medición, la tasa de generación por usuario es, por tanto, el inverso del TPOT. Sin embargo, el inverso del TPOT medio de varias solicitudes no tiene por qué coincidir con la media de sus tasas de generación.
El TTFT medido en el cliente tampoco es solo tiempo de ejecución de la GPU: incluye las colas, la red y el procesamiento de la solicitud. En modelos de razonamiento, el primer token de razonamiento puede llegar mucho antes que la primera parte de la respuesta final. AIPerf dispone de una métrica independiente de «tiempo hasta el primer token de salida que no sea de razonamiento» para distinguirlos. Definición de métricas de AIPerf
Por ello, «una respuesta en medio segundo» es una descripción incompleta si no se especifica dónde termina la medición.
Empezar antes no garantiza terminar antes
Consideremos dos configuraciones hipotéticas:
| Configuración | TTFT | TPOT | Tasa de generación después del primer token | Final de una respuesta de 101 tokens | Final de una respuesta de 1001 tokens |
|---|---|---|---|---|---|
| A | 0,4 s | 40 ms | 25 tokens/s | 4,4 s | 40,4 s |
| B | 1 s | 20 ms | 50 tokens/s | 3 s | 21 s |
Las cifras son ilustrativas y no corresponden a un hardware concreto. Se supone que las longitudes de salida son iguales y que los TPOT indicados se mantienen en ambas longitudes. El tiempo hasta completar la respuesta se calcula así:
La configuración A empieza antes; la B termina antes las respuestas largas. En este ejemplo, ambas terminan al mismo tiempo una salida de 31 tokens; a partir de ahí, B se adelanta.
Esta diferencia importa al definir los requisitos. Para mostrar una respuesta corta, la espera inicial puede ser el problema principal. Al generar un informe o encadenar llamadas dependientes, cobra más importancia el tiempo de finalización. En un sistema basado en agentes también deben mantenerse en el cálculo el número de pasos, la longitud de salida de cada uno y el tiempo de las herramientas. Acelerar la generación de tokens no reduce la duración de todos los componentes del proceso.
La inferencia no es una carga de trabajo uniforme
En la ejecución habitual de un modelo de lenguaje autorregresivo, prefill procesa la entrada y almacena las claves y los valores de las capas de atención en la caché KV. El resultado de ese procesamiento también se utiliza para seleccionar el primer token. Después, decode continúa la generación utilizando el estado anterior y amplía la caché KV.
Durante prefill, muchos tokens de entrada pueden participar en los cálculos matriciales. En decode convencional, cada solicitud avanza un token por paso, por lo que cambia la oportunidad de utilizar simultáneamente las unidades de cálculo. Decode con lotes pequeños puede ser sensible a la lectura de los pesos y de la caché KV, mientras que un prefill largo suele ofrecer más posibilidades de aprovechar la capacidad de cálculo. Es una tendencia: la longitud del contexto, la arquitectura del modelo, el tamaño del lote y el método de ejecución pueden cambiar el cuello de botella. Análisis de inferencia de transformers en How To Scale Your Model
Por tanto, un buen resultado al procesar entradas largas no implica necesariamente una generación más rápida para un usuario. Una prueba que solo informe de la suma de tokens de entrada y salida también puede mostrar una cifra mayor al aumentar la entrada, sin acelerar la continuación de la respuesta para el usuario.
La memoria no es solo el lugar donde cabe el modelo
Al evaluar la memoria hay que separar tres preguntas: ¿caben los datos?, ¿a qué velocidad pueden leerse? y ¿cuánto tarda el acceso al dato necesario?
Una capacidad mayor puede permitir alojar el modelo, un contexto más largo o más solicitudes activas. Pero esa capacidad, por sí sola, no reduce el tiempo de lectura de los pesos. El ancho de banda describe una tasa de transferencia y no equivale a la latencia de acceso.
Para una operación, una primera aproximación es:
Aquí, es el número de operaciones de cálculo, la tasa de cálculo, el volumen de datos intercambiado con el nivel de memoria examinado y el ancho de banda de ese nivel. La aproximación supone que cálculo y transferencia pueden solaparse; la sobrecarga de ejecución y la falta de paralelismo pueden aumentar el tiempo. Guía oficial de NVIDIA sobre limitaciones de cálculo, memoria y latencia
Si la lectura de datos domina la ruta crítica, duplicar el rendimiento de multiplicación matricial no reduce necesariamente a la mitad el tiempo de la operación.
Por ejemplo, supongamos que un paso de decode necesita leer exactamente 70 GB de memoria y que el ancho de banda efectivo es de 2 TB/s. Con unidades decimales, el límite inferior de esa lectura es de 35 milisegundos:
Este cálculo no predice la velocidad de un modelo de 70 000 millones de parámetros. Parte de una hipótesis concreta sobre el volumen real leído en cada paso y no contabiliza por separado la atención, la comunicación ni las sobrecargas. Su utilidad consiste en mostrar un límite que el aumento de FLOPS, por sí solo, no elimina.
La caché KV también debe incluirse en el presupuesto de memoria. En la atención convencional sobre todo el contexto, su demanda crece con la longitud de la secuencia y el número de solicitudes activas. Cuantizar la caché o trasladarla a la memoria del anfitrión puede reducir el consumo de memoria de la GPU, pero tiene sus propios efectos sobre el rendimiento; también importan el tipo de atención y la estrategia de caché. Guía de estrategias de caché KV en Transformers
Que los pesos quepan no demuestra la capacidad de atender solicitudes.
¿Por qué una mayor capacidad total puede ralentizar a cada usuario?
Ejecutar varias solicitudes en un lote puede mejorar el aprovechamiento de los pesos y los recursos de cálculo. Sin embargo, el objetivo del sistema puede ser maximizar la salida conjunta, aunque aumente el intervalo entre tokens de cada solicitud.
Para aclarar la diferencia, consideremos un intervalo estable y totalmente hipotético en el que todas las solicitudes están en decode:
| Caso | Solicitudes activas en decode | Tasa por solicitud | Tasa total de salida |
|---|---|---|---|
| A | 20 | 80 tokens/s | 1600 tokens/s |
| B | 100 | 30 tokens/s | 3000 tokens/s |
El caso B produce aproximadamente 1,9 veces más tokens en total, pero cada usuario del caso A recibe la salida unas 2,7 veces más rápido. La tabla muestra la aritmética de una situación hipotética; no establece una ley sobre cómo cambia la velocidad al aumentar la concurrencia.
En un servicio real, las solicitudes entran y salen continuamente y tienen longitudes distintas. La planificación también importa. Por ejemplo, la documentación de vLLM explica que chunked prefill divide las entradas largas en fragmentos pequeños y los planifica junto con decode. Cambiar el presupuesto de tokens de esa planificación puede alterar el equilibrio entre TTFT y latencia entre tokens. Documentación de optimización de vLLM
Así, dos pruebas con el mismo hardware y modelo, pero con políticas de planificación diferentes, pueden ofrecer experiencias de usuario distintas.
LPX: repartir el trabajo incluso dentro de decode
En la arquitectura anunciada de Vera Rubin con Groq 3 LPX, NVIDIA asigna prefill y la atención de decode a la GPU, y las operaciones FFN/MoE de decode a la LPU. Por tanto, no se traslada todo decode a la LPU. Ambas partes intercambian datos intermedios. Explicación oficial de la arquitectura de NVIDIA
El siguiente diagrama reconstruye conceptualmente ese reparto. Omite operaciones auxiliares como la normalización, las conexiones residuales y los detalles de distribución de tensores:
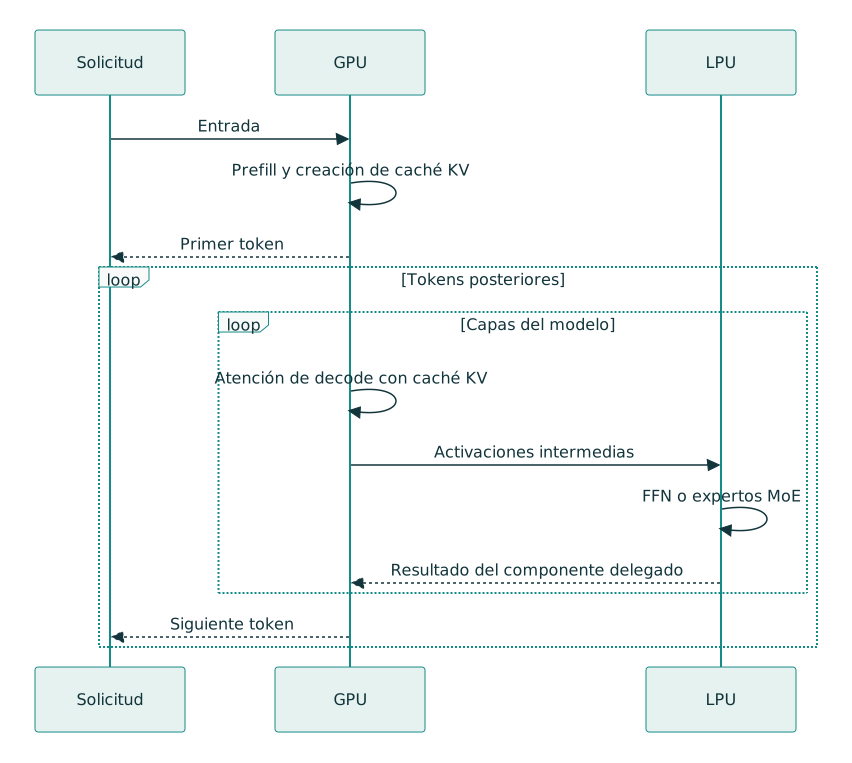
Descargar el código Mermaid del diagrama
Esto no equivale a separar prefill y decode en dos grupos de procesadores. DistServe es un ejemplo de separación de ambas fases para controlar su interferencia y optimizar el servicio bajo restricciones de latencia; LPX lleva el reparto hasta los componentes internos de decode. Artículo original de DistServe
El interés del ejemplo es arquitectónico, más allá del nombre del producto: las distintas partes de una solicitud no necesitan las mismas proporciones de capacidad de memoria, ancho de banda y potencia de cálculo.
Leer las cifras de memoria en la escala adecuada
La página oficial de LPX anuncia las siguientes especificaciones:
| Especificación anunciada | Escala |
|---|---|
| 500 MB de SRAM | Por LPU |
| 150 TB/s de ancho de banda de SRAM | Por LPU |
| 256 chips LPU | Un rack LPX |
| 128 GB de SRAM y 12 TB de DDR5 | Un rack LPX |
| Aproximadamente 40 PB/s de ancho de banda de SRAM | Agregado del rack |
| 640 TB/s de ancho de banda de scale-up | A escala de rack |
Fuente: Página oficial de NVIDIA Groq 3 LPX
Son especificaciones anunciadas por el fabricante. El ancho de banda agregado de SRAM de un rack no puede compararse directamente con el de la HBM de una sola GPU. La capacidad DDR5 tampoco es capacidad SRAM, y la tasa de scale-up interna del rack no determina la tasa aprovechable de un intercambio concreto entre GPU y LPU.
Un total de 128 GB de SRAM tampoco permite concluir que todos los pesos de un modelo muy grande quepan siempre en SRAM. La ubicación de los datos, su distribución y la frecuencia con la que se mueven deben seguir formando parte del análisis.
La comunicación determina el coste del reparto
Dividir una operación entre dos aceleradores resulta útil cuando el ahorro de ejecución supera el coste adicional de transferencia y coordinación.
El tiempo de un intercambio puede aproximarse así:
Aquí, es la latencia fija de inicio y entrega, el tamaño del mensaje y el ancho de banda efectivo de la ruta. Este modelo simple no recoge por completo la congestión ni la variabilidad de ejecución, pero aclara una distinción: para mensajes pequeños, reducir la latencia fija puede importar más que aumentar el ancho de banda.
Por ejemplo, supongamos que un diseño hipotético necesita 80 viajes de ida y vuelta dependientes para generar cada token y que el coste fijo total de cada uno es de 10 microsegundos. La contribución fija de la comunicación, antes de contar el volumen de datos, es de 0,8 milisegundos. Si cada ida y vuelta tarda 50 microsegundos, esa contribución aumenta a 4 milisegundos.
Este ejemplo no describe las especificaciones de LPX. Muestra por qué incluso los intercambios de pocos datos pueden importar en un bucle que se repite con frecuencia.
Sin solapamiento, una condición simple para que compense delegar una parte es:
En una implementación real deben medirse los costes que permanecen en la ruta crítica después del solapamiento.
La misma consideración se aplica al añadir GPU. Aumentar el paralelismo de tensores puede liberar más memoria, pero exige más coordinación; la documentación de vLLM señala expresamente esa sobrecarga. Consideraciones de paralelismo en vLLM
Por tanto, «el modelo se ejecuta en cuatro tarjetas» no significa «cada usuario recibe una respuesta cuatro veces más rápido».
¿Cuáles son los límites de una afirmación del fabricante?
Para la combinación de Vera Rubin NVL72 y LPX, NVIDIA anuncia hasta 35 veces más rendimiento por megavatio que GB200 NVL72 en un punto de aproximadamente 400 tokens por segundo y usuario. Es una afirmación del fabricante sobre la configuración y el escenario presentados; no significa que el tiempo de respuesta de cada solicitud se reduzca 35 veces ni que LPX sea superior en todos los casos. Gráfico y explicación de NVIDIA
Para utilizar esa afirmación como criterio de compra deben conocerse el modelo, la precisión numérica, las longitudes de entrada y salida, la concurrencia, el número de racks, los límites de la medición de potencia y la restricción de latencia. Una cifra de «tokens por megavatio» tampoco recoge por sí sola el precio de compra, el coste de red, la operación ni el aprovechamiento real de la capacidad.
Entre las fuentes examinadas para este artículo, la descripción de LPX se basa en la documentación de NVIDIA. Sus cifras no se presentan aquí como resultados reproducidos de forma independiente.
¿Qué capacidad se puede vender o utilizar realmente?
Un servicio puede alcanzar una tasa elevada en una prueba mientras una parte considerable de las solicitudes supera la latencia permitida. La capacidad nominal de esa prueba no es una capacidad fiable de servicio.
En nuestra experiencia con Targoman bajo carga (informe en persa), las respuestas solían comenzar en menos de un segundo con poca carga; bajo presión, la espera podía alcanzar el límite de 20 segundos, tras el cual se cancelaba la solicitud si la respuesta aún no había comenzado. Durante aquel episodio, el sistema tenía unas 300 solicitudes concurrentes, pero no todas terminaban correctamente. Por eso, la capacidad útil debe contar las respuestas entregadas en un tiempo aceptable, no solo las solicitudes presentes en el sistema.
La métrica goodput aborda este problema contando las solicitudes que cumplen las restricciones establecidas. En AIPerf también se distingue de la proporción de solicitudes que las cumplen: un servicio que rechaza muchas solicitudes no debería considerarse exitoso solo porque las respuestas restantes sean rápidas. Guía de goodput de AIPerf
Para un servicio concreto podría plantearse inicialmente este objetivo: «Al menos el 95 % de las solicitudes deben tener tanto un TTFT inferior a dos segundos como un TPOT inferior a 50 milisegundos». Las cifras son ejemplos y deben derivarse de las necesidades del producto.
La exigencia de cumplir ambas condiciones es deliberada. Informar por separado del percentil 95 de cada métrica no garantiza que el mismo 95 % de las solicitudes cumpla las dos.
La calidad de la respuesta también requiere una evaluación independiente. Acortar la salida o cambiar el modelo puede mejorar los tiempos, pero la comparación solo sigue siendo válida si la salida satisface las necesidades de la aplicación.
Definir las pruebas de aceptación a partir del servicio
Antes de comparar tarjetas, las especificaciones de la prueba deben ser fijas y reproducibles:
| Área de la prueba | Qué registrar |
|---|---|
| Modelo y calidad | Versión de los pesos, tokenizer, cuantización y criterios de aceptación de la respuesta |
| Entrada y salida | Distribución de longitudes, idioma, contexto de varios turnos y longitud real de salida |
| Carga entrante | Tasa de llegada, concurrencia, picos de tráfico y duración de la prueba |
| Motor de ejecución | Versiones, lotes, paralelismo, chunked prefill y configuración de caché |
| Funciones de aceleración | Estado de prefix caching y speculative decoding |
| Latencia | Distribuciones de TTFT y TPOT, pausas del flujo y tiempo de finalización |
| Capacidad | Tasa total de salida, solicitudes exitosas, errores, timeouts y goodput |
| Infraestructura y coste | Número de tarjetas y servidores, topología, consumo eléctrico y coste total de la configuración |
Una prueba con un solo usuario ayuda a conocer el límite inferior de latencia, pero no determina la capacidad del servicio. Hay que aumentar la carga e identificar el punto a partir del cual dejan de cumplirse las restricciones de experiencia de usuario. También debe distinguirse una prueba con concurrencia fija de otra con tasa de llegada fija: en la primera, un servicio más lento puede retrasar automáticamente el envío de la siguiente solicitud y reducir la presión aplicada.
Para contenido en persa, la muestra debe incluir entradas reales en persa. «Tokens por segundo» no representa necesariamente el mismo volumen de texto con dos tokenizers distintos; por eso, comparar modelos diferentes también exige evaluar la calidad y el tiempo necesario para completar una tarea común.
Asimismo, debe quedar claro si se pretende aislar el efecto del hardware o comparar el mejor servicio que pueda desplegarse. En el primer caso, la configuración debe ser lo más parecida posible. En el segundo, puede optimizarse cada pila de software, siempre que se documenten las diferencias y se mantenga el criterio de calidad.
Elegir GPU empieza por definir la respuesta deseada
Al comprar infraestructura de inferencia, preguntar «¿qué tarjeta es más rápida?» resulta prematuro. Primero hay que determinar si las respuestas son cortas o largas, cuántas solicitudes simultáneas habrá, qué latencia es aceptable y qué parte de la ejecución consume el tiempo.
LPX ejemplifica una respuesta arquitectónica a las distintas necesidades de los componentes de inferencia. Su existencia no implica que todo servicio necesite hardware heterogéneo. A veces basta con mejorar la planificación, elegir la pila de software adecuada o reducir la presión sobre la memoria; otras veces, el reparto entre procesadores compensa el coste de comunicación.
El criterio de compra debe ser la capacidad de atender solicitudes con la calidad y la latencia necesarias. El cálculo, la memoria y la red son medios para conseguirlo. Una posición superior en una de esas columnas, por sí sola, no garantiza un mejor rendimiento de respuesta.