Un acelerador se convierte en una alternativa práctica cuando puede ejecutar el modelo y las bibliotecas necesarios, cumple los objetivos del servicio y justifica el trabajo de ingeniería requerido para migrar. Los FLOPS máximos no bastan para resolver esa cuestión. También importan el soporte del software, el consumo energético, la densidad de cálculo y el comportamiento del sistema completo.
Para esta comparación, supongamos que disponemos en el laboratorio de un sistema NVIDIA y otro Ascend. La pregunta es directa:
¿Cuál es la brecha técnica entre Ascend y NVIDIA?
Si NVIDIA es más rápido, la medición debe reflejarlo. Si consume menos energía por token útil, ese resultado debe registrarse. Del mismo modo, si Ascend ejecuta una carga dentro del acuerdo de nivel de servicio (SLA) exigido, la ausencia de CUDA no convierte por sí sola al sistema en una opción inutilizable.
Antes de comparar el hardware, conviene precisar el alcance: los modelos de lenguaje grandes (LLM) son solo una parte de la IA. El mantenimiento predictivo, la detección de anomalías en sensores, la previsión de demanda, la inspección de calidad y la optimización energética también son aplicaciones importantes. A la escala habitual de una organización, muchos modelos especializados para estas tareas no necesitan grandes cantidades de GPU durante la inferencia. Puede bastar una CPU, un acelerador pequeño o un número reducido de GPU. El entrenamiento debe evaluarse por separado; el tamaño del modelo, la tasa de solicitudes y los límites de latencia siguen determinando la capacidad necesaria. Este mismo criterio de partir de la carga real guía la elección de una GPU para IA.
Esta diferencia explica por qué aquí me centro en los modelos de lenguaje. Servir LLM grandes puede exigir mucha memoria y numerosos aceleradores para almacenar los pesos, mantener una caché de claves y valores (KV) que crece con el contexto y las solicitudes simultáneas, generar tokens de forma secuencial e intercambiar datos entre aceleradores. A esa escala, el ancho de banda de memoria, las interconexiones, los kernels y el motor de inferencia afectan directamente a la capacidad del servicio y al coste. Por eso concentro la comparación en el entrenamiento y la inferencia de modelos de lenguaje, especialmente en el servicio de modelos grandes. Los modelos pequeños tampoco necesitan automáticamente grandes clústeres: elegir el tamaño adecuado para la tarea sigue siendo el punto de partida. Las demás aplicaciones de IA necesitan mediciones de sus propias cargas.
Primero, definamos qué estamos comparando
«Ascend frente a NVIDIA» es una expresión demasiado amplia para comparar hardware con precisión.
Ascend 910C, utilizado en CloudMatrix384 y en la generación A3, no es lo mismo que Ascend 950PR o 950DT. Incluso 950PR y 950DT, pertenecientes a la misma generación, se dirigen a cargas diferentes. Huawei diseñó 950PR para el procesamiento inicial de la entrada —prefill— y los sistemas de recomendación, y 950DT para la generación de tokens —decode— y el entrenamiento, debido a sus distintas necesidades de cálculo y ancho de banda. Huawei
En NVIDIA, H200 y B300 también pertenecen a generaciones distintas. H200 es una referencia útil para infraestructuras de centros de datos ya instaladas; B300 representa Blackwell Ultra, con mucha más capacidad de cálculo, memoria e interconexión. H200 ofrece 141GB de HBM3e, 4.8TB/s de ancho de banda de memoria y 900GB/s mediante NVLink. Para B300 en HGX, los documentos oficiales indican 270–288GB y 7.7–8TB/s según el documento o la configuración; NVLink de quinta generación proporciona 1.8TB/s por GPU. Especificaciones de H200 · Ficha de Blackwell Ultra
Utilizo cuatro referencias: Atlas 350 con 950PR para prefill, Atlas 650E con 950DT, H200 como representante consolidado de Hopper y B300 como referencia más reciente de NVIDIA.
Las especificaciones del chip y las del producto son distintas
Un primer ejemplo muestra por qué comparar fichas técnicas no es tan sencillo como parece.
Para el procesador 950PR, Huawei anuncia hasta 128GB de memoria, 1.6TB/s de ancho de banda y 1,784TFLOPS. Pero Atlas 350, la tarjeta real basada en ese procesador, ofrece 112GB, 1.4TB/s, 425TFLOPS en BF16/FP16 y 804TFLOPS en mxFP8. Su consumo máximo es de 600W. Especificaciones de los procesadores Ascend · Tarjetas Atlas
Para 950DT, la hoja de ruta de Huawei de 2025 describía 144GB de memoria HiZQ 2.0 con 4TB/s. Sin embargo, la página actual de Atlas 650E especifica 8×96GB para sus ocho procesadores 950DT: el mismo ancho de banda, pero menos capacidad. Tomo como referencia el producto actual, porque no he encontrado una explicación pública clara de esa diferencia. Hoja de ruta de Huawei · Especificaciones de Atlas 650E
La misma regla se aplica a NVIDIA: las capacidades de la arquitectura, los máximos del chip y la configuración instalada en un servidor concreto son tres cosas diferentes.
Comparación de especificaciones: la brecha no es un solo número
La tabla compara productos de la forma más coherente que permiten los datos disponibles. Cuando NVIDIA anuncia rendimiento de Tensor Cores suponiendo dispersión de los datos, utilizo el valor para cálculo denso.
| Métrica | Ascend 950PR en Atlas 350 | Ascend 950DT en Atlas 650E, por NPU | H200 SXM | B300 en HGX, por GPU |
|---|---|---|---|---|
| Carga objetivo | Prefill / recomendación | Decode / entrenamiento | Entrenamiento e inferencia generales | Entrenamiento e inferencia generales |
| BF16/FP16 teórico | 425 TFLOPS | 425 TFLOPS | ≈990 TFLOPS densos | ≈2.25 PFLOPS densos |
| FP8 o familia comparable | 804 TFLOPS | ≈804 TFLOPS | ≈1.98 PFLOPS densos | ≈4.5 PFLOPS densos |
| Memoria del acelerador | 112GB | 96GB en el Atlas 650E actual | 141GB | 270–288GB |
| Ancho de banda de memoria | 1.4TB/s | 4.0TB/s | 4.8TB/s | 7.7–8TB/s |
| Interconexión dentro del sistema | 318GB/s por tarjeta en una malla completa de cuatro tarjetas | 784GB/s/NPU bidireccionales en el servidor de ocho NPU | 900GB/s NVLink | 1.8TB/s NVLink |
| Especificación de potencia | ≤600W por tarjeta | 14.5kW para el servidor completo de ocho NPU | ≤700W por GPU; DGX H200 completo: 10.2kW | Hasta ≈1.1kW en HGX; DGX B300: consumo declarado de 14.5kW, entrada máxima de 15kW |
Nota sobre B300: Los documentos oficiales de NVIDIA indican estos dos conjuntos de valores según el documento o la configuración: 288GB y 8TB/s en la arquitectura de referencia de HGX B300, y 270GB y 7.7TB/s en la ficha de Blackwell Ultra. Arquitectura de referencia de NVIDIA · Ficha de Blackwell Ultra
Los datos de Ascend proceden de las páginas actuales de Atlas 350 y Atlas 650E; los de NVIDIA, de la documentación oficial de H200, HGX y DGX. Las cifras de potencia no corresponden al mismo nivel de medida. Aquí no disponemos de una potencia de diseño térmico (TDP) pública e independiente para 950DT, mientras Huawei proporciona la potencia del servidor completo. Por tanto, esta tabla no permite calcular directamente la eficiencia por chip. Especificaciones de Ascend · Guía de DGX B300
La tabla muestra algo más útil que un ganador.
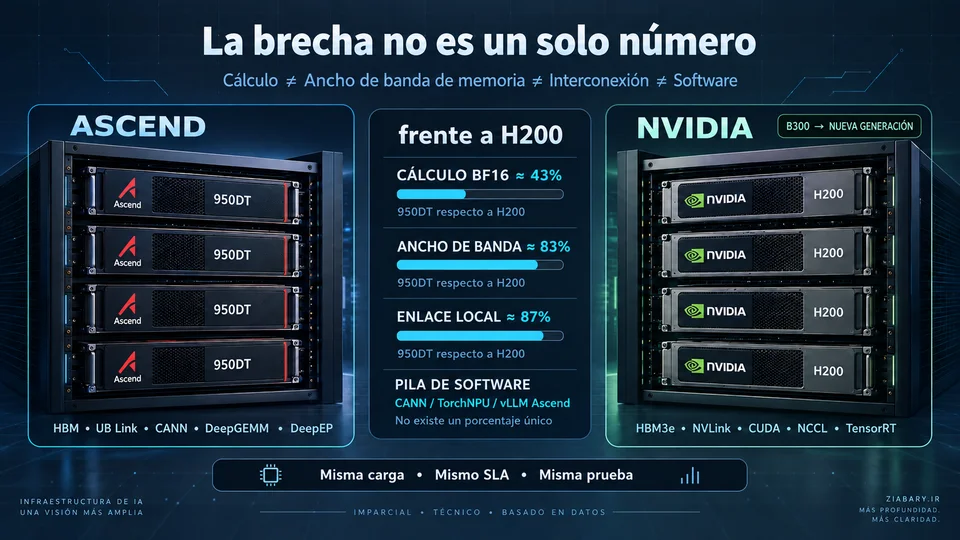
El 950DT actual ofrece aproximadamente el 43% del rendimiento BF16 teórico de H200 y el 41% de su rendimiento FP8. Sin embargo, alcanza alrededor del 83% de su ancho de banda de memoria y del 87% del ancho de banda local anunciado. Frente a B300, la diferencia de cálculo es mucho mayor: 950DT tiene menos de una quinta parte del cálculo bruto, aproximadamente la mitad del ancho de banda de memoria y cerca de un tercio de la capacidad de memoria en el Atlas 650E actual.
Ascend puede tener alrededor del 40% de la capacidad de cálculo de NVIDIA y más del 80% de su ancho de banda de memoria. La relación que importa depende de la carga.
Por qué los 4TB/s de 950DT importan más de lo que parece
En el artículo sobre latencia y capacidad de inferencia, utilicé una aproximación sencilla:
representa la cantidad de cálculo; , la capacidad de cálculo; , los datos que deben transferirse; y , el ancho de banda de memoria. Si domina el segundo término, añadir FLOPS no acelera necesariamente la operación.
La misma relación permite obtener un umbral sencillo:
Un kernel con intensidad aritmética por debajo de este umbral tiene más probabilidades de estar limitado por la memoria; por encima, la capacidad de cálculo cobra mayor importancia.
Con el rendimiento BF16 teórico, los valores aproximados son:
| Acelerador | BF16 | Ancho de banda de memoria | aproximado |
|---|---|---|---|
| Ascend 950PR / Atlas 350 | 425TFLOPS | 1.4TB/s | ≈304 FLOP/Byte |
| Ascend 950DT / Atlas 650E | 425TFLOPS | 4.0TB/s | ≈106 FLOP/Byte |
| H200 SXM | ≈990TFLOPS | 4.8TB/s | ≈206 FLOP/Byte |
| B300 HGX | ≈2.25PFLOPS | 7.7–8TB/s | ≈281–292 FLOP/Byte |
Estos valores no son resultados de pruebas: son cocientes entre especificaciones teóricas. Aun así, ayudan a entender los distintos diseños de 950PR y 950DT.
Durante prefill, especialmente con lotes grandes, las operaciones matriciales tienen mayor intensidad aritmética, de modo que resulta útil disponer de más capacidad de cálculo. 950PR se dirige a esta fase y mantiene 1.4TB/s de ancho de banda de memoria.
Durante decode, sobre todo con lotes pequeños, el procesador lee repetidamente los pesos y la caché KV. El ancho de banda cobra más importancia. En las especificaciones de Atlas 650E, 950DT aumenta el ancho de banda de 1.4 a 4TB/s sin elevar el rendimiento BF16 respecto a Atlas 350.
Para la generación de tokens, Huawei cambió el equilibrio entre cálculo y memoria, en lugar de confiar únicamente en más FLOPS.
Las etiquetas FP4 y FP8 no garantizan una ejecución comparable
La dificultad de comparar bajas precisiones numéricas va más allá del cálculo disperso frente al denso.
Huawei admite mxFP4, mxFP8 y HiF8; NVIDIA utiliza NVFP4 y sus formatos FP8 en Blackwell. El mismo número de bits no implica la misma representación numérica, factores de escala, granularidad de esos factores, kernels o precisión del resultado.
Afirmar que Atlas 350 supera varias veces a H20 en FP4 tiene un valor limitado si no se explica la ruta numérica. H20 no fue diseñado para esa misma ruta FP4, por lo que la relación no establece cuánto más rápido se ejecutará un modelo real. Los formatos y el kernel utilizados deben acompañar la comparación. Especificaciones de Ascend · Ficha de Blackwell Ultra
En la práctica, hay que registrar conjuntamente el formato de los pesos, las activaciones, los factores de escala y el kernel. Como expliqué en «INT8 o FP8», llamar «FP8» o «INT8» a los pesos no garantiza que la multiplicación matricial utilice esa misma ruta. BF16 sirve aquí como referencia porque facilita una comparación arquitectónica coherente, no porque todos los despliegues deban utilizarlo.
Más allá de la ficha técnica: ¿funciona bien la carga completa?
Una página de producto con 4TB/s y 804TFLOPS no demuestra un buen rendimiento con un modelo real. Las pruebas públicas disponibles tienen distinto alcance y distinta solidez. En esta tabla, TPOT significa tiempo por token de salida.
| Evidencia | Hardware | Qué mide | Resultado | Calidad de la evidencia |
|---|---|---|---|---|
| MLPerf Inference 6.1 | NVIDIA y otros fabricantes | Modelos y cargas estandarizados | Datos amplios y comparables | Reglas de presentación y revisión; Huawei no participa |
| CloudMatrix-Infer | 910C | Servicio completo de DeepSeek-R1 | 1,943 tokens/s/NPU con TPOT≈49.4ms | Artículo técnico de Huawei y SiliconFlow; no es una prueba independiente |
| DeepGEMM-Ascend | 950DT | Kernel de multiplicación matricial (GEMM) | Hasta el 99.8% del máximo declarado del kernel | Código abierto y reproducible; no mide el modelo completo |
| DeepEP-Ascend | 950DT | Comunicación en modelos MoE | Aproximadamente el 90–95% del máximo de ancho de banda útil hasta EP32 | Código abierto; probado en PoC HDK, con limitaciones pendientes |
MLPerf Inference v6.1 se publicó en septiembre de 2026 con 30 participantes y 120 sistemas. Su Closed Division está concebida para comparar bajo condiciones comunes. NVIDIA tiene una presencia amplia, pero Huawei no figura entre los participantes. Por tanto, estos resultados no contienen una comparación oficial de MLPerf entre H200 y 950DT. Esta es una carencia importante de los datos públicos sobre Ascend. MLCommons
La ausencia de una prueba estandarizada no significa que el hardware no pueda ejecutar la carga. Tampoco permite cubrir ese vacío con pruebas del fabricante y llamarlas comparaciones independientes.
910C: la evidencia pública más sólida sobre la ejecución completa
Para la generación 950 todavía falta una prueba independiente y completa comparable con MLPerf. Para evaluar la madurez del software de Ascend al servir modelos grandes, CloudMatrix384 basado en 910C sigue siendo especialmente útil.
Serving Large Language Models on Huawei CloudMatrix384 estudia DeepSeek-R1 en un sistema con 384 NPU y 192 CPU. Con entradas de 4K, el rendimiento de prefill predeterminado es de 5,655 tokens/s por NPU. El valor de 6,688 corresponde a la configuración idealizada Perfect EPLB, no a la ejecución predeterminada. Durante decode, con un lote de 96, una caché KV de longitud 4096 y un TPOT de 49.4ms, se obtienen aproximadamente 1,943 tokens/s por NPU.
El artículo también incluye referencias de H800 y H100. SGLang en H100, con un lote de 128, registra unos 2,172 tokens/s y TPOT≈55.6ms; CloudMatrix, con un lote de 96, registra 1,943 tokens/s y 49.4ms. Tabla 4 del artículo
Estas cifras no justifican decir que Ascend es simplemente «un 10% más lento que H100». Cambian el lote, la precisión numérica y el software. También deben controlarse la generación especulativa y la predicción de múltiples tokens (MTP). El artículo supone explícitamente una aceptación efectiva del 70% para un token especulativo, tanto en el MTP simulado de SGLang como en CloudMatrix-Infer. Esa condición debe acompañar al resultado.
La evidencia permite una conclusión más limitada:
910C y su software pueden servir DeepSeek-R1 a una escala considerable con un tiempo por token competitivo.
Esto importa para la comparación técnica. Una conclusión más fuerte exigiría una prueba común.
950DT: los kernels matriciales ya no son el punto débil evidente
La generación 950 es más reciente y todavía no acumula tanta evidencia sobre modelos completos como 910C. Una prueba reciente de DeepSeek permite, sin embargo, observar su ruta de cálculo.
DeepGEMM-Ascend se publicó el 30 de septiembre de 2026. El README revisado documenta pruebas reproducibles en Ascend 950DT con CANN 9.20. Para las grandes matrices indicadas, BF16 GEMM alcanza 431TFLOPS de un máximo de 432TFLOPS: el 99.8%. FP8×FP8 alcanza 861 de 865TFLOPS, y FP4×FP4, aproximadamente 1701 de 1730TFLOPS. README de DeepGEMM-Ascend
Esto no demuestra que 950DT supere a H200 o B300: NVIDIA no participa en la prueba. Demuestra que, con dimensiones matriciales adecuadas, el kernel disponible puede utilizar casi toda la capacidad matricial declarada de esta NPU. Un rendimiento bajo en esas rutas ya no puede atribuirse automáticamente a un compilador Ascend deficiente.
Ejecutar un LLM implica mucho más que unas pocas multiplicaciones grandes. La atención, la normalización, el muestreo, la gestión de la caché, la comunicación, la planificación y las operaciones pequeñas todavía pueden convertirse en cuellos de botella.
MoE necesita comunicación rápida además de cálculo
En los modelos de mezcla de expertos (MoE), la comunicación puede importar tanto como el cálculo. Los tokens se distribuyen entre expertos y después se combinan sus resultados. Con paralelismo de expertos, los intercambios entre todos los participantes pueden ocupar una parte considerable del tiempo de generación.
DeepEP-Ascend en 950DT registra unos 373–375GB/s en la distribución de tokens con EP=8 y mantiene 335–340GB/s con EP=32. El proyecto declara aproximadamente un 90–95% del máximo físico de ancho de banda para datos útiles hasta EP32. El rendimiento sigue cayendo con EP64 y EP128; la combinación de resultados también empeora, y los desarrolladores señalan que continúan optimizando estas partes. Aquí EP indica el tamaño del grupo de paralelismo de expertos. DeepEP-Ascend
Las mediciones se realizaron en kits de desarrollo de hardware de prueba de concepto (PoC HDK), con un firmware concreto. No debe suponerse que un Atlas 650E de producción reproduce esos valores sin cambios. La prueba es prometedora y el método es público, pero el estado del hardware y las versiones del software deben acompañar a las cifras.
Software: la brecha puede importar más que el hardware
«¿Funcionarán las bibliotecas necesarias?» puede ser una pregunta más útil que comparar FLOPS.
PyTorch en Ascend es una opción real y práctica, pero la compatibilidad con CUDA no es completa.
TorchNPU 26.1 admite oficialmente 950DT. Huawei conserva buena parte de la API y del flujo de desarrollo de PyTorch; algunas interfaces se conectan a la NPU mediante modificaciones de las funciones durante la ejecución. Documentación de TorchNPU
Migrar código basado en operadores estándar de PyTorch puede ser relativamente sencillo. Una aplicación que utiliza extensiones CUDA, kernels propios, bibliotecas específicas de CUDA, comportamientos particulares de NCCL u operadores ausentes en CANN/TorchNPU es otro caso. Huawei documenta un proceso de adaptación de operadores, reconociendo que no todos se trasladan sin trabajo adicional. Guía de adaptación de operadores
Cambiar .cuda() por .npu() puede bastar en una demostración sencilla. No permite estimar con fiabilidad el esfuerzo para migrar una aplicación de producción.
vLLM: un soporte mucho más sustancial que un experimento periférico
Para servir LLM, la situación actual resulta más alentadora.
La tabla de soporte de vLLM Ascend para 950DT incluye DeepSeek V4, DeepSeek-V3.1 y GLM-5.1, con funciones como W8A8, prefill por bloques, reutilización de prefijos en caché, generación especulativa, paralelismo de expertos, paralelismo de datos y separación entre prefill y decode. Tabla de soporte de vLLM Ascend
La imagen oficial de contenedor vllm-ascend:v0.23.0-a5 está documentada para 950DT, con instrucciones de despliegue en varios nodos para modelos como GLM-5/5.1.
Sin embargo, no todas las combinaciones tienen soporte completo. Algunos modelos son experimentales, ciertas funciones no se han probado y LoRA o el paralelismo por etapas tienen restricciones en determinadas configuraciones. «Se admite vLLM» no basta. La pregunta útil es:
¿Qué modelo, con qué cuantización, qué funciones y en qué generación de Ascend?
La misma disciplina se aplica a una afirmación genérica de que una GPU «admite FP8».
Entrenamiento: los datos públicos no demuestran igualdad
950DT se dirige a la generación de tokens y al entrenamiento, con mucho más ancho de banda de memoria e interconexión que su predecesor. TorchNPU proporciona una vía de entrenamiento con PyTorch. Afirmar que no se pueden entrenar modelos en Ascend es incorrecto. Huawei
Pero la viabilidad es solo la primera pregunta. En un entrenamiento grande importa la utilización de FLOPS del modelo:
¿Cuánta utilización se mantiene con 64, 256 o varios miles de aceleradores? ¿Qué cuestan las operaciones colectivas? ¿Cómo afecta la recuperación tras fallos? ¿Cómo se guardan los puntos de control y se reparte el estado del optimizador? ¿Cuánto intercambio introduce el paralelismo de expertos? ¿Qué parte de la capacidad teórica conserva el compilador con el modelo real?
Para NVIDIA existen numerosos resultados de MLPerf Training, experiencia pública con clústeres y herramientas de desarrollo y supervisión. Las cargas recientes de entrenamiento de MLPerf también incluyen MoE y DeepSeek-V3. MLCommons
Para Ascend, los resultados públicos estandarizados todavía no sitúan 950DT junto a B300 o H200 bajo las mismas condiciones.
DeepGEMM demuestra un uso eficaz del cálculo matricial. DeepEP demuestra un software de comunicación sustancial. Juntos todavía no constituyen una prueba del proceso completo de entrenamiento. Para elegir hardware destinado al preentrenamiento a muy gran escala, los datos públicos de NVIDIA siguen siendo mucho más completos.
Inferencia: donde la comparación puede acercarse mucho más
La inferencia, especialmente la generación de tokens, cambia el panorama.
El 950DT actual tiene aproximadamente el 43% del rendimiento BF16 de H200, pero el 83% de su ancho de banda de memoria. Si decode está limitado principalmente por ese ancho de banda, el rendimiento real no tiene por qué guardar la misma proporción que el cálculo.
Los resultados de CloudMatrix con el anterior 910C refuerzan esta idea. Con kernels, memoria, comunicación y software adecuados, una NPU con menos cálculo máximo que H100 puede ofrecer una capacidad y un tiempo por token competitivos para una carga concreta.
El diseño de 950 también distingue estas necesidades: los 1.4TB/s de 950PR se dirigen a una fase más intensiva en cálculo, mientras los 4TB/s de 950DT se orientan a cargas más dependientes de la memoria y la comunicación. Huawei
Para servir LLM, esta diferenciación aporta más información que aumentar los FLOPS por sí solos. El soporte de vLLM Ascend para separar prefill y decode en 950DT sigue esa dirección. Tabla de soporte de vLLM
Interconexiones: NVLink sigue importando, pero la comparación no es sencilla
H200 proporciona hasta 900GB/s mediante NVLink de cuarta generación; B300 ofrece 1.8TB/s con la quinta. En HGX B300, ocho GPU se conectan mediante NVSwitch con un ancho de banda agregado de 14.4TB/s. NVIDIA HGX
En Atlas 650E, cada NPU dispone de 784GB/s bidireccionales mediante UB dentro del servidor de ocho NPU. Dos servidores pueden formar una malla completa de 16 NPU, con hasta 1.68TB/s por NPU. UBoE y RoCE proporcionan además 400Gbps cada uno por NPU para la comunicación entre sistemas. Atlas 650E
Comparar 784 con 900 sugiere una brecha pequeña, pero resulta insuficiente. Importan la topología, la latencia, las operaciones colectivas, el número de participantes y el patrón de comunicación en el que está disponible ese ancho de banda. En MoE es especialmente relevante el tiempo real de distribución de tokens y combinación de resultados con paralelismo de expertos. El comportamiento medido por DeepEP aporta más información que el valor de 784GB/s por sí solo.
La escala también puede compensar chips individuales menos potentes
CloudMatrix384 ilustra esta estrategia: Huawei conecta 384 NPU dentro de un gran dominio de comunicación. SemiAnalysis estimó aproximadamente 300PFLOPS BF16 densos, 49TB de memoria y más de 1.2PB/s de ancho de banda agregado, por encima de GB200 NVL72 a escala de sistema. El mismo análisis señala el coste: muchos más aceleradores y un consumo eléctrico varias veces mayor. Son estimaciones del sistema completo, no evidencia de igualdad por chip. Comparación de SemiAnalysis
Huawei puede compensar parte de la brecha por chip mediante un sistema con más aceleradores interconectados.
Es una estrategia arquitectónica válida, pero tiene costes: más racks, equipos ópticos, complejidad de red, un dominio de fallo mayor y más demanda eléctrica contribuyen al coste total de propiedad.
Coste total de propiedad: el acelerador es solo una partida
Una comparación económica útil necesita presupuestos reales para las configuraciones propuestas, no una relación genérica entre precios de tarjetas. El coste total de propiedad incluye el acelerador, el servidor anfitrión, la red, la electricidad, la refrigeración, el software, la migración, el soporte y los repuestos:
Para un servicio de inferencia, el coste por token entregado dentro del objetivo acordado resulta más útil que el coste total por sí solo:
Un sistema que produce el doble de tokens no ofrece necesariamente más capacidad útil si el tiempo por token supera el límite acordado.
Ascend no es automáticamente la opción de menor consumo. Atlas 650E con ocho 950DT declara unos 14.5kW para el sistema completo. DGX H200 con ocho GPU especifica hasta 10.2kW. DGX B300 indica 14.5kW de consumo, mientras su guía fija 15kW como potencia máxima de entrada. Consumo declarado y entrada máxima son especificaciones diferentes. Las diferencias de CPU, red y diseño del sistema tampoco permiten deducir el rendimiento por vatio solo con esas cifras. Atlas 650E · Guía de DGX B300
Hay que medir tokens por julio, tokens por segundo por rack y tokens por segundo por dólar, con el mismo modelo, distribución de longitudes de contexto, concurrencia y objetivos de servicio. Sin esas condiciones, comparar precios de tarjetas resulta insuficiente.
¿Cuál es, entonces, la brecha real?
La evidencia disponible permite evaluar cada capa por separado:
| Capa | Situación técnica actual |
|---|---|
| Cálculo bruto por acelerador | Ventaja clara de NVIDIA; el 950DT actual ofrece alrededor del 40% de H200 en BF16/FP8 y menos del 20% de B300 |
| Ancho de banda de memoria | Mucho más cercano a H200: 4 frente a 4.8TB/s |
| Capacidad de memoria | El 950DT del Atlas 650E actual queda por detrás de H200 y B300; 950PR está más cerca de H200 |
| Generación de tokens en LLM | La brecha puede ser mucho menor que la diferencia de FLOPS |
| Prefill | La capacidad de cálculo pesa más; 950PR se dirige específicamente a esta fase |
| Comunicación MoE | Software operativo y resultados prometedores, pero los grupos grandes de expertos necesitan mejoras |
| PyTorch | Soporte oficial; no se garantiza la ejecución sin cambios de código dependiente de CUDA |
| vLLM | Soporte activo y sustancial, con diferencias en modelos y funciones disponibles |
| Entrenamiento a gran escala | Viable, pero la evidencia pública independiente no demuestra igualdad |
| Pruebas estandarizadas | Carencia importante para Ascend; Huawei no aparece en los resultados actuales de MLPerf |
| Inferencia del modelo completo | Hay resultados reales, principalmente del fabricante o sus socios |
| Coste total de propiedad | Requiere medir la carga y conocer el precio real de las configuraciones |
La evidencia no justifica afirmar que Ascend ha alcanzado a NVIDIA en todos los aspectos. Tampoco permite descartarlo como una opción técnicamente inutilizable.
El 950DT actual tiene una diferencia importante de cálculo bruto frente a H200, y especialmente frente a B300, pero una brecha mucho menor en ancho de banda de memoria y de conexión local anunciado. Por eso, decode y algunas cargas con mucha comunicación pueden mostrar una diferencia de rendimiento completo menor de lo que sugieren los TFLOPS.
Para entrenamientos enormes o aplicaciones que dependen de extensiones CUDA propias, kernels muy optimizados y herramientas maduras, el software puede importar todavía más que las especificaciones del chip. Aquí la comparación teórica debe dar paso a la medición.
La prueba que me gustaría realizar
Con un Atlas 650E, o incluso un sistema A3, migraría una carga real que hoy se ejecuta en NVIDIA a Ascend sin simplificarla. Mantendría el mismo modelo, tokenizador, distribución de longitudes de contexto, pruebas con los mismos niveles de concurrencia y objetivos de servicio.
Registraría el tiempo hasta el primer token (TTFT), el tiempo por token de salida (TPOT), la tasa de tokens de salida, las solicitudes en curso, la utilización de HBM, la capacidad de caché KV, la potencia del sistema y los fallos durante una ejecución de 24 o 72 horas.
También mediría el tiempo de ingeniería de la migración. ¿Cuántas líneas cambiaron? ¿Qué operadores fallaron? ¿Qué kernels hubo que sustituir? ¿Qué rutas de cuantización no estaban disponibles? Una vez ejecutado el modelo, ¿cuántos días de ajuste hicieron falta para obtener un rendimiento aceptable?
Ese esfuerzo forma parte de la prueba porque afecta a la decisión de despliegue.
La brecha entre Ascend y NVIDIA no es un único porcentaje. BF16, memoria, generación de tokens y ecosistema de software producen comparaciones diferentes.
La pregunta útil es:
Para este modelo, este motor, este objetivo de servicio y esta escala, ¿a qué renunciamos con Ascend y cuánta de la capacidad necesaria puede entregar realmente?
Hasta medirlo en hardware real, tanto afirmar una equivalencia general como descartar la alternativa resulta prematuro. La respuesta necesita una prueba con la carga real.