La IA de confianza cero necesita algo más que herramientas de seguridad alrededor de un modelo. Si los datos, el código, los experimentos, los artefactos y los despliegues no pueden seguirse y controlarse, la verificación continua queda en una declaración de intenciones. MLOps aporta los procesos de ingeniería que permiten llevar esa política a la práctica.
Las operaciones de aprendizaje automático, o MLOps, reúnen ciencia de datos, ingeniería de software y operaciones para construir y mantener modelos fiables en producción. Abarcan todo el ciclo de vida, incluidos los cambios posteriores al despliegue.
La relación entre MLOps y DevOps
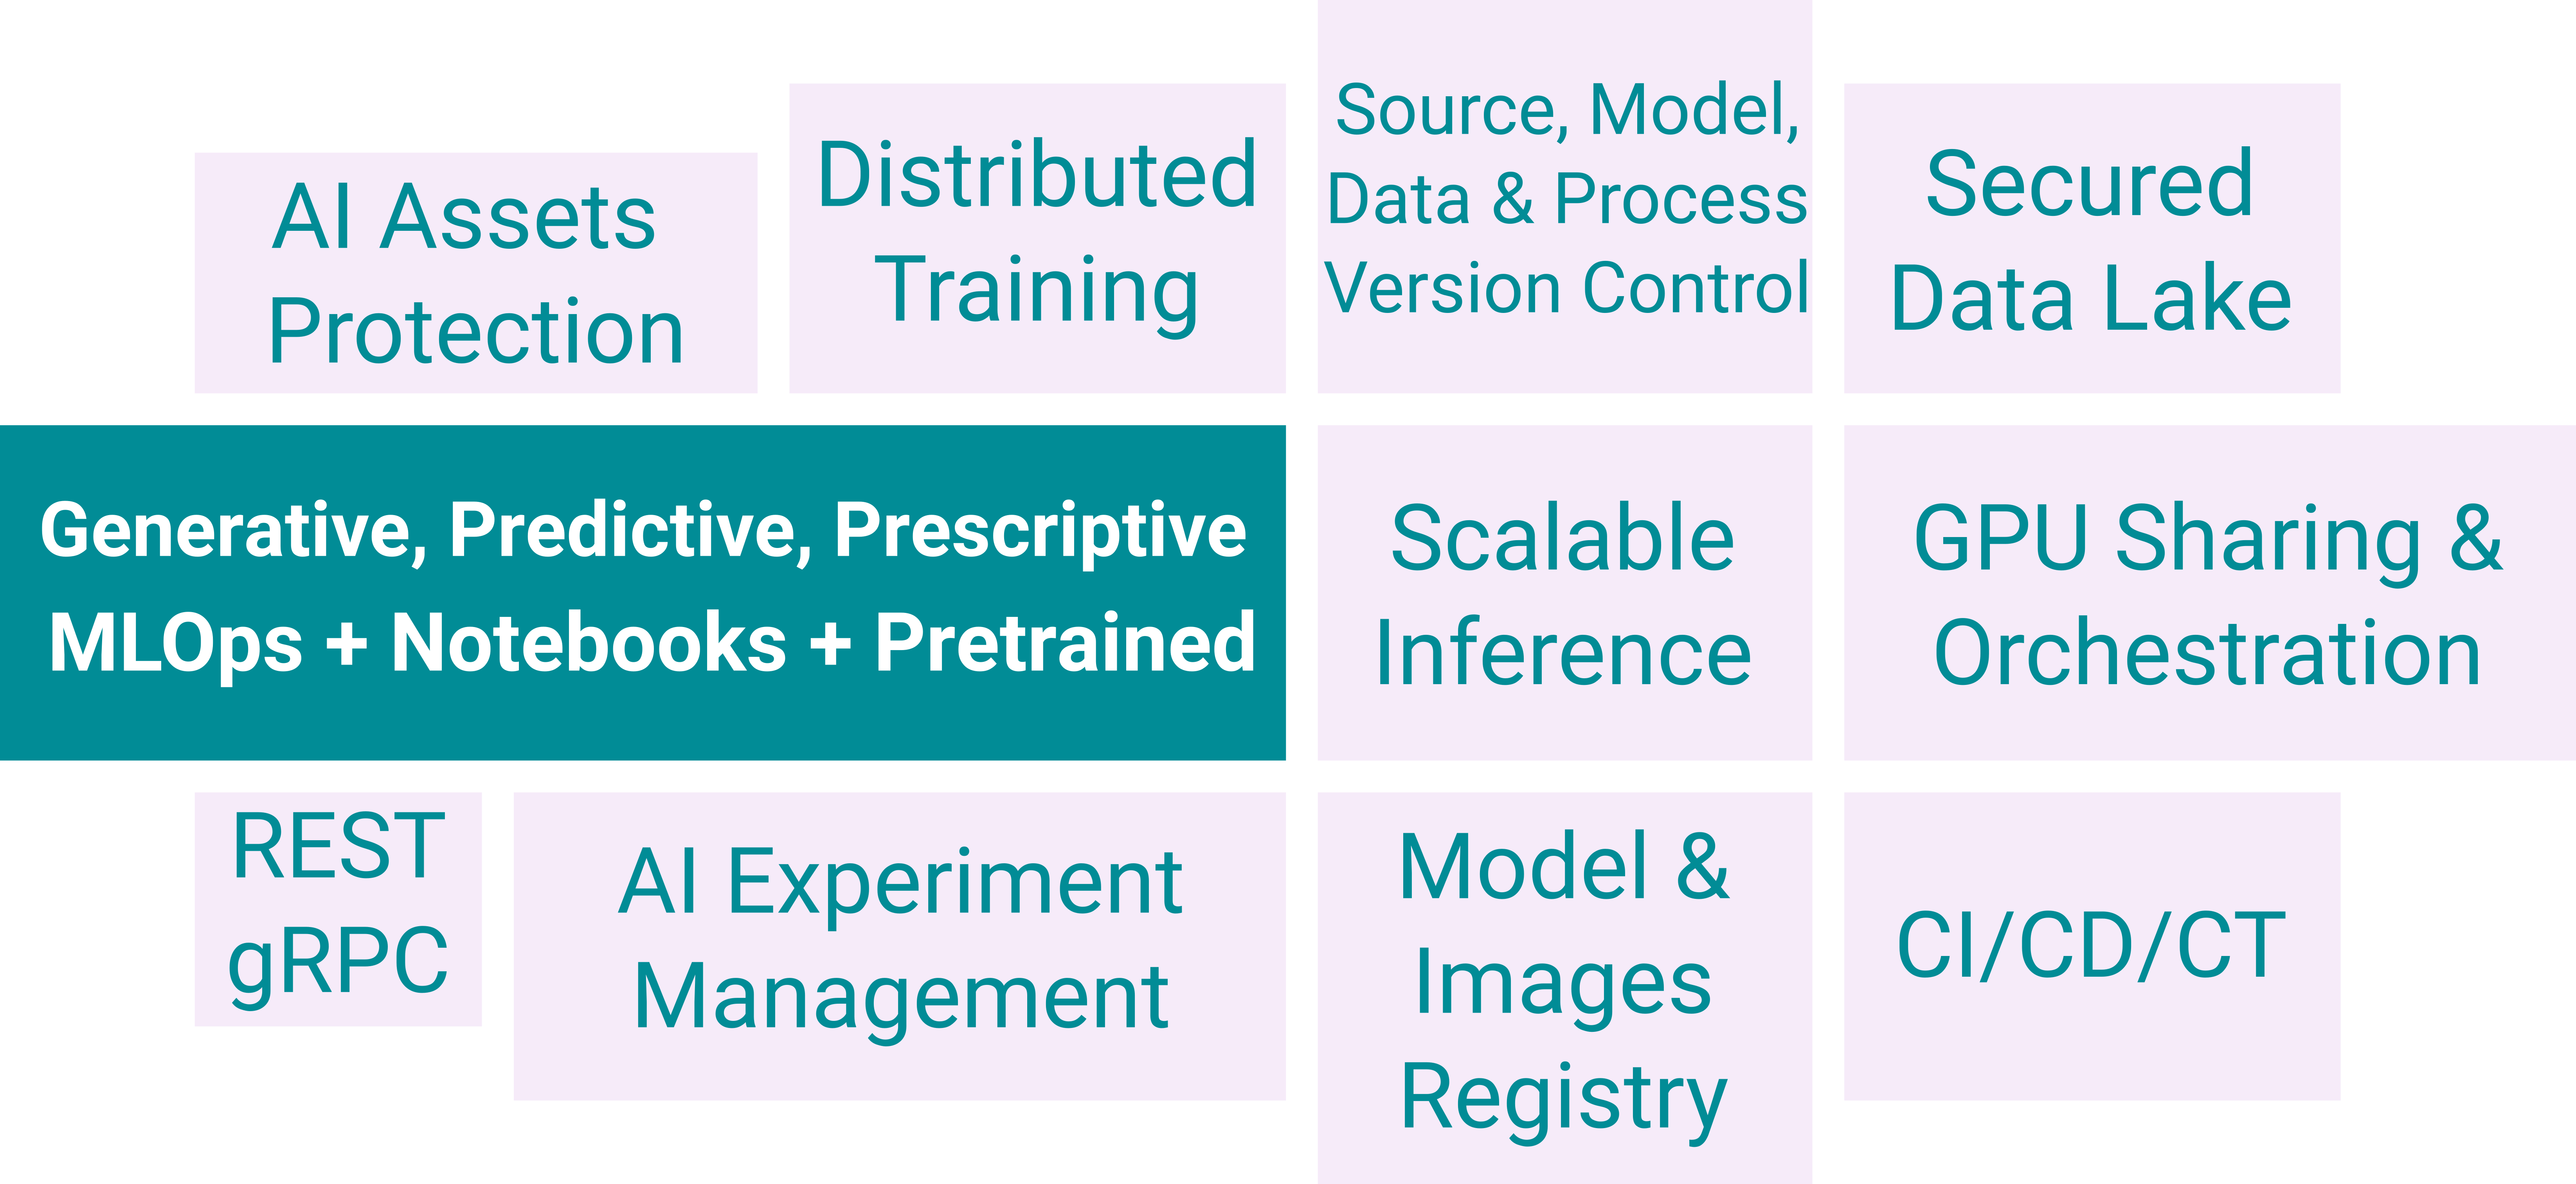
DevOps automatiza y supervisa el desarrollo de software desde la programación y la compilación hasta las pruebas, la publicación, el despliegue y la operación. MLOps aplica estas prácticas a otras etapas: recopilar y explorar datos, prepararlos, entrenar un modelo, evaluarlo y observar su comportamiento en uso.
Ambos buscan mejorar la velocidad de entrega, la calidad y la fiabilidad operativa. El aprendizaje automático añade dependencias menos prominentes en el software convencional. El comportamiento de un modelo depende de sus datos de entrenamiento; los cambios de datos pueden exigir reentrenamiento; y los artefactos resultantes necesitan gestión junto con el código de la aplicación.
Por qué importa la base operativa
El primer beneficio es acortar el camino de la investigación a la producción. La automatización reduce el trabajo manual necesario para convertir un experimento en un servicio. Las etapas estandarizadas también reducen errores evitables, y la supervisión facilita detectar problemas. Publicar más rápido solo resulta útil si la organización puede comprender y gestionar lo que publica.
El segundo beneficio es la escala. Sin un proceso compartido, cada modelo se convierte en un proyecto independiente que depende de personas concretas y sus herramientas locales. Un ciclo de vida común permite repetir el entrenamiento, el despliegue y el mantenimiento entre modelos y equipos.
El tercer beneficio es la gobernanza. La organización necesita reconstruir qué datos, código y configuración produjeron un modelo, qué evaluación respaldó su publicación y qué versión atiende una solicitud. Esta evidencia sirve tanto para las revisiones de seguridad y privacidad como para investigar incidentes operativos. Debe mantenerse durante el reentrenamiento y la sustitución, no terminar en el primer despliegue.
Las partes principales del ciclo de vida
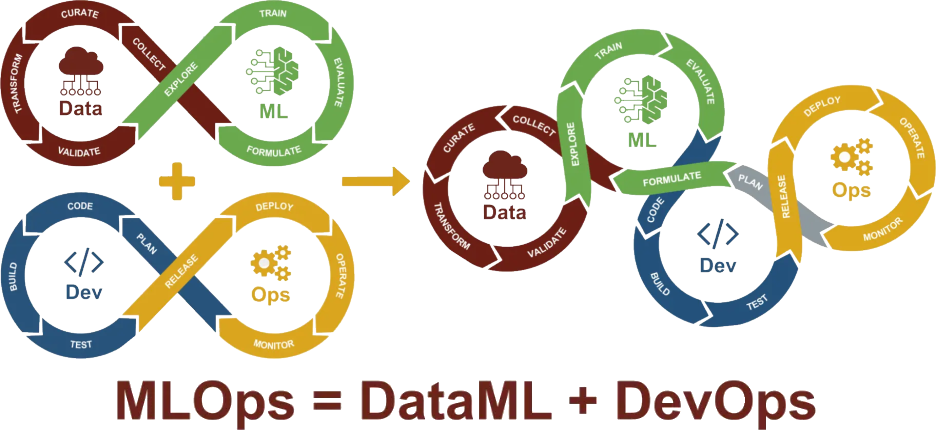
La gestión de datos incluye recopilación, limpieza, ingeniería de características, versiones y catálogo. La gestión de código y configuración sigue el código del modelo, los scripts de entrenamiento, las dependencias y los parámetros. El entrenamiento y la validación organizan experimentos, selección de hiperparámetros, evaluación y aprobación en un proceso repetible y progresivamente automatizable.
Después, el modelo entrenado debe almacenarse, versionarse y vincularse con la evidencia que lo respalda. Un registro puede relacionar un artefacto con su código fuente, referencias a los datos, resultados experimentales y estado de publicación. Los controles de despliegue gobiernan cómo llega ese artefacto a un servidor, un servicio API o un dispositivo de borde.
Tras el despliegue, la supervisión comprueba el rendimiento, los cambios en la distribución de las entradas y las señales de que el modelo ya no se ajusta al uso previsto. La retroalimentación incorpora nueva evidencia operativa al siguiente ciclo de desarrollo o entrenamiento. Un evento que activa el reentrenamiento debe conducir a través de los controles de validación y publicación exigidos; no concede permiso para sustituir el modelo de producción sin ellos.
La seguridad y la gobernanza atraviesan todas estas actividades. Las políticas de acceso, las reglas de conservación, la integridad de los artefactos y los requisitos de aprobación no pueden aplazarse hasta una revisión final, después de que el proceso ya haya expuesto datos sensibles.
Cómo ayuda MLOps a ZTAI
MLOps no equivale por sí mismo a confianza cero. Crea un ciclo de vida observable y estructurado en el que pueden aplicarse decisiones de seguridad.
Las versiones de datos, código y experimentos permiten evaluar procedencia e integridad. Una vía definida de publicación ofrece un punto donde admitir o rechazar un artefacto. La supervisión aporta evidencia para reevaluar un despliegue después de su aprobación inicial. En conjunto, estas capacidades extienden la verificación más allá del inicio de sesión y la incorporan a la operación del servicio.
También hacen visibles los límites. Registrar el origen de un modelo no demuestra que sus datos de entrenamiento sean benignos. Automatizar un proceso no elimina los privilegios de quienes pueden cambiar su código o inspeccionar sus resultados. Para resolver esas cuestiones, los principios y controles de ZTAI deben formar parte del diseño del flujo de trabajo.
La mayoría de las organizaciones construye esta capacidad gradualmente. El modelo de madurez de ZTAI describe una progresión desde el trabajo manual aislado hasta operaciones automatizadas con separación entre desarrollo y procesamiento sensible en producción. Su última etapa añade un objetivo arquitectónico: el trabajo rutinario no debería exigir que las personas manipulen datos sensibles en bruto. Alcanzarlo depende de controlar tanto las vías de acceso indirecto como las directas.
Continúe con la colección de cinco artículos sobre ZTAI.