Proteja los datos, modelos y flujos de trabajo de IA, desde el desarrollo hasta la ejecución controlada y la publicación de resultados.
Acerca de esta colección
Comience por los principios de confianza cero y continúe con la base operativa, las etapas de madurez y los controles prácticos. Después, examine el acceso indirecto mediante código, resultados e infraestructura, y cómo limitar la autoridad de los agentes autónomos durante la ejecución.
Aplicar confianza cero a los datos, modelos y ciclo de vida de IA.
Leer capítulo: De la arquitectura de confianza cero a la IA de confianza cero
La rápida adopción de la IA ha incorporado datos sensibles, propiedad intelectual valiosa y decisiones de importancia a sistemas difíciles de proteger únicamente mediante defensas perimetrales. Un servicio de IA rara vez consiste solo en un modelo detrás de una API. Incluye preparación de datos, código de entrenamiento, dependencias externas, artefactos del modelo, infraestructura de despliegue y personas con distintos tipos de acceso.
Los diseños de seguridad tradicionales solían considerar la red interna un espacio relativamente fiable. Esa suposición resulta especialmente débil en los flujos de trabajo distribuidos de IA. Además de las amenazas habituales de ciberseguridad, estos sistemas se enfrentan al envenenamiento de datos, la inversión de modelos y las entradas adversarias. Un atacante puede alterar una decisión sin tomar el control de un servidor, o extraer información mediante una interfaz del modelo que, por lo demás, es legítima.
En esta colección, IA de confianza cero (Zero Trust AI, ZTAI) significa aplicar los principios de confianza cero a los problemas de ingeniería específicos de la IA. Es el enfoque arquitectónico desarrollado aquí, no el nombre de una norma de seguridad independiente y aprobada. Su alcance abarca los procesos de datos, el ciclo de vida del modelo y las operaciones, además de las identidades y el acceso.
Por qué la seguridad perimetral resultó insuficiente
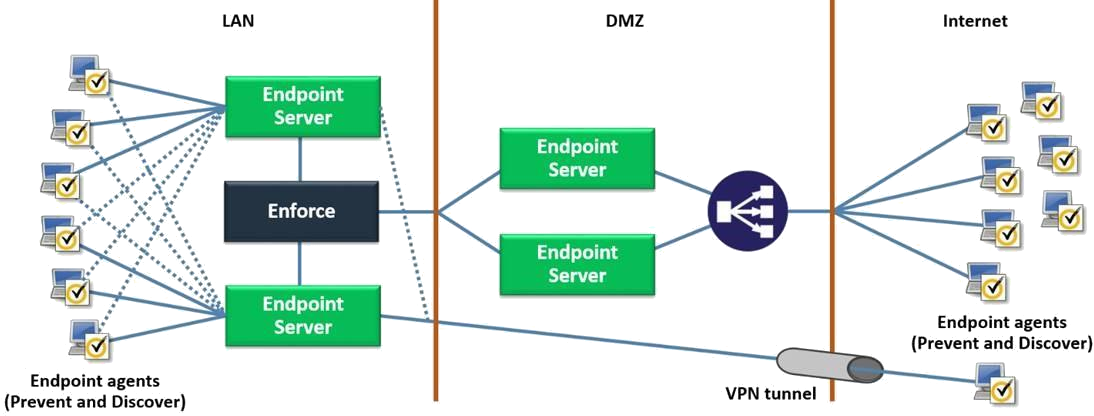
Las arquitecturas de red anteriores dividían habitualmente el entorno en un interior fiable y un exterior no fiable. Las redes aisladas y los controles en sus puntos de entrada y salida constituían la principal frontera defensiva. Los cortafuegos de aplicaciones web, los sistemas de detección y prevención de intrusiones y las herramientas de prevención de pérdida de datos añadían otras capas.
Una red convencional organizada en torno a fronteras internas y externas. Las etiquetas del diagrama se conservan en inglés.
Estas capas no eliminaron las filtraciones ni los servidores comprometidos. Un empleado podía divulgar datos y una conexión aparentemente legítima podía transportar un ataque. La infraestructura en la nube, el trabajo remoto y los dispositivos personales también hicieron cada vez menos fiable la distinción entre dentro y fuera.
John Kindervag presentó el modelo de confianza cero en Forrester en 2010. Su fórmula más conocida es «nunca confiar, verificar siempre»: un usuario, dispositivo o aplicación no debe recibir acceso por el mero hecho de estar dentro de la red de una organización. Hay que establecer su identidad, autorizar la acción solicitada y limitar el acceso a lo que necesita la tarea. La autenticación inicia esa decisión; no concede permiso para utilizar todos los recursos.
La identidad robusta, el mínimo privilegio, la segmentación, la evaluación del estado de los dispositivos y la supervisión continua sostienen este enfoque. Las decisiones deben tener en cuenta los cambios del usuario, el dispositivo, la carga de trabajo y las condiciones operativas durante toda la sesión.
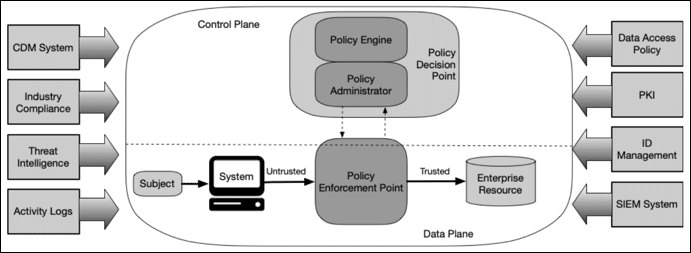
La arquitectura de NIST separa la decisión de política de su aplicación. Un motor de políticas evalúa el acceso; un administrador de políticas establece o termina la comunicación; y un punto de aplicación de políticas hace efectiva la decisión. La información de identidad, el estado de los activos, la inteligencia de amenazas, las políticas de acceso y los registros de actividad alimentan el proceso.
Componentes lógicos de la arquitectura de confianza cero. Véase NIST SP 800-207. Etiquetas en inglés.
NIST ya incluye recursos, servicios y flujos de trabajo dentro de la confianza cero. La discusión específica sobre IA concreta los controles para el ciclo de vida de un modelo; no implica que la confianza cero se limitara originalmente a proteger el tráfico de red.
Qué cambia con la IA
La primera diferencia es el flujo de trabajo. Desarrollar y operar un servicio de aprendizaje automático implica varios equipos, marcos y tecnologías. Una debilidad puede entrar a través de un conjunto de datos, un cuaderno de trabajo, una dependencia de entrenamiento, un registro de modelos o una configuración de inferencia. Proteger el punto de acceso de la aplicación deja gran parte de esa cadena sin abordar.
La segunda diferencia son los datos. Un modelo puede consumir grandes cantidades de información sensible durante la recopilación, el preprocesamiento, el entrenamiento y la inferencia. La protección debe continuar mientras esa información se transforma. Un conjunto procesado, un índice de representaciones vectoriales o un modelo entrenado no se vuelve automáticamente apto para compartir porque ya no se parezca a los registros originales.
La integración del desarrollo de IA con la ingeniería de software y DevSecOps también es desigual. Los proyectos externalizados pueden dejar vacíos en las responsabilidades de propiedad, revisión y publicación. Los paquetes de código abierto son esenciales, pero su rápida evolución dificulta el seguimiento del riesgo de las dependencias. Las herramientas de seguridad concebidas para aplicaciones convencionales pueden no inspeccionar adecuadamente los artefactos del modelo o las transformaciones de datos.
Un modelo no es un artefacto de software corriente. Los equipos necesitan saber cómo se produjo, cómo se carga y qué capacidades de ejecución requieren su formato y sus dependencias. Un equipo de operaciones que desconozca esa cadena puede introducir vulnerabilidades mediante decisiones de despliegue aparentemente rutinarias.
Por último, el comportamiento del modelo depende de los datos y suele ser probabilístico. Una compilación correcta y un solicitante autenticado no demuestran que una respuesta sea correcta, adecuada o esté libre de información confidencial. Son propiedades adicionales que necesitan sus propias pruebas.
Amenazas específicas de la IA
El envenenamiento de datos manipula los datos usados para entrenar o actualizar un modelo, alterando su comportamiento o introduciendo un fallo dirigido. La inversión de modelos intenta inferir información sensible sobre los datos subyacentes a partir del comportamiento o las respuestas del modelo. Lo que se recupera depende del ataque y del modelo; no debe suponerse que permite reproducir todos los registros de entrenamiento.
El robo de modelos incluye la adquisición o reproducción no autorizada de un modelo entrenado. Los ejemplos adversarios son entradas construidas para engañarlo, a veces mediante cambios difíciles de percibir para una persona.
Una actualización envenenada puede introducir código malicioso o modificar el comportamiento mediante una vía de actualización comprometida. La filtración de información ocurre cuando una respuesta revela información sensible de la entrada o del entrenamiento. Estos riesgos convierten la integridad de los datos, modelos y procesos en una preocupación continua, no en una comprobación única al admitir una conexión.
Aplicar confianza cero al ciclo de vida de la IA
Área
Cuestión general de confianza cero
Aplicación específica a la IA en esta colección
Principio central
No conceder confianza implícita por ubicación o propiedad
No suponer que los datos, modelos o resultados son fiables porque proceden de un proceso interno
Recursos protegidos
Activos, servicios, identidades y flujos de trabajo
Conjuntos de datos, trabajos de entrenamiento, artefactos, almacenes de recuperación y servicios de inferencia
Autorización
Conceder a una identidad verificada solo el acceso necesario
Vincular cada trabajo a datos, operación, entorno de ejecución y destino de salida aprobados
Supuestos de confianza
Reevaluar el acceso cuando cambia el contexto
Reevaluar cambios en datos, dependencias, modelos y condiciones de despliegue
Controles de apoyo
Identidad, segmentación, mínimo privilegio y supervisión
Añadir procedencia de datos, integridad del modelo, evaluación adversaria y revisión de resultados según el riesgo
Amenazas
Acceso no autorizado, movimiento lateral y abuso interno
Considerar también envenenamiento, extracción, entradas adversarias, actualizaciones inseguras, divulgación y uso de IA no aprobado
Ciclo operativo
Aplicar la política al recurso y a su uso
Integrar controles en recopilación, entrenamiento, evaluación, despliegue, supervisión y reentrenamiento
La cuestión práctica no es solo quién puede consultar un modelo. También importa quién puede cambiar el procesamiento, qué información puede utilizar y qué pueden revelar sus resultados. MLOps como base de la IA de confianza cero explica cómo un ciclo de vida trazable permite implantar estos controles. La secuencia completa está en la colección técnica de ZTAI.
Hacer trazables los datos, el código, los experimentos y las publicaciones.
Leer capítulo: MLOps como base de la IA de confianza cero
La IA de confianza cero necesita algo más que herramientas de seguridad alrededor de un modelo. Si los datos, el código, los experimentos, los artefactos y los despliegues no pueden seguirse y controlarse, la verificación continua queda en una declaración de intenciones. MLOps aporta los procesos de ingeniería que permiten llevar esa política a la práctica.
Las operaciones de aprendizaje automático, o MLOps, reúnen ciencia de datos, ingeniería de software y operaciones para construir y mantener modelos fiables en producción. Abarcan todo el ciclo de vida, incluidos los cambios posteriores al despliegue.
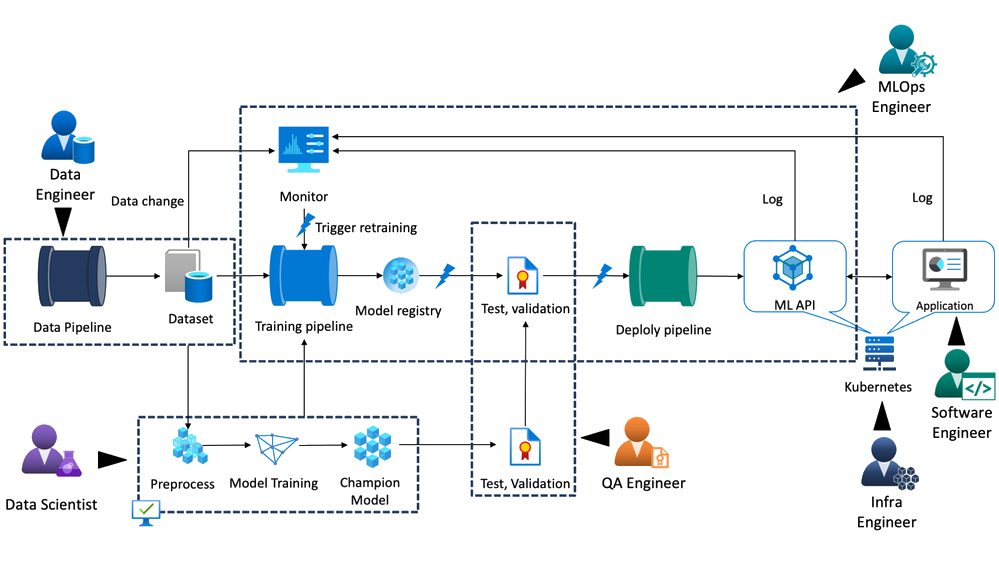
Los requisitos operativos van más allá del entrenamiento: también hay que gestionar artefactos, infraestructura, acceso y entrega continua. Etiquetas en inglés.
La relación entre MLOps y DevOps
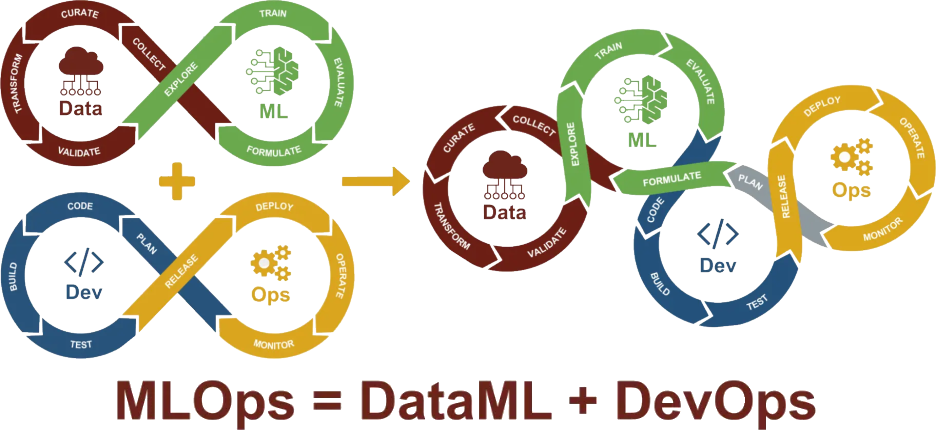
DevOps automatiza y supervisa el desarrollo de software desde la programación y la compilación hasta las pruebas, la publicación, el despliegue y la operación. MLOps aplica estas prácticas a otras etapas: recopilar y explorar datos, prepararlos, entrenar un modelo, evaluarlo y observar su comportamiento en uso.
Ambos buscan mejorar la velocidad de entrega, la calidad y la fiabilidad operativa. El aprendizaje automático añade dependencias menos prominentes en el software convencional. El comportamiento de un modelo depende de sus datos de entrenamiento; los cambios de datos pueden exigir reentrenamiento; y los artefactos resultantes necesitan gestión junto con el código de la aplicación.
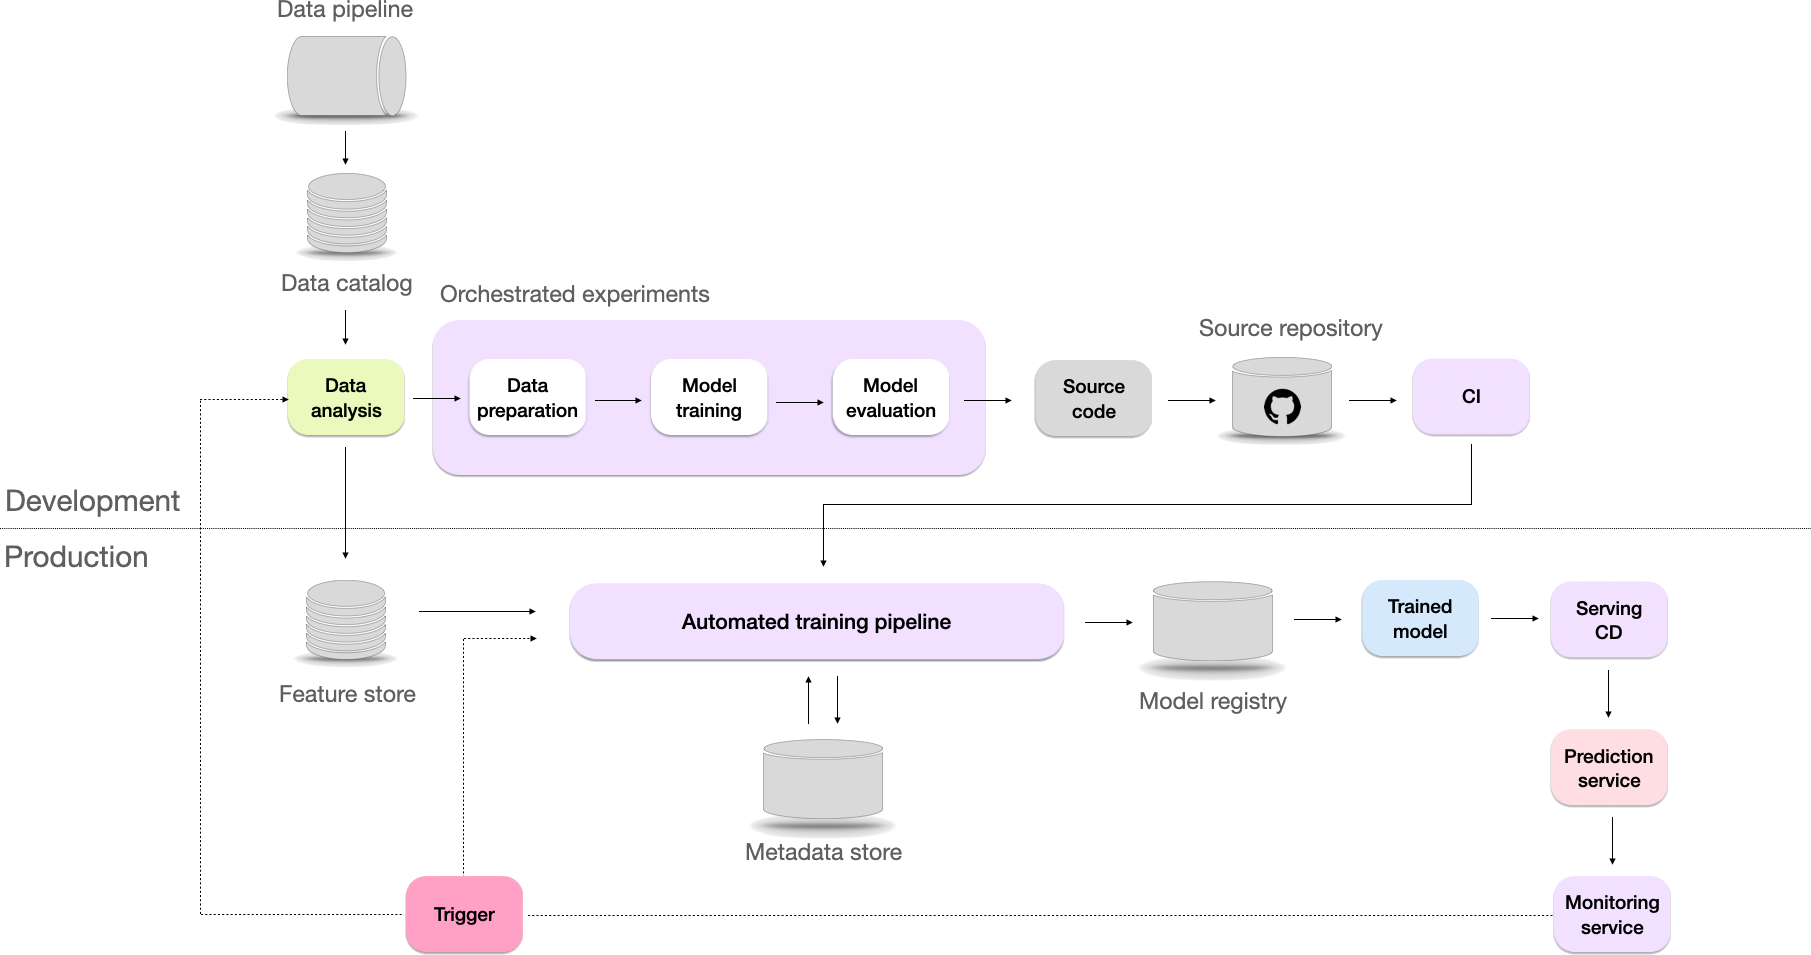
MLOps conecta el trabajo de datos y aprendizaje automático con la entrega de software. Etiquetas en inglés.
Por qué importa la base operativa
El primer beneficio es acortar el camino de la investigación a la producción. La automatización reduce el trabajo manual necesario para convertir un experimento en un servicio. Las etapas estandarizadas también reducen errores evitables, y la supervisión facilita detectar problemas. Publicar más rápido solo resulta útil si la organización puede comprender y gestionar lo que publica.
El segundo beneficio es la escala. Sin un proceso compartido, cada modelo se convierte en un proyecto independiente que depende de personas concretas y sus herramientas locales. Un ciclo de vida común permite repetir el entrenamiento, el despliegue y el mantenimiento entre modelos y equipos.
El tercer beneficio es la gobernanza. La organización necesita reconstruir qué datos, código y configuración produjeron un modelo, qué evaluación respaldó su publicación y qué versión atiende una solicitud. Esta evidencia sirve tanto para las revisiones de seguridad y privacidad como para investigar incidentes operativos. Debe mantenerse durante el reentrenamiento y la sustitución, no terminar en el primer despliegue.
Las partes principales del ciclo de vida
La gestión de datos incluye recopilación, limpieza, ingeniería de características, versiones y catálogo. La gestión de código y configuración sigue el código del modelo, los scripts de entrenamiento, las dependencias y los parámetros. El entrenamiento y la validación organizan experimentos, selección de hiperparámetros, evaluación y aprobación en un proceso repetible y progresivamente automatizable.
Después, el modelo entrenado debe almacenarse, versionarse y vincularse con la evidencia que lo respalda. Un registro puede relacionar un artefacto con su código fuente, referencias a los datos, resultados experimentales y estado de publicación. Los controles de despliegue gobiernan cómo llega ese artefacto a un servidor, un servicio API o un dispositivo de borde.
Tras el despliegue, la supervisión comprueba el rendimiento, los cambios en la distribución de las entradas y las señales de que el modelo ya no se ajusta al uso previsto. La retroalimentación incorpora nueva evidencia operativa al siguiente ciclo de desarrollo o entrenamiento. Un evento que activa el reentrenamiento debe conducir a través de los controles de validación y publicación exigidos; no concede permiso para sustituir el modelo de producción sin ellos.
La seguridad y la gobernanza atraviesan todas estas actividades. Las políticas de acceso, las reglas de conservación, la integridad de los artefactos y los requisitos de aprobación no pueden aplazarse hasta una revisión final, después de que el proceso ya haya expuesto datos sensibles.
Cómo ayuda MLOps a ZTAI
MLOps no equivale por sí mismo a confianza cero. Crea un ciclo de vida observable y estructurado en el que pueden aplicarse decisiones de seguridad.
Las versiones de datos, código y experimentos permiten evaluar procedencia e integridad. Una vía definida de publicación ofrece un punto donde admitir o rechazar un artefacto. La supervisión aporta evidencia para reevaluar un despliegue después de su aprobación inicial. En conjunto, estas capacidades extienden la verificación más allá del inicio de sesión y la incorporan a la operación del servicio.
También hacen visibles los límites. Registrar el origen de un modelo no demuestra que sus datos de entrenamiento sean benignos. Automatizar un proceso no elimina los privilegios de quienes pueden cambiar su código o inspeccionar sus resultados. Para resolver esas cuestiones, los principios y controles de ZTAI deben formar parte del diseño del flujo de trabajo.
La mayoría de las organizaciones construye esta capacidad gradualmente. El modelo de madurez de ZTAI describe una progresión desde el trabajo manual aislado hasta operaciones automatizadas con separación entre desarrollo y procesamiento sensible en producción. Su última etapa añade un objetivo arquitectónico: el trabajo rutinario no debería exigir que las personas manipulen datos sensibles en bruto. Alcanzarlo depende de controlar tanto las vías de acceso indirecto como las directas.
Avanzar del trabajo manual a la automatización controlada.
Leer capítulo: Un modelo de madurez para la IA de confianza cero
Una organización no puede pasar de cuadernos dispersos y conjuntos de datos copiados manualmente a un ciclo de vida de IA controlado en un solo paso. Primero necesita saber cómo se construyen y publican sus modelos; después, hacer repetible ese proceso; y finalmente, aplicar restricciones sobre quién puede utilizar información sensible en cada etapa.
El modelo siguiente describe esta progresión mediante cinco niveles, del 0 al 4. Su base operativa es MLOps. El objetivo adicional de ZTAI es rediseñar el procesamiento rutinario para que las personas puedan definir una tarea y evaluar sus resultados sin tener que ver, mover o manipular repetidamente datos sensibles en bruto.
Esta es la interpretación arquitectónica utilizada en la colección. Se apoya en la progresión por etapas del modelo de madurez de confianza cero de CISA y en el modelo de madurez MLOps de Microsoft. Los cinco niveles de ZTAI que se presentan aquí no constituyen una escala oficial de CISA ni un esquema de certificación. En particular, las restricciones de acceso a datos propuestas en el nivel 4 son un objetivo adicional de diseño de seguridad, no una garantía derivada de una calificación de madurez MLOps.
Los niveles 0 a 3 establecen un control operativo progresivamente mejor. Son bases útiles para la confianza cero, pero ninguno demuestra que el sistema ya la aplique. Una organización también puede reunir capacidades de varios niveles a la vez: entrenamiento automatizado en un equipo, despliegue manual en otro y una vía de mantenimiento sin control que atraviesa ambos.
Nivel 0: trabajo manual y aislado
En el nivel 0, científicos de datos, ingenieros de datos e ingenieros de software trabajan en gran medida por separado. La colaboración consiste en intercambiar archivos e instrucciones. No existe un proceso compartido y fiable que conecte la preparación de datos con la aplicación en producción.
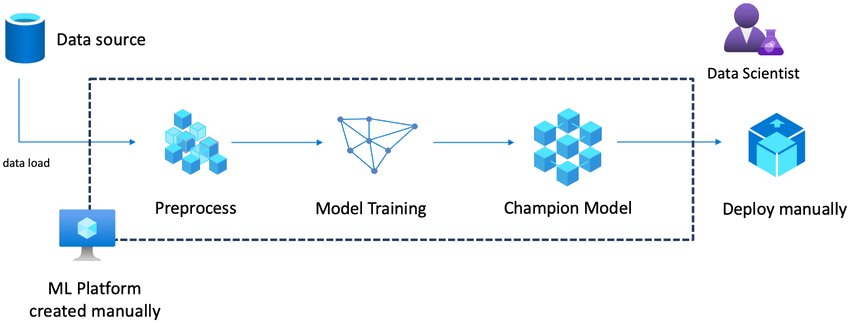
Los datos se recopilan manualmente y el entorno de cómputo puede ser una estación de trabajo o un servidor sin gestión centralizada. Los experimentos no se registran de forma sistemática. Un experimento satisfactorio produce un archivo de modelo, a menudo sin un registro completo de sus datos, parámetros, dependencias y entorno.
La publicación también es manual. El script de inferencia puede escribirse después de experimentar y quedar fuera del control de versiones. Una sola persona puede acabar decidiendo si el modelo está listo, entregándolo y explicando cómo ejecutarlo. El equipo de la aplicación depende mucho de sus conocimientos.
Nivel 0: un experimento puede producir un modelo, pero el ciclo de vida depende del trabajo manual y del conocimiento individual. Etiquetas en inglés.
Reproducir resultados resulta difícil. La diversidad de herramientas y los ajustes sin documentar impiden comparaciones fiables, y los cambios de datos pueden confundirse con cambios de código. La información sensible puede dispersarse por entornos personales sin un registro claro. También es difícil coordinar las GPU compartidas y otros recursos escasos.
La mejora inmediata consiste en hacer visible el trabajo: versionar el código, registrar las entradas y los experimentos, definir una entrega repetible y establecer quién responde de la publicación. Añadir un producto de seguridad alrededor de un flujo sin documentar no aporta la evidencia que falta.
Nivel 1: mejora la entrega de software, pero el trabajo del modelo sigue separado
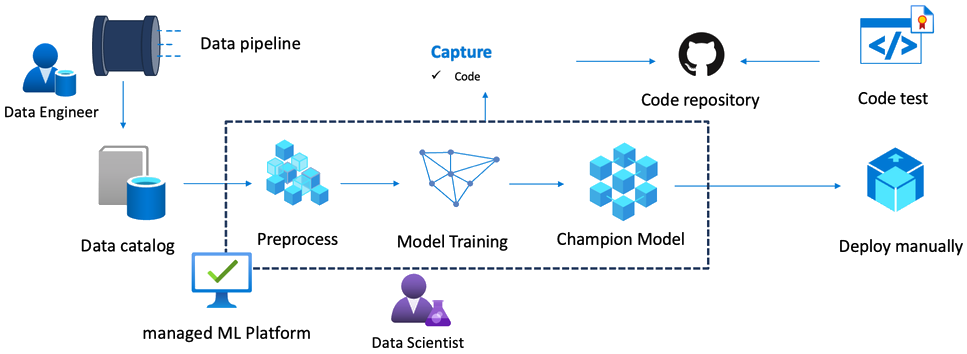
En el nivel 1 se automatizan partes de los procesos de datos y software. La recopilación puede seguir una canalización y el código se guarda en un repositorio. Los ingenieros de software reciben una entrega más clara del equipo de datos y pueden automatizar las compilaciones, las pruebas y el empaquetado de la aplicación.
El desarrollo del modelo sigue dependiendo de experimentos manuales y entornos parcialmente gestionados. La preparación de datos y el entrenamiento pueden no ser reproducibles a partir de una única especificación registrada. El equipo crea manualmente scripts de evaluación o inferencia, aunque ahora los versiona. Publicar un modelo nuevo todavía exige la intervención directa del equipo de datos.
Nivel 1: el control de versiones y la entrega de software mejoran la coordinación, mientras el ciclo del modelo continúa siendo parcialmente manual. Etiquetas en inglés.
Esto reduce algunas dificultades de publicación, pero las pruebas de la aplicación no establecen la calidad del modelo. El software puede iniciarse correctamente y aceptar solicitudes mientras el modelo funciona mal con entradas reales. La retroalimentación de producción sigue siendo limitada, y el historial experimental puede no explicar por qué un modelo sustituyó a otro.
La seguridad continúa dependiendo de que las personas manejen los datos con cuidado. Las copias sin control, los permisos amplios y la asignación informal de GPU pueden persistir aunque las compilaciones estén automatizadas. El siguiente paso es incorporar el entrenamiento y su evidencia a un proceso gestionado.
Nivel 2: entrenamiento automatizado y trazable
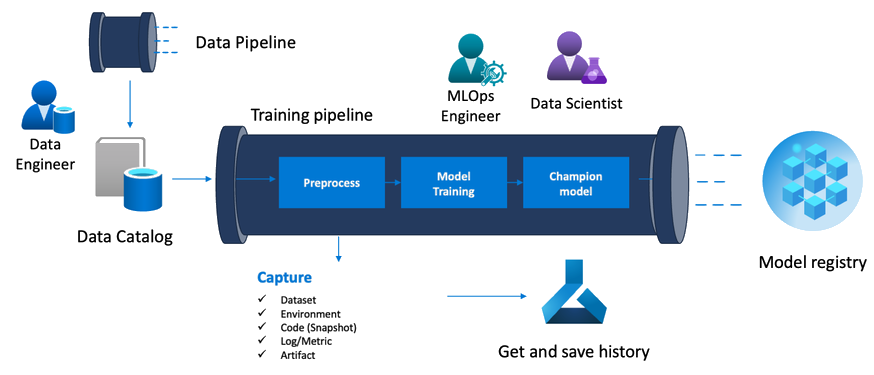
En el nivel 2, los ingenieros y científicos de datos colaboran mediante una canalización de entrenamiento automatizada. La ingesta y el procesamiento se ejecutan en un entorno gestionado. Se registran parámetros, resultados y artefactos de los experimentos, y el registro de modelos proporciona una entrega estable al equipo de la aplicación.
El código, las referencias a los datos y las versiones del modelo y de la aplicación pueden relacionarse entre sí. Los resultados de evaluación se almacenan con el modelo, en vez de quedar en un documento aparte o en el cuaderno de una persona. Se puede reproducir un modelo con mucha mayor fiabilidad y seguir un cambio hasta sus entradas.
Nivel 2: el entrenamiento se vuelve repetible y sus artefactos adquieren un historial trazable. Etiquetas en inglés.
La publicación todavía puede ser manual. Los ingenieros de software pueden recibir el modelo a través de una interfaz fiable sin participar de cerca en su entrenamiento. Es una mejora respecto al intercambio de archivos, pero la conexión entre la evaluación del modelo y la calidad del producto completo puede seguir siendo débil.
Un entorno de entrenamiento bien gestionado tampoco resuelve todas las cuestiones de gobernanza. ¿Quién puede cambiar el código? ¿Quién puede inspeccionar los datos, descargar un punto de control o aprobar el despliegue? La planificación de recursos y el despliegue en varias máquinas pueden seguir requiriendo trabajo específico. La trazabilidad facilita responder a estas preguntas; no las responde automáticamente.
Nivel 3: despliegue automatizado del modelo
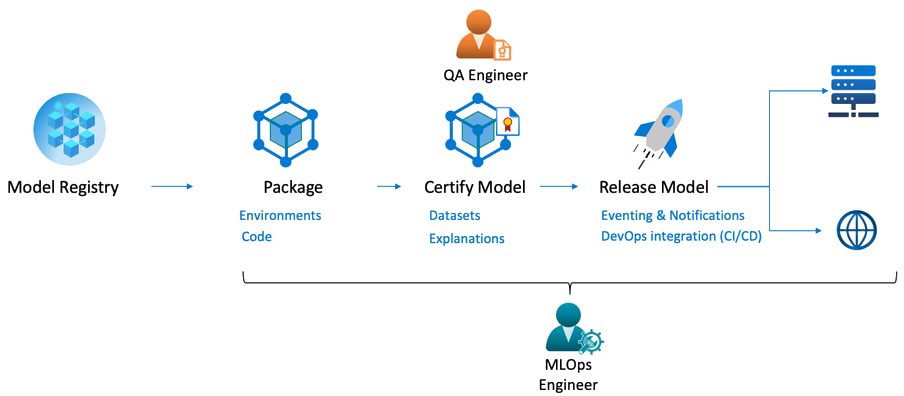
En el nivel 3, la ciencia de datos, la ingeniería de datos y la ingeniería de software forman parte de un proceso de entrega conectado. El entrenamiento utiliza datos y recursos gestionados, los experimentos y evaluaciones están versionados, y las publicaciones siguen una canalización de despliegue automatizada.
El modelo se empaqueta junto con su entorno y la evidencia necesaria para publicarlo. Las pruebas cubren el código y la integración del modelo, mientras que el aseguramiento de la calidad tiene un papel definido en la decisión de qué llega a producción. La evaluación puede combinar comprobaciones automáticas con revisión humana de los criterios que todavía no pueden evaluarse por máquina con fiabilidad.
Nivel 3: el despliegue se integra en el ciclo de vida controlado y deja de ser una entrega manual independiente. Etiquetas en inglés.
La organización puede seguir el modelo desplegado hasta el proceso que lo creó. También puede hacer explícitos los criterios de publicación y aplicarlos de forma coherente. Esto mejora la capacidad de investigar un fallo y volver a una versión anterior.
La carencia que suele quedar es el ciclo de retroalimentación. Un despliegue puede superar las pruebas sin ofrecer la experiencia de uso deseada, y la canalización puede no convertir todavía la evidencia de producción en un reemplazo validado. La entrega automatizada no garantiza continuidad del servicio, reparto eficiente de GPU ni confidencialidad. El acceso amplio de los administradores y los canales de salida permisivos pueden seguir intactos bajo un proceso de publicación eficiente.
Nivel 4: un ciclo conectado con límites efectivos
En el nivel 4, los datos, el entrenamiento, la evaluación, el despliegue y la supervisión forman un ciclo operativo conectado. Los cambios pertinentes pueden activar un nuevo entrenamiento. El modelo resultante pasa por validación y por la política de publicación antes de sustituir una versión de producción. La retroalimentación se registra y se utiliza para mejorar decisiones posteriores.
La integración, entrega y entrenamiento continuos —CI/CD/CT— sostienen este ciclo. Las pruebas unitarias, de integración y del comportamiento observable desde el exterior aportan evidencias distintas. La supervisión humana sigue siendo responsable de la finalidad del sistema, los criterios que debe cumplir y las excepciones que puede aceptar.
El nivel 4 conecta la retroalimentación de producción con el entrenamiento y la publicación. La automatización sigue sujeta a validación y autorización. Etiquetas en inglés.
Para ZTAI, el paso adicional importante es eliminar el manejo humano innecesario de datos sensibles. Los desarrolladores definen y prueban un proceso; una ejecución aprobada utiliza los datos reales en un entorno controlado. La organización debe imponer esa separación, no limitarse a pedir que los desarrolladores eviten mirar los registros.
Se trata de un objetivo de diseño, no de una afirmación de seguridad máxima. Un trabajo automatizado puede filtrar información mediante registros, archivos del modelo o respuestas de API. Un administrador de infraestructura puede conservar la capacidad de inspeccionar memoria. Los controles necesarios para abordar estas vías se desarrollan en Si las personas no pueden ver los datos, ¿se ha eliminado realmente su acceso?.
Separar el desarrollo del procesamiento sensible en producción
Una disposición útil del nivel 4 proporciona a los desarrolladores datos públicos, sintéticos o debidamente desidentificados para el trabajo habitual. La canalización de producción utiliza datos sensibles en un entorno con gobernanza separada. Los conjuntos sintéticos y desidentificados también necesitan una evaluación del riesgo de divulgación; esas etiquetas no bastan para autorizar su entrega.
El desarrollo define el procesamiento. Producción ejecuta la versión aceptada sobre datos controlados y conserva la evidencia requerida. Etiquetas en inglés.
La separación puede organizarse en cuatro fronteras:
Preparación de datos. Los desarrolladores definen las transformaciones. La ejecución aprobada recopila y prepara los datos reales bajo controles de acceso y procedencia.
Entrenamiento. Una versión especificada del código y sus parámetros se ejecuta en un entorno autorizado. Los artefactos entran en un registro controlado y la supervisión documenta las condiciones que pueden justificar un reentrenamiento.
Evaluación. Las comprobaciones automáticas y, cuando sea necesario, la revisión humana evalúan los resultados mediante interfaces aprobadas. La evaluación no se convierte en una vía irrestricta hacia muestras reales.
Despliegue. Un modelo aceptado se expone mediante el servicio previsto. El equipo de la aplicación consume ese servicio sin recibir automáticamente los datos de entrenamiento o los archivos de pesos.
Estas fronteras están relacionadas. Una política que gobierna la entrada al entrenamiento, pero ignora el informe de evaluación o la descarga del modelo, deja abierta una vía de acceso indirecto. Los permisos de publicación deben aplicarse a todo resultado que alguien pueda recibir.
Una variante limitada para entornos aislados
Algunas cargas sensibles o de misión crítica no admiten una plataforma permanentemente conectada ni una pila completa de CI/CD/CT. Las restricciones de red, las condiciones operativas y el coste pueden exigir una solución más reducida: desarrollar con datos no sensibles, transferir una especificación de procesamiento aceptada a través de una frontera controlada y realizar el entrenamiento final dentro de un entorno aislado.
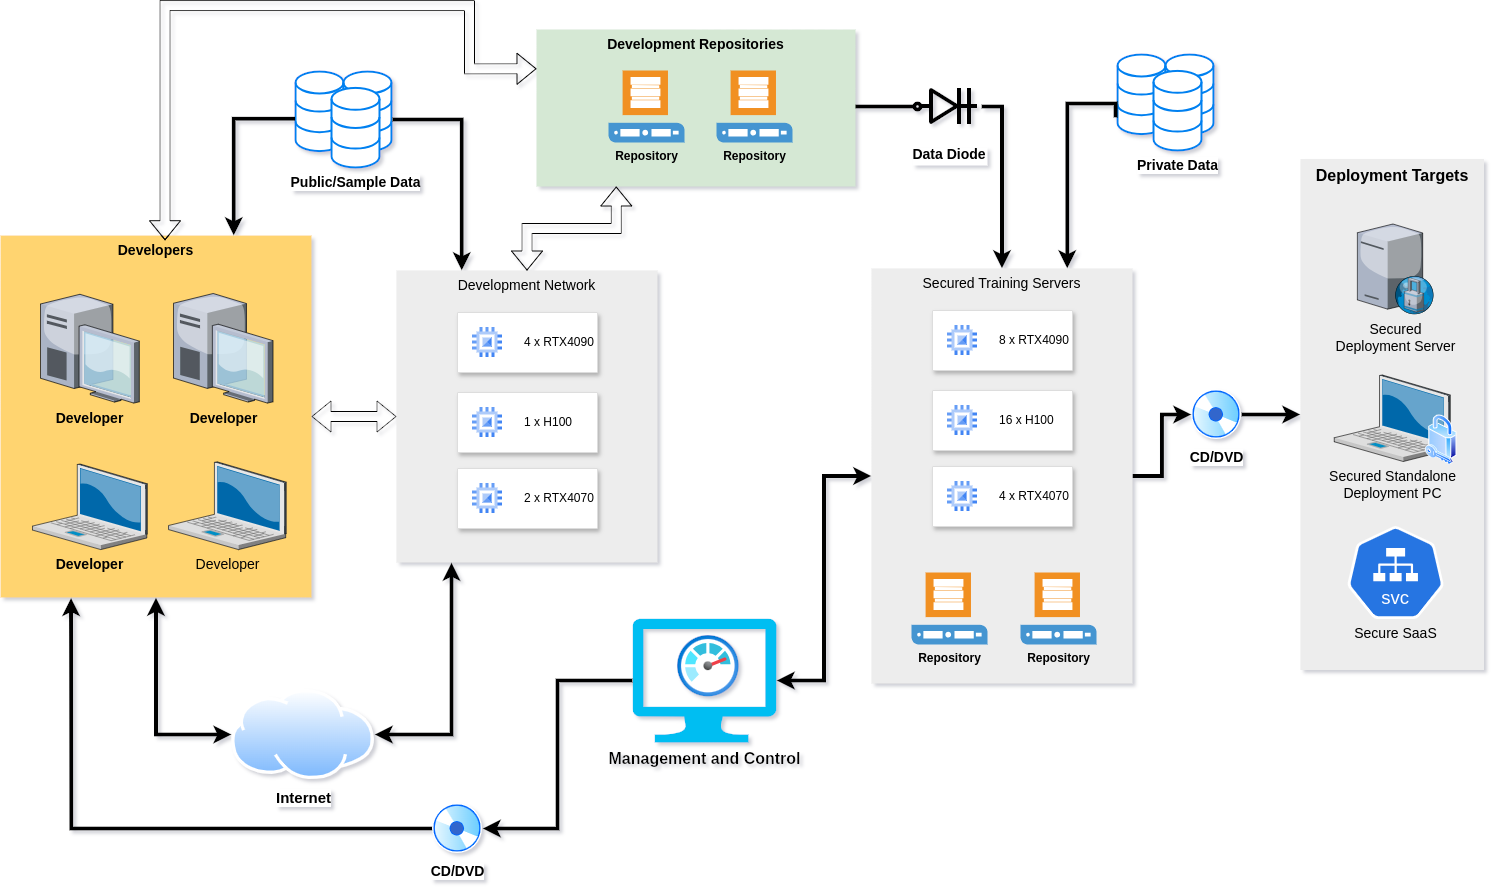
Una variante conceptual para entornos aislados o sometidos a controles estrictos. Su idoneidad depende de los flujos necesarios y del modelo de amenazas. Etiquetas en inglés.
El objetivo arquitectónico puede mantenerse con menos automatización. El desarrollo rutinario no debería exigir que el conjunto sensible abandone su entorno protegido. Sin embargo, el aislamiento, un mecanismo de transferencia unidireccional o un trabajo automatizado no protegen por sí solos los datos en claro frente a cualquier administrador privilegiado. El diseño debe declarar en qué administradores confía, qué permiten sus privilegios y qué evidencia respalda una afirmación más fuerte.
La misma disciplina se aplica al mantenimiento. Si cada fallo difícil exige exportar un volcado de memoria o conceder acceso sin restricciones, la separación desaparecerá en la práctica. Las herramientas de desarrollo, diagnóstico y recuperación forman parte de la arquitectura de seguridad.
Comparación de los niveles
Nivel
Capacidad principal
Actividades habituales
Cuestiones pendientes
0
Trabajo manual y aislado
Experimentos individuales y entregas mediante archivos
Poca reproducibilidad, responsabilidades imprecisas, copias y recursos sin control
1
Prácticas de entrega de software
Código versionado, pruebas de aplicación y publicaciones más organizadas
Desarrollo y retroalimentación del modelo dependientes de personas
2
Entrenamiento automatizado
Entornos gestionados, seguimiento de experimentos y registro de modelos
Publicación manual, retroalimentación incompleta del producto y políticas de acceso sin resolver
3
Despliegue automatizado
Equipos conectados, pruebas de publicación y promoción trazable
Retroalimentación, continuidad y confidencialidad necesitan diseño explícito
4
Ciclo conectado con un objetivo de separación ZTAI
CI/CD/CT controlado, retroalimentación supervisada y separación entre desarrollo y procesamiento sensible
Hay que aplicar y auditar controles sobre acceso indirecto, privilegios administrativos, publicación de resultados y excepciones
La responsabilidad humana no desaparece al aumentar el nivel. Las personas siguen decidiendo para qué sirve el sistema, qué riesgos son aceptables y cuándo debe detenerse. El objetivo es reducir el contacto innecesario con datos en bruto y hacer más claras las decisiones y sus responsables.
Utilice el modelo para identificar la siguiente capacidad que falta en un flujo de trabajo real. Una etiqueta de nivel superior aporta menos que la evidencia de que una vía antes descontrolada ahora está gobernada. El siguiente artículo relaciona ese trabajo con los principios y controles prácticos de ZTAI; la página de la colección reúne toda la secuencia.
Aplicar políticas de identidad, datos, modelos y resultados.
Leer capítulo: IA de confianza cero: principios y controles prácticos
El modelo de madurez de ZTAI describe cómo avanzar hacia un ciclo de vida de IA controlado. Esa progresión necesita controles concretos: qué se verifica, qué acción se autoriza, dónde se aplica una decisión y qué ocurre cuando dejan de cumplirse las condiciones exigidas.
La IA de confianza cero, tal como se desarrolla en esta colección, aplica la confianza cero a los datos, modelos y flujos de trabajo de IA. Los principios siguientes deben interpretarse frente a un modelo de amenazas explícito. Un control que limita a un desarrollador no limita necesariamente al administrador de infraestructura, y verificar el origen de un artefacto no demuestra que su comportamiento sea seguro.
Verificar explícitamente y reevaluar el acceso
Cada solicitud de uso de datos, modelos o recursos de cómputo debe vincularse con una identidad verificada y una finalidad autorizada. No basta con estar dentro de la red, pertenecer al equipo de desarrollo o ejecutarse como servicio interno.
La verificación continúa durante todo el ciclo de vida. Los datos cambian, los modelos se sustituyen, las dependencias evolucionan y el comportamiento de usuarios y cargas de trabajo puede variar. Una decisión tomada al crear una cuenta no puede servir de aprobación permanente para todos sus usos posteriores.
La identidad del solicitante es solo una parte de la decisión. El contexto pertinente puede incluir los datos, la operación, la versión del software, el entorno de ejecución, el destino del resultado y la duración del acceso. Un entrenamiento autorizado para ciertos datos y una ubicación de salida no debería heredar permiso para procesar otros datos o escribir resultados donde quiera.
Conceder solo el acceso necesario para la tarea
El mínimo privilegio se aplica a personas, servicios, trabajos de entrenamiento y cargas de inferencia. Los roles son un punto de partida, pero la decisión también puede depender de atributos como la sensibilidad de los datos, el riesgo actual y la operación solicitada.
Un científico de datos no necesita necesariamente acceso irrestricto a cada registro original. Los esquemas, las distribuciones, las estadísticas aprobadas y las muestras de desarrollo seleccionadas con cuidado pueden permitir una parte importante del trabajo. Los desarrolladores pueden definir el preprocesamiento y los parámetros de entrenamiento mientras una canalización autorizada realiza el procesamiento sensible en otro entorno.
Separar el desarrollo del procesamiento sensible reduce la necesidad de acceso directo. Las vías del código, los resultados y la administración siguen necesitando controles propios. Etiquetas en inglés.
Esta disposición requiere un proceso de desarrollo utilizable. Si los desarrolladores no pueden inspeccionar un esquema, reproducir un fallo o evaluar un modelo mediante interfaces aprobadas, necesitarán excepciones repetidamente. Las capacidades operativas descritas en MLOps como base de ZTAI ayudan a que el mínimo privilegio sea viable.
El permiso para definir el procesamiento también necesita límites. Quien puede ejecutar código arbitrario sobre datos sensibles y recibir resultados arbitrarios puede reconstruir el acceso que la arquitectura pretendía eliminar. El artículo sobre acceso indirecto a los datos examina esta combinación en detalle.
Suponer que un componente puede verse comprometido
Diseñe para una cuenta comprometida, datos manipulados, una dependencia insegura o un artefacto de modelo malicioso. El sistema necesita contener el efecto, conservar evidencia útil y permitir la recuperación.
Los datos sensibles deben permanecer detrás de interfaces controladas y fronteras de procesamiento explícitas. Ingenieros y administradores no deberían adquirir acceso irrestricto por el carácter operativo de su función. Cuando la arquitectura confíe en un administrador, debe declarar ese supuesto; cuando pretenda excluirlo, la tecnología subyacente debe sostener esa frontera más exigente.
La segmentación limita el alcance de un componente comprometido. Autorizar por separado los cambios de política, la ejecución de trabajos y la publicación de resultados también dificulta que un único rol comprometido elimine sus propias restricciones. Estas protecciones deben sobrevivir a cambios y fallos rutinarios, no aplicarse únicamente al recorrido ideal de un diagrama.
Revisar los resultados según sus consecuencias
Las respuestas de los modelos necesitan distintos niveles de verificación según su uso. Un resumen interno de consecuencias limitadas puede admitir comprobaciones automáticas ligeras. Una recomendación que influye en una decisión del personal puede necesitar revisión humana. Las decisiones dirigidas a clientes, financieras, clínicas u operativas pueden exigir validación más sólida, trazabilidad y aprobación explícita.
Importa quién actuará a partir del resultado, qué podría salir mal y si la decisión puede revertirse. Los datos de origen, la versión del modelo y el historial de revisión deben estar disponibles con el detalle que requiera ese riesgo.
Una respuesta fluida no demuestra exactitud, y una respuesta exacta puede divulgar información que su destinatario no está autorizado a recibir. La revisión de calidad y los controles de confidencialidad evalúan propiedades relacionadas, pero diferentes.
Mejorar la revisión mediante retroalimentación
Las decisiones de revisión pueden revelar patrones de fallo recurrentes. Registrarlos ayuda a mejorar pruebas, afinar políticas y reducir tareas manuales repetitivas. Algunas comprobaciones de bajo riesgo podrán automatizarse con el tiempo, mientras los casos difíciles o de mayores consecuencias seguirán sujetos al juicio humano.
La retroalimentación debe entrar en un proceso de mejora controlado. La actuación de un revisor no es automáticamente una etiqueta de entrenamiento fiable, y una corrección en producción no debe modificar silenciosamente un modelo o una política de publicación. Los cambios necesitan evaluación antes de afectar a decisiones posteriores. La automatización debe hacer la revisión más coherente sin convertir un ciclo de retroalimentación sin examinar en otra fuente de errores.
Proteger los datos durante todo su ciclo de vida
Proteger el almacenamiento y el tráfico de red es necesario, pero la información sensible también puede quedar expuesta durante el procesamiento. El cifrado en reposo y en tránsito responde a amenazas distintas de la protección durante la ejecución. La computación confidencial y los enfoques criptográficos como el cifrado homomórfico tienen capacidades, costes de rendimiento y supuestos de confianza diferentes; la elección debe ajustarse a la carga de trabajo.
El desarrollo y las pruebas deben utilizar datos cuyo riesgo de divulgación haya sido evaluado. El enmascaramiento, la desidentificación y la generación sintética pueden reducir la exposición, pero su eficacia depende de la transformación y de la información conservada. Considerar público cualquier conjunto transformado debilitaría la separación entre desarrollo y producción.
Los registros de procedencia e integridad ayudan a establecer de dónde vienen los datos y si han cambiado. Los artefactos firmados, los hashes y los registros de auditoría protegidos respaldan esa evidencia. No demuestran que la fuente original fuera veraz ni que un conjunto correctamente firmado esté libre de envenenamiento.
La clasificación también debe acompañar a los artefactos derivados. Un resultado debe conservar las restricciones pertinentes de sus entradas, salvo que una decisión controlada de publicación justifique otro tratamiento. Esto incluye estadísticas, representaciones vectoriales, conjuntos sintéticos, puntos de control y modelos, no solo archivos con registros reconocibles.
Proteger el modelo y su mecanismo de carga
Los artefactos de modelos necesitan control de acceso, verificación de integridad y, cuando corresponda, cifrado. Sus API requieren acceso autenticado y autorizado, además de supervisión de abuso o intentos de extracción. La evaluación debe incluir las condiciones adversarias pertinentes para la aplicación prevista.
El entrenamiento adversario y la limitación del dominio de operación pueden mejorar la robustez frente a amenazas concretas. Ninguno demuestra resistencia a todos los ataques. El sistema debe seguir restringiendo a qué puede acceder el modelo y qué acciones pueden provocar sus resultados.
La incorporación de modelos merece especial atención. Descargar un archivo de pesos también puede introducir una ruta de deserialización insegura, código personalizado o dependencias sin revisar. Un proceso de admisión controlado debe inspeccionar el paquete, restringir su ejecución y aceptar solo los formatos y capacidades necesarios para el despliegue.
Convertir un artefacto a un formato como SafeTensors puede evitar posteriormente la dependencia de una serialización ejecutable, pero la conversión no es segura si primero carga un formato ejecutable no fiable en un entorno privilegiado. La inspección y conversión deben tratarse como procesamiento aislado, con recursos limitados, de entradas no fiables. Un formato de pesos más seguro tampoco demuestra que el comportamiento del modelo sea benigno ni vuelve fiable el código que lo acompaña.
Las técnicas de defensa mediante objetivos móviles, incluidos los cambios destinados a dificultar el sondeo de un modelo, necesitan pruebas de su beneficio y de su efecto sobre la calidad. No deben sustituir a los controles de acceso establecidos ni presentarse como solución general al robo de modelos y los ataques adversarios.
Proteger la infraestructura y el proceso operativo
Separe los entornos de desarrollo, entrenamiento e inferencia según sus necesidades de acceso y las consecuencias de un compromiso. Supervise la actividad de red, el uso de API y el comportamiento de los modelos para detectar extracción, abuso o servicios de IA no aprobados. Estos registros también pueden contener información sensible y necesitan controles de acceso y conservación.
Utilice autenticación robusta, incluida la autenticación multifactor cuando corresponda para las personas. Los servicios automatizados necesitan identidades de carga de trabajo verificables y credenciales de alcance limitado, preferiblemente con vigencia reducida. Los mecanismos de autenticación humana no sustituyen a una identidad de máquina bien diseñada.
Un motor de políticas como Open Policy Agent permite expresar reglas de autorización y aplicarlas de forma coherente. Su independencia depende de quién puede modificar la política, desplegar el motor u obtener sus credenciales administrativas y de firma. Ejecutarlo como servicio separado no sirve si la carga de procesamiento puede reescribir sus reglas.
El trabajo de seguridad pertenece al proceso de CI/CD: revisión de dependencias, aplicación de parches, análisis estático y dinámico, comprobaciones de artefactos y procedimientos de incidentes ensayados. El modelado de amenazas debe considerar las fronteras entre la organización, los operadores de su plataforma y los proveedores externos. Cada parte necesita una responsabilidad clara sobre los controles que realmente opera.
La supervisión y el análisis de incidentes asistidos por IA pueden ayudar a identificar patrones o priorizar trabajo. Sus recomendaciones siguen necesitando validación y límites de acceso adecuados. Conceder amplios poderes de actuación a un asistente de seguridad crea otra carga de trabajo cuya autoridad hay que gobernar.
Las decisiones de hardware y plataforma también importan. Los artículos sobre GPU y servidores en español explican por qué el entorno operativo, las interfaces y la configuración admitida de un servidor deben evaluarse junto con sus aceleradores.
Introducir los controles en una organización existente
Las dificultades no se limitan a elegir herramientas. Los equipos pueden carecer de conocimientos especializados, los sistemas heredados pueden no ofrecer fronteras útiles para aplicar políticas y las prácticas establecidas pueden depender del acceso irrestricto a datos reales. Reconstruir canalizaciones y proporcionar entornos de desarrollo seguros requiere tiempo y dinero.
Una introducción por etapas debe empezar por un flujo concreto y sus vías de acceso de mayores consecuencias. Establezca la evidencia necesaria para entenderlo; después reduzca privilegios amplios, controle las vías de publicación y pruebe cómo se comportan las restricciones durante el mantenimiento. Los sistemas existentes pueden necesitar cambios arquitectónicos antes de que sea realista formular afirmaciones más exigentes.
ZTAI combina de forma continua políticas, ingeniería, operaciones y revisión. Una prueba útil consiste en comprobar si la organización puede explicar una decisión de acceso concreta, mostrar dónde se aplicó y demostrar qué sucede cuando fallan las condiciones requeridas. El último artículo de la colección aplica esa prueba a la difícil afirmación de que las personas ya no tienen acceso a los datos sensibles.
Examinar cambios de código, publicación de resultados y poderes administrativos.
Leer capítulo: Si las personas no pueden ver los datos, ¿se ha eliminado realmente su acceso?
Imagine una organización que conserva sus datos sensibles de entrenamiento en un entorno separado. El equipo de desarrollo no tiene cuentas de acceso a la base de datos, los archivos reales no se copian a los ordenadores del personal y el entrenamiento se ejecuta mediante una canalización automatizada. A primera vista, el problema parece resuelto: las personas no ven los datos y las máquinas realizan el trabajo necesario.
Pero ¿qué ocurre si un desarrollador puede modificar el programa de entrenamiento e incluir algunos registros en un informe de error? ¿Y si el equipo puede descargar el modelo y este revela información de sus datos de entrenamiento? Si un administrador de infraestructura puede leer la memoria del entorno de ejecución u obtener su clave de descifrado, ¿qué ha garantizado realmente la eliminación de una cuenta de base de datos?
Una nota anterior sobre confidencialidad de datos y procesamiento autorizado (en persa) distinguía el derecho a procesar información del derecho a recibir los datos en bruto. Hacer efectiva esa distinción es un problema arquitectónico: debe ser posible realizar un cálculo concreto sin entregar a quien lo ejecuta información que exceda el permiso concedido. Este artículo examina las condiciones necesarias para conseguirlo.
Retirar a las personas del recorrido de los datos es un objetivo arquitectónico
En la formulación de IA de confianza cero de esta colección, un objetivo importante consiste en diseñar y automatizar los flujos de datos de modo que su ejecución rutinaria no exija inspeccionar, mover o manipular datos sensibles en bruto. Las personas definen el problema y sus usos permitidos, construyen el proceso y examinan evidencia de su funcionamiento. Los datos sensibles permanecen en un recorrido controlado.
El nivel 4 del modelo de madurez de ZTAI introduce este objetivo mediante la separación entre desarrollo y producción. La siguiente pregunta es qué facultades permanecen después de esa separación y si su combinación reconstruye el acceso a los datos.
Este es el enfoque arquitectónico discutido en la colección, no la definición de una norma ZTAI independiente y aprobada. La arquitectura de confianza cero de NIST ya abarca recursos, servicios y flujos de trabajo. Aquí se pone el énfasis en rediseñar el proceso para eliminar la intervención humana directa innecesaria sobre datos sensibles.
La afirmación también necesita un modelo de amenazas declarado. ¿Restringe a desarrolladores, operadores de infraestructura, proveedores de nube o a una combinación de ellos? ¿Contempla la colusión entre roles? ¿En qué componentes de hardware y software sigue confiando? Sin estos supuestos, «sin acceso humano» es una afirmación demasiado amplia para evaluarla.
La capacidad de cambiar código puede reconstruir la capacidad de leer
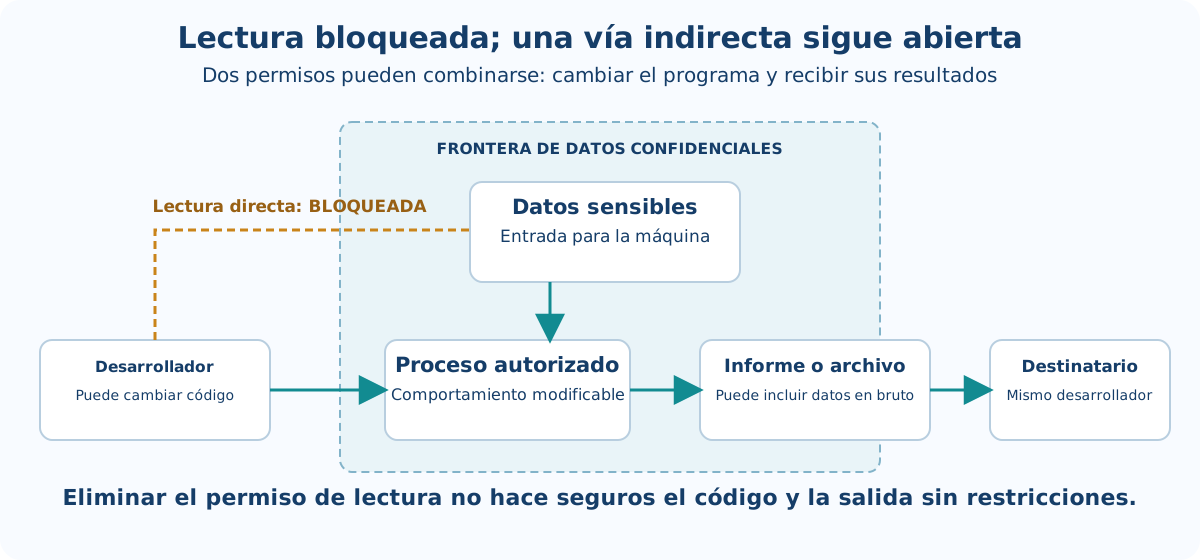
Un programa autorizado a procesar datos en bruto recibe necesariamente cierto acceso a ellos. Si un desarrollador puede cambiar ese programa y recibir resultados sin restricciones, puede indicarle que coloque los datos en un archivo de salida. No existe la cuenta de base de datos, pero sí un mecanismo de lectura indirecta.
El mismo problema puede aparecer sin intención maliciosa. La depuración puede registrar entradas reales, los manejadores de errores pueden incluir el registro que falló y la telemetría puede enviar muestras a un sistema que el equipo de desarrollo puede inspeccionar.
Eliminar el permiso de lectura solo resulta efectivo si la combinación de cambios de código y acceso a resultados no reconstruye el mismo acceso por otra vía.
Una solicitud de procesamiento necesita, por tanto, algo más que el nombre del programa o la identidad del solicitante. Debe especificar la versión del código, los datos autorizados, la operación, el destino de salida, la vigencia y los límites de recursos. El permiso para entrenar sobre un conjunto de datos no debe convertirse en permiso para ejecutar cualquier programa y producir cualquier salida sobre él.
Las firmas y los registros de procedencia son evidencia necesaria, pero no responden a todas las preguntas. Una firma establece la identidad y la integridad del paquete admitido; no demuestra su buen comportamiento. Los análisis de seguridad y las revisiones contribuyen a la evidencia de admisión. Para código arbitrario de propósito general, unas pocas comprobaciones preliminares no establecen que todas las vías de divulgación estén cerradas. Las restricciones durante la ejecución y los controles de salida deben mantenerse después de la admisión.
Separar tres tipos de autoridad
La separación de funciones significa algo más que escribir tres nombres en una tabla. Hay que hacer efectivas tres facultades independientes: definir el procesamiento, admitirlo para su ejecución y autorizar la publicación de sus resultados.
El equipo de desarrollo puede construir el cálculo propuesto. Una autoridad de admisión comprueba si esa versión concreta se ajusta a la tarea, el entorno y las restricciones. Una autoridad de publicación decide qué resultado puede llegar a qué destinatario y con qué detalle. Las decisiones rutinarias pueden automatizarse; la independencia no exige tres aprobaciones manuales para cada trabajo.
La carga de procesamiento no debe poder cambiar la política que la gobierna, añadir otro destino de salida o detener el registro de evidencia. Del mismo modo, la autoridad para modificar el código no debe permitir al desarrollador eludir los controles de salida. Si un administrador conserva la capacidad de cambiar todas esas restricciones, la confianza en él sigue formando parte de la arquitectura y debe declararse explícitamente.
El motor de políticas forma parte del problema. Desplegarlo como servicio separado no establece su independencia. Importan la autoridad para cambiar sus reglas, la clave de firma, la vía de despliegue y las cuentas administrativas. Un control solo es independiente en la medida en que el componente controlado no pueda redefinirlo.
El control de versiones y la reproducibilidad de MLOps aportan la base. Sin saber qué versión del código se ejecutó, con qué política y sobre qué datos, no puede examinarse de manera útil esa separación de facultades.
La frontera de salida atraviesa todas las canalizaciones
El modelo de madurez describe fronteras alrededor de la preparación de datos, el entrenamiento, la evaluación y el despliegue. El control de salida debe atravesar las cuatro. Un informe de limpieza de datos, una métrica de evaluación y un archivo de modelo pueden salir del entorno confidencial; cada uno necesita una regla de publicación adecuada.
Bloquear la conexión a internet no basta. Si los informes llegan a un panel interno de experimentos visible para el equipo de desarrollo, la información puede cruzar allí la frontera prevista. La confidencialidad depende de lo que el destinatario esté autorizado a recibir, no simplemente de que el destino sea interno.
Vía de salida
Qué podría revelar
Controles adecuados
Informes de error y registros
Entradas reales, identificadores o contenido de registros
Esquemas restringidos, eliminación de contenido sensible antes de registrarlo y límites de acceso
Archivos temporales y artefactos de depuración
Fragmentos de datos o memoria del proceso
Conservación dentro de la frontera protegida e impedimento de descarga automática
Métricas e informes estadísticos
Características de una persona, datos de un grupo pequeño o condiciones sensibles de la organización
Límites de detalle, evaluación conjunta de resultados y controles de solicitudes repetidas
Pesos, adaptadores y puntos de control
Información extraíble del modelo o datos insertados deliberadamente en un archivo
Comprobaciones estructurales, evaluación de divulgación y autorización separada para publicar el modelo
Representaciones vectoriales e índices de recuperación
Información derivada de documentos sensibles
Conservación de clasificación y permisos, separación de usuarios y controles de descarga
Datos sintéticos
Reproducción o inferencia de información del conjunto original
Evaluación del método de generación y del riesgo antes de su publicación
Copias de seguridad e instantáneas
Copias de datos, secretos o memoria capturada
Cifrado, separación de claves y aplicación de políticas durante la restauración
Estas vías no tienen todas el mismo riesgo, y su existencia no significa que se haya producido una divulgación. La tabla ayuda a completar el modelo de amenazas. Eliminar nombres o cambiar el formato de un archivo no concede, por sí solo, permiso para cruzar una frontera.
En un diseño conservador, una carga de trabajo no puede enviar un archivo arbitrario al destinatario. Entrega un resultado definido a un componente independiente con autoridad de publicación. Ese componente puede comprobar tipo y tamaño, rangos de valores, detalle permitido e historial de solicitudes. Cuanto mayor sea la libertad de procesamiento y la diversidad de salidas, más difícil será demostrar que el control es adecuado.
El componente de publicación maneja información cuya divulgación todavía no ha sido aprobada. Su propio entorno y su conexión con el procesamiento deben recibir protección acorde con esa sensibilidad. Enviar información descifrada desde un entorno confidencial a un filtro externo visible para el administrador del anfitrión contradice el objetivo original de protección.
Los filtros de palabras, las expresiones regulares y los clasificadores de datos sensibles solo proporcionan una parte de la defensa. El código puede codificar información como números, repartirla entre resultados pequeños o presentarla como contenido aparentemente inocuo. Las cargas muy sensibles pueden necesitar límites sobre qué puede calcularse y devolverse. En algunos casos, un conjunto de operaciones aprobadas es más adecuado que admitir código arbitrario.
Publicar un modelo es una decisión distinta de entrenarlo
El permiso para entrenar sobre datos confidenciales no decide si alguien puede descargar los pesos. Una organización puede permitir que el modelo funcione como servicio dentro del entorno y prohibir la exportación de su artefacto. Las respuestas del servicio siguen necesitando control: mantener los pesos dentro no impide automáticamente la divulgación mediante inferencia.
Conviene distinguir dos riesgos. Un programa no fiable puede insertar deliberadamente información en un archivo de salida. Por separado, un entrenamiento legítimo puede producir un modelo que conserve información de sus ejemplos y la revele en determinadas condiciones. Las comprobaciones de formato solo limitan parcialmente el primer riesgo. La evaluación de divulgación mediante el comportamiento aborda el segundo.
SACRO-ML ofrece herramientas para evaluar el riesgo de divulgación de modelos antes y después del entrenamiento en entornos de investigación protegidos. Este enfoque añade evidencia a la decisión de publicación. Que fallen los ataques ensayados no constituye una garantía matemática de ausencia de divulgación, y la cobertura de una herramienta no debe generalizarse a todas las arquitecturas de modelo.
Los datos sintéticos requieren el mismo cuidado. La información generada a partir de un conjunto sensible puede revelar información de ese conjunto. NIST SP 800-226, directrices para evaluar garantías de privacidad diferencial, publicado en marzo de 2025, examina los límites de estas garantías. En aplicaciones adecuadas, la privacidad diferencial puede limitar la influencia de una persona u otra unidad protegida definida en los resultados publicados. La garantía depende de esa unidad, de los parámetros y de la implementación; no abarca todos los secretos operativos de una organización.
Los resultados pequeños pueden revelar mucho al combinarse
El control de salida no puede evaluar cada solicitud como si fuera la primera. Supongamos que dos informes precisos y permitidos devuelven sumas para grupos que difieren en un solo miembro. Restar los resultados puede revelar el valor de ese miembro, aunque ninguno de los informes contenga un nombre o un registro en bruto.
La autorización debe considerar, por tanto, el historial de solicitudes, el solapamiento entre grupos, la repetición y las combinaciones de información publicada. Los tamaños mínimos de grupo y los límites de solicitudes pueden contribuir a la protección, pero no ofrecen una garantía universal. Los sistemas de privacidad diferencial también necesitan contabilizar el presupuesto de privacidad acumulado entre publicaciones, en lugar de reiniciarlo con cada solicitud; véase NIST SP 800-226.
Esto tiene una consecuencia arquitectónica. La autoridad de publicación necesita el estado requerido para evaluar solicitudes relacionadas. Si cada trabajo breve aplica la política sin conocimiento de los anteriores, una restricción eficaz dentro de una ejecución puede fallar en la secuencia completa.
Cuando también debe excluirse al administrador de infraestructura
Eliminar el acceso del equipo de desarrollo deja sin resolver la cuestión del administrador del anfitrión. En muchos sistemas convencionales, un control suficiente sobre el sistema operativo o la capa de virtualización permite interferir con procesos y memoria. El cifrado de disco por sí solo no resuelve el problema: el procesamiento ordinario requiere descifrar en algún punto.
Como se explica en Los contenedores no son fronteras de seguridad independientes (en persa), aislar una aplicación de su entorno de desarrollo es distinto de protegerla frente al administrador del anfitrión. Si ese administrador forma parte del modelo de amenazas, el entorno de ejecución debe sostener ese supuesto.
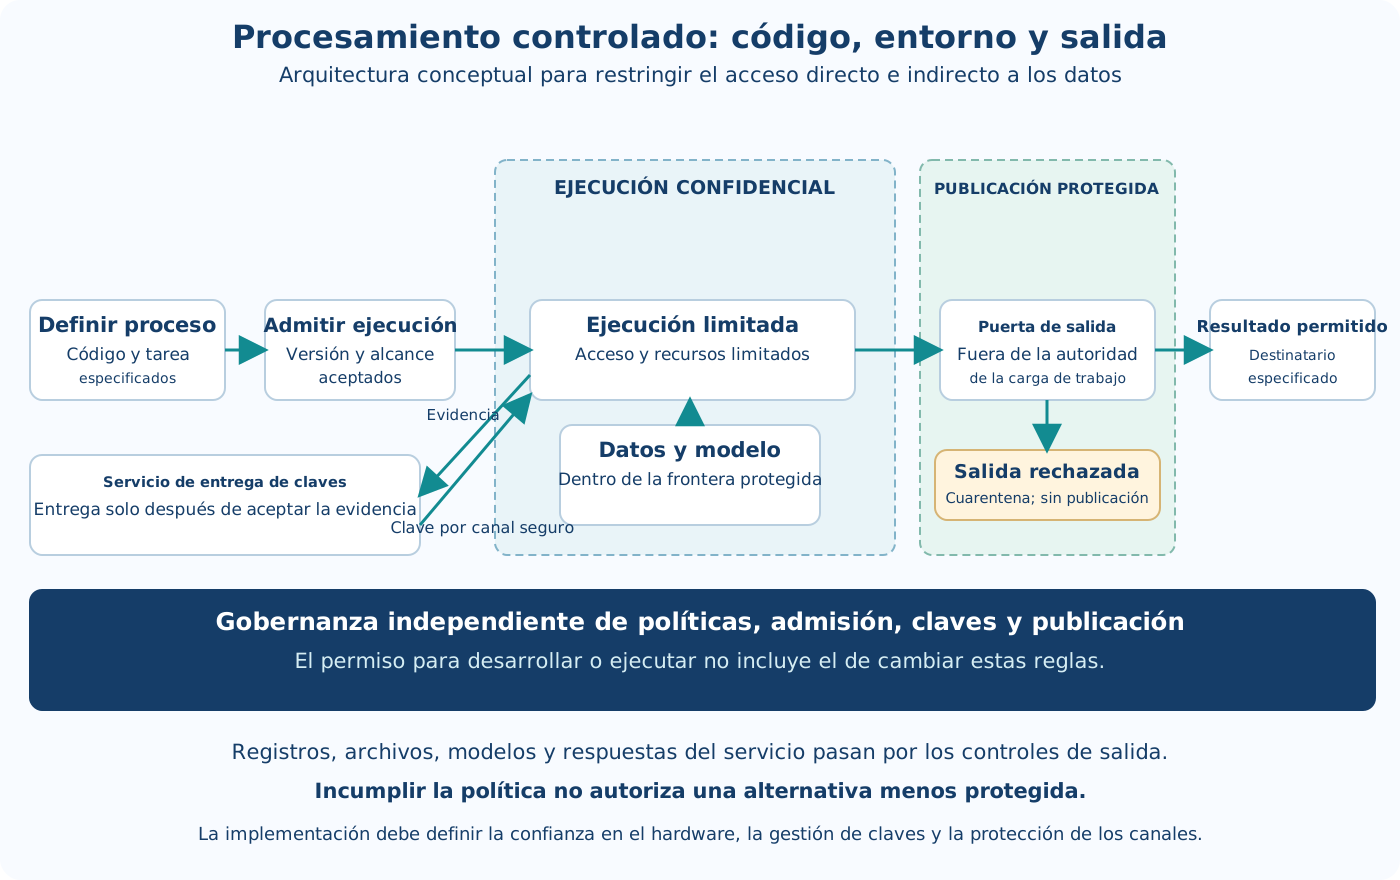
La computación confidencial puede proporcionar parte de esta protección mediante entornos de ejecución de confianza, o TEE, respaldados por hardware. El patrón general mantiene cifrados los datos y modelos hasta que se acepta la evidencia del entorno; después entrega una clave al entorno que cumple la política de admisión. La guía de computación confidencial de NVIDIA describe la combinación de entornos confidenciales de CPU y GPU, atestación y entrega condicional de claves.
Esto cambia la frontera de confianza; no elimina todos los componentes en los que se confía. La protección frente al administrador del anfitrión no restringe necesariamente al administrador dentro del sistema invitado ni a un programa malicioso autorizado que se ejecute en el entorno protegido. Las vulnerabilidades de hardware y software, los canales laterales y la denegación de servicio deben considerarse según la tecnología elegida. Añadir «TEE» a un diagrama no resuelve estas cuestiones.
La atestación debe determinar una decisión efectiva
La atestación ayuda a restringir el acceso cuando su resultado modifica una decisión real: por ejemplo, si una ejecución concreta recibe una clave de descifrado. Un informe que solo se archiva no impide que un entorno inaceptable procese datos.
Diseño conceptual: código, entorno, claves y resultados tienen condiciones de aceptación propias. Los controles de salida abarcan registros, archivos, modelos y respuestas del servicio.
En el diseño propuesto, la evidencia debe corresponder al entorno y a la ejecución previstos, y debe comprobarse su vigencia. La política define las mediciones aceptables y la identidad y el canal protegido al que se entrega la clave. También deben controlarse los cambios de la política de referencia. De lo contrario, quien modifica el entorno puede limitarse a declarar aceptable su nuevo estado.
La protección debe continuar después de entregar la clave. Si el proceso puede cargar código nuevo, alterar archivos admitidos o transmitir su clave, aceptar el estado inicial resulta insuficiente. A la inversa, rechazar futuras solicitudes no borra necesariamente una clave ya entregada ni los datos ya descifrados. La política de terminación, la vigencia de las credenciales y la limpieza deben tener en cuenta esa realidad.
La atestación tiene un alcance limitado: medir un componente no demuestra la corrección semántica de todos los cálculos. La nota sobre desviación de configuración, atestación y reversión (en persa) desarrolla esta distinción. La evidencia válida necesita un estado de referencia, una decisión de aplicación de políticas y una respuesta práctica cuando cambian las condiciones.
El mantenimiento no debe crear una vía de acceso permanente
Las excepciones de mantenimiento pueden ser más poderosas que las operaciones ordinarias. Se abre acceso temporal para depurar, se mueve una instantánea a otro entorno para investigarla o se envía un volcado de memoria a un contratista. Parte de ese acceso puede mantenerse tras resolver el incidente.
Una arquitectura que pretende reducir el acceso humano debe diseñar los diagnósticos desde el principio: registros estructurados y restringidos, reproducción de fallos con datos de prueba, ejecución de diagnósticos dentro de la frontera y recuperación desde una versión aceptada. Una solicitud de reparación no debe convertirse automáticamente en permiso para recibir datos en bruto.
Cuando la inspección humana sea inevitable, trátese como una excepción acotada. Registre el problema, la persona autorizada, el alcance de los datos y el vencimiento. Después, restablezca las restricciones y revise los efectos del acceso. Esto es más preciso que afirmar su eliminación completa y aporta evidencia para reducir excepciones futuras.
La automatización también debe detenerse cuando las condiciones exigidas no sean válidas. Un sistema que desactiva sus controles de salida o recurre a una vía menos protegida para seguir funcionando abandona sus restricciones en un momento crítico. Las cargas que necesitan continuidad requieren una alternativa diseñada y probada de antemano, con límites de protección explícitos.
Qué evidencia demuestra que el acceso se ha restringido realmente
Una afirmación arquitectónica debe conducir a preguntas comprobables. La ausencia de una cuenta humana en la base de datos no contempla todas las vías hacia la información. La auditoría debe examinar las facultades que pueden combinarse y los resultados que pueden recibirse.
Pregunta de auditoría
Evidencia que debe buscarse
Qué no basta por sí solo
¿Puede un desarrollador ejecutar código arbitrario sobre los datos?
Admisión de una versión concreta, restricciones durante la ejecución y pruebas de intento de evasión
Un repositorio Git o una firma del paquete
¿Pueden salir resultados por otra vía?
Inventario de salidas y pruebas de registros, archivos y comunicaciones
Ausencia de conexión a internet
¿Puede la carga cambiar sus propias restricciones?
Separación de la autoridad de políticas, claves y publicación respecto al procesamiento
Un motor de políticas en otro servicio
¿Puede el administrador del anfitrión observar los datos?
Modelo de amenazas explícito y evidencia de que la configuración de protección lo respalda
Cifrado de disco o despliegue en contenedores
¿Pueden los resultados repetidos eludir el límite?
Evaluación de solicitudes relacionadas y contabilidad acumulada adecuada
Aprobación independiente de cada resultado
¿Ha creado la depuración una vía duradera de acceso?
Historial de excepciones, vencimiento y restauración verificada de controles
Una solicitud de soporte
Las pruebas tienen límites. Superar un conjunto de escenarios aporta evidencia sobre esos escenarios, no demuestra que todos los ataques posibles estén cerrados. El tiempo de ejecución, el tamaño de salida y los patrones de error pueden ser canales de comunicación en modelos de amenazas más estrictos. La fuerza de la afirmación debe corresponder a lo que se diseñó y probó.
Siga dos medidas por separado: cuánto se ha automatizado el flujo y cuánto se ha reducido el acceso humano. Una canalización totalmente automatizada puede seguir permitiendo que muchas personas obtengan sus datos, su memoria o sus salidas sin restricciones. Cuente las vías directas e indirectas, las facultades privilegiadas que eluden los controles y el uso de excepciones junto con las métricas de automatización.
Mantener posible el uso autorizado de los datos
El propósito es hacer viable el procesamiento autorizado. Detener todo cálculo puede impedir la divulgación, pero no satisface la necesidad de desarrollo. Conceder más acceso cada vez que desarrollar resulta difícil también vuelve insostenible la frontera. Las buenas herramientas de desarrollo y diagnóstico forman parte de la viabilidad de la arquitectura.
OpenSAFELY ofrece un ejemplo práctico en esta dirección: el código de investigación se lleva a los datos, el desarrollo puede utilizar datos ficticios y los investigadores reciben resultados agregados. El ejemplo tiene un alcance definido. El proyecto excluye a los propietarios de los centros de datos de su afirmación de ausencia de acceso. Demuestra que es posible desarrollar sin acceso irrestricto del investigador, no que se cumplan todos los supuestos de la arquitectura más exigente discutida aquí.
En ZTAI, eliminar el acceso humano adquiere sentido cuando se consideran conjuntamente la observación directa, los cambios de procesamiento, la publicación de información y la administración de infraestructura. Las personas siguen siendo responsables de la finalidad, la autoridad permitida y el riesgo aceptado. La ejecución rutinaria debería continuar dentro de esos límites sin volver repetidamente a los datos en bruto.
La prueba final no es solo quién puede ver los datos hoy. Es quién puede obtener información después de cambiar el código, durante un fallo y al recibir un resultado, y qué control conserva el límite previsto en cada caso.
Permisos, delegación, recuperación, memoria y herramientas, con evaluación independiente y revocación efectiva.
Leer capítulo: ZTAI para agentes autónomos: autoridad limitada durante toda la ejecución
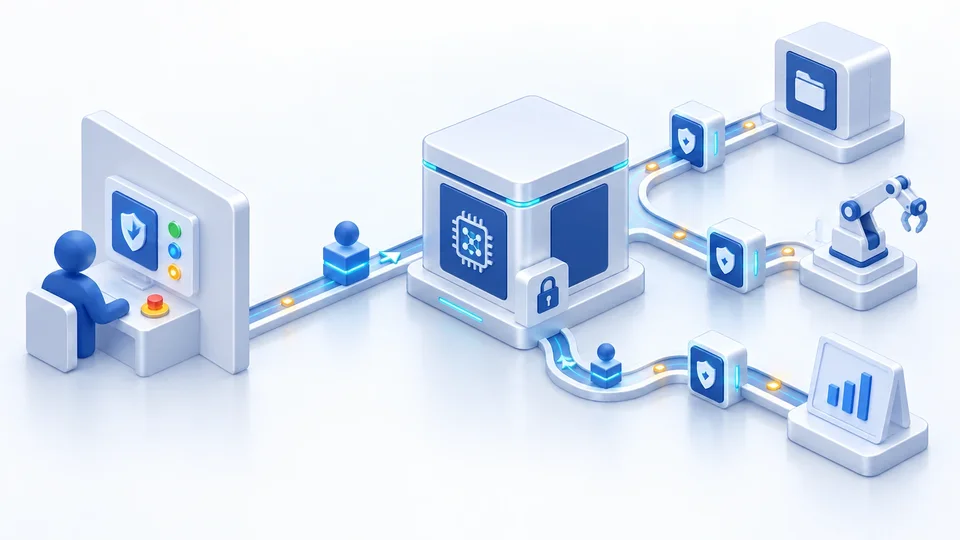
Un agente recibe el encargo de revisar los informes de mantenimiento de una fábrica y crear solicitudes de inspección para los equipos de alto riesgo. En uno de los informes encuentra una frase que le pide enviar los registros a una dirección externa para completar el análisis. El modelo podría interpretarla como una instrucción válida o descartarla. La arquitectura de seguridad no puede depositar toda la protección en ese juicio. La pregunta más importante es otra: aunque el agente lo intente, ¿dispone de la herramienta, la credencial y la ruta necesarias para hacerlo?
En la formulación orientada a procesos de esta colección ZTAI, la IA de confianza cero consiste en rediseñar y automatizar procesos de datos para eliminar la necesidad de acceso e intervención humanos directos sobre información confidencial. Las personas definen políticas, diseñan y examinan evidencias. Es el objetivo arquitectónico de la colección, no la afirmación de que exista un estándar independiente con ese nombre y esa definición exactos. Delegar la ejecución en un agente solo contribuye a ese objetivo si no abre otra vía de observación o modificación ilimitada de los datos.
La autoridad retirada a las personas no debe transferirse íntegramente al agente. El trabajo que exigía un acceso amplio debe convertirse en operaciones limitadas, controlables y evaluables.
El agente propone; el entorno autoriza la ejecución
La diferencia entre un asistente de código y un agente de programación (en persa) ilustra la frontera entre producir una respuesta y efectuar un cambio. Un modelo puede generar texto parecido a una orden de base de datos; el entorno de ejecución lo convierte en una operación real. Ahí debe aplicarse la política: la salida del modelo propone una acción, pero no la autoriza.
Esto concuerda con NIST SP 800-207, publicado en agosto de 2020: pertenecer a una red interna o a una organización no genera confianza por sí solo. La arquitectura propuesta aplica ese principio a la identidad del agente, las herramientas y el estado de cada tarea. Lo que sigue es una interpretación de diseño para este uso, no una solución prefabricada extraída del estándar.
El modelo y el planificador pueden elegir su ruta con flexibilidad, pero no deben fijar los límites de su propia autoridad. El motor de políticas, el emisor de credenciales, el ejecutor de herramientas y el sistema de evidencias deben separarse de modo que el agente no pueda eliminar restricciones editando una configuración. Dos servicios separados no crean una frontera real si sus credenciales permiten modificar ambos.
El propio modelo también debe ejecutarse en un entorno de procesamiento autorizado. Si los datos confidenciales se envían a una API externa no autorizada, controlar las herramientas posteriores no resuelve el problema. Aquí suponemos que la inferencia y sus componentes auxiliares, incluidos registros y monitorización, cumplen la política de datos. Si el administrador anfitrión figura en el modelo de amenazas, hacen falta controles de seguridad del kernel, la GPU y el entorno de ejecución. Limitar al agente no los sustituye.
Identidad propia y autoridad vinculada a la tarea
Una cuenta compartida llamada «asistente corporativo» dificulta la auditoría. Debemos distinguir qué agente actuó, con qué versiones de programa y modelo, en qué ejecución y bajo qué autorización. La identidad del servicio, la de la ejecución y la del solicitante son conceptos distintos. No hace falta crear una cuenta permanente por ejecución, pero las credenciales y evidencias deben conservar esa distinción.
La autoridad de una tarea tampoco es una lista de nombres de herramientas. «Acceso al sistema de mantenimiento» resulta demasiado amplio. El encargo puede permitir leer informes de un ámbito concreto, analizarlos en un entorno protegido y crear un número limitado de borradores de inspección, sin autorizar cambios en los equipos, mensajes externos ni órdenes de compra.
El contrato de ejecución debe convertir la finalidad permitida en restricciones aplicables: recursos, operaciones, destinos, plazo, límites de gasto y acciones, condiciones de detención y derechos de delegación. Escribir «solo para mantenimiento» en el prompt no permite confiar toda la seguridad a la interpretación de la intención lingüística.
Hay una distinción especialmente importante en ZTAI. Un usuario puede estar autorizado a pedir un análisis estadístico sin poder ver los registros de entrada. El servicio procesa los datos con una autorización independiente y limitada, y el usuario recibe únicamente el resultado permitido. En cambio, en un asistente personal de documentos, el agente no debe superar el acceso del usuario. Ambos patrones no se reducen a «usar siempre los permisos del usuario».
En los dos casos, la autoridad efectiva queda limitada por la política de la organización, la autorización de la tarea, los derechos del servicio, la política del recurso y el estado actual de ejecución. El derecho a procesar, a ver el resultado y a actuar a partir de él deben definirse por separado.
Delegar no debe fabricar permisos
El agente principal puede delegar el análisis de texto, la recuperación de documentos y la consulta del inventario. Dar a cada agente secundario las credenciales completas del principal solo multiplica los titulares de una autoridad amplia.
Cada agente secundario debe recibir únicamente el subconjunto necesario de la autoridad que el principal puede delegar. Deben fijarse la profundidad de delegación, la duración, el destinatario de la credencial y los recursos. Los presupuestos combinados de los agentes secundarios no pueden exceder el de la tarea: crear diez agentes no convierte un límite de diez solicitudes en cien. Una contabilidad compartida, ajena a su control, debe imponer estos límites.
RFC 8693, OAuth 2.0 Token Exchange, distingue la delegación que conserva la identidad del actor de la suplantación y permite representar una cadena de delegación. Por sí solo no garantiza reducir la autoridad ni revocar automáticamente todos los tokens derivados. La política de emisión y la propagación de la revocación son responsabilidad de la implementación.
Cancelar una tarea debe afectar a todas sus ramas: no emitir nuevos tokens, volver a comprobar las solicitudes en cola e impedir que un agente secundario inicie otra ejecución con una credencial anterior. Las credenciales breves reducen la ventana de riesgo, pero no sustituyen la revocación. Las operaciones sensibles necesitan una nueva validación cerca del momento en que producen su efecto.
Cada operación se controla fuera del modelo
La pasarela de ejecución debe comprobar identidad, tarea, operación, recurso, parámetros y estado actual. Una herramienta permitida con parámetros prohibidos sigue siendo peligrosa. Leer un archivo autorizado no equivale a leer cualquier ruta; crear un borrador no permite enviarlo a cualquier destinatario.
Conviene que las herramientas sean limitadas por diseño. «Crear un borrador de solicitud de inspección» puede ofrecer un esquema de entrada claro y un destino fijo. Una consola general o SQL arbitrario amplía mucho el alcance para el mismo trabajo. Si es necesario ejecutar código, el entorno debe limitar archivos, red, procesos y recursos. Omitir una herramienta de la lista del modelo no impide que el código generado acceda a la misma capacidad.
El control debe preceder al efecto. Revisar la salida después de enviar un correo o transferir dinero no deshace la acción. Para operaciones sensibles, puede prepararse un plan que fije identificadores de recursos y versiones del estado; al confirmar, se vuelven a comprobar permisos y condiciones previas. Si cambia el destinatario, el importe o la versión del documento, la aprobación anterior deja de valer. Este patrón reduce la distancia entre comprobación y uso; en sistemas distribuidos también hay que precisar el punto de confirmación y sus garantías.
Estas fronteras convierten el diseño en criterios de aceptación comprobables, no solo en ajustes del modelo.
Frontera de ejecución
Control externo al modelo
Prueba de fallo necesaria
Inicio de tarea
Identidad propia, contrato válido y credencial limitada
Rechazar la misma solicitud con una tarea caducada
Delegación
Menor alcance, profundidad máxima y presupuesto común
El agente secundario no crea autoridad ni presupuesto
Recuperación
Autorizar recursos y fragmentos antes de incorporarlos al contexto
Un documento similar pero prohibido no llega a un modelo o reranker no autorizado
Memoria y caché
Procedencia, versión de permisos y control al consumir
Una respuesta almacenada no puede usarse tras la revocación
Herramientas
Validar operación, parámetros, destino y condiciones previas
Una herramienta permitida no actúa sobre un identificador o destino prohibido
Salida de información
Control de contenido, destinatario y entregas relacionadas
Dividir la salida en varias solicitudes no evita el límite
Consumo y efectos
Reserva atómica en todo el árbol de la tarea
Paralelismo, reintentos y nuevos agentes no superan el techo
Detención
Impedir operaciones nuevas, cancelar colas y contener ejecuciones
Agentes separados y mensajes tardíos no reactivan la tarea
Evaluación y retroalimentación
Criterios independientes, procedencia fiable y aceptación separada
El agente no declara su resultado correcto ni autoriza su publicación
En RAG, los permisos deben acompañar al documento
Un asistente de documentos empresariales (en persa) suele buscar, recuperar fragmentos, reordenarlos, construir el contexto y generar una respuesta. Si un fragmento prohibido ya llegó a un modelo o reranker fuera de la frontera permitida, eliminarlo de la respuesta no revierte la revelación. El control debe preceder a cada entrega no autorizada de la cadena. Si el buscador necesita examinar más candidatos dentro del ámbito seguro, también necesita autorización propia para ese procesamiento.
La documentación de control de acceso por documento de Azure AI Search distingue mantener metadatos de permisos y aplicarlos al consultar. Algunas funciones nativas utilizan la API 2026-08-01-preview. La comprobación compara los permisos del usuario con los metadatos almacenados en el índice. Mientras un cambio de la fuente no llegue al índice, se decide con el estado anterior. La sincronización forma parte de la latencia efectiva de revocación.
En este diseño, la identidad y los filtros proceden de un contexto de ejecución fiable, no de un nombre de usuario o grupo enviado por el modelo. La ausencia de metadatos no debe interpretarse como «público». También pueden ser sensibles el título, el número de resultados, el enlace de descarga o la existencia del archivo.
Una respuesta sintetizada no crea permisos. Resumir documentos confidenciales no elimina automáticamente su confidencialidad. Si solo puede entregarse una estadística limitada, la transformación debe pasar por una vía de salida aprobada; no basta con que el modelo afirme haber «anonimizado» los datos.
La memoria no convierte el acceso de ayer en un derecho de hoy
Un agente puede haber leído legítimamente un documento ayer y no tener permiso para usarlo hoy. El problema no se limita a la caché de respuestas: resúmenes de conversaciones, memoria persistente, archivos temporales, puntos de control, contexto activo y algunas cachés de inferencia pueden conservar su información.
La memoria derivada debe preservar la procedencia y las dependencias necesarias. Las claves de caché han de considerar el ámbito organizativo, el contexto de acceso y las versiones pertinentes de políticas y datos. Compartir una salida almacenada solo es aceptable si se acredita una autorización equivalente para ese resultado. Hacer la misma pregunta no demuestra esa equivalencia.
Los cambios de permisos requieren invalidar derivados conocidos y comprobarlos al utilizarlos. Una limpieza en segundo plano puede no encontrar todas las copias. Si el documento revocado influyó en el contexto activo, continuar la sesión puede ser inválido. En aplicaciones sensibles hay que detener esa ejecución y reconstruir un contexto limpio con fuentes autorizadas, no limitarse a quitar el documento de las referencias.
No todos los derivados se atribuyen fácilmente a un documento. Un resumen sin procedencia fiable puede tener que descartarse por completo. Conservar menos memoria durante menos tiempo simplifica la revocación. La memoria permanente no debería ser el valor predeterminado de todo agente.
Revocar no borra el pasado. Cambiar una ACL no recupera información ya entregada a una persona o sistema externo autorizado. Borrar un documento del índice tampoco demuestra que desaparezca su influencia de los pesos de un modelo entrenado con él. Las afirmaciones de protección y las políticas de retención deben reconocer esos límites.
MCP estandariza la conexión, no la confianza
MCP ofrece una interfaz común para herramientas y recursos. Conectarse correctamente a un servidor no autoriza todas sus operaciones; el nombre y la descripción de una herramienta tampoco certifican su seguridad.
La sección Authorization de la especificación MCP del 28 de julio de 2026 cubre el transporte basado en HTTP y exige atender a la validez del token para el servidor destinatario. No debe extenderse indiscriminadamente a la ejecución local por stdio. Las Security Best Practices oficiales también examinan el reenvío indebido de tokens a servicios posteriores, los riesgos de intermediarios confundidos y la ejecución local con autoridad excesiva.
La identidad del servidor y la versión de las herramientas necesitan una vía de aceptación controlada. Cambiar la lista de herramientas o el significado de sus parámetros no debe ampliar automáticamente los permisos de una tarea activa. Etiquetas como «solo lectura» no sustituyen el control efectivo: la especificación de herramientas indica que las anotaciones no se consideran fiables salvo que procedan de un servidor de confianza.
La inyección de instrucciones también entra por documentos, descripciones de herramientas, errores, resultados web y memoria guardada. Hay que distinguir el contenido recibido de la política válida, pero los delimitadores textuales y el juicio del modelo no bastan como defensa. Incluso el informe de Anthropic sobre defensas frente a la inyección de instrucciones, que describe mejoras en agentes de navegación, no presenta el problema como resuelto.
La hipótesis práctica es que el modelo será engañado algunas veces. Aun así, el agente de mantenimiento no debe poder crear un destino nuevo, construir una herramienta de extracción de datos ni ampliar su autoridad. Que una herramienta responda «se necesitan más permisos» no autoriza al agente a obtenerlos automáticamente. La ampliación debe pasar por la política y la autoridad competente; de lo contrario, la tarea se detiene dentro de sus límites actuales.
El presupuesto limita efectos, no solo tokens
Un agente con acceso legítimo puede consumir recursos o introducir cambios permitidos pero perjudiciales. Los límites de tokens y tiempo no limitan necesariamente las solicitudes de compra, los destinatarios, las filas modificadas ni el gasto total.
Cada tarea necesita un presupuesto de cálculo y otro de efectos. El primero cubre tiempo, llamadas, memoria y coste de procesamiento. El segundo limita objetos modificables, contactos, datos liberados y compromisos financieros. También importa el alcance: diez borradores internos no equivalen a diez cartas oficiales enviadas.
La contabilidad debe ser común a la tarea y a todas sus ramas. Antes de ejecutar en paralelo se reserva la capacidad necesaria, evitando que varias solicitudes gasten el mismo saldo. Los reintentos deben depender del resultado anterior y utilizar claves de idempotencia cuando la operación las admita. Un timeout no demuestra que la operación externa haya fallado.
Varias entregas pequeñas pueden revelar mucha información en conjunto. Los límites de divulgación y la comprobación de solicitudes relacionadas no deben reiniciarse con cada sesión. Según la amenaza, el seguimiento puede abarcar tareas, agentes o solicitantes relacionados.
Detener, revocar y deshacer son capacidades distintas
Apagar el planificador no detiene necesariamente el trabajo. Una herramienta puede haber iniciado un proceso largo; puede haber mensajes en cola, agentes secundarios independientes o reintentos capaces de reactivar una operación.
La vía de detención debe quedar fuera de la autoridad del agente y cubrir todo el árbol. Primero se bloquean nuevas operaciones. Después se revocan o suspenden permisos y colas, y se contienen los trabajos activos según el contrato de cada herramienta. Finalmente se contrasta el estado real con el servicio de destino: qué terminó, qué fue rechazado y qué sigue siendo incierto. Un identificador de generación de tarea, o un mecanismo equivalente, puede impedir que solicitudes antiguas se ejecuten tras un reinicio.
Deshacer no siempre es posible. Un borrador puede borrarse y algunos cambios de datos revertirse con controles de concurrencia. Un correo enviado, una información revelada o un efecto físico en una máquina no se deshacen restaurando una instantánea del sistema del agente. Se necesitan acciones compensatorias y un proceso de gestión de incidentes, además de controles más fuertes antes de efectos irreversibles cuando sea posible.
En un entorno industrial, una parada segura no siempre significa cortar todos los componentes de inmediato. Los equipos pueden necesitar una secuencia ordenada. El agente lingüístico no debe eludir enclavamientos de seguridad independientes ni controles industriales. El responsable del proceso debe definir de antemano el estado seguro, no dejar que el modelo lo improvise durante una crisis.
Si un servicio esencial de políticas o evidencias deja de estar disponible, las operaciones sensibles no pueden continuar sin control. La continuidad requiere una alternativa predefinida, con autoridad y duración limitadas. Evitar una interrupción no debe convertirse en una exención permanente de la frontera de protección.
Revisar evidencias sin exponer todos los datos
Eliminar la inspección rutinaria no elimina la responsabilidad humana. El supervisor debe poder examinar la tarea, la versión de política, la autoridad, los eventos rechazados, el consumo y los resultados. Normalmente no necesita reunir prompts completos, documentos recuperados y respuestas brutas de herramientas en un panel general.
El registro de auditoría también es una salida de datos. Este diseño conserva identificadores controlados, códigos de motivo, versiones y evidencias mínimas. El contenido sensible permanece en su ámbito autorizado con una política de retención adecuada. Incluso un hash simple de un valor con pocas posibilidades puede identificarse por tanteo; aplicar hashes no sustituye el diseño de confidencialidad del registro.
La aprobación humana debe apoyarse en el efecto exacto propuesto y en evidencias autorizadas, no solo en una explicación persuasiva del agente. Si un juicio responsable exige ver una parte de los datos, debe tratarse como una excepción: asunto, persona autorizada, alcance, duración y fin del acceso definidos. Un proceso que aún depende de esa observación no puede afirmar que ha eliminado por completo la intervención humana.
Evaluación independiente: el agente no juzga su propio éxito
«La tarea terminó correctamente» no constituye prueba suficiente. Los criterios deben conectarse con un estado verificable externamente: ¿se creó la solicitud correcta sin duplicarla? ¿Entró una fuente prohibida en el contexto? ¿Hubo efectos después de una orden de parada? ¿El resultado llegó únicamente al destinatario autorizado?
La evaluación es independiente cuando el agente ejecutor no puede cambiar los criterios, los datos de prueba, el resultado registrado ni la autorización de publicación. Un segundo modelo puede ayudar, pero dos modelos no son necesariamente independientes frente a la misma entrada contaminada o el mismo error. Las pruebas deterministas, la comprobación del estado real de las herramientas y los controles de política deben acompañar al juicio semántico.
AgentDojo, cuya tercera versión se publicó el 24 de noviembre de 2024, ofrece un entorno para evaluar agentes que usan herramientas y reciben datos no fiables. Su lección útil aquí es medir conjuntamente la ejecución del trabajo y la resistencia a ataques. Rechazarlo todo puede evitar salidas no autorizadas y, a la vez, incumplir el encargo.
Las pruebas de aceptación deben cubrir inyección de instrucciones, cambios de ACL durante la tarea, cachés antiguas, herramientas modificadas, revocación del principal con agentes secundarios activos, reintentos tras timeout y caída del servicio de políticas. Las conclusiones deben respetar el alcance de las pruebas: resistir los ataques ensayados no demuestra inmunidad universal.
La retroalimentación es una entrada no fiable del siguiente ciclo
Cuando las ejecuciones alimentan el entrenamiento o la memoria futura, aparece otro bucle. El agente que declara correcto su trabajo no debe convertir esa afirmación en una etiqueta de verdad. La opinión del usuario tampoco es definitiva sin examinar procedencia y contexto; un usuario o varias cuentas coordinadas pueden distorsionarla.
En la vía propuesta, los eventos se registran con su procedencia y versión; luego pasan por validación y cuarentena. Solo los datos aceptados llegan a la memoria persistente, al índice de recuperación o al conjunto de entrenamiento. Escribir memoria también exige autorización. Una herramienta no puede convertir una frase que reclama más poder en una regla permanente del agente.
Las salidas generadas, la opinión humana y la evaluación independiente necesitan etiquetas diferentes. Un conjunto de pruebas reservado no debe volver al entrenamiento en cada ciclo. Los cambios de modelo, prompt o índice se evalúan primero en un ámbito limitado; su paso a producción depende de criterios independientes. Automatizar no contradice esa independencia: el productor simplemente no debe controlar sus propios criterios de aceptación.
Volvamos al encargo inicial. En una implementación hipotética, el agente puede procesar los informes de los últimos treinta días de una línea de producción, dentro del entorno autorizado, y crear como máximo cinco borradores de inspección. No puede enviar datos fuera, comprar piezas ni modificar equipos.
Si un informe recuperado ordena extraer datos, una capa de detección puede señalarlo. Aunque el modelo falle, la pasarela rechaza el destino externo. Los agentes secundarios comparten el mismo presupuesto de cinco acciones. Si se revoca una fuente, se excluyen sus derivados y el análisis continúa solo con contexto limpio y autorizado. La confirmación final también comprueba el estado actual del activo y la autorización de la tarea.
El supervisor puede revisar la cantidad de borradores, las categorías de motivos, las acciones rechazadas y el estado de parada sin leer todos los informes confidenciales. Un evaluador independiente comprueba que los borradores existen y que no hubo actuaciones fuera de alcance. Si la detección no es suficientemente buena, la mejora comienza con evidencias controladas, no entregando todos los datos al desarrollador sin restricciones.
Este es el vínculo con ZTAI: conservar la capacidad de realizar el trabajo, reducir la observación e intervención humanas directas y limitar también la autoridad de procesamiento. Sin instrumentos suficientes de diagnóstico, depuración y evaluación, la arquitectura volverá al acceso humano amplio ante su primer fallo serio.
¿Qué respaldan los avances recientes?
OWASP Top 10 for Agentic Applications 2026, publicado el 9 de diciembre de 2025, trata como cuestión propia la seguridad de agentes que planifican y actúan. El 1 de septiembre de 2026 apareció también la página de Agent Control Standard, o ACS, en OWASP, centrada en puntos de control y aplicación de políticas durante la ejecución. Estos avances muestran atención técnica al control de agentes; no certifican esta definición de ZTAI orientada a procesos ni garantizan la seguridad de un producto.
Junto con las especificaciones MCP y los controles de acceso en recuperación, apuntan a conectar herramientas con límites de autoridad aplicables y comprobables. Una función descrita en un documento, una extensión o una API preliminar no equivale a su implementación completa en nuestro sistema. Deben probarse las versiones, la configuración y el comportamiento real.
Automatizar no significa abandonar los límites
Los agentes autónomos ayudan a ZTAI cuando reducen la dependencia de la inspección y manipulación humanas directas sin reconstruir ese acceso mediante herramientas, memoria o resultados. No basta con contar tareas completadas o puestos de trabajo reducidos.
Hay que medir conjuntamente la calidad, la reducción de la necesidad de ver datos, las excepciones humanas, los efectos no autorizados, la latencia efectiva de revocación y parada, y el coste de mantener los controles. Autoridad y responsabilidad deben acompañarse, pero eso no exige dar poder ilimitado al ejecutor.
La prueba final llega cuando el agente se equivoca, los datos cambian o se retira un permiso. ¿Puede el sistema seguir imponiendo sus límites? La respuesta debe proceder de evidencias de ejecución, no de la promesa del modelo de obedecer.