LLM & SLM

Cómo elegir un modelo de lenguaje grande o pequeño

Compara modelos, software de inferencia y requisitos de memoria según tu tarea, con resultados publicados y guías prácticas.

Un modelo de lenguaje en una computadora o servidor propio puede servir para conversar, programar, traducir o responder a partir de documentos. La confidencialidad de los datos, el control de las dependencias externas y los costos son motivos habituales para considerar un despliegue local. La variedad de modelos y métodos de ejecución complica la elección: ¿qué modelo basta para la tarea, qué se puede ejecutar con el hardware disponible y cuándo aporta una mejora útil ampliar la infraestructura?

Esta guía reúne esas decisiones. Sus tablas interactivas comparan modelos de lenguaje pequeños y grandes, modelos especializados, requisitos de hardware y software de ejecución, con enlaces a las fuentes. Los artículos explican las ventajas y limitaciones prácticas de cada enfoque y relacionan la tarea y la calidad necesaria con los recursos y el presupuesto para prestarla.

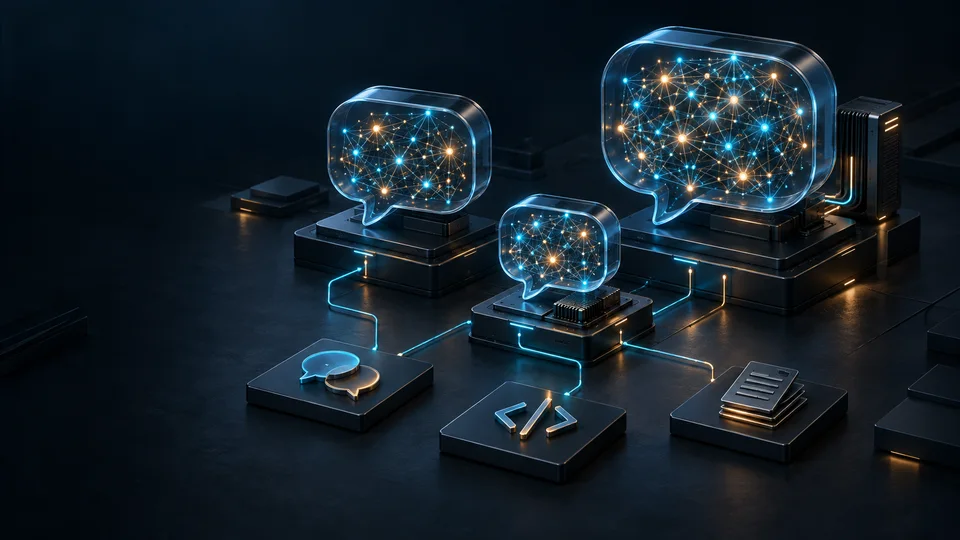
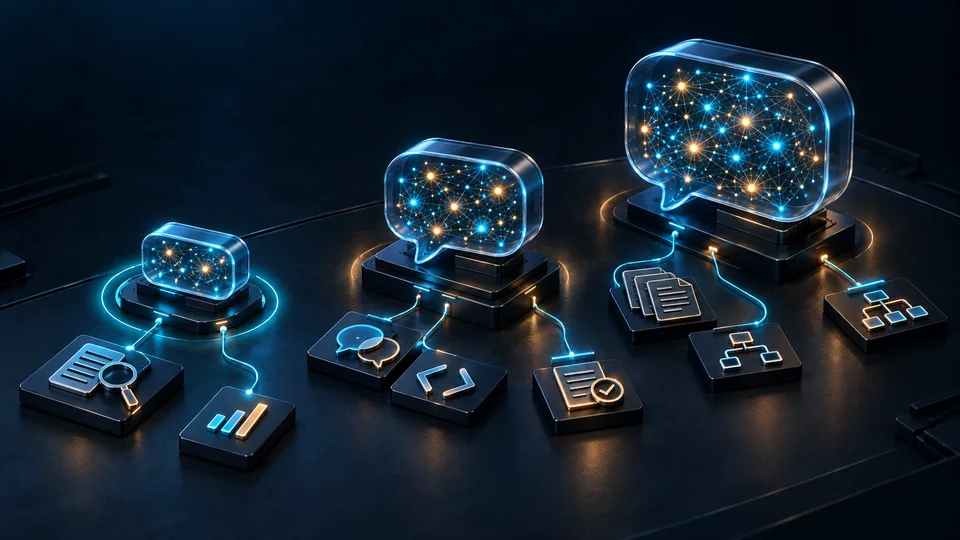
Modelos de lenguaje de distintos tamaños conectados a aplicaciones de conversación, programación y documentos
Cómo usar esta colección

¿Por dónde empezar?

Abre una tabla para comparar opciones; lee los artículos de cada ruta para entender los conceptos y las decisiones.

Guía interactiva

Empiece con las preguntas principales; añada después detalles para afinar el plan.

¿Qué tarea quiere mejorar?

La tarea determina qué capacidades evaluar.

Artículo relacionado ↗
Guía de modelos para organizaciones

Elija una tarea para una primera prueba

Elija resumir cartas, extraer importes o consultar normas. Defina la respuesta correcta con quien realiza la tarea y vuelva a la primera pregunta.

Información que ha proporcionado

Para la siguiente decisión

Para el equipo técnico

Pruebe los mismos candidatos con versiones y ajustes registrados.

Las condiciones de los pesos, del software y del proveedor son distintas. Consulta la licencia de pesos para este uso; el motor y el servicio alojado tienen sus propias condiciones.

Todas las respuestas y su origen

2026-09-20.2 · 2026-09-20 — Qwen3.6 / Qwen3.7

Para el proveedor

Presupueste un piloto con estos modelos, presupuestos y criterios. Separe instalación, operación y soporte; indique mantenimiento y aceptación de carga.

161 Modelo 17 Software 7 tablas interactivas 14 artículos de guía Última actualización de datos:

Una vez definidos el modelo y la memoria necesaria, compare las GPU y los servidores adecuados.

Fuentes y alcance

Las especificaciones proceden de fichas y configuraciones de modelos y de documentación de versiones de software. Los resultados de calidad y velocidad conservan su autor y las condiciones de la fuente; este sitio no ha ejecutado pruebas independientes de los modelos.

Los candidatos cubren funciones distintas: generación de texto, programación, imágenes y documentos, embeddings y reranking. El tamaño y la etiqueta multilingüe no sustituyen la evidencia de la tarea y el idioma elegidos.

La tabla de hardware y la mayoría de los informes de velocidad actuales se centran en NVIDIA. La ejecución en CPU, Apple Silicon y AMD depende del software y del backend; faltan resultados en condiciones equivalentes para clasificar todas estas plataformas por velocidad. Opciones de software y hardware compatible

Las estimaciones de memoria suman los bytes del archivo de pesos, la caché KV y una reserva por dispositivo. La fórmula convencional de KV no se aplica a arquitecturas híbridas, MLA o desconocidas. Los supuestos figuran en la sección de memoria.

Revisión de datos: · Comunicar una corrección mediante los enlaces de contacto del currículum

Vista de datos

Catálogo de modelos

Modelos con pesos descargables: tamaño, arquitectura, contexto y licencia. No se incluyen servicios exclusivamente API.

Prueba de la columna de resultados: MIRACL · nDCG@10 · es

Esta selección se aplica a las columnas de resultados. Las condiciones figuran en los detalles de cada modelo.

Resultados agrupados por prueba ←
161 resultados de 161 filas
Paquete descargable
Ruta documentada de puesta en marcha
Familia
Tipo de modelo
Etapa del modelo
Tamaño declarado del modelo(mil millones)
Filtros avanzados 18 controles
Editor del archivo
Parámetros activos(mil millones)
Arquitectura de parámetros
Entrada
Salida
Aplicación
Longitud máxima de contexto(token)
Estado de publicación
Fecha de publicación
Fecha de revisión
Todas las filas
Comparación de filas y condiciones

Regla de comparación: Se pueden mostrar datos juntos; los cálculos requieren unidades compatibles y atribución a versiones concretas.

Use × junto al encabezado para ocultar una columna. Abra los detalles de la fila para ver fuentes y condiciones.

Columnas ocultas:
Modelos disponibles por API · 6

Estos servicios API quedan fuera de las estimaciones de memoria y las recomendaciones de ejecución local.

GPT-6.1 Sol · gpt-6.1-sol

OpenAI · API · 1.050.000 tokens de contexto · salida máxima 128.000 · 2026-10-03

Entrada: texto e imagen → salida: texto · sin pesos descargables · sin ajuste fino.

Herramientas de Responses API: MCP · computer use · code interpreter · file search · web search

USD estándar por millón de tokens; entrada / entrada en caché / escritura de caché / salida: $2 / $0.1 / $2.5 / $10

Si una solicitud supera los 272.000 tokens de entrada, las tarifas de toda la solicitud pasan a ser $4 / $0.2 / $5 / $15. Las herramientas se cobran aparte; la calidad en persa y el rendimiento requieren evaluación independiente.

Fuente oficial y disponibilidad ↗
Qwen3.7-Plus · qwen3.7-plus-2026-05-26

Alibaba Cloud Model Studio · API · 1.000.000 tokens de contexto · salida máxima 131.072 · 2026-09-20

Fuente oficial y disponibilidad ↗
Qwen3.7-Max · qwen3.7-max-2026-05-20

Alibaba Cloud Model Studio · API · 1.000.000 tokens de contexto · salida máxima 131.072 · 2026-09-20

Fuente oficial y disponibilidad ↗
NVIDIA Nemotron 3.5 Bolt E4B · nvidia/nemotron-3.5-bolt-e4b

NVIDIA · API · 65.536 tokens de contexto · 2026-10-24

Prototipo: NVIDIA ofrece un endpoint gratuito. La ficha base especifica 64K; la página API lo redondea a 66K. «Download not available» describe solo esta plataforma; los pesos públicos BF16 y GGUF están disponibles por separado en Hugging Face. No se verificaron la calidad en persa ni el acceso regional.

Fuente oficial y disponibilidad ↗
Catálogo de modelos de lenguaje
CompararDetalles
Entrada → salida
Usos principales
Licencia
Descargar y ejecutar
Página oficial ↗
BGE · BAAI aproximadamente 0,569 mil millones · Denso Texto ← Vector 8192 tokens Recuperación híbrida de documentos en RAG MIT ↗
Página oficial ↗
BGE · BAAI aproximadamente 0,568 mil millones · Denso Texto ← Datos estructurados 8192 tokens Reordenar documentos recuperados Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Aya / Cohere · Cohere Labs aproximadamente 32 mil millones · Denso Texto ← Texto 131.072 tokens Redacción y chat multilingües con documentos largos CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ Uso comercial sujeto a licencia
Página oficial ↗
Aya / Cohere · Cohere Labs aproximadamente 8 mil millones · Denso Texto ← Texto 8192 tokens Asistente de redacción y reescritura multilingüe CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ Uso comercial sujeto a licencia
Página oficial ↗
Aya / Cohere · Cohere Labs aproximadamente 3,35 mil millones · Denso Texto ← Texto 8192 tokens Chat local en varios idiomas CC-BY-NC-4.0 + Cohere Acceptable Use Policy ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
SmolLM · Hugging Face aproximadamente 1,7 mil millones · Denso Texto ← Texto 8192 tokens Crear un prototipo de asistente pequeño con llamadas a funciones Apache-2.0 ↗
Página oficial ↗
SmolLM · Hugging Face aproximadamente 0,135 mil millones · Denso Texto ← Texto 8192 tokens Explorar el seguimiento de instrucciones con un modelo muy pequeño Apache-2.0 ↗
Página oficial ↗
SmolLM · Hugging Face aproximadamente 0,36 mil millones · Denso Texto ← Texto 8192 tokens Reescritura y resumen de textos cortos Apache-2.0 ↗
Página oficial ↗
SmolLM · Hugging Face aproximadamente 3 mil millones · Denso Texto ← Texto 65.536 tokens Hasta 131.072 tokens con Configurar YaRN y aumentar max_position_embeddings Asistente pequeño con modo de razonamiento seleccionable Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 0,6 mil millones · Denso Texto ← Texto 32.768 tokens Crear un prototipo de chat con el menor Qwen3 Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 1,7 mil millones · Denso Texto ← Texto 32.768 tokens Asistente de texto pequeño con control del razonamiento Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 14,8 mil millones · Denso Texto ← Texto 32.768 tokens Hasta 131.072 tokens con Configuración de YaRN Generación y análisis de texto con Qwen3 denso Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 30,5 mil millones · 3,3 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 32.768 tokens Hasta 131.072 tokens con Configuración de YaRN Asistente con herramientas y arquitectura MoE Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 32,8 mil millones · Denso Texto ← Texto 32.768 tokens Hasta 131.072 tokens con Configuración de YaRN Análisis por etapas con un Qwen3 denso mayor Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 4 mil millones · Denso Texto ← Texto 32.768 tokens Hasta 131.072 tokens con Configuración de YaRN Asistente general de cuatro mil millones de parámetros Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 8,2 mil millones · Denso Texto ← Texto 32.768 tokens Hasta 131.072 tokens con Configuración de YaRN Chat y tareas de texto con control del razonamiento Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 30,5 mil millones · 3,3 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 262.144 tokens Hasta 1.048.576 tokens con Configuración de YaRN Edición de repositorios con un asistente que usa herramientas Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 0,6 mil millones · Denso Texto ← Vector 32.768 tokens Recuperación vectorial con el menor Qwen3 Embedding Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 4 mil millones · Denso Texto ← Vector 32.768 tokens Indexación multilingüe con vectores ajustables Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 8 mil millones · Denso Texto ← Vector 32.768 tokens Recuperación de documentos con el mayor Qwen3 Embedding de la lista Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 0,6 mil millones · Denso Texto ← Datos estructurados 32.768 tokens Reclasificación ligera en la familia Qwen3 Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 4 mil millones · Denso Texto ← Datos estructurados 32.768 tokens Reclasificación de documentos candidatos con instrucciones Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 8 mil millones · Denso Texto ← Datos estructurados 32.768 tokens Reclasificación con la variante Qwen3 de 8B Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 8 mil millones nominales · Denso Recuento total de parámetros sin verificar Texto, Imagen, Vídeo ← Texto 262.144 tokens Leer imágenes y documentos con Qwen3-VL Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 2 mil millones · aproximadamente 2 mil millones Componente lingüístico · Denso · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Prototipos multimodales con Qwen3.5 pequeño Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 35 mil millones · 3 mil millones activos · aproximadamente 35 mil millones Componente lingüístico · Mezcla de expertos (MoE) · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Hasta 1.010.000 tokens con Ampliación de contexto con YaRN Agente multimodal con Qwen3.5 MoE Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 4 mil millones · aproximadamente 4 mil millones Componente lingüístico · Denso · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Hasta 1.010.000 tokens con Ampliación de contexto con YaRN Procesamiento de texto e imagen con cuatro mil millones de parámetros Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 9 mil millones · aproximadamente 9 mil millones Componente lingüístico · Denso · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Hasta 1.010.000 tokens con Ampliación de contexto con YaRN Asistente de documentos e imágenes con Qwen3.5 denso Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 27 mil millones · aproximadamente 27 mil millones Componente lingüístico · Híbrido · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Hasta 1.000.000 tokens con Ampliación de contexto con YaRN Flujos de trabajo largos con un agente de texto e imagen Apache-2.0 ↗
Página oficial ↗
OLMo · Allen Institute for AI aproximadamente 7 mil millones · Denso Texto ← Texto 65.536 tokens Investigación de seguimiento de instrucciones con entrenamiento examinable Apache-2.0 ↗
Página oficial ↗
DeepSeek · DeepSeek aproximadamente 8 mil millones · Denso Texto ← Texto 131.072 tokens Explorar razonamiento destilado de R1-0528 MIT ↗
Página oficial ↗
DeepSeek · DeepSeek aproximadamente 70 mil millones · Denso Texto ← Texto 131.072 tokens Razonamiento destilado sobre Llama 70B MIT + underlying Llama 3.3 terms ↗
Página oficial ↗
DeepSeek · DeepSeek aproximadamente 1,5 mil millones · Denso Texto ← Texto 131.072 tokens Explorar los límites del razonamiento en un modelo destilado muy pequeño MIT ↗
Página oficial ↗
DeepSeek · DeepSeek aproximadamente 14 mil millones · Denso Texto ← Texto 131.072 tokens Resolución de problemas con una destilación R1 intermedia MIT ↗
Página oficial ↗
DeepSeek · DeepSeek aproximadamente 32 mil millones · Denso Texto ← Texto 131.072 tokens Análisis y programación con una destilación densa de 32B MIT ↗
Página oficial ↗
DeepSeek · DeepSeek aproximadamente 7 mil millones · Denso Texto ← Texto 131.072 tokens Resolución de problemas con la destilación R1 de 7B MIT ↗
Página oficial ↗
DeepSeek · DeepSeek 685,397 mil millones de elementos almacenados · Mezcla de expertos (MoE) Recuento almacenado en el checkpoint, incluidos componentes adicionales; no son los parámetros activos por token generado. Texto ← Texto 163.840 tokens Conectar razonamiento y herramientas en flujos de agentes MIT ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
DeepSeek · DeepSeek 8 mil millones Activos durante prefill · 16 mil millones Activos durante decode · aproximadamente 552 mil millones Red principal · aproximadamente 196 mil millones Memoria condicional Engram · Mezcla de expertos (MoE) · atención híbrida Recuento total de parámetros sin verificar Texto, Imagen ← Texto 1.000.000 tokens Agente multimodal para entradas muy largas MIT ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Gemma · Google DeepMind aproximadamente 12 mil millones · Denso Texto, Imagen ← Texto 131.072 tokens Consultar imágenes y texto con Gemma 3 intermedio gemma ↗
Página oficial ↗
Gemma · Google DeepMind aproximadamente 1 mil millones · Denso Texto ← Texto 32.768 tokens Asistente de texto pequeño de la familia Gemma 3 gemma ↗
Página oficial ↗
Gemma · Google DeepMind aproximadamente 27 mil millones · Denso Texto, Imagen ← Texto 131.072 tokens Comprender texto e imagen con el mayor Gemma 3 de la lista gemma ↗
Página oficial ↗
Gemma · Google DeepMind aproximadamente 4 mil millones · Denso Texto, Imagen ← Texto 131.072 tokens Primeros pasos con imágenes en la familia Gemma 3 gemma ↗
Página oficial ↗
Gemma · Google DeepMind aproximadamente 26 mil millones nominales · aproximadamente 25,2 mil millones Componente lingüístico de la tabla de la entidad editora · Mezcla de expertos (MoE) Recuento total de parámetros sin verificar Texto, Imagen, Vídeo ← Texto 262.144 tokens Razonamiento multimodal con Gemma 4 MoE Apache-2.0 ↗
Página oficial ↗
Gemma · Google DeepMind aproximadamente 2,3 mil millones Recuento efectivo sin la tabla de embeddings · aproximadamente 5,1 mil millones Componente lingüístico con embeddings · aproximadamente 0,3 mil millones Codificador de audio · Denso Recuento total de parámetros sin verificar Texto, Imagen, Audio, Vídeo ← Texto 131.072 tokens Procesamiento local de texto, imagen y audio con Gemma 4 pequeño Apache-2.0 ↗
Página oficial ↗
Granite · IBM aproximadamente 2 mil millones · Denso Texto ← Texto 131.072 tokens Generar respuestas a partir de documentos recuperados Apache-2.0 ↗
Página oficial ↗
E5 · intfloat / multilingual E5 authors 0,118 mil millones · Denso Texto ← Vector 512 tokens Recuperación multilingüe con vectores de pocas dimensiones MIT ↗
Página oficial ↗
Llama · Meta aproximadamente 70 mil millones · Denso Texto ← Texto 131.072 tokens Asistente general con Llama 3.1 grande llama3.1 ↗
Página oficial ↗
Llama · Meta aproximadamente 8 mil millones · Denso Texto ← Texto 131.072 tokens Chat y tareas de texto con Llama 3.1 8B llama3.1 ↗
Página oficial ↗
Llama · Meta aproximadamente 1 mil millones · Denso Texto ← Texto 131.072 tokens Reescritura y resumen locales con Llama pequeño llama3.2 ↗
Página oficial ↗
Llama · Meta aproximadamente 3 mil millones · Denso Texto ← Texto 131.072 tokens Asistente de texto en el dispositivo con Llama 3B llama3.2 ↗
Página oficial ↗
Phi · Microsoft aproximadamente 3,8 mil millones · Denso Texto ← Texto 131.072 tokens Análisis y lógica con recursos más limitados MIT ↗
Página oficial ↗
Mistral · Mistral AI aproximadamente 24 mil millones · Denso Texto, Imagen ← Texto 262.144 tokens Agente de edición de varios archivos y búsqueda en repositorios Apache-2.0 ↗
Página oficial ↗
Mistral · Mistral AI aproximadamente 3,4 mil millones Componente lingüístico · Denso Recuento total de parámetros sin verificar Texto, Imagen ← Texto 262.144 tokens Pesos publicados en FP8; la capacidad de ejecución depende de la precisión y de la memoria del contexto. Asistente multimodal para despliegue en el borde Apache-2.0 ↗
Página oficial ↗
Mistral · Mistral AI aproximadamente 7 mil millones · Denso Texto ← Texto 32.768 tokens Asistente textual con formato Mistral de llamadas a funciones Apache-2.0 ↗
Página oficial ↗
Mistral · Mistral AI aproximadamente 24 mil millones · Denso Texto, Imagen ← Texto 131.072 tokens Asistente multilingüe de texto e imagen Apache-2.0 ↗
Página oficial ↗
Nemotron · NVIDIA aproximadamente 9 mil millones · Híbrido · atención híbrida Texto ← Texto 131.072 tokens Respuestas basadas en documentos con presupuesto de razonamiento nvidia-open-model-license ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
gpt-oss · OpenAI aproximadamente 117 mil millones · 5,1 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 131.072 tokens Con la configuración de YaRN que acompaña al modelo publicado Agente de razonamiento ajustable con gpt-oss grande Apache-2.0 ↗
Página oficial ↗
gpt-oss · OpenAI aproximadamente 21 mil millones · 3,6 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 131.072 tokens Con la configuración de YaRN que acompaña al modelo publicado Razonamiento local con gpt-oss pequeño Apache-2.0 ↗
Página oficial ↗
GLM · Z.ai aproximadamente 30 mil millones · 3 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 202.752 tokens Agente de programación con razonamiento conservado MIT ↗
Página oficial ↗
Kimi · Moonshot AI aproximadamente 1000 mil millones nominales · 32 mil millones activos · Mezcla de expertos (MoE) Recuento total de parámetros sin verificar Texto ← Texto 131.072 tokens Agente textual para programación y flujos con herramientas Modified MIT ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Kimi · Moonshot AI aproximadamente 1000 mil millones nominales · 32 mil millones activos · Mezcla de expertos (MoE) Recuento total de parámetros sin verificar Texto ← Texto 262.144 tokens Agente de razonamiento para cadenas largas de herramientas y análisis Modified MIT ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Kimi · Moonshot AI aproximadamente 1000 mil millones nominales · 32 mil millones activos · Mezcla de expertos (MoE) Recuento total de parámetros sin verificar Texto, Imagen, Vídeo ← Texto 262.144 tokens Agente multimodal para programar a partir de diseños visuales y analizar documentos Modified MIT ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
MiniMax · MiniMax aproximadamente 230 mil millones nominales · 10 mil millones activos · Mezcla de expertos (MoE) Recuento total de parámetros sin verificar Texto ← Texto 196.608 tokens Asistente de desarrollo de software para flujos con herramientas Modified MIT ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
MiniMax · MiniMax aproximadamente 230 mil millones nominales · 10 mil millones activos · Mezcla de expertos (MoE) Recuento total de parámetros sin verificar Texto ← Texto 196.608 tokens Modelo con herramientas para programación y planificación por etapas Modified MIT ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 235 mil millones · 22 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 262.144 tokens Asistente grande de respuesta directa con contexto largo Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 480 mil millones · 35 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 262.144 tokens Agente de programación para repositorios grandes con varios archivos Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 27 mil millones · Denso · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Asistente multimodal para análisis, código y documentos Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 0,8 mil millones · Denso · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Modelo pequeño para prototipos y especialización por tarea Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 122 mil millones · 10 mil millones activos · Mezcla de expertos (MoE) Texto, Imagen, Vídeo ← Texto 262.144 tokens Modelo MoE multimodal para análisis y uso de herramientas Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 397 mil millones · 17 mil millones activos · Mezcla de expertos (MoE) Texto, Imagen, Vídeo ← Texto 262.144 tokens Asistente multimodal grande para problemas complejos Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Llama · Meta aproximadamente 70 mil millones nominales · Denso Recuento total de parámetros sin verificar Texto ← Texto 131.072 tokens Asistente textual multilingüe para respuestas y tareas empresariales llama3.3 ↗ Uso comercial sujeto a licencia
Página oficial ↗
Phi · Microsoft aproximadamente 14 mil millones nominales · Denso Recuento total de parámetros sin verificar Texto ← Texto 16.384 tokens Modelo en inglés para matemáticas, lógica y generación de texto MIT ↗
Página oficial ↗
SmolVLM · Hugging Face aproximadamente 2,2 mil millones nominales · Denso Recuento total de parámetros sin verificar Texto, Imagen, Vídeo ← Texto 8192 tokens Modelo pequeño para preguntas sobre imágenes y video Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
MiniLM · Sentence Transformers 0,023 mil millones · Denso Texto ← Vector 256 tokens Embeddings ligeros en inglés para búsqueda y agrupación Apache-2.0 ↗
Página oficial ↗
E5 · intfloat / multilingual E5 authors 0,278 mil millones · Denso Texto ← Vector 512 tokens Embeddings multilingües con prefijos distintos para consultas y documentos MIT ↗
Página oficial ↗
E5 · intfloat / multilingual E5 authors 0,56 mil millones · Denso Texto ← Vector 512 tokens Embeddings multilingües para búsqueda semántica MIT ↗
Página oficial ↗
BGE · BAAI 0,033 mil millones · Denso Texto ← Vector 512 tokens Modelo pequeño de embeddings en inglés para recuperación de documentos MIT ↗
Página oficial ↗
BGE · BAAI 0,278 mil millones · Denso Texto ← Datos estructurados 512 tokens Reclasificador en inglés y chino para resultados de búsqueda MIT ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 7,61 mil millones · Denso Texto ← Texto 32.768 tokens Asistente pequeño de programación para explicar y corregir código Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 14,7 mil millones · Denso Texto ← Texto 32.768 tokens Asistente de programación para generar, explicar y depurar código Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud aproximadamente 32,5 mil millones · Denso Texto ← Texto 32.768 tokens Asistente de programación con mayor capacidad para problemas difíciles Apache-2.0 ↗
Página oficial ↗
EmbeddingGemma · Google DeepMind aproximadamente 0,3 mil millones nominales · Denso Recuento total de parámetros sin verificar Texto ← Vector 2048 tokens Modelo pequeño de embeddings multilingües para ejecución en el dispositivo gemma ↗ Uso comercial sujeto a licencia
Página oficial ↗
Jina · Jina AI aproximadamente 0,57 mil millones nominales · Denso Recuento total de parámetros sin verificar Texto ← Vector 8192 tokens Modelo de embeddings multilingües con adaptadores por tarea CC-BY-NC-4.0 ↗ Uso comercial sujeto a licencia
Página oficial ↗
Jina · Jina AI 0,278 mil millones · Denso Texto ← Datos estructurados 1024 tokens Reclasificador multilingüe para documentos más largos CC-BY-NC-4.0 ↗ Uso comercial sujeto a licencia
Página oficial ↗
Mixedbread · Mixedbread 0,335 mil millones · Denso Texto ← Vector 512 tokens Modelo de embeddings en inglés para recuperación con instrucciones de consulta Apache-2.0 ↗
Página oficial ↗
Nomic · Nomic AI 0,137 mil millones · Denso Texto ← Vector 8192 tokens Modelo de embeddings en inglés con contexto largo y dimensiones reducibles Apache-2.0 ↗
Página oficial ↗
ModernBERT · Answer.AI / LightOn 0,15 mil millones · Denso Texto ← Datos estructurados 8192 tokens Codificador base para entrenar clasificación y extracción de entidades Apache-2.0 ↗
Página oficial ↗
Qwen · Qwen 1,54 mil millones · Denso Texto ← Texto 32.768 tokens Completado de código y relleno intermedio apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
StarCoder2 · bigcode 3 mil millones · Denso Texto ← Texto 16.384 tokens Atención local con ventana de 4096 tokens. Completado de código con atención de ventana deslizante bigcode-openrail-m ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Qwen · Qwen 80 mil millones · 3 mil millones activos · Mezcla de expertos (MoE) · atención híbrida Texto ← Texto 262.144 tokens Agente de programación apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
E5 · intfloat 0,56 mil millones · Denso Texto ← Vector 512 tokens Recuperación multilingüe con instrucciones de tarea mit ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Qwen · Qwen 4 mil millones · Denso Texto ← Texto 262.144 tokens Asistente pequeño de respuesta directa apache-2.0 ↗
SAFETENSORS · Oficial ↗SAFETENSORS · Tercero ↗
Página oficial ↗
Tooka · PartAI 0,123 mil millones · Denso Texto ← Vector 512 tokens Embeddings de texto en persa —
SAFETENSORS · Oficial ↗
Página oficial ↗
Tooka · PartAI 0,353 mil millones · Denso Texto ← Vector 512 tokens Embeddings de texto en persa —
SAFETENSORS · Oficial ↗
Página oficial ↗
ParsBERT · HooshvareLab Denso Recuento de parámetros no registrado Texto ← Datos estructurados 512 tokens Base de entrenamiento para tareas en persa —
PYTORCH · Oficial ↗
Página oficial ↗
Salamandra · BSC-LT 2,253 mil millones · Denso Texto ← Texto 8192 tokens Generación de texto en lenguas ibéricas Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Salamandra · BSC-LT 7,768 mil millones · Denso Texto ← Texto 8192 tokens Generación de texto en lenguas ibéricas Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
MiniCPM · openbmb 2,517 mil millones · Denso Texto ← Texto 131.072 tokens Razonamiento con un modelo compacto Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
LFM · LiquidAI 1,17 mil millones · Híbrido Texto ← Texto 32.768 tokens Extracción de información en el dispositivo LFM Open License 1.0 ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Granite · ibm-granite 3,66 mil millones · Denso Texto ← Texto 131.072 tokens Razonamiento con un modelo compacto Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
GLM · Z.ai 744 mil millones · 40 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 202.752 tokens Programación y uso de herramientas MIT ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
GLM · Z.ai 753,864 mil millones de elementos almacenados · Mezcla de expertos (MoE) Recuento almacenado en el checkpoint, incluidos componentes adicionales; no son los parámetros activos por token generado. Texto ← Texto 202.752 tokens Programación y uso de herramientas MIT ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
GLM · Z.ai 753,33 mil millones de elementos almacenados · Mezcla de expertos (MoE) Recuento almacenado en el checkpoint, incluidos componentes adicionales; no son los parámetros activos por token generado. Texto ← Texto 1.048.576 tokens Programación y uso de herramientas MIT ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
GLM · Z.ai Mezcla de expertos (MoE) Recuento de parámetros no registrado Texto ← Texto 1.048.576 tokens Programación y uso de herramientas GLM-5.3 License ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Kimi · Moonshot AI 1000 mil millones · 32 mil millones activos · Mezcla de expertos (MoE) Texto, Imagen, Vídeo ← Texto 262.144 tokens Programación y uso de herramientas Modified MIT ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Kimi · Moonshot AI 1000 mil millones · 32 mil millones activos · Mezcla de expertos (MoE) Texto, Imagen, Vídeo ← Texto 262.144 tokens Programación y uso de herramientas Modified MIT ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Kimi · Moonshot AI 2800 mil millones · 104 mil millones activos · Mezcla de expertos (MoE) Texto, Imagen, Vídeo ← Texto 1.048.576 tokens Programación y uso de herramientas Kimi K3 License ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Qwen · Qwen 2 mil millones · Denso Texto, Imagen, Vídeo ← Vector 32.768 tokens Recuperación multimodal Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Qwen · Qwen 8 mil millones · Denso Texto, Imagen, Vídeo ← Vector 32.768 tokens Recuperación multimodal Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Qwen · Qwen 2 mil millones · Denso Texto, Imagen, Vídeo ← Datos estructurados 32.768 tokens Reordenación multimodal Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Qwen · Qwen 8 mil millones · Denso Texto, Imagen, Vídeo ← Datos estructurados 32.768 tokens Reordenación multimodal Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud 27,781 mil millones · aproximadamente 27 mil millones Componente lingüístico; cifra redondeada del editor · Denso · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Hasta 1.010.000 tokens con Requiere configurar YaRN; contexto nativo de 262.144 tokens. Modelo textual y visual con atención híbrida Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Qwen · Qwen / Alibaba Cloud 35,952 mil millones · 3 mil millones activos · aproximadamente 35 mil millones Componente lingüístico; cifra redondeada del editor · Mezcla de expertos (MoE) · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Hasta 1.010.000 tokens con Requiere configurar YaRN; contexto nativo de 262.144 tokens. Modelo textual y visual con atención híbrida Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
HY-MT · Tencent 1,8 mil millones · Denso Texto ← Texto — Traducción especializada de texto Tencent HY Community License ↗ Uso comercial sujeto a licencia
Página oficial ↗
HY-MT · Tencent 7 mil millones · Denso Texto ← Texto — Traducción especializada de texto Tencent HY Community License ↗ Uso comercial sujeto a licencia
Página oficial ↗
HY-MT · Tencent 1,8 mil millones · Denso Texto ← Texto — Traducción especializada Apache-2.0 ↗
Página oficial ↗
HY-MT · Tencent 7 mil millones · Denso Texto ← Texto — Traducción especializada Apache-2.0 ↗
Página oficial ↗
HY-MT · Tencent 30 mil millones · 3 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto — Traducción especializada Apache-2.0 ↗
SAFETENSORS · Oficial ↗SAFETENSORS · Oficial ↗
Página oficial ↗
Gemma · Google 4 mil millones · Denso Texto, Imagen ← Texto — Traducción especializada Gemma terms ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Gemma · Google 12 mil millones · Denso Texto, Imagen ← Texto — Traducción especializada Gemma terms ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Gemma · Google 27 mil millones · Denso Texto, Imagen ← Texto — Traducción especializada Gemma terms ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
MADLAD · Google 3 mil millones · Denso Texto ← Texto — Traducción especializada Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
NLLB · Meta 0,6 mil millones · Denso Texto ← Texto — Traducción especializada CC-BY-NC-4.0 ↗ Uso comercial sujeto a licencia
PYTORCH · Oficial ↗
Página oficial ↗
Qwen-Image · Qwen / Alibaba aproximadamente 7 mil millones Generador de imágenes DiT · aproximadamente 8 mil millones Codificador Qwen3-VL · Otro Recuento total de parámetros sin verificar Texto, Imagen ← Imagen — Generación y edición de imágenes Qwen Research License — no comercial ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
MiMo · Xiaomi MiMo 1020 mil millones · 42 mil millones activos · Mezcla de expertos (MoE) · atención híbrida Texto, Imagen, Vídeo, Audio ← Texto 1.048.576 tokens Programación, agentes de software y análisis de texto e imágenes MIT ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
LFM · LiquidAI 3,123 mil millones · Híbrido Texto, Imagen ← Texto 32.768 tokens Modelo objetivo para entradas de imagen y texto LFM Open License 1.0 ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
LFM · LiquidAI 0,279 mil millones · Denso — — Requiere LFM2.5-VL-3B; generación de borradores de tokens LFM Open License 1.0 ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
Cohere Embed · Cohere Otro Recuento de parámetros no registrado Texto, Imagen ← Vector 128.000 tokens 128K declarado por el editor; calidad de contexto largo no medida. Espacio vectorial compartido Pro/Fast: indexación con Pro y consultas con Fast, con dimensiones y formato iguales. No implica compatibilidad con índices de Embed 4. —
Página oficial ↗
Cohere Embed · Cohere Otro Recuento de parámetros no registrado Texto, Imagen ← Vector 128.000 tokens 128K declarado por el editor; calidad de contexto largo no medida. Espacio vectorial compartido Pro/Fast: indexación con Pro y consultas con Fast, con dimensiones y formato iguales. No implica compatibilidad con índices de Embed 4. —
Página oficial ↗
Clef · Cloudflare 27 mil millones · Denso Texto, Imagen ← Datos estructurados — Clasificación, enrutamiento, puntuación y control de decisiones de agentes Apache-2.0 ↗
Página oficial ↗
Clef · Cloudflare 9 mil millones · Denso Texto, Imagen ← Datos estructurados — Clasificación, enrutamiento, puntuación y control de decisiones de agentes Apache-2.0 ↗
Página oficial ↗
North Small Translate · Cohere Labs 218 mil millones · 25 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 32.768 tokens Hasta 16K tokens de entrada y 16K de salida; 32K es el límite combinado, no el cupo de entrada. Traducción de texto; los pesos requieren aceptar las condiciones de acceso. CC BY-NC 4.0 ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Bespoke Nimble · Bespoke Labs 9 mil millones · Denso Texto ← Datos estructurados 8192 tokens Requiere los pesos completos de Qwen3.5-9B; el archivo de 165 MiB es solo el adaptador. Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
GLM · Z.ai 320 mil millones · 18 mil millones activos · Mezcla de expertos (MoE) · atención híbrida Texto, Imagen, Vídeo ← Texto — Texto e imágenes para programación y agentes; la calidad en persa no se ha probado. MIT ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Beam · Reflection 501,3 mil millones · 23,4 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 1.048.576 tokens Código, razonamiento y herramientas de agentes Apache-2.0 ↗
Página oficial ↗
K2 Horizon · IFM 0,9 mil millones · Denso Texto ← Texto 131.072 tokens Conversación, razonamiento, código y llamadas a herramientas Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
K2 Horizon · IFM 3,7 mil millones · Denso Texto ← Texto 524.288 tokens Conversación, razonamiento, código y llamadas a herramientas Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
K2 Horizon · IFM 7 mil millones · Denso Texto ← Texto 524.288 tokens Conversación, razonamiento, código y llamadas a herramientas Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
K2 Horizon · IFM 32 mil millones · Denso Texto ← Texto 524.288 tokens Conversación, razonamiento, código y llamadas a herramientas Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
K2 Horizon · IFM 36 mil millones · 4 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 524.288 tokens Conversación, razonamiento, código y llamadas a herramientas Apache-2.0 ↗
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
EmbeddingGemma · Google DeepMind 0,74 mil millones · aproximadamente 0,27 mil millones Componente de texto; carga independiente · Denso · atención híbrida Texto, Imagen, Vídeo, Audio ← Vector 8192 tokens Recuperación multimodal local para RAG; no genera respuestas Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Muse · Meta 816 mil millones · 42 mil millones activos · Mezcla de expertos (MoE) Texto, Imagen ← Texto 1.000.000 tokens Razonamiento, código y análisis de imágenes Muse Model License ↗ Uso comercial sujeto a licencia
SAFETENSORS · Oficial ↗
Página oficial ↗
Nemotron · NVIDIA 120 mil millones · 12 mil millones activos · Híbrido Texto, Imagen, Vídeo ← Texto 1.048.576 tokens Razonamiento, código y comprensión de documentos y vídeo OpenMDW-1.1 ↗
SAFETENSORS · Oficial ↗SAFETENSORS · Oficial ↗
Página oficial ↗
Nemotron · NVIDIA 74 mil millones · 9 mil millones activos · Híbrido Texto, Imagen, Vídeo ← Texto 262.144 tokens Agentes locales, código y comprensión de imágenes OpenMDW-1.1 ↗
Página oficial ↗
DeepSeek · DeepSeek Mezcla de expertos (MoE) Recuento de parámetros no registrado Texto, Imagen ← Texto 1.000.000 tokens Razonamiento, código, agentes y entrada visual MIT ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
LFM · LiquidAI 24 mil millones · 2,45 mil millones activos · Mezcla de expertos (MoE) Texto ← Texto 131.072 tokens Razonamiento y agentes locales LFM Open License v1.0 ↗ Uso comercial sujeto a licencia
Página oficial ↗
Granite · IBM aproximadamente 8 mil millones Modelo base, sin el paquete completo de adaptadores y codificador · Denso Recuento total de parámetros sin verificar Texto, Audio ← Texto 131.072 tokens Chat, decisiones y transcripción de voz Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Granite · IBM aproximadamente 30 mil millones Modelo base, sin el paquete completo de adaptadores y codificador · Denso Recuento total de parámetros sin verificar Texto, Audio ← Texto 131.072 tokens Chat, decisiones y transcripción de voz Apache-2.0 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Nemotron · NVIDIA 4 mil millones · Otro · atención híbrida Texto ← Texto 262.144 tokens Razonamiento textual; vía de ejecución pendiente de validación OpenMDW-1.1 ↗
Página oficial ↗
Nemotron · NVIDIA 1,55 mil millones · Denso Texto, Imagen ← Vector 32.768 tokens Recuperación de documentos para RAG; no genera respuestas de texto OpenMDW-1.1 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Nemotron · NVIDIA 8,38 mil millones · Denso Texto, Imagen ← Vector 32.768 tokens Recuperación de documentos para RAG; no genera respuestas de texto OpenMDW-1.1 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
MiniCPM-V · OpenBMB aproximadamente 1 mil millones nominales · Denso · atención híbrida Recuento total de parámetros sin verificar Texto, Imagen, Vídeo ← Texto 262.144 tokens Comprensión de imágenes, OCR, documentos y vídeo Apache-2.0 ↗
Página oficial ↗
MiniCPM-V · OpenBMB 35 mil millones · 3 mil millones activos · Mezcla de expertos (MoE) · atención híbrida Texto, Imagen, Vídeo ← Texto 262.144 tokens Comprensión de imágenes, OCR, documentos y vídeo Apache-2.0 ↗
Página oficial ↗
d3 · vLLM Semantic Router 2,21 mil millones · Denso · atención híbrida Texto, Datos estructurados, Imagen, Vídeo ← Datos estructurados 262.144 tokens Clasificación, enrutamiento, puntuación y control de decisiones del agente Apache-2.0 ↗
SAFETENSORS · Oficial ↗OLLAMA · Tercero ↗
Página oficial ↗
d3 · vLLM Semantic Router 4,54 mil millones · Denso · atención híbrida Texto, Datos estructurados, Imagen, Vídeo ← Datos estructurados 262.144 tokens Clasificación, enrutamiento, puntuación y control de decisiones del agente Apache-2.0 ↗
SAFETENSORS · Oficial ↗OLLAMA · Tercero ↗
Página oficial ↗
d3 · vLLM Semantic Router 8,39 mil millones · Denso · atención híbrida Texto, Datos estructurados, Imagen, Vídeo ← Datos estructurados 262.144 tokens Clasificación, enrutamiento, puntuación y control de decisiones del agente Apache-2.0 ↗
SAFETENSORS · Oficial ↗OLLAMA · Tercero ↗
Página oficial ↗
d3 · vLLM Semantic Router 26,09 mil millones · Denso · atención híbrida Texto, Datos estructurados, Imagen, Vídeo ← Datos estructurados 262.144 tokens Clasificación, enrutamiento, puntuación y control de decisiones del agente Apache-2.0 ↗
SAFETENSORS · Oficial ↗OLLAMA · Tercero ↗
Página oficial ↗
Nemotron · NVIDIA 8 mil millones · aproximadamente 4 mil millones Parámetros efectivos; no sustituyen al total ni a la memoria de pesos · Denso Texto ← Texto 65.536 tokens Conversación local, razonamiento y llamadas a herramientas OpenMDW-1.1 ↗
Página oficial ↗
Nemotron · NVIDIA 8,38 mil millones · Denso Texto, Imagen ← Datos estructurados 32.768 tokens Reordenación de documentos en RAG y Vision RAG OpenMDW-1.1 ↗
SAFETENSORS · Oficial ↗
Página oficial ↗
Mistral · Mistral AI 1000 mil millones · 52 mil millones activos · Mezcla de expertos (MoE) Texto, Imagen ← Texto 1.048.576 tokens Programación con agentes, análisis y documentos visuales Mistral Ecosystem Open-Weight License ↗ Uso comercial sujeto a licencia
Página oficial ↗
Mage · Microsoft 4,742 mil millones · Denso Texto, Imagen ← Texto 262.144 tokens Agente de escritorio con herramientas computer_use y bash Apache-2.0 ↗
SAFETENSORS · Oficial ↗

«—» indica que no hay información registrada; no significa que el modelo carezca de esa capacidad.

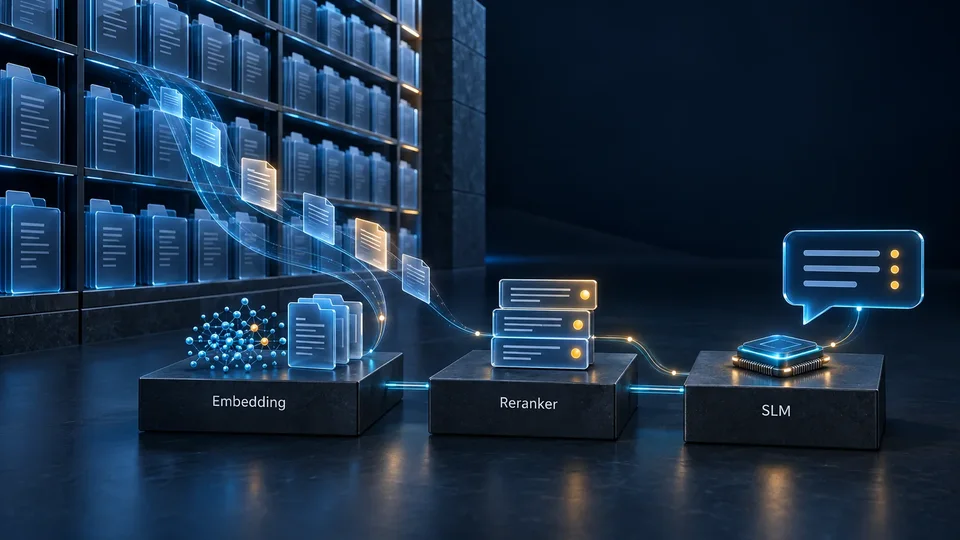
Para RAG, examine por separado la recuperación, la reclasificación y la generación de respuestas.
Vista de datos

Adecuación del modelo a la tarea

Modelos para conversación, programación, búsqueda y documentos.

Prueba de la columna de resultados: MIRACL · nDCG@10 · es

Esta selección se aplica a las columnas de resultados. Las condiciones figuran en los detalles de cada modelo.

Resultados agrupados por prueba ←
¿Qué modelo conviene considerar?

Puntos de partida documentados, no una clasificación de calidad.

Recuperación en español

E5-Small es una referencia de menor tamaño; Large-Instruct obtiene más en este informe MIRACL en español. Los resultados de Qwen son agregados multilingües, no puntuaciones específicas de español.

Cuando consultas y documentos están en español; identifique por separado la recuperación entre idiomas.

La diferencia de 51,2 a 53,7 no acredita la calidad de la respuesta final ni la cobertura de todas las variedades del español.

Recuperación en inglés

Trate Large y Large-Instruct como variantes distintas: Large obtiene más en MIRACL inglés en este informe. Para valorar un reranker, use la comparación de Qwen con el mismo conjunto de candidatos.

Cuando importa más la evidencia en el idioma objetivo que una media multilingüe.

La etiqueta Instruct no garantiza una mejora en todas las tareas.

Añadir una etapa de reranking

Empiece la comparación de tamaños con 0,6B. Considere 4B y 8B si la mejora en la tarea justifica el presupuesto de la segunda etapa; 8B no encabeza todas las métricas.

Cuando los documentos pertinentes están entre los candidatos pero aparecen mal ordenados; la cantidad de candidatos forma parte del diseño.

El reranker no puede recuperar un documento ausente de su conjunto de entrada.

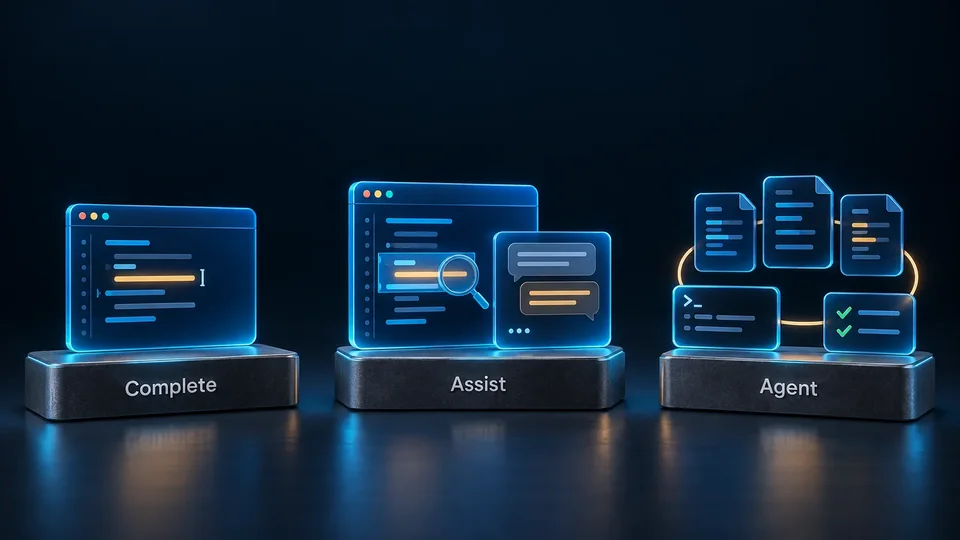
¿Ejercicios de programación o edición de código?

Para un asistente que sigue instrucciones, separa edición de repositorios y ejercicios de programación. StarCoder2-3B sirve para autocompletado/FIM; HumanEval no mide conversación ni calidad de un agente editor.

Una vez definida la interfaz: autocompletado, cambios en varios archivos o resolución de un ejercicio.

Los parámetros activos de un MoE no determinan la memoria de todos sus pesos residentes.

Un modelo pequeño para una tarea acotada

LFM es un candidato pequeño para extracción y flujos acotados; MiniCPM y Granite también cuentan con evidencia de razonamiento y herramientas. El tamaño real de los pesos puede diferir de la cifra redondeada del nombre.

Cuando se conocen la tarea, el formato de salida y el límite de memoria.

Una buena puntuación de un modelo pequeño no demuestra menor latencia ni viabilidad en portátil con el contexto máximo.

Elegir un modelo generativo para español

Salamandra aporta evidencia directa en varias tareas españolas. Compárelo con candidatos multilingües generales; los datos disponibles no identifican al mejor chatbot en español.

Cuando es necesario separar la evidencia en español de una afirmación multilingüe general.

La cobertura del idioma no acredita todas las regiones ni los ámbitos profesionales.

Clasificación de intenciones y textos

Use MassiveIntent y MTOP para valorar la clasificación de intenciones. El modelo de embeddings es un componente; el resultado también depende del clasificador y de sus datos de entrenamiento.

Para un conjunto definido de etiquetas; la evidencia publicada ayuda a formar una lista inicial.

Un modelo de embeddings o ParsBERT sin adaptación no es un chatbot listo para usar.

SmolLM3-3B

Modelo de 3 mil millones con dos modos de razonamiento. Para respuestas breves, elige el modo sin razonamiento y un límite explícito de salida.

es: Declaración del editor
SmolLM3-3B — model card · Informe del editor https://huggingface.co/HuggingFaceTB/SmolLM3-3B/blob/a07cc9a04f16550a088caea529712d1d335b0ac1/README.md ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Revisión / commit
a07cc9a04f16550a088caea529712d1d335b0ac1
Sección pertinente de la fuente
README.md: model description / architecture / intended use; matching lines 26, 33, 345
  • Las cifras del anuncio del modelo están redondeadas; safetensors.total cuenta elementos almacenados, no necesariamente parámetros únicos.
SmolLM3-3B — Hub metadata · Informe del editor https://huggingface.co/api/models/HuggingFaceTB/SmolLM3-3B?blobs=true ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Revisión / commit
a07cc9a04f16550a088caea529712d1d335b0ac1
Sección pertinente de la fuente
$.sha; $.id; $.pipeline_tag; $.cardData; $.safetensors; $.siblings
  • El inventario de archivos y el número de tensores no equivalen a memoria de ejecución ni a parámetros únicos.
SmolLM3-3B — parameter specification · Informe del editor https://huggingface.co/HuggingFaceTB/SmolLM3-3B/blob/a07cc9a04f16550a088caea529712d1d335b0ac1/README.md ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Revisión / commit
a07cc9a04f16550a088caea529712d1d335b0ac1
Sección pertinente de la fuente
README.md: parameter count / named model variant; matching lines 14, 35, 59, 90, 151, 160, 210, 216, 221, 225, 246, 261
  • Las cifras del anuncio del modelo están redondeadas; safetensors.total cuenta elementos almacenados, no necesariamente parámetros únicos.
SmolLM3-3B — license declaration · Informe del editor https://huggingface.co/HuggingFaceTB/SmolLM3-3B/blob/a07cc9a04f16550a088caea529712d1d335b0ac1/README.md ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Revisión / commit
a07cc9a04f16550a088caea529712d1d335b0ac1
Sección pertinente de la fuente
README.md: license / underlying-model terms; Hub $.cardData.license; matching lines 3, 31, 381, 382
SmolLM3-3B — configuration · Informe del editor https://huggingface.co/HuggingFaceTB/SmolLM3-3B/blob/a07cc9a04f16550a088caea529712d1d335b0ac1/config.json ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Revisión / commit
a07cc9a04f16550a088caea529712d1d335b0ac1
Sección pertinente de la fuente
config.json: architectures, model_type, text_config, max_position_embeddings, quantization_config, torch_dtype/dtype
SmolLM3 release · Informe del editor https://huggingface.co/blog/smollm3 ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Sección pertinente de la fuente
Publication date July 8 2025; SmolLM3-3B
  • Fecha de publicación de las variantes indicadas, no de creación del repositorio ni de extracción de datos.
SmolLM3-3B — declared context · Informe del editor https://huggingface.co/HuggingFaceTB/SmolLM3-3B/blob/a07cc9a04f16550a088caea529712d1d335b0ac1/README.md ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Sección pertinente de la fuente
Key features; Long context processing: trained at 64k; YaRN for 128k
  • Capacidad documentada de la variante indicada; distinta de la longitud de salida de una prueba o del límite de una API alojada
HuggingFaceTB/SmolLM3-3B — model card · Informe del editor https://huggingface.co/HuggingFaceTB/SmolLM3-3B/raw/a07cc9a04f16550a088caea529712d1d335b0ac1/README.md ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Sección pertinente de la fuente
Description; model details; usage
HuggingFaceTB/SmolLM3-3B — repository metadata · Informe del editor https://huggingface.co/api/models/HuggingFaceTB/SmolLM3-3B?blobs=true ↗
Entidad editora / autoría
Hugging Face
Fecha de consulta
2026-09-15
Sección pertinente de la fuente
cardData; sha; safetensors; siblings
144 resultados de 144 filas
Aplicación
Tamaño declarado del modelo(mil millones)
Fundamento de la recomendación
Función en el sistema
Filtros avanzados 3 controles
Tipo de modelo
Todas las filas
Comparación de filas y condiciones

Regla de comparación: Los modelos pueden diferir; tarea, idioma, datos, versión de la prueba, métrica y unidad deben coincidir o declararse.

Use × junto al encabezado para ocultar una columna. Abra los detalles de la fila para ver fuentes y condiciones.

Columnas ocultas:
Guía de aplicaciones de modelos
CompararDetalles
Función en el sistema
Uso principal
Característica distintiva y justificación
Condición de uso pertinente
Fundamento de la recomendación
Empezar
Página oficial ↗
Recuperación de documentos Recuperación híbrida de documentos en RAG Salidas densas, dispersas y multivector en un modelo; más de 100 idiomas, entradas de 8192 tokens y vectores densos de 1024 dimensiones. Use FlagEmbedding para las tres salidas a la vez; la salida de GGUF u Ollama depende del backend. Recomendación analítica de la guía
Página oficial ↗
Reordenamiento de documentos Reordenar documentos recuperados Lee la consulta y el documento conjuntamente para puntuar relevancia; complementa la recuperación de BGE-M3. Recupere primero un conjunto limitado de candidatos. La puntuación sigmoid no es probabilidad de respuesta correcta y la salida no es un embedding. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada Redacción y chat multilingües con documentos largos Aya Expanse 32B tiene un contexto de 131 072 tokens; el persa figura entre los 23 idiomas declarados por la entidad editora. Versión de investigación con licencia no comercial; la longitud de contexto no demuestra una precisión uniforme en todo el documento. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada Asistente de redacción y reescritura multilingüe Aya Expanse 8B combina un contexto de 8192 tokens con entrenamiento de preferencias multilingües; también es candidato para evaluar redacción en persa. Respete la licencia no comercial y el límite de contexto de esta variante; no hereda los resultados de 32B. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Chat local en varios idiomas Tiny Aya Global ofrece cobertura lingüística amplia; es distinta de las variantes regionales Earth, Fire y Water. Evalúe ejemplos en persa si ese es el uso previsto; las variantes regionales o base no sustituyen este checkpoint sin revisión. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
Llamadas a herramientas, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Crear un prototipo de asistente pequeño con llamadas a funciones La mayor variante SmolLM2 de la lista admite un formato de llamadas a funciones además de seguir instrucciones; las dos menores no heredan esa función. Modelo principalmente en inglés. La aplicación anfitriona ejecuta las funciones y debe validar sus argumentos. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada Explorar el seguimiento de instrucciones con un modelo muy pequeño La variante SmolLM2 de 135 millones de parámetros sirve para prototipos sencillos de generación y para explorar los límites de modelos muy pequeños. Use entradas cortas y tareas acotadas; no espere conocimiento amplio ni las llamadas a herramientas de la variante 1.7B. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada Reescritura y resumen de textos cortos SmolLM2 360M usa SFT y DPO para ajustar instrucciones; su ficha incluye un ejemplo de ejecución en CPU. Enfocado en inglés; el tamaño pequeño no demuestra velocidad ni calidad en persa. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Asistente pequeño con modo de razonamiento seleccionable SmolLM3 3B ofrece modos de respuesta directa y razonamiento, contexto de entrenamiento de 65 536 tokens y detalles públicos del entrenamiento. Ampliar el contexto requiere YaRN. La ficha nombra seis idiomas nativos, incluido alemán, mientras las etiquetas del repositorio enumeran ocho distintos; ninguna lista incluye persa. Requiere Transformers 4.53 o posterior., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Crear un prototipo de chat con el menor Qwen3 Qwen3 0.6B denso ofrece modos con y sin razonamiento; hay un archivo oficial Q8_0. Limite el presupuesto de salida; compartir familia no demuestra la capacidad de resolver problemas de variantes mayores., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Asistente de texto pequeño con control del razonamiento Qwen3-1.7B figura entre las opciones de menos de 2 mil millones de parámetros; la plantilla de mensajes permite elegir respuesta directa. En modo de razonamiento, los tokens de pensamiento cuentan en el costo y la longitud de salida. El GGUF oficial de este registro es Q8_0., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Generación y análisis de texto con Qwen3 denso Qwen3-14B es un modelo denso con dos modos de respuesta; sus variantes GGUF oficiales permiten elegir precisión de pesos. Hay paquetes Q4_K_M y Q8_0; esta guía no ha probado su velocidad ni calidad., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Llamadas a herramientas, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación Asistente con herramientas y arquitectura MoE Qwen3-30B-A3B usa expertos seleccionados y el patrón Qwen-Agent para conectar herramientas. Los parámetros activos no sustituyen el tamaño de todos los pesos al estimar memoria; la ejecución requiere plantillas y parsers compatibles., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Programación, Generación de texto, Generación basada en documentos, Extracción estructurada, Llamadas a herramientas Análisis por etapas con un Qwen3 denso mayor A diferencia de 30B-A3B, Qwen3-32B es denso; el modo de razonamiento se puede elegir según la complejidad de la pregunta. Compare respuesta directa y razonamiento con presupuestos de salida y condiciones equiparables; esta descripción no es una clasificación de calidad., Es un modelo general; Coder especializado tiene entrenamiento y formatos de herramientas distintos., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía, Uso documentado por el editor
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Asistente general de cuatro mil millones de parámetros Qwen3-4B cambia el modo de razonamiento dentro de un checkpoint; los archivos GGUF oficiales ofrecen varias cuantizaciones. El contexto nativo es de 32 768 tokens; ampliarlo requiere configurar la extensión de contexto., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Chat y tareas de texto con control del razonamiento Qwen3-8B es un modelo general denso con 8,2 mil millones de parámetros declarados; la plantilla selecciona respuesta directa o razonamiento. Hay archivos oficiales Q4_K_M y Q8_0 para uso local; esta guía no ha medido su calidad ni su memoria de ejecución., La recuperación, la inserción de documentos y la comprobación de citas corresponden al sistema; esta relación no es una prueba de RAG ni de persa., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Programación, Llamadas a herramientas, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento Edición de repositorios con un asistente que usa herramientas Qwen3-Coder-30B-A3B-Instruct está ajustado para generar código, editar repositorios y trabajar con agentes de programación; su contexto nativo es de 262 144 tokens. Es una variante sin modo de razonamiento. Use el formato de herramientas de Coder; es distinta de Qwen3-30B-A3B general., La aplicación anfitriona proporciona herramientas de archivos, pruebas y ejecución., Este checkpoint solo produce respuestas directas; no tiene un modo de razonamiento independiente. Recomendación analítica de la guía, Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Recuperación vectorial con el menor Qwen3 Embedding La variante 0.6B produce embeddings condicionados por instrucciones, con hasta 1024 dimensiones y entradas de 32 768 tokens. Añada la instrucción de tarea a la consulta; indexe los documentos con el mismo modelo y configuración de dimensiones. Recomendación analítica de la guía
Página oficial ↗
Recuperación de documentos Indexación multilingüe con vectores ajustables Qwen3-Embedding-4B produce hasta 2560 dimensiones y usa instrucciones de consulta para adaptar las representaciones a la tarea. Reducir dimensiones requiere comprobar la calidad de recuperación en la colección prevista; una puntuación MTEB no sustituye esa comprobación. Recomendación analítica de la guía
Página oficial ↗
Recuperación de documentos Recuperación de documentos con el mayor Qwen3 Embedding de la lista Qwen3-Embedding-8B admite hasta 4096 dimensiones y 32 768 tokens de contexto; recibe texto y produce vectores. Contabilice la indexación y el almacenamiento vectorial aparte de la generación; este modelo no redacta la respuesta final. Recomendación analítica de la guía
Página oficial ↗
Reordenamiento de documentos Reclasificación ligera en la familia Qwen3 Qwen3-Reranker 0.6B está ajustado para puntuar la relevancia consulta–documento con instrucciones de tarea. Requiere la plantilla de reclasificación y puntuación yes/no; no use la ruta de chat ni de generación de embeddings., Compatibilidad versionada de llama.cpp: una entrada RANK mayor que n_ubatch requiere b11223+ con la corrección #28876 y atención causal efectiva. b11223 es un prelanzamiento experimental; esta corrección no certifica soporte multimodal completo de /rerank o /embedding, calidad de contexto largo ni preparación para producción. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Reordenamiento de documentos Reclasificación de documentos candidatos con instrucciones Qwen3-Reranker-4B es la opción intermedia; consulta, instrucción de recuperación y documento intervienen en la puntuación de relevancia. Envíe solo documentos candidatos a esta etapa; más pares consulta–documento aumentan el costo de la segunda fase., Compatibilidad versionada de llama.cpp: una entrada RANK mayor que n_ubatch requiere b11223+ con la corrección #28876 y atención causal efectiva. b11223 es un prelanzamiento experimental; esta corrección no certifica soporte multimodal completo de /rerank o /embedding, calidad de contexto largo ni preparación para producción. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Reordenamiento de documentos Reclasificación con la variante Qwen3 de 8B Qwen3-Reranker-8B es el mayor reclasificador de esta colección; puntúa la relevancia consulta–documento. Para elegir entre este y 4B, compare calidad de recuperación y latencia en sus documentos; el tamaño por sí solo no establece una clasificación., Compatibilidad versionada de llama.cpp: una entrada RANK mayor que n_ubatch requiere b11223+ con la corrección #28876 y atención causal efectiva. b11223 es un prelanzamiento experimental; esta corrección no certifica soporte multimodal completo de /rerank o /embedding, calidad de contexto largo ni preparación para producción. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Leer imágenes y documentos con Qwen3-VL Qwen3-VL 8B Instruct combina entradas de texto, imagen y video para comprensión visual y trabajo con documentos. Use el procesador y la plantilla multimodales; los checkpoints Thinking e Instruct tienen comportamientos distintos. Recomendación analítica de la guía
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Prototipos multimodales con Qwen3.5 pequeño Qwen3.5-2B se presenta para prototipos y ajuste por tarea; admite entradas visuales junto con texto. La calidad de variantes mayores no se transfiere a este modelo de 2 mil millones de parámetros., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Llamadas a herramientas, Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación Agente multimodal con Qwen3.5 MoE La variante 35B-A3B combina una base de texto e imagen con arquitectura híbrida; es candidata para flujos de trabajo de varias etapas. Qwen3.5-Flash alojado ofrece herramientas y contexto predeterminado distintos; las especificaciones de la API no se transfieren a los pesos locales., Use los ajustes multimodales y límites de imagen documentados para estos pesos., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía, Uso documentado por el editor
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Procesamiento de texto e imagen con cuatro mil millones de parámetros Qwen3.5-4B pertenece a la generación integrada de texto e imagen; es una alternativa menor que 9B para explorar extracción de información documental. Los documentos escaneados requieren la ruta multimodal; el límite de contexto textual no determina cuántas imágenes se pueden procesar., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Asistente de documentos e imágenes con Qwen3.5 denso Qwen3.5 9B combina texto e imágenes en una arquitectura densa. Compare con 4B usando los mismos documentos y ajustes de imagen; distinga los parámetros lingüísticos de los visuales., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Llamadas a herramientas, Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación Flujos de trabajo largos con un agente de texto e imagen Qwen3.8-27B es un modelo denso de texto e imagen con control del razonamiento; su anuncio destaca programación, investigación y tareas por etapas. Las funciones anunciadas del servicio en la nube, como herramientas integradas y contexto predeterminado, no son garantías de los pesos locales., Las dimensiones de imagen y el muestreo de fotogramas forman parte de las condiciones de uso., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía, Uso documentado por el editor
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Investigación de seguimiento de instrucciones con entrenamiento examinable Olmo 3 7B Instruct se publica con datos Dolma 3 y Dolci; los detalles públicos del entrenamiento lo distinguen para investigación reproducible. Este checkpoint es Instruct; no le atribuya resultados de Olmo Think. Requiere Transformers 4.57 o posterior. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Explorar razonamiento destilado de R1-0528 Posentrenado a partir de Qwen3-8B-Base con cadenas de razonamiento de DeepSeek-R1-0528; distinto de Qwen3-8B estándar. Los resultados del R1-0528 completo no corresponden a esta variante de 8B., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Razonamiento destilado sobre Llama 70B Este checkpoint destila R1 sobre una base Llama y es la mayor variante destilada de la lista. Importan tanto la licencia base de Llama como las condiciones de la entidad que destila; estime por separado tamaño de pesos y longitud del razonamiento., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Explorar los límites del razonamiento en un modelo destilado muy pequeño La variante 1.5B destila R1 sobre Qwen2.5-Math y permite explorar la transferencia de razonamiento a un modelo pequeño. Las respuestas largas pueden volverse repetitivas., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Resolución de problemas con una destilación R1 intermedia DeepSeek-R1-Distill-Qwen-14B usa Qwen2.5-14B y datos generados por R1; sus pesos no son los del R1 completo. Las cifras publicadas corresponden a esta variante y configuración; evite compararlas con respuestas directas en condiciones distintas., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Análisis y programación con una destilación densa de 32B La variante Qwen-32B destila R1 sobre una base Qwen2.5. La capacidad de razonamiento declarada no equivale a llamadas a herramientas ni ejecución automática de código; la aplicación debe aportar herramientas y validación., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Resolución de problemas con la destilación R1 de 7B Basado en Qwen2.5-Math-7B; distinto de la destilación posterior R1-0528 sobre Qwen3. Mantenga la plantilla y el tokenizador de este repositorio; compararlo con la variante 8B requiere una evaluación común., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía
Página oficial ↗
Llamadas a herramientas, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación Conectar razonamiento y herramientas en flujos de agentes DeepSeek-V3.2 combina atención dispersa DSA y posentrenamiento orientado a agentes; su plantilla de chat difiere de versiones anteriores. Use plantillas y rutas de ejecución específicas de V3.2; los resultados de Speciale no se transfieren a este modelo., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Llamadas a herramientas, Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación Agente multimodal para entradas muy largas DeepSeek-V4.1-Flash procesa texto e imágenes con arquitectura CED; el número de parámetros activos difiere entre prefill y decode. Los parámetros activos no son una cifra fija; la compresión KV y una ruta de ejecución específica forman parte de esta arquitectura., Use la ruta de ejecución específica de CED; esta relación no es un resultado de evaluación de OCR., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía, Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Consultar imágenes y texto con Gemma 3 intermedio Gemma 3 12B IT es una variante multimodal ajustada a instrucciones con 131 072 tokens de contexto; conecta imágenes de entrada con respuestas textuales. Requiere el procesador visual y la plantilla Gemma 3; el contexto máximo no demuestra comprensión uniforme de documentos largos. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Asistente de texto pequeño de la familia Gemma 3 A diferencia de las variantes mayores de esta generación, Gemma 3 1B IT solo admite texto y tiene 32 768 tokens de contexto. Las imágenes escaneadas requieren primero OCR externo; las funciones multimodales de 4B y superiores no se aplican a esta variante. Recomendación analítica de la guía
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Comprender texto e imagen con el mayor Gemma 3 de la lista Gemma 3 27B IT es la variante densa mayor de esta generación, con entrada visual y cobertura multilingüe. Descargar los pesos requiere aceptar la licencia Gemma. Recomendación analítica de la guía
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Primeros pasos con imágenes en la familia Gemma 3 Gemma 3 4B IT es el menor modelo multimodal de esta generación en la lista; a diferencia de 1B, lee imágenes junto con texto. Descargue juntos los pesos y el procesador de 4B; valide los números extraídos del documento en la salida textual. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Razonamiento multimodal con Gemma 4 MoE Gemma 4 26B-A4B es un modelo de expertos con control del razonamiento y 262 144 tokens de contexto; su arquitectura difiere de E2B pequeño. Esta variante no admite audio; los parámetros activos difieren de todos los pesos del modelo., Requiere la ruta del procesador de imagen; la compatibilidad de audio de E2B no se transfiere a este modelo., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía, Uso documentado por el editor
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Procesamiento local de texto, imagen y audio con Gemma 4 pequeño Gemma 4 E2B se presenta para ejecución en el dispositivo y admite audio. E2B es un recuento efectivo, no todos los pesos. Use el recuento total y los archivos reales para calcular memoria; las rutas de audio e imagen requieren sus procesadores correspondientes., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Generación basada en documentos, Extracción estructurada, Generación de texto, Programación, Llamadas a herramientas Generar respuestas a partir de documentos recuperados Granite 3.3 2B Instruct es un modelo pequeño orientado a empresas, con RAG, resumen, extracción de texto y modo de razonamiento. El sistema debe recuperar documentos e incluirlos en el prompt; el modelo no es un buscador. El persa no figura entre sus 12 idiomas declarados., Valide la salida con el esquema de la aplicación; pedir un formato no garantiza JSON válido. Recomendación analítica de la guía, Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Recuperación multilingüe con vectores de pocas dimensiones Multilingual E5 Small convierte texto en vectores de 384 dimensiones con un límite de entrada de 512 tokens; es candidato para fragmentos cortos de documentos. Los prefijos query: y passage: se requieren también fuera del inglés; divida los textos largos antes de indexarlos. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Asistente general con Llama 3.1 grande Llama 3.1 70B Instruct admite chat multilingüe y tareas de texto con 131 072 tokens de contexto. Esta variante recibe texto; el uso de los pesos está sujeto a la licencia Llama. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Chat y tareas de texto con Llama 3.1 8B Llama 3.1 8B está ajustado para asistencia general y seguimiento de instrucciones; difiere del modelo base del mismo tamaño. Mantenga la plantilla y el tokenizador Instruct; un contexto largo por sí solo no garantiza calidad de respuestas basadas en documentos. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Reescritura y resumen locales con Llama pequeño Llama 3.2 1B Instruct es el modelo textual pequeño de esta generación, presentado para tareas acotadas en dispositivos locales. No admite imágenes directamente; los modelos Llama 3.2 Vision son productos distintos. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Asistente de texto en el dispositivo con Llama 3B Llama 3.2 3B Instruct está ajustado para chat, reescritura y resumen, con más parámetros que la variante 1B. Compare calidad y latencia en la tarea prevista; ninguno de los modelos textuales 1B y 3B admite imágenes. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Análisis y lógica con recursos más limitados Phi-4-mini-instruct se centra en datos de razonamiento y seguimiento de instrucciones, con 131 072 tokens de contexto. Distinto de mini-reasoning y multimodal-instruct; compare ejemplos matemáticos o lógicos con el nombre exacto de esta variante. Recomendación analítica de la guía
Página oficial ↗
Programación, Llamadas a herramientas, Generación de texto, Generación basada en documentos, Extracción estructurada, Comprensión de imágenes Agente de edición de varios archivos y búsqueda en repositorios Devstral Small 2 se orienta a ingeniería de software y revisión y edición de código con herramientas; esta generación también admite imágenes. Los pesos Instruct de este repositorio son FP8; use el formato Mistral y las dependencias de esta revisión, no ajustes genéricos de chat., Las herramientas del agente y las plantillas Mistral deben corresponder a la revisión del modelo., Requiere el procesador y componentes visuales de esta revisión; la cantidad de imágenes, resolución y fotogramas afectan al consumo de memoria. Recomendación analítica de la guía, Uso documentado por el editor
Página oficial ↗
Comprensión de imágenes, Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Asistente multimodal para despliegue en el borde Ministral 3 3B Instruct es el modelo pequeño de texto e imagen de la familia; el componente lingüístico tiene 3,4 mil millones de parámetros y el codificador visual, 0,4 mil millones. Los pesos oficiales son FP8; 3B en el nombre no cuenta todos los parámetros lingüísticos y visuales. Recomendación analítica de la guía
Página oficial ↗
Llamadas a herramientas, Generación de texto, Generación basada en documentos, Extracción estructurada Asistente textual con formato Mistral de llamadas a funciones Mistral 7B Instruct v0.3 añade la tercera versión del tokenizador y llamadas a funciones a este modelo textual. Use el formato de herramientas y tokenizador v3 de este checkpoint; esta variante no admite imágenes. Recomendación analítica de la guía
Página oficial ↗
Comprensión de imágenes, Extracción estructurada, Generación de texto, Generación basada en documentos, Programación, Llamadas a herramientas Asistente multilingüe de texto e imagen Mistral Small 3.1 24B Instruct añade procesamiento de imágenes y contexto largo a Small; el persa figura en la lista de idiomas de la entidad editora. Las herramientas y la salida JSON requieren plantilla y parser compatibles; no mezcle resultados Base e Instruct., Configure el parser y la validación de esquema en la aplicación. Recomendación analítica de la guía, Uso documentado por el editor
Página oficial ↗
Generación basada en documentos, Generación de texto, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Respuestas basadas en documentos con presupuesto de razonamiento Nemotron Nano 9B v2 combina Mamba-2 con atención; permite controlar el modo de razonamiento y su presupuesto de tokens. Los documentos recuperados se suministran externamente; el persa no figura entre los seis idiomas declarados y el backend debe admitir la arquitectura híbrida., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Llamadas a herramientas, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento Agente de razonamiento ajustable con gpt-oss grande gpt-oss-120b es un modelo MoE con 117 mil millones de parámetros totales y 5,1 mil millones activos; los pesos de expertos se publican en MXFP4. La ejecución correcta requiere el formato harmony; la aplicación proporciona navegador o Python. La memoria declarada por la entidad editora no es una medición del sitio., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Razonamiento, Generación de texto, Generación basada en documentos, Extracción estructurada, Llamadas a herramientas Razonamiento local con gpt-oss pequeño gpt-oss-20b tiene 21 mil millones de parámetros totales y 3,6 mil millones activos, se orienta a uso local o especializado y ofrece tres niveles de razonamiento. Requiere formato harmony y backend compatible con MXFP4; no sustituya el recuento real de pesos por el nombre 20B en los cálculos., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida. Recomendación analítica de la guía
Página oficial ↗
Llamadas a herramientas, Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación Agente de programación con razonamiento conservado GLM-4.7-Flash es un MoE de clase 30B-A3B; su ficha describe la conservación del razonamiento entre turnos para agentes de varias etapas. Las rutas vLLM y SGLang dependen de versiones de desarrollo concretas., Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Agente textual para programación y flujos con herramientas — — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Agente de razonamiento para cadenas largas de herramientas y análisis — Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas, Comprensión de imágenes Agente multimodal para programar a partir de diseños visuales y analizar documentos — Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto., Requiere el procesador y componentes visuales de esta revisión; la cantidad de imágenes, resolución y fotogramas afectan al consumo de memoria. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Asistente de desarrollo de software para flujos con herramientas — Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Modelo con herramientas para programación y planificación por etapas — Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Asistente grande de respuesta directa con contexto largo — Este checkpoint solo produce respuestas directas; no tiene un modo de razonamiento independiente. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Agente de programación para repositorios grandes con varios archivos — Este checkpoint solo produce respuestas directas; no tiene un modo de razonamiento independiente. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas, Comprensión de imágenes Asistente multimodal para análisis, código y documentos — Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto., Requiere el procesador y componentes visuales de esta revisión; la cantidad de imágenes, resolución y fotogramas afectan al consumo de memoria. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas, Comprensión de imágenes Modelo pequeño para prototipos y especialización por tarea — Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto., Requiere el procesador y componentes visuales de esta revisión; la cantidad de imágenes, resolución y fotogramas afectan al consumo de memoria. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas, Comprensión de imágenes Modelo MoE multimodal para análisis y uso de herramientas — Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto., Requiere el procesador y componentes visuales de esta revisión; la cantidad de imágenes, resolución y fotogramas afectan al consumo de memoria. Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas, Comprensión de imágenes Asistente multimodal grande para problemas complejos — Para respuestas sencillas, desactive el razonamiento si se admite o limite el presupuesto de salida., Incluya los tokens de razonamiento en el tiempo de respuesta y el contexto., Requiere el procesador y componentes visuales de esta revisión; la cantidad de imágenes, resolución y fotogramas afectan al consumo de memoria. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación, Llamadas a herramientas Asistente textual multilingüe para respuestas y tareas empresariales — — Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Modelo en inglés para matemáticas, lógica y generación de texto — — Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Comprensión de imágenes Modelo pequeño para preguntas sobre imágenes y video — Requiere el procesador y componentes visuales de esta revisión; la cantidad de imágenes, resolución y fotogramas afectan al consumo de memoria. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Recuperación de documentos Embeddings ligeros en inglés para búsqueda y agrupación — Media de tokens con máscara de atención y normalización L2 Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Embeddings multilingües con prefijos distintos para consultas y documentos — Media con máscara y L2; query: para consultas y passage: para documentos Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Embeddings multilingües para búsqueda semántica — Media con máscara y L2; query: para consultas y passage: para documentos Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Modelo pequeño de embeddings en inglés para recuperación de documentos — Pooling CLS y normalización; instrucción de recuperación solo en las consultas Uso documentado por el editor
Página oficial ↗
Reordenamiento de documentos Reclasificador en inglés y chino para resultados de búsqueda — Cross-encoder sobre pares consulta–documento; puntuación de relevancia Uso documentado por el editor
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Asistente pequeño de programación para explicar y corregir código — — Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Asistente de programación para generar, explicar y depurar código — — Recomendación analítica de la guía
Página oficial ↗
Generación de texto, Generación basada en documentos, Extracción estructurada, Programación Asistente de programación con mayor capacidad para problemas difíciles — — Recomendación analítica de la guía
Página oficial ↗
Recuperación de documentos Modelo pequeño de embeddings multilingües para ejecución en el dispositivo — Más de 100 idiomas; reducción de dimensiones con Matryoshka hasta 128 Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Modelo de embeddings multilingües con adaptadores por tarea — Adaptadores retrieval.query / retrieval.passage; media de tokens y L2 Uso documentado por el editor
Página oficial ↗
Reordenamiento de documentos Reclasificador multilingüe para documentos más largos — Reclasificación multilingüe con entradas de hasta 1024 tokens; licencia no comercial Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Modelo de embeddings en inglés para recuperación con instrucciones de consulta — Instrucción para la consulta: Represent this sentence for searching relevant passages: Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Modelo de embeddings en inglés con contexto largo y dimensiones reducibles — Prefijo search_query: para consultas y search_document: para documentos; normalización y reducción de dimensiones Uso documentado por el editor
Página oficial ↗
Extracción estructurada Codificador base para entrenar clasificación y extracción de entidades — Para llama.cpp use b11532+; las versiones anteriores calculaban hidden_activation=gelu con la aproximación tanh. Los GGUF existentes no requieren reconversión; repita las pruebas de versiones anteriores., Codificador bidireccional; salida de tokens o cabeza de tarea entrenada Uso documentado por el editor
Página oficial ↗
Autocompletado / FIM Completado de código y relleno intermedio Modelo base de programación con unos 1,54 mil millones de parámetros; para FIM y continuación de código, no chat con instrucciones. Use el formato de completado / FIM de este modelo; no lo sustituya por la plantilla de chat de un modelo ajustado a instrucciones. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Autocompletado / FIM Completado de código con atención de ventana deslizante Modelo base de programación; entrada de 16 384 tokens y ventana de atención de 4096 tokens. Para completado, no como asistente de chat. Use el formato de completado / FIM de este modelo; no lo sustituya por la plantilla de chat de un modelo ajustado a instrucciones. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Programación Agente de programación Modelo MoE con 80 mil millones de parámetros totales y 3 mil millones activos, atención híbrida y respuesta directa; la memoria de pesos corresponde al modelo completo. — Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperación de documentos Recuperación multilingüe con instrucciones de tarea Embeddings de 1024 dimensiones; añada una instrucción de una frase a las consultas y pase los documentos sin ella. Formato de consulta: Instruct: … Query: …; documentos sin instrucciones. Media con máscara y normalización L2; máximo de 512 tokens. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto Asistente pequeño de respuesta directa Variante 4B ajustada a instrucciones con límite textual de 262 144 tokens; este checkpoint no tiene modo de razonamiento. — Uso documentado por el editor
SAFETENSORS · Oficial ↗SAFETENSORS · Tercero ↗
Página oficial ↗
Recuperación de documentos Embeddings de texto en persa Variante pequeña de Tooka-SBERT-V2 con vectores de 768 dimensiones; candidato centrado en persa para recuperación y similitud textual. Los metadatos obtenidos no especifican una licencia de uso. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperación de documentos Embeddings de texto en persa Variante grande de Tooka-SBERT-V2 con vectores de 1024 dimensiones; los resultados PTEB no se pueden clasificar directamente frente a otras pruebas. Los metadatos obtenidos no especifican una licencia de uso. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Extracción estructurada Base de entrenamiento para tareas en persa ParsBERT base para comprensión de texto persa; clasificación y NER requieren cabezas de tarea y entrenamiento. No es un modelo de embeddings de recuperación listo para usar. Los pesos base por sí solos no son un clasificador ni un modelo NER listo para usar., Los metadatos obtenidos no especifican una licencia de uso. Uso documentado por el editor
PYTORCH · Oficial ↗
Página oficial ↗
Generación de texto Generación de texto en lenguas ibéricas Candidato de referencia para español y lenguas ibéricas, con resultados publicados por tarea. La variante 2B ajustada para instrucciones aporta una comparación lingüística; sus resultados no demuestran superioridad general. — Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto Generación de texto en lenguas ibéricas Candidato de referencia para español y lenguas ibéricas, con resultados publicados por tarea. La variante 7B ajustada para instrucciones aporta una comparación lingüística; sus resultados no demuestran superioridad general. — Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Razonamiento Razonamiento con un modelo compacto Candidato compacto para razonamiento y uso de herramientas, con unos 2,52 mil millones de parámetros según los metadatos. Hay que separar las evaluaciones del desarrollador de las cifras tomadas de Artificial Analysis. Este paquete no acredita calidad específica en español o persa. — Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Extracción estructurada Extracción de información en el dispositivo Candidato compacto para extracción de datos y tareas acotadas en el dispositivo. El editor desaconseja usarlo para programación y tareas que requieren muchos conocimientos. Declara español, pero este paquete no aporta una puntuación específica de calidad en ese idioma. Tiene licencia propia. — Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Razonamiento Razonamiento con un modelo compacto Modelo de razonamiento Granite con modos thinking y non-thinking. La etiqueta 3B identifica la gama; los metadatos registran unos 3,66 mil millones de parámetros. Distinga el contexto nativo de 128K de la ampliación anunciada a 512K. — Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperación de documentos Recuperación multimodal Recuperación de texto, imágenes y vídeo con vectores de 64–2048 dimensiones y un contexto de tarea de 32K tokens. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperación de documentos Recuperación multimodal Recuperación de texto, imágenes y vídeo con vectores de 64–4096 dimensiones y un contexto de tarea de 32K tokens. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Reordenamiento de documentos Reordenación multimodal Puntúa la relevancia de texto, imágenes y vídeo respecto a la consulta; reordena candidatos con hasta 32K tokens. Compatibilidad versionada de llama.cpp: una entrada RANK mayor que n_ubatch requiere b11223+ con la corrección #28876 y atención causal efectiva. b11223 es un prelanzamiento experimental; esta corrección no certifica soporte multimodal completo de /rerank o /embedding, calidad de contexto largo ni preparación para producción. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Reordenamiento de documentos Reordenación multimodal Puntúa la relevancia de texto, imágenes y vídeo respecto a la consulta; reordena candidatos con hasta 32K tokens. Compatibilidad versionada de llama.cpp: una entrada RANK mayor que n_ubatch requiere b11223+ con la corrección #28876 y atención causal efectiva. b11223 es un prelanzamiento experimental; esta corrección no certifica soporte multimodal completo de /rerank o /embedding, calidad de contexto largo ni preparación para producción. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto, Comprensión de imágenes, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Modelo textual y visual con atención híbrida Qwen3.6-27B acepta texto, imágenes y vídeo. Pesos BF16 oficiales registrados; la memoria de atención híbrida requiere medición específica del motor. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto, Comprensión de imágenes, Generación basada en documentos, Extracción estructurada, Razonamiento, Programación, Llamadas a herramientas Modelo textual y visual con atención híbrida Qwen3.6-35B-A3B acepta texto, imágenes y vídeo. Pesos BF16 oficiales registrados; la memoria de atención híbrida requiere medición específica del motor. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto Traducción especializada de texto Modelo dedicado a traducción con terminología y contexto; no se elige para chat general ni preguntas sobre documentos. — Recomendación analítica de la guía
Página oficial ↗
Generación de texto Traducción especializada de texto Modelo dedicado a traducción con terminología y contexto; no se elige para chat general ni preguntas sobre documentos. — Recomendación analítica de la guía
Página oficial ↗
Generación de texto Traducción especializada Traductor Hy-MT de segunda generación con instrucciones y control terminológico. — Recomendación analítica de la guía
Página oficial ↗
Generación de texto Traducción especializada Traductor Hy-MT de segunda generación con instrucciones y control terminológico. — Recomendación analítica de la guía
Página oficial ↗
Generación de texto Traducción especializada Traductor Hy-MT de segunda generación con instrucciones y control terminológico. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto Traducción especializada Traductor de texto e imágenes con límite de entrada de 2K y plantilla específica. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto Traducción especializada Traductor de texto e imágenes con límite de entrada de 2K y plantilla específica. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto Traducción especializada Traductor de texto e imágenes con límite de entrada de 2K y plantilla específica. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto Traducción especializada Traductor T5 con amplia cobertura; el prefijo de idioma destino forma parte de la entrada. — Recomendación analítica de la guía
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
Generación de texto Traducción especializada Referencia de traducción para investigación, licencia no comercial y entradas de entrenamiento hasta 512 tokens. — Recomendación analítica de la guía
PYTORCH · Oficial ↗
Página oficial ↗
Programación Programación, agentes de software y análisis de texto e imágenes Modelo multimodal de Xiaomi para programación, uso de herramientas y entradas largas; el checkpoint RL publica pesos con metadatos de licencia MIT. Aproximadamente 1,02 billones de parámetros totales y 42 mil millones activos; los archivos ocupan 534,1 GiB. Este checkpoint no cabe en una sola GPU de 24 o 48 GB., Índice de inteligencia de Artificial Analysis v4.3.2: 46 para el servicio MiMo-V2.6-Pro; no es una evaluación en persa ni una prueba local del checkpoint RL. Recomendación analítica de la guía
SAFETENSORS · Oficial ↗
Página oficial ↗
Programación, Razonamiento, Llamadas a herramientas Código, razonamiento y herramientas de agentes Beam 1.0 se publica con pesos oficiales BF16, FP8 y NVFP4 bajo Apache-2.0. llama.cpp b11701 incorpora Beam después de v0.7.0; no se atribuye soporte a 0.7.0. vLLM/SGLang requieren una revisión compatible. Uso documentado por el editor
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas Conversación, razonamiento, código y llamadas a herramientas Modelo de texto K2 Horizon con pesos oficiales Safetensors y GGUF; ejecución con llama.cpp desde el prelanzamiento b11454. Sin evidencia de evaluación en persa; velocidad y memoria real de esta vía sin probar. Uso documentado por el editor
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas Conversación, razonamiento, código y llamadas a herramientas Modelo de texto K2 Horizon con pesos oficiales Safetensors y GGUF; ejecución con llama.cpp desde el prelanzamiento b11454. Sin evidencia de evaluación en persa; velocidad y memoria real de esta vía sin probar. Uso documentado por el editor
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas Conversación, razonamiento, código y llamadas a herramientas Modelo de texto K2 Horizon con pesos oficiales Safetensors y GGUF; ejecución con llama.cpp desde el prelanzamiento b11454. Sin evidencia de evaluación en persa; velocidad y memoria real de esta vía sin probar. Uso documentado por el editor
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas Conversación, razonamiento, código y llamadas a herramientas Modelo de texto K2 Horizon con pesos oficiales Safetensors y GGUF; ejecución con llama.cpp desde el prelanzamiento b11454. Sin evidencia de evaluación en persa; velocidad y memoria real de esta vía sin probar. Uso documentado por el editor
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas Conversación, razonamiento, código y llamadas a herramientas Modelo de texto K2 Horizon con pesos oficiales Safetensors y GGUF; ejecución con llama.cpp desde el prelanzamiento b11454. Sin evidencia de evaluación en persa; velocidad y memoria real de esta vía sin probar. Uso documentado por el editor
SAFETENSORS · Oficial ↗GGUF · Oficial ↗
Página oficial ↗
Recuperación de documentos Recuperación multimodal local para RAG; no genera respuestas Modelo local de embeddings multimodales con pesos oficiales Apache-2.0; EmbeddingGemma anterior conserva su entrada. Antes de elegir para RAG textual en persa, compare recuperación en un corpus persa con consultas/documentos idénticos a 768 y 256 dimensiones; calidad en persa y memoria real desconocidas. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas, Comprensión de imágenes Razonamiento, código y análisis de imágenes Muse Spark Open multimodal con 816B totales y 42B activos; la descarga exige aprobación de acceso y licencia propia. La Muse Model License condiciona Model-as-a-Service: ingresos agregados superiores a 20 millones USD en doce meses consecutivos exigen notificar a Meta y un acuerdo separado antes de ofrecer el modelo en ese negocio. Acepte las condiciones y revise la política de uso. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas, Comprensión de imágenes, Extracción estructurada Razonamiento, código y comprensión de documentos y vídeo Modelo de visión y lenguaje híbrido Mamba-2/Transformer/MoE con entrada de texto, imagen y vídeo y salida textual. La ficha usa vLLM nightly con commit 3f1bcfd82bb2e93fcd364fc7a5491718453a77e2; no demuestra soporte estable en 0.31. Ollama 0.40.5 anuncia soporte Super. Uso documentado por el editor
SAFETENSORS · Oficial ↗SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas, Comprensión de imágenes, Extracción estructurada Agentes locales, código y comprensión de imágenes Modelo multimodal 74B con 9B activos y paquete oficial IQ2 orientado a 24 GB; no se ha establecido la memoria completa del servicio. 24GB es el nombre del paquete y objetivo del editor, no una garantía para 256K. Presupueste por separado pesos, proyector, KV, drafter y sobrecarga., El ejemplo vLLM usa nightly-77154ca6116ae34cbfe314beef1016bde9b63989, no v0.31 estable verificada. llama.cpp 0.7.0 incluye Bolt. Uso documentado por el editor
Página oficial ↗
Generación de texto, Programación, Razonamiento, Llamadas a herramientas, Comprensión de imágenes Razonamiento, código, agentes y entrada visual Snapshot independiente del 17 de octubre de DeepSeek-V4.1-Flash con Safetensors y MIT; se conservan la versión anterior y sus resultados. No incluye plantilla Jinja; se documentan el codificador de referencia y deepseek-recipe. No se hereda soporte de versiones previas al snapshot 1017., llama.cpp b11870 añadió soporte para deepseek41; el snapshot 1017 con un artifact convertido y el backend elegido sigue requiriendo validación. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto, Razonamiento, Llamadas a herramientas, Programación Razonamiento y agentes locales MoE textual de razonamiento con 24,0B totales, 2,45B activos y contexto 131.072; dispone de variantes oficiales FP8, GGUF y MLX. El 12 de octubre es la creación del repositorio base, no una fecha de lanzamiento verificada para todas las variantes. 2,45B activos no determinan el tamaño de los 24B totales., LFM Open License v1.0 no permite uso comercial incondicional; revise el umbral anual de 10 millones USD, la entidad jurídica y la excepción sin ánimo de lucro. Uso documentado por el editor
Página oficial ↗
Generación de texto, Extracción estructurada, Llamadas a herramientas Chat, decisiones y transcripción de voz Granite Switch 4.1 combina una base densa con adaptadores de decisión/Guardian y un codificador de voz. Chat, decisiones tipadas y Guardian dependen del adaptador/codificador elegido; no es solo un clasificador., La vía oficial vLLM requiere el complemento Granite Switch. b11700 incorpora decisiones después de 0.7.0; no se atribuye a 0.7.0. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto, Extracción estructurada, Llamadas a herramientas Chat, decisiones y transcripción de voz Granite Switch 4.1 combina una base densa con adaptadores de decisión/Guardian y un codificador de voz. Chat, decisiones tipadas y Guardian dependen del adaptador/codificador elegido; no es solo un clasificador., La vía oficial vLLM requiere el complemento Granite Switch. b11700 incorpora decisiones después de 0.7.0; no se atribuye a 0.7.0. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Generación de texto, Razonamiento Razonamiento textual; vía de ejecución pendiente de validación Modelo de razonamiento 4B con ejecución repetida de capas y contexto declarado 256K; idioma declarado: inglés. normalized-GPT recurrente: bucles y motor afectan la latencia. vLLM usa el PR #60149 y llama.cpp un fork/commit propio. Se desactiva la recomendación local por defecto hasta validar la ejecución. Uso documentado por el editor
Página oficial ↗
Recuperación de documentos Recuperación de documentos para RAG; no genera respuestas de texto Modelo de embeddings de texto e imagen con pesos BF16 oficiales; 1B es la etiqueta de tamaño y el total es 1.55B parámetros. Evalúe la recuperación en su corpus; no constan pruebas locales, puntuación independiente en persa ni medición completa de VRAM. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperación de documentos Recuperación de documentos para RAG; no genera respuestas de texto Modelo de embeddings de texto e imagen con pesos BF16 oficiales; 8B es la etiqueta de tamaño y el total es 8.38B parámetros. Evalúe la recuperación en su corpus; no constan pruebas locales, puntuación independiente en persa ni medición completa de VRAM. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Comprensión de imágenes, Extracción estructurada Comprensión de imágenes, OCR, documentos y vídeo MiniCPM-V 4.7 1B recibe texto, imágenes y vídeo para comprensión visual, OCR y análisis documental. Las distribuciones oficiales incluyen tamaños reales de archivo. El límite de 262144 tokens procede de la configuración; la calidad a esa longitud no está verificada. GGUF requiere un proyector compatible; DSpark es auxiliar. Las cifras de memoria y velocidad de iPhone no se generalizan a todas las GPU. Uso documentado por el editor
Página oficial ↗
Comprensión de imágenes, Extracción estructurada Comprensión de imágenes, OCR, documentos y vídeo MiniCPM-V 4.7 35B-A3B recibe texto, imágenes y vídeo para comprensión visual, OCR y análisis documental. Las distribuciones oficiales incluyen tamaños reales de archivo. El límite de 262144 tokens procede de la configuración; la calidad a esa longitud no está verificada. GGUF requiere un proyector compatible; DSpark es auxiliar. Las cifras de memoria y velocidad de iPhone no se generalizan a todas las GPU. Uso documentado por el editor
Página oficial ↗
Extracción estructurada Clasificación, enrutamiento, puntuación y control de decisiones del agente El modelo de decisión multimodal d3 recibe texto o JSON con imágenes y vídeo y devuelve elección, sí/no o puntuaciones probabilísticas. No genera texto libre ni extrae valores arbitrarios. Descargue el modelo junto con su readout. La ruta Semantic Router está en el canal de desarrollo y no demuestra soporte directo del motor general vLLM. El tamaño del paquete Ollama es de descarga; no se midieron VRAM ni KV en ejecución. Uso documentado por el editor
SAFETENSORS · Oficial ↗OLLAMA · Tercero ↗
Página oficial ↗
Extracción estructurada Clasificación, enrutamiento, puntuación y control de decisiones del agente El modelo de decisión multimodal d3 recibe texto o JSON con imágenes y vídeo y devuelve elección, sí/no o puntuaciones probabilísticas. No genera texto libre ni extrae valores arbitrarios. Descargue el modelo junto con su readout. La ruta Semantic Router está en el canal de desarrollo y no demuestra soporte directo del motor general vLLM. El tamaño del paquete Ollama es de descarga; no se midieron VRAM ni KV en ejecución. Uso documentado por el editor
SAFETENSORS · Oficial ↗OLLAMA · Tercero ↗
Página oficial ↗
Extracción estructurada Clasificación, enrutamiento, puntuación y control de decisiones del agente El modelo de decisión multimodal d3 recibe texto o JSON con imágenes y vídeo y devuelve elección, sí/no o puntuaciones probabilísticas. No genera texto libre ni extrae valores arbitrarios. Descargue el modelo junto con su readout. La ruta Semantic Router está en el canal de desarrollo y no demuestra soporte directo del motor general vLLM. El tamaño del paquete Ollama es de descarga; no se midieron VRAM ni KV en ejecución. Uso documentado por el editor
SAFETENSORS · Oficial ↗OLLAMA · Tercero ↗
Página oficial ↗
Extracción estructurada Clasificación, enrutamiento, puntuación y control de decisiones del agente El modelo de decisión multimodal d3 recibe texto o JSON con imágenes y vídeo y devuelve elección, sí/no o puntuaciones probabilísticas. No genera texto libre ni extrae valores arbitrarios. Descargue el modelo junto con su readout. La ruta Semantic Router está en el canal de desarrollo y no demuestra soporte directo del motor general vLLM. El tamaño del paquete Ollama es de descarga; no se midieron VRAM ni KV en ejecución. Uso documentado por el editor
SAFETENSORS · Oficial ↗OLLAMA · Tercero ↗
Página oficial ↗
Generación de texto, Llamadas a herramientas, Razonamiento Conversación local, razonamiento y llamadas a herramientas Modelo pequeño Gemma-4-E4B para conversación local, herramientas en varios turnos e interfaces de dispositivos; 8B totales y 4B efectivos. Hay pesos oficiales BF16 y GGUF. NVIDIA especifica texto y 64K. Ollama anuncia imágenes y 128K para su paquete; esta diferencia pendiente no activa el filtro multimodal del modelo. El GGUF principal tiene 6.180.446.208 bytes; 4GB no es el tamaño ni una garantía de VRAM. DFlash es auxiliar y necesita memoria adicional. Uso documentado por el editor
Página oficial ↗
Reordenamiento de documentos Reordenación de documentos en RAG y Vision RAG Reranker multimodal con torre lingüística bidireccional Ministral3 y codificador visual Pixtral; puntúa consultas textuales emparejadas con documentos de texto, imagen o mixtos. Use Transformers 5.20.0 para imágenes; 5.17–5.19 con Flash Attention 2 pueden dar resultados incorrectos o errores CUDA. La ruta multimodal de vLLM 0.32.0 usa /classify con mensajes query/document, no /score ni /rerank. La salida es un logit, no un embedding ni una probabilidad calibrada. Uso documentado por el editor
SAFETENSORS · Oficial ↗
Página oficial ↗
Programación, Llamadas a herramientas, Razonamiento, Comprensión de imágenes Programación con agentes, análisis y documentos visuales MoE multimodal de cerca de un billón de parámetros, 52B activos y contexto de un millón de tokens; entrada de texto/imagen y salida de texto. FP8 es la versión principal; NVFP4 está destinado a Blackwell. Seleccione la imagen Docker de Mistral Large 4. Uso documentado por el editor
Página oficial ↗
Llamadas a herramientas, Comprensión de imágenes Agente de escritorio con herramientas computer_use y bash Modelo de visión y lenguaje de Microsoft para tareas de escritorio; combina clics, escritura y ejecución de código en una política. Los pesos BF16 contienen 4,74B parámetros. La referencia usa AutoProcessor y /generate nativo en el contenedor de microsoft/Mage; conserve la plantilla computer_use y bash. Uso documentado por el editor
SAFETENSORS · Oficial ↗

«—» indica que no hay información registrada; no significa que el modelo carezca de esa capacidad.

Vista de datos

Viabilidad en el hardware

Memoria para pesos, KV y ejecución con la configuración seleccionada.

Cálculo a partir de especificaciones. El contexto incluye historial, entrada y salida. Las solicitudes activas no equivalen a usuarios diarios.

Configuraciones de GPU · 3 Configuración seleccionada
Especificaciones en la guía de GPU →
Método de cálculo y límites del escenario

Tamaño real del archivo de pesos + caché KV + reserva de ejecución. Los escenarios GGUF usan caché KV en FP16. La reserva predeterminada es de 2 GiB por GPU y de 4 GiB en CPU; son supuestos de planificación.

El cálculo de los modelos MoE incluye todos sus pesos. La capacidad nominal de la GPU se utiliza como presupuesto en GiB; para el despliegue se necesita la memoria libre que informa el dispositivo. La suma de la memoria de varias GPU no es memoria unificada.

Los escenarios FP32 de SmolLM2 usan FP32 para pesos y caché KV. Se excluyen los escenarios que superan el contexto del archivo seleccionado, incluido Aya Expanse 32B con el límite de 8192 tokens del archivo GGUF seleccionado.

61 resultados de 61 filas
Filtros avanzados 1 controles
Memoria necesaria(GiB)
Todas las filas
Comparación de filas y condiciones

Regla de comparación: Las celdas de hardware comparten el escenario de su fila. Comparar filas requiere igualar las condiciones ajenas al hardware.

Use × junto al encabezado para ocultar una columna. Abra los detalles de la fila para ver fuentes y condiciones.

Viabilidad del archivo según la configuración de hardware
CompararDetalles
Modelo
Versión de los pesos
RTX 4090 24GB
RTX 5090 32GB
RTX 6000 Ada 48GB
Página oficial ↗
Q8_0 3,47 GiB 0,6 GiB 0,88 GiB
Página oficial ↗
Q8_0 4,58 GiB 1,71 GiB 0,88 GiB
Página oficial ↗
Q4_K_M 5,45 GiB 2,33 GiB 1,13 GiB
Página oficial ↗
Q8_0 7,11 GiB 3,99 GiB 1,13 GiB
Página oficial ↗
Q4_K_M 7,81 GiB 4,68 GiB 1,13 GiB
Página oficial ↗
Q8_0 11,24 GiB 8,11 GiB 1,13 GiB
Página oficial ↗
Q4_K_M 11,63 GiB 8,38 GiB 1,25 GiB
Página oficial ↗
Q8_0 17,87 GiB 14,62 GiB 1,25 GiB
Página oficial ↗
Q4_K_M 20,03 GiB 17,28 GiB 0,75 GiB
Página oficial ↗
Q8_0 33 GiB 30,25 GiB 0,75 GiB
Página oficial ↗
Q4_K_M 22,4 GiB 18,4 GiB 2 GiB
Página oficial ↗
Q8_0 36,43 GiB 32,43 GiB 2 GiB
Página oficial ↗
Q4_K_M 44,1 GiB 39,6 GiB 2,5 GiB
Página oficial ↗
Q8_0 74,33 GiB 69,83 GiB 2,5 GiB
Página oficial ↗
Q4_K_M 11,87 GiB 8,37 GiB 1,5 GiB
Página oficial ↗
Q8_0 18,12 GiB 14,62 GiB 1,5 GiB
Página oficial ↗
Q4_K_M 22,49 GiB 18,49 GiB 2 GiB
Página oficial ↗
Q8_0 36,43 GiB 32,43 GiB 2 GiB
Página oficial ↗
Q4_K_M 6,8 GiB 4,36 GiB 0,44 GiB
Página oficial ↗
Q8_0 9,98 GiB 7,54 GiB 0,44 GiB
Página oficial ↗
Q4_K_M 44,1 GiB 39,6 GiB 2,5 GiB
Página oficial ↗
Q8_0 74,33 GiB 69,83 GiB 2,5 GiB
Página oficial ↗
Q4_K_M 7,58 GiB 4,58 GiB 1 GiB
Página oficial ↗
Q8_0 10,95 GiB 7,95 GiB 1 GiB
Página oficial ↗
Q4_K_M 21,69 GiB 18,44 GiB 1,25 GiB
Página oficial ↗
Q8_0 35,22 GiB 31,97 GiB 1,25 GiB
Página oficial ↗
Q4_K_M 7,71 GiB 4,71 GiB 1 GiB
Página oficial ↗
Q8_0 10,95 GiB 7,95 GiB 1 GiB
Página oficial ↗
Q4_K_M 4,48 GiB 0,98 GiB 1,5 GiB
Página oficial ↗
Q4_K_M 2,27 GiB 0,1 GiB 0,18 GiB
Página oficial ↗
Q8_0 2,31 GiB 0,13 GiB 0,18 GiB
Página oficial ↗
Q8_0 2,67 GiB 0,36 GiB 0,31 GiB
Página oficial ↗
Q4_K_M 20,03 GiB 17,28 GiB 0,75 GiB
Página oficial ↗
Q8_0 33 GiB 30,25 GiB 0,75 GiB
Página oficial ↗
Q4_K_M 7,81 GiB 4,68 GiB 1,13 GiB
Página oficial ↗
Q8_0 11,24 GiB 8,11 GiB 1,13 GiB
Página oficial ↗
Q4_K_M 3,26 GiB 1,04 GiB 0,22 GiB
Página oficial ↗
Q8_0 3,98 GiB 1,76 GiB 0,22 GiB
Página oficial ↗
Q4_K_M 4,06 GiB 1,44 GiB 0,63 GiB
Página oficial ↗
Q8_0 5,13 GiB 2,51 GiB 0,63 GiB
Página oficial ↗
Q4_K_M 5,32 GiB 2,32 GiB 1 GiB
Página oficial ↗
Q8_0 6,8 GiB 3,8 GiB 1 GiB
Página oficial ↗
Q4_K_M 7,07 GiB 4,07 GiB 1 GiB
Página oficial ↗
Q8_0 10,17 GiB 7,17 GiB 1 GiB
Página oficial ↗
Q4_K_M 136,32 GiB 132,85 GiB 1,47 GiB
Página oficial ↗
Q8_0 236,24 GiB 232,77 GiB 1,47 GiB
Página oficial ↗
Q4_K_M 274,8 GiB 270,86 GiB 1,94 GiB
Página oficial ↗
Q8_0 479,24 GiB 475,3 GiB 1,94 GiB
Página oficial ↗
Q4_K_M 11,99 GiB 8,43 GiB 1,56 GiB
Página oficial ↗
Q8_0 18,07 GiB 14,51 GiB 1,56 GiB
Página oficial ↗
Q4_K_M 6,8 GiB 4,36 GiB 0,44 GiB
Página oficial ↗
Q8_0 9,98 GiB 7,54 GiB 0,44 GiB
Página oficial ↗
Q4_K_M 11,87 GiB 8,37 GiB 1,5 GiB
Página oficial ↗
Q8_0 18,12 GiB 14,62 GiB 1,5 GiB
Página oficial ↗
Q4_K_M 22,49 GiB 18,49 GiB 2 GiB
Página oficial ↗
Q8_0 36,43 GiB 32,43 GiB 2 GiB
Página oficial ↗
Q4_K_M 3,06 GiB 0,62 GiB 0,44 GiB
Página oficial ↗
Q4_K_M 6,06 GiB 2,94 GiB 1,13 GiB
Página oficial ↗
Q4_K_M 8,33 GiB 5,21 GiB 1,13 GiB
Página oficial ↗
Q4_K_M 23,63 GiB 19,63 GiB 2 GiB
Página oficial ↗
Q4_K_M 24,33 GiB 20,83 GiB 1,5 GiB

«—» indica que no hay información registrada; no significa que el modelo carezca de esa capacidad.

Usa la herramienta para contrastar la concurrencia y la longitud de contexto con el modelo y el número de GPU. El artículo que la acompaña explica los cálculos y el diseño de una prueba de capacidad del servicio. ¿Qué significan 100 usuarios simultáneos en un asistente de IA?

Del número de usuarios al presupuesto de memoria

¿En qué GPU cabe esta carga?

Elige un modelo y una carga. Si aún no has elegido una GPU, la herramienta propone opciones para probar. Que quepa en memoria es una estimación; la velocidad y la calidad del servicio requieren pruebas.

Supuestos de memoria y espacio libre real

Modelo ilustrativo: 8 mil millones de parámetros, pesos BF16 sin comprimir, 32 capas, 8 cabezas KV y dimensión de cabeza de 128. Geometría actual: 32 capas, 8 cabezas KV, dimensión de cabeza 128.

La reserva de 2 GiB es un supuesto de planificación de la tabla, no una medición ni un límite de sobrecarga. Cuantizar los pesos no implica una caché KV de baja precisión: comprueba por separado su compatibilidad y su efecto en la calidad. Esta estimación de atención completa no supone ahorros por caché de prefijos, atención con ventana deslizante, MLA ni arquitecturas híbridas.

Primera opción para comparar: 1 × GeForce RTX 5090

Cabe según la estimación de memoria

Presupuesto de la GPU con más carga24,9 GiB
Clase de memoria por GPU32 GiB
Margen de memoria por GPU7,1 GiB
Límite teórico de solicitudes activas por memoria15
  • Pesos 14,9 GiB
  • KV 8 GiB
  • Reserva y otros componentes 2 GiB

Con un reparto equilibrado, se supone que la GPU con más carga atiende 8 solicitudes. Cada GPU carga todos los pesos; las colas y un reparto desigual pueden cambiar esta estimación.

Para una primera evaluación, la clase nominal de memoria de la tabla se trata como un presupuesto en GiB. Antes del despliegue, indica la memoria libre real del dispositivo. Ese límite teórico no establece la capacidad de respuesta con una latencia aceptable.

PCIe; depende del fabricante de la tarjeta · Activa · PCIe 5.0

Especificaciones del fabricante ↗
Opciones de GPU para probar

Las opciones proceden de la lista actual de GPU del sitio, ordenadas por menor número de dispositivos y después por capacidad de memoria. Aún hay que comprobar precio, velocidad y compatibilidad del paquete con cada motor. Si hacen falta más dispositivos, el número propuesto aparece junto al nombre de la GPU.

  • 1 × GeForce RTX 509032 GB por GPU · margen estimado 7,1 GiB
  • 1 × RTX 6000 Ada48 GB por GPU · margen estimado 23,1 GiB
  • 2 × GeForce RTX 4090 D24 GB por GPU · margen estimado 3,1 GiB

Las propuestas excluyen productos anunciados, placas no oficiales, memoria unificada y capacidad agregada de varios chips. Para AMD e Intel, comprueba la compatibilidad del paquete, los kernels y el motor en el modelo y sistema operativo concretos.

Explorar la carga de usuarios y la demanda de tokens
Solicitudes de usuario por segundo
0,833
Llamadas al modelo por segundo
0,833
Demanda de entrada, tokens/segundo
3583,33
Demanda de salida, tokens/segundo
275
Solicitudes en curso; ley de Little
6,67

En régimen estable, la ley de Little incluye la cola y todas las etapas del flujo de trabajo. No modifica automáticamente el control de inferencias en ejecución. Entrada y salida se calculan por separado; el tiempo de respuesta supuesto no es una predicción de la herramienta.

Demanda dividida por la capacidad medida: Prefill Requiere pruebas; Decode Requiere pruebas.

Estos cocientes son una primera evaluación. Hay que probar la interacción entre etapas, P95, ráfagas de carga y goodput con una carga mixta. Indica la capacidad medida de toda la configuración; la herramienta no multiplica la velocidad por el número de GPU. Al cambiar el modelo, la distribución o la longitud de solicitud, se borran las mediciones para introducir los resultados de los nuevos ajustes.

Sección cuatro · dos vistas independientes

Software de inferencia y servicio

Vista de datos

Comparación de software

Compara software de inferencia local y servicio de modelos.

72 resultados de 72 filas
Necesidad de despliegue
Entorno de ejecución
Función del software
Filtros avanzados 36 controles
Producto
Local / nube
Tareas y modalidades
Cola de solicitudes
Concurrencia
Batching
Control de admisión
Carga / descarga del modelo
Varios modelos
Cold start
Prefix caching
Speculative decoding
Descarga a CPU/GPU y de KV
Distribución del modelo entre GPU
Réplicas independientes
Streaming
Salida estructurada
Tool calling
Control del razonamiento
Plantilla de conversación / modelo
Parser
Supervisión
Metrics
Health check
Autenticación
Limitación de frecuencia
Cómo se proporciona la capacidad
Estado de mantenimiento
Fecha de publicación
Fecha de revisión
Todas las filas
Comparación de filas y condiciones

Regla de comparación: Las versiones pueden mostrarse juntas. Al comparar interfaces se mantiene el backend; al comparar el sistema completo puede variar.

Use × junto al encabezado para ocultar una columna. Abra los detalles de la fila para ver fuentes y condiciones.

Columnas ocultas:
Comparación de software de inferencia y servicio por versión
CompararDetalles
¿Para qué sirve?
Ventaja práctica
Condición de elección
Empezar
Ollama · v0.40.2
Motor / biblioteca de inferencia, Servidor API, Gestor de modelos Inicio local, desarrollo y servicios pequeños Descarga y gestión de modelos e inicio de API en una herramienta La ejecución local y en la nube se separa; OLLAMA_NO_CLOUD=1 desactiva las vías en la nube. Ollama v0.40.2 estable / Latest: solo las arquitecturas aprobadas se ejecutan con MLX por defecto en Apple Silicon: Qwen3.8, Qwen3.6, Qwen3.5, Gemma 4, Nimble, Tev1, Clef, Clef Flash y EmbeddingGemma 2. No se extiende a todos los modelos, tamaños, cuantizaciones, entradas ni sistemas operativos; verifique por separado la etiqueta y el paquete compatibles de cada vía. Los modelos de decisión devuelven respuestas tipadas, sin chat, tools ni thinking. Calidad en persa, velocidad y memoria real de esta vía sin probar. Al ejecutar por primera vez cada modelo antiguo, se actualiza en segundo plano y el original permanece temporalmente en disco. Compruebe el espacio libre antes de actualizar; la eliminación automática de copias se prevé para una versión futura. Se mantiene el requisito v0.40.1+ para Windows/Clef Flash. Primeros pasos ↗
Ollama · v0.40.0
Motor / biblioteca de inferencia, Servidor API, Gestor de modelos Descargar, gestionar y ejecutar modelos localmente mediante una API Generación de texto, Generación de embeddings, Salida en streaming, Salida estructurada Ollama v0.40.0 estable; versión histórica: solo las arquitecturas aprobadas se ejecutan con MLX por defecto en Apple Silicon: Qwen3.8, Qwen3.6, Qwen3.5, Gemma 4, Nimble, Tev1, Clef, Clef Flash y EmbeddingGemma 2. No se extiende a todos los modelos, tamaños, cuantizaciones, entradas ni sistemas operativos; verifique por separado la etiqueta y el paquete compatibles de cada vía. Los modelos de decisión devuelven respuestas tipadas, sin chat, tools ni thinking. Calidad en persa, velocidad y memoria real de esta vía sin probar. Ollama v0.40.0 estable; versión histórica: solo las arquitecturas aprobadas se ejecutan con MLX por defecto en Apple Silicon: Qwen3.8, Qwen3.6, Qwen3.5, Gemma 4, Nimble, Tev1, Clef, Clef Flash y EmbeddingGemma 2. No se extiende a todos los modelos, tamaños, cuantizaciones, entradas ni sistemas operativos; verifique por separado la etiqueta y el paquete compatibles de cada vía. Los modelos de decisión devuelven respuestas tipadas, sin chat, tools ni thinking. Calidad en persa, velocidad y memoria real de esta vía sin probar. Primeros pasos ↗
vLLM · v0.29.0
Motor / biblioteca de inferencia, Servidor API API de modelos de lenguaje con solicitudes simultáneas Procesamiento continuo por lotes y gestión de caché KV; API compatible con OpenAI Versión histórica; GGUF requiere instalar por separado vllm-gguf-plugin; la compatibilidad con este formato es experimental. GHSA-x6mc-67gf-chw4: vulnerabilidad condicional en >=0.24.0,<0.30.0. El frontend Python con muestreo de vídeo Qwen2-VL/Qwen3-VL acepta media_io_kwargs.video.max_frames y fps, permitiendo DoS de memoria; la solicitud también puede elegir el muestreador. --limit-mm-per-prompt limita elementos, no fotogramas; en versiones afectadas --api-key por sí solo no protege /tokenize ni /invocations. Rust rechaza esa entrada y queda excluido solo de este caso. Actualizar a 0.30.0 es la corrección declarada; autenticación en gateway y límites de recursos son controles adicionales. GHSA-85xf-c7hm-whqw: una salida estructurada malformada puede detener EngineCore compartido; intervalo declarado <0.30.0, pero el informe confirma pruebas en 0.25.1 sin establecer el límite inferior. GHSA-5fj9-pfhr-6j48: frontend Rust activado anterior a 0.30.0; métodos HTTP arbitrarios acumulan etiquetas Prometheus y memoria, incluso con respuestas 405 en /tokenize. GHSA-58v5-2m8f-94pr: >=0.23.0rc2,<0.30.0; modelos con vídeo y media_io_kwargs permiten elegir GLMGA y consumir CPU/memoria antes de decodificar; con autenticación API activada se requiere una clave válida. Los otros tres avisos también declaran 0.30.0 corregida. Primeros pasos ↗
SGLang · v0.5.20
Motor / biblioteca de inferencia, Servidor API Servicio de modelos de lenguaje y multimodales en una GPU o un clúster Generación de texto, Procesamiento continuo por lotes, Caché de prefijos, Salida estructurada Los parsers de herramientas y los kernels de cuantización dependen de la arquitectura del modelo. Desde 0.5.20 ya no se publican paquetes ni imágenes CUDA 12; 0.5.19 es la última versión para esta vía. Las imágenes publicadas anteriormente siguen disponibles. El almacenamiento de Responses está desactivado por defecto. La recuperación, previous_response_id y las solicitudes en segundo plano requieren --enable-response-store; no puede activarse en despliegues con prefill y decode separados (PD). Los parsers de herramientas y los kernels de cuantización dependen de la arquitectura del modelo. Desde 0.5.20 ya no se publican paquetes ni imágenes CUDA 12; 0.5.19 es la última versión para esta vía. Las imágenes publicadas anteriormente siguen disponibles. El almacenamiento de Responses está desactivado por defecto. La recuperación, previous_response_id y las solicitudes en segundo plano requieren --enable-response-store; no puede activarse en despliegues con prefill y decode separados (PD). Primeros pasos ↗
SGLang · v0.5.19
Motor / biblioteca de inferencia, Servidor API Servicio multiusuario y cargas con prefijos compartidos Procesamiento por lotes y caché de prefijos; ajuste según la carga Los parsers de herramientas y kernels de cuantización dependen de la arquitectura; consulte la versión y los ajustes de cada fila junto con el resultado. Primeros pasos ↗
llama.cpp / llama-server · v0.4.1
Motor / biblioteca de inferencia, Servidor API GGUF en CPU, GPU y RAM/VRAM combinadas Control de cuantización, reparto de capas y ejecución en CPU Versión histórica v0.4.1; no mezcle RPC major 6 con major 7 de v0.5.0. La ejecución parcial en CPU es distinta de la carga por capas de AirLLM. Primeros pasos ↗
TensorRT-LLM · v1.2.1
Motor / biblioteca de inferencia, Servidor API Despliegue especializado en GPU de NVIDIA Optimización de modelo, kernels y servicio Las rutas compatibles y ajustes varían según versión y arquitectura. Primeros pasos ↗
Triton Inference Server · v2.73.0
Servidor API, Gestor de despliegue Alojar varios modelos y frameworks mediante un servicio común TensorRT / PyTorch / ONNX / OpenVINO / Python y otros backends La versión 26.09 añade soporte inicial para Rubin; no incluye un contenedor dedicado del backend TensorRT-LLM. Elija la imagen del backend por separado. Primeros pasos ↗
Triton Inference Server · v2.72.0
Servidor API, Gestor de despliegue Gestionar servicios de modelos y cadenas de inferencia Gestión de modelos, planificación e integración de backends especializados La versión 2.72.0 no incluye un contenedor del backend TensorRT-LLM. Primeros pasos ↗
Text Embeddings Inference (TEI) · v1.9.4
Motor / biblioteca de inferencia, Servidor API Servicio de embeddings, reclasificación y clasificación de texto Candle / cuBLASLt / ONNX; Metal en Mac según el modelo Se añadieron ARM64 y SM121 para GB10 y soporte inicial AMD/ROCm; esto no valida todas las GPU AMD. La tarea y el pooling dependen del modelo. Primeros pasos ↗
Text Embeddings Inference (TEI) · v1.9.3
Motor / biblioteca de inferencia, Servidor API Servicio de embeddings de documentos y consultas Procesamiento por lotes y API de embeddings; imágenes para CPU y GPU La compatibilidad con embeddings no implica reclasificación para todas las arquitecturas. Primeros pasos ↗
AirLLM · v4.0.0
Motor / biblioteca de inferencia Ejecutar modelos grandes con VRAM limitada Cargar y descargar capas mediante memoria del host y almacenamiento El objetivo principal es reducir memoria de GPU; el chat simultáneo requiere una prueba de esa carga. Primeros pasos ↗
Transformers · v5.18.0
Motor / biblioteca de inferencia, Servidor API Cargar modelos y crear flujos de inferencia en Python PyTorch y clases de modelos de Transformers; serve según la versión La versión 5.18 incorpora modelos y correcciones GGUF; verifique GPT-OSS/ROCm y el servicio con las versiones exactas del backend y modelo. Primeros pasos ↗
Transformers · v5.17.0
Motor / biblioteca de inferencia, Servidor API Investigación, control directo del modelo y rutas personalizadas Acceso directo al modelo y a la lógica de procesamiento La velocidad de una ruta sencilla de Transformers no representa todos los motores para ese modelo. Primeros pasos ↗
LiteLLM · v1.103.1
Pasarela de modelos, Servidor API Pasarela común para varios proveedores y servicios de modelos Conecta API de proveedores y servidores de modelos Nueva versión estable de la pasarela API; la generación ocurre en el servicio conectado. No atribuya funciones o licencia Enterprise al núcleo abierto. Primeros pasos ↗
LiteLLM · v1.101.0
Pasarela de modelos, Servidor API Gestionar varios proveedores y backends API común, enrutamiento y gestión del consumo La capacidad de ejecutar pesos procede del backend. Primeros pasos ↗
Open WebUI · v0.11.4
Interfaz de conversación Interfaz de chat para Ollama y API compatibles Ollama o un servicio compatible con OpenAI API La imagen slim elimina modelos locales y muchos paquetes; revise las dependencias externas para uso sin conexión, embeddings, documentos y voz. Primeros pasos ↗
Open WebUI · v0.11.3
Interfaz de conversación Panel de chat conectado a backends de modelos Interfaz de chat para usuarios y conexión al motor La memoria y velocidad del modelo corresponden al backend conectado. Primeros pasos ↗
Text Generation Inference (TGI) · v3.3.7
Motor / biblioteca de inferencia, Servidor API Mantenimiento del servicio de generación de texto para modelos compatibles Generación de texto, Distribución del modelo entre GPU (condicionado), Salida en streaming, Procesamiento continuo por lotes El repositorio está archivado y es de solo lectura desde el 21 de marzo de 2026. El repositorio está archivado y es de solo lectura desde el 21 de marzo de 2026. Primeros pasos ↗
LM Studio · 0.4.24 Build 1
Interfaz de conversación, Gestor de modelos, Servidor API Descargar modelos, conversar e iniciar una API local Carga y descarga de modelos, Salida en streaming, Salida estructurada, Solicitudes simultáneas Las capacidades y los formatos del modelo dependen del motor elegido. Las capacidades y los formatos del modelo dependen del motor elegido. Primeros pasos ↗
KTransformers · v0.7.1
Motor / biblioteca de inferencia Cuando la memoria del sistema y la GPU forman parte del diseño del despliegue. Ejecución heterogénea en CPU y GPU, con rutas optimizadas para modelos MoE compatibles. El rendimiento depende del modelo, la CPU, la memoria y la configuración. Primeros pasos ↗
Sentence Transformers · v6.1.0
Motor / biblioteca de inferencia Para implementar y evaluar la capa de recuperación. Embeddings para recuperación semántica y modelos CrossEncoder para puntuar o reordenar resultados. Mejoraron la entrada multimodal y la documentación; image/audio/video requieren dependencias opcionales y el orden de claves puede cambiar embeddings o puntuaciones. Primeros pasos ↗
Sentence Transformers · v6.0.1
Motor / biblioteca de inferencia Para implementar y evaluar la capa de recuperación. Embeddings para recuperación semántica y modelos CrossEncoder para puntuar o reordenar resultados. La compatibilidad de la biblioteca no demuestra la calidad en cada tarea o idioma. Primeros pasos ↗
FlagEmbedding · v1.4.2
Motor / biblioteca de inferencia Ejecución de la familia BGE y sus reclasificadores Salidas densas, dispersas y multivector de BGE-M3 Las tres salidas de BGE-M3 requieren diferentes formas de indexación y uso; la salida densa no sustituye a las tres. Primeros pasos ↗
MLX LM · v0.31.3
Motor / biblioteca de inferencia Generación local y cuantización de modelos compatibles en Apple silicon Generación de texto (condicionado), Salida en streaming (condicionado), Caché de prefijos (condicionado), Distribución del modelo entre GPU (condicionado) Ruta directa para generación local y cuantización en Apple silicon con modelos compatibles. No sume la memoria unificada dos veces como RAM y VRAM. El requisito de macOS 15 del README se refiere al bloqueo de memoria para modelos grandes, no a todas las funciones. Ruta directa para generación local y cuantización en Apple silicon con modelos compatibles. No sume la memoria unificada dos veces como RAM y VRAM. El requisito de macOS 15 del README se refiere al bloqueo de memoria para modelos grandes, no a todas las funciones. Primeros pasos ↗
vLLM · v0.30.0
Motor / biblioteca de inferencia, Servidor API Servicio de modelos con vLLM; estable 0.30.0 Cuatro avisos de seguridad corregidos; revise las condiciones de actualización Estable; corrige GHSA-x6mc-67gf-chw4, GHSA-85xf-c7hm-whqw, GHSA-5fj9-pfhr-6j48 y GHSA-58v5-2m8f-94pr según los avisos oficiales. Al actualizar desde 0.29: se elimina GPTQ activation ordering con g_idx y se ignora g_idx; revise los checkpoints dependientes. vllm serve requiere --enable-scale-out; se elimina VLLM_ENABLE_SCALE_OUT_ENDPOINTS. launch render y --tokens-only son excepciones. Los paquetes predeterminados usan CUDA 13.0; existen ruedas e imágenes separadas CUDA 12.9. Compruebe GPU y controlador con el paquete elegido. No se atribuyen resultados anteriores a esta versión. Primeros pasos ↗
llama.cpp / llama-server · v0.5.0
Motor / biblioteca de inferencia, Servidor API Inferencia GGUF y servicio con la versión estable 0.5.0 Protocolo RPC 7; clientes y servidores deben ser compatibles. En RPC, el cliente y todos los servidores deben compartir major; minor del servidor no puede superar al del cliente. Alinee las compilaciones: no conecte v0.4.1 con protocolo 6 a v0.5.0 con protocolo 7. Las correcciones y capacidades preliminares figuran en sus propias versiones. Primeros pasos ↗
llama.cpp / llama-server · b11262 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API corrección en CPU con AVX512-FP16 Acumulación FP32 en productos escalares F16; corrección de desbordamiento La versión preliminar b11262 corrige el cálculo en CPU. En la ruta AVX512-FP16, la acumulación FP16 de productos escalares F16 podía desbordarse y alterar los logits; b11262 acumula en FP32. Antes de confiar en esta ruta, repita las pruebas de versiones anteriores con b11262+ y la corrección #29545. No demuestra mayor velocidad ni se recomienda por defecto para producción. Primeros pasos ↗
Ollama · v0.35.1
Motor / biblioteca de inferencia, Servidor API Versión estable; decisiones tipadas mediante /v1/systemone para Nimble, Tev1, Clef y Clef Flash Entrada de texto e imagen con Clef/Clef Flash; choice, noul y score; capacidad decision Versión estable v0.35.1: /v1/systemone acepta preguntas choice, noul y score con modelos de decisión compatibles; Clef y Clef Flash puntúan texto e imágenes conjuntamente. Declare CAPABILITY decision en un modelo compatible; los clientes no deben ofrecerlo para chat, tools ni thinking. El endpoint no genera texto libre. Las notas mencionan actualizaciones de llama.cpp y MLX, sin acreditar la compatibilidad de cada backend por separado. Para Nimble y Tev1, disponer de Safetensors no demuestra que el mismo archivo funcione con SystemOne; verifique el artefacto compatible. No se ha ejecutado el modelo localmente ni evaluado su calidad en persa. Primeros pasos ↗
llama.cpp / llama-server · b11310 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API seguridad de memoria y ejecución de IQ4_NL CUDA/HIP/MUSA; filas IQ4_NL no divisibles por QK_K Prelanzamiento; corrección de seguridad de memoria de IQ4_NL en CUDA/HIP/MUSA. Esta ruta requiere b11310+ con #29683. Si el número de elementos es múltiplo de QK4_NL pero no de QK_K, el último bloque podía leer fuera de la entrada y escribir fuera del búfer; los múltiplos de QK_K no sufren este fallo. En la prueba de depuración del autor con 192 elementos, las escrituras fuera de límites bajaron de 128 a cero bytes (CUDA H20-3e y MUSA S5000); HIP comparte el código, sin prueba independiente en ese informe. A 1 de octubre de 2026, las fuentes no anuncian CVE ni explotabilidad. No demuestra mayor velocidad ni cambios en la memoria necesaria. Primeros pasos ↗
llama.cpp / llama-server · b11307 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API ejecución simultánea de DFlash/DFlash2 Orden de layer input; flujos KV separados y tensor split Prelanzamiento; restaura el orden de layer input para DFlash/DFlash2 con varias secuencias. Con concurrency mayor que uno, especialmente con flujos KV separados, use b11307+ con #29019; la corrección también admite tensor split. Dividir el batch podía entregar al drafter el hidden state de otro token; se restaura el orden original. En SPEED-Bench del autor, Qwen3.8-27B y DFlash2, ambos Q4_K_M con concurrency=16, pasaron de 3.3531 a 3.9211 de longitud media de aceptación (+16.94%). No demuestra velocidad final, calidad en persa ni rendimiento en otros modelos o equipos. #27117 aporta contexto, sin confirmar que todos sus casos estén resueltos. Sin pruebas locales; no es la opción predeterminada de producción. Primeros pasos ↗
llama.cpp / llama-server · b11371 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API soporte inicial de Clef en /v1/systemone Esta compilación admite Clef solo con texto; v0.6.0 añade imágenes b11371 añade soporte inicial de Clef solo para texto. v0.6.0 estable añade imágenes con GGUF y proyector compatibles; el límite de esta compilación no se aplica a versiones posteriores ni a Ollama v0.35.1. b11371 sigue siendo preliminar; rendimiento local y calidad en persa no verificados. Primeros pasos ↗
llama.cpp / llama-server · v0.6.0
Motor / biblioteca de inferencia, Servidor API llama.cpp / llama-server estable con decisiones de Clef sobre texto e imágenes Clasificación (condicionado) La versión estable v0.6.0 añade imágenes para Clef mediante /v1/systemone. Use GGUF con la plantilla actualizada y un proyector compatible (--mmproj); los archivos antiguos pueden requerir otra conversión. El prompt completo debe caber en --ubatch-size; las imágenes usan data URLs. Las respuestas son choice, noul o score; el servidor Clef no genera texto libre. Incluye la corrección Vulkan FlashAttention #29988. No se han probado calidad en persa, velocidad ni memoria total. La versión estable v0.6.0 añade imágenes para Clef mediante /v1/systemone. Use GGUF con la plantilla actualizada y un proyector compatible (--mmproj); los archivos antiguos pueden requerir otra conversión. El prompt completo debe caber en --ubatch-size; las imágenes usan data URLs. Las respuestas son choice, noul o score; el servidor Clef no genera texto libre. Incluye la corrección Vulkan FlashAttention #29988. No se han probado calidad en persa, velocidad ni memoria total. Primeros pasos ↗
llama.cpp / llama-server · b11424 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API corrige un acceso fuera de límites en Vulkan FlashAttention Vulkan + FlashAttention: corrección de escritura en memoria compartida b11424 incluye #29988 para una escritura fuera de límites en memoria compartida de Vulkan FlashAttention; el informe oficial describe un fallo DeviceLost en NVIDIA. Para la ruta afectada, use b11424+ con la corrección o v0.6.0 estable y repita las pruebas. No demuestra mayor velocidad, CVE ni explotación probada; las estimaciones de VRAM no cambian. Primeros pasos ↗
llama.cpp / llama-server · b11454 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API vía mínima de llama.cpp para cinco modelos K2 Horizon con GGUF oficial Generación de texto (condicionado), Llamadas a herramientas (condicionado) Modelos publicados el 3 de septiembre; b11454 añade ejecución el 6 de octubre y sigue siendo un prelanzamiento. Solo cinco modelos GGUF oficiales; no se atribuye esta vía a 375B-A23B. -sm tensor desactivado. Las correcciones ZWNJ/ZWJ y Windows no demuestran calidad en persa; velocidad y memoria real sin probar. Modelos publicados el 3 de septiembre; b11454 añade ejecución el 6 de octubre y sigue siendo un prelanzamiento. Solo cinco modelos GGUF oficiales; no se atribuye esta vía a 375B-A23B. -sm tensor desactivado. Las correcciones ZWNJ/ZWJ y Windows no demuestran calidad en persa; velocidad y memoria real sin probar. Primeros pasos ↗
llama.cpp / llama-server · b11532 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API versión mínima con las correcciones de seguridad de memoria y GELU de ModernBERT b11529+ comprueba el offset en ggml_acc_impl antes de convertirlo a int32_t para evitar escrituras fuera de límites por desbordamiento. El informe del PR también menciona offsets negativos recibidos por RPC GRAPH_COMPUTE; el parche final no valida directamente los parámetros RPC. b11532+ usa GELU exacto como Transformers para ModernBERT con hidden_activation=gelu. Las fuentes revisadas no anuncian CVE ni explotación real; esta corrección no demuestra un aumento de velocidad. Los GGUF existentes de ModernBERT no requieren reconversión; repita las pruebas de versiones anteriores. El autor probó solo CPU/F32 con gte-reranker-modernbert-base: el error máximo de activación bajó de 5.8e-2 a 7.4e-6; no probó GPU y la variación de velocidad CPU quedó dentro del ruido entre ejecuciones. Estas cifras no evalúan directamente ModernBERT-base. Primeros pasos ↗
llama.cpp / llama-server · b11537 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API versión mínima con la corrección del orden del grafo de embeddings tras la regresión de lotes mixtos La corrección #30160 coloca GET_ROWS antes de otras operaciones de entrada para reducir divisiones innecesarias del grafo y ejecución en CPU. Use b11537 o posterior para lotes mixtos/embeddings y como punto de partida al repetir pruebas de MTP y varias GPU; verifique por separado el soporte del modelo. Un informe de usuario en Linux, SYCL y dos Arc Pro B70 con Qwen3.8-Flash-Next / UD-IQ3_XXS: unos 365 pp y 24 tg pasaron a 582.23 pp y 32.75 tg. Los valores corregidos proceden de la rama del PR, no de una prueba independiente del binario b11537. No se detallan por completo la entrada, las repeticiones ni una prueba separada de MTP; no generalice a todas las GPU. Primeros pasos ↗
llama.cpp / llama-server · b11540 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API decodificación optimizada de MoE MXFP4 en SYCL SYCL MXFP4 MoE optimized decode; #29809 usa decodificación aritmética y reordenamiento de pesos. El autor informa que gpt-oss-20b con una B70 pasa de 55.84 a 106.64 tok/s y gpt-oss-120b con dos B70 de 33.27 a 67.14 tok/s. La prueba original del autor del PR usa Windows 11, oneAPI 2026.0, CPU EPYC 7402P y Flash Attention activado; cinco repeticiones para 20B y dos para 120B. Son resultados de decodificación; no los extrapole a prefill, Linux u otras GPU. b11540 incluye la corrección, pero las cifras proceden de la rama del PR; el sitio no las ha probado de forma independiente. Primeros pasos ↗
llama.cpp / llama-server · b11552 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API corrección del aislamiento de contexto en llama-server con id_slot fijo y caché de prompts en RAM Una solicitud con id_slot fijo espera sin cargar contexto de caché en un slot ocupado. Requisito: pinned id_slot + RAM prompt cache → b11552+. No use esta combinación en un servicio multiusuario hasta actualizar y superar la prueba de aceptación con canary. Se confirmó un fallo de aislamiento de contexto; el release y el PR no informan de un CVE ni de una divulgación real de datos. Prueba limitada del proyecto: M2 Ultra/Metal, Qwen3.8-27B-UD-Q4_K_M con mmproj, --parallel 10, --kv-unified, --no-cache-idle-slots, --cache-ram 8192 e id_slot=7. b11146: 30 pares simultáneos, 1 cruce y 9 respuestas dañadas. Rama del PR (build 11550): 60 pares, 0 cruces y 0 respuestas dañadas; una ronda agotó el plazo de 60 segundos del cliente. b11552 incluye la corrección; no son mediciones del binario publicado ni una garantía para todas las configuraciones. El alcance sin slot pinning sigue sin conocerse. Primeros pasos ↗
llama.cpp / llama-server · v0.7.0
Motor / biblioteca de inferencia, Servidor API Servicio estable con caché de expertos MoE y LiliCorr --moe-cache-mib fija la caché para expertos en el host; esta versión usa el protocolo RPC 8 y admite tensor split. Antes de conectar por RPC, compruebe la compatibilidad con el protocolo 8 en ambos extremos. La ejecución directa usa el puerto 9931; Docker conserva el 8080 interno. Los cambios de chat session API y formato part-based pueden requerir ajustes del cliente. Beam en b11701 y Granite en b11700/11707 llegaron después de esta versión. Primeros pasos ↗
Ollama · v0.40.5
Motor / biblioteca de inferencia, Servidor API, Gestor de modelos Versión estable histórica 0.40.5; la nueva versión figura aparte Nemotron 3.5 Super/Bolt; corrección de continuación Responses con herramientas propias La migración en segundo plano de 0.40.2 se pausó en 0.40.3 por rendimiento; no se extiende a 0.40.5. Los modelos de decisión cloud no son ejecución local. Bolt 24GB no garantiza contexto completo ni memoria total; compruebe paquete y versión. Primeros pasos ↗
vLLM · v0.31.0
Motor / biblioteca de inferencia, Servidor API vLLM 0.31.0 estable; servicio condicionado a versión y entradas Corrección GHSA-4xqp-c3mv-qff7; rango afectado declarado anterior a 0.31.0 El aviso describe entradas inválidas en /inference/v1/generate que bloquean el servicio mientras /health sigue sano: rango <0.31.0, corregido >=0.31.0, prueba en 0.29. Revise kwargs multimodales, tokenizer_mode=slow, caché y demás avisos del 6 de octubre. No se atribuye a esta estable soporte nightly de modelos nuevos. Primeros pasos ↗
SGLang · v0.5.21
Motor / biblioteca de inferencia, Servidor API SGLang 0.5.21 estable; vías CUDA y ROCm versionadas Soporte versionado MiMo 2.6 y GLM 5.3 Flash en MI355X Las imágenes ROCm dependen de la familia GPU; soporte MI355X no certifica todas las AMD. No se generalizan aceleraciones a otros modelos o condiciones; se conservan resultados históricos. Primeros pasos ↗
SGLang · v0.5.22
Motor / biblioteca de inferencia, Servidor API SGLang 0.5.22 estable: migración de configuración y corrección del estado de modelos híbridos Python ≥3.11; una instalación sin versión fijada en Python 3.10 puede seleccionar silenciosamente una versión anterior. Usar --attn-dp-size N en lugar de --enable-dp-attention; la combinación antigua se convierte con aviso. --dp-size cuenta réplicas; en DeepSeek CP conserva temporalmente el significado de attention DP, que se rechazará después del 2026-12-31. Combinar réplicas con attention DP, o ambas grafías, provoca error al iniciar. --disaggregation-decode-host-receive-threshold invierte sus valores: 1=desactivado (predeterminado), 0=recibir siempre en el host. Se eliminó tc_piecewise; --cuda-graph-backend-prefill tc_piecewise y tc_compiler provocan error al iniciar. Fechas separadas: publicación GitHub el 19 de octubre de 2026 a las 02:55 UTC; paquete PyPI disponible desde el 16 de octubre. Corrección de ejecución: corrige el registro incorrecto de checkpoints Mamba al combinar decodificación especulativa y salida estructurada, que podía restaurar modelos híbridos desde un estado erróneo (PR #43029). Seguridad: no se ha confirmado una corrección de Dumper; la ruta eval() sigue en la etiqueta 0.5.22. No se considera resuelta la vulnerabilidad anterior. Confianza alta en versión, requisitos y cambios; sin pruebas locales de rendimiento ni calidad en persa. El registro no recomienda actualizar sin pruebas; las BOM/QPL específicas de OEM y el código interno del asistente no tienen cobertura completa. Primeros pasos ↗
llama.cpp / llama-server · b11722 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Flash Attention multisecuencia en Hexagon Desde b11722, Flash Attention puede procesar varias secuencias en Hexagon con --no-kv-unified. El PR #30218 prueba IQ-9075 EVK / Hexagon v73 con Llama-3.2-1B y Qwen3.5-2B Q4_0. La ruta requiere --no-kv-unified. No valida todos los Snapdragon ni una mejora con una sola sesión: pruebe su dispositivo antes de usarla. Sin prueba local de ejecución. Primeros pasos ↗
llama.cpp / llama-server · b11727 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Evitar salidas dañadas al preparar GGUF gguf-split y export-lora detectan lecturas incompletas de tensores y se detienen con error. Un búfer reutilizado podía completar los bytes no leídos con datos del tensor anterior y producir una salida dañada que parecía correcta. La corrección #30497 rechaza ese caso; sigue siendo necesario verificar el checksum de entrada. No implica fallos en archivos válidos ni cambia la calidad del modelo. Sin prueba local de ejecución. Primeros pasos ↗
llama.cpp / llama-server · b11774 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Preprocesamiento de imágenes LFM2 y LFM2.5-VL acorde con Transformers La imagen se estira a la cuadrícula de mosaicos; el redimensionado y el redondeo siguen la referencia Python. Vuelva a convertir mmproj con el conversor actualizado para guardar processor_config.json; incluye los cambios de b11767. Antes de la corrección, la distribución difería en 31 926 tamaños entre unos 16,8 millones de casos hasta 4096×4096. En el ejemplo 720×1600, los tokens bajaron de 2812 a 2298. Otras formas pueden aumentar los tokens y el tiempo. Las pruebas de salida del PR cubren sobre todo modelos 450M y la familia d1; la ruta LFM2.5-VL-3B sigue siendo experimental y requiere pruebas con sus imágenes. No se certifica el modelo DSpark. Sin prueba local de ejecución. Primeros pasos ↗
llama.cpp / llama-server · b11778 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Embeddings de texto con Nemotron-3 y Nemotron-3.5 Embed Permite convertir los pesos BF16 de Embed 1B/8B a GGUF y ejecutarlos con llama-embedding. Es una conversión del usuario; no se registra un GGUF oficial listo para descargar. Una comparación publicada para una entrada de texto del modelo 1B informa una similitud coseno de 0.999847 frente a PyTorch. Mide concordancia de implementación, no calidad de recuperación ni corrección para toda entrada. No constan pruebas completas de imagen ni de 8B. La ruta no cubre Rerank-8B ni NVFP4. Sin prueba local de ejecución. Primeros pasos ↗
llama.cpp / llama-server · b11160 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Vulkan INT8 en RDNA3 y RDNA4 coopmat1 requiere una compilación cooperative matrix y soporte INT8 del dispositivo/controlador; GGML_VK_DISABLE_COOPMAT no debe desactivarlo. Formatos: q4_0, q4_1, q5_0, q5_1, q8_0, q3_k, q4_k, q5_k, q6_k, mxfp4, nvfp4 e iq4_nl. En RDNA4, MUL_MAT excluye q4_1, q5_1, q4_k, q5_k y nvfp4; MUL_MAT_ID también excluye nvfp4. Las pruebas incluyen RDNA3.5, sin validar todas las GPU AMD. Antes de confiar en b11160, repita primero las pruebas de corrección y luego las de rendimiento en b11224+ con #28956. Primeros pasos ↗
llama.cpp / llama-server · b11182 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Precisión de activaciones FP4 según los metadatos En CUDA sobre Blackwell, las capas NVFP4/MXFP4 marcadas W4A16 pueden usar W4A8. Los pesos FP4 no implican activaciones de cuatro bits. GGML_CUDA_MMQ_PREC=auto sigue los metadatos; q4 y q8 fuerzan la precisión. q4 puede acelerar el prompt a costa de precisión: pruébelo antes de elegirlo como predeterminado. El cambio no pertenece a v0.5.0 estable. Primeros pasos ↗
llama.cpp / llama-server · b11223 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Entradas largas para rerankers causales Qwen3 y Qwen3-VL Desde b11223+ con #28876, la entrada RANK con atención causal puede repartirse entre varios lotes físicos. Antes se rechazaban entradas mayores que n_ubatch, 512 tokens por defecto. Los cross-encoders bidireccionales aún necesitan un solo lote físico. No completa el soporte multimodal de /rerank ni /embedding; el despliegue requiere pruebas controladas. Primeros pasos ↗
llama.cpp / llama-server · b11224 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Corrección de lecturas con stride en Vulkan La corrección #28956 ajusta las lecturas mul_mat y mul_mat_id de ciertas vistas de caché y expertos con stride. El PR describe un bucle infinito en SheetSage2 y un fallo Qwen3 AR con --no-fa. En b11224+, compare la salida con CPU/CUDA usando ajustes iguales y tolerancias numéricas explícitas. También deben repetirse las pruebas de b11160. No demuestra mayor velocidad ni fallos en todos los modelos. Primeros pasos ↗
llama.cpp / llama-server · b11240 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API API multimodal para Qwen3-VL-Embedding Desde b11240+, /v1/embeddings acepta entradas tipadas de estilo OpenAI; las modalidades dependen del modelo. Cada objeto {"content": [...]} produce un embedding; se rechazan los arrays content sin envoltura y se conserva la API anterior. KV prefix reuse está desactivado para embedding/rerank: vuelva a medir capacidad y velocidad. La ruta Qwen3-VL-Embedding-2B/8B es experimental y no certifica Reranker multimodal. Primeros pasos ↗
llama.cpp / llama-server · b11279 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Soporte inicial de GLM-5.3-Flash b11279 incorporó el soporte con #27773; las pruebas también necesitan la corrección posterior #29745. Tras la integración se notificó una carrera de datos en CPU/ThreadSanitizer. b11279 no contiene #29745: compruebe que su compilación incluya la corrección y repita las pruebas de salida. No se acredita soporte para GLM-5.3-BF16. Sin prueba local de ejecución. Primeros pasos ↗
llama.cpp / llama-server · b11821 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Corrección de Intel XMX para lotes cortos y verificación especulativa Refactorización de kernels multicolumna, alineación y gate/up fusionado; corrige NaN con filas no divisibles por cuatro. La evidencia de rendimiento se limita a Arc Pro B70 y oneAPI; no se generaliza a todas las GPU Intel. No se probaron localmente la corrección ni la velocidad. Primeros pasos ↗
llama.cpp / llama-server · b11822 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Corrige el aborto de la primera solicitud DFlash en Qwen3.8-Flash-Next Los flujos residuales se promedian antes de pasarlos al drafter; esta ruta DFlash requiere b11822 o posterior. El requisito es específico de DFlash, no de inferencia normal ni MTP. No se ejecutó una prueba local. Primeros pasos ↗
llama.cpp / llama-server · b11826 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Soporte del motor para MiniCPM-OCR 1.0 Registra el modelo y el proyector mediante la conversión MiniCPM-V 4.6; esto no acredita por sí solo pesos públicos ni licencia. El texto OCR puede aparecer en reasoning_content; use --reasoning off o reasoning_effort: "none" para content. Esta corrección del motor no acredita pesos públicos ni licencia. Primeros pasos ↗
llama.cpp / llama-server · b11828 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Conserva los límites de commits de audio en Realtime API Completa cada commit tras decodificar su última fila, evitando unir commits vecinos o filtrar audio posterior a un elemento previo. Se limita al audio en tiempo real de llama-server; no cambia el soporte de modelos ni la estimación de memoria. No hubo prueba local. Primeros pasos ↗
llama.cpp / llama-server · b11829 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Corrige la sustitución de placeholders en plantillas rerank Sustituye {query} y {document} solo en la plantilla original, sin reinterpretar la entrada del usuario. Es una corrección de rerank; no cambia la política general de seguridad ni la calidad del modelo. No hubo prueba local. Primeros pasos ↗
llama.cpp / llama-server · b11835 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Corrige el fallo de compilación SYCL/oneDNN Pasa el dispositivo a mul_mat_uses_onednn; corrige la regresión en el commit f64a498. La corrección de compilación no demuestra nuevos modelos, cuantizaciones ni rendimiento. No hubo compilación ni prueba de ejecución local. Primeros pasos ↗
llama.cpp / llama-server · b11838 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Corrige el desbordamiento del temporizador en servicios Windows prolongados Elimina la multiplicación intermedia que desbordaba ggml_time_us y corrige el cierre comunicado tras unos 10,5 días. Se limita a servicios Windows prolongados; no se afirma que pasaran todas las verificaciones upstream ni una prueba local de resistencia. Primeros pasos ↗
llama.cpp / llama-server · b11847 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Corrige la compilación BF16 WMMA en gfx11/gfx12 Cambia operandos __bf16 por short sin alterar bits; corrige la compilación en gfx1150/1151 y gfx1200/1201 con HIP/ROCm y LLVM recientes. Use b11847 o posterior para estos objetivos con toolchain reciente. El autor del PR solo probó gfx1151; no todas las GPU RDNA3/RDNA4. No cambian las especificaciones ni las estimaciones de memoria. Primeros pasos ↗
Ollama · v0.40.9
Motor / biblioteca de inferencia, Servidor API, Gestor de modelos Estable histórica; d3, voz Phonon y Flint multiplataforma d3 en /v1/systemone; Phonon en /v1/audio/speech sobre Apple Silicon; Flint en Linux y Windows; notificación de errores en streams OpenAI/Anthropic. Phonon solo funciona en Apple Silicon y no es un modelo persa. d3 devuelve decisiones, no texto libre. Los errores ya no deben ocultarse tras una salida parcial; no hubo prueba local. Primeros pasos ↗
Ollama · v0.40.10
Motor / biblioteca de inferencia, Servidor API, Gestor de modelos Estable / Latest; añade E4B y DFlash nemotron-3.5-bolt:e4b con DFlash; conserva las novedades d3, voz y Flint de 0.40.9. NVIDIA especifica texto y 64K. Ollama anuncia imágenes y 128K para su paquete; esta diferencia pendiente no activa el filtro multimodal del modelo. El GGUF principal tiene 6.180.446.208 bytes; 4GB no es el tamaño ni una garantía de VRAM. DFlash es auxiliar y necesita memoria adicional. Primeros pasos ↗
llama.cpp / llama-server · b11865 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Corrige el desbordamiento del búfer de recepción RPC/RDMA En rdma_recv se rechaza antes de memcpy una recepción mayor que el espacio restante; se repone la ranura de recepción y se cierra la conexión. Se limita a RPC sobre RDMA, no a la API HTTP. El autor del PR reprodujo el fallo y su corrección con ASan y SoftRoCE; no se acredita explotación real ni prueba local independiente. Primeros pasos ↗
llama.cpp / llama-server · b11858 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Restricción de tensor split para mellum y flint Desactiva --split-mode tensor para mellum y flint; mistral4 ya estaba excluida. Dividir una fila daba máximos parciales en vez del máximo completo necesario para reescalar MoE. La restricción es específica de estas arquitecturas y este modo; no prohíbe todos los modelos MoE ni todos los métodos multi-GPU. No se realizó una prueba independiente en varias GPU. Primeros pasos ↗
llama.cpp / llama-server · b11870 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API Soporte de la arquitectura DeepSeek-V4.1-Flash Añade la arquitectura deepseek41 en el commit 74bca39; la conversión guarda la tabla Engram como BF16 y elimina su ruta MXFP8. El soporte de arquitectura no valida el snapshot 1017 con un artifact y backend concretos. No se verifican GGUF oficial, soporte directo MXFP8, calidad en persa, velocidad ni memoria; no se informó del éxito de todas las verificaciones del PR. Primeros pasos ↗
Ollama · v0.40.14 · Estable / Latest
Motor / biblioteca de inferencia, Servidor API, Gestor de modelos Conservar el muestreo del modelo y corregir la API Si se omiten temperature o top_p, los endpoints compatibles conservan los valores del paquete. Se corrigen respuestas comprimidas de búsqueda web, contenido de /v1/responses y muestreo top-k de MLX. Los clientes que omiten parámetros de muestreo pasan a usar los del modelo; téngalo en cuenta al reproducir salidas. Primeros pasos ↗
SGLang · v0.5.23 · Estable / Latest
Motor / biblioteca de inferencia, Servidor API SGLang 0.5.23: Paged Experts y LoRA para MoE cuantizado Paged Experts permite MoE mayores que la memoria GPU; el motor LoRA admite MoE FP8/NVFP4, ambos opcionales. TPU7x usa TorchTPU y DeepSeek-V4.1-Flash de baja latencia usa plugins megakernel o monokernel. MI35x, MI30x, XPU y TPU tienen imágenes distintas; las nuevas rutas Paged Experts y LoRA requieren activación explícita. Primeros pasos ↗
vLLM · v0.32.0 · Estable / Latest
Motor / biblioteca de inferencia, Servidor API vLLM 0.32.0: decisiones estructuradas y KV de baja precisión Añade /v1/systemone para choice, noul y score, y el parser genérico hf. KV NVFP4 se amplía a SM8x, SM90 y SM12x; MRV2 pasa a ser predeterminado en ROCm. Se elimina Python 3.10; CORS ya no admite todos los orígenes por defecto. Transformers debe ser >=5.16.1 y <5.20.0. Primeros pasos ↗
vLLM · v0.33.0rc3 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API vLLM 0.33.0rc3: migración de CUDA y PyTorch Esta etiqueta documenta PyTorch 2.14, Triton 3.8, paquetes CUDA 13.0, imágenes ROCm 10 por defecto y /v1/decisions. Ya no se publican paquetes CUDA 12.9. Versión preliminar rc3; la migración desde 0.32.0 cambia los paquetes CUDA y PyTorch. Primeros pasos ↗
llama.cpp / llama-server · b12065 · Versión preliminar
Motor / biblioteca de inferencia, Servidor API llama.cpp b12065: corrección de caché KV compartida Las cachés compartidas, incluido gemma4 assistant, ya no devuelven kv_rows cero durante el calentamiento; evita cambios de máscara y abortos por reasignación del grafo. La corrección afecta a la construcción del grafo con caché compartida; la compilación es preliminar. Primeros pasos ↗

«—» indica que no hay información registrada; no significa que el modelo carezca de esa capacidad.

Resultados de evaluación

Evidencias para elegir un modelo

Cómo se selecciona y compara

En MIRACL español, nDCG@10 pasa de 51,2 con Small a 53,7 con Large-Instruct. En inglés, Large obtiene 52,9 y Large-Instruct 51,5; en persa, 59,0 y 59,4. La media multilingüe no sustituye la comparación en el idioma de uso.

Dos cifras mostradas juntas no son automáticamente comparables para ordenar modelos. Revise variante, versión del benchmark, idioma, modo y protocolo. Una diferencia de puntuación no es una proporción de calidad ni demuestra significación estadística.

MIRACL · nDCG@10· español

ModeloPuntuaciónDiferencia respecto a la primera filaFuente y configuración
51,2 puntos / 100—
Fuente y configuraciónMultilingual E5 technical report, arXiv:2402.05672v1 ↗Informe del editor del modelo

Appendix / detailed MIRACL results / language=es / column=1

Partición de datos
development
Escala de puntuación
0–100 as printed
51,5 puntos / 1000,3
Fuente y configuraciónMultilingual E5 technical report, arXiv:2402.05672v1 ↗Informe del editor del modelo

Appendix / detailed MIRACL results / language=es / column=2

Partición de datos
development
Escala de puntuación
0–100 as printed
52,9 puntos / 1001,7
Fuente y configuraciónMultilingual E5 technical report, arXiv:2402.05672v1 ↗Informe del editor del modelo

Appendix / detailed MIRACL results / language=es / column=3

Partición de datos
development
Escala de puntuación
0–100 as printed
53,7 puntos / 1002,5
Fuente y configuraciónMultilingual E5 technical report, arXiv:2402.05672v1 ↗Informe del editor del modelo

Appendix / detailed MIRACL results / language=es / column=4

Partición de datos
development
Escala de puntuación
0–100 as printed

MIRACL · Recall@100· español

ModeloPuntuaciónDiferencia respecto a la primera filaFuente y configuración
87,6 puntos / 100—
Fuente y configuraciónMultilingual E5 technical report, arXiv:2402.05672v1 ↗Informe del editor del modelo

Appendix / detailed MIRACL results / language=es / column=5

Partición de datos
development
Escala de puntuación
0–100 as printed
88,6 puntos / 1001
Fuente y configuraciónMultilingual E5 technical report, arXiv:2402.05672v1 ↗Informe del editor del modelo

Appendix / detailed MIRACL results / language=es / column=6

Partición de datos
development
Escala de puntuación
0–100 as printed
89,1 puntos / 1001,5
Fuente y configuraciónMultilingual E5 technical report, arXiv:2402.05672v1 ↗Informe del editor del modelo

Appendix / detailed MIRACL results / language=es / column=7

Partición de datos
development
Escala de puntuación
0–100 as printed
89,3 puntos / 1001,7
Fuente y configuraciónMultilingual E5 technical report, arXiv:2402.05672v1 ↗Informe del editor del modelo

Appendix / detailed MIRACL results / language=es / column=8

Partición de datos
development
Escala de puntuación
0–100 as printed

Calidad en evaluaciones publicadas

MIRACL · nDCG@10 · español · / 100

Seleccionar para compararModeloPuntuación y escalaModo / subconjuntoAutor del informeFuente
51,2 / 100—developmentMicrosoft E5 authorsInforme del editor
Condiciones y fuente
MIRACL · nDCG@10: 51,2Informe del editor · Microsoft E5 authors· es
Modelo indicado en el informe
multilingual-e5-small
Prueba / versión
MIRACL
Métrica y unidad
nDCG@10 · score-points-0-100
Idioma
es
Partición de datos
development
Escala de puntuación
0–100 as printed
Fecha de consulta
2026-09-16 (gregoriano)
Multilingual E5 technical report, arXiv:2402.05672v1 · Informe del editor https://arxiv.org/html/2402.05672v1 ↗
Fecha de consulta
2026-09-16
Sección pertinente de la fuente
Appendix / detailed MIRACL results / language=es / column=1
SHA-256
6e288db32f6399019e4d6b5f47105954e046c1a959ab5038f700911f2833e269
Captura del documento
2026-09-16T21:06:05.393094+00:00
51,5 / 100—developmentMicrosoft E5 authorsInforme del editor
Condiciones y fuente
MIRACL · nDCG@10: 51,5Informe del editor · Microsoft E5 authors· es
Modelo indicado en el informe
multilingual-e5-base
Prueba / versión
MIRACL
Métrica y unidad
nDCG@10 · score-points-0-100
Idioma
es
Partición de datos
development
Escala de puntuación
0–100 as printed
Fecha de consulta
2026-09-16 (gregoriano)
Multilingual E5 technical report, arXiv:2402.05672v1 · Informe del editor https://arxiv.org/html/2402.05672v1 ↗
Fecha de consulta
2026-09-16
Sección pertinente de la fuente
Appendix / detailed MIRACL results / language=es / column=2
SHA-256
6e288db32f6399019e4d6b5f47105954e046c1a959ab5038f700911f2833e269
Captura del documento
2026-09-16T21:06:05.393094+00:00
52,9 / 100—developmentMicrosoft E5 authorsInforme del editor
Condiciones y fuente
MIRACL · nDCG@10: 52,9Informe del editor · Microsoft E5 authors· es
Modelo indicado en el informe
multilingual-e5-large
Prueba / versión
MIRACL
Métrica y unidad
nDCG@10 · score-points-0-100
Idioma
es
Partición de datos
development
Escala de puntuación
0–100 as printed
Fecha de consulta
2026-09-16 (gregoriano)
Multilingual E5 technical report, arXiv:2402.05672v1 · Informe del editor https://arxiv.org/html/2402.05672v1 ↗
Fecha de consulta
2026-09-16
Sección pertinente de la fuente
Appendix / detailed MIRACL results / language=es / column=3
SHA-256
6e288db32f6399019e4d6b5f47105954e046c1a959ab5038f700911f2833e269
Captura del documento
2026-09-16T21:06:05.393094+00:00
53,7 / 100—developmentMicrosoft E5 authorsInforme del editor
Condiciones y fuente
MIRACL · nDCG@10: 53,7Informe del editor · Microsoft E5 authors· es
Modelo indicado en el informe
multilingual-e5-large-instruct
Prueba / versión
MIRACL
Métrica y unidad
nDCG@10 · score-points-0-100
Idioma
es
Partición de datos
development
Escala de puntuación
0–100 as printed
Fecha de consulta
2026-09-16 (gregoriano)
Multilingual E5 technical report, arXiv:2402.05672v1 · Informe del editor https://arxiv.org/html/2402.05672v1 ↗
Fecha de consulta
2026-09-16
Sección pertinente de la fuente
Appendix / detailed MIRACL results / language=es / column=4
SHA-256
6e288db32f6399019e4d6b5f47105954e046c1a959ab5038f700911f2833e269
Captura del documento
2026-09-16T21:06:05.393094+00:00
Vista de datos

Modelos pequeños y especializados complementarios

Compara funciones especializadas, límites de entrada, dimensiones y resultados del idioma seleccionado.

Prueba de la columna de resultados: MIRACL · nDCG@10 · es

Esta selección se aplica a las columnas de resultados. Las condiciones figuran en los detalles de cada modelo.

Resultados agrupados por prueba ←
34 resultados de 34 filas
Tipo de modelo
Aplicación
Tamaño declarado del modelo(mil millones)
Filtros avanzados 6 controles
Tipo de evidencia
Todas las filas
Comparación de filas y condiciones

Regla de comparación: La métrica y la unidad deben describir la misma tarea; document/s no se convierte implícitamente en token/s.

Use × junto al encabezado para ocultar una columna. Abra los detalles de la fila para ver fuentes y condiciones.

Columnas ocultas:
Modelos pequeños y especializados
CompararDetalles
Tarea concreta
Tipo / dimensiones de salida
Idiomas y evidencia del idioma seleccionado
Licencia
Resultado del idioma seleccionado
Descarga y puesta en marcha
Página oficial ↗
Recuperación densa, dispersa y multivector aproximadamente 0,569 mil millones 8192 tokens Vector denso de 1024 dimensiones + pesos de tokens + salida multivector multilingual es: Sin evidencia registrada MIT ↗ — 3,81 GiB / un millón de vectores
Página oficial ↗
Reclasificación de pares consulta–documento aproximadamente 0,568 mil millones 8192 tokens Puntuación de relevancia; sigmoid opcional para el intervalo 0–1 multilingual es: Sin evidencia registrada Apache-2.0 ↗ — No almacena vectores fijos
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Recuperación semántica y embeddings de texto aproximadamente 0,6 mil millones 32.768 tokens Vector denso; 1024 dimensiones predeterminadas / máximas multilingual es: Sin evidencia registrada Apache-2.0 ↗ — 3,81 GiB / un millón de vectores
Página oficial ↗
Recuperación semántica y embeddings de texto aproximadamente 4 mil millones 32.768 tokens Vector denso; 2560 dimensiones predeterminadas / máximas multilingual es: Sin evidencia registrada Apache-2.0 ↗ — 9,54 GiB / un millón de vectores
Página oficial ↗
Recuperación semántica y embeddings de texto aproximadamente 8 mil millones 32.768 tokens Vector denso; 4096 dimensiones predeterminadas / máximas multilingual es: Sin evidencia registrada Apache-2.0 ↗ — 15,26 GiB / un millón de vectores
Página oficial ↗
Reclasificación de pares consulta–documento aproximadamente 0,6 mil millones 32.768 tokens Puntuación de relevancia del par de textos; sin salida de embeddings multilingual es: Sin evidencia registrada Apache-2.0 ↗ — No almacena vectores fijos
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Reclasificación de pares consulta–documento aproximadamente 4 mil millones 32.768 tokens Puntuación de relevancia del par de textos; sin salida de embeddings multilingual es: Sin evidencia registrada Apache-2.0 ↗ — No almacena vectores fijos
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Reclasificación de pares consulta–documento aproximadamente 8 mil millones 32.768 tokens Puntuación de relevancia del par de textos; sin salida de embeddings multilingual es: Sin evidencia registrada Apache-2.0 ↗ — No almacena vectores fijos
SAFETENSORS · Oficial ↗GGUF · Tercero ↗
Página oficial ↗
Recuperación y similitud de texto 0,118 mil millones 512 tokens Vector de 384 dimensiones multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh es: Resultado publicado MIT ↗ 1,43 GiB / un millón de vectores
Página oficial ↗
Recuperación y similitud de texto 0,023 mil millones 256 tokens Vector de 384 dimensiones en es: Sin evidencia registrada Apache-2.0 ↗ — 1,43 GiB / un millón de vectores
Página oficial ↗
Recuperación y similitud de texto 0,278 mil millones 512 tokens Vector de 768 dimensiones multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh es: Resultado publicado MIT ↗ 2,86 GiB / un millón de vectores
Página oficial ↗
Recuperación y similitud de texto 0,56 mil millones 512 tokens Vector de 1024 dimensiones multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh es: Resultado publicado MIT ↗ 3,81 GiB / un millón de vectores
Página oficial ↗
Recuperación y similitud de texto 0,033 mil millones 512 tokens Vector de 384 dimensiones en es: Sin evidencia registrada MIT ↗ — 1,43 GiB / un millón de vectores
Página oficial ↗
Reclasificación de resultados de búsqueda 0,278 mil millones 512 tokens Puntuación de relevancia de consulta–documento en, zh es: Sin evidencia registrada MIT ↗ — No almacena vectores fijos
Página oficial ↗
Recuperación y similitud de texto aproximadamente 0,3 mil millones nominales Recuento total de parámetros sin verificar 2048 tokens Vector de 768 dimensiones multilingual es: Sin evidencia registrada gemma ↗ Uso comercial sujeto a licencia — 2,86 GiB / un millón de vectores
Página oficial ↗
Recuperación y similitud de texto aproximadamente 0,57 mil millones nominales Recuento total de parámetros sin verificar 8192 tokens Vector de 1024 dimensiones multilingual, af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh es: Resultado publicado CC-BY-NC-4.0 ↗ Uso comercial sujeto a licencia — 3,81 GiB / un millón de vectores
Página oficial ↗
Reclasificación de resultados de búsqueda 0,278 mil millones 1024 tokens Puntuación de relevancia de consulta–documento multilingual es: Sin evidencia registrada CC-BY-NC-4.0 ↗ Uso comercial sujeto a licencia — No almacena vectores fijos
Página oficial ↗
Recuperación y similitud de texto 0,335 mil millones 512 tokens Vector de 1024 dimensiones en es: Sin evidencia registrada Apache-2.0 ↗ — 3,81 GiB / un millón de vectores
Página oficial ↗
Recuperación y similitud de texto 0,137 mil millones 8192 tokens Vector de 768 dimensiones en es: Sin evidencia registrada Apache-2.0 ↗ — 2,86 GiB / un millón de vectores
Página oficial ↗
Especialización en clasificación y reconocimiento de entidades 0,15 mil millones 8192 tokens Representaciones de tokens; cabeza de tarea tras el entrenamiento en es: Sin evidencia registrada Apache-2.0 ↗ — No almacena vectores fijos
Página oficial ↗
Recuperación y similitud de texto 0,56 mil millones 512 tokens Vector denso af, am, ar, as, az, be, bg, bn, br, bs, ca, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fr, fy, ga, gd, gl, gu, ha, he, hi, hr, hu, hy, id, is, it, ja, jv, ka, kk, km, kn, ko, ku, ky, la, lo, lt, lv, mg, mk, ml, mn, mr, ms, my, ne, nl, no, om, or, pa, pl, ps, pt, ro, ru, sa, sd, si, sk, sl, so, sq, sr, su, sv, sw, ta, te, th, tl, tr, ug, uk, ur, uz, vi, xh, yi, zh es: Resultado publicado mit ↗ 3,81 GiB / un millón de vectores
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperación y similitud de texto 0,123 mil millones 512 tokens Vector denso fa es: Sin evidencia registrada — — 2,86 GiB / un millón de vectores
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperación y similitud de texto 0,353 mil millones 512 tokens Vector denso fa es: Sin evidencia registrada — — 3,81 GiB / un millón de vectores
SAFETENSORS · Oficial ↗
Página oficial ↗
Base para entrenar clasificación y reconocimiento de entidades — 512 tokens Representaciones de tokens; la cabeza de tarea requiere entrenamiento fa es: Sin evidencia registrada — — No almacena vectores fijos
PYTORCH · Oficial ↗
Página oficial ↗
Recuperación de texto, imágenes y vídeo 2 mil millones 32.768 tokens Vector de hasta 2048 dimensiones — es: Sin evidencia registrada Apache-2.0 ↗ — 7,63 GiB / un millón de vectores
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperación de texto, imágenes y vídeo 8 mil millones 32.768 tokens Vector de hasta 4096 dimensiones — es: Sin evidencia registrada Apache-2.0 ↗ — 15,26 GiB / un millón de vectores
SAFETENSORS · Oficial ↗
Página oficial ↗
Reordenador 2 mil millones 32.768 tokens — — es: Sin evidencia registrada Apache-2.0 ↗ — No almacena vectores fijos
SAFETENSORS · Oficial ↗
Página oficial ↗
Reordenador 8 mil millones 32.768 tokens — — es: Sin evidencia registrada Apache-2.0 ↗ — No almacena vectores fijos
SAFETENSORS · Oficial ↗
Página oficial ↗
Embeddings multimodales de texto, imágenes y páginas PDF mixtas — 128.000 tokens 128K declarado por el editor; calidad de contexto largo no medida. Vectores float, int8 o binary; 2048 dimensiones por defecto fa, en, es es: Declaración del editor — — 7,63 GiB / un millón de vectores
Página oficial ↗
Embeddings multimodales de texto, imágenes y páginas PDF mixtas — 128.000 tokens 128K declarado por el editor; calidad de contexto largo no medida. Vectores float, int8 o binary; 2048 dimensiones por defecto fa, en, es es: Declaración del editor — — 7,63 GiB / un millón de vectores
Página oficial ↗
Recuperación de texto, código y medios en un espacio común 0,74 mil millones · aproximadamente 0,27 mil millones Componente de texto; carga independiente 8192 tokens Vectores MRL de 768 dimensiones; reducción a 512, 256 o 128 multilingual es: Sin evidencia registrada Apache-2.0 ↗ — 2,86 GiB / un millón de vectores
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperar documentos de texto o imágenes de páginas con consultas de texto 1,55 mil millones 32.768 tokens Vector de 2048 dimensiones; reducible a 1024 o 512 multilingual, fa es: Sin evidencia registrada OpenMDW-1.1 ↗ — 7,63 GiB / un millón de vectores
SAFETENSORS · Oficial ↗
Página oficial ↗
Recuperar documentos de texto o imágenes de páginas con consultas de texto 8,38 mil millones 32.768 tokens Vector de 4096 dimensiones; reducible a 1024 o 512 multilingual, fa es: Sin evidencia registrada OpenMDW-1.1 ↗ — 15,26 GiB / un millón de vectores
SAFETENSORS · Oficial ↗
Página oficial ↗
Reordenación de documentos en RAG y Vision RAG 8,38 mil millones 32.768 tokens Logit bruto de relevancia por par consulta/documento; sin vector persistente multilingual, fa, en, es es: Declaración del editor OpenMDW-1.1 ↗ — No almacena vectores fijos
SAFETENSORS · Oficial ↗

«—» indica que no hay información registrada; no significa que el modelo carezca de esa capacidad.

Artículos de la guía

Selección de modelos, memoria, software de ejecución y evaluación de calidad.

Volver a las tablas ↑
14 min

¿Qué tamaño de modelo de lenguaje necesita realmente tu tarea?

Cómo elegir entre modelos especializados, generadores pequeños y LLM grandes separando calidad, idioma, recuperación, memoria y capacidad de servicio, con comparaciones publicadas y un ejemplo de cálculo.

Leer el artículo independiente ↗
19 min

RAG, CAG, KAG, fine-tuning e instruction tuning: ¿en qué se diferencian y cuál elegir?

Cuando un modelo no responde bien, ¿necesita más entrenamiento o simplemente acceso a la información adecuada? Mediante ejemplos sencillos, este artículo compara RAG, CAG y KAG con el fine-tuning y el instruction tuning: recuperar documentos, almacenar cálculos en caché, razonar sobre relaciones y cambiar el comportamiento del modelo. Una tabla comparativa y varios escenarios prácticos ayudan a distinguir la falta de conocimiento de un comportamiento inadecuado antes de invertir en entrenamiento, y a elegir el método o la combinación que necesita el proyecto.

Leer el artículo independiente ↗
13 min

Cómo elegir el generador, el modelo embedding y el reranker para RAG empresarial

Una cadena de tres componentes para asistentes documentales: candidatos pequeños, calidad de recuperación, presupuestos de vectores y KV, preparación de documentos y diagnóstico de errores.

Leer el artículo independiente ↗
12 min

Autocompletado, asistentes y agentes de programación: tres criterios de elección

Modelos según su función: sugerencias FIM rápidas, correcciones guiadas correctas o tareas de repositorio aceptadas. Candidatos, alcance de benchmarks, entorno de herramientas y coste por tarea.

Leer el artículo independiente ↗
13 min

AirLLM y la inferencia por capas: modelos grandes, poca VRAM y el coste de esperar

Dónde residen los pesos, cómo limita la transferencia a la generación, por qué sigue importando KV y qué trabajos de investigación, lotes y adaptación pueden aprovechar la ejecución por capas.

Leer el artículo independiente ↗
14 min

Ollama, vLLM, SGLang o llama.cpp: cómo elegir el motor de inferencia

Cómo cambian la elección la planificación, la caché KV, los formatos y el control operativo: comparación de cuatro motores con un cálculo de memoria y un método reproducible.

Leer el artículo independiente ↗
14 min

Por qué la GPU más rápida no siempre ofrece la respuesta más rápida

Más capacidad de cálculo y una mayor tasa de tokens no siempre se traducen en una respuesta más rápida. Analizamos el tiempo hasta el primer token y hasta completar la respuesta, la memoria, la concurrencia, el reparto entre GPU y LPU y el coste de comunicación para elegir infraestructura según la capacidad de atender solicitudes con la calidad y latencia necesarias.

Leer el artículo independiente ↗
14 min

De un usuario al servicio empresarial: cuándo cambiar el modelo, las réplicas o la GPU

Diagnóstico separado de colas, memoria y disponibilidad, con ejemplos de capacidad tras fallos y ampliación temporal que preservan calidad y tiempo de respuesta.

Leer el artículo independiente ↗
18 min

¿Qué significan 100 usuarios simultáneos en un asistente de IA?

El número de usuarios no define por sí solo la capacidad de un asistente. Ejemplos y una herramienta interactiva relacionan las tasas de solicitud, los tokens, las colas y la caché KV con la elección de GPU y las pruebas de aceptación.

Leer el artículo independiente ↗