امنیت زیرساخت

امنیت و حاکمیت لینوکس سازمانی

از مدل تهدید و انتخاب توزیع تا محیط ایزوله، کانتینر، GPU، استاندارد و Legacy

هستهٔ محاسباتی محافظت‌شده در لایه‌های جدا و کنترل‌شده
دربارهٔ این مجموعه

امنیت لینوکس محصول یک تنظیم جادویی یا چک‌لیست واحد نیست؛ از شناخت کاربری و تهدید آغاز می‌شود و به انتخاب زیست‌بوم، کنترل تغییر، مرزهای کانتینر، امنیت GPU، انطباق و ادارهٔ ریسک سامانه‌های قدیمی می‌رسد.

۱

یک سیاست ایمن‌سازی برای همهٔ لینوکس‌ها وجود ندارد

چرا نوع کاربری، سطح مواجهه و مأموریت باید پیش از انتخاب پروفایل سخت‌سازی مشخص شود.

مطالعهٔ فصل: یک سیاست ایمن‌سازی برای همهٔ لینوکس‌ها وجود ندارد

در سازمان‌های بزرگ، سامانه‌های مبتنی بر لینوکس کارکردهای متنوعی دارند و هر کدام در برابر مجموعه‌ای متفاوت از تهدیدها قرار می‌گیرند. از ایستگاه کاری متصل به اینترنت تا سرور کاملاً ایزوله، از میزبان کانتینر تا زیرساخت هوش مصنوعی و از سامانهٔ صنعتی تا مخزن پشتیبان، نمی‌توان یک سطح سخت‌گیری، یک مدل به‌روزرسانی و یک نسخهٔ واحد برای ایمن‌سازی تجویز کرد.

اعمال یک سیاست یکنواخت نه عملی است و نه الزاماً امن. چنین سیاستی یا در کاربری‌های پرریسک به اندازهٔ کافی سخت‌گیر نیست، یا پایداری و قابلیت بهره‌برداری سامانه‌های دیگر را مختل می‌کند. رویکرد درست آن است که ابتدا سامانه‌ها بر اساس نوع کاربری و سطح مواجهه دسته‌بندی شوند و سپس پروفایل متناسب با هر دسته انتخاب شود؛ پروفایلی که میان امنیت، عملکرد، پایداری و قابلیت نگهداری تعادل برقرار کند.

خط پایهٔ مشترک، پروفایل‌های متفاوت

استانداردهای معتبر نیز امنیت را یک تنظیم ثابت نمی‌بینند. CIS Benchmarks میان Server و Workstation تفکیک قائل می‌شود و برای هر یک پروفایل‌های سطح یک و دو ارائه می‌دهد. DISA STIG سخت‌گیری را با اهمیت مأموریت و سطح دسترسی اطلاعات پیوند می‌زند. چارچوب‌های NIST نیز بر اصولی مانند دفاع در عمق، کمترین دسترسی و معماری بدون اعتماد تأکید دارند، اما اجرای این اصول در همهٔ محیط‌ها شکل یکسانی ندارد.

در تمام سامانه‌ها حداقلی مشترک لازم است: به‌روزرسانی برنامه‌ریزی‌شده، ثبت و نگهداری لاگ قابل ممیزی، پایش امنیتی، مدیریت دسترسی و آمادگی برای پاسخ به رخداد. این حداقل، جایگزین کنترل‌های متناسب با ریسک هر کاربری نیست. خط پایه می‌گوید چه چیزهایی نباید حذف شوند؛ پروفایل کاربری می‌گوید هر کنترل با چه شدت و چه سازوکار عملیاتی اجرا شود.

ده کاربری که نباید یکسان دیده شوند

نوع سامانهتهدید غالبجهت‌گیری اصلی ایمن‌سازی
ایستگاه کاری عمومی متصل به اینترنتفیشینگ، بدافزار، اجرای کد مخرب و خطای کاربرمحدودسازی اختیار کاربر، کنترل نرم‌افزار اجرایی، سخت‌سازی مرورگر، کنترل USB و به‌روزرسانی متمرکز
سرور عمومی متصل به اینترنتبهره‌برداری هدفمند، دسترسی غیرمجاز و ماندگاری مهاجمنصب حداقلی، حذف سرویس‌های غیرضروری، فایروال سخت‌گیرانه، دسترسی مدیریتی محدود و پایش مستمر
سرور توسعه، آموزش یا CI/CD/CTزنجیرهٔ تأمین، اجرای کد دریافت‌شده و افشای کلیدهااعتبارسنجی منابع، محیط اجرای جدا، مدیریت اسرار، کمترین دسترسی و ممیزی دقیق اجرای کد
سامانهٔ کاملاً ایزولهدسترسی فیزیکی، رسانهٔ قابل حمل، تهدید داخلی و وصله‌نشدنامنیت فیزیکی، زنجیرهٔ بوت، کنترل رسانه، اصالت‌سنجی بسته و پایش آفلاین
سرور شبکهٔ داخلیحرکت جانبی و سوءاستفاده از اعتماد داخلیتفکیک شبکه، RBAC، پایش رفتار داخلی و حذف اعتماد پیش‌فرض به شبکهٔ سازمان
میزبان کانتینرشکست جداسازی، آسیب‌پذیری کرنل و دسترسی ممتاز runtimeسخت‌سازی میزبان، سیاست‌های LSM و seccomp، حداقل‌سازی میزبان و کنترل دسترسی runtime
زیرساخت هوش مصنوعی و GPUنشت داده، سرقت مدل، سوءاستفادهٔ محاسباتی و ناسازگاری درایورتثبیت و ممیزی پشتهٔ کرنل/درایور، جداسازی بار کاری و کنترل داده، مدل و GPU
کنترل‌پلین و نودهای ابر خصوصیتصاحب سطح مدیریتی و سرایت گستردهٔ خطاRBAC سخت‌گیرانه، حفاظت از دادهٔ پیکربندی، جداسازی namespace و اعمال خودکار سیاست
سامانهٔ صنعتی و عملیاتیتوقف مأموریت، آسیب فیزیکی و محدودیت شدید در به‌روزرسانیپایداری مأموریت، whitelist، کنترل فیزیکی و تغییر فقط در پنجره‌های تعمیراتی آزموده‌شده
پشتیبان‌گیری و بازیابیباج‌افزار، حذف یا رمزگذاری نسخه‌های پشتیبانجداسازی شبکه، دسترسی نوشتن محدود، ذخیره‌سازی تغییرناپذیر و در صورت امکان Air Gap واقعی

این جدول نسخهٔ نهایی سیاست نیست؛ نقشه‌ای برای جلوگیری از اشتباه رایج «یک نسخه برای همه» است. برای نمونه، سرور SIEM یا سامانهٔ مدیریت هویت اگرچه در شبکهٔ داخلی است، به دلیل دسترسی و نقش سراسری ممکن است به سخت‌گیری بیشتر از یک وب‌سرور مرزی نیاز داشته باشد. به همین ترتیب، محیط staging باید با محیط تولید متناظر هم‌راستا باشد، اما می‌تواند برای آزمون تغییرات، ریسک بیشتری را به‌صورت آگاهانه و محدود بپذیرد.

ایزوله‌بودن مترادف امن‌بودن نیست

در سامانهٔ کاملاً ایزوله، مواجههٔ شبکه‌ای پایین است، اما تهدید حذف نشده؛ فقط شکل و مسیر آن تغییر کرده است. رسانهٔ قابل حمل آلوده، لپ‌تاپ مهندسی، دستکاری فیزیکی، زنجیرهٔ تأمین یا خطای یک کاربر ممتاز می‌تواند همان نقشی را بازی کند که در محیط متصل، اینترنت ایفا می‌کند. خطر مهم‌تر، حس کاذب امنیت است؛ حسی که به تعویق وصله، کاهش ممیزی لاگ و سستی در کنترل تغییر منجر می‌شود.

به همین دلیل، محیط آفلاین باید در بعضی حوزه‌ها سخت‌گیرتر از محیط متصل باشد. در چنین محیطی، ورود هر بسته یک رویداد حاکمیتی است، منشأ هر تغییر باید قابل اثبات باشد و مسیر بازیابی باید پیش از شکست طراحی شده باشد. جزئیات این نگاه در مقالهٔ آفلاین‌بودن، امنیت نیست؛ مرز اعتماد را جابه‌جا می‌کند آمده است.

کانتینر و هوش مصنوعی، دو استثنای ظاهری نیستند

میزبان کانتینر یک سرور همه‌منظوره نیست؛ غلاف امنیتی پیرامون مجموعه‌ای از بارهای کاری است. کانتینرها کرنل میزبان را به اشتراک می‌گذارند و اتکا به جداسازی کانتینری بدون سخت‌سازی میزبان، خطایی پرریسک است. سامانهٔ CI/CD که به‌صورت کانتینری اجرا می‌شود نیز به دلیل دریافت و اجرای مداوم کد، باید یک دارایی پرریسک در نظر گرفته شود، حتی اگر خودش دادهٔ محرمانه نگه ندارد.

زیرساخت هوش مصنوعی نیز فقط نسخهٔ پرقدرت‌تر یک سرور معمولی نیست. وابستگی به GPU، درایور، کتابخانه‌های سطح پایین و runtime کانتینری، آن را در نقطهٔ تنش میان ثبات و تغییر قرار می‌دهد. از یک سو تکرارپذیری مدل به محیط پایدار نیاز دارد و از سوی دیگر، آسیب‌پذیری‌های کرنل، درایور و کتابخانه‌ها الزام به به‌روزرسانی ایجاد می‌کنند. به همین علت امنیت زیرساخت هوش مصنوعی از کرنل و GPU آغاز می‌شود، اما در همان‌جا پایان نمی‌یابد.

مدل تهدید پیش از پروفایل سخت‌سازی

مدل تهدید و مسیرهای حمله به زیرساخت لینوکسی در محیط‌های با کاربری متفاوت
سخت‌سازی زمانی معنا دارد که دارایی، مهاجم، مسیر حمله و پیامد مأموریتی پیش از آن روشن شده باشند.

مدل تهدید با محیط تغییر می‌کند. در IT، محرمانگی و یکپارچگی اطلاعات معمولاً در مرکز قرار دارند. در OT و سامانه‌های صنعتی، در دسترس بودن و پایداری ممکن است بر محرمانگی تقدم پیدا کند؛ زیرا یک توقف کوتاه می‌تواند خسارت فیزیکی یا اختلال عملیاتی ایجاد کند. در هوش مصنوعی، داده، مدل و منابع محاسباتی هر سه دارایی‌اند و حمله ممکن است بدون نشانه‌های کلاسیک نفوذ، از طریق دستکاری داده یا سوءاستفاده از خروجی رخ دهد.

تهدید داخلی نیز در هر سه محیط جدی است. حساب‌های ممتاز دائمی، استفادهٔ کنترل‌نشده از root، پیکربندی نادرست sudo و نبود ممیزی رفتار مدیران می‌تواند یک اشتباه یا سوءنیت محدود را به بحران سراسری تبدیل کند. زنجیرهٔ تأمین نیز صرفاً ریسک مخزن عمومی نیست؛ هر بسته، firmware، image و به‌روزرسانی باید منشأ و مسیر ورود مشخص داشته باشد.

ریسک قابل پذیرش باید صاحب داشته باشد

امنیت مطلق دست‌یافتنی نیست. هدف، افزایش هزینهٔ نفوذ، کاهش زمان کشف، محدودکردن دامنهٔ خسارت و حفظ مأموریت است. مدیران باید میان ریسکی که برای ادامهٔ عملیات ناگزیر به پذیرش آن هستند و ریسکی که بقای سامانه یا سازمان را تهدید می‌کند تمایز بگذارند.

این تمایز زمانی واقعی است که شفاف، مستند و قابل بازبینی باشد. سخت‌سازی نباید صرفاً به تیم فنی واگذار شود تا میان اختلال و امنیت یکی را انتخاب کند. سازمان باید تعیین کند چه کسی می‌تواند استثنا بدهد، چه کسی پیامد آن را می‌پذیرد و چه زمانی تصمیم دوباره ارزیابی می‌شود. همین نقطه است که ایمن‌سازی سیستم‌عامل را از یک فهرست تنظیمات به مسئله‌ای حاکمیتی تبدیل می‌کند.

نتیجه ساده است: پیش از پرسیدن «کدام توزیع امن‌تر است؟» باید پرسید «این سامانه چه مأموریتی دارد، در معرض چه تهدیدی است و شکست آن چه اثری می‌گذارد؟» پاسخ این سه پرسش، مسیر انتخاب توزیع به‌عنوان یک تصمیم امنیتی و حاکمیتی را نیز روشن می‌کند.

بازکردن مقاله در تب جدید
۲

انتخاب توزیع لینوکس، یک تصمیم امنیتی و حاکمیتی است

انتخاب چرخهٔ تغییر، زنجیرهٔ تصمیم، مدل اعتماد و هزینهٔ بازگشت؛ نه فقط مجموعه‌ای از بسته‌ها.

مطالعهٔ فصل: انتخاب توزیع لینوکس، یک تصمیم امنیتی و حاکمیتی است

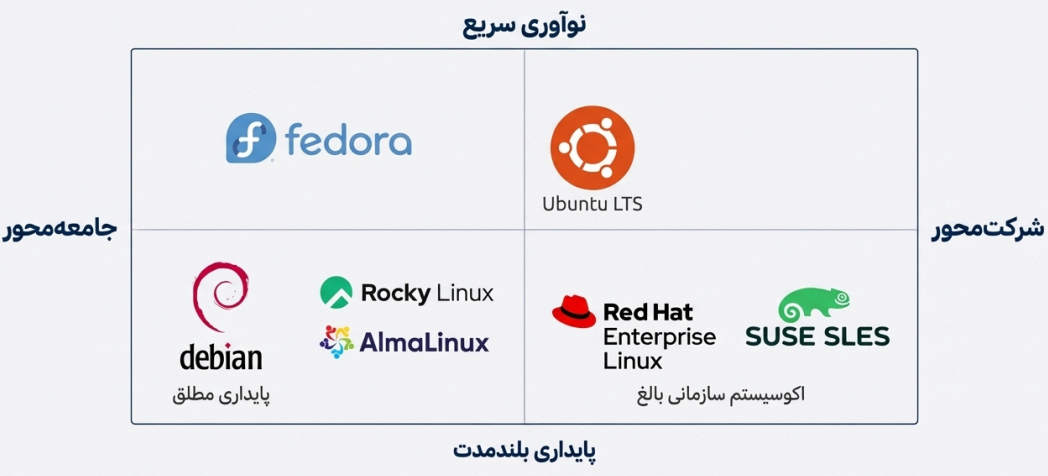
تنوع توزیع‌ها یکی از نقاط قوت راهبردی لینوکس است. همین تنوع اجازه می‌دهد از ایستگاه کاری عمومی تا زیرساخت حیاتی، محیط کاملاً ایزوله و سامانهٔ هوش مصنوعی، انتخاب‌های متفاوتی داشته باشند. اما اگر سازمان راهبرد انتخاب و حاکمیت متمرکز نداشته باشد، این مزیت به ناهمگونی امنیتی، پیچیدگی عملیاتی و خطای پیکربندی تبدیل می‌شود.

همهٔ توزیع‌ها از کرنل لینوکس استفاده می‌کنند، اما مدل انتشار، چرخهٔ پشتیبانی، روش مدیریت بسته، ابزارهای تغییر، سیاست سخت‌سازی و زنجیرهٔ تصمیم یکسانی ندارند. در مقیاس سازمانی، انتخاب توزیع در حقیقت انتخاب یک «مدل حاکمیت بر ریسک» است.

چند توزیع لینوکس درون یک مرز امنیتی و حاکمیتی مشترک
تعدد بی‌قاعدهٔ توزیع‌ها آزادی ایجاد نمی‌کند؛ شکاف در وصله‌گذاری، مهارت و پاسخ‌گویی ایجاد می‌کند.

امنیت توزیع، محصول نسخهٔ کرنل نیست

در نگاه غیرتخصصی، تفاوت توزیع‌ها به مدیر بسته، ظاهر یا نسخهٔ نرم‌افزار تقلیل داده می‌شود. در زیرساخت حساس، پرسش‌های مهم‌تر چیز دیگری‌اند:

  • بسته از کجا می‌آید و اصالت آن چگونه اثبات می‌شود؟
  • وصلهٔ امنیتی چه زمانی و با چه تعهدی ارائه می‌شود؟
  • آیا می‌توان پچ امنیتی را بدون تغییر رفتاری گسترده دریافت کرد؟
  • تغییر چگونه آزموده، ممیزی و بازگردانده می‌شود؟
  • ابزارهای مدیریت در شبکهٔ ایزوله نیز کامل کار می‌کنند یا به سرویس خارجی وابسته‌اند؟
  • سازمان در بحران تا چه اندازه می‌تواند بدون تصمیم یا کلید یک بازیگر بیرونی ادامه دهد؟

در این چارچوب، محبوبیت جهانی یا دسترسی سریع به جدیدترین قابلیت‌ها معیار کافی نیست. برای سامانه‌ای که باید سال‌ها پایدار بماند، پیش‌بینی‌پذیری، قابلیت ممیزی، پشتیبانی بلندمدت و امکان اعمال کنترل‌شدهٔ پچ ممکن است از تازگی نسخه مهم‌تر باشند.

پنج لایهٔ تصمیم

۱. زنجیرهٔ تأمین و منشأ اعتماد

هر توزیع روشی برای تولید، امضا، انتشار و اصلاح بسته‌ها دارد. سازمان باید بداند چه نهادی بسته را تولید می‌کند، کلید امضا دست چه کسی است، آسیب‌پذیری چگونه به وصله تبدیل می‌شود و در صورت قطع دسترسی، چه بخشی از زنجیره را می‌تواند درون خود بازسازی کند.

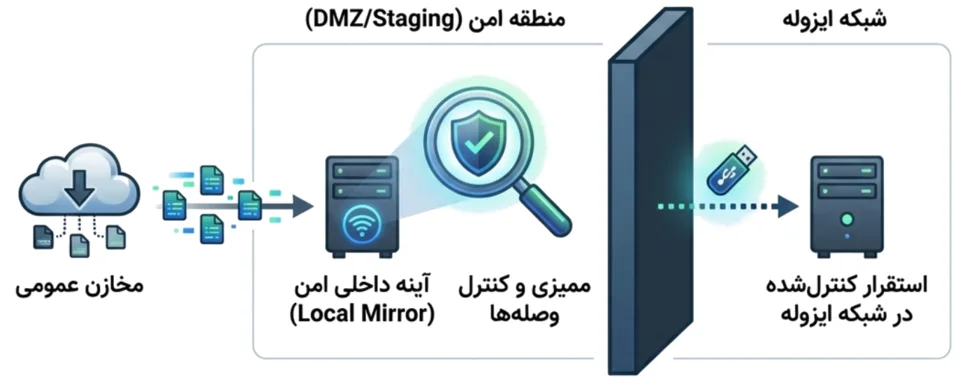
مخزن داخلی صرفاً یک cache نیست. در محیط حساس، مخزن داخلی مرجع رسمی تغییر است: بسته از بیرون وارد ناحیهٔ دریافت می‌شود، اصالت و وابستگی آن بررسی می‌گردد، در staging آزموده می‌شود و فقط پس از تأیید به مخزن عملیاتی راه پیدا می‌کند. توزیعی که این چرخه را شفاف، تکرارپذیر و قابل ممیزی می‌کند، بخشی از ریسک را در معماری مهار می‌کند؛ توزیعی که صرفاً ابزار خام می‌دهد، این ریسک را به فرآیند و مهارت تیم منتقل می‌سازد.

۲. جداسازی امنیت از تغییر قابلیت

یکی از دلایل اصلی نصب‌نشدن وصله‌ها، ترس از شکستن سرویس است. توزیع‌های سازمانی معمولاً با backporting تلاش می‌کنند اصلاح امنیتی را بدون تغییر نسخهٔ اصلی و رفتار عمومی نرم‌افزار ارائه دهند. این راهبرد برای حفظ پایداری مهم است، اما نباید بهانه‌ای برای تعویق نامحدود ارتقای اصلی باشد. طولانی‌شدن بیش از حد این فاصله، بدهی فنی و امنیتی ایجاد می‌کند.

تفاوت کلیدی این است که سازمان بتواند میان سه چیز تفکیک قائل شود: وصلهٔ حیاتی، اصلاح خطا و قابلیت جدید. اگر هر سه در یک جریان تغییر وارد شوند، هر به‌روزرسانی به یک پروژهٔ پرریسک تبدیل می‌شود و تیم در نهایت همهٔ تغییرها را عقب می‌اندازد.

۳. طول عمر رسمی در برابر طول عمر عملی

عدد پشتیبانی روی کاغذ فقط بخشی از واقعیت است. طول عمر عملی یعنی تا چه زمانی سازمان می‌تواند همان سامانه را با سخت‌افزار، درایور، ابزار مدیریتی، مخزن داخلی و نیروی انسانی موجود واقعاً اداره کند.

ممکن است یک نسخه هنوز پشتیبانی شود، اما درایور GPU یا کارت شبکهٔ لازم با آن سازگار نباشد. ممکن است وصله وجود داشته باشد، اما انتقال امن آن به محیط ایزوله، آزمون و بازگشت از شکست برای سازمان ممکن نباشد. ممکن است مستندات کامل باشند، اما دانش اجرای آن فقط در اختیار یک نفر قرار گرفته باشد. در همهٔ این حالت‌ها، طول عمر رسمی ادامه دارد ولی طول عمر عملی پایان یافته است.

۴. مدیریت متمرکز و ظرفیت انسانی

توزیعی که در مقیاس صدها یا هزاران میزبان، ابزار مدیریت پیکربندی، وصله‌گذاری، ممیزی و گزارش وضعیت نداشته باشد، عملاً قابل ایمن‌سازی یکنواخت نیست. با این حال، وجود ابزار هم کافی نیست. ابزار پیچیده‌ای که تیم آن را نمی‌فهمد، خود یک سطح حمله و منشأ خطای انسانی است.

انتخاب توزیع باید با ظرفیت واقعی تیم هم‌راستا باشد: منحنی یادگیری، کیفیت مستندات، امکان انتقال دانش، دسترس‌پذیری متخصص و میزان وابستگی به حافظهٔ افراد. امنیتی که فقط با حضور دو کارشناس خاص حفظ می‌شود، امنیت سازمانی نیست.

۵. بازگشت‌پذیری و هزینهٔ اشتباه

خطرناک‌ترین لحظهٔ سیستم‌عامل، زمان تغییر است. یک انتخاب بالغ فقط احتمال شکست را کم نمی‌کند؛ هزینهٔ شکست و مسیر بازگشت را نیز روشن می‌سازد. Snapshot، به‌روزرسانی اتمیک و وضعیت اعلامی می‌توانند بخشی از این ریسک را در سامانه مهار کنند. در مدل‌های دیگر، همان نتیجه ممکن است با فرآیند، تست و انضباط انسانی به دست آید. تفاوت در این است که ریسک در کجا نگهداری می‌شود: معماری، فرآیند یا انسان.

زنجیرهٔ تصمیم واقعی را ببینیم

نقشهٔ ارتباط توزیع‌های اصلی لینوکس و جایگاه چرخه‌های بالادستی و پایین‌دستی
نام تجاری توزیع کافی نیست؛ باید دانست تصمیم امنیتی در کدام نقطه از زیست‌بوم گرفته و به چه کسانی تحمیل می‌شود.

در ارزیابی حاکمیتی باید پرسید تصمیم‌گیر واقعی کیست. چه نهادی مسیر نسخه، دسترسی به کد، سیاست بسته‌ها و پایان پشتیبانی را تعیین می‌کند؟ جامعه تا چه اندازه می‌تواند قدرت نهادی را تعدیل کند؟ امکان انشعاب فنی وجود دارد، اما هزینهٔ واقعی حفظ یک fork چقدر است؟

متن‌بازبودن به‌تنهایی به معنای استقلال عملیاتی نیست. اگر سازمان نتواند کد را بسازد، بسته را امضا کند، مخزن را نگه دارد و دانش لازم را حفظ کند، حق نظری انشعاب در بحران ارزش محدودی دارد. از سوی دیگر، تجاری‌بودن نیز لزوماً به معنای قفل‌شدگی نیست؛ گاهی قرارداد، SLA و ابزارهای رسمی ریسک را کاهش می‌دهند. مسئله این است که سازمان بداند چه وابستگی‌ای می‌خرد و در برابر آن چه تضمینی دریافت می‌کند.

«قابل‌مالکیت بودن» یعنی چه؟

قابل‌مالکیت بودن یک توزیع به معنای ثبت مالکیت حقوقی بر آن نیست. منظور این است که سازمان بتواند چرخهٔ عملیاتی خود را بدون اتصال دائم به بیرون اداره کند:

  • آینهٔ داخلی کامل و قابل بازسازی داشته باشد؛
  • کلیدها و سیاست امضای سازمانی را کنترل کند؛
  • image و گونهٔ سازمانی آزموده‌شده بسازد؛
  • سخت‌سازی، استثناها و تغییرها را نسخه‌گذاری کند؛
  • وضعیت هر میزبان را با مرجع مصوب مقایسه کند؛
  • و در بحران، بدون تصمیم لحظه‌ای یک تأمین‌کنندهٔ خارجی، سامانه را بازیابی کند.

این سطح از مالکیت هزینه دارد. سازمانی که حاضر نیست مخزن، کلید، دانش و فرآیند را اداره کند، نباید استقلال را صرفاً با انتخاب یک توزیع جامعه‌محور مفروض بگیرد.

انتخاب را روی کاغذ نهایی نکنید

مقایسهٔ جدولی توزیع‌ها می‌تواند میدان انتخاب را محدود کند، اما تصمیم باید در محیط واقعی اعتبارسنجی شود. آزمایش‌های مفید، عمداً بدبینانه‌اند:

  1. یک به‌روزرسانی واقعی را از دریافت تا تأیید و استقرار اجرا کنید.
  2. شکست بوت، سرویس حیاتی یا درایور سخت‌افزاری را شبیه‌سازی کنید.
  3. یک انحراف کوچک در پیکربندی ایجاد کنید و توان تشخیص و اصلاح آن را بسنجید.
  4. عملیات حساس را به تیم واگذار کنید و ببینید موفقیت به معماری متکی است یا حافظهٔ یک فرد.
  5. دسترسی خارجی را قطع کنید و چرخهٔ وصله، مستندات و بازیابی را دوباره آزمایش کنید.

انتخاب درست لزوماً انتخاب بدون مشکل نیست. انتخاب درست، مشکل را زود، شفاف و قابل توضیح آشکار می‌کند. تیم باید بداند چه اتفاقی افتاده، مسیر بازگشت کجاست و چه کسی در وضعیت شکست تصمیم می‌گیرد.

نشانه‌های خطر نیز مستقل از نام توزیع‌اند: افزایش کارهای دستی مستندنشده، انباشت استثناها، وابستگی به یک یا دو نفر، ترس از تغییر به دلیل ناشناخته‌بودن پیامد و توجیه مداوم مشکلات با عباراتی مانند «فعلاً» یا «ذات لینوکس است».

بنابراین پرسش نهایی «کدام توزیع بهتر است؟» نیست. پرسش درست این است: کدام زیست‌بوم با کاربری و مدل تهدید سازمان، ظرفیت تیم، مرز اعتماد، مدل تغییر و توان زندگی‌کردن با پیامدهای انتخاب سازگارتر است؟

بازکردن مقاله در تب جدید
۳

آفلاین‌بودن، امنیت نیست؛ مرز اعتماد را جابه‌جا می‌کند

ریشهٔ اعتماد، TPM، بوت امن، بوت اندازه‌گیری‌شده و مسیر کنترل‌شدهٔ ورود وصله‌ها.

مطالعهٔ فصل: آفلاین‌بودن، امنیت نیست؛ مرز اعتماد را جابه‌جا می‌کند

نبود اتصال مستقیم به اینترنت، یک کنترل امنیتی مهم است؛ اما اگر آن را معادل امنیت بدانیم، به خطرناک‌ترین نقطهٔ معماری تبدیل می‌شود. در محیط ایزوله، تهدید حذف نمی‌شود؛ مسیر ورود، نقطهٔ اعتماد و هزینهٔ واکنش تغییر می‌کند.

رسانهٔ قابل حمل، لپ‌تاپ مهندسی، زنجیرهٔ تأمین، firmware، دسترسی فیزیکی، فرآیند بوت و بستهٔ به‌روزرسانی، همگی می‌توانند نقش دروازهٔ بیرونی را بازی کنند. از آن مهم‌تر، محیط آفلاین معمولاً امکان پایش برخط، واکنش فوری و دریافت سریع اصلاحات را ندارد. بنابراین همان کنترلی که سطح مواجههٔ شبکه‌ای را کم می‌کند، اگر با معماری اعتماد و تغییر همراه نشود، می‌تواند زمان ماندگاری تهدید را افزایش دهد.

فرض تهدید در محیط ایزوله متفاوت است

بسیاری از فرض‌های رایج امنیت سازمانی در این محیط وجود ندارند. اتصال دائمی، SIEM مرکزی برخط، واکنش سریع تیم بیرونی یا نصب فوری وصله ممکن نیست. در مقابل، سناریوهایی اهمیت بیشتری پیدا می‌کنند که در محیط ابری یا مرکز دادهٔ عمومی کمتر دیده می‌شوند.

نخست، دسترسی فیزیکی محدود اما معنادار است. مهاجم شاید نتواند ساعت‌ها با سامانه کار کند، اما ممکن است قطعه‌ای را تعویض کند، از رسانهٔ جانبی بوت کند یا ذخیره‌ساز را خارج سازد. اگر حفاظت فقط پس از بوت آغاز شود، این کنترل‌ها دیر وارد میدان شده‌اند.

دوم، آلودگی می‌تواند پیش از بهره‌برداری شکل گرفته باشد: در firmware، بوت‌لودر، image اولیه یا فرآیند آماده‌سازی. در محیطی که تغییرها دیر و با فاصله اعمال می‌شوند، چنین آلودگی‌ای می‌تواند مدت طولانی پنهان بماند.

سوم، تصمیم عملیاتی پس از کشف رخداد الزاماً توقف فوری نیست. مأموریت، ایمنی فیزیکی یا تداوم سرویس ممکن است اجازهٔ خاموش‌کردن سامانه را ندهد. در اینجا امنیت باید علاوه بر پیشگیری، «آگاهی قابل اثبات از وضعیت» فراهم کند تا مدیر بداند سامانه در چه وضعی است و با چه ریسکی ادامه می‌دهد.

اعتماد باید پایین‌تر از سیستم‌عامل آغاز شود

یک پرسش ساده تعیین‌کننده است: نخستین چیزی که به آن اعتماد می‌کنیم چیست؟ اگر پاسخ «سیستم‌عامل» باشد، زنجیرهٔ پیش از آن نادیده گرفته شده است. سیستم‌عامل محصول firmware، UEFI، بوت‌لودر، کرنل، initramfs و درایورهاست. آلودگی هر حلقه، اعتماد به لایه‌های بالاتر را بی‌معنا می‌کند.

ریشهٔ اعتماد باید کوچک، محدود، قابل اندازه‌گیری و تا حد ممکن خارج از دسترس مهاجم نرم‌افزاری باشد. این ریشه نباید با دسترسی root قابل بازنویسی باشد و نباید سلامت خود را از همان سیستم‌عاملی بگیرد که قرار است ارزیابی کند.

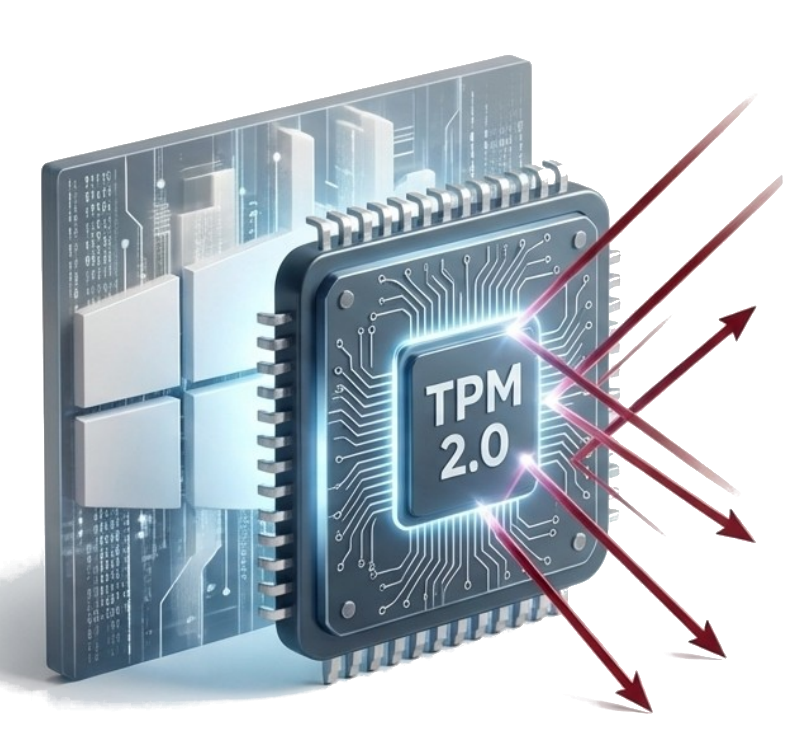
تراشه TPM به‌عنوان ریشهٔ سخت‌افزاری اعتماد برای کلیدها و اندازه‌گیری وضعیت بوت
TPM می‌تواند کلید را از سیستم‌عامل جدا کند، اما فقط زمانی مفید است که سیاست کلید و بازیابی در اختیار سازمان باشد.

TPM 2.0 می‌تواند کلیدهای غیرقابل استخراج تولید و نگهداری کند، عملیات رمزنگاری را درون تراشه انجام دهد و اندازه‌گیری مراحل بوت را در ثبات‌های PCR ثبت کند. حتی اگر مهاجم به root برسد، نباید بتواند کلید خصوصی را خام استخراج یا سابقهٔ اندازه‌گیری مراحل قبلی را پاک کند.

اما ریشهٔ اعتماد شمشیر دولبه است. اگر کلید، سیاست و مسیر recovery به‌درستی طراحی نشده باشند، همان کنترل امنیتی می‌تواند سامانه را پس از یک به‌روزرسانی یا خرابی سخت‌افزاری قفل کند. مسئله فقط فعال‌کردن TPM نیست؛ مسئله این است که چه کسی کلیدها را کنترل می‌کند، چه کسی مجاز به تغییر سیاست است و اگر همه‌چیز طبق انتظار پیش نرفت، چه کسی هنوز اختیار بازیابی دارد.

بوت امن و بوت اندازه‌گیری‌شده یک چیز نیستند

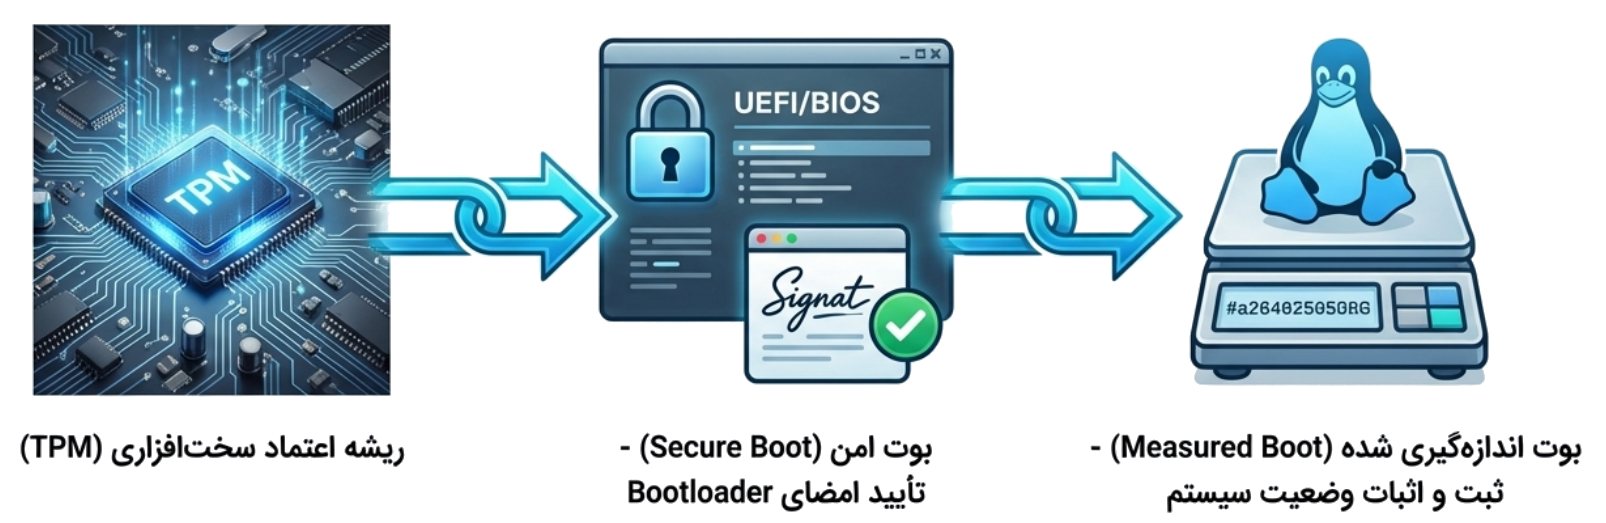
بوت امن در سطح UEFI اجازه می‌دهد فقط مؤلفه‌های دارای امضای معتبر، از بوت‌لودر تا کرنل، اجرا شوند. اگر امضا معتبر نباشد، فرآیند متوقف می‌شود. این کنترل پیشگیرانه است: جزء ناشناخته نباید اجرا شود.

بوت اندازه‌گیری‌شده هر مرحله را پیش از اجرا هش می‌کند و نتیجه را در TPM ثبت می‌نماید. این کنترل به‌جای توقف الزامی، شواهد تولید می‌کند: سامانه نشان می‌دهد واقعاً با چه firmware، بوت‌لودر و کرنلی بالا آمده است. این شواهد می‌توانند با وضعیت طلایی مقایسه یا برای آزادسازی مشروط کلید دیسک استفاده شوند.

زنجیرهٔ اعتماد از TPM و UEFI تا Secure Boot، Measured Boot و سیستم‌عامل
بوت امن مانع اجرای جزء بدون امضا می‌شود؛ بوت اندازه‌گیری‌شده شواهد وضعیت واقعی را حفظ می‌کند.

در محیط آفلاین، ترکیب این دو اهمیت ویژه دارد. سامانه می‌تواند فقط image مجاز را اجرا کند و هم‌زمان ثابت کند چه چیزی اجرا شده است. با مهروموم‌کردن کلید دیسک به مقادیر PCR، کلید فقط زمانی آزاد می‌شود که زنجیرهٔ بوت با وضعیت تأییدشده مطابقت داشته باشد. تعویض مادربورد، تغییر firmware یا دستکاری بوت‌لودر در این صورت به‌طور مستقیم بر دسترسی به داده اثر می‌گذارد.

این سخت‌گیری باید مسیر بازیابی کنترل‌شده داشته باشد. اگر هر تغییر مجاز نیز کلید را برای همیشه غیرقابل دسترس کند، سازمان میان امنیت و تداوم مأموریت گرفتار می‌شود. سیاست بالغ، وضعیت‌های مجاز، فرآیند ثبت تغییر، کلیدهای بازیابی، تفکیک اختیار و ممیزی استفاده از recovery را از پیش تعریف می‌کند.

وصله در محیط آفلاین، یک زنجیره است

به‌روزرسانی بدون اینترنت بیش از آنکه مسئلهٔ ابزار باشد، مسئلهٔ لجستیک و حاکمیت است. هر وصله نماینده‌ای از دنیای بیرون است و باید مسیر زیر را طی کند:

  1. دریافت در ناحیه‌ای جدا از محیط عملیاتی؛
  2. اعتبارسنجی امضا، منشأ و تمامیت بسته؛
  3. بررسی دامنهٔ تغییر و وابستگی‌ها؛
  4. ساخت snapshot یا نقطهٔ بازگشت معتبر؛
  5. آزمون روی سخت‌افزار و بار کاری متناظر در staging؛
  6. تأیید فنی و پذیرش ریسک عملیاتی؛
  7. انتقال یک‌طرفه یا کنترل‌شده به مخزن داخلی؛
  8. استقرار مرحله‌ای و ثبت شواهد نتیجه.

سیستم‌عامل نباید در خطا یا وضعیت خاص، پنهانی به مخزن عمومی متصل شود. همهٔ منابع باید صریح، داخلی و قابل ممیزی باشند. آینهٔ داخلی نیز تنها زمانی قابل اعتماد است که سازمان بتواند نسخهٔ آن، مجموعهٔ بسته‌ها، کلیدها و تغییرهای اعمال‌شده را بازتولید کند.

آفلاین‌بودن، مسئولیت انسان را کم نمی‌کند

در محیط متصل، بخشی از شکست را می‌توان با بازیابی از cloud، دریافت فوری بسته یا کمک بیرونی جبران کرد. محیط ایزوله چنین فرصت‌هایی ندارد. در نتیجه اتکای پنهان به حافظهٔ مدیر سیستم، رسانهٔ بدون شناسنامه یا دستورالعمل غیرنسخه‌گذاری‌شده خطرناک‌تر است.

سامانه باید بتواند بدون «قهرمان‌سازی انسانی» تغییر کند و بازگردد. ابزار و معماری باید وضعیت را ثبت کنند، اما تصمیم دربارهٔ پذیرش ریسک، استثنا و ادامهٔ مأموریت همچنان انسانی و سازمانی است. حذف اتصال خارجی، مسئولیت حاکمیتی را حذف نمی‌کند؛ آن را به درون سازمان منتقل می‌کند.

محیط ایزوله زمانی امن‌تر است که سازمان مالک ریشهٔ اعتماد، کلیدها، مخازن، فرآیند تغییر و شواهد وضعیت باشد. در غیر این صورت، Air Gap تنها فاصله‌ای فیزیکی است که تهدید را کند می‌کند، اما هم‌زمان دید و سرعت واکنش مدافع را نیز کاهش می‌دهد. گام بعدی این معماری، حفظ و اثبات وضعیت و امکان بازگشت پس از شکست است.

بازکردن مقاله در تب جدید
۴

ثباتی که قابل اثبات و بازگشت نیست، امنیت نیست

رانش پیکربندی، وضعیت اعلامی، Attestation، Snapshot و رفتار سامانه پس از شکست.

مطالعهٔ فصل: ثباتی که قابل اثبات و بازگشت نیست، امنیت نیست

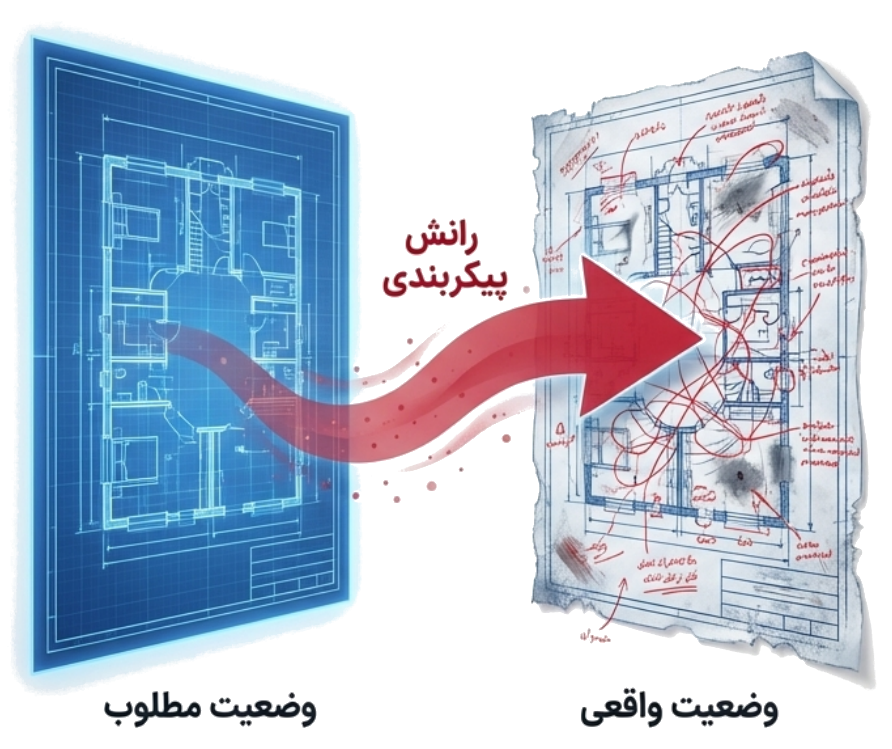
امن‌بودن در لحظهٔ نصب یا درست‌پیکربندی‌شدن در روز اول، تضمینی برای تداوم امنیت نیست. بسیاری از اختلالات جدی نه با یک حملهٔ آشکار، بلکه با تغییرهای کوچک، موجه و ثبت‌نشده آغاز می‌شوند. هر تغییر به‌تنهایی بی‌خطر به نظر می‌رسد، اما مجموع آن‌ها فاصلهٔ میان «آنچه سامانه باید باشد» و «آنچه واقعاً هست» را افزایش می‌دهد.

این پدیده رانش پیکربندی است. به‌روزرسانی جزئی، اصلاح اضطراری، تفاوت ترتیب نصب بسته‌ها، تغییر permission، فعال‌ماندن یک پورت موقت یا نصب ابزاری برای عیب‌یابی می‌تواند دو سروری را که روز نخست یکسان بوده‌اند، به دو سامانهٔ متفاوت تبدیل کند.

فاصله گرفتن تدریجی وضعیت واقعی سامانه از وضعیت مطلوب بر اثر رانش پیکربندی
رانش پیکربندی معمولاً با یک تصمیم بزرگ رخ نمی‌دهد؛ از انباشت استثناهای کوچک شکل می‌گیرد.

سرور منحصربه‌فرد، دارایی ارزشمند نیست

در محیط‌های طولانی‌عمر، اصلاحات دستی در لحظهٔ بحران به‌تدریج «سرورهای منحصربه‌فرد» می‌سازند؛ سامانه‌هایی که دیگر قابل تکثیر، بازسازی یا مقایسه نیستند. شناخت آن‌ها در ذهن یک یا دو مدیر باقی می‌ماند و حتی اسکریپت امنیتی یکسان روی دو میزبان ظاهراً مشابه نتیجهٔ متفاوت می‌دهد.

از منظر امنیتی، رانش سطح حمله را بی‌صدا تغییر می‌دهد. ممکن است سطح وصلهٔ دو سامانه یکسان باشد، اما روی یکی سرویس اضافه‌ای فعال، ماژولی متفاوت بارگذاری یا دسترسی موقتی فراموش شده باشد. گزارش «همهٔ بسته‌ها به‌روزند» این تفاوت را نشان نمی‌دهد.

رانش را نمی‌توان فقط با دقت بیشتر یا مستندسازی بهتر حذف کرد. در مقیاس سازمانی و در طول زمان، رانش یک پدیدهٔ طبیعی است. بلوغ سازمان در توان شناسایی، مهار و بازگرداندن سامانه به وضعیت مورد انتظار دیده می‌شود.

Snapshot و وضعیت اعلامی، پاسخ یکسانی نمی‌دهند

Snapshot تصویری از وضعیت سامانه در یک نقطهٔ زمانی است. ارزش آن فقط سرعت بازیابی نیست؛ امکان «بازگشت بدون تفسیر» است. وقتی snapshot معتبر وجود دارد، لازم نیست در لحظهٔ بحران حدس بزنیم کدام فایل، بسته یا تنظیم باید بازسازی شود.

اما snapshot می‌گوید سامانه چه بوده است، نه اینکه چه باید باشد. وضعیت اعلامی این شکاف را پر می‌کند. در مدل declarative، بسته‌ها، تنظیمات، سرویس‌ها و سیاست‌های معتبر به‌صورت صریح تعریف می‌شوند و سامانه با مرجع سنجیده می‌شود. هر انحراف—even اگر سرویس همچنان کار کند—یک وضعیت غیرعادی است.

دو رویکرد کلی وجود دارد. در رویکرد ترمیمی، ابزارهایی مانند Ansible انحراف را شناسایی و سامانه را به تعریف مرجع نزدیک می‌کنند. در رویکرد پیشگیرانه، لایه‌های تغییرناپذیر اساساً اجازه نمی‌دهند فایل‌های حساس خارج از تراکنش مجاز تغییر کنند. انتخاب میان این دو، انتخاب میان ابزارها نیست؛ تعیین می‌کند سازمان رانش را پس از وقوع اصلاح می‌کند یا امکان وقوع آن را در لایه‌ای از سامانه محدود می‌سازد.

پایش با اثبات وضعیت فرق دارد

پایش عملیاتی معمولاً می‌پرسد سرویس بالا هست یا نه، CPU اشباع شده یا دیسک پر است. این اطلاعات ضروری‌اند، اما نشان نمی‌دهند سامانه همان چیزی است که باید باشد.

اثبات وضعیت یا Attestation یعنی تولید شواهد فنی معتبر از وضعیت واقعی، بدون اتکا به ادعای همان لایه‌ای که ممکن است آلوده شده باشد. این توان بر سه پایه استوار است:

  1. وضعیت مرجع باید دقیق و نسخه‌گذاری‌شده باشد.
  2. انحراف در بوت و زمان اجرا باید قابل مشاهده باشد؛ برای مثال با IMA/EVM و کنترل تمامیت فایل‌های حساس.
  3. شواهد باید با ریشهٔ اعتماد سخت‌افزاری امضا شوند تا مدیر بتواند از بیرون سامانه، سلامت ساختاری آن را ارزیابی کند.

در محیط آفلاین، این قابلیت اهمیت بیشتری دارد؛ زیرا بازرسی انسانی دائم و پایش خارجی برخط همیشه ممکن نیست. سامانه باید بتواند نشان دهد با چه زنجیرهٔ بوت، کرنل و پیکربندی‌ای اجرا شده است.

شکست باید فرض طراحی باشد

به‌روزرسانی ممکن است نیمه‌کاره بماند، درایور جدید با سخت‌افزار سازگار نباشد، وابستگی‌ها به بن‌بست برسند یا برق در بدترین لحظه قطع شود. معماری بالغ این رخدادها را «استثنای ناممکن» نمی‌داند؛ برای آن‌ها رفتار تعریف‌شده دارد.

سیستم نباید اجازه دهد شکست جزئی به وضعیت خاکستری تبدیل شود: نه کاملاً سالم، نه آشکارا شکست‌خورده و نه قابل تحلیل. تغییر باید یا کامل اعمال شود یا سامانه به وضعیت معتبر قبلی برگردد. این رفتار، بار تصمیم را از لحظهٔ فشار به زمان طراحی منتقل می‌کند.

بازگشت‌پذیری واقعی با نسخهٔ پشتیبان یا امکان نصب مجدد یکی نیست. نصب مجدد یک وضعیت تازه می‌سازد که باید دوباره اعتبارسنجی شود. بازگشت واقعی یعنی رجوع کامل به آخرین وضعیت معتبر و آزموده‌شده؛ نه الزاماً جدیدترین وضعیت.

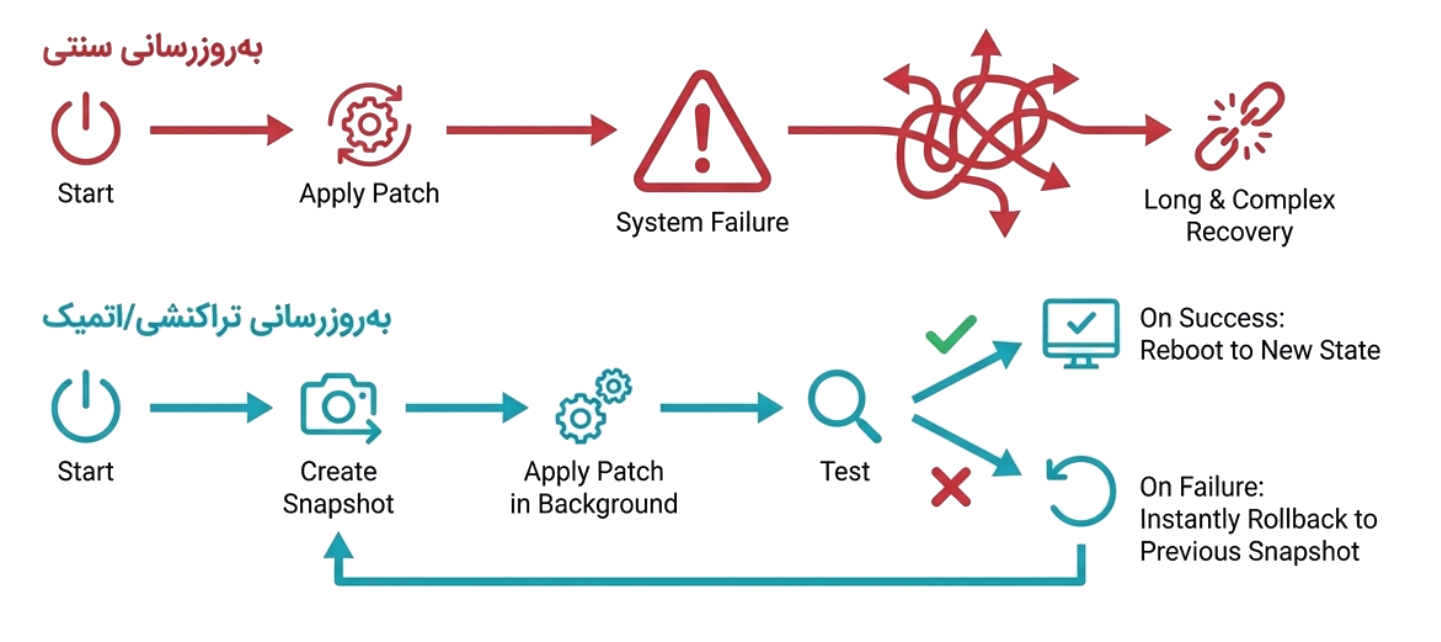
مقایسهٔ به‌روزرسانی سنتی با به‌روزرسانی اتمیک و بازگشت خودکار به snapshot سالم
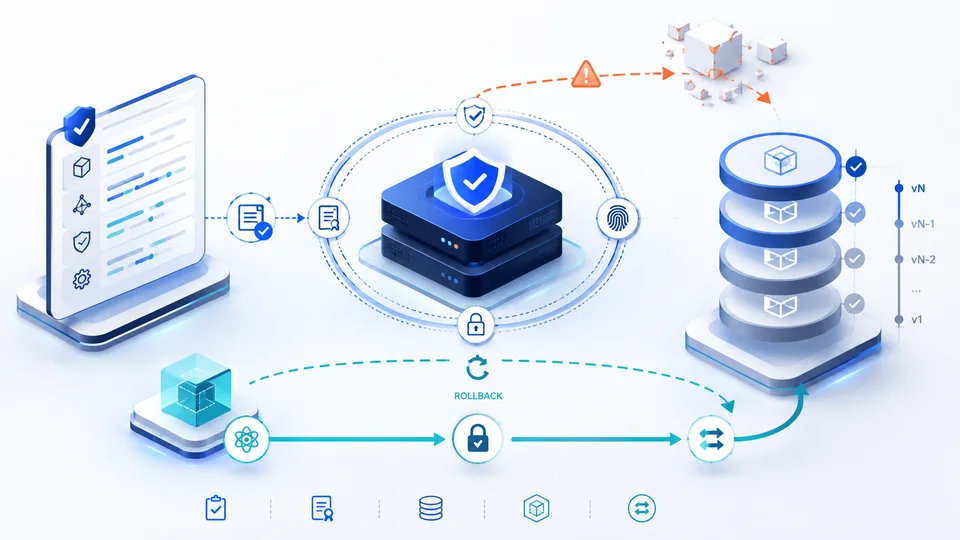
در تغییر اتمیک، شکست مسیر بازگشت ازپیش‌تعریف‌شده دارد و سامانه در حالت میانی رها نمی‌شود.

به‌روزرسانی اتمیک چه چیزی را عوض می‌کند؟

در به‌روزرسانی تدریجی، بسته‌ها روی وضعیت جاری تغییر می‌کنند. اگر تراکنش قطع شود، پایگاه دادهٔ بسته شاید سالم بماند اما فایل‌ها، سرویس‌ها و تنظیمات می‌توانند در وضعیتی ناسازگار قرار گیرند. بازگردانی تاریخچهٔ package manager نیز الزاماً تغییرات فایل پیکربندی و اسکریپت‌های پس از نصب را خنثی نمی‌کند.

در مدل اتمیک، تغییر روی یک وضعیت جدا اعمال می‌شود و وضعیت فعال تا لحظهٔ تأیید دست‌نخورده می‌ماند. اگر نتیجه معتبر باشد، بوت بعدی به وضعیت جدید می‌رود؛ در غیر این صورت، سامانه به وضعیت قبلی ادامه می‌دهد. بازگشت بخشی از رفتار طبیعی سیستم است، نه عملیات اضطراری وابسته به حافظهٔ مدیر.

این مدل اختیار اپراتور را حذف نمی‌کند. برعکس، اجازه می‌دهد تغییر اجرا، نتیجه مشاهده و در صورت لزوم بازگردانده شود، بدون آنکه سامانه وارد وضعیت نامعلوم شود. آنچه کم می‌شود نیاز به تصمیم فوری و پرریسک در لحظهٔ شکست است.

پیش‌بینی‌پذیری و بازگشت‌پذیری مکمل‌اند

پیش‌بینی‌پذیری ناظر بر پیش از شکست است: تغییر چه اثری دارد، وابستگی چگونه حل می‌شود و آیا نتیجه از پیش قابل تصور است. بازگشت‌پذیری ناظر بر پس از شکست است: اگر فرض‌ها غلط بودند، سامانه چگونه از وضعیت نامطلوب خارج می‌شود.

اولی احتمال شکست را کم می‌کند و دومی هزینهٔ آن را محدود می‌سازد. پایدارترین سامانه نیز با خطای ترکیبی، سخت‌افزار غیرمنتظره یا شرایطی خارج از سناریوی آزموده‌شده روبه‌رو می‌شود. در آن لحظه، اصرار بر اینکه «نباید شکست می‌خورد» مأموریت را نجات نمی‌دهد؛ مسیر خروج از شکست است که اهمیت دارد.

پس از بازگشت نیز شواهد نباید از بین بروند. snapshot شکست‌خورده، لاگ تغییر و تفاوت آن با وضعیت سالم باید برای تحلیل ریشه‌ای حفظ شوند. سامانهٔ تاب‌آور شکست را محدود، ثبت و قابل تحلیل می‌کند؛ سامانهٔ شکننده اجازه می‌دهد شکست به بی‌نظمی عملیاتی تبدیل شود.

ثباتی که فقط با «دست نزدن» حفظ می‌شود، امنیت نیست. سامانهٔ قابل اعتماد باید بتواند تغییر کند، وضعیت خود را اثبات کند و اگر تغییر نامعتبر بود، بدون قهرمان‌سازی انسانی به آخرین وضعیت معتبر برگردد. این منطق در معماری کانتینری نیز ادامه پیدا می‌کند؛ جایی که وضعیت سالم به‌جای نگهداری یک نمونه، باید قابل بازتولید باشد.

بازکردن مقاله در تب جدید
۵

کانتینر، مرز امنیتی مستقل نیست

کرنل مشترک، تغییرناپذیری، زنجیرهٔ ساخت، eBPF، هویت سرویس و مدیریت اسرار.

مطالعهٔ فصل: کانتینر، مرز امنیتی مستقل نیست

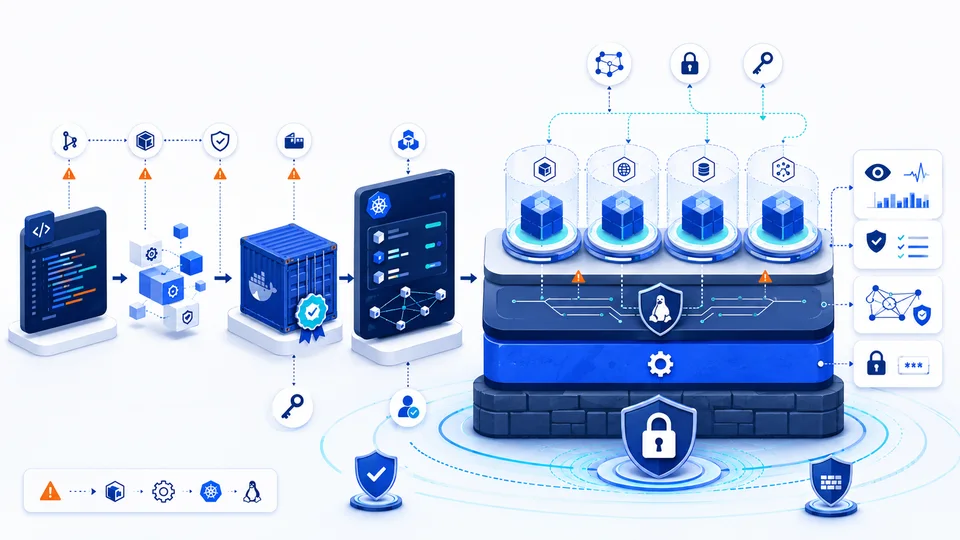
معماری‌های کانتینری امنیت سیستم‌عامل را حذف نکرده‌اند؛ آن را از یک لایهٔ مستقل به بخشی از زنجیره‌ای پیچیده‌تر تبدیل کرده‌اند. بارهای کاری کوتاه‌عمر می‌شوند، برنامه و وابستگی در image قرار می‌گیرند، runtime و ارکستریتور میان سامانه و سرویس می‌نشینند و تصمیم‌های زمان اجرا به‌اندازهٔ تصمیم‌های زمان ساخت اهمیت پیدا می‌کنند.

در این معماری، سیستم‌عامل میزبان دیگر محل اجرای مستقیم همهٔ برنامه‌ها نیست؛ بستر اعتماد و کنترل برای تمام لایه‌های بالاتر است. هر ضعفی در کرنل، درایور، runtime یا سیاست میزبان می‌تواند هم‌زمان چندین بار کاری را تحت تأثیر قرار دهد. بنابراین کانتینر یک مرز امنیتی مستقل از سیستم‌عامل نیست.

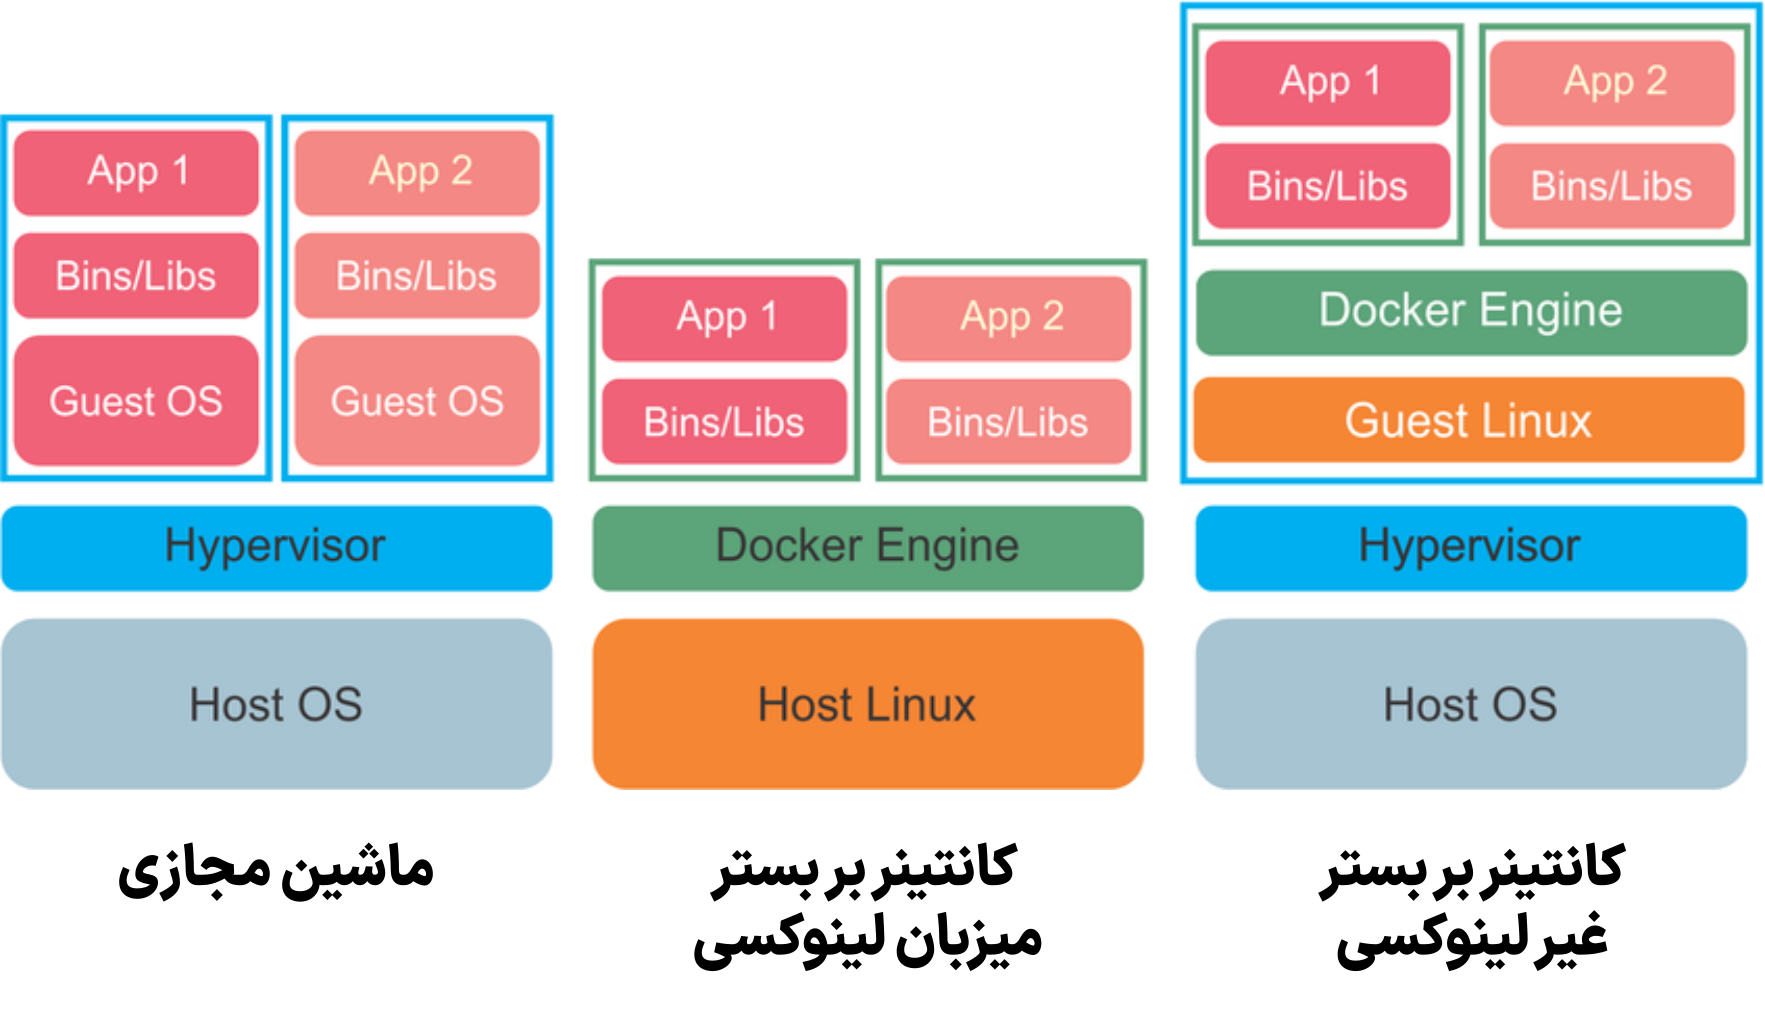
ماشین مجازی و کانتینر، دو نوع جداسازی‌اند

ماشین مجازی یک سامانهٔ مستقل با کرنل، چرخهٔ بوت و سیستم‌عامل مهمان خود دارد. این استقلال مرز روشن‌تری می‌سازد، اما در مقابل منابع بیشتر مصرف می‌کند و تعداد سیستم‌عامل‌هایی را که باید وصله، پایش و اداره شوند افزایش می‌دهد.

کانتینر محیط اجرای ایزولهٔ یک برنامه است که مستقیماً روی کرنل میزبان اجرا می‌شود. برنامه، کتابخانه و وابستگی‌های لازم را همراه دارد، اما کرنل مستقل ندارد. جداسازی فرآیند، فایل‌سیستم، شبکه و منابع با قابلیت‌های بومی هستهٔ لینوکس انجام می‌شود.

مقایسهٔ ماشین مجازی با کانتینر روی میزبان لینوکسی و غیرلینوکسی
در ماشین مجازی، هر مهمان کرنل خود را دارد؛ در کانتینر، جداسازی بر کرنل مشترک میزبان متکی است.

اشتراک کرنل هم مزیت است و هم نقطهٔ تمرکز ریسک. کانتینرها سبک‌ترند و می‌توانند سطح حملهٔ فضای کاربر را کاهش دهند، اما شکست جداسازی یا آسیب‌پذیری کرنل مرز میان بارهای کاری را تضعیف می‌کند. در محیط حساس، بحث کانتینر بدون بحث میزبان ناقص است.

توزیع داخل کانتینر با توزیع میزبان یکی نیست

میزبان می‌تواند یک توزیع سازمانی پایدار و سخت‌سازی‌شده باشد، در حالی که کانتینر از Alpine، یک user-space دیگر یا image نوع Distroless استفاده کند. آنچه کانتینر «سیستم‌عامل» می‌نامد، مجموعهٔ کتابخانه‌ها و ابزارهای فضای کاربر است؛ کرنل همچنان از میزبان می‌آید.

این جدایی اجازه می‌دهد لایهٔ کاربرد چابک بماند و لایهٔ زیرساخت با چرخه‌ای محافظه‌کارانه‌تر اداره شود. image بدون shell و ابزار مدیریتی، مسیرهای سوءاستفاده پس از نفوذ را کم می‌کند. اما اگر برنامه به GPU، ماژول کرنل یا قابلیت خاص سخت‌افزاری نیاز داشته باشد، وابستگی میان image، runtime، درایور و میزبان دوباره پررنگ می‌شود.

لایه‌های برنامه، کتابخانه، runtime کانتینر و سیستم‌عامل میزبان
کانتینر می‌تواند فضای کاربر متفاوتی داشته باشد، اما امنیت نهایی به کرنل و کنترل‌های میزبان بازمی‌گردد.

تغییرناپذیری رانش را حذف نمی‌کند؛ جابه‌جا می‌کند

در مدل درست کانتینری، نمونهٔ در حال اجرا نگهداری نمی‌شود. تغییر برنامه یا وابستگی باید image تازه‌ای بسازد و نمونهٔ قبلی جایگزین شود. کانتینری که درون آن اصلاح دستی انجام شده، دیگر مرجع معتبر نیست و نباید باقی بماند.

این منطق بخش بزرگی از رانش پیکربندی در سطح بار کاری را حذف می‌کند. دو نمونه از یک image باید یکسان باشند و بدافزاری که روی فایل‌سیستم موقتی ماندگار شده، با جایگزینی نمونه از بین برود. اما ریسک به مرحلهٔ ساخت منتقل می‌شود. اگر image پایه آلوده، وابستگی آسیب‌پذیر یا پیکربندی نادرست باشد، تغییرناپذیری همان خطا را با سرعت و مقیاس بیشتری تکثیر می‌کند.

بنابراین وضعیت معتبر باید در کل زنجیره تعریف شود: Dockerfile یا دستور ساخت، image پایه، وابستگی‌ها، امضا، SBOM، رجیستری، سیاست استقرار و پیکربندی زمان اجرا. ثبات قابل اثبات و بازگشت در کانتینر به معنای توان بازتولید image سالم است، نه نگهداری طولانی یک نمونهٔ ظاهراً پایدار.

مرزهای واقعی در کرنل میزبان

Namespace دید هر بار کاری به فرآیند، شبکه، mount و کاربران را محدود می‌کند. Cgroup مصرف CPU، حافظه و سایر منابع را کنترل می‌کند. Linux capabilities اختیار یکپارچهٔ root را به قابلیت‌های کوچک‌تر می‌شکند. Seccomp فراخوانی‌های مجاز سیستم را محدود می‌سازد و SELinux یا AppArmor می‌توانند رفتار فرآیند را با سیاست اجباری مهار کنند.

هیچ‌یک از این سازوکارها به‌تنهایی مرز کامل نیستند. امنیت از هم‌پوشانی آن‌ها شکل می‌گیرد:

  • کانتینر تا حد ممکن با کاربر غیر root اجرا شود؛
  • capabilities غیرضروری حذف شوند؛
  • اجرای privileged و mountکردن مسیرهای میزبان استثنایی باشد؛
  • سوکت مدیریتی runtime در دسترس بار کاری قرار نگیرد؛
  • seccomp و LSM فعال و قابل ممیزی باشند؛
  • ماژول‌ها و سطح حملهٔ کرنل میزبان محدود شوند؛
  • و میزبان چرخهٔ وصله و بازگشت مشخص داشته باشد.

اگر runtime یا سوکت مدیریتی با دسترسی گسترده در اختیار کانتینر قرار گیرد، بحث «امنیت کانتینر» عملاً بی‌معنا می‌شود؛ زیرا بار کاری می‌تواند مرز اعتماد میزبان را بازتعریف کند.

زنجیرهٔ تأمین از بسته به image گسترش یافته است

Image ممکن است کد سازمان، صدها وابستگی متن‌باز، ابزار build و لایه‌های به‌جامانده از مراحل قبلی را در خود داشته باشد. اسکن آسیب‌پذیری فقط یکی از کنترل‌هاست. سازمان باید منشأ image پایه، digest دقیق، امضای سازنده، SBOM و مجوز ورود به رجیستری عملیاتی را کنترل کند.

اصل مهم این است که «ساخته‌شدن موفق» معادل «مجازبودن برای استقرار» نیست. image باید در محیط جدا ساخته شود، بدون دریافت رازهای تولید آزموده شود، خروجی آن امضا گردد و admission policy فقط artifact تأییدشده را بپذیرد. در محیط ایزوله، رجیستری داخلی همان نقشی را دارد که مخزن بستهٔ داخلی برای سیستم‌عامل ایفا می‌کند.

امنیت زمان اجرا و eBPF

پیش از اجرا می‌توان image را اسکن و سیاست را بررسی کرد، اما رفتار واقعی تنها در runtime دیده می‌شود. اجرای shell غیرمنتظره، دسترسی به فایل حساس، اتصال شبکه‌ای جدید یا افزایش ناگهانی مصرف منابع ممکن است نشانهٔ نفوذ باشد.

eBPF امکان مشاهده و اعمال سیاست در سطح کرنل را بدون افزودن عامل سنگین به هر کانتینر فراهم می‌کند. این قابلیت می‌تواند syscall، ارتباط شبکه و رفتار فرآیند را ببیند و با وضعیت مورد انتظار مقایسه کند. مزیت اصلی آن دید مشترک از میزبان و بارهای کاری است؛ همان نقطه‌ای که مرز واقعی اجرا قرار دارد.

این قدرت باید با حاکمیت همراه باشد. برنامهٔ eBPF نیز کد سطح پایین و پرقدرت است و مجوز بارگذاری، منشأ و رفتار آن باید کنترل شود. ابزار دفاعی بدون کنترل تغییر می‌تواند خودش بخشی از سطح حمله شود.

شبکه باید بر هویت متکی باشد، نه مکان

در معماری کانتینری، IPها موقتی‌اند و «داخل شبکه» مرز باثباتی نیست. ارتباط نباید فقط به دلیل حضور دو سرویس در یک subnet مجاز باشد. هر سرویس باید هویت دیجیتال خود را اثبات کند و سیاست مشخص سازد با چه سرویسی و برای چه هدفی ارتباط دارد.

در الگوی مبتنی بر mTLS و Service Mesh، هر دو طرف ارتباط هویت یکدیگر را تأیید می‌کنند و ترافیک رمز می‌شود. ریزقطعه‌بندی مبتنی بر هویت، حرکت جانبی را محدود می‌کند؛ حتی اگر مهاجم به یک کانتینر رسیده باشد. ابزارهایی مانند Cilium می‌توانند بخشی از شبکه و سیاست را با eBPF در سطح کرنل اعمال کنند، اما اصل مهم‌تر از ابزار است: اعتماد باید به هویت و مجوز گره بخورد، نه آدرس.

اسرار نباید بخشی از image باشند

هاردکدکردن رمز عبور، کلید API یا گواهی در image، یک راز را به شیئی تکثیرپذیر تبدیل می‌کند. آن راز در رجیستری، محیط آزمون، نسخهٔ پشتیبان و هر کپی image پخش می‌شود. حتی حذف آن در لایهٔ بعدی لزوماً داده را از لایه‌های قبلی image پاک نمی‌کند.

در معماری تغییرناپذیر، راز بخشی از پیکربندی ثابت نیست. راز باید در زمان اجرا، برای هویتی مشخص، با عمر محدود و ترجیحاً در حافظه تحویل شود. سامانه‌ای مانند Vault یا راهکار معادل، راز را رمز‌شده نگه می‌دارد و بر اساس هویت و سیاست در اختیار مصرف‌کننده می‌گذارد. کانتینر مالک راز نیست؛ مصرف‌کنندهٔ موقت آن است.

کانتینر امن یا ناامن نیست؛ معماری آن چنین است

کانتینر محل اعمال اعتماد را تغییر می‌دهد: از سرور به image، از نمونهٔ پایدار به artifact بازتولیدپذیر و از مرز شبکه به هویت سرویس. اگر image، زنجیرهٔ ساخت، runtime و میزبان در یک چرخهٔ کنترل‌شده قرار نگیرند، این جابه‌جایی فقط پیچیدگی را افزایش می‌دهد.

سخت‌سازی کرنل، انتخاب توزیع میزبان، مدیریت وصله، سیاست LSM، کنترل runtime و مشاهده‌پذیری، پیش‌نیاز امنیت کانتینرند. این موضوع برای بارهای کاری GPU و AI حساس‌تر نیز می‌شود، زیرا زنجیرهٔ میزبان به درایور و شتاب‌دهنده ادامه پیدا می‌کند؛ موضوع مقالهٔ امنیت زیرساخت هوش مصنوعی از کرنل و GPU آغاز می‌شود.

بازکردن مقاله در تب جدید
۶

امنیت زیرساخت هوش مصنوعی از کرنل و GPU آغاز می‌شود

ABI، درایور، runtime، کانتینر، داده، مدل و شتاب‌دهنده به‌عنوان یک زنجیرهٔ اعتبارسنجی.

مطالعهٔ فصل: امنیت زیرساخت هوش مصنوعی از کرنل و GPU آغاز می‌شود

در بارهای کاری هوش مصنوعی و محاسبات سنگین، سیستم‌عامل فقط بستری برای اجرای برنامه نیست؛ بخشی از مسیر داده، زمان‌بندی محاسبات، دسترسی به حافظه و صحت عملیاتی سامانه است. تغییر نسخهٔ کرنل، درایور یا کتابخانهٔ سطح پایین می‌تواند بدون تغییر کد مدل، عملکرد، مصرف حافظه، پایداری و حتی تکرارپذیری نتیجه را تغییر دهد.

امنیت این زیرساخت نیز از همین زنجیره پیروی می‌کند. اگر کرنل، درایور GPU، runtime کانتینر و ابزار تخصیص منابع با هم سازگار و قابل ممیزی نباشند، کنترل‌های لایهٔ مدل بر بستری شکننده اجرا می‌شوند. از این منظر، امنیت AI از کرنل و GPU آغاز می‌شود، هرچند به آن‌ها محدود نمی‌ماند.

سازگاری خاموش، از شکست آشکار خطرناک‌تر است

ناسازگاری باینری همیشه با crash آغاز نمی‌شود. سیستم بوت می‌شود، سرویس بالا می‌آید و بار کاری اجرا می‌شود، اما رفتار زمان‌بندی، مدیریت حافظه یا وقفه‌ها کمی تغییر کرده است. در آموزش طولانی یا شبیه‌سازی HPC، همین تفاوت می‌تواند به افت عملکرد، توقف نادر یا نتیجهٔ غیرقابل بازتولید منجر شود.

رابط باینری کرنل و ماژول‌ها قراردادی نادیدنی است. برخی زیست‌بوم‌ها با ثابت‌نگه‌داشتن ABI و backportکردن وصله‌ها تلاش می‌کنند این قرارداد را در چرخه‌ای طولانی حفظ کنند. برخی دیگر تغییر را می‌پذیرند، اما آن را با بسته‌بندی ماژول، آزمون و مسیر بازگشت مهار می‌کنند. هیچ رویکردی به‌تنهایی درست‌تر نیست؛ پرسش اصلی این است که سازمان بداند چه چیز ثابت مانده، چه چیز تغییر کرده و چگونه نتیجه را اعتبارسنجی می‌کند.

در محیط آفلاین، این موضوع سخت‌تر است. درایوری که پس از ارتقای کرنل به build محلی نیاز دارد، کامپایلر، header، سورس و ابزار توسعه را به سامانهٔ عملیاتی وارد می‌کند. این کار هم سطح حمله را افزایش می‌دهد و هم شکست کامپایل را به قطع کامل دسترسی GPU پیوند می‌زند. بستهٔ ازپیش‌ساخته و آزموده‌شده می‌تواند این ریسک را کم کند، مشروط بر اینکه زنجیرهٔ تولید و امضای آن قابل اعتماد باشد.

GPU یک قطعهٔ جانبی معمولی نیست

در بار کاری کلاسیک، خرابی یک شتاب‌دهنده ممکن است فقط عملکرد را کم کند. در AI، GPU می‌تواند شرط امکان اجرای مدل باشد. ظرفیت و پهنای‌باند حافظه تعیین می‌کند مدل در سامانه جا می‌شود یا نه؛ توپولوژی ارتباطی بر مقیاس آموزش اثر می‌گذارد و درایور و runtime مسیر دسترسی همهٔ بارهای کاری به این دارایی را کنترل می‌کنند.

برای انتخاب سخت‌افزار باید میان نوع کارت، فرم‌فکتور، توان، اتصال و کاربرد تفکیک کرد. مجموعهٔ راهنمای انتخاب GPU این تصمیم را از منظر سخت‌افزار و استقرار بررسی می‌کند. از منظر امنیتی، همان BOM نهایی اهمیت دارد: مدل و part number واقعی کارت، firmware، نسخهٔ درایور، سرور پشتیبانی‌کننده و مسیر به‌روزرسانی باید یک واحد اعتبارسنجی تلقی شوند.

قابلیت‌هایی مانند MIG در برخی GPUهای مرکز داده امکان تقسیم سخت‌افزاری یک GPU به نمونه‌های جدا با سهم مشخصی از پردازنده، cache و حافظه را می‌دهند. این جداسازی برای محیط چندمستاجره از time-slicing نرم‌افزاری قوی‌تر است، اما فعال‌سازی و حفظ آن به هماهنگی کرنل، درایور، ابزار مدیریتی و runtime کانتینر وابسته است. پیکربندی MIG که پس از reboot از بین می‌رود یا با ارتقای درایور تغییر می‌کند، کنترل پایدار محسوب نمی‌شود.

کانتینر وابستگی GPU به میزبان را حذف نمی‌کند

NVIDIA Container Toolkit و ابزارهای مشابه اجازه می‌دهند برنامه داخل کانتینر به GPU میزبان دسترسی پیدا کند. کتابخانه‌های فضای کاربر می‌توانند داخل image قرار گیرند، اما درایور کرنل روی میزبان است. در نتیجه نسخهٔ image، libnvidia-container، runtime و درایور باید با هم سازگار باشند.

این همان نقطه‌ای است که تصور «کانتینر همه‌چیز را ثابت کرده» شکست می‌خورد. image برنامه شاید تغییرناپذیر باشد، اما میزبان و درایور همچنان تغییر می‌کنند. اگر این دو چرخه جداگانه و بدون آزمون مشترک اداره شوند، یک وصلهٔ امنیتی کرنل می‌تواند مسیر GPU را از کار بیندازد و یک ارتقای درایور می‌تواند محیطی را که مدل روی آن اعتبارسنجی شده تغییر دهد.

به همین دلیل، image مدل و نرم‌افزار، نسخهٔ درایور، کرنل، firmware و پیکربندی GPU باید در قالب یک «پروفایل اجرای تأییدشده» ثبت شوند. آزمون پذیرش نیز نباید به دیده‌شدن کارت با nvidia-smi محدود بماند؛ بار کاری واقعی، تخصیص حافظه، اجرای چندمستاجره، reboot و مسیر بازگشت باید آزموده شوند. مقالهٔ کانتینر، مرز امنیتی مستقل نیست جزئیات نقش میزبان را توضیح می‌دهد.

داده، مدل و GPU سه دارایی به‌هم‌پیوسته‌اند

در معماری کلاسیک، داده در پایگاه داده، نرم‌افزار در کد و سخت‌افزار در نقش بستر دیده می‌شد. در AI این تفکیک فرو می‌ریزد. داده رفتار مدل را شکل می‌دهد، مدل عصارهٔ سرمایه‌گذاری داده‌ای و محاسباتی است و GPU شرط آموزش یا استنتاج در مقیاس مورد نیاز است.

  • داده ممکن است طبقه‌بندی‌شده، منحصربه‌فرد یا حاصل عملیات واقعی باشد. مسمومیت یا نشت آن مستقیماً تصمیم سامانه را تغییر می‌دهد.
  • مدل فقط یک فایل اجرایی نیست؛ وزن‌ها و معماری آن دارایی فکری و عملیاتی‌اند. سرقت آن می‌تواند سرمایه‌گذاری سازمان را در اختیار مهاجم قرار دهد.
  • GPU منبعی کمیاب، گران و وابسته به زنجیرهٔ تأمین است. سوءاستفادهٔ محاسباتی، قطع سرویس یا اختلال در درایور می‌تواند توان عملیاتی را بدون تخریب داده از بین ببرد.

از این رو، سیاست دسترسی نباید این سه را جداگانه ببیند. کاربری که اجازهٔ اجرای job دارد لزوماً نباید به دادهٔ خام یا فایل وزن دسترسی مستقیم داشته باشد. سرویسی که مدل را بارگذاری می‌کند نباید اختیار تغییر image یا درایور میزبان را داشته باشد. مدیر زیرساخت نیز الزاماً نباید محتوای دادهٔ آموزش را ببیند. این تفکیک نقطهٔ اتصال امنیت زیرساخت با اصول هوش مصنوعی بدون اعتماد است.

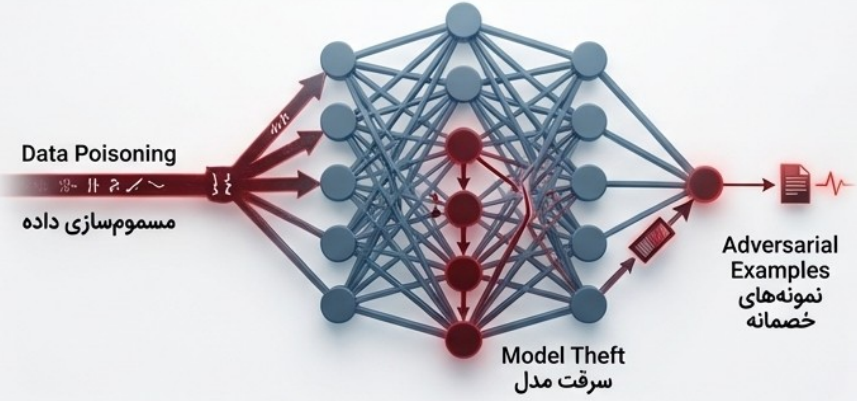
تهدیدهای مسمومیت داده، نمونهٔ خصمانه و سرقت مدل در سامانهٔ هوش مصنوعی
امنیت اجرا مانع همهٔ حمله‌های AI نمی‌شود؛ داده و مدل نیز سطح حملهٔ مستقل دارند.

تهدید می‌تواند بدون نفوذ کلاسیک رخ دهد

در نرم‌افزار سنتی، رفتار عمدتاً در کد صریح است. در AI، بخشی از منطق در دادهٔ آموزش و وزن‌های مدل نهفته است. مهاجم می‌تواند بدون نصب بدافزار یا شکستن کانتینر، داده را مسموم کند، از خروجی مدل اطلاعات استنباط کند، با نمونهٔ خصمانه تصمیم را منحرف سازد یا به‌روزرسانی مدل را هدف بگیرد.

این تهدیدها نشان می‌دهند «امنیت اجرا» معادل «امنیت تصمیم» نیست. کرنل و GPU باید امن و پایدار باشند، اما چرخهٔ داده، آموزش، ارزیابی، استقرار و خروجی نیز باید منشأ، مجوز و شواهد خود را داشته باشد. تفاوت این دو دامنه در مقالهٔ از معماری بدون اعتماد تا هوش مصنوعی بدون اعتماد تشریح شده است.

زنجیرهٔ تأمین سخت‌افزار را از مدل تهدید حذف نکنیم

GPUهای رده‌بالا تحت زنجیرهٔ تأمین پیچیده و محدودیت‌های صادراتی قرار دارند. در سازمان حساس، نباید اصالت firmware، مسیر تأمین، مالکیت قبلی، امکان به‌روزرسانی و وابستگی به سرویس سازنده را بدیهی فرض کرد. این به معنای ادعای وجود سازوکار مخفی در یک محصول مشخص نیست؛ به معنای واردکردن احتمال دستکاری، قطع پشتیبانی یا محدودشدن دسترسی در مدل تهدید است.

تنوع تأمین، آزمون سخت‌افزاری پیش از استقرار، ایزولاسیون شبکهٔ مدیریت، ثبت نسخهٔ firmware و پایش رفتار غیرعادی می‌توانند این ریسک را کاهش دهند. کارت مصرفی و مرکز داده نیز جایگزین کامل یکدیگر نیستند؛ تنوع باید با نیاز واقعی حافظه، پایداری و مقیاس سازگار باشد، نه صرفاً برای افزودن نام‌های متفاوت به فهرست خرید.

ثبات، به معنی منجمدکردن همیشگی نیست

منجمدکردن کرنل و درایور، تکرارپذیری کوتاه‌مدت ایجاد می‌کند اما آسیب‌پذیری و ناسازگاری با سخت‌افزار جدید را انباشته می‌سازد. به‌روزرسانی مداوم نیز محیط اعتبارسنجی‌شده را بی‌ثبات می‌کند. راه‌حل، چرخهٔ تغییر کنترل‌شده است: پروفایل نسخه، مخزن داخلی، staging متناظر، بار آزمون واقعی، snapshot، rollout مرحله‌ای و بازگشت ازپیش‌تعریف‌شده.

امنیت زیرساخت AI نه با خرید GPU پایان می‌یابد و نه با نصب درایور آغاز می‌شود. این امنیت محصول یک زنجیرهٔ قابل اثبات از firmware و کرنل تا داده، مدل و خروجی است. هر حلقه‌ای که خارج از حاکمیت تغییر کند، می‌تواند کل قابلیت هوش مصنوعی را از وضعیت معتبر خارج سازد.

بازکردن مقاله در تب جدید
۷

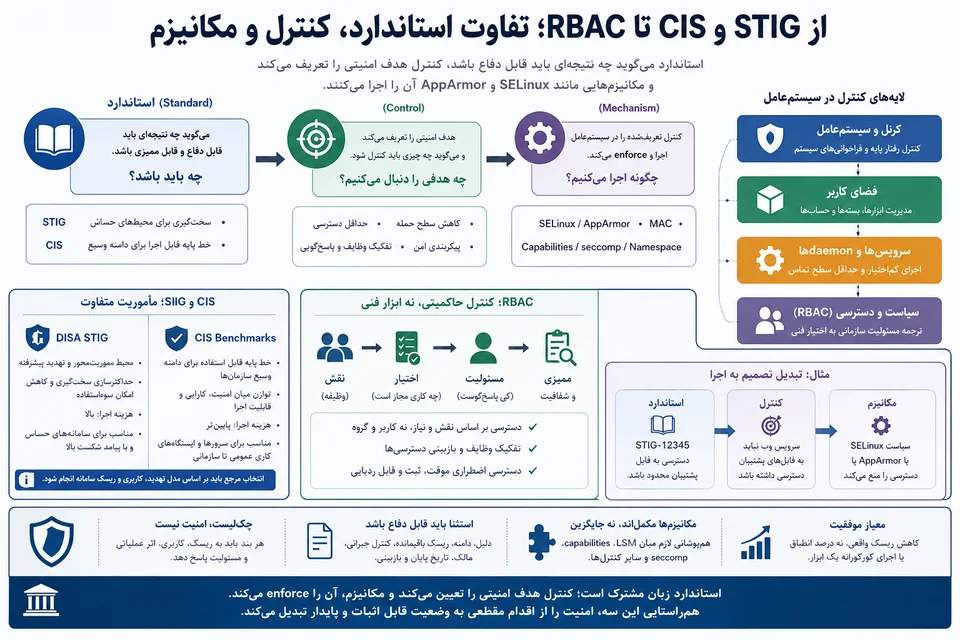
از STIG و CIS تا RBAC؛ تفاوت استاندارد، کنترل و مکانیزم

چرا درصد انطباق جای مدل تهدید را نمی‌گیرد و SELinux یا AppArmor خودِ کنترل نیستند.

مطالعهٔ فصل: از STIG و CIS تا RBAC؛ تفاوت استاندارد، کنترل و مکانیزم

ایمن‌سازی لینوکس در مقیاس سازمانی مجموعه‌ای از تنظیمات پراکنده نیست؛ تصمیمی است که باید قابل دفاع، قابل ممیزی و قابل تکرار باشد. بدون مرجع مشترک، امنیت به تجربه و سلیقهٔ مدیر سیستم وابسته می‌شود و با جابه‌جایی افراد یا افزایش فشار عملیاتی، انسجام خود را از دست می‌دهد.

استانداردها فاصلهٔ میان «احساس امنیت» و «امنیت قابل اثبات» را پر می‌کنند. آن‌ها زبان مشترکی میان تیم فنی، مدیر، ممیز و نهاد ناظر می‌سازند: چه چیزی الزام است، کدام ریسک پذیرفته شده، انحراف با چه توجیهی باقی مانده و مسئول تصمیم چه کسی است.

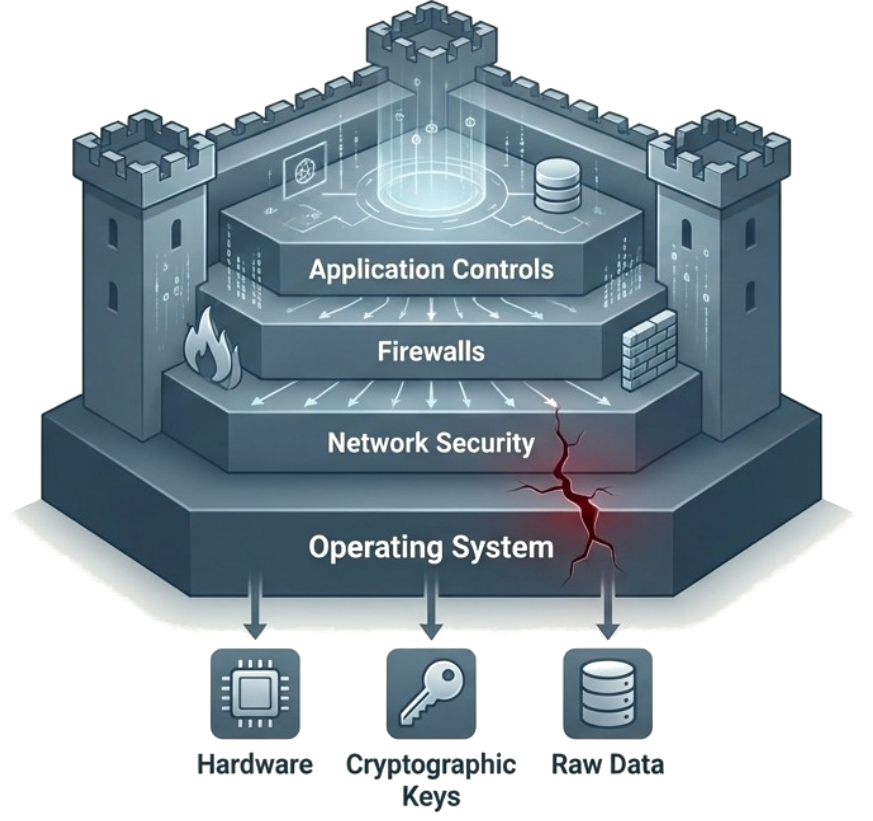
لایه‌های دفاعی امنیت لینوکس از سخت‌افزار و سیستم‌عامل تا شبکه، فایروال و کنترل کاربرد
هیچ ابزار یا لایه‌ای به‌تنهایی امنیت کامل نمی‌سازد؛ استاندارد باید هم‌پوشانی کنترل‌ها را قابل مشاهده کند.

سه نوع مرجع را با هم اشتباه نگیریم

مراجع امنیتی مرتبط با لینوکس را می‌توان در سه دسته دید:

  1. فنی–اجرایی: به پیکربندی، کاهش سطح حمله، دسترسی، سرویس و لاگ می‌پردازد و پاسخ می‌دهد سامانه چگونه باید سخت‌سازی شود.
  2. ممیزی و بنچمارک: خط پایهٔ قابل سنجش می‌سازد و نشان می‌دهد وضعیت فعلی تا چه اندازه با مرجع منطبق است.
  3. حاکمیتی و رگولاتوری: نقش‌ها، فرآیند پذیرش ریسک، مستندسازی و پاسخ‌گویی را تعریف می‌کند.

این سه دسته رقیب نیستند. کنترل فنی بدون معیار ممیزی قابل سنجش نیست و بدون پشتوانهٔ حاکمیتی به اقدام مقطعی تبدیل می‌شود. از سوی دیگر، سیاست حاکمیتی بدون مکانیزم فنی، سندی صوری است که در سامانه enforce نمی‌شود.

STIG و CIS یک مأموریت ندارند

ویژگیDISA STIGCIS Benchmarks
نقطهٔ آغازمحیط مأموریت‌محور و تهدید پیشرفتهخط پایهٔ قابل استفاده برای دامنهٔ وسیع سازمان‌ها
جهت‌گیریحداکثرسازی سخت‌گیری و کاهش امکان سوءاستفادهتوازن میان امنیت، کارایی و قابلیت اجرا
ساختارRule، شدت، روش Check و دستور Fixتوصیهٔ قابل سنجش با پروفایل و سطح اجرا
مناسب برایسامانه‌های حساس، طبقه‌بندی‌شده یا با پیامد شکست بالاسرورها و ایستگاه‌های کاری عمومی تا سازمانی
هزینهٔ اجرابالا؛ نیازمند آزمون، استثنا و انضباط عملیاتیپایین‌تر و مناسب‌تر برای خط پایهٔ گسترده
خطر استفادهٔ کورکورانهاختلال در مأموریت یا پیچیدگی غیرضروریایجاد حس کاذب کفایت در محیط‌های پرریسک

STIG برای بدترین سناریو و مهاجم توانمند طراحی شده است. هر قاعده معمولاً شدت، روش بررسی و روش اصلاح مشخص دارد. این دقت، ممیزی و خودکارسازی را آسان‌تر می‌کند، اما اعمال کامل آن روی هر سامانه‌ای درست نیست. محدودسازی‌ای که برای سرور حساس لازم است، ممکن است ایستگاه توسعه یا سامانهٔ عملیاتی را از کار بیندازد.

CIS تلاش می‌کند خط پایه‌ای قابل دفاع و قابل اجرا برای دامنهٔ وسیع‌تری ارائه کند. Level 1 معمولاً حداقل سخت‌گیری با اثر عملیاتی محدودتر است و Level 2 کنترل‌های بیشتری برای محیط پرریسک دارد. با این حال، حتی Level 2 نیز جای مدل تهدید مأموریت‌محور را نمی‌گیرد.

بنابراین انتخاب مرجع باید پس از دسته‌بندی کاربری و ریسک سامانه انجام شود. این‌که یک اسکنر «۱۰۰ درصد CIS» گزارش کند، چیزی دربارهٔ تناسب آن خط پایه با مأموریت مشخص نمی‌گوید.

چک‌لیست امنیت نیست

چک‌لیست برای تکرار و ممیزی ضروری است، اما اگر از زمینه جدا شود، سه خطا می‌سازد. نخست، سازمان به عدد انطباق به‌جای کاهش ریسک پاداش می‌دهد. دوم، کنترل‌های ناسازگار با مأموریت یا غیرفعال می‌شوند یا بدون ثبت استثنا دور زده می‌شوند. سوم، تیم تصور می‌کند موارد خارج از چک‌لیست فاقد اهمیت‌اند.

هر بند باید به چهار پرسش پاسخ دهد:

  • کدام تهدید یا ریسک را کاهش می‌دهد؟
  • در کدام کاربری و با چه شدت لازم است؟
  • چه اثر عملیاتی یا تعارضی ایجاد می‌کند؟
  • اگر اعمال نشد، چه کسی استثنا را تا چه زمانی پذیرفته است؟

در این نگاه، امتیاز انطباق خروجی فرعی است. خروجی اصلی، شواهدی است که نشان می‌دهد کنترل مناسب، در جای مناسب و با مالک تصمیم مشخص اعمال شده است.

لایه‌های کنترل در سیستم‌عامل

کنترل‌های استاندارد را می‌توان در چهار لایه دید:

لایهنقش امنیتینمونهٔ تصمیم
کرنل و سیستم‌عاملکنترل رفتار پایه، حافظه، ماژول‌ها و فراخوانی‌های سیستمچه ماژول و قابلیت کرنل مجاز است؟
فضای کاربرمهار برنامه‌ها، ابزارها و حساب‌های محلیچه بسته و ابزار مدیریتی باید نصب باشد؟
سرویس‌ها و daemonهاکاهش سطح تماس با شبکه و اجرای کم‌اختیارکدام سرویس فعال و با چه حسابی اجرا شود؟
سیاست و دسترسیترجمهٔ مسئولیت سازمانی به اختیار فنیچه نقشی مجاز است کدام عمل را انجام دهد؟

هسته می‌تواند سوءاستفادهٔ ساختاری را دشوار کند، اما پاسخ‌گویی مدیریتی ایجاد نمی‌کند. سیاست دسترسی می‌تواند اختیار را تعریف کند، اما اگر سرویس با root و بدون محدودیت کرنل اجرا شود، سیاست روی کاغذ باقی می‌ماند. امنیت از رفت‌وبرگشت میان تصمیم بالادستی و enforceشدن در لایه‌های پایین ساخته می‌شود.

RBAC یک کنترل حاکمیتی است

RBAC پیش از آنکه ویژگی فنی باشد، پاسخ به این پرسش است: چه کسی، به دلیل کدام وظیفه، با چه سطح اختیار و تحت مسئولیت چه نقشی به منبع دسترسی دارد؟ نقش معادل نام کاربر یا گروه لینوکسی نیست؛ نمایندهٔ وظیفه، اختیار و پاسخ‌گویی سازمانی است.

اگر چند گروه ساخته شوند اما نسبت آن‌ها با مسئولیت واقعی روشن نباشد، RBAC پیاده نشده است. اگر فرد با تغییر سمت همچنان دسترسی قبلی را نگه دارد، نقش فقط برچسب بوده است. اگر دسترسی اضطراری دائمی شود یا استفاده از آن ممیزی نشود، تفکیک وظایف شکست خورده است.

RBAC در بالاترین لایهٔ معماری قرار دارد، اما خودش عمل فنی را enforce نمی‌کند. تصمیم «اپراتور فقط وضعیت سرویس را ببیند و مدیر تغییر را تأیید کند» باید با sudo policy، PAM، گروه‌ها، مجوز فایل، API، ابزار مدیریت و ثبت لاگ اجرا شود. قابلیت ردیابی از نقش سازمانی تا مجوز فنی، معیار بلوغ است.

SELinux و AppArmor کنترل نیستند؛ مکانیزم‌اند

عبارت «SELinux داریم» هدف امنیتی را توضیح نمی‌دهد. SELinux و AppArmor سازوکارهای Mandatory Access Control هستند که می‌توانند رفتار فرآیند را فراتر از مجوز سنتی کاربر/گروه محدود کنند. آن‌ها ابزار اجرای سیاست‌اند، نه خود سیاست.

کنترل می‌گوید «سرویس وب حتی پس از نفوذ نباید فایل پشتیبان یا سوکت مدیریتی را بخواند». مکانیزم مشخص می‌کند این محدودیت با type enforcement در SELinux، پروفایل AppArmor، namespace، seccomp یا ترکیبی از آن‌ها چگونه اجرا شود.

این تفکیک چند فایده دارد. سازمان به یک ابزار خاص قفل نمی‌شود، ممیز می‌تواند نتیجه را بسنجد و تیم فنی می‌تواند با توجه به توزیع و کاربری، مکانیزم مناسب را انتخاب کند. در میزبان کانتینر، همین کنترل ممکن است هم‌زمان به LSM، seccomp، capability و سیاست runtime نیاز داشته باشد.

استثنا نشانهٔ ضعف نیست؛ استثنای بی‌مالک ضعف است

هیچ خط پایه‌ای بدون استثنا بر همهٔ سامانه‌ها اعمال نمی‌شود. سامانهٔ صنعتی شاید نتواند الگوریتم یا timeout مورد توصیه را بپذیرد؛ برنامهٔ قدیمی ممکن است با یک سیاست MAC ناسازگار باشد. بلوغ در انکار این تعارض نیست؛ در ثبت و ادارهٔ آن است.

استثنای دفاع‌پذیر باید شامل کنترل مرجع، دلیل فنی و مأموریتی، دامنهٔ سامانه‌ها، ریسک باقی‌مانده، کنترل جبرانی، مالک پذیرش، تاریخ پایان و شرط بازبینی باشد. استثنایی که پایان و صاحب ندارد، عملاً تغییر غیررسمی خط پایه است.

این منطق دربارهٔ سیستم‌های Legacy اهمیت بیشتری دارد. اجرای اسکن و گزارش قرمز، تصمیم را حل نمی‌کند. باید مشخص شود دارایی قابل اصلاح است، باید منزوی شود یا اساساً به نقطه‌ای رسیده که مهاجرت ظاهری ریسک آن را حذف نمی‌کند.

استاندارد نقطهٔ پایان امنیت نیست؛ راهی برای تبدیل تصمیم به زبان مشترک، کنترل قابل اجرا و شواهد قابل ممیزی است. هرجا نام ابزار جای هدف کنترل را بگیرد یا درصد انطباق جای مدل تهدید بنشیند، استاندارد به آیین اداری تبدیل شده است.

بازکردن مقاله در تب جدید
۸

مهاجرت، ریسک سامانه‌های Legacy را حذف نمی‌کند

تفکیک دارایی‌های قابل بازاستقرار، حساس و نیازمند انزوا، و غیرقابل ارتقا.

مطالعهٔ فصل: مهاجرت، ریسک سامانه‌های Legacy را حذف نمی‌کند

بسیاری از پروژه‌های امنیتی با انتخاب مقصد آغاز می‌شوند: لینوکس، کانتینر، ابر خصوصی یا یک توزیع استاندارد. اما مسیر گذار را فناوری مقصد تعیین نمی‌کند؛ ماهیت دارایی‌های موجود تعیین می‌کند. اگر پیش از شناخت دارایی، راه‌حل انتخاب شود، سازمان یا تغییر را روی سامانه‌ای تحمیل می‌کند که تحمل آن را ندارد، یا ریسک سامانهٔ فرسوده را پشت ظاهری مدرن پنهان می‌سازد.

زیرساخت واقعی معمولاً محصول طراحی یکپارچه نیست. در طول سال‌ها، نیاز فوری، تغییر مدیر، محدودیت بودجه و تصمیم‌های مقطعی چند توزیع، نسخه، روش نصب و سیاست امنیتی متفاوت ساخته‌اند. هر تصمیم در زمان خود شاید منطقی بوده، اما مجموعهٔ آن‌ها به ناهمگونی، فرسودگی و نبود حاکمیت عملیاتی منجر شده است.

ناهمگونی آگاهانه با ناهمگونی ناخواسته فرق دارد

تنوع آگاهانه هدف دارد، پیامد آن شناخته شده و هزینهٔ اداره‌اش پذیرفته شده است. ناهمگونی ناخواسته باقی‌ماندهٔ تصمیم‌هایی است که دیگر قابل دفاع یا حتی به‌درستی قابل یادآوری نیستند. چند توزیع برای یک کاربری، نسخه‌های متفاوت یک سرویس و تنظیماتی که فقط در ذهن افراد وجود دارند، نشانهٔ خروج زیرساخت از کنترل معماری‌اند.

این ناهمگونی هنگام اعمال یک سیاست امنیتی آشکار می‌شود. مشخص نیست کنترل روی کدام سامانه قابل اجراست، آیا نتیجه در همهٔ محیط‌ها یکسان خواهد بود و آیا آزمون موفق یک بخش قابل تعمیم است. در نتیجه تغییر یا بیش از حد محافظه‌کارانه می‌شود یا ناقص و ناهماهنگ اجرا می‌گردد.

پذیرش این واقعیت به معنای تسلیم نیست؛ نقطهٔ شروع بازگرداندن حاکمیت است. بدون inventory واقعی و شناخت وابستگی، هر برنامهٔ گذار روی فرضی سست ساخته می‌شود.

فرسودگی با یک شکست بزرگ شروع نمی‌شود

فرسودگی تدریجی است. هر به‌روزرسانی کمی پرریسک‌تر می‌شود، هر تغییر وابستگی پنهان تازه‌ای آشکار می‌کند و «دست نزدن» به سامانه به راهبرد نانوشته تبدیل می‌شود. سیستم همچنان کار می‌کند و همین کارکردن، تعویق را توجیه می‌کند.

چرخهٔ معیوب روشن است: هرچه سامانه قدیمی‌تر می‌شود، تغییر سخت‌تر است؛ و هرچه تغییر سخت‌تر می‌شود، به تعویق می‌افتد. در نهایت بخش‌هایی با برچسب «حساس»، «بحرانی» یا «Legacy» به مناطق ممنوعه تبدیل می‌شوند که همه خطرشان را می‌دانند، اما کسی مالک تصمیم دربارهٔ آن‌ها نیست.

از منظر امنیتی، خطر زمانی عادی می‌شود. runtime منسوخ، الگوریتم قدیمی و دسترسی گسترده به دلیل نبود حادثهٔ آشکار «قابل تحمل» فرض می‌شوند، بدون آنکه این پذیرش آگاهانه، مستند یا زمان‌مند باشد. نداشتن حادثه، به‌ویژه وقتی مشاهده‌پذیری ضعیف است، به معنای نداشتن ریسک نیست.

سه گروه، سه منطق تصمیم

گروهوضعیتمنطق اصلی
الف: قابل مهاجرت یا بازاستقرارمنطق کسب‌وکار از بستر اجرا قابل تفکیک استتغییر کنترل‌شده برای ساخت الگوی تکرارپذیر
ب: حساس و نیازمند انزواقابل تغییر است اما تحمل اختلال یا مهاجرت مستقیم کم استکاهش شعاع آسیب و دامنهٔ اعتماد، نه الزاماً انتقال
ج: غیرقابل ارتقارفتار امنیتی قابل اصلاح یا پشتیبانی نیستتصمیم مدیریتی برای مهار موقت، جایگزینی یا خروج

این دسته‌بندی برای مستندسازی نیست؛ برای جداکردن مسیر تصمیم است. همهٔ دارایی‌ها نباید با یک الگوی مهاجرت، یک سرعت یا یک معیار موفقیت مواجه شوند.

گروه الف؛ جایی برای ساخت الگوی واقعی

دارایی گروه الف الزاماً جدید نیست. ویژگی آن این است که بدون تغییر بنیادین منطق کسب‌وکار می‌تواند بازاستقرار یابد. وب‌سرور، API، سرویس پردازشی، صف و حتی برخی پایگاه‌های داده ممکن است به سیستم‌عامل یا محیط فعلی وابستگی سطحی داشته باشند.

نمونهٔ مناسب باید به اندازه‌ای واقعی باشد که چرخهٔ کامل استقرار، پشتیبان‌گیری، پایش، به‌روزرسانی و بازیابی را بیازماید، اما آن‌قدر بحرانی نباشد که هر خطا غیرقابل پذیرش شود. انتقال مکانیکی یک سرویس از Windows Server به لینوکس، بدون بازبینی کاربر سرویس، دسترسی‌ها، پیکربندی و مشاهده‌پذیری، فقط محل ریسک را عوض می‌کند.

معیار موفقیت «بالا آمدن سرویس» نیست. پس از گذار باید پاسخ روشن باشد:

  • سرویس قابل کنترل‌تر و قابل مشاهده‌تر شده است؟
  • روش استقرار برای دارایی بعدی قابل تکرار است؟
  • تنظیمات و secrets از دستکاری دستی خارج شده‌اند؟
  • بازگشت و بازیابی واقعاً آزموده شده‌اند؟
  • ریسک کم شده یا دست‌کم شفاف و صاحب‌دار شده است؟

گروه الف سکوی یادگیری است. اگر هر دارایی به مجموعه‌ای تازه از استثناها نیاز داشته باشد، الگو ساخته نشده است.

گروه ب؛ مهاجرت همیشه پاسخ درست نیست

دیتابیس مرکزی، سامانهٔ هویت، سرویس مالی یا صنعتی ممکن است از نظر فنی قابل انتقال باشد، اما تحمل عملیاتی آن را نداشته باشد. خطای رایج، نگاه صفر و یکی است: یا مهاجرت کامل یا رهاکردن کامل.

در این گروه، هدف اصلی کاهش blast radius است. مسیرهای دسترسی باید محدود و مستند شوند، شبکه تفکیک شود، اعتماد پیش‌فرض کاهش یابد و رفتار سامانه قابل مشاهده گردد. ممکن است سیستم‌عامل یا برنامه همان بماند، اما اگر نفوذ یا شکست رخ داد، اثر آن نباید به کل زیرساخت سرایت کند.

برای سامانهٔ هویت، انزوا یعنی هر سرویس فقط به همان بخش از اطلاعات و اختیار هویتی دسترسی داشته باشد که نیاز دارد. برای دیتابیس مرکزی، به معنای کاهش مصرف‌کنندگان مستقیم، کنترل مسیرهای اتصال و حذف دسترسی عمومی تیم‌هاست. برای سامانهٔ صنعتی، ممکن است اولویت با تثبیت محیط، bastion کنترل‌شده و پایش غیرفعال باشد، نه نصب سریع نسخهٔ جدید.

انزوا زمانی واقعی است که دقیقاً معلوم باشد چه ریسکی را کم می‌کند. قرار دادن سامانه در VLAN جدا بدون تعریف ارتباط مجاز، خیلی زود با استثناهای عملیاتی سوراخ می‌شود. تصمیم «فعلاً مهاجرت نمی‌دهیم» نیز باید صاحب، بازهٔ اعتبار و شرط بازبینی داشته باشد؛ وگرنه تعویق به پذیرش دائمی ریسک تبدیل می‌شود.

گروه ج؛ مسئلهٔ امنیتی، نه پروژهٔ فنی

دارایی گروه ج قدیمی است، اما قدیمی‌بودن معیار اصلی نیست. معیار، ناتوانی ساختاری در اصلاح رفتار امنیتی است. نسخهٔ پشتیبانی‌شده وجود ندارد، runtime قابل ارتقا نیست، وابستگی با کتابخانه و دیتابیس منسوخ گره خورده یا فعال‌کردن کنترل‌های جدید سامانه را از کار می‌اندازد.

Java 6 یا 7، نسخه‌های قدیمی .NET Framework، سرویس وابسته به glibc یا OpenSSL منسوخ، schema ناسازگار با نسخهٔ جدید دیتابیس و برنامه‌ای که فقط با دسترسی گسترده کار می‌کند، نمونه‌های رایج‌اند. چنین سامانه‌ای ممکن است روی لینوکس جدید یا داخل کانتینر اجرا شود، اما رفتار امنیتی آن اصلاح نشده است.

اگر یک برنامهٔ آسیب‌پذیر داخل image قرار گیرد، کانتینر فقط بسته‌بندی و توزیع آن را آسان کرده است. اگر برای کارکرد برنامه مجبور شویم seccomp، LSM یا اسکن را غیرفعال کنیم، زیرساخت مدرن سپر دفاعی خود را برای حفظ Legacy کنار گذاشته است. کانتینر مرز امنیتی مستقل نیست و نمی‌تواند runtime آسیب‌پذیر را سالم کند.

چرا مهاجرت ریسک گروه ج را حذف نمی‌کند؟

مهاجرت زمانی کاهش ریسک ایجاد می‌کند که رفتار امنیتی پس از آن قابل اصلاح، قابل به‌روزرسانی و قابل اتکا شود. اگر همان runtime، همان الگوی دسترسی و همان وابستگی باقی بماند، تغییر سیستم‌عامل یا محل اجرا فقط سطح حمله را جابه‌جا می‌کند.

خطر بزرگ‌تر، شکاف میان تصور و واقعیت است. مدیران سامانه را «مهاجرت‌داده‌شده» و بنابراین امن‌تر می‌بینند، در حالی که هستهٔ آسیب‌پذیر پنهان شده است. پروژه از نظر تحویل موفق گزارش می‌شود و سؤال اصلی—آیا این سامانه باید همچنان فعال بماند؟—بی‌پاسخ می‌ماند.

برای گروه ج، مهاجرت فقط وقتی معنا دارد که بخشی از بازطراحی، جایگزینی یا خروج تدریجی باشد. در غیر این صورت بازآرایی ریسک است، نه کاهش آن.

خطاهای رایج در مواجهه با Legacy

  • پنهان‌کردن در زیرساخت جدید: ماشین مجازی، کانتینر یا cloud نام ریسک را عوض می‌کند، نه ماهیت آن را.
  • تبدیل انزوا به راه‌حل دائمی: برای گروه ج، انزوا کنترل موقت است و باید برنامهٔ خروج داشته باشد.
  • افزودن وابستگی تازه: هر اتصال و قابلیت جدید، هزینهٔ حذف آینده را بیشتر می‌کند.
  • نبود مالک ریسک: تیم فنی تحویل گرفته، امنیت هشدار داده و مدیریت تحمل کرده، اما کسی تصمیم را نپذیرفته است.
  • تفسیر سکوت به‌عنوان ثبات: نبود لاگ و مشاهده‌پذیری می‌تواند حادثه را پنهان کند، نه حذف.
  • توجیه با هزینهٔ گذشته: سرمایه‌گذاری انجام‌شده دلیل ادامهٔ وابستگی نیست؛ باید هزینهٔ آینده و پیامد شکست سنجیده شود.

کادر تصمیم مدیریتی

برای هر دارایی گروه ج باید پاسخ صریح وجود داشته باشد:

  1. آیا مسیر ارتقا یا جایگزینی واقعی و آزموده‌شده وجود دارد؟
  2. اگر نه، ادامهٔ فعالیت چه ریسک و چه پیامد مأموریتی دارد؟
  3. چه کنترل جبرانی‌ای واقعاً شعاع آسیب را کم می‌کند؟
  4. مالک رسمی پذیرش ریسک چه کسی است؟
  5. این پذیرش تا چه تاریخی معتبر است و چه رخدادی آن را باطل می‌کند؟
  6. چه اتصال یا قابلیت تازه‌ای از امروز ممنوع می‌شود تا هزینهٔ خروج افزایش نیابد؟
  7. برنامهٔ خروج، جایگزینی یا بازطراحی چه نقطهٔ تصمیم بعدی دارد؟

امنیت Legacy با «تمیزکردن» ظاهر آن حل نمی‌شود. تصمیم درست ممکن است مهاجرت، انزوا، بازطراحی یا حتی ادامهٔ موقت فعالیت باشد؛ اما باید روشن، صاحب‌دار، زمان‌مند و قابل بازبینی باشد. همان‌گونه که در مقالهٔ استاندارد، کنترل و مکانیزم گفته شد، استثنا نشانهٔ ضعف نیست؛ استثنایی که بی‌صاحب و بی‌پایان بماند، ضعف حاکمیت است.

بازکردن مقاله در تب جدید