از ارسال فرمان و انتقال PCIe تا NVLink رمزگذاریشده و معماری پشته استنتاج
پردازش محرمانه قرار است داده، مدل و وضعیت میانی اجرای آنها را حتی از مدیر زیرساخت، سیستمعامل میزبان و hypervisor پنهان نگه دارد. برای سنجش هزینهٔ این حفاظت باید دید کدام بخش مسیر اجرا مشمول سربار میشود، چه مقدار از زمان هر درخواست در آن بخش میگذرد و پشته نرمافزاری تا چه اندازه میتواند این هزینه را پنهان یا تشدید کند؟
یک پیشچاپ تازه درباره عملکرد پردازش محرمانه روی NVIDIA B200 دو نتیجه ظاهراً متناقض گزارش میکند: در یک پشته درست تنظیمشده، سربار استنتاج میتواند حدود ۱ تا ۳ درصد باشد؛ اما در بعضی پیکربندیهای بدون اصلاح، افت توان عملیاتی به ۳۰ تا ۴۰ درصد میرسد.
در یادداشت پشتیبانی واقعی INT8 و FP8 دیدیم که پشتیبانی اسمی از یک قالب عددی، استفاده واقعی از آن را تضمین نمیکند. در یادداشت تأخیر و توان عملیاتی نیز توضیح دادیم که سریعترین GPU لزوماً سریعترین پاسخ را تولید نمیکند. در سومین نوشتهٔ این دنباله در راهنمای انتخاب GPU، مسئله یک گام پایینتر است: حتی وقتی سختافزار و مدل ثابتاند، معماری امنیتی و نرمافزار استنتاج میتوانند تعیین کنند که حفاظت از داده چند درصد هزینه داشته باشد.
دقیقاً چه چیزی محرمانه میشود؟
در سامانه مورد بررسی، ماشین مجازی محرمانه با Intel TDX از حافظه و وضعیت CPU در برابر میزبان محافظت میکند و حالت Confidential Computing انویدیا دامنه حفاظت را به GPU گسترش میدهد.
در یادداشت امنیت زیرساخت از کرنل و GPU مسئلهٔ دسترسی لایههای زیرین به داده را بررسی کردیم. اینجا هزینهٔ حفاظت از همان مرزها مطرح است:
- حافظه ماشین مجازی و وضعیت CPU؛
- انتقال داده میان حافظه میزبان و GPU روی PCIe؛
- حافظه داخلی GPU؛
- مسیر فرمان از میزبان به پردازنده مدیریتی GPU؛
- ارتباط میان GPUها روی NVLink؛
- و زنجیره تایید اصالت سختافزار، firmware و محیط اجرا.
در معماری Intel TDX، حافظهٔ خصوصی ماشین مجازی از ناظر ماشین مجازی یا VMM و نرمافزار میزبان جدا میشود.
طبق راهنمای پردازش محرمانهٔ NVIDIA، در Blackwell حالت چند GPU نیز از NVLink رمزگذاریشده پشتیبانی میکند. انتقال CPU–GPU میتواند از بافر واسط رمزگذاریشده یا، در پلتفرمهای سازگار، از TDISP/IDE استفاده کند.
بنابراین «فعالکردن رمزگذاری» یک عملیات منفرد نیست. چند مرز متفاوت وجود دارند و هرکدام الگوی هزینه خاص خود را دارند.
این اندازهگیری دقیقاً درباره چه سامانهای است؟
مبنای این یادداشت نسخهٔ دوم پیشچاپ، منتشرشده در اول سپتامبر ۲۰۲۶ است. اعداد زیر حاصل آزمون نویسندگان پژوهشاند؛ در این یادداشت آنها را تحلیل میکنیم.
سامانه آزمون شامل این اجزا بوده است:
| مولفه | پیکربندی آزمون |
|---|---|
| میزبان | یک سرور دوپردازنده با Intel Xeon 6767P |
| GPU | هشت NVIDIA B200 متصل به NVLink |
| محیط محرمانه | Intel TDX همراه با NVIDIA CC |
| سیستمعامل | Ubuntu 24.04.3 |
| درایور مهمان | NVIDIA 595.71.05 Open Driver |
| موتورهای استنتاج | SGLang 0.5.13.post1 و شاخهٔ اصلاحشده، vLLM 0.21.0 و 0.22.0 |
| مدلها | چند مدل dense و MoE با NVFP4، FP8، AWQ و bf16 |
| روش مقایسه | اجرای جفتشده CC روشن و خاموش روی همان میزبان، دیسک و GPU |
این پژوهش از نظر کنترل متغیرها ارزشمند است: در هر ردیف، اجرای محرمانه و عادی روی همان سختافزار انجام شدهاند و فقط وضعیت TDX و CC تغییر کرده است. بااینحال، نسخهٔ چارچوب نرمافزاری، مدل و تنظیمات بین تمام ردیفها یکسان نیستند؛ بنابراین مقایسه درون هر ردیف معتبرتر از مقایسه آزادانه ردیفهای مختلف است.
نویسندگان همچنین میگویند اجرای تمیز نیازمند راهاندازی مجدد بوده است. یک اجرای آلوده به وضعیت باقیمانده GPU، سربار ۱۶ درصدی نشان داده بود؛ درحالیکه اندازهگیری تمیز همان بار کاری حدود ۲ درصد بوده است. بنابراین وضعیت باقیماندهٔ GPU میتواند اختلافی بسیار بزرگتر از سربار واقعی ایجاد کند.
بخش محاسباتی مسئله اصلی نیست
نتیجه مرکزی پژوهش این است که در پیکربندی مورد آزمایش، ضرب ماتریسی، GEMM و دسترسی به HBM عامل اصلی سربار نبودهاند. هزینه بیشتر در مرزهای ارتباطی ظاهر شده است:
- ارسال فرمان از میزبان به GPU؛
- انتقال CPU–GPU روی PCIe؛
- ارتباط GPU–GPU روی NVLink رمزگذاریشده.
به زبان ساده، GPU برای محاسبه امن لزوماً کند نشده است؛ اما رساندن فرمان و داده به آن و هماهنگکردن چند GPU گرانتر شده است.
هزینه نخست: هر فرمان کوچک، یک هزینه ثابت دارد
هر بار که میزبان کرنلی را برای اجرا به GPU ارسال میکند، فرمان از یک مسیر کنترل محافظتشده به GSP یا GPU System Processor میگذرد. این پژوهش برای هر ارسال کرنل روی یک GPU، حدود ۱۲ میکروثانیه هزینه اضافه اندازه گرفته است:
| عملیات | CC خاموش | CC روشن | تفاوت |
|---|---|---|---|
| ارسال یک کرنل | ۳٫۴۵ میکروثانیه | ۱۵٫۷ میکروثانیه | حدود ۱۲ میکروثانیه |
| همگامسازی بدون ارسال | ۱٫۶۲ میکروثانیه | ۱٫۶۷ میکروثانیه | تقریباً صفر |
دوازده میکروثانیه عدد بزرگی به نظر نمیرسد؛ مگر آنکه یک گام decode شامل دهها یا صدها ارسال جداگانه باشد.
در آزمون کوچک و مستقل پژوهش، هر گام حدود ۱۸۱ کرنل داشت. اجرای eager مجبور بود این فرمانها را در هر گام دوباره از میزبان ارسال کند:
| شیوه اجرا | CC خاموش | CC روشن | نسبت زمان |
|---|---|---|---|
| Eager | ۲۶۴۴ میکروثانیه در هر گام | ۶۳۵۸ میکروثانیه | ۲٫۴۱ برابر |
| CUDA graph کامل | ۲۵۰۰ میکروثانیه | ۲۵۸۹ میکروثانیه | ۱٫۰۴ برابر |
CUDA graph مجموعه عملیات را از قبل ثبت میکند و بهجای صدها ارسال، یک graph را بازپخش میکند. به همین دلیل هزینه مسیر فرمان از مسئلهای بزرگ به سرباری چنددرصدی تبدیل میشود.
اما عبارت «CUDA graph فعال است» کافی نیست. اگر framework گراف را در هر لایه attention بشکند، هنوز ممکن است نزدیک به ۱۸۵ ارسال میزبان در هر گام باقی بماند. مسئله تعداد واقعی ارسالهاست، نه صرفاً نام گزینه تنظیماتی.
میتوان سهم تقریبی این بخش را چنین نوشت:
هرچه یک گام محاسباتی کوتاهتر و تعداد ارسالها بیشتر باشد، سهم این هزینه ثابت بزرگتر میشود.
هزینه دوم: PCIe رمزگذاریشده فقط پهنایباند نیست
انتقال داده میان حافظه میزبان و GPU در این پشته با AES-GCM و bounce bufferهای تحت مدیریت درایور انجام شده است. برای انتقالهای حجیم، هزینه تقریباً متناسب با تعداد بایتهاست؛ اما در انتقالهای کوچک، هزینه ثابت آمادهسازی رمزنگاری و فراخوانی اهمیت بیشتری پیدا میکند.
در آزمون مقاله:
- نرخ انتقال در اندازهٔ یک مگابایت ۷٫۲۱ و در اندازههای ۱۶ و ۶۴ مگابایت حدود ۹٫۴ تا ۹٫۶ گیگابایتبرثانیه بوده است؛
- انتقالهای ۶۴ کیلوبایت و کوچکتر بیشتر تحت تاثیر هزینه ثابت تقریبی ۳ تا ۶ میکروثانیه بودهاند؛
- افزایش تعداد threadهای میزبان، سرعت رمزنگاری یک session مربوط به یک GPU را افزایش نداده است.
این محدودیت در بارگذاری اولیه وزنها قابل مشاهده است، اما اگر وزنها و KV cache پس از بارگذاری در GPU باقی بمانند، لزوماً در مسیر داغ هر توکن تکرار نمیشود.
مشکل حساستر، خواندن نتیجه sampling از GPU در پایان هر گام decode است. در پشته بدون اصلاح، کپی کوچک device-to-host که باید با محاسبه گام بعدی همپوشانی داشته باشد، عملاً synchronous شده و زمانبند را متوقف کرده است. GPU منتظر میماند، utilization کاهش پیدا میکند و افت توان عملیاتی بسیار بیشتر از زمان محاسبه AES دیده میشود.
این همان نقطهای است که عدد ۳۰ تا ۴۰ درصد شکل میگیرد.
چرا یک آزمایش ۳۹ درصد و آزمایش دیگر کمتر از یک درصد نشان میدهد؟
در SGLang منتشرشده و بدون اصلاح، اجرای Qwen3-8B روی یک B200 با overlap فعال چنین نتیجهای داشته است:
| همزمانی | توان عملیاتی بدون CC | توان عملیاتی با CC | افت توان عملیاتی |
|---|---|---|---|
| ۱۶ | ۳۸۲۸ توکنبرثانیه | ۲۵۱۳ | ۳۴٫۴٪ |
| ۳۲ | ۶۹۳۱ | ۴۵۳۴ | ۳۴٫۶٪ |
| ۶۴ | ۱۱٬۱۳۷ | ۶۸۰۵ | ۳۸٫۹٪ |
در همزمانی ۶۴، TPOT از ۵٫۴۸ به ۸٫۲۸ میلیثانیه و TTFT از ۲۵۹ به ۴۰۹ میلیثانیه رسیده است. بنابراین «۳۹ درصد» در اینجا افت توان عملیاتی است؛ افزایش بعضی معیارهای تاخیر حتی از آن بیشتر بوده است.
علت اصلی این نتیجه، کندشدن محاسبات GPU نبوده است. کپی کوچک D2H دیگر پشت محاسبه پنهان نشده، زمانبند serial شده و استفاده از GPU از ۷۴ به ۵۷ درصد کاهش یافته است.
پس از انتقال D2H به یک worker غیرهمزمان و اعمال اصلاحات سازگار با CC، آزمایش تک GPU دیگری با Qwen2.5-72B-AWQ در sweep همزمانی، نتیجهای بین منفی ۰٫۲ تا مثبت ۰٫۶ درصد نشان داده است؛ یعنی عملاً در محدودهٔ نویز. مدل این آزمون با آزمون قبلی فرق دارد؛ این دو عدد، اندازهگیری قبل و بعد از اصلاح روی یک مدل واحد نیستند. در ده شکل متفاوت ورودی و خروجی نیز میانه سربار ۱٫۲ درصد و بدترین مقدار ۶٫۵ درصد بوده است.
بنابراین ۳۰ تا ۴۰ درصد را نباید «هزینه ذاتی رمزنگاری GPU» نامید. این عدد، نتیجه برهمکنش حالت محرمانه با رفتار مشخص یک پشته اصلاحنشده است. در مقابل، عدد نزدیک به صفر نیز تضمین عمومی نیست؛ آن هم به framework، مدل و شکل بار وابسته است.
هزینه سوم: NVLink رمزگذاریشده
با ورود GPU دوم، یک مسیر تازه به مسئله اضافه میشود. ارتباطات collective مانند all-reduce و all-to-all باید روی NVLink رمزگذاریشده انجام شوند.
آزمون کوچک و مستقل چهار B200 روی یک گرهٔ NUMA چنین تفاوتی نشان داده است:
| معیار | CC روشن | CC خاموش | کاهش محاسبهشده |
|---|---|---|---|
| Copy Engine، خواندن یکطرفه | ۸۰۷۰ گیگابایتبرثانیه | ۹۱۷۰ گیگابایتبرثانیه | ۱۲٪ کاهش |
| Copy Engine، نوشتن یکطرفه | ۸۲۷۸ گیگابایتبرثانیه | ۹۲۹۲ گیگابایتبرثانیه | ۱۰٫۹٪ کاهش |
| مسیر مبتنی بر SM، خواندن | ۷۶۹۳ گیگابایتبرثانیه | ۹۳۸۸ گیگابایتبرثانیه | ۱۸٫۱٪ کاهش |
| NCCL all-reduce | ۱۵۶ گیگابایتبرثانیه | ۱۸۵ گیگابایتبرثانیه | ۱۵٫۷٪ |
| NCCL all-to-all | ۱۳۰ گیگابایتبرثانیه | ۱۴۹ گیگابایتبرثانیه | ۱۲٫۸٪ |
درصدهای دو ردیف NCCL از اعداد همان ردیف محاسبه شدهاند؛ برچسب «۱۰٪» در جدول اصلی با این مقادیر سازگار نیست. ردیفهای Copy Engine و SM شاخص گزارششدهٔ آزمون D2D هستند، نه مشخصات پهنایباند یک اتصال NVLink. تأخیر میانهٔ نوشتن کوچک P2P نیز از ۳٫۷ به ۱۴٫۵ میکروثانیه رسیده؛ نزدیک به چهار برابر.
این اعداد به معنای ده تا هجده درصد افت کل سرویس نیستند. افت نهایی به این بستگی دارد که چه سهمی از زمان هر گام واقعا در ارتباط میان GPUها صرف شود.
اگر ارتباط collective تنها ۲۰ درصد مسیر بحرانی باشد و رمزگذاری آن بخش را ۱۰ درصد کندتر کند، سهم مستقیم آن در زمان کل بسیار کمتر از ۱۰ درصد خواهد بود. اگر workload تقریباً بهطور کامل communication-bound باشد، اثر به نرخ خام ارتباط نزدیکتر میشود.
از این منظر، تفاوت PCIe و SXM فقط تفاوت شکل نصب کارت نیست؛ مسیر و حجم ارتباط میان GPUها در هزینهٔ اجرای محرمانه نیز اثر میگذارد.
دو محور مستقل سربار
نتایج مقاله را میتوان با دو محور توضیح داد:
| محور هزینه | رفتار | راه کاهش |
|---|---|---|
| هزینه ثابت عملیات میزبان | با هر ارسال، synchronization یا readback تکرار میشود | CUDA graph کاملتر، کاهش graph split، worker غیرهمزمان D2H |
| هزینه ترافیک NVLink | با حجم ارتباط رمزگذاریشده میان GPUها تغییر میکند | کاهش collective غیرضروری و انتخاب parallelism مناسب |
بزرگترکردن دستهٔ درخواستها میتواند هزینه ثابت ارسال فرمان را میان درخواستهای بیشتری تقسیم کند. اما دستهٔ بزرگتر، حجم collective را هم افزایش میدهد. بنابراین batching یک محور را بهبود میدهد و ممکن است محور دیگر را تا رسیدن به یک سطح ثابت پررنگتر کند.
این توضیح میدهد چرا هیچ اندازهٔ دستهٔ ثابت و جهانشمولی برای کمینهکردن سربار وجود ندارد.
عدد ۱ تا ۳ درصد دقیقاً در چه شرایطی به دست آمده است؟
مهمترین نتیجه چند GPU مربوط به MiniMax-M2.7، یک مدل MoE با حدود ۲۲۹ میلیارد پارامتر و ۶ میلیارد پارامتر فعال، روی هشت B200 است.
در نقطه مرجع با ۱۰۲۴ توکن ورودی، ۲۰۴۸ توکن خروجی و همزمانی ۳۲:
- TP8 در دو مجموعه پنجتکراری، ۲٫۸ و ۳٫۶ درصد سربار نشان داده است؛
- TP4 حدود ۱٫۵ درصد سربار داشته است؛
- TP4 با نصفکردن عرض tensor parallel، هنوز ۹۴ درصد توان عملیاتی TP8 را حفظ کرده است.
پس عبارت «حدود ۱ تا ۳ درصد» خلاصه یک سطح عملکردی مشخص است: پشتهٔ اصلاحشده با گرافهای قطعهای CUDA و همپوشانی فعال، بار غالباً تولید توکن و موازیسازی متناسب با مدل. این عدد نه مربوط به همه بارهاست و نه حتی برای همین سرور در همه تنظیمات برقرار میماند.
| سناریوی اندازهگیریشده | سربار گزارششده | سازوکار غالب |
|---|---|---|
| یک GPU، overlap خاموش | حدود ۲٪ | هزینه باقیمانده مسیر فرمان |
| یک GPU، overlap روشن و پشته اصلاحنشده | ۳۴ تا ۳۹٪ | از دسترفتن همپوشانی محاسبه و کپی |
| یک GPU، graph و پشته اصلاحشده | کمتر از ۱٪ در sweep اصلی | حذف هزینه مسیر بحرانی |
| MoE با TP8 | حدود ۲٫۸ تا ۳٫۶٪ | all-reduce رمزگذاریشده |
| MoE با TP4 | حدود ۱٫۵٪ | ترافیک کمتر NVLink |
| Qwen3.5 با DP-attention و EP، ورودی ۳۲٬۷۶۸ توکن | حدود ۲٪ | نبود all-reduce در attention |
| آموزش هشت GPU | ۱۱ تا ۲۴٪ افزایش زمان گام | ارتباطهای جمعی پرتکرار آموزش |
در ردیفهای استنتاج، درصدها افت توان عملیاتیاند؛ در آموزش، افزایش زمان هر گام اندازهگیری شده است. مخرج این دو معیار یکسان نیست. اختلاف میان آزمونهای آموزش هم قابل توجه است:
| آزمون آموزش روی هشت GPU | زمان گام بدون CC | زمان گام با CC | افزایش زمان |
|---|---|---|---|
| مدل dense با bf16 و TP8 | ۱۳٫۹۵ ثانیه | ۱۵٫۸ ثانیه | ۱۳٫۳٪ |
| مدل dense با delayed FP8 و TP8 | ۱۴٫۵ ثانیه | ۱۸ ثانیه | ۲۴٫۱٪ |
| مدل MoE تنظیمشده با EP8 | ۲٫۱۶ ثانیه | ۲٫۴۰ ثانیه | ۱۱٫۱٪ |
درصدهای این جدول از زمانهای گزارششده محاسبه شدهاند. آزمون FP8 بیشترین افزایش زمان را داشته است.
طول خروجی چگونه نتیجه را تغییر میدهد؟
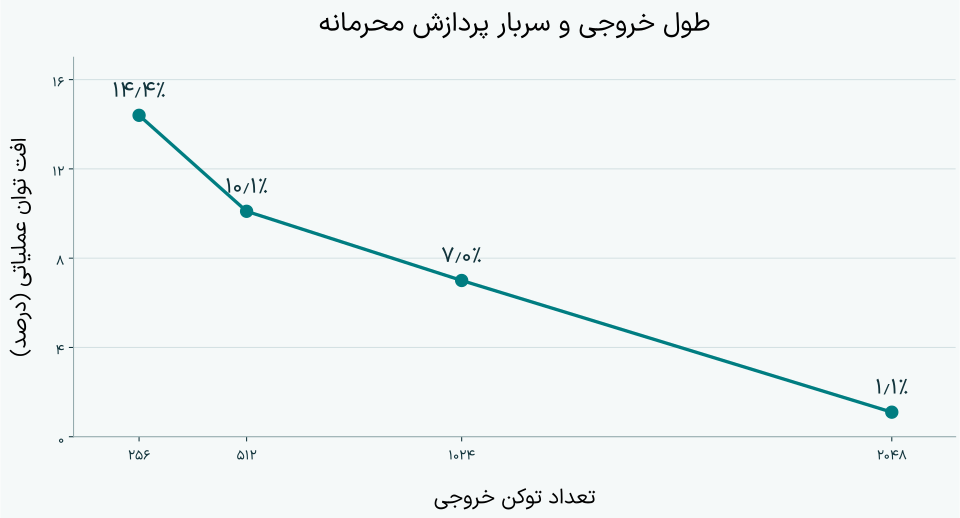
در یک sweep با MiniMax-M2.7، TP8، ورودی ۱۰۲۴ توکنی و همزمانی ۳۲، خروجی بلندتر باعث شد هزینه prefill رمزگذاریشده روی تعداد بیشتری از گامهای decode تقسیم شود:
| طول خروجی | بدون CC | با CC | افت توان عملیاتی |
|---|---|---|---|
| ۲۵۶ | ۱۷۰۱٫۰ توکنبرثانیه | ۱۴۵۶٫۰ | ۱۴٫۴٪ |
| ۵۱۲ | ۲۳۰۰٫۵ | ۲۰۶۸٫۴ | ۱۰٫۱٪ |
| ۱۰۲۴ | ۲۵۵۱٫۴ | ۲۳۷۱٫۶ | ۷٫۰٪ |
| ۲۰۴۸ | ۲۵۳۰٫۷ | ۲۵۰۴٫۰ | ۱٫۱٪ |
دادههای نمودار عیناً از sweep مقاله گرفته شدهاند. بیشتر نقاط این سطح، اجرای منفرد روی داده تصادفی بودهاند و نویسندگان نویز تقریبی دو واحد درصد را گزارش کردهاند. برای همان شکل ۱۰۲۴ ورودی و ۲۰۴۸ خروجی، اندازهگیریهای پنجتکراری عدد ۲٫۸ تا ۳٫۶ درصد را نشان دادهاند، نه ۱٫۱ درصد. بنابراین نمودار برای نشاندادن جهت تغییر معتبرتر از استناد به آخرین رقم اعشار هر نقطه است.
در این آزمون، پردازش اولیهٔ ورودی یا prefill در پاسخ کوتاه سهم بزرگتری از کل زمان داشته؛ با طولانیشدن تولید خروجی یا decode، سهم آن کاهش یافته است.
زمینه بلند همیشه سربار را کم نمیکند
اثر طول زمینه به نوع موازیسازی وابسته است.
در آزمون MiniMax-M2.7 با NVFP4 روی چهار GPU و چیدمان TP2/EP4/DP2، افزایش ورودی از ۴٬۰۹۶ به ۳۲٬۷۶۸ توکن سربار را از ۹ به ۱۴٫۵ درصد رسانده است. دلیل آن افزایش ترافیک all-reduce در prefill بوده است.
اما در آزمون Qwen3.5-397B-A17B با FP8 روی هشت GPU و چیدمان DP8/EP8، که attention به all-reduce میان GPUها نیاز نداشته، سربار در همین بازه از ۱۱٫۱ به ۱٫۹ درصد کاهش یافته است. در این حالت، محاسبه بیشتر شده، ولی هزینه ثابت و ارتباط کارشناسان بهتر مستهلک شدهاند.
این دو آزمون مدل، قالب عددی و تعداد GPU یکسان ندارند؛ پس اختلافشان را نمیتوان فقط به نوع موازیسازی نسبت داد. در هر دو، طول خروجی ۲۵۶ توکن و همزمانی ۳۲ بوده است.
پس جمله «زمینه بلند سربار CC را کم میکند» به همان اندازه ناقص است که بگوییم «زمینه بلند آن را زیاد میکند». پرسش تعیینکننده این است:
با بلندترشدن زمینه، چه مقدار محاسبه اضافه میشود و چه مقدار ارتباط رمزگذاریشده؟
موازیسازی بیشتر همیشه بهتر نیست
Tensor parallelism برای هر لایه، بخشهایی از activation را میان GPUها جابهجا و معمولاً all-reduce میکند. در حالت محرمانه این ترافیک باید رمزگذاری شود. اگر مدل بدون هشتراه TP هم با ظرفیت مناسب اجرا میشود، تقسیم آن میان GPUهای بیشتر ممکن است فقط سطح ارتباط را افزایش دهد.
در نقطه مرجع پژوهش، کاهش TP8 به TP4:
- سربار CC را از حدود ۳ به ۱٫۵ درصد رسانده است؛
- در عین حال ۹۴ درصد توان عملیاتی TP8 را حفظ کرده است.
درس این آزمایش «کمکردن تعداد GPU» نیست. تعداد GPU و عرض یک گروه tensor-parallel یک مفهوم نیستند. میتوان deployment بزرگتری داشت، اما هر replica یا گروه TP را فقط به اندازه مورد نیاز مدل نگه داشت.
برای مدلهای MoE نیز expert parallelism و data parallelism ممکن است نسبت به tensor parallelism ترافیک همزمان کمتری تولید کنند. بااینحال انتخاب نهایی باید روی همان مدل، batch، طول زمینه و توپولوژی واقعی آزموده شود.
پشته نرمافزاری بخشی از معماری امنیتی است
در مقایسهٔ Ollama، vLLM، SGLang و llama.cpp انتخاب ابزار را از نیاز سرویس آغاز کردیم. برای اجرای محرمانه، رفتار نسخهٔ مشخص ابزار در مسیر انتقال داده هم وارد این انتخاب میشود. تصمیمهای framework مستقیما تعیین میکنند که یک هزینه کوچک سختافزاری چند بار و در کجای مسیر بحرانی تکرار شود.
بر اساس این مطالعه، موارد زیر بیشترین اثر را داشتهاند:
- استفاده از CUDA graph و کاهش graph split؛
- اجرای غیرهمزمان readback توکن روی worker جداگانه؛
- پرهیز از درخواست بیفایده pinned host memory در پشتهای که آن را پشتیبانی نمیکند؛
- استفاده از global timer بهجای CUDA event در autotuner؛
- انتخاب fusionهایی که به multicast مسدودشده در CC وابسته نیستند؛
- resident نگهداشتن وزنها و KV cache در GPU؛
- پرهیز از weight streaming، CPU expert offload و KV offload روی مسیر داغ؛
- و تنظیم عرض TP براساس نیاز مدل، نه براساس تعداد GPUهای موجود.
انویدیا در یک گزارش رسمی منتشرشده در دوم ژوئیه ۲۰۲۶ نیز روی async D2H worker، زمانسنج سازگار با CC و piecewise CUDA graph تاکید کرده است. آزمون آن گزارش روی HGX B300 و Qwen3.5 انجام شده و افتی حدود ۱ تا ۸ درصد در شکلهای مختلف بار گزارش میکند. این نتایج را نمیتوان با اعداد B200 جمع یا جایگزین کرد، اما مستقل از عدد نهایی نشان میدهد نسخه و تنظیم پشته بخشی از نتیجهاند.
این پژوهش چه چیزهایی را اندازه نگرفته است؟
عنوان این یادداشت عمدا درباره «سربار پردازش» است، نه هزینه جامع استقرار پردازش محرمانه. چند بخش مهم خارج از دامنه اندازهگیری بودهاند:
راهاندازی و attestation
زمان ساخت ماشین محرمانه، راهاندازی GPU، برقراری session امن، attestation CPU و GPU و تحویل کلید اندازهگیری نشده است.
Attestation معمولاً پیش از تحویل اسرار و آغاز workload انجام میشود و قرار نیست برای هر درخواست استنتاج تکرار شود. بااینحال در سامانههای کوتاهعمر، autoscaling شدید یا serverless، زمان راهاندازی میتواند از نظر عملی مهم باشد. مطالعه حاضر عددی برای آن ارائه نمیکند.
ارتباط میان میزبانها
همه نتایج به یک میزبان فیزیکی محدودند. RDMA، ارتباط GPUها میان چند سرور، prefill/decode disaggregation و انتقال KV cache بین nodeها اندازهگیری نشدهاند.
مقاله توضیح میدهد که در پشته مورد آزمایش، فعالبودن CC مسیر GPUDirect RDMA و pinned buffer متداول را محدود میکند و میتواند انتقال میان میزبانها را به مسیر GPU–CPU–CPU–GPU ببرد. این توضیح یک هشدار معماری است، نه بنچمارک کمی برای clusterهای چندnode.
اثبات امنیت
این پژوهش هیچ خاصیت امنیتی را ممیزی یا اثبات نکرده است. مقاومت در برابر مهاجم مشخص، امنیت firmware، زنجیره تامین، مدیریت کلید، سیاست attestation و پوشش حملات جانبی خارج از حوزه آزمون بودهاند.
برای بررسی اختیارات مدیر زیرساخت، مسیرهای گزارشگیری و امکان استخراج داده از خروجی، مسئلهٔ دسترسی غیرمستقیم به داده همچنان جداگانه مطرح است.
تعمیم به سختافزارهای دیگر
نتایج مربوط به B200، Intel TDX و نسخههای مشخصی از درایور و framework هستند. نمیتوان اعداد آن را مستقیما به H100، B300، GPUهای دیگر، AMD SEV-SNP، پلتفرمهای TDISP/IDE یا نسلهای بعدی نرمافزار تعمیم داد.
آزمون پذیرش مناسب چگونه نوشته شود؟
برای خرید یا پذیرش یک زیرساخت محرمانه، یک عدد میانگین کافی نیست. آزمون باید حداقل این موارد را ثبت کند:
| حوزه | موارد لازم |
|---|---|
| سختافزار | مدل CPU و GPU، تعداد GPU، توپولوژی NUMA و NVLink |
| امنیت | نوع TEE، حالت CC، نسخه firmware و روش attestation |
| نرمافزار | نسخه driver، CUDA، NCCL، framework و patchهای CC |
| مدل | نسخه وزنها، precision، معماری dense یا MoE |
| بار | توزیع طول ورودی و خروجی، batch و نرخ ورود درخواست |
| موازیسازی | TP، PP، DP و EP با عرض دقیق هر گروه |
| زمانبندی | CUDA graph، piecewise graph، overlap و chunked prefill |
| حافظه | محل وزنها و KV cache و وضعیت offload |
| خروجی آزمون | TTFT، TPOT، توان عملیاتی، goodput، خطا و utilization |
| چرخه عمر | زمان startup، attestation و تحویل کلید، در صورت اهمیت |
| مقیاس | تکمیزبان یا چندمیزبان و مسیر واقعی ارتباطات |
همان workload باید یکبار با CC و یکبار بدون CC روی سختافزار و داده یکسان اجرا شود. برای هر نقطه چند تکرار لازم است و پراکندگی نتیجه باید همراه میانه یا میانگین گزارش شود.
اگر تنها یک اجرای تکمرحلهای انجام شود، اختلاف یک یا دو درصد ممکن است چیزی بیش از نویز اندازهگیری نباشد.
پیش از انتخاب پیکربندی
اگر افت توان عملیاتی با افزایش همزمانی از ۳۴ به ۳۹ درصد میرسد و استفاده از GPU هم پایین میآید، ابتدا مسیر خواندن نتیجه و زمانبند را بررسی کنید. اگر افت با طول ورودی و ترافیک جمعی رشد میکند، عرض TP و ارتباط میان GPUها اهمیت بیشتری پیدا میکند. این دو وضعیت به اصلاح یکسانی نیاز ندارند.
در پیکربندی مرجع همین پژوهش، TP4 حدود ۹۴ درصد توان عملیاتی TP8 را با سربار محرمانگی کمتر حفظ کرده است. برای انتخاب زیرساخت، چنین مقایسهای از یک درصد کلی برای «هزینهٔ CC» کاربردیتر است: کدام پیکربندی، بار واقعی سرویس را با تأخیر و ظرفیت مورد نیاز اجرا میکند؟